

对话流程
配置助手在对话中如何处理超时、打断和轮次切换。
概览
对话流程设置决定助手如何处理用户沉默、说话时被打断以及轮次切换。这些设置有助于让对话更自然,并可根据使用场景自定义。
这些设置也适用于使用 Realtime 模型 的智能体。
最长对话时长
最长对话时长设置用于限制对话保持活跃状态的总时长。 该全局限制从对话开始时计时,且独立于单轮超时。 默认值为 600 秒(10 分钟)。可设置为 60 至 7,200 秒。
配置
在 CLI 和 API 中,使用
conversation_config.conversation.max_duration_seconds 字段配置此设置。
通过控制台更新
通过 CLI 更新
通过 API 更新
在控制台中打开智能体,前往 高级 标签页,然后在 通话限制 下调整 **最长对话 时长 **。保存更改。
WhatsApp 消息对话默认有 15 分钟非活动超时,从智能体最近一次回复开始计算。该超时可能会在达到配置的 最长时长前结束消息对话。若企业版客户的使用场景需要不同的超时时间,请通过 support@elevenlabs.io 联系支持团队。
静默后接管轮次
静默后接管轮次设置决定在用户沉默多久后,助手会接管下一轮并提示用户回复。
配置
该值以秒为单位,必须介于 1 至 30 秒。在 CLI 和 API 中,使用 conversation_config.turn.turn_timeout 字段配置此设置。
通过控制台更新
通过 CLI 更新
通过 API 更新
在控制台中打开智能体,前往 高级 标签页,然后调整 静默后接管轮次 值。保存更改。
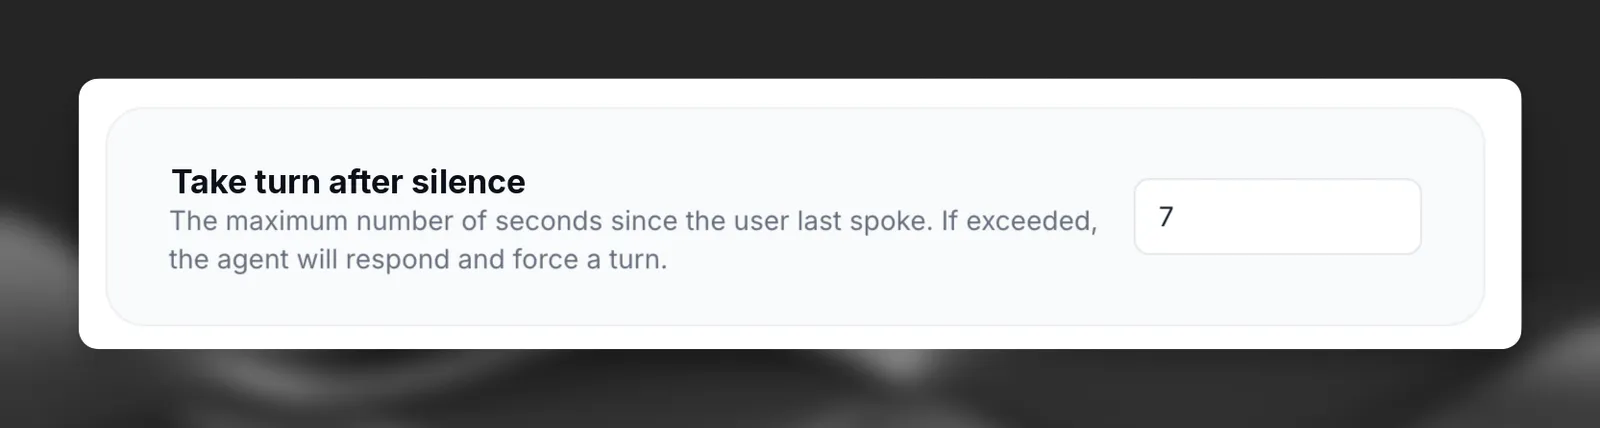
请根据使用场景选择合适的超时时长。较短的超时可让对话响应更快,但可能会打断需要更多时间回复的用户,导致对话不够自然。
最佳实践
- 对需要快速往返交流的日常对话,设置较短的超时(5–10 秒)
- 当用户可能需要更多时间思考或组织复杂回复时,使用较长的超时(10–30 秒)
- 考虑用户场景:客户服务可能适合较短超时,而技术支持可能需要较长超时
软超时
当 LLM 生成回复所需时间超过预期时,软超时会立即提供音频反馈。等待期间,智能体不会陷入尴尬的沉默,而是会说出简短的填充语,例如“嗯……”或“让我想想……”,以保持自然的对话节奏。
此功能适用于:
- 需要较长 LLM 处理时间的复杂查询
- 处理 LLM 提供商的可变延迟
- 通过自然的思考停顿营造更接近真人的对话
工作原理
- 用户说完后,系统开始生成 LLM 回复
- 根据配置的超时时长启动计时器
- 如果 LLM 回复在超时之前到达,则不会说出填充语
- 如果在 LLM 回复之前达到超时时间:
- 会立即说出配置的填充消息
- 智能体会继续等待实际回复
- 准备就绪后,智能体会说出完整的 LLM 回复
软超时每轮仅触发一次,以避免连续出现多个填充语。
配置
通过控制台更新
通过 CLI 更新
通过 API 更新
在控制台中打开智能体,前往 高级 标签页,然后调整 软超时 设置。保存更改。
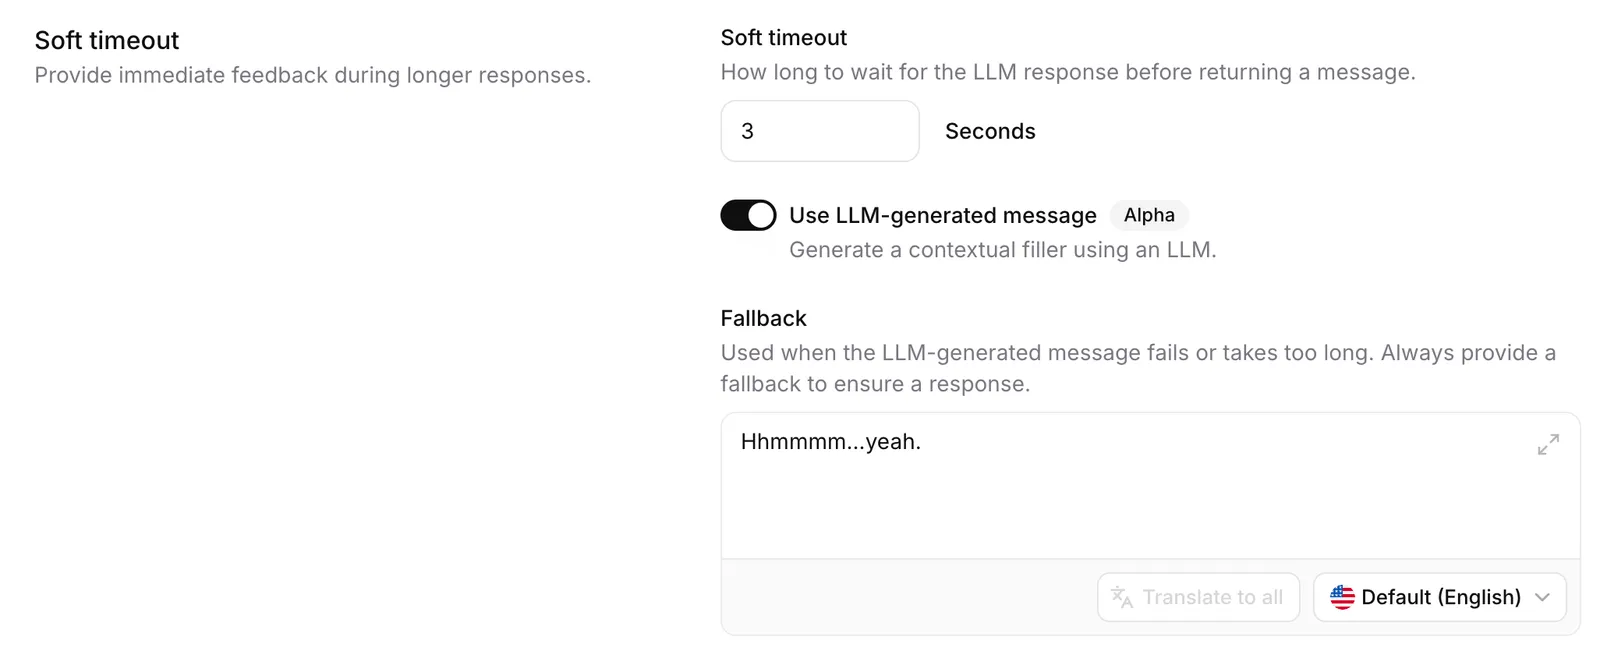
超时时长
等待 LLM 回复期间,说出填充消息前的秒数。
建议从 3.0 秒开始:既能避免在快速回复时不必要地使用填充语,也足以防止尴尬的沉默。
静态消息
软超时触发时说出的预设填充语。
此消息支持:
- 语言覆盖:自动翻译为为智能体配置的其他语言
- 客户端覆盖:可通过 SDK 按每次通话自定义
LLM 生成的消息
启用后,会使用轻量级 LLM 动态生成符合上下文的填充语,而非使用静态消息。
系统会使用最近的对话上下文(最多 4 条消息、1000 个字符)生成相关填充语,例如“嗯……”“我明白了……”“了解……”“知道了……”或“好的……”。
最佳实践
- 避免在填充消息中使用时间提示(例如“稍等一下……”),因为实际回复时间不可预测
- 对回复始终很快的 FAQ 机器人,建议禁用软超时
打断
打断处理决定用户能否在助手说话时打断它。
配置
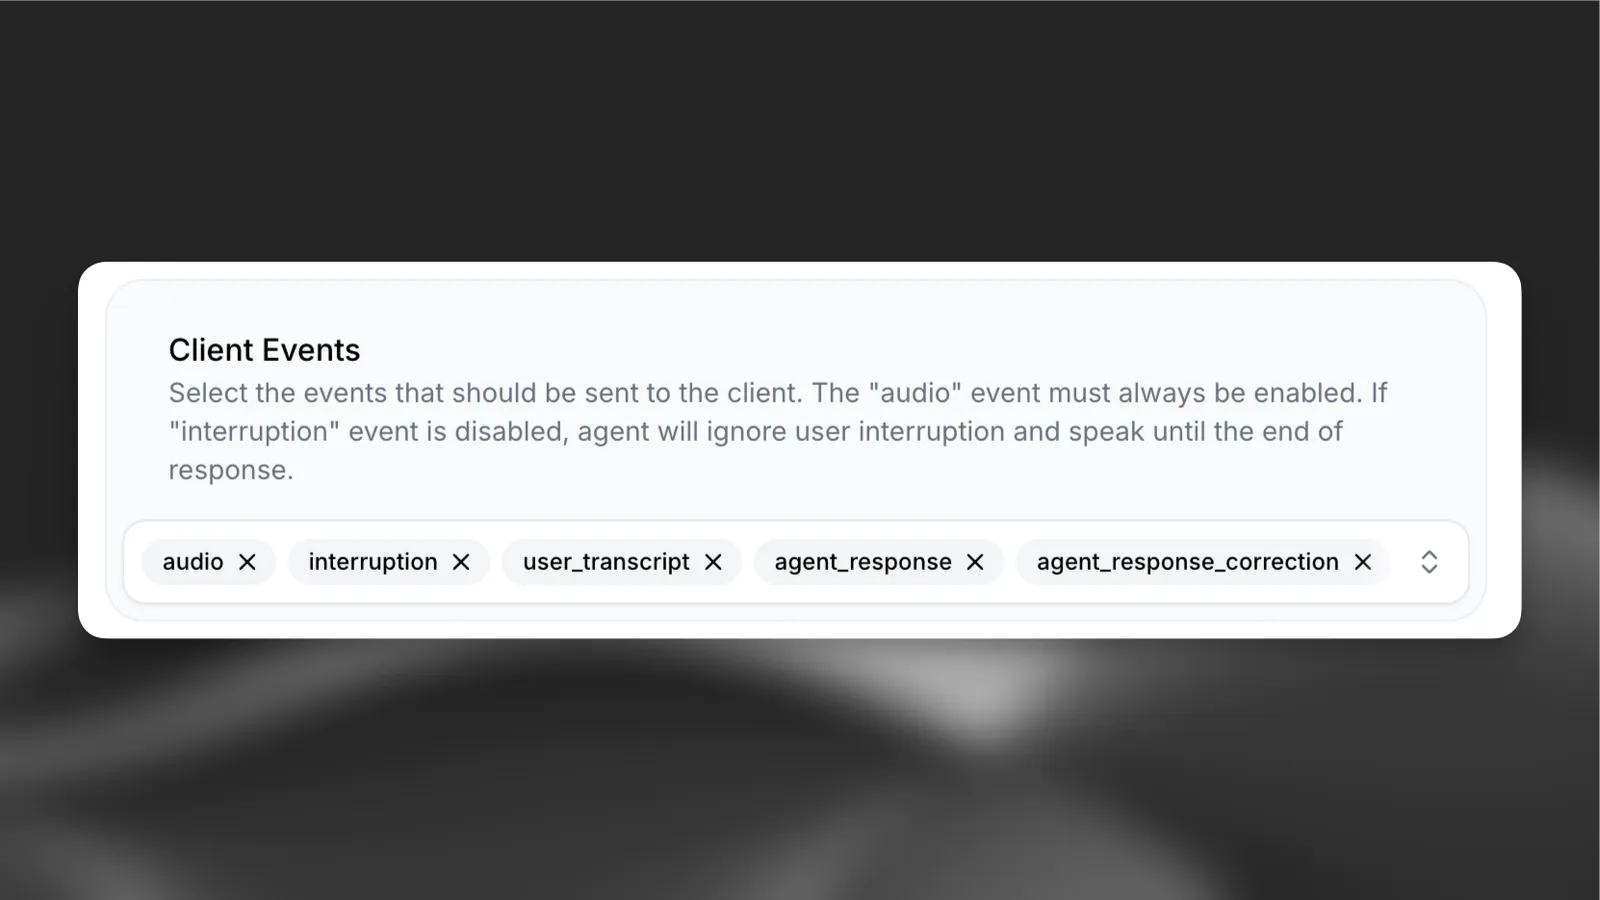
可在智能体 高级 标签页的 客户端事件 下配置打断设置。
要启用打断,请确保已将打断选为客户端事件。
已启用打断
已禁用打断
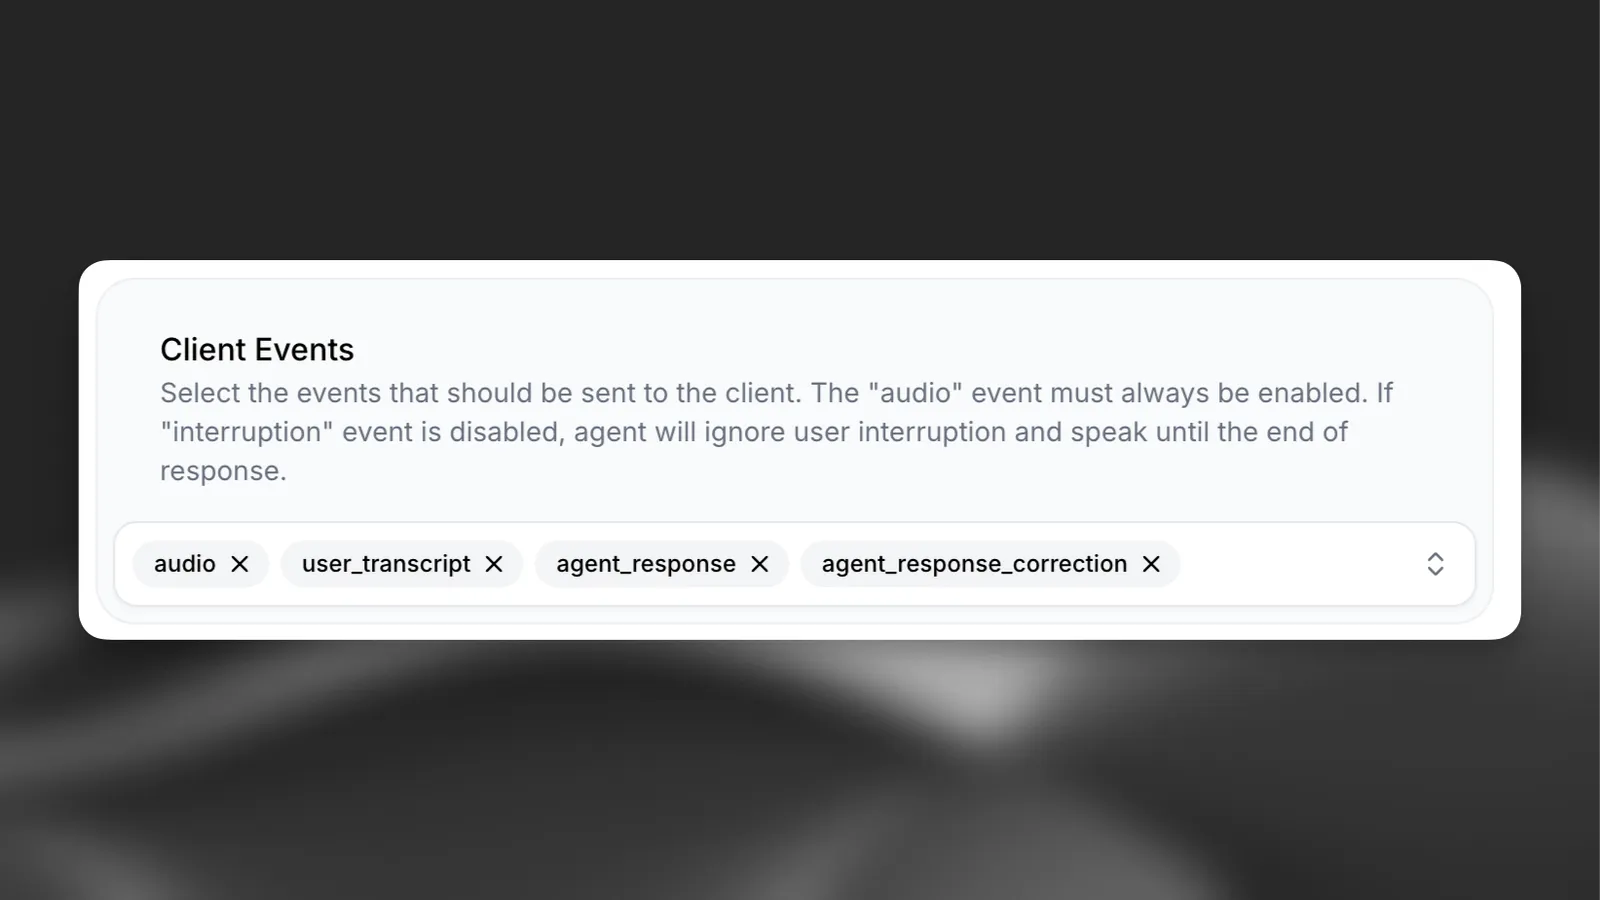
当完整传达信息至关重要时,例如法律免责声明或安全说明,请禁用打断。
打断的最佳实践
- 在预期有来回对话的自然对话流程中启用打断
- 当必须完整传达消息时禁用打断(例如条款与条件、安全信息)
- 考虑使用场景:客户服务可能适合启用打断,而信息传达则未必适合
轮次积极度
轮次积极度控制助手在对话中响应用户输入的速度。此设置决定助手会多积极地根据检测到的语音模式接管轮次并开始说话。
工作原理
助手现在包含两项关键改进,可实现更自然的轮次切换:
-
更快生成回复:助手从语言模型接收到足够的词语和一个逗号后便会开始说话,而不是等待完整句子。这能降低延迟,使对话响应更快,尤其是在助手回复较长时。
-
可配置的轮次积极度:控制助手将停顿或语音模式判断为回复时机的速度。
配置
提供 3 种模式:
- 积极:助手会快速响应用户输入,在最早的机会介入。适合重视即时响应的快节奏对话。
- 普通:平衡的轮次切换,适合大多数对话场景。助手会等待自然的对话停顿后再回复。
- 耐心:助手会等待更久再接管轮次,给用户更多时间表达想法。适合收集详细信息,或用户需要时间组织回复的场景。
通过控制台更新
通过 CLI 更新
通过 API 更新
在控制台中打开智能体,前往 智能体 设置,然后选择所需的轮次积极度模式。保存更改。
将轮次积极度与 workflow 结合使用时尤其强大。你可以根据上下文动态调整助手的响应速度:在日常对话中让它更快介入,或在收集电话号码、邮箱地址等敏感信息时等待更久。
轮次积极度最佳实践
- 在需要快速响应以改善用户体验的客户服务场景中,使用 积极 模式
- 收集电话号码、地址或邮箱地址等结构化信息时,使用 耐心 模式
- 将 普通 模式作为通用对话流程的默认设置
- 与 workflow 结合,根据对话上下文动态调整轮次积极度
- 针对具体使用场景测试不同设置,找到最佳平衡
嘈杂环境检测
启用 嘈杂环境检测 后,智能体会监听用户背景中其他人的说话声。 如果听到其他人说话,它会播放一条固定消息,请用户移至更安静的地方。
背景人声是造成转写错误和误触发打断的主要原因。 语音识别会将其转写为用户所说的内容,还可能导致智能体在回复中途停止。 让用户移至更安静的地方,能改善后续对话的转写和轮次切换效果。 此设置最适合用户经常在商店、家庭等嘈杂场所来电的智能体。
工作原理
模型会在整个对话过程中分析用户音频,当检测到除用户外的第二个声音时触发。 它仅检测人声:交通或动物等其他背景噪声不会触发。
检测触发时:
- 如果智能体正在说话,当前回复会停止。若回复已禁用打断,则会先播放完毕。
- 智能体会播放该消息。用户无法打断它,因为触发该消息的背景人声可能会使消息提前中断。
- 每次对话最多播放一次该消息。
这与 高级 > 自动语音识别 下的 过滤背景语音 设置不同,后者会从转写中移除背景语音。 嘈杂环境检测使用的是另一种模型,会分析更长时间段的音频。 它检测背景人声的速度较慢但准确性更高,更适合此用途。
配置
在 CLI 和 API 中,使用 conversation_config.turn.noisy_environment_detection 启用该设置,并使用 conversation_config.turn.noisy_environment_message 设置消息。
通过控制台更新
通过 CLI 更新
通过 API 更新
语言
智能体会以对话当前语言播放消息,包括通过 语言检测 工具切换语言后。
在控制台中,翻译方式与首条消息相同:
- 启用该设置时,会将消息翻译为为智能体配置的每种其他语言。
- 添加语言时,会将消息翻译为该语言。
- 要查看或编辑翻译,请在消息字段的语言下拉菜单中选择该语言。
- 编辑主消息后,点击 全部翻译 更新翻译内容。
CLI 和 API 不会翻译消息。
默认消息为英语,因此请以智能体的默认语言设置 noisy_environment_message,并在 language_presets 中为每种其他语言添加翻译。
示例:法语翻译
嘈杂环境检测最佳实践
- 保持消息简短。用户无法打断它,因此会听完整条消息。
- 在大范围启用前,先使用外呼智能体测试消息。
推荐配置
客户服务
- 使用较短超时(5–10 秒)以实现快速交互 - 启用打断,让客户可以插话提问 - 使用 积极 轮次积极度,实现快速响应的对话
信息收集
- 使用适中超时(10–15 秒),让用户有时间收集信息 - 启用打断,保持自然对话流程 - 收集电话号码、地址或邮箱地址时,使用 耐心 轮次积极度
法律免责声明
- 使用较长超时(15–30 秒),以便处理复杂回复 - 禁用打断,确保完整传达法律信息 - 使用 普通 轮次积极度,保持稳定节奏
对话式教育科技
- 使用较长超时(10–30 秒),让用户有时间思考和组织回复 - 启用打断,让学生可以插话提问 - 使用 耐心 轮次积极度,给学生充足的回复时间