跳到导航

集成自己的模型

将智能体连接到自己的 LLM,或自行托管服务器。

自定义 LLM 可通过外部端点将对话连接到自己的 LLM。 ElevenLabs 也支持原生集成的 LLM

自定义 LLM让你可以使用自己的 OpenAI API 密钥,或运行完全自定义的 LLM 服务器。

自定义 LLM 无法与 Realtime 模型搭配使用。

概述

默认情况下,我们会为 OpenAI 等热门模型使用内部凭据。要使用自定义 LLM 服务器,其请求和响应结构必须符合以下任一 OpenAI 兼容格式:

Responses API 是 OpenAI 较新的 API 格式,支持更多功能。这两种 API 格式都完全支持自定义 LLM 集成。

以下指南涵盖两种使用方式:

  1. 使用自己的 OpenAI 密钥:在平台中使用自己的 OpenAI API 密钥。
  2. 自定义 LLM 服务器:托管并连接自己的 LLM 服务器实现。

你将了解如何:

  • 在 ElevenLabs 中存储 OpenAI API 密钥
  • 托管一个复刻 OpenAI Chat Completions 或 Responses端点的服务器
  • 让 ElevenLabs 指向自定义端点
  • 按需向 LLM 传递额外参数

推理摘要

端点必须将推理内容与最终答案分开返回。ElevenLabs 不会根据最终答案生成推理内容。

要从支持的端点请求推理,请在智能体的 LLM 设置中开启 推理摘要,或通过 API 设置 enable_reasoning_summary。

返回推理内容

请使用与端点匹配的格式:

在每个响应增量的 reasoning 或 reasoning_content 字段中流式传输推理内容。

对于兼容 Gemini 的端点,ElevenLabs 通过 google.thinking_config.include_thoughts 请求思考内容,并读取标记为 extra_content.google.thought 的内容。

有关存储、传递方式和限制,请参阅推理摘要。

使用自己的 OpenAI 密钥

要集成自定义 OpenAI 密钥,请在 ElevenLabs 控制台中更新智能体设置,使其指向自定义 LLM 服务器,并创建一个包含 OPENAI_API_KEY 的密钥:
1

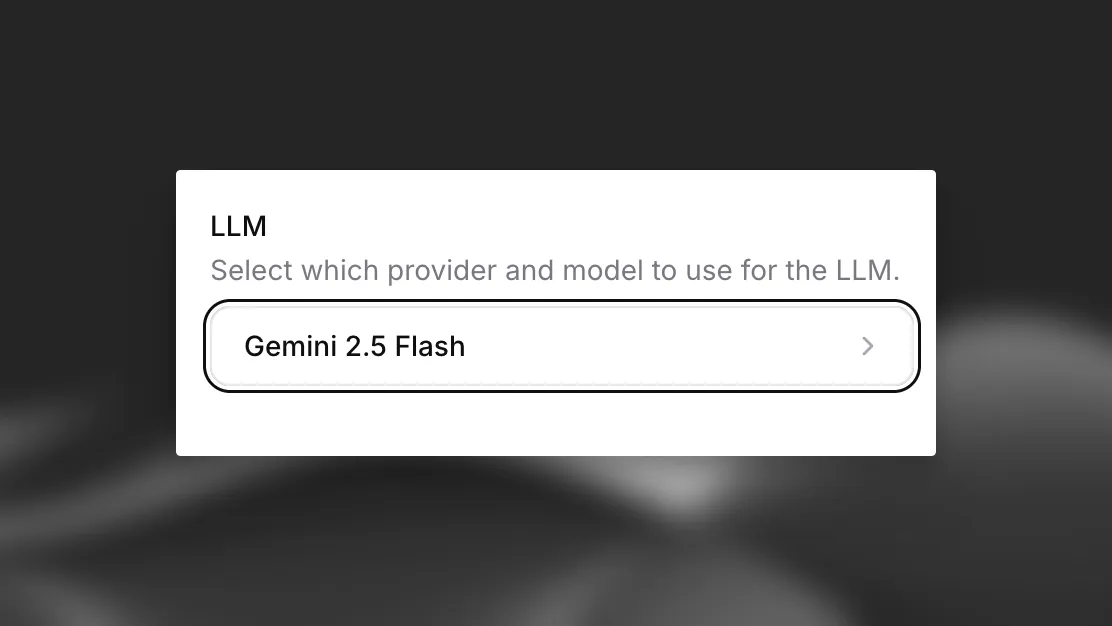
在 ElevenLabs 控制台的智能体设置中,从右侧“LLM”下拉菜单选择“Custom LLM”。

添加密钥

2

点击“LLM”下方的字段,向下滚动并选择“Custom LLM”。

3

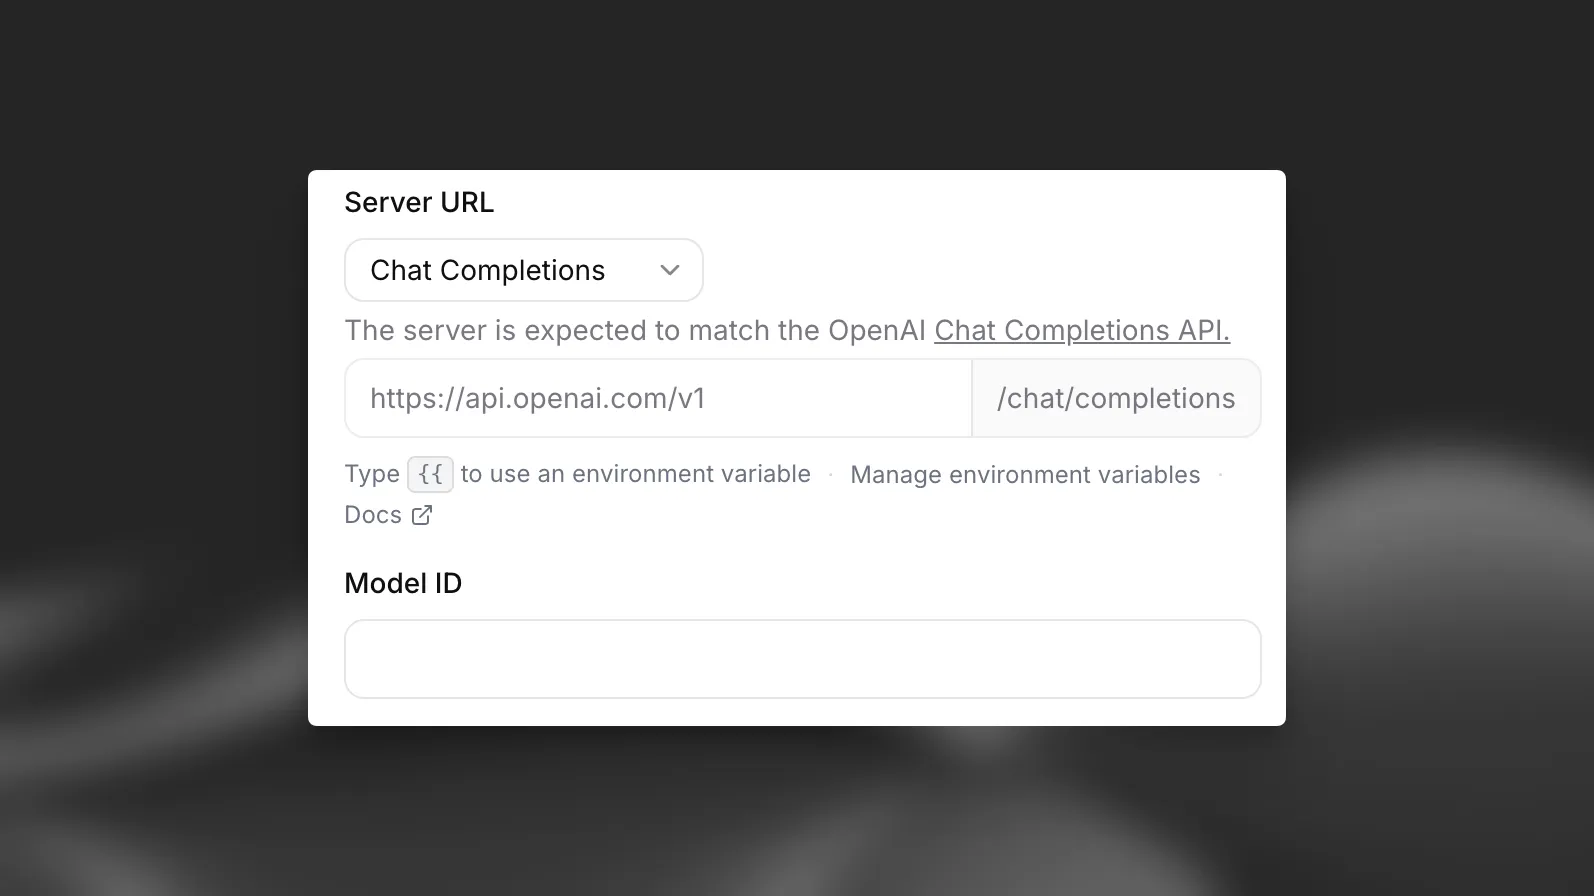
输入自定义 LLM 服务器的服务器 URL 和模型 ID。

输入 URL

4

点击“API key”下方的下拉菜单,选择“Create new secret”。将密钥命名为 OPENAI_API_KEY,在“value”字段中添加密钥,然后点击“Add secret”。

5

点击“x”按钮关闭 LLM 弹窗,然后点击“Publish”保存更改。

自定义 LLM 服务器

要接入自定义 LLM 服务器,请使用 OpenAI 风格设置兼容的服务器端点。你可以实现 Chat Completions API(/v1/chat/completions)或 Responses API(/v1/responses)。

两个端点都必须以 SSE(服务器发送事件)格式返回响应,并使用 Content-Type: text/event-stream。

Chat Completions API 使用 /v1/chat/completions 端点。

每个块必须采用 data: {json}\n\n 格式,且流必须以 data: [DONE]\n\n 结束。

以下是服务器实现示例:

import json
import os
import fastapi
from fastapi.responses import StreamingResponse
from openai import AsyncOpenAI
import uvicorn
import logging
from dotenv import load_dotenv
from pydantic import BaseModel
from typing import List, Optional
# Load environment variables from .env file
load_dotenv()
# Retrieve API key from environment
OPENAI_API_KEY = os.getenv('OPENAI_API_KEY')
if not OPENAI_API_KEY:
raise ValueError("OPENAI_API_KEY not found in environment variables")
app = fastapi.FastAPI()
oai_client = AsyncOpenAI(api_key=OPENAI_API_KEY)
class Message(BaseModel):
role: str
content: str
class ChatCompletionRequest(BaseModel):
messages: List[Message]
model: str
temperature: Optional[float] = 0.7
max_tokens: Optional[int] = None
stream: Optional[bool] = False
user_id: Optional[str] = None
@app.post("/v1/chat/completions")
async def create_chat_completion(request: ChatCompletionRequest) -> StreamingResponse:
oai_request = request.dict(exclude_none=True)
if "user_id" in oai_request:
oai_request["user"] = oai_request.pop("user_id")
chat_completion_coroutine = await oai_client.chat.completions.create(**oai_request)
async def event_stream():
try:
async for chunk in chat_completion_coroutine:
# Convert the ChatCompletionChunk to a dictionary before JSON serialization
chunk_dict = chunk.model_dump()
yield f"data: {json.dumps(chunk_dict)}\n\n"
yield "data: [DONE]\n\n"
except Exception as e:
logging.error("An error occurred: %s", str(e))
yield f"data: {json.dumps({'error': 'Internal error occurred!'})}\n\n"
return StreamingResponse(event_stream(), media_type="text/event-stream")
if __name__ == "__main__":
uvicorn.run(app, host="0.0.0.0", port=8013)

运行此代码或自己的服务器代码。

为服务器设置公共 URL

要让服务器可访问,请使用 ngrok 等隧道工具创建公共 URL:
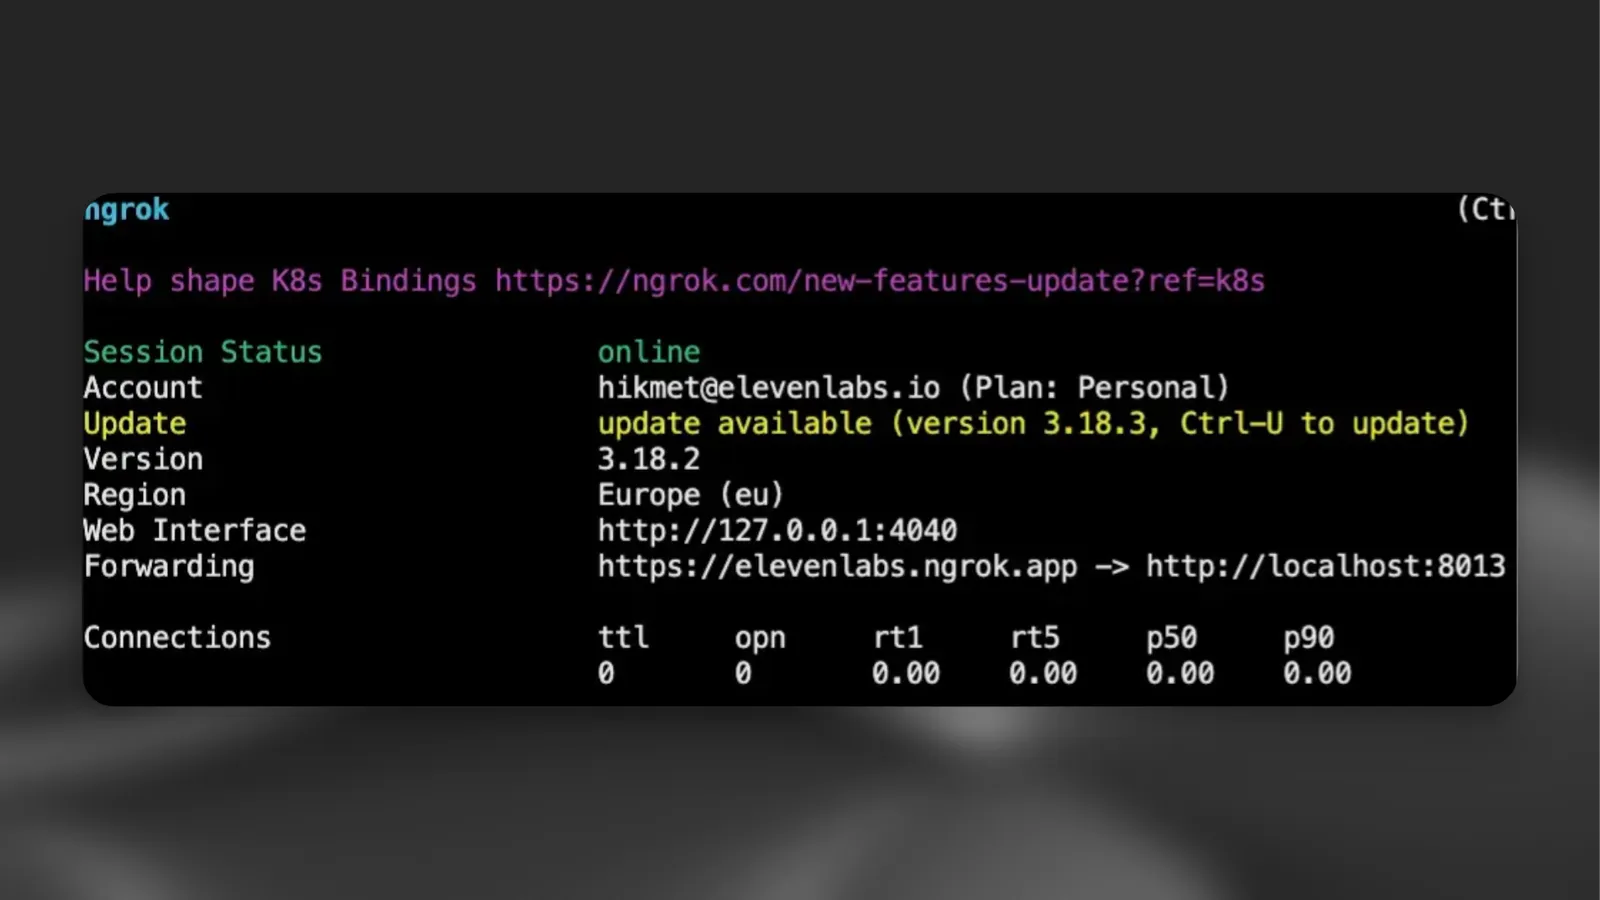
ngrok http --url=<Your url>.ngrok.app 8013

配置 ElevenLabs CustomLLM

接下来,在 ElevenLabs 控制台中更新智能体设置,使其指向自定义 LLM 服务器。
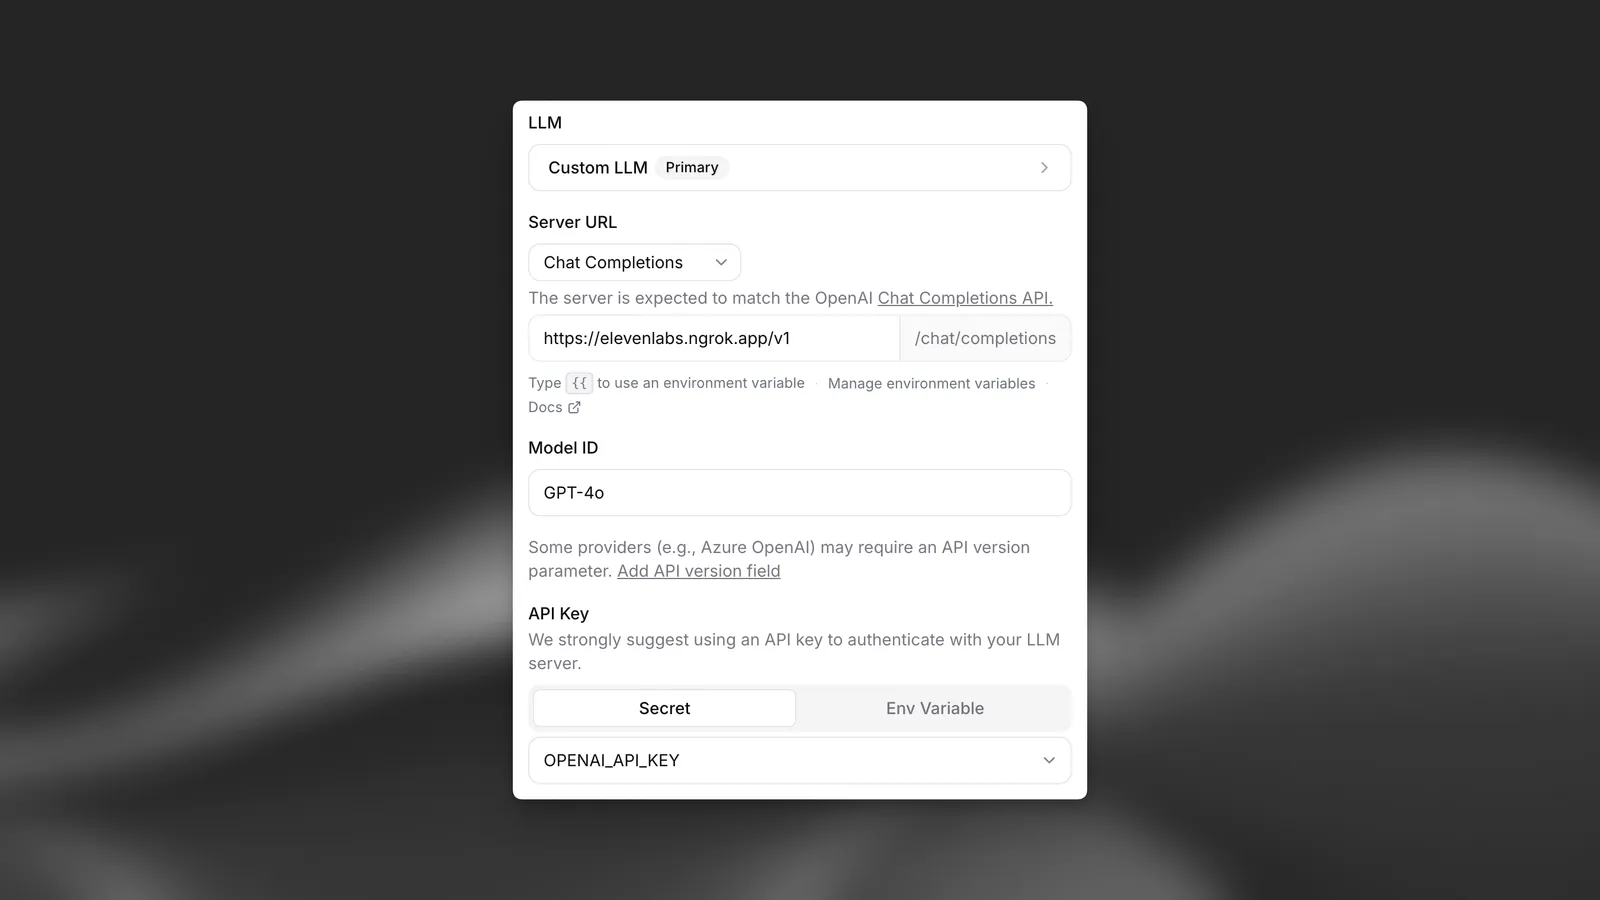
将服务器 URL 指向 ngrok 端点,并将“Limit token usage”设为 5000。

现在可以使用自己的 LLM 服务器开始与智能体互动。

针对处理较慢的 LLM 进行优化

如果自定义 LLM 处理时间较长(可能是因为智能体推理或预处理需求),可以在流式响应中加入 缓冲词,改善对话流畅度。该技术可让 LLM 生成完整回复时,语音仍保持自然韵律。

缓冲词

当 LLM 需要更多时间处理完整回复时,请返回一个以 "... "(省略号后加空格)结尾的初始响应。这样,文本转语音系统便能保持自然流畅,对话也更具动态感。 这会形成自然的停顿,并顺畅衔接 LLM 可进一步推理的后续内容。额外的空格至关重要,可避免后续内容直接附加到 "..." 后,从而导致音频失真。

实现方式

以下展示如何修改自定义 LLM 服务器以实现缓冲词:

@app.post("/v1/chat/completions")
async def create_chat_completion(request: ChatCompletionRequest) -> StreamingResponse:
oai_request = request.dict(exclude_none=True)
if "user_id" in oai_request:
oai_request["user"] = oai_request.pop("user_id")
async def event_stream():
try:
# Send initial buffer chunk while processing
initial_chunk = {
"id": "chatcmpl-buffer",
"object": "chat.completion.chunk",
"created": 1234567890,
"model": request.model,
"choices": [{
"delta": {"content": "Let me think about that... "},
"index": 0,
"finish_reason": None
}]
}
yield f"data: {json.dumps(initial_chunk)}\n\n"
# Process the actual LLM response
chat_completion_coroutine = await oai_client.chat.completions.create(**oai_request)
async for chunk in chat_completion_coroutine:
chunk_dict = chunk.model_dump()
yield f"data: {json.dumps(chunk_dict)}\n\n"
yield "data: [DONE]\n\n"
except Exception as e:
logging.error("An error occurred: %s", str(e))
yield f"data: {json.dumps({'error': 'Internal error occurred!'})}\n\n"
return StreamingResponse(event_stream(), media_type="text/event-stream")

系统工具集成

自定义 LLM 可触发系统工具,以控制对话流程和状态。在智能体中完成配置后,这些工具会自动包含在聊天补全请求的 tools 参数中。

系统工具的工作方式

  1. LLM 决策:自定义 LLM 根据对话上下文决定何时调用这些工具
  2. 工具响应:LLM 以标准 OpenAI 格式返回函数调用
  3. 后端处理:ElevenLabs 处理工具调用并更新对话状态

如需了解系统工具的更多信息,请参阅指南。

可用系统工具

用途:在满足适当条件时自动结束对话。

触发条件:LLM 应在以下情况调用此工具:

  • 主要任务已完成,且用户满意
  • 双方达成一致,对话自然结束
  • 用户明确表示想结束对话

参数:

  • reason(字符串,必填):结束通话的原因
  • message(字符串,选填):结束通话前发送给用户的告别消息

函数调用格式:

{
"type": "function",
"function": {
"name": "end_call",
"arguments": "{\"reason\": \"Task completed successfully\", \"message\": \"Thank you for using our service. Have a great day!\"}"
}
}

实现方式:在智能体设置中配置为系统工具。LLM 将收到有关何时调用此函数的详细说明。

了解更多:结束通话工具

用途:在对话中自动切换至检测到的用户语言。

触发条件:LLM 应在以下情况调用此工具:

  • 用户使用的语言不同于当前对话语言
  • 用户明确请求切换语言
  • 对话需要支持多种语言

参数:

  • reason(字符串,必填):切换语言的原因
  • language(字符串,必填):要切换至的语言代码(必须在支持的语言列表中)

函数调用格式:

{
"type": "function",
"function": {
"name": "language_detection",
"arguments": "{\"reason\": \"User requested Spanish\", \"language\": \"es\"}"
}
}

实现方式:在智能体设置中配置支持的语言并添加语言检测系统工具。智能体会自动切换语音和回复,以匹配检测到的语言。

了解更多:语言检测工具

用途:根据用户需求,在专业 AI 智能体之间转接对话。

触发条件:LLM 应在以下情况调用此工具:

  • 用户请求需要专业知识或不同的智能体能力
  • 当前智能体无法妥善处理该问题
  • 对话流程表明需要其他类型的智能体

参数:

  • reason(字符串,选填):转接智能体的原因
  • agent_number(整数,必填):要转接至的智能体从 0 开始的编号(基于已配置的转接规则)

函数调用格式:

{
"type": "function",
"function": {
"name": "transfer_to_agent",
"arguments": "{\"reason\": \"User needs billing support\", \"agent_number\": 0}"
}
}

实现方式:定义将条件映射到特定智能体 ID 的转接规则。配置当前智能体可转接到哪些智能体。智能体在转接配置中以从 0 开始的编号引用。

了解更多:智能体转接工具

用途:当 AI 协助不足时,无缝将对话转交给人工客服。

触发条件:LLM 应在以下情况调用此工具:

  • 问题复杂,需要人工判断
  • 用户明确请求人工协助
  • AI 的能力无法满足具体请求
  • 触发升级处理流程

参数:

  • reason(字符串,选填):转接原因
  • transfer_number(字符串,必填):要转接至的电话号码(必须与已配置的号码匹配)
  • client_message(字符串,必填):等待转接期间向客户播报的消息
  • agent_message(字符串,必填):发送给接听通话的人工客服的消息

函数调用格式:

{
"type": "function",
"function": {
"name": "transfer_to_number",
"arguments": "{\"reason\": \"Complex billing issue\", \"transfer_number\": \"+15551234567\", \"client_message\": \"I'm transferring you to a billing specialist who can help with your account.\", \"agent_message\": \"Customer has a complex billing dispute about order #12345 from last month.\"}"
}
}

实现方式:配置转接电话号码和条件,并分别定义面向客户和接听通话的人工客服的消息。同时支持 Twilio 和 SIP 中继。

了解更多:转接人工客服工具

用途:允许智能体暂停并等待用户输入,不发出语音。

触发条件:LLM 应在以下情况调用此工具:

  • 用户表示需要一点时间(“等我一下”“让我想想”)
  • 用户请求暂停对话
  • 智能体检测到用户需要时间处理信息

参数:

  • reason(字符串,选填):说明为何需要暂停的自由文本原因

函数调用格式:

{
"type": "function",
"function": {
"name": "skip_turn",
"arguments": "{\"reason\": \"User requested time to think\"}"
}
}

实现方式:无需额外配置。该工具仅会让智能体保持静默,直到用户再次说话。

了解更多:跳过回合工具

参数:

  • reason(字符串,必填):检测到语音信箱的原因(例如,“检测到自动问候语”“无人响应”)

函数调用格式:

{
"type": "function",
"function": {
"name": "voicemail_detection",
"arguments": "{\"reason\": \"Automated greeting detected with request to leave message\"}"
}
}

了解更多:语音信箱检测工具

使用系统工具的请求示例

配置系统工具后,自定义 LLM 将收到包含工具的请求,格式遵循标准 OpenAI 格式:

{
"messages": [
{
"role": "system",
"content": "You are a helpful assistant. You have access to system tools for managing conversations."
},
{
"role": "user",
"content": "I think we're done here, thanks for your help!"
}
],
"model": "your-custom-model",
"temperature": 0.7,
"max_tokens": 1000,
"stream": true,
"tools": [
{
"type": "function",
"function": {
"name": "end_call",
"description": "Call this function to end the current conversation when the main task has been completed...",
"parameters": {
"type": "object",
"properties": {
"reason": {
"type": "string",
"description": "The reason for the tool call."
},
"message": {
"type": "string",
"description": "A farewell message to send to the user along right before ending the call."
}
},
"required": ["reason"]
}
}
},
{
"type": "function",
"function": {
"name": "language_detection",
"description": "Change the conversation language when the user expresses a language preference explicitly...",
"parameters": {
"type": "object",
"properties": {
"reason": {
"type": "string",
"description": "The reason for the tool call."
},
"language": {
"type": "string",
"description": "The language to switch to. Must be one of language codes in tool description."
}
},
"required": ["reason", "language"]
}
}
},
{
"type": "function",
"function": {
"name": "skip_turn",
"description": "Skip a turn when the user explicitly indicates they need a moment to think...",
"parameters": {
"type": "object",
"properties": {
"reason": {
"type": "string",
"description": "Optional free-form reason explaining why the pause is needed."
}
},
"required": []
}
}
}
]
}

自定义 LLM 必须支持函数调用才能使用系统工具。请确保模型能够以 OpenAI 格式生成 正确的函数调用响应。

其他功能

可以向自定义 LLM 实现传递其他参数。

1

定义额外参数

创建一个包含自定义参数的对象:

from elevenlabs.conversational_ai.conversation import Conversation, ConversationInitiationData
extra_body_for_convai = {
"UUID": "123e4567-e89b-12d3-a456-426614174000",
"parameter-1": "value-1",
"parameter-2": "value-2",
}
config = ConversationInitiationData(
extra_body=extra_body_for_convai,
)
2

更新 LLM 实现

修改自定义 LLM 代码以处理额外参数:

import json
import os
import fastapi
from fastapi.responses import StreamingResponse
from fastapi import Request
from openai import AsyncOpenAI
import uvicorn
import logging
from dotenv import load_dotenv
from pydantic import BaseModel
from typing import List, Optional
# Load environment variables from .env file
load_dotenv()
# Retrieve API key from environment
OPENAI_API_KEY = os.getenv('OPENAI_API_KEY')
if not OPENAI_API_KEY:
raise ValueError("OPENAI_API_KEY not found in environment variables")
app = fastapi.FastAPI()
oai_client = AsyncOpenAI(api_key=OPENAI_API_KEY)
class Message(BaseModel):
role: str
content: str
class ChatCompletionRequest(BaseModel):
messages: List[Message]
model: str
temperature: Optional[float] = 0.7
max_tokens: Optional[int] = None
stream: Optional[bool] = False
user_id: Optional[str] = None
elevenlabs_extra_body: Optional[dict] = None
@app.post("/v1/chat/completions")
async def create_chat_completion(request: ChatCompletionRequest) -> StreamingResponse:
oai_request = request.dict(exclude_none=True)
print(oai_request)
if "user_id" in oai_request:
oai_request["user"] = oai_request.pop("user_id")
if "elevenlabs_extra_body" in oai_request:
oai_request.pop("elevenlabs_extra_body")
chat_completion_coroutine = await oai_client.chat.completions.create(**oai_request)
async def event_stream():
try:
async for chunk in chat_completion_coroutine:
chunk_dict = chunk.model_dump()
yield f"data: {json.dumps(chunk_dict)}\n\n"
yield "data: [DONE]\n\n"
except Exception as e:
logging.error("An error occurred: %s", str(e))
yield f"data: {json.dumps({'error': 'Internal error occurred!'})}\n\n"
return StreamingResponse(event_stream(), media_type="text/event-stream")
if __name__ == "__main__":
uvicorn.run(app, host="0.0.0.0", port=8013)

请求示例

使用此自定义消息设置后,LLM 将收到以下格式的请求:

{
"messages": [
{
"role": "system",
"content": "\n <Redacted>"
},
{
"role": "assistant",
"content": "Hey I'm currently unavailable."
},
{
"role": "user",
"content": "Hey, who are you?"
}
],
"model": "gpt-4o",
"temperature": 0.5,
"max_tokens": 5000,
"stream": true,
"elevenlabs_extra_body": {
"UUID": "123e4567-e89b-12d3-a456-426614174000",
"parameter-1": "value-1",
"parameter-2": "value-2"
}
}