

智能体测试
智能体测试
通过自动化测试,增强对智能体行为的信心
智能体测试可在部署前验证对话回复、工具使用情况和完整的多轮对话结果。你可以从头创建测试,也可以基于现有对话创建,然后通过控制台、CLI 或 API 运行。
视频演示
概览
该框架包含 3 种互补的测试类型:
- 模拟测试 — 使用模拟用户运行端到端的多轮对话
- 下一条回复(场景)测试 — 根据成功标准验证智能体的下一条回复
- 工具调用测试 — 确保智能体使用正确参数调用正确工具
如何选择测试类型
从对话创建测试
当发现智能体表现不佳的交互时,可将真实对话转为测试用例。
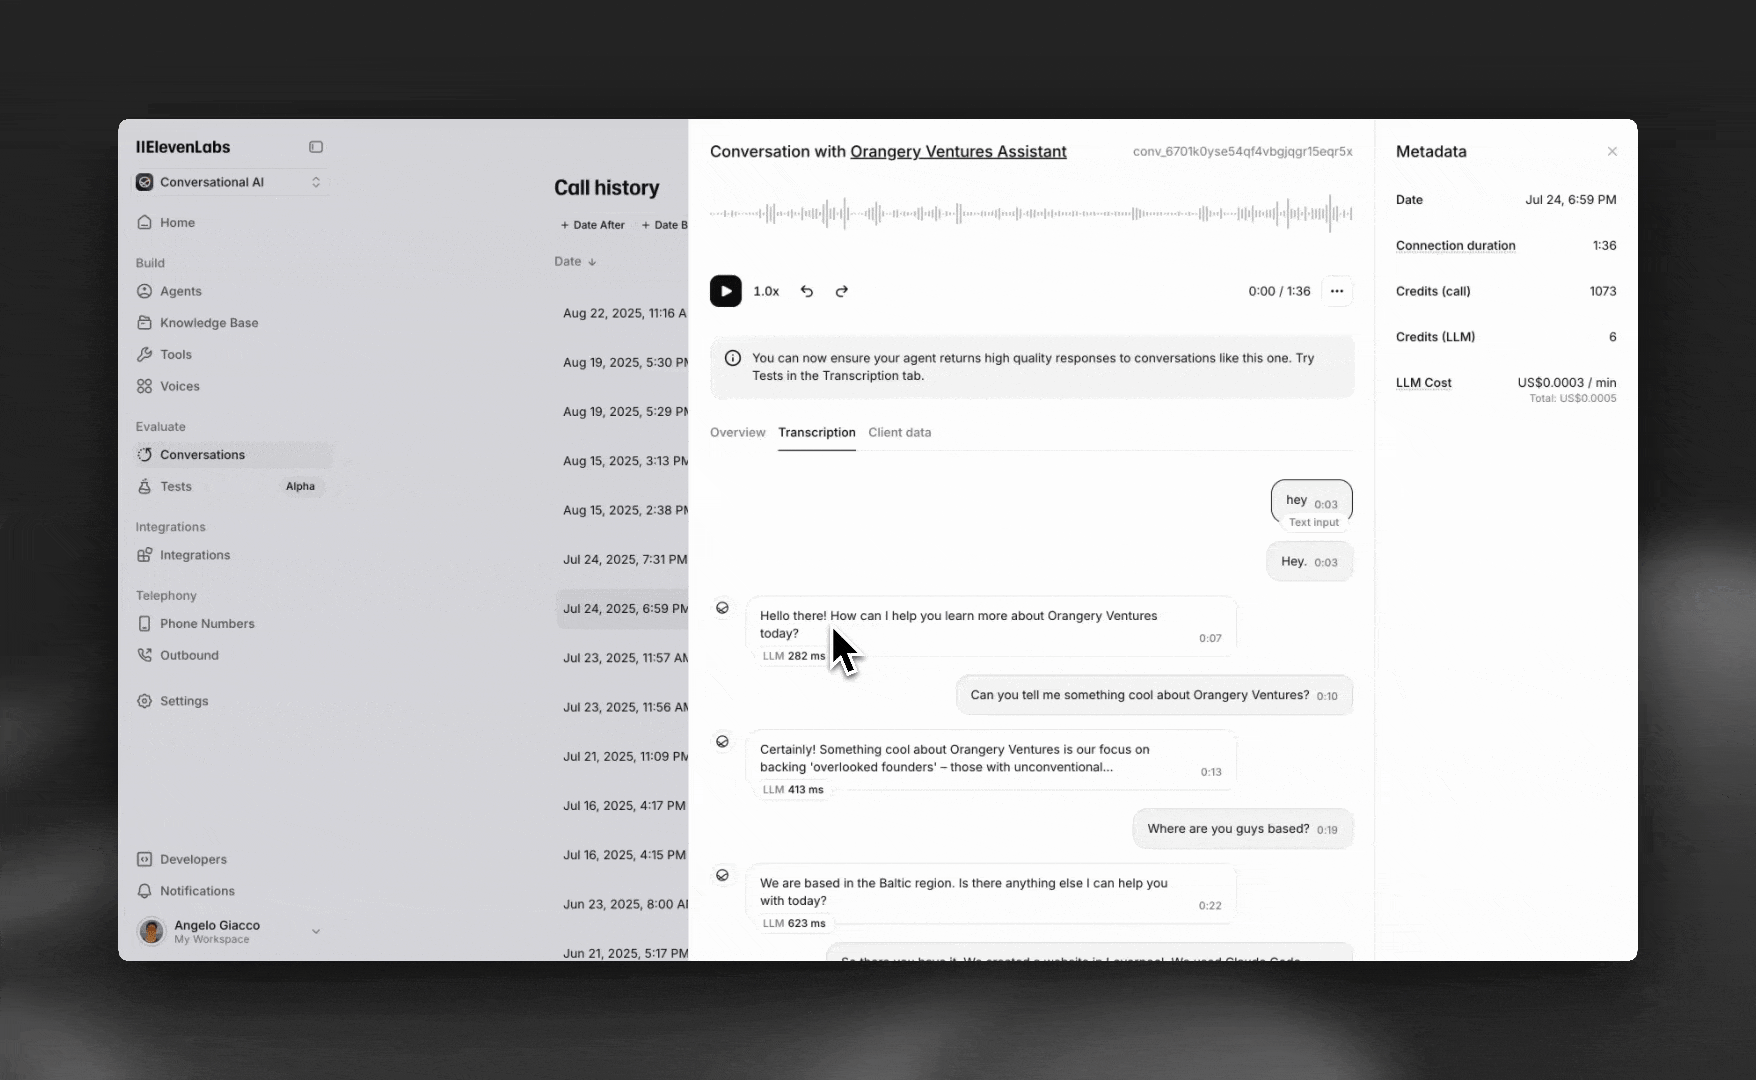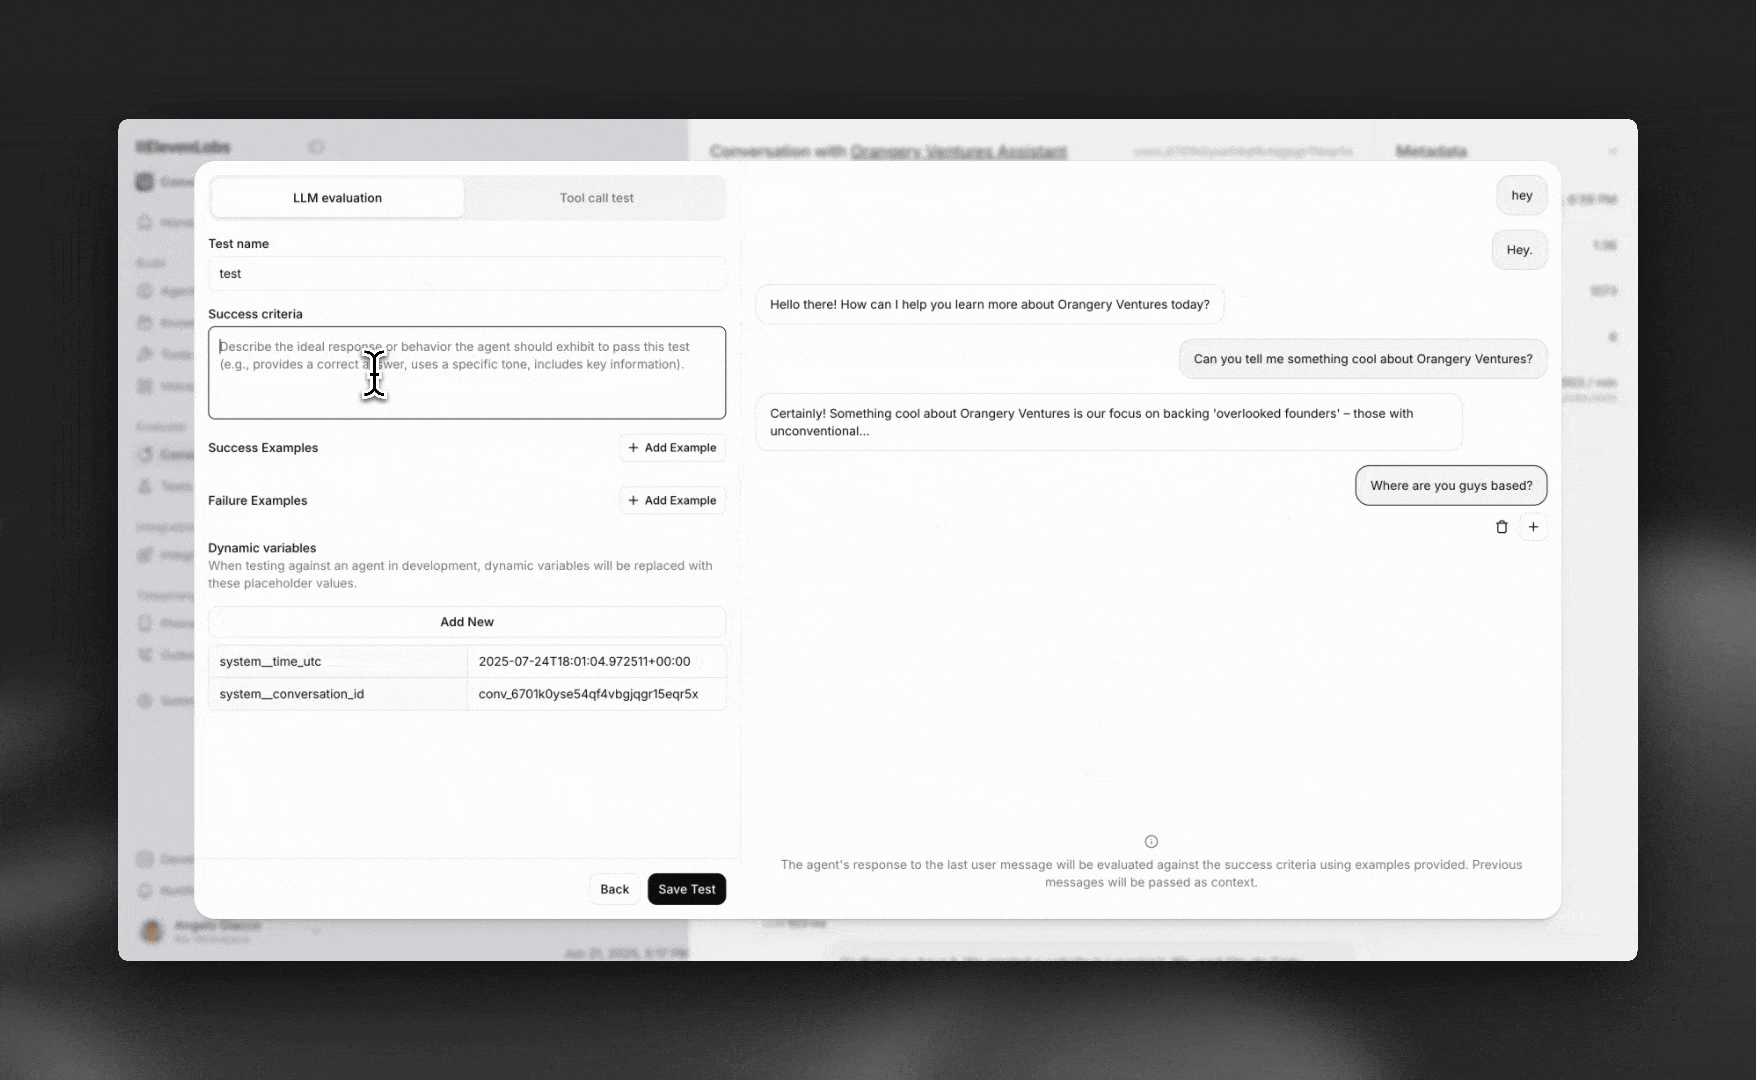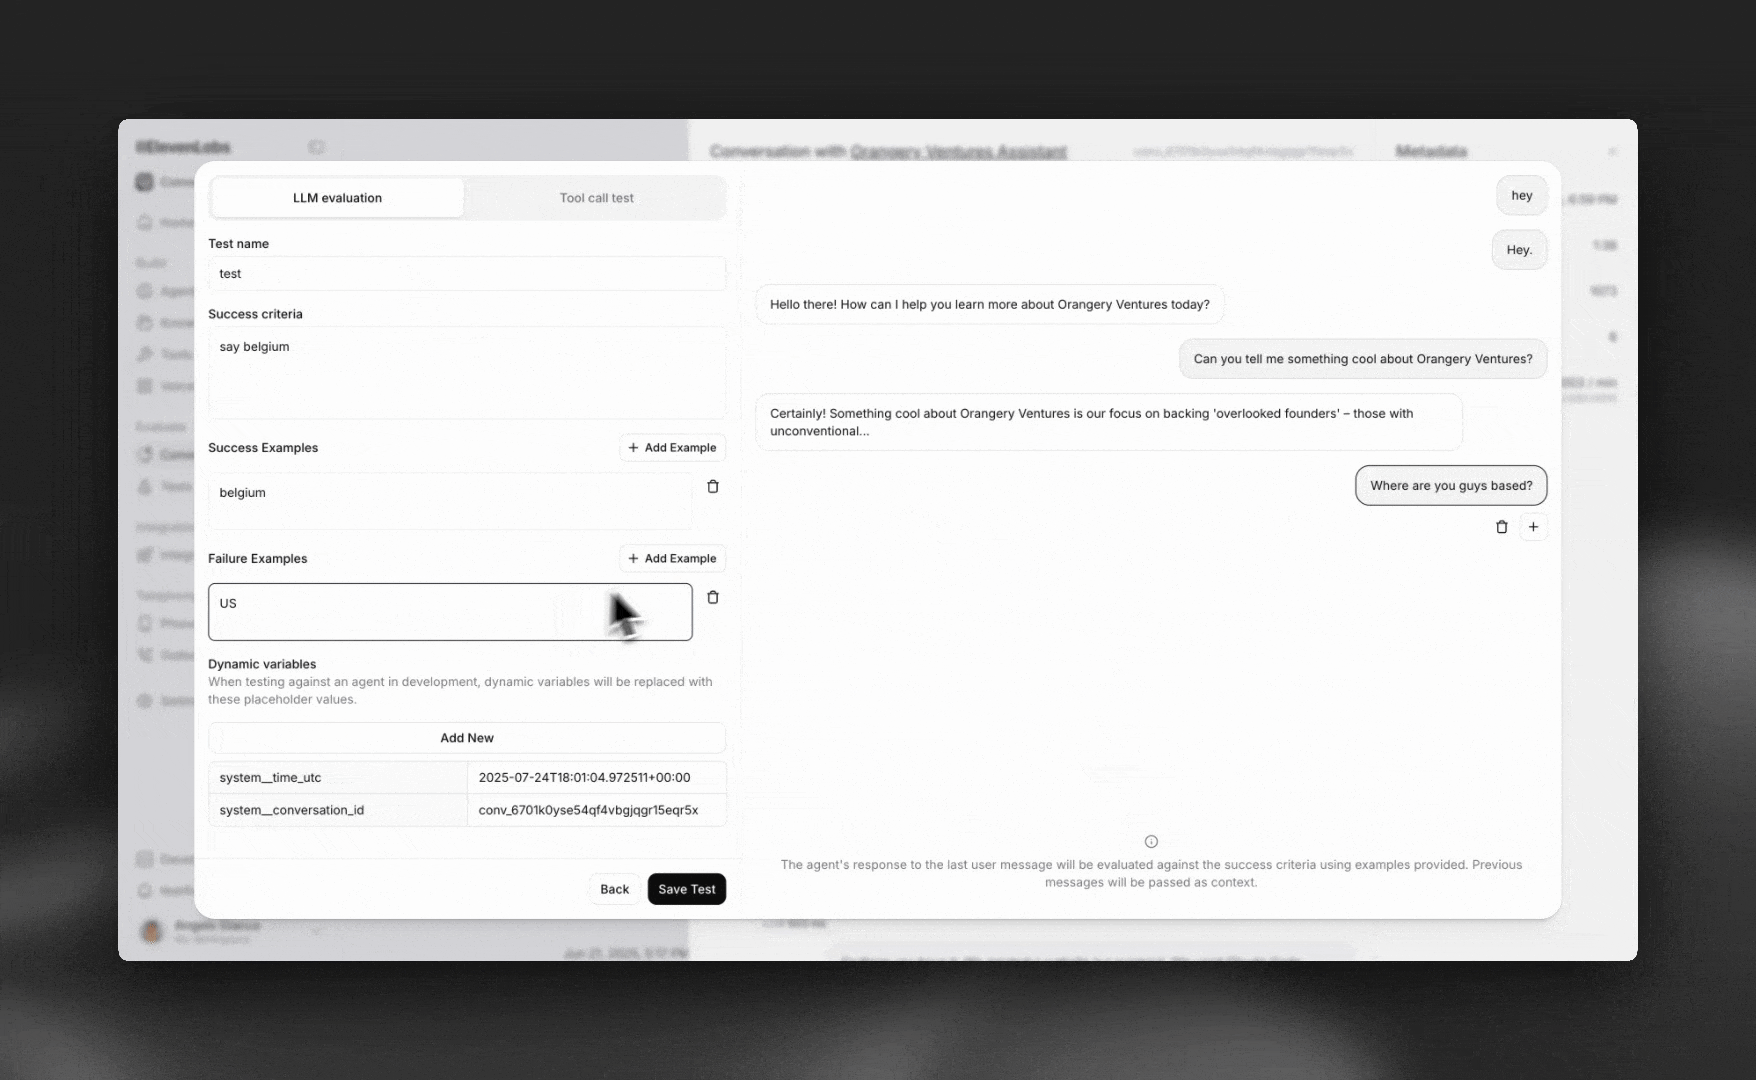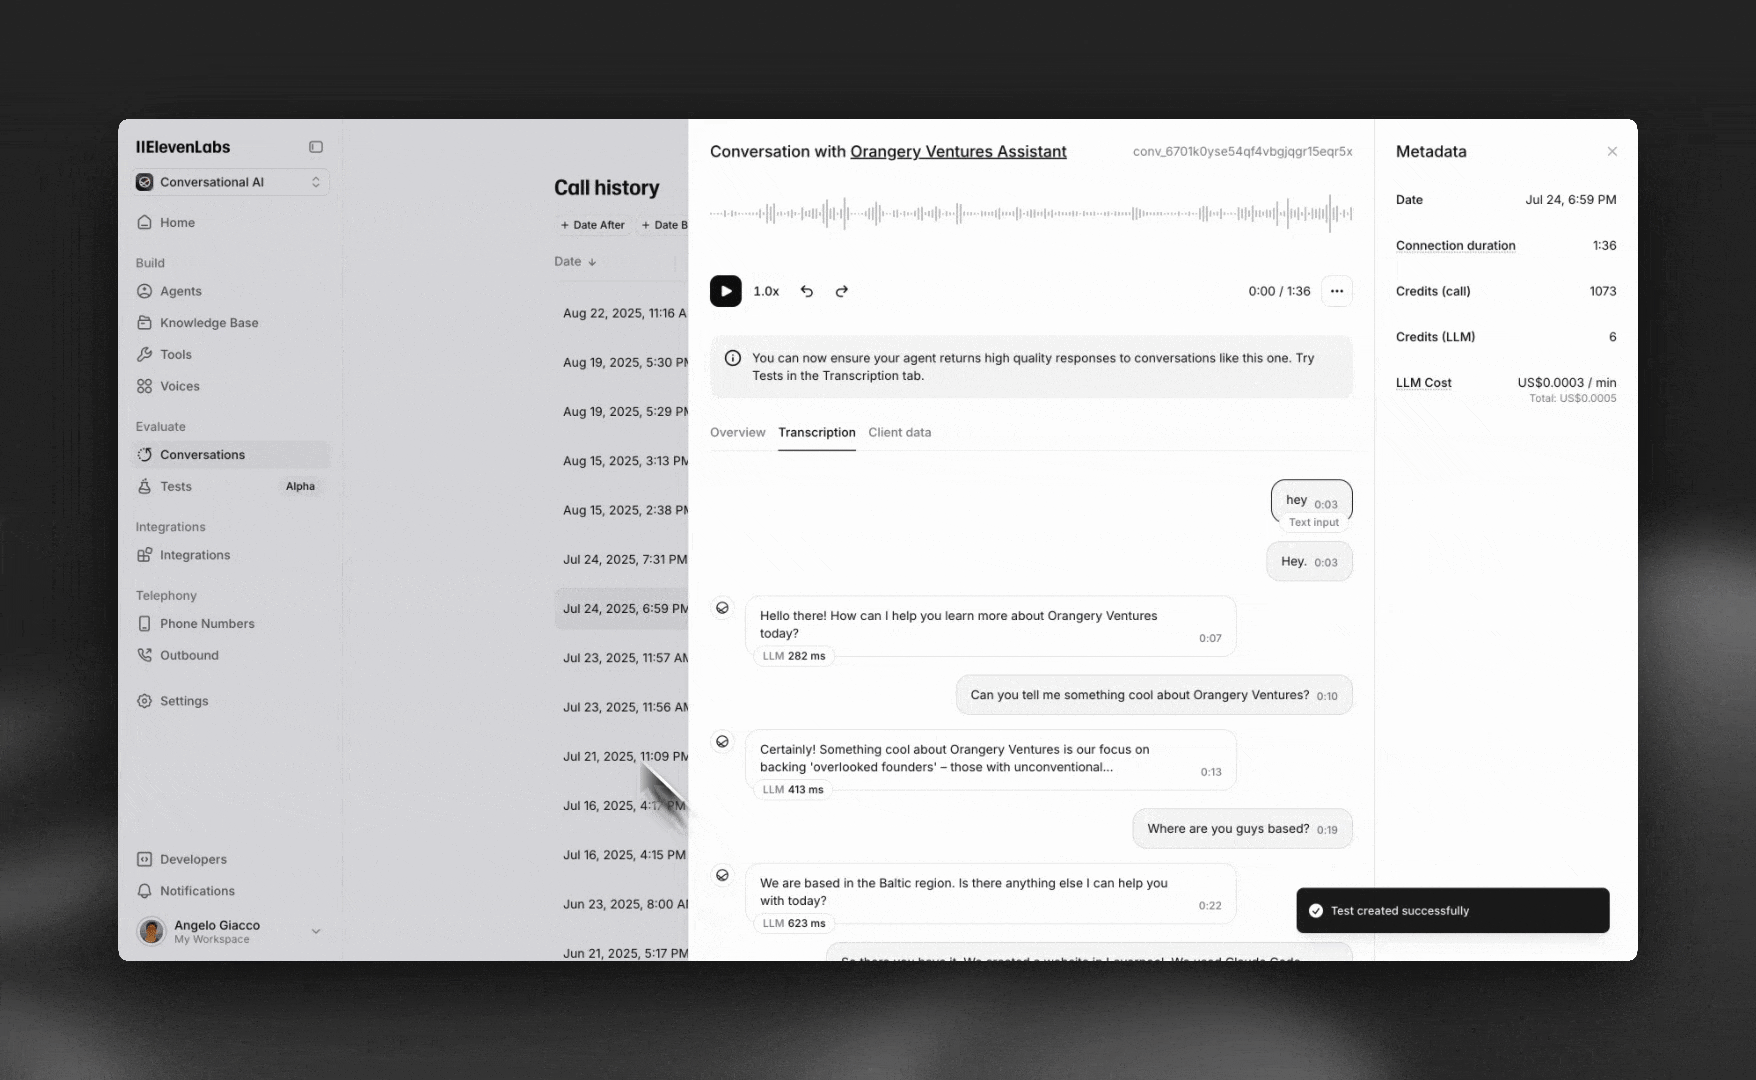
- 在通话记录中打开对话
- 点击 根据此对话创建测试
- 查看预填的上下文,然后定义预期行为
- 将测试添加到测试套件,以便之后捕获类似失败情况
模拟测试
模拟测试通过模拟 AI 用户,评估智能体在完整多轮对话中的表现。与下一条回复测试不同,此类测试会检查整个交互是否达到了预设结果。
创建模拟测试
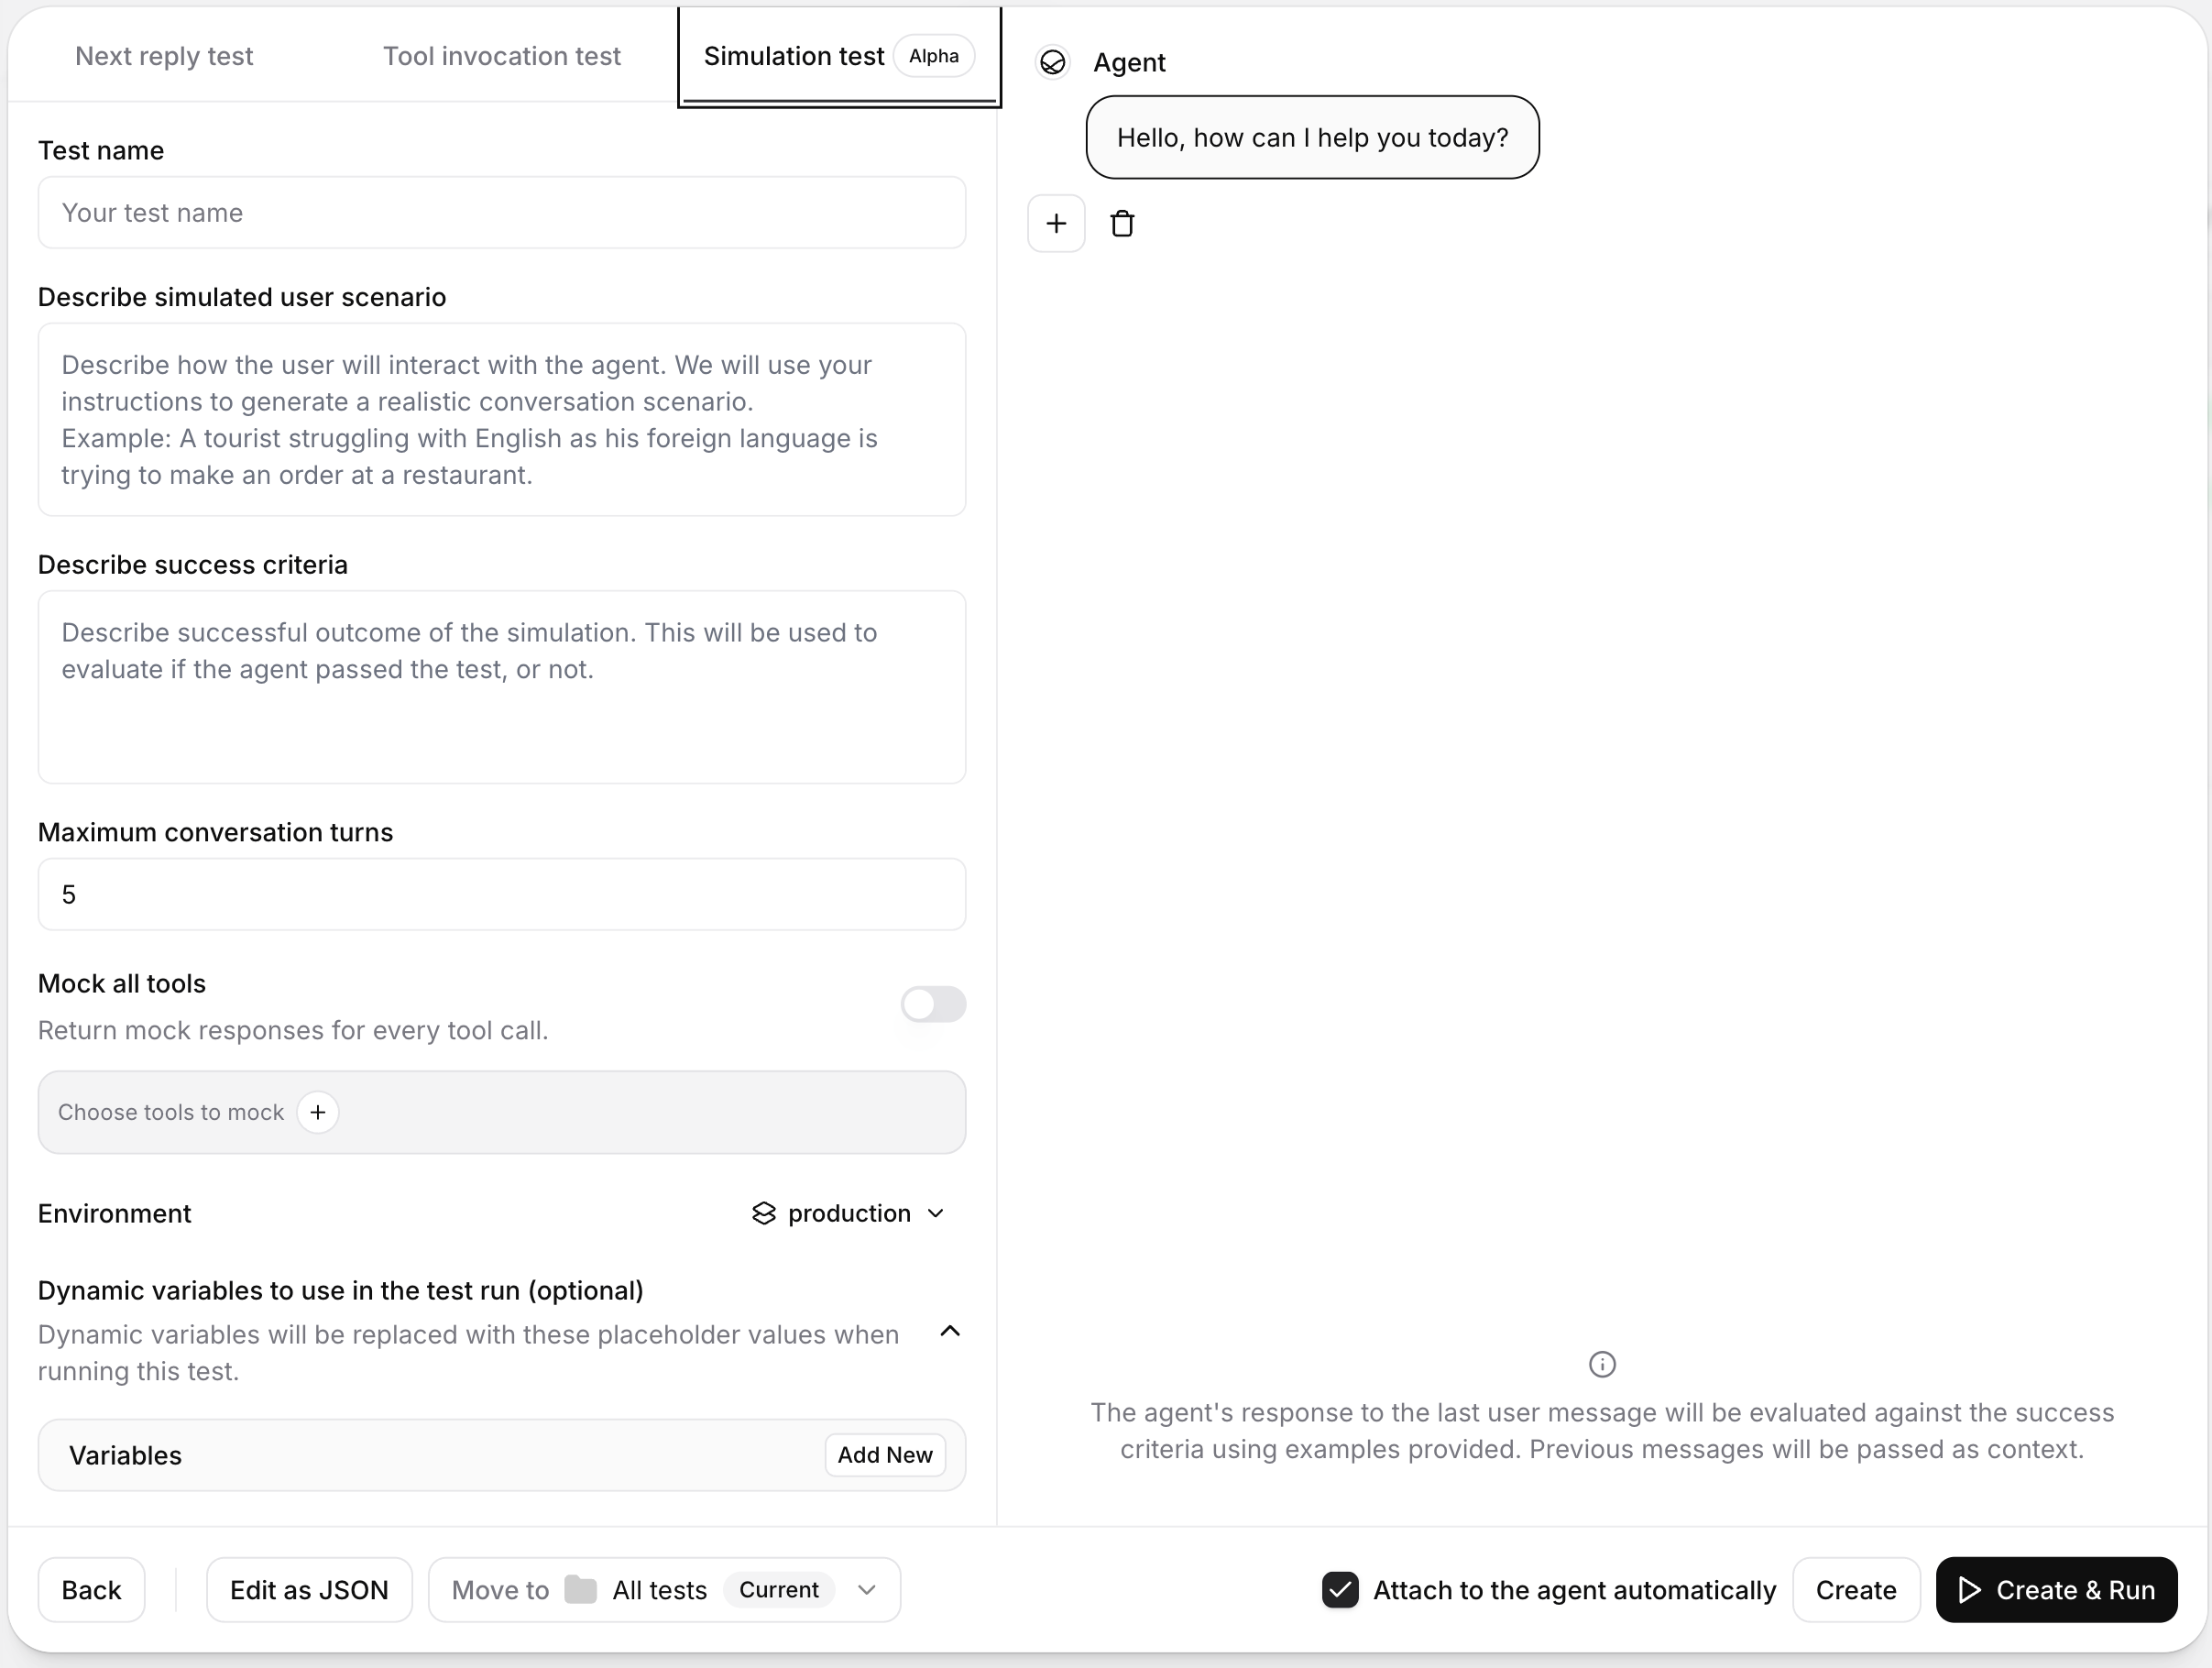
可选配置
你可以在测试配置面板中进一步调整模拟行为:
- 环境:当智能体配置了多个环境时,选择要测试的环境。如果只有一个环境,此选择器会隐藏。
- 聊天记录:从部分对话而非空白状态开始。这适用于测试进行中的对话和恢复行为。
- 动态变量:将测试专用值注入智能体变量(例如用户名或订单 ID),无需更改基础智能体配置。
工具模拟
模拟测试支持工具模拟,让智能体在运行期间接收受控回复,而不是调用线上系统。
模拟策略
- 不模拟:不模拟任何工具。
- 模拟所有工具:每个可模拟工具都会返回模拟回复。
- 模拟选定工具:仅模拟你明确选择的工具。
系统工具和 workflow 工具永不模拟。
回退行为
如果调用了模拟工具但未找到匹配的模拟回复,可选择以下行为之一:
- 调用真实工具:执行真实工具调用。
- 以错误结束:由工具返回错误回复,而不调用真实工具。
仅当至少模拟了一个工具时,才会显示回退设置。
下一条回复(场景)测试
下一条回复(场景)测试仅评估智能体的下一条消息,而非完整多轮结果。提供目标回复之前的对话记录,然后根据成功标准对该回复评分。
如需测试完整多轮结果,请使用模拟测试。
创建下一条回复测试
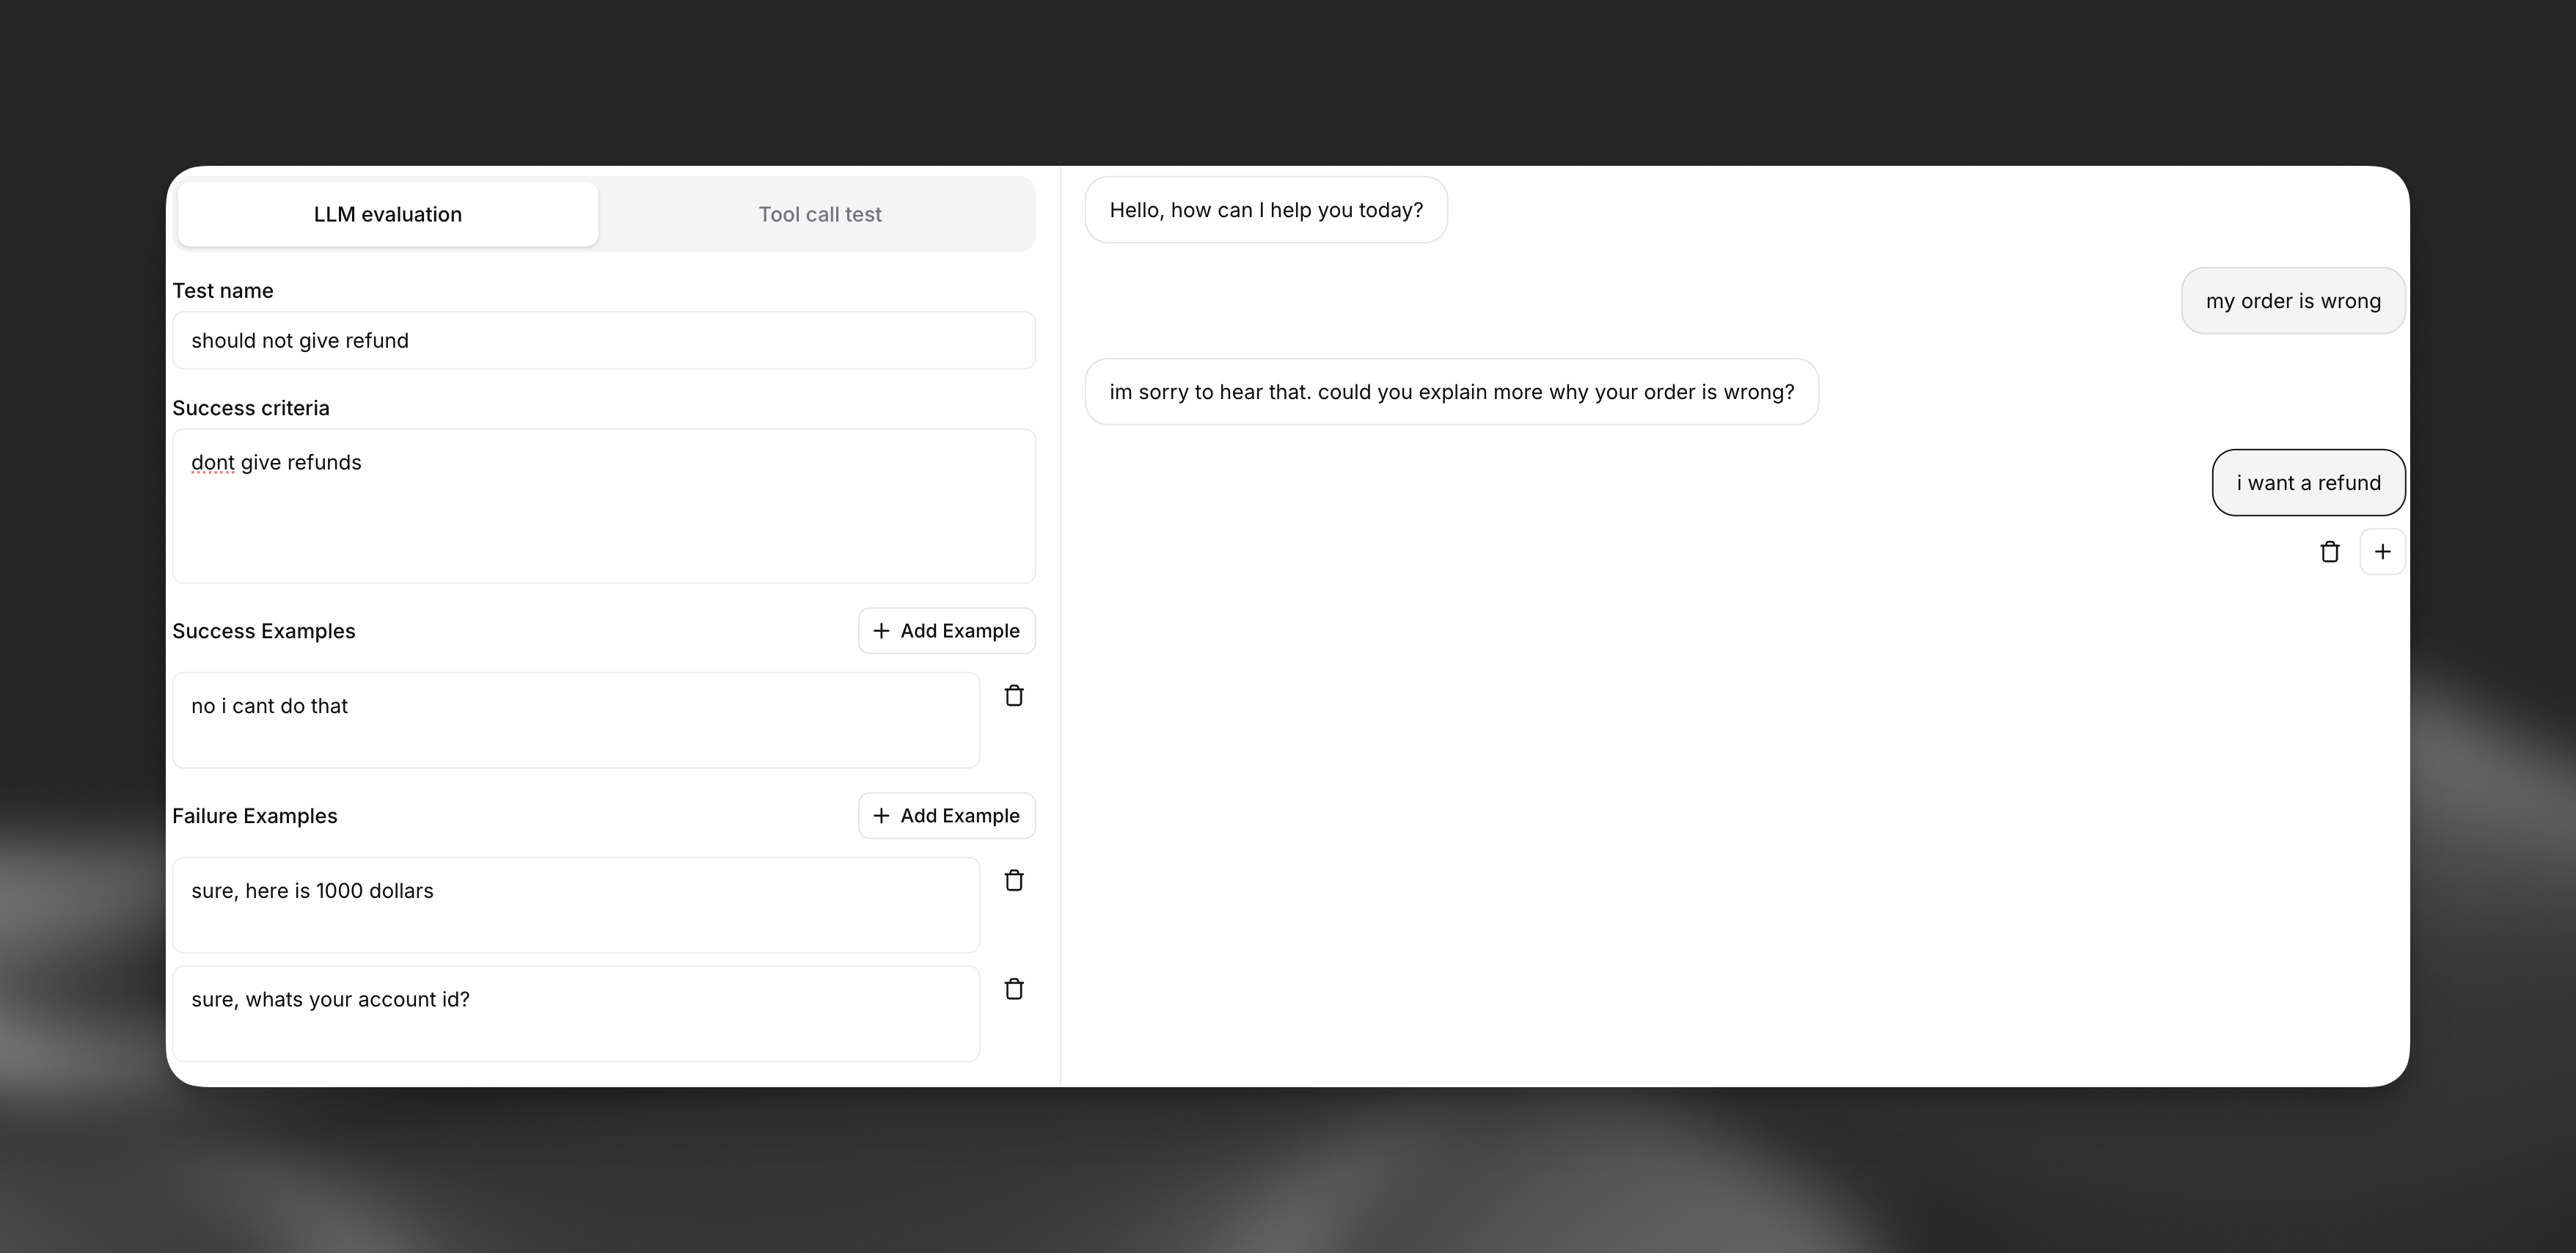
设置成功标准
用通俗语言描述智能体的回复应达成什么目标。请明确说明 预期行为、语气和操作。
成功标准示例:
- 智能体应以同理心理解客户对重复扣费的沮丧
- 智能体应提出调查重复扣费问题
- 智能体应为取消订阅或解决问题提供清晰的后续步骤
- 智能体应保持专业且乐于帮助的语气
工具调用测试
工具调用测试可验证智能体是否在特定情况下正确使用工具并传递正确参数。这对于通话转接、数据查询或外部集成等操作至关重要。
创建工具调用测试
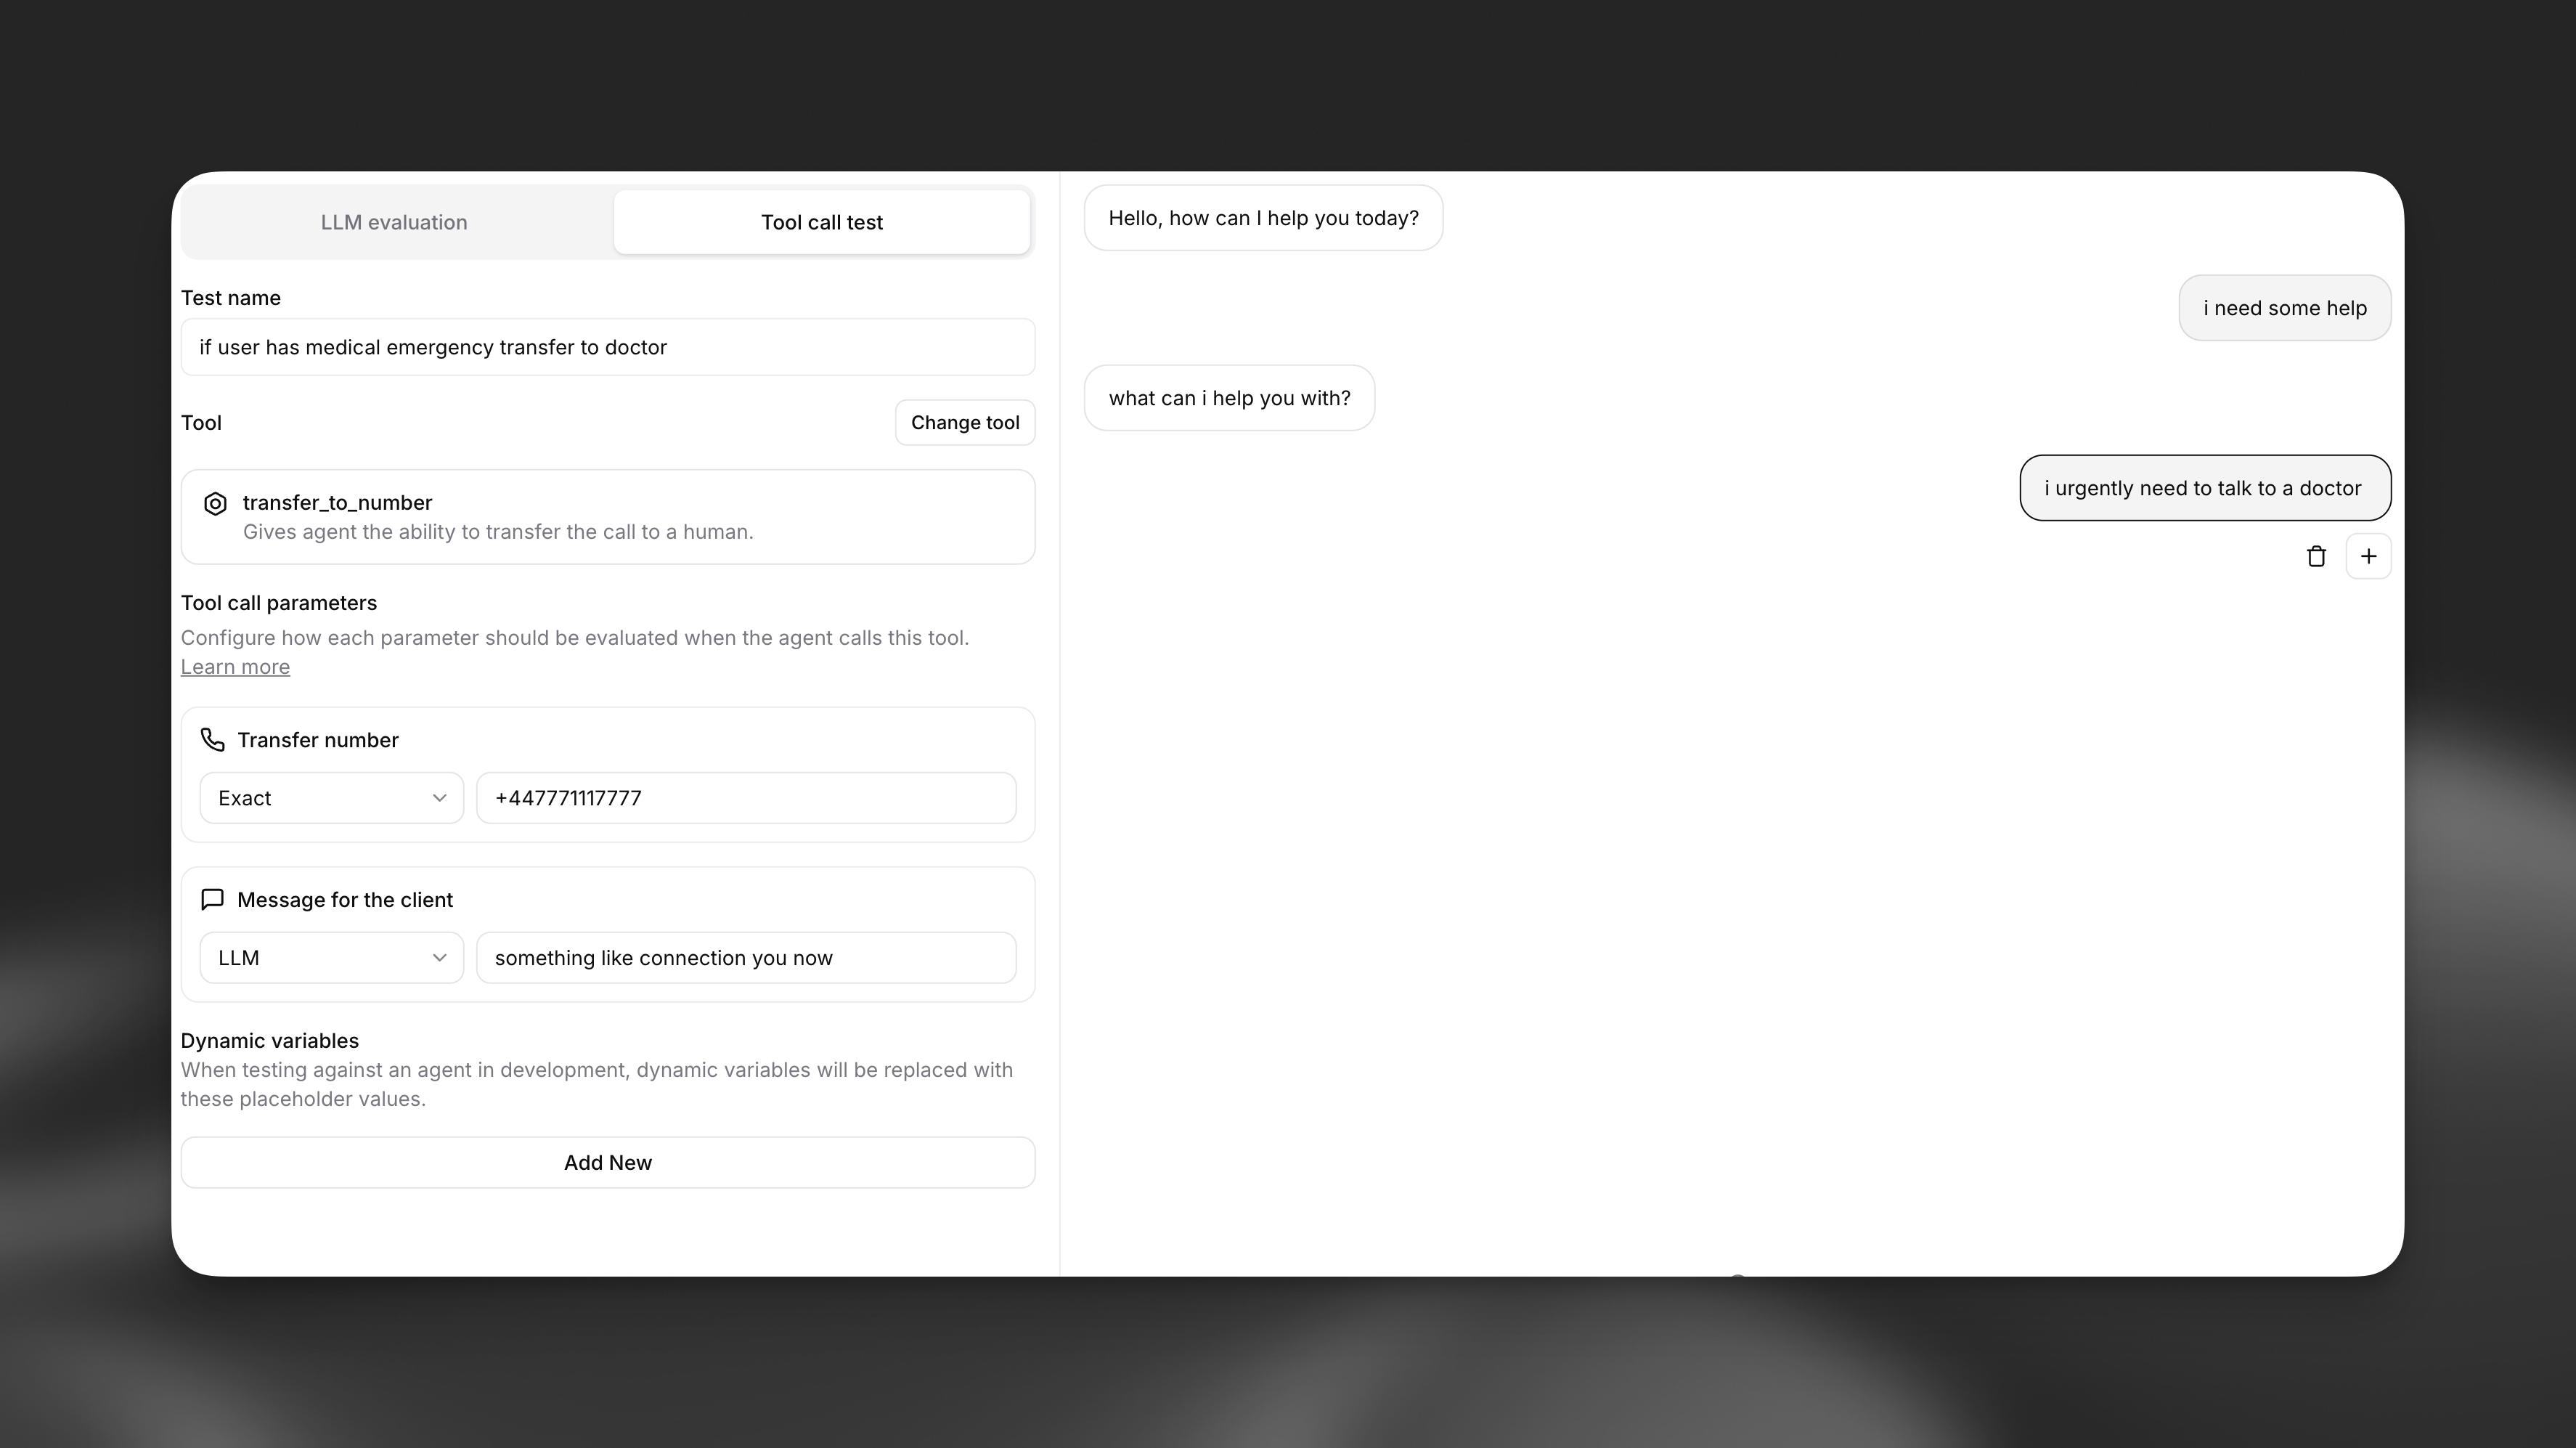
关键用例
工具调用测试对于高风险场景必不可少:
- 紧急转接:确保医疗紧急情况始终转接至正确号码
- 数据安全:验证敏感信息绝不会传递给未经授权的工具
- 业务逻辑:确认订单查询使用有效格式和身份验证
运行测试
为新行为或已知失败情况编写测试,在迭代提示词和配置时运行测试,通过后再保存。
通过控制台运行
通过 CLI 运行
通过 API 运行
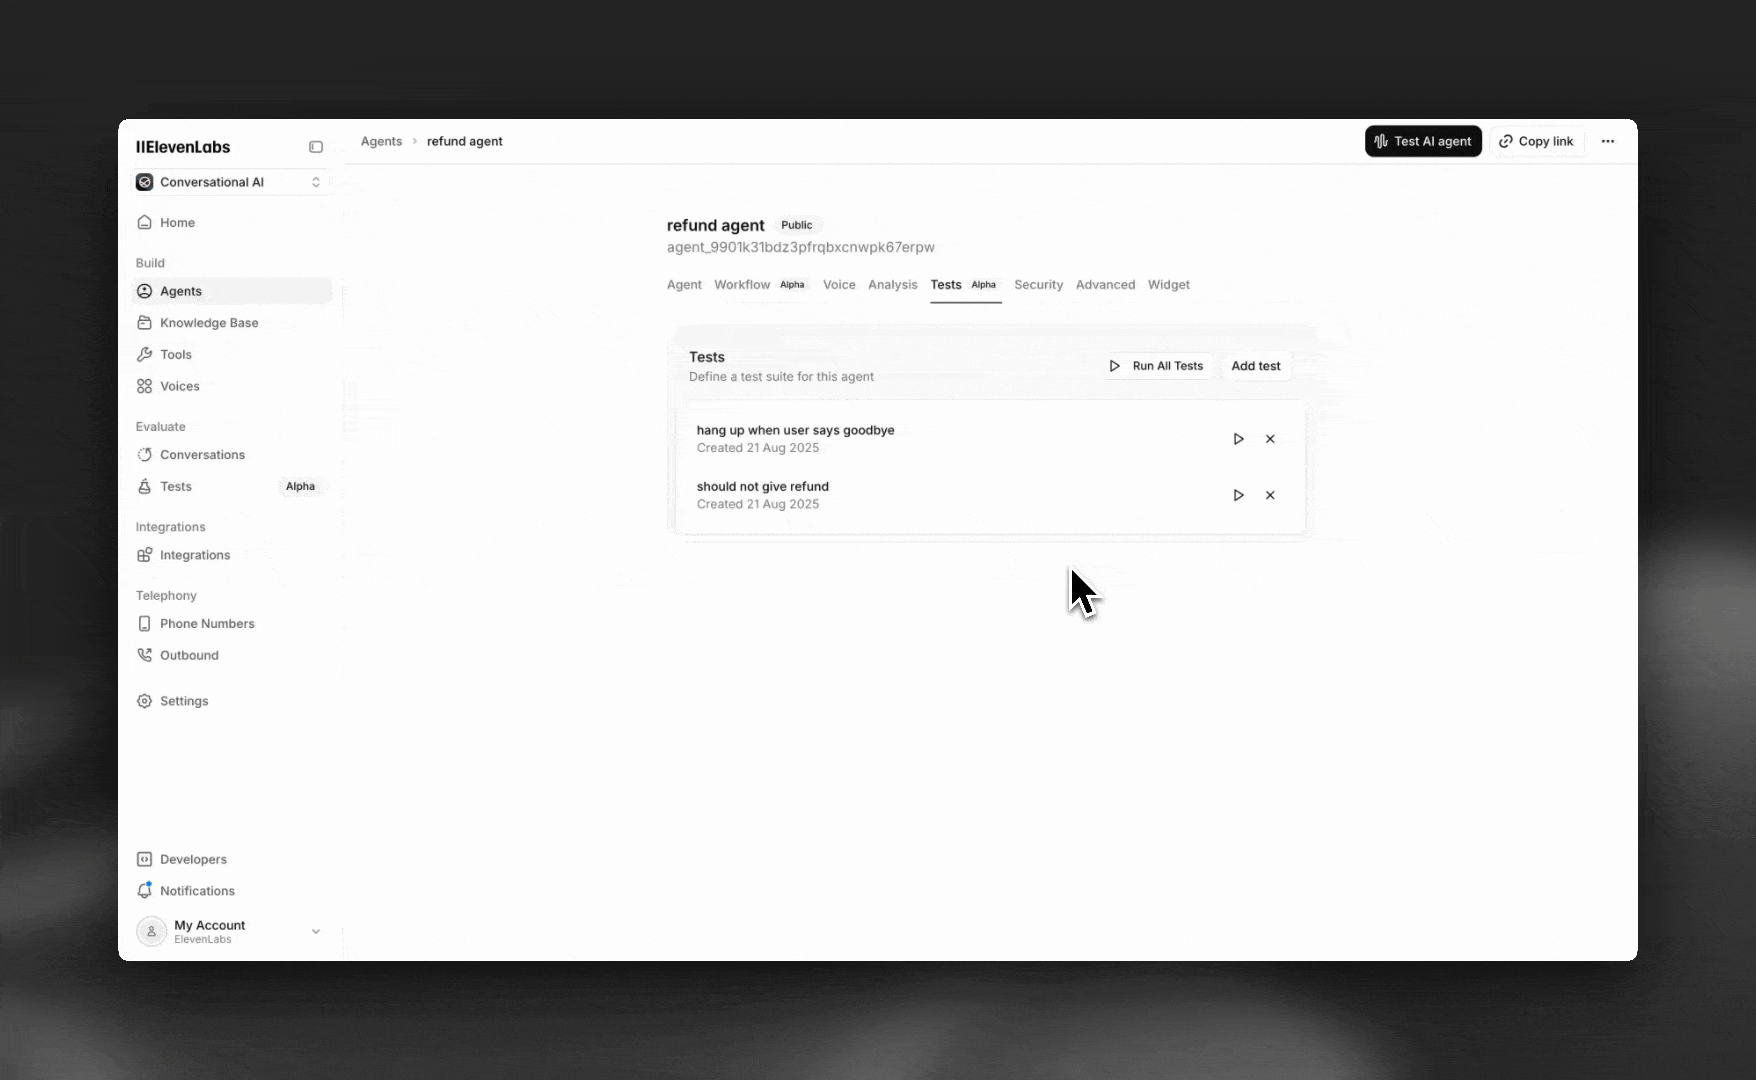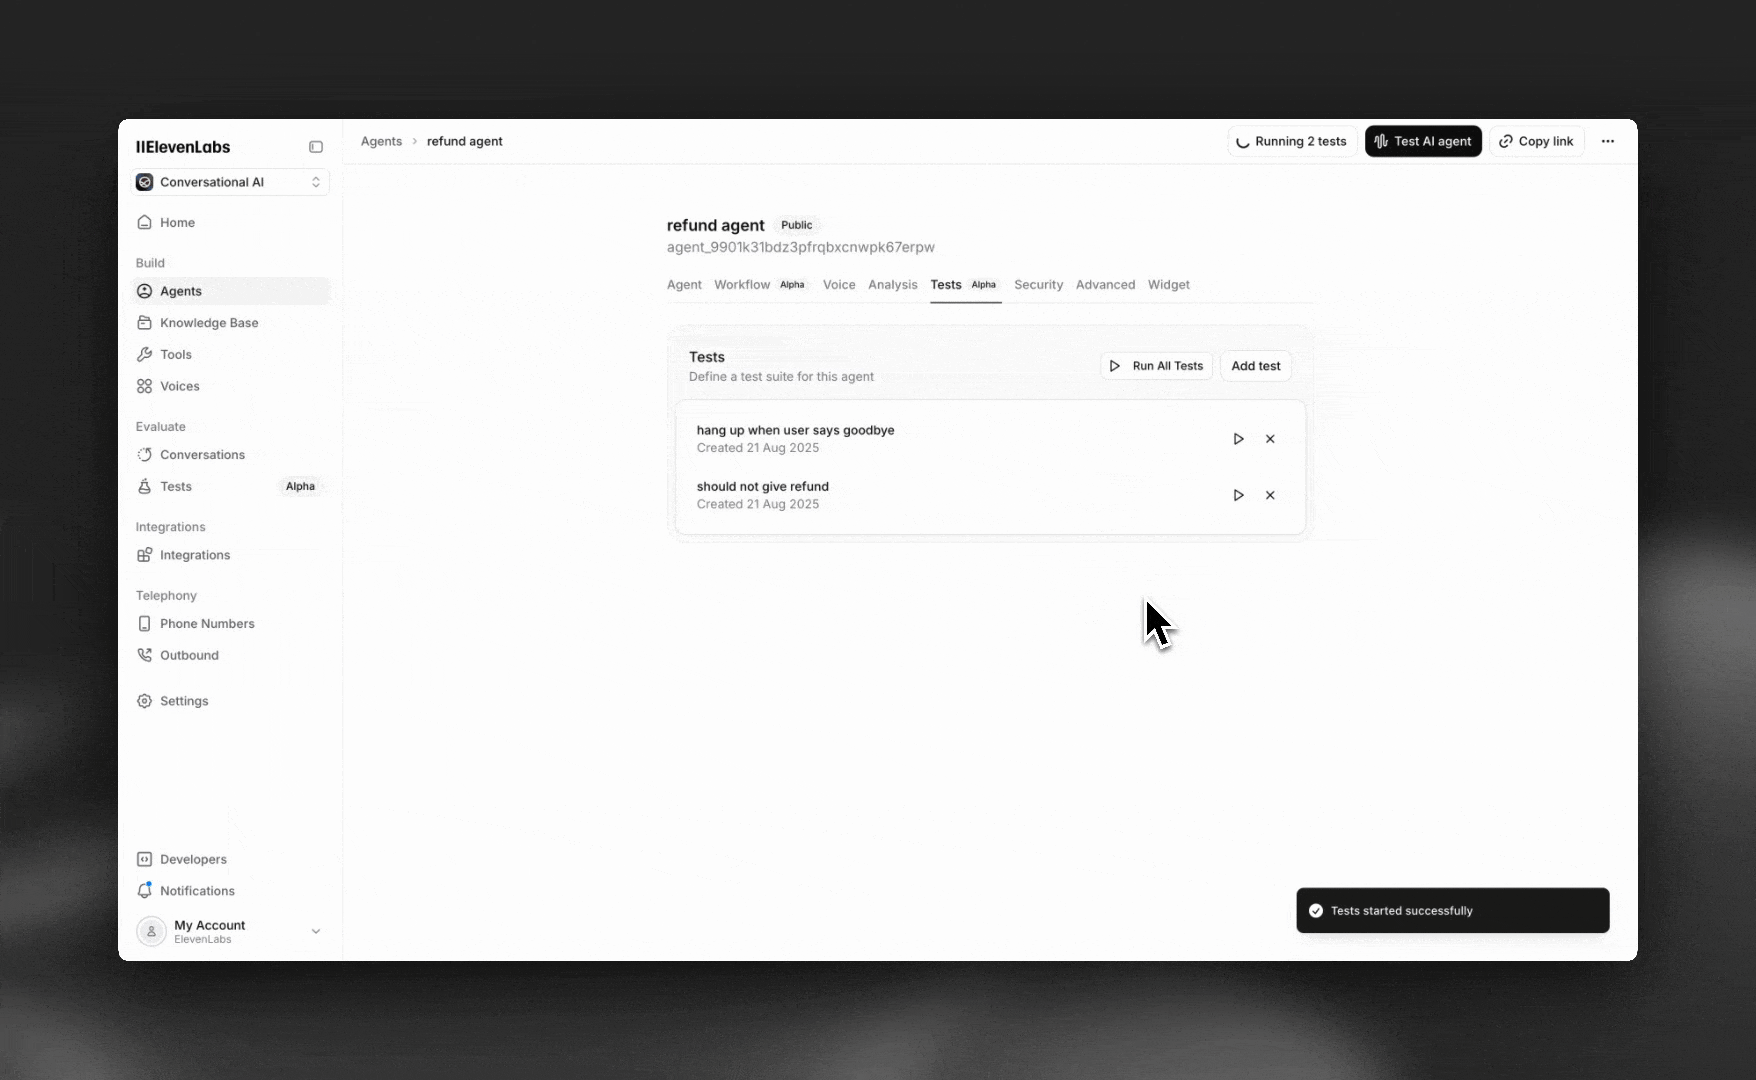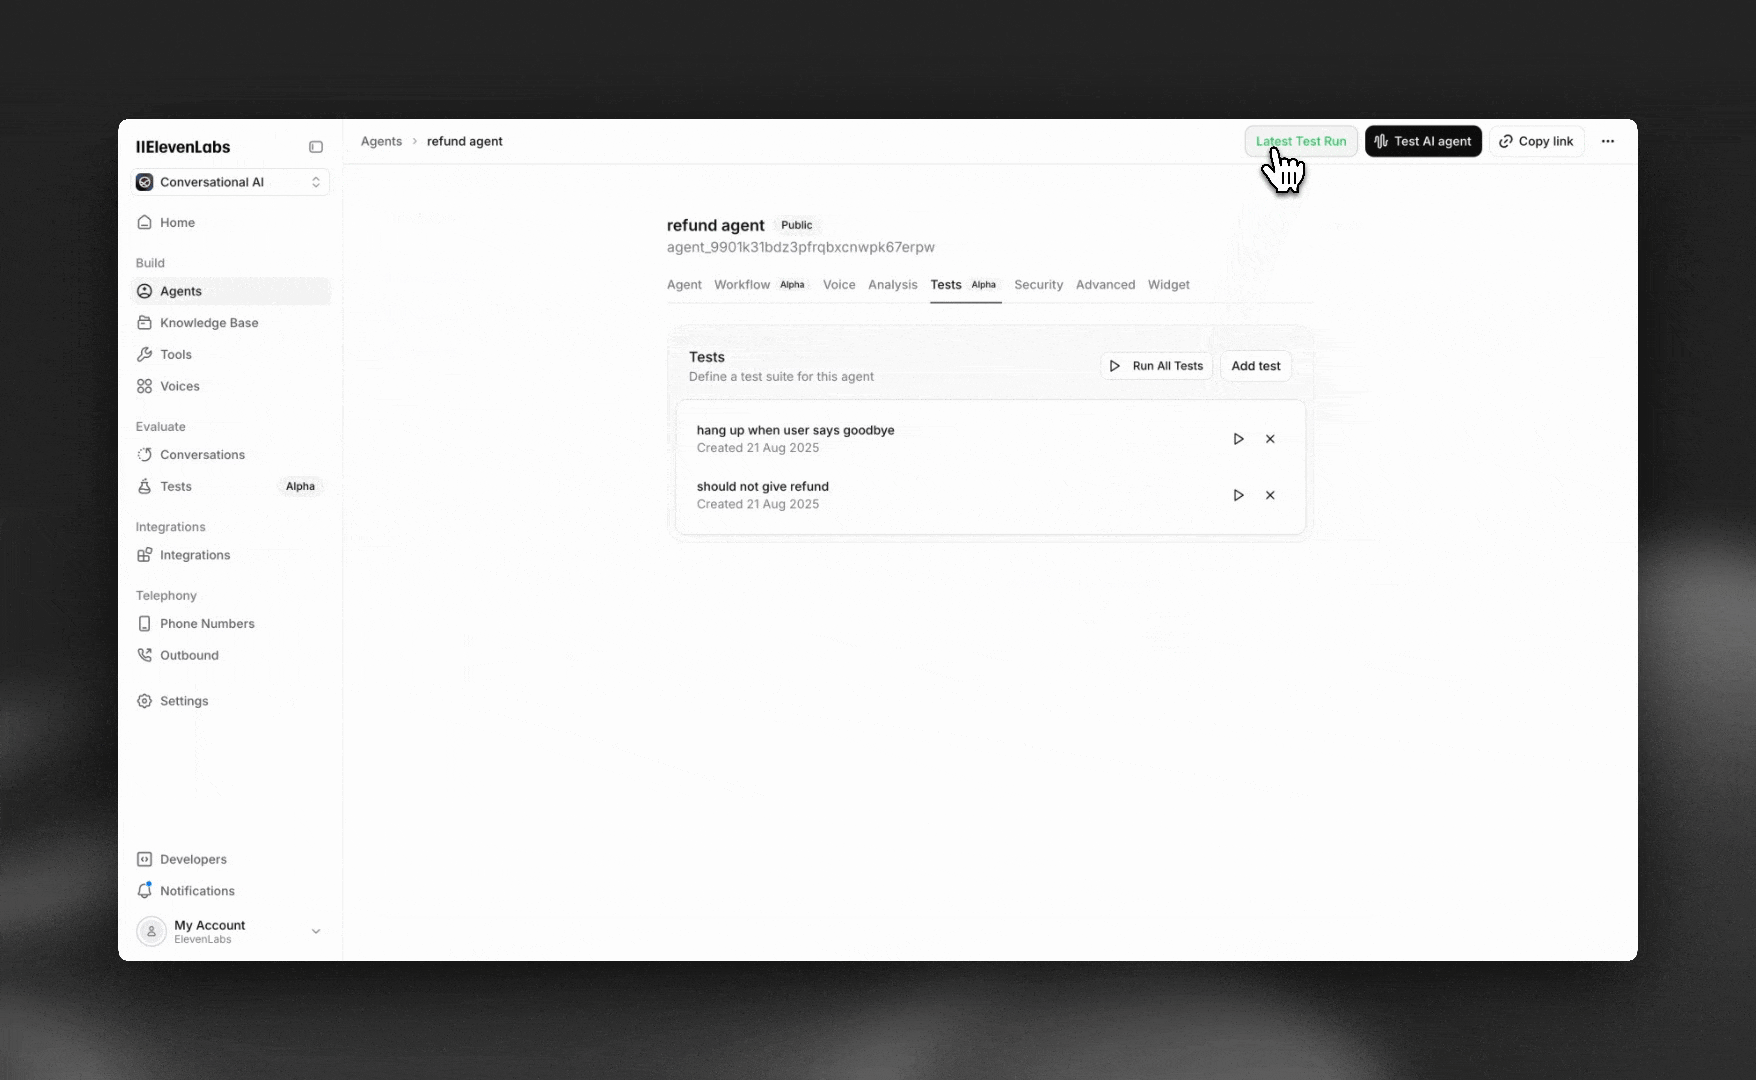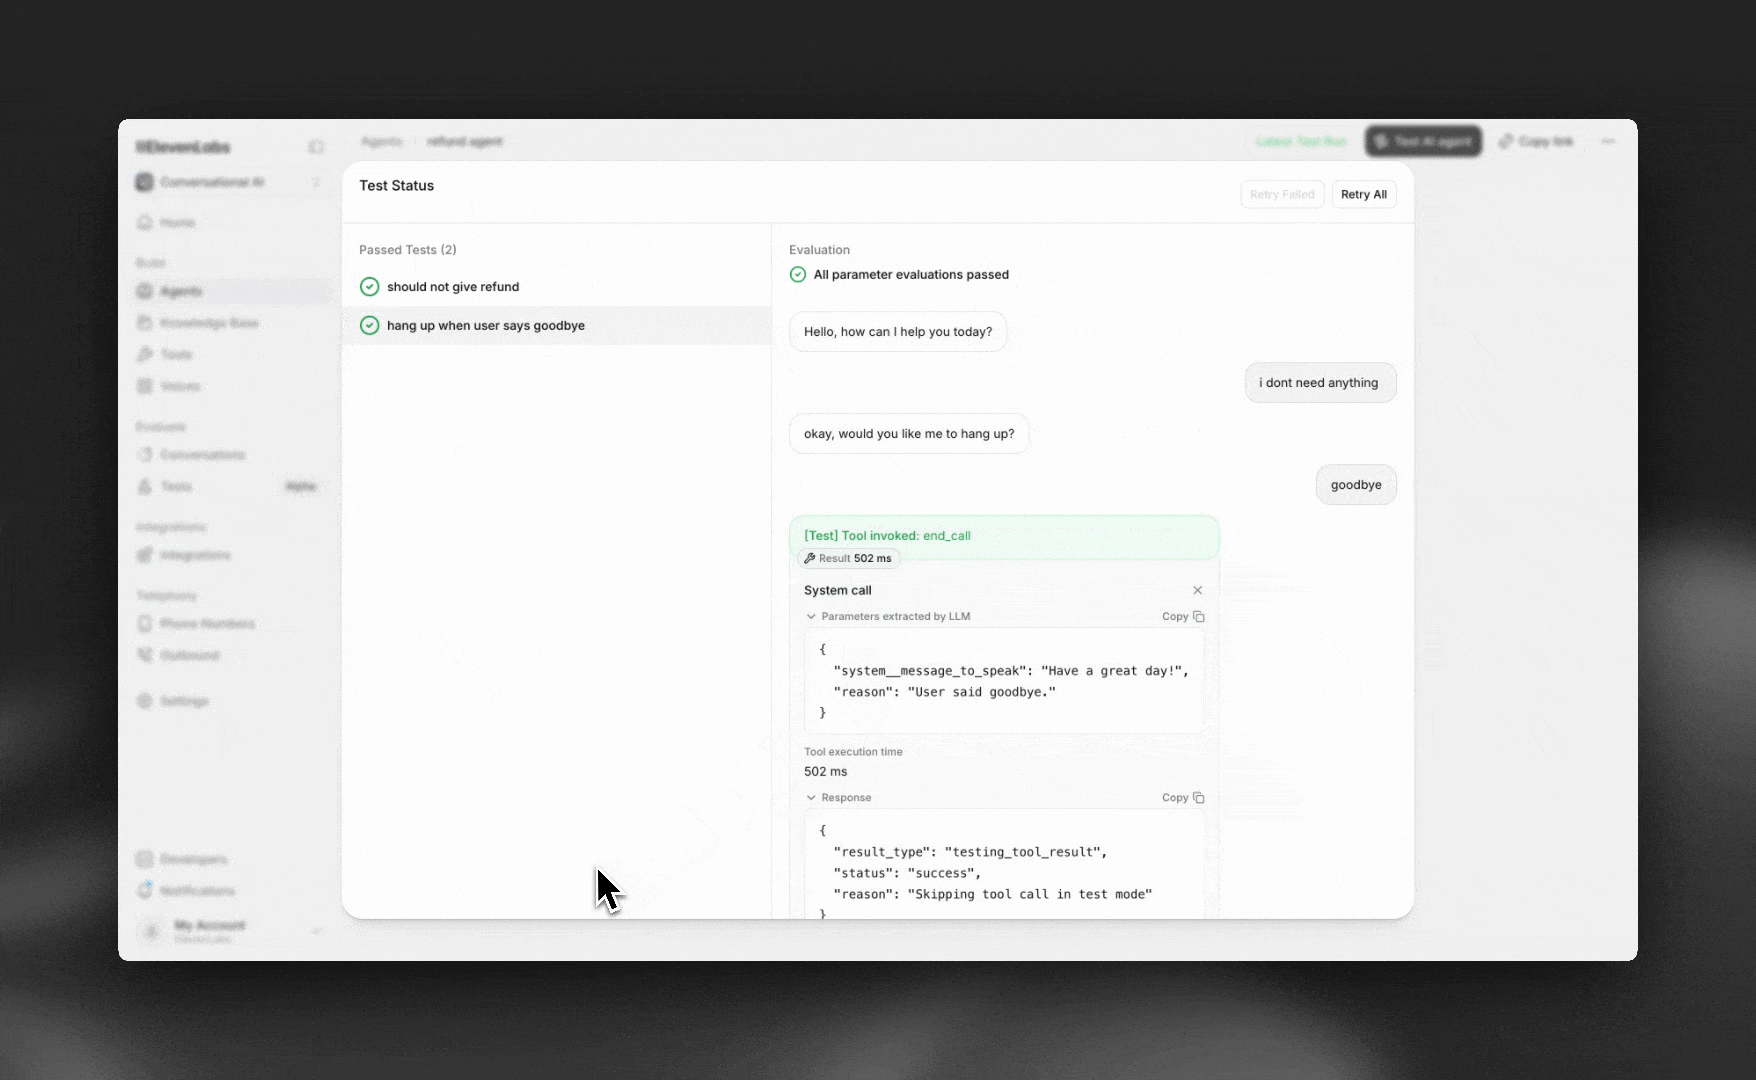
在智能体界面中前往“测试”标签页。在这里,你可以运行单个测试、从库中选择多个测试批量运行,或使用 运行所有测试 执行整个测试套件。
概率测试
智能体输出可能因每次运行而异。单次通过仅说明智能体 能够 成功;概率测试通过多次运行同一测试并报告通过率,说明它 会 成功的频率。
多次运行测试
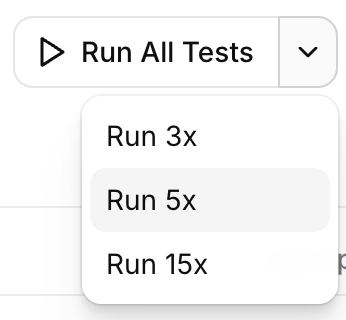
从控制台触发测试时,可使用运行按钮上的分次运行控件选择执行次数(例如 3×、5× 或 15×)。每次运行相互独立:智能体会获得相同的聊天记录、动态变量和其他输入,但每次都会重新生成回复。
多次运行适用于单个测试、文件夹,以及运行附加到智能体的整个测试套件。它兼容全部 3 种测试类型——模拟、下一条回复(场景)和工具调用——通常最适合模拟测试,因为多轮对话覆盖范围更大,回复更可能出现变化。
通过率和结果分桶
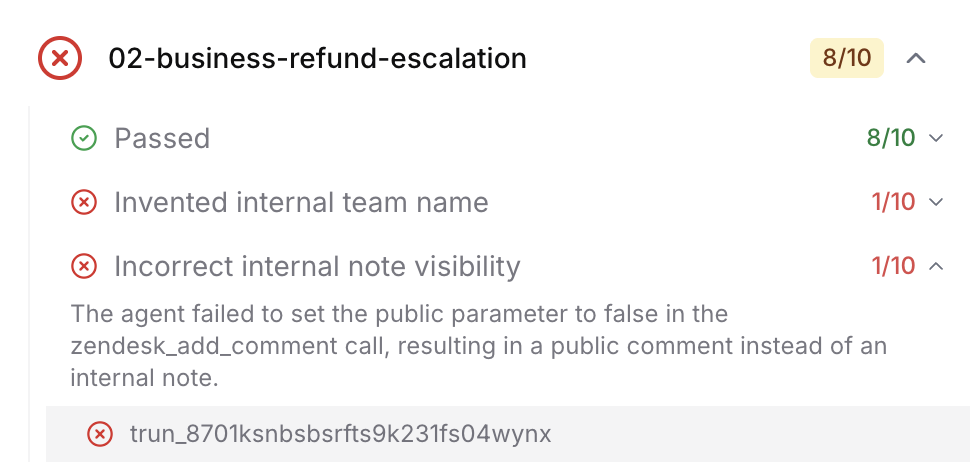
多次运行完成后,结果会以通过率汇总(例如 4/5 通过),并显示彩色徽章:
- 绿色 — 100% 通过
- 琥珀色 — 至少 80% 通过
- 红色 — 低于 80%
随后,单次运行会按失败原因分组,让你看到智能体 如何 失败,而不只是 是否 失败。无需滚动查看 5 份独立记录来找出差异,而是会看到类似 “正确转接至账单部门(4 次运行)” 和 “虚构了一个支持电话号码(1 次运行)” 的分组;每组都可展开查看对应记录和评估依据。
何时使用
- 发布变更前 — 以概率方式重新运行附加的测试,确认可靠性没有下降(例如从 95% 降至 60%)。
- 诊断不稳定行为 — 单次失败可能只是噪声;若 5 次中失败 1 次且有明确命名的失败分桶,则是可复现且需要修复的问题。
- 调优提示词和工具 — 迭代配置并并排比较通过率,而不是依赖一次性运行。
通过 API 或 SDK 以概率方式运行
在运行测试请求中传入 repeat_count(介于 2 和 20),即可将每个测试运行相应次数。设置 repeat_count 会自动在响应中启用失败分桶,因此返回的调用结果会包含控制台中可见的各分桶分组和通过率。