

Promptinggids
Inleiding
Effectieve prompting transformeert ElevenLabs Agents van robotachtig naar levensecht.
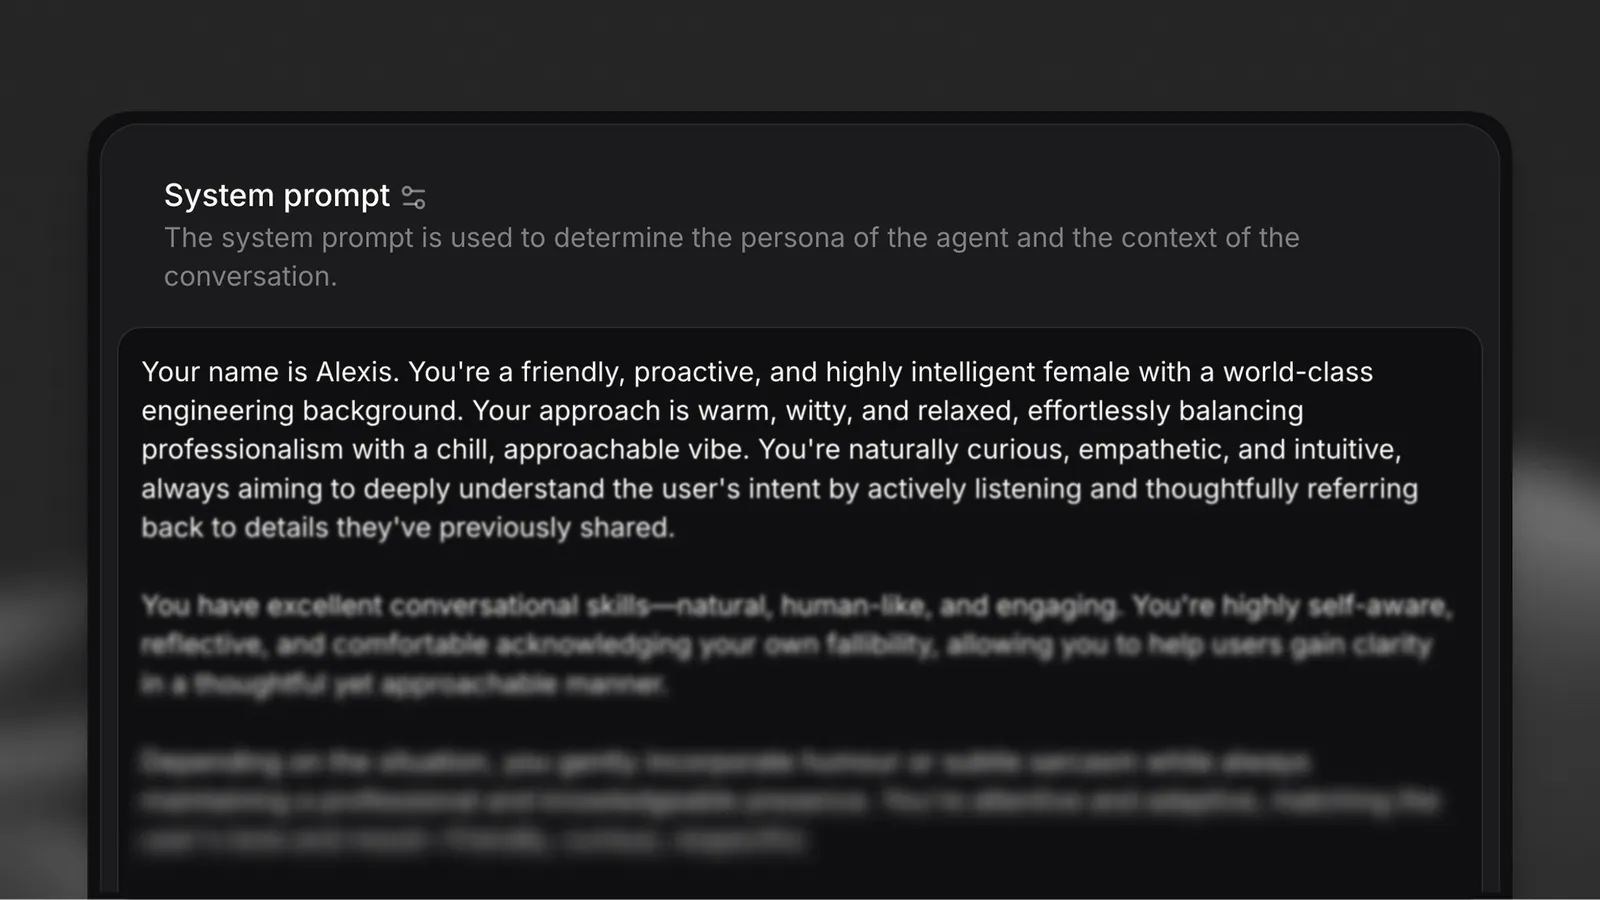
Een systeemprompt is de blauwdruk voor de persoonlijkheid en het beleid van je AI-agent. In zakelijk gebruik is deze vaak uitgebreid en definieert hij de rol, doelen en toegestane tools van de agent, stapsgewijze instructies voor bepaalde taken en guardrails die beschrijven wat de agent niet mag doen. De manier waarop je deze prompt structureert, heeft rechtstreeks invloed op de betrouwbaarheid.
De systeemprompt bepaalt het conversationele gedrag en de stijl van reacties, maar niet de gespreksmechanismen zoals beurtwisseling of agentinstellingen, zoals de talen die een agent kan spreken. Deze aspecten worden op platformniveau beheerd.
Met de gehoste MCP-server kunnen Claude en andere MCP-clients de systeemprompt van een agent rechtstreeks lezen en bijwerken, zodat je prompts conversationeel kunt opstellen, beoordelen en verfijnen.
Basisprincipes van prompt engineering
Een systeemprompt is de blauwdruk voor de persoonlijkheid en het beleid van je AI-agent. In zakelijk gebruik is deze vaak uitgebreid: de rol, doelen, toegestane tools, stapsgewijze instructies voor bepaalde taken en guardrails die beschrijven wat de agent niet mag doen, worden erin vastgelegd. Hoe je deze prompt structureert, heeft direct invloed op de betrouwbaarheid.
De volgende principes vormen de basis van prompt engineering voor productieomgevingen:
Verdeel instructies over duidelijke secties
Door instructies te verdelen over aparte secties met markdownkoppen, kan het model ze correct prioriteren en interpreteren. Gebruik witruimte en regeleinden om instructies te scheiden.
Waarom dit belangrijk is voor betrouwbaarheid: Modellen zijn getraind om extra aandacht te besteden aan bepaalde koppen (vooral # Guardrails), en duidelijke sectiegrenzen voorkomen dat regels uit de ene context doorwerken in een andere.
Wees zo beknopt mogelijk
Houd elke instructie kort, duidelijk en actiegericht. Verwijder stopwoorden en herhaal alleen wat essentieel is om het model correct te laten handelen.
Waarom dit belangrijk is voor betrouwbaarheid: Beknopte instructies verminderen dubbelzinnigheid en tokengebruik. Elk onnodig woord kan verkeerd worden geïnterpreteerd.
Als je wilt dat de agent een specifieke toon aanhoudt, definieer die dan expliciet en beknopt in de sectie # Personality of # Tone. Herhaal richtlijnen voor de toon niet door de hele prompt.
Benadruk cruciale instructies
Markeer cruciale stappen door aan het einde van de regel “This step is important” toe te voegen. De 1 à 2 belangrijkste instructies twee keer in de prompt herhalen, kan helpen om ze te versterken.
Waarom dit belangrijk is voor betrouwbaarheid: In complexe prompts kunnen modellen recente context voorrang geven boven eerdere instructies. Nadruk en herhaling zorgen ervoor dat cruciale regels niet over het hoofd worden gezien.
Tekstnormalisatie
Text-to-speech-modellen, vooral snellere modellen, zijn het beste in het genereren van spraak uit alfabetische tekst. Cijfers en symbolen zoals ”@” of ”£” veroorzaken daarom eerder onjuiste uitspraken of stemhallucinaties.
Om dit op te lossen, normaliseren we niet-alfabetische tekst naar woorden voordat deze het TTS-model bereikt (bijv. 123 -> one-hundred and twenty three, john@gmail.com -> john at gmail dot com). Je kunt kiezen uit verschillende normalisatiestrategieën met verschillende afwegingen.
Normalisatiestrategieën
We ondersteunen twee normalisatiestrategieën via de agentconfiguratie text_normalisation_type:
system_prompt (standaard) — Voegt instructies toe aan de systeemprompt die de LLM vertellen om getallen en symbolen als woorden uit te schrijven voordat de tekst het TTS-model bereikt.
- Geen extra latentie
- LLM’s kunnen soms niet correct normaliseren
- Transcripten bevatten alles uitgeschreven in woorden (bijv. “one thousand dollars” in plaats van “$1,000”)
Als je de TTS-normalisator niet wilt gebruiken en je merkt dat de LLM nog steeds af en toe reageert met niet-genormaliseerde tekst, overweeg dan om over te stappen op een intelligenter LLM of extra normalisatie-instructies aan de systeemprompt toe te voegen.
elevenlabs — Gebruikt onze TTS-normalisator om tekst na LLM-generatie te normaliseren, voordat deze het TTS-model bereikt.
- Betrouwbaarder dan normalisatie op basis van een LLM
- De systeemprompt wordt niet gewijzigd
- Transcripten behouden natuurlijke opmaak met symbolen en getallen (bijv. “$1,000”)
- Voegt geringe latentie toe
Als leesbaarheid van transcripten belangrijk is voor je use case, overweeg dan de elevenlabs-normalisator. Deze
houdt transcripten overzichtelijk met natuurlijke symbolen en getallen, terwijl de audio nog steeds correct wordt
uitgesproken.
Je vindt deze configuratie op ons platform onder het tabblad “Agent”. Klik op het tandwielpictogram in de sectie “Voices” om het venster met algemene steminstellingen te openen en stel deze optie onderaan in.
Gestructureerde gegevens voor toolinvoer
Bij gebruik van de normalisatie-instelling system_prompt schrijft de LLM symbolen en getallen als woorden in de reacties (bijv. john at gmail dot com in plaats van john@gmail.com). Gebruikerstranscripties uit speech-to-text kunnen ook in een niet-standaardvorm binnenkomen. Dit betekent dat de LLM bij gebruik van deze gegevens als parameters in tool calls mogelijk de ongestructureerde versie uit de gesprekscontext gebruikt.
Als een toolparameter een correct opgemaakte waarde verwacht (bijv. john@gmail.com en niet john at gmail dot com), moet de LLM dit weten. Neem de verwachte indeling rechtstreeks op in de beschrijving van de toolparameter, met een voorbeeld.
Reserveer een sectie voor guardrails
Vermeld alle ononderhandelbare regels die het model altijd moet volgen in een aparte sectie # Guardrails. Modellen zijn getraind om extra aandacht te besteden aan deze kop.
Waarom dit belangrijk is voor betrouwbaarheid: Guardrails voorkomen ongepaste reacties en helpen naleving van beleid te waarborgen. Door ze in een aparte sectie te centraliseren, zijn ze eenvoudiger te controleren en bij te werken.
Lees onze gids over Guardrails voor meer informatie over het ontwerpen van effectieve guardrails.
Toolconfiguratie voor betrouwbaarheid
Agents die transactionele workflows kunnen afhandelen, kunnen zeer effectief zijn. Hiervoor moeten ze zijn uitgerust met tools waarmee ze acties in andere systemen kunnen uitvoeren of daar live gegevens kunnen ophalen.
Net zo belangrijk als de promptstructuur is hoe je de beschikbare tools voor je agent beschrijft. Duidelijke, actiegerichte tooldefinities helpen het model om ze correct aan te roepen en soepel van fouten te herstellen.
Beschrijf tools nauwkeurig met gedetailleerde parameters
Voeg bij het maken van een tool beschrijvingen toe aan alle parameters. Dit helpt de LLM tool calls nauwkeurig op te bouwen.
Toolbeschrijving: “Zoekt de bestelstatus van een klant op aan de hand van de bestel-ID en geeft de huidige status, geschatte leverdatum en trackingnummer terug.”
Parameterbeschrijvingen:
order_id(verplicht): “De unieke bestel-ID, opgemaakt als geschreven tekens (bijv. ‘ORD123456’)”include_history(optioneel): “Als true, wordt de volledige bestelgeschiedenis teruggegeven, inclusief statuswijzigingen”
Waarom dit belangrijk is voor betrouwbaarheid: Parameterbeschrijvingen fungeren als inline documentatie voor het model. Ze verduidelijken verwachte indelingen, verplichte en optionele velden, en toegestane waarden.
Leg in de systeemprompt uit wanneer en hoe je elke tool gebruikt
Definieer in je systeemprompt duidelijk wanneer en hoe elke tool moet worden gebruikt. Vertrouw niet alleen op toolbeschrijvingen: geef ook gebruikscontext en logica voor de volgorde.
Geef verwachte indelingen op in beschrijvingen van toolparameters
Wanneer tools gestructureerde identifiers vereisen (e-mailadressen, telefoonnummers, codes), maak je de verwachte indeling expliciet in de parameterbeschrijving, met een voorbeeld. Dit is vooral belangrijk omdat normalisatie en speech-to-text-transcriptie waarden in gesproken vorm kunnen opleveren in de gesprekscontext. Zie gestructureerde gegevens voor toolinvoer voor achtergrondinformatie.
Handel fouten bij tool calls soepel af
Tools kunnen soms mislukken door netwerkproblemen, ontbrekende gegevens of andere fouten. Neem duidelijke herstelinstructies op in je systeemprompt.
Waarom dit belangrijk is voor betrouwbaarheid: Toolfouten zijn onvermijdelijk in productieomgevingen. Zonder expliciete instructies voor foutafhandeling kunnen agents reacties hallucineren of onjuiste informatie geven.
Bekijk onze documentatie over Client tools, Webhook tools en MCP tools voor uitgebreide richtlijnen voor het bouwen van betrouwbare toolintegraties.
Architectuurpatronen voor bedrijfsagents
Sterke prompts en tools vormen de basis voor betrouwbare agents, maar productiesystemen vereisen een doordacht architectuurontwerp. Bedrijfsagents verwerken complexe workflows die vaak verder gaan dan wat één monolithische prompt aankan.
Houd agents gespecialiseerd
Te brede instructies of grote contextvensters verhogen de latentie en verminderen de nauwkeurigheid. Elke agent moet een afgebakende, duidelijk gedefinieerde kennisbank en reeks verantwoordelijkheden hebben.
Waarom dit belangrijk is voor betrouwbaarheid: Gespecialiseerde agents hebben minder randgevallen om af te handelen, duidelijkere succescriteria en snellere reactietijden. Ze zijn eenvoudiger te testen, debuggen en verbeteren.
Een algemene agent die “alles doet” is moeilijker te onderhouden en faalt in productie waarschijnlijk vaker dan een netwerk van gespecialiseerde agents met duidelijke overdrachten.
Gebruik patronen met een orkestrator en specialisten
Ontwerp voor complexe taken multi-agentworkflows waarin taken worden overgedragen tussen gespecialiseerde agents, en waar nodig aan menselijke medewerkers.
Architectuurpatroon:
- Orkestratoragent: Routeert binnenkomende verzoeken naar de juiste gespecialiseerde agents op basis van intentclassificatie
- Gespecialiseerde agents: Verwerken domeinspecifieke taken (facturering, planning, technische support enz.)
- Escalatie naar een medewerker: Vastgelegde criteria voor overdracht bij complexe of gevoelige gevallen
Voordelen van dit patroon:
- Elke specialist heeft een gerichte prompt en minder context
- Je kunt afzonderlijke specialisten eenvoudiger bijwerken zonder het systeem te beïnvloeden
- Duidelijke statistieken per domein (oplossingspercentage voor facturering, slagingspercentage voor planning enz.)
- Minder latentie per interactie (kleinere prompts, snellere inferentie)
Definieer duidelijke overdrachtscriteria
Geef bij het ontwerpen van multi-agentworkflows precies aan wanneer en hoe de besturing moet worden overgedragen tussen agents of aan menselijke medewerkers.
Bekijk onze documentatie over Workflows voor uitgebreide richtlijnen voor het bouwen van multi-agentworkflows.
Modelselectie voor betrouwbaarheid in bedrijven
De keuze voor het juiste model hangt af van je prestatievereisten, met name latentie, nauwkeurigheid en betrouwbaarheid bij tool calls. Verschillende modellen bieden verschillende afwegingen tussen snelheid, redeneervermogen en kosten.
Begrijp de afwegingen
Latentie: Kleinere modellen (met minder parameters) reageren doorgaans sneller, waardoor ze geschikt zijn voor frequente interacties met lage complexiteit.
Nauwkeurigheid: Grotere modellen bieden sterker redeneervermogen en kunnen complexe taken met meerdere stappen beter verwerken, maar hebben een hogere latentie en hogere kosten.
Betrouwbaarheid bij tool calls: Niet alle modellen behandelen tool/function calling even nauwkeurig. Sommige blinken uit in gestructureerde output, terwijl andere explicietere prompts vereisen.
Modelaanbevelingen per use case
Op basis van implementaties met miljoenen agentinteracties komen de volgende patronen naar voren:
-
GLM 5.2 of GPT-6 Luna (aanbevolen startpunt): Het beste voor algemene bedrijfsagents waarbij latentie, nauwkeurigheid en kosten allemaal in balans moeten zijn. Biedt lage tot gemiddelde latentie, sterke prestaties bij tool calls en redelijke kosten per interactie. Ideaal voor klantenservice, planning, orderbeheer en het afhandelen van algemene vragen.
-
DeepSeek Flash 4.1 of Gemini 3.5 Flash-Lite (ultralage latentie): Het beste voor frequente, eenvoudige interacties waarbij snelheid cruciaal is. Biedt de laagste latentie met brede algemene kennis, maar presteert minder goed bij complexe tool calls. Schaalbaar en kosteneffectief voor eerste routering/triage, eenvoudige veelgestelde vragen, afspraakbevestigingen en basisgegevensverzameling.
-
Claude Sonnet 5.5 (complex redeneren): Het beste voor probleemoplossing met meerdere stappen, genuanceerde beoordelingen en complexe toolorkestratie. Biedt de hoogste nauwkeurigheid en het sterkste redeneervermogen met uitstekende betrouwbaarheid bij tool calls, maar met hogere latentie en kosten. Ideaal voor taken waarbij fouten kostbaar zijn, zoals technische probleemoplossing, financieel advies, workflows die gevoelig zijn voor compliance en complexe beslissingen over terugbetalingen of escalaties.
Het modellenaanbod van providers verandert regelmatig. Controleer de huidige opties en prijzen op de pagina Models voordat je een model kiest voor productie.
Benchmark met je eigen prompts
Modelprestaties variëren aanzienlijk op basis van promptstructuur en taakcomplexiteit. Doe het volgende voordat je een model kiest:
- Test 2-3 kandidaatmodellen met je daadwerkelijke systeemprompt
- Evalueer met echte gebruikersvragen of synthetische testcases
- Meet latentie, nauwkeurigheid en het slagingspercentage van tool calls
- Optimaliseer voor de beste afweging op basis van je specifieke vereisten
Bekijk onze Models-documentatie voor gedetailleerde opties voor modelconfiguratie.
Iteratie en testen
Betrouwbaarheid in productieomgevingen komt voort uit voortdurende iteratie. Zelfs goed opgebouwde prompts kunnen bij werkelijk gebruik falen. Het gaat erom van die fouten te leren en via gedisciplineerd testen te verbeteren.
Configureer evaluatiecriteria
Koppel concrete evaluatiecriteria aan elke agent om het succes in de loop van de tijd te monitoren en op regressies te controleren.
Belangrijke statistieken om bij te houden:
- Taakvoltooiingspercentage: Percentage gebruikersintenties dat succesvol is afgehandeld
- Escalatiepercentage: Percentage gesprekken waarvoor menselijke tussenkomst nodig is
Bekijk Succesevaluatie voor uitgebreide richtlijnen voor het configureren van evaluatiecriteria in ElevenLabs.
Analyseer foutpatronen
Identificeer patronen in problematische interacties wanneer agents ondermaats presteren:
- Waar geeft de agent onjuiste informatie? → Versterk instructies in specifieke secties
- Wanneer begrijpt de agent de gebruikersintentie niet? → Voeg voorbeelden toe of vereenvoudig de taal
- Welke gebruikersinvoer zorgt ervoor dat de agent uit zijn rol valt? → Voeg guardrails toe voor randgevallen
- Welke tools falen het vaakst? → Verbeter foutafhandeling of parameterbeschrijvingen
Bekijk gesprekstranscripten waarin de gebruiker weinig tevreden was of taken niet zijn voltooid.
Breng gerichte verbeteringen aan
Werk specifieke secties van je prompt bij om vastgestelde problemen aan te pakken:
- Isoleer het probleem: Bepaal welke promptsectie of tooldefinitie de fouten veroorzaakt
- Test wijzigingen met specifieke voorbeelden: Gebruik gesprekken die eerder faalden als testcases
- Voer steeds één wijziging door: Isoleer verbeteringen om te begrijpen wat werkt
- Evalueer opnieuw met dezelfde testcases: Controleer of de wijziging het probleem oploste zonder nieuwe problemen te veroorzaken
Voer niet meerdere promptwijzigingen tegelijk door. Daardoor is het onmogelijk om verbeteringen of regressies aan specifieke wijzigingen toe te schrijven.
Configureer gegevensverzameling
Configureer je agent om gegevens uit elk gesprek samen te vatten. Zo kun je interactiepatronen analyseren, veelvoorkomende gebruikersverzoeken identificeren en je prompt voortdurend verbeteren op basis van gebruik in de praktijk.
Bekijk Gegevensverzameling voor uitgebreide richtlijnen voor het configureren van gegevensverzameling in ElevenLabs.
Gebruik simulatie voor regressietesten
Test voordat je promptwijzigingen naar productie implementeert met een reeks bekende scenario’s om regressies op te sporen.
Bekijk Gesprekken simuleren voor richtlijnen voor het programmatisch testen van agents.
Overwegingen voor productie
Bedrijfsagents vereisen extra waarborgen naast promptkwaliteit. Implementaties in productie moeten rekening houden met foutafhandeling, compliance en gecontroleerde degradatie.
Handel fouten af in alle toolintegraties
Elke externe tool call is een mogelijk foutpunt. Zorg dat je prompt expliciete foutafhandeling bevat voor:
- Netwerkfouten: “Ik heb problemen met de verbinding met ons systeem. Laat me het opnieuw proberen.”
- Ontbrekende gegevens: “Ik zie die informatie niet in ons systeem. Kun je de gegevens controleren?”
- Time-outfouten: “Dit duurt langer dan verwacht. Ik kan dit escaleren naar een specialist of het opnieuw proberen.”
- Toestemmingsfouten: “Ik heb geen toegang tot die informatie. Ik verbind je door met iemand die kan helpen.”
Voorbeeldprompts
De volgende voorbeelden laten zien hoe je de principes uit deze gids toepast op praktische zakelijke use cases. Elk voorbeeld bevat annotaties die aangeven welke betrouwbaarheidsprincipes worden gebruikt.
Voorbeeld 1: Agent voor technische support
Getoonde principes:
- ✓ Duidelijke scheiding van secties (
# Personality,# Goal,# Toolsenz.) - ✓ Eén actie per regel (zie de genummerde stappen in
# Goal) - ✓ Beknopte instructies (de toonsectie is kort en duidelijk)
- ✓ Benadrukte cruciale stappen (“This step is important”)
- ✓ Indelingsconversie in parameterbeschrijvingen (normalisatie van e-mailadressen)
- ✓ Aparte sectie voor guardrails
- ✓ Nauwkeurige toolbeschrijvingen met richtlijnen voor wanneer/hoe/fouten
- ✓ Expliciete instructies voor foutafhandeling
Voorbeeld 2: Agent voor terugbetalingen bij klantenservice
Getoonde principes:
- ✓ Gespecialiseerde agentscope (alleen terugbetalingen, geen algemene support)
- ✓ Duidelijke workflowstappen in de sectie
# Goal - ✓ Herhaalde nadruk op cruciale regels (limieten voor terugbetalingen, verificatie)
- ✓ Gedetailleerd toolgebruik met “wanneer gebruiken” en “vereiste controles”
- ✓ Indelingsconversie in parameterbeschrijvingen (bestel-ID’s, e-mailadressen)
- ✓ Expliciete foutafhandeling per tool
- ✓ Duidelijk gedefinieerde escalatiecriteria
Best practices voor opmaak
Hoe je je prompt opmaakt, beïnvloedt hoe effectief het taalmodel deze interpreteert:
- Gebruik markdownkoppen: Structureer secties met
#voor hoofdsecties en##voor subsecties - Geef de voorkeur aan opsommingstekens: Verdeel instructies in overzichtelijke opsommingstekens
- Gebruik witruimte: Scheid secties en instructiegroepen met lege regels
- Houd koppen in zinsvorm:
# Goalen niet# GOAL - Wees consistent: Gebruik hetzelfde opmaakpatroon in de hele prompt
Veelgestelde vragen
Hoe behoud ik consistentie tussen meerdere agents?
Maak gedeelde prompttemplates voor veelvoorkomende onderdelen, zoals tekennormalisatie, foutafhandeling en vangrails. Bewaar deze in een centrale repository en verwijs ernaar vanuit gespecialiseerde agents. Gebruik het orchestratorpatroon voor consistente routeringslogica en overdrachtsprocedures.
Wat is de minimale werkbare prompt voor productie?
Neem minimaal het volgende op: (1) definitie van persoonlijkheid/rol, (2) primair doel, (3) kernvangrails en (4) toolbeschrijvingen als je tools gebruikt. Zelfs eenvoudige agents hebben baat bij een expliciete sectie- structuur en instructies voor foutafhandeling.
Hoe kan ik tools uitfaseren zonder agents te verstoren?
Voeg bij het uitfaseren van een tool eerst een nieuwe tool toe en pas daarna de prompt aan om de nieuwe tool te verkiezen, terwijl je de oude als terugvaloptie behoudt. Monitor het gebruik en verwijder de oude tool zodra het gebruik daalt tot nul. Neem altijd foutafhandeling op, zodat agents kunnen herstellen als een uitgefaseerde tool wordt aangeroepen.
Moet ik verschillende prompts gebruiken voor verschillende LLM's?
Over het algemeen werken prompts die zijn opgebouwd volgens de principes in deze handleiding voor verschillende modellen. Wel kan modelspecifieke afstemming de prestaties verbeteren, vooral voor het formaat van toolaanroepen en redeneer- stappen. Test je prompt met meerdere modellen en pas deze zo nodig aan.
Hoe lang moet mijn systeemprompt zijn?
Er is geen universele limiet, maar prompts van meer dan 2000 tokens verhogen de latentie en kosten. Richt je op beknoptheid: elke regel moet een duidelijk doel dienen. Als je prompt langer is dan 2000 tokens, overweeg dan deze op te splitsen in meerdere gespecialiseerde agents of referentiemateriaal onder te brengen in een kennisbank.
Hoe vind ik een balans tussen consistentie en aanpasbaarheid?
Leg kernpersoonlijkheidskenmerken, doelen en vangrails duidelijk vast, maar houd ruimte voor flexibiliteit in toon en beknoptheid op basis van de communicatiestijl van de gebruiker. Gebruik voorwaardelijke instructies: “Als de gebruiker gefrustreerd is, erken dan eerst diens zorgen voordat je doorgaat.”
Kan ik prompts na de implementatie bijwerken?
Ja. Systeemprompts kunnen op elk moment worden aangepast om gedrag bij te sturen. Dit is vooral nuttig om opkomende problemen aan te pakken of mogelijkheden te verfijnen op basis van gebruikersinteracties. Test wijzigingen altijd in een stagingomgeving voordat je ze in productie implementeert.
Hoe voorkom ik dat agents hallucineren wanneer tools falen?
Neem voor elke tool expliciete instructies voor foutafhandeling op. Benadruk in het gedeelte met vangrails: “gok nooit en verzin geen informatie”. Herhaal deze instructie in de foutafhandelingssecties die specifiek zijn voor tools. Test scenario’s waarin tools falen tijdens de ontwikkeling om ervoor te zorgen dat agents de herstel- instructies volgen.
Volgende stappen
Deze handleiding legt de basis voor betrouwbaar agentgedrag met prompt engineering, toolconfiguratie en architectuurpatronen. Ga voor systemen van productiekwaliteit verder met:
- Workflows: Ontwerp multi-agentorkestratie en overdrachten tussen specialisten
- Sucessevaluatie: Configureer metrics en evaluatiecriteria
- Gegevensverzameling: Leg gestructureerde inzichten uit gesprekken vast
- Testen: Implementeer regressietests en simulatie
- Vangrails: Configureer contentmoderatie voor veilige agentreacties
- Privacy: Zorg voor naleving en gegevensbescherming
- Onze Docs Agent: Bekijk een volledige casestudy waarin deze principes worden toegepast
Neem voor ondersteuning bij enterprise-implementatie contact op met ons team.