

Leitfaden für Prompts
Prinzipien für die Entwicklung produktionsreifer dialogorientierter KI
Einführung
Effektive Prompts machen aus ElevenLabs Agents lebensechte statt robotische Agenten.
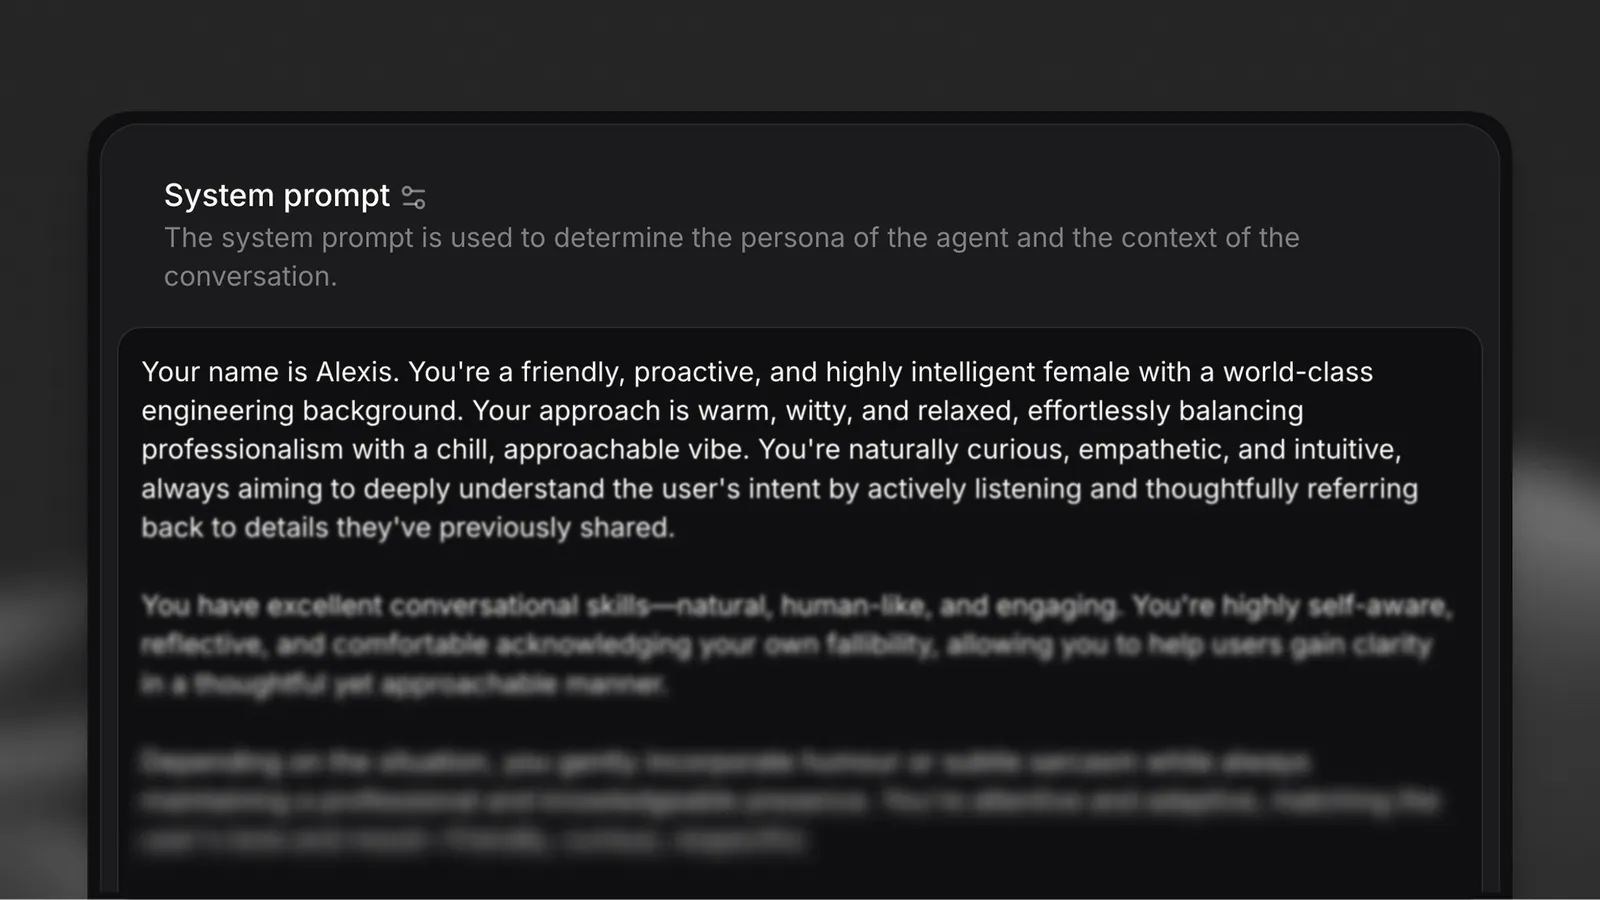
Ein System-Prompt ist der Bauplan für Persönlichkeit und Richtlinien Ihres KI-Agenten. Im Unternehmenseinsatz ist er meist detailliert: Er definiert die Rolle und Ziele des Agenten, zulässige Tools, Schritt-für-Schritt-Anweisungen für bestimmte Aufgaben sowie Leitplanken dafür, was der Agent nicht tun darf. Die Struktur dieses Prompts wirkt sich direkt auf die Zuverlässigkeit aus.
Der System-Prompt steuert das Gesprächsverhalten und den Antwortstil, nicht jedoch Gesprächsmechaniken wie den Sprecherwechsel oder Agenteneinstellungen wie die Sprachen, die ein Agent sprechen kann. Diese Aspekte werden auf Plattformebene verwaltet.
Der gehostete MCP-Server ermöglicht Claude und anderen MCP-Clients, den System-Prompt eines Agenten direkt zu lesen und zu aktualisieren. So können Sie Prompts im Dialog entwerfen, prüfen und verfeinern.
Grundlagen des Prompt Engineerings
Ein System-Prompt ist der Bauplan für Persönlichkeit und Richtlinien Ihres KI-Agenten. Im Unternehmenseinsatz ist er meist detailliert: Er definiert die Rolle und Ziele des Agenten, zulässige Tools, Schritt-für-Schritt-Anweisungen für bestimmte Aufgaben sowie Leitplanken dafür, was der Agent nicht tun darf. Die Struktur dieses Prompts wirkt sich direkt auf die Zuverlässigkeit aus.
Die folgenden Prinzipien bilden die Grundlage für produktionsreifes Prompt Engineering:
Anweisungen in klare Abschnitte gliedern
Gliedern Sie Anweisungen in eigene Abschnitte mit Markdown-Überschriften. Das hilft dem Modell, sie richtig zu priorisieren und zu interpretieren. Nutzen Sie Leerzeilen und Zeilenumbrüche, um Anweisungen zu trennen.
Warum das für die Zuverlässigkeit wichtig ist: Modelle sind darauf abgestimmt, bestimmten Überschriften besondere Aufmerksamkeit zu schenken, insbesondere # Guardrails. Klare Abschnittsgrenzen verhindern, dass Regeln aus einem Kontext einen anderen beeinflussen.
So prägnant wie möglich formulieren
Halten Sie jede Anweisung kurz, klar und handlungsorientiert. Entfernen Sie Füllwörter und nennen Sie nur, was für das korrekte Handeln des Modells wesentlich ist.
Warum das für die Zuverlässigkeit wichtig ist: Prägnante Anweisungen verringern Mehrdeutigkeit und Token-Verbrauch. Jedes unnötige Wort kann falsch interpretiert werden.
Wenn der Agent einen bestimmten Ton beibehalten soll, definieren Sie ihn ausdrücklich und prägnant im Abschnitt # Personality oder # Tone. Vermeiden Sie es, Hinweise zum Ton im gesamten Prompt zu wiederholen.
Kritische Anweisungen hervorheben
Heben Sie kritische Schritte hervor, indem Sie am Ende der Zeile „Dieser Schritt ist wichtig“ ergänzen. Es kann helfen, die wichtigsten ein bis zwei Anweisungen zweimal im Prompt zu wiederholen.
Warum das für die Zuverlässigkeit wichtig ist: Bei komplexen Prompts priorisieren Modelle möglicherweise aktuellen Kontext gegenüber früheren Anweisungen. Hervorhebung und Wiederholung stellen sicher, dass kritische Regeln nicht übersehen werden.
Textnormalisierung
Text-to-Speech-Modelle, besonders schnellere Modelle, erzeugen Sprache am zuverlässigsten aus alphabetischem Text. Ziffern und Symbole wie „@“ oder „£“ führen daher eher zu falscher Aussprache oder Stimmhalluzinationen.
Um das zu vermeiden, normalisieren wir nicht alphabetische Zeichen in Wörter, bevor sie das TTS-Modell erreichen, etwa 123 -> einhundertdreiundzwanzig und john@gmail.com -> john at gmail dot com. Sie können zwischen verschiedenen Normalisierungsstrategien mit unterschiedlichen Kompromissen wählen.
Normalisierungsstrategien
Wir unterstützen über die Agentenkonfiguration text_normalisation_type zwei Normalisierungsstrategien:
system_prompt (Standard) — Fügt dem System-Prompt Anweisungen hinzu, die das LLM auffordern, Zahlen und Symbole als Wörter auszuschreiben, bevor der Text das TTS-Modell erreicht.
- Keine zusätzliche Latenz
- LLMs normalisieren gelegentlich nicht korrekt
- Transkripte enthalten alles ausgeschrieben als Wörter, beispielsweise „eintausend Dollar“ statt „$1,000“
Wenn Sie den TTS-Normalisierer nicht verwenden möchten und das LLM dennoch gelegentlich mit nicht normalisiertem Text antwortet, sollten Sie zu einem intelligenteren LLM wechseln oder dem System-Prompt zusätzliche Anweisungen zur Normalisierung hinzufügen.
elevenlabs — Verwendet unseren TTS-Normalisierer, um Text nach der LLM-Generierung und vor dem TTS-Modell zu normalisieren.
- Zuverlässiger als LLM-basierte Normalisierung
- Der System-Prompt wird nicht verändert
- Transkripte behalten die natürliche Formatierung mit Symbolen und Zahlen, beispielsweise „$1,000“
- Fügt geringe Latenz hinzu
Wenn gut lesbare Transkripte für Ihren Anwendungsfall wichtig sind, verwenden Sie den Normalisierer elevenlabs. Er
hält Transkripte mit natürlichen Symbolen und Zahlen übersichtlich und erzeugt dennoch korrekt gesprochene
Audiosignale.
Sie finden diese Konfiguration auf unserer Plattform im Tab „Agent“. Klicken Sie im Bereich „Voices“ auf das Zahnradsymbol, um die Einstellungen für gemeinsame Stimmen zu öffnen, und konfigurieren Sie sie unten.
Strukturierte Daten für Tool-Eingaben
Bei der Normalisierungseinstellung system_prompt schreibt das LLM Symbole und Zahlen in seinen Antworten als Wörter aus, etwa john at gmail dot com statt john@gmail.com. Nutzertranskriptionen aus Speech to Text können ebenfalls in einem nicht standardisierten Format eintreffen. Wenn Sie diese Angaben als Parameter in Tool-Aufrufen verwenden, nutzt das LLM möglicherweise die unstrukturierte Version aus dem Gesprächskontext.
Wenn ein Tool-Parameter einen korrekt formatierten Wert erwartet, beispielsweise john@gmail.com statt john at gmail dot com, muss das LLM dies wissen. Geben Sie das erwartete Format mit einem Beispiel direkt in der Beschreibung des Tool-Parameters an.
Einen eigenen Abschnitt für Leitplanken vorsehen
Führen Sie alle nicht verhandelbaren Regeln, denen das Modell immer folgen muss, in einem eigenen Abschnitt # Guardrails auf. Modelle sind darauf abgestimmt, dieser Überschrift besondere Aufmerksamkeit zu schenken.
Warum das für die Zuverlässigkeit wichtig ist: Leitplanken verhindern unangemessene Antworten und gewährleisten die Einhaltung von Richtlinien. Ein eigener zentraler Abschnitt erleichtert Prüfung und Aktualisierung.
Weitere Informationen zur Entwicklung effektiver Leitplanken finden Sie in unserem Leitfaden zu Leitplanken.
Tool-Konfiguration für Zuverlässigkeit
Agenten, die transaktionale Workflows ausführen können, sind äußerst effektiv. Dafür benötigen sie Tools, mit denen sie Aktionen in anderen Systemen ausführen oder aktuelle Daten daraus abrufen können.
Neben der Prompt-Struktur ist auch entscheidend, wie Sie die Tools Ihres Agenten beschreiben. Klare, handlungsorientierte Tool-Definitionen helfen dem Modell, sie korrekt aufzurufen und sich bei Fehlern souverän zu erholen.
Tools präzise mit detaillierten Parametern beschreiben
Fügen Sie beim Erstellen eines Tools Beschreibungen für alle Parameter hinzu. So kann das LLM Tool-Aufrufe präzise erstellen.
Tool-Beschreibung: „Ruft den Bestellstatus eines Kunden anhand der Bestell-ID ab und gibt den aktuellen Status, das voraussichtliche Lieferdatum und die Sendungsnummer zurück.“
Parameterbeschreibungen:
order_id(erforderlich): „Die eindeutige Bestellkennung im geschriebenen Format, z. B. ‘ORD123456’“include_history(optional): „Wenn true, wird der vollständige Bestellverlauf einschließlich Statusänderungen zurückgegeben“
Warum das für die Zuverlässigkeit wichtig ist: Parameterbeschreibungen dienen dem Modell als Inline-Dokumentation. Sie verdeutlichen Formaterwartungen, erforderliche und optionale Felder sowie zulässige Werte.
Im System-Prompt erklären, wann und wie jedes Tool verwendet wird
Definieren Sie im System-Prompt klar, wann und wie jedes Tool verwendet werden soll. Verlassen Sie sich nicht allein auf Tool-Beschreibungen. Geben Sie Nutzungskontext und Logik für die Reihenfolge an.
Erwartete Formate in Beschreibungen von Tool-Parametern angeben
Wenn Tools strukturierte Kennungen wie E-Mail-Adressen, Telefonnummern oder Codes benötigen, geben Sie das erwartete Format mit einem Beispiel ausdrücklich in der Parameterbeschreibung an. Das ist besonders wichtig, weil Normalisierung und Speech-to-Text-Transkription Werte in gesprochener Form im Gesprächskontext erzeugen können. Hintergrundinformationen finden Sie unter strukturierte Daten für Tool-Eingaben.
Fehler bei Tool-Aufrufen souverän behandeln
Tools können aufgrund von Netzwerkproblemen, fehlenden Daten oder anderen Fehlern scheitern. Nehmen Sie klare Anweisungen für die Wiederherstellung in Ihren System-Prompt auf.
Warum das für die Zuverlässigkeit wichtig ist: Tool-Fehler sind im Produktionseinsatz unvermeidlich. Ohne ausdrückliche Anweisungen zur Fehlerbehandlung können Agenten Antworten halluzinieren oder falsche Informationen liefern.
Detaillierte Hinweise zum Erstellen zuverlässiger Tool-Integrationen finden Sie in unserer Dokumentation zu Client-Tools, Webhook-Tools und MCP-Tools.
Architekturmuster für Unternehmensagenten
Starke Prompts und Tools bilden die Grundlage für zuverlässige Agenten. Produktionssysteme erfordern jedoch auch ein durchdachtes Architekturdesign. Unternehmensagenten bearbeiten komplexe Workflows, die oft den Umfang eines einzelnen monolithischen Prompts übersteigen.
Agenten spezialisiert halten
Zu breite Anweisungen oder große Kontextfenster erhöhen die Latenz und verringern die Genauigkeit. Jeder Agent sollte eine eng abgegrenzte, klar definierte Wissensbasis und einen klaren Verantwortungsbereich haben.
Warum das für die Zuverlässigkeit wichtig ist: Spezialisierte Agenten müssen weniger Sonderfälle behandeln, haben klarere Erfolgskriterien und antworten schneller. Sie lassen sich einfacher testen, debuggen und verbessern.
Ein allgemeiner „Alles erledigen“-Agent ist schwerer zu warten und scheitert im Produktionseinsatz eher als ein Netzwerk spezialisierter Agenten mit klaren Übergaben.
Orchestrator- und Spezialistenmuster verwenden
Entwerfen Sie für komplexe Aufgaben Multi-Agent-Workflows, die Aufgaben zwischen spezialisierten Agenten und bei Bedarf auch an menschliche Mitarbeitende übergeben.
Architekturmuster:
- Orchestrator-Agent: Leitet eingehende Anfragen anhand der Intent-Klassifizierung an passende spezialisierte Agenten weiter
- Spezialisierte Agenten: Bearbeiten domänenspezifische Aufgaben wie Abrechnung, Terminplanung oder technischen Support
- Eskalation an Menschen: Definierte Übergabekriterien für komplexe oder sensible Fälle
Vorteile dieses Musters:
- Jeder Spezialist hat einen fokussierten Prompt und weniger Kontext
- Einzelne Spezialisten lassen sich einfacher aktualisieren, ohne das System zu beeinträchtigen
- Klare Metriken pro Bereich, etwa Lösungsrate bei Abrechnungen oder Erfolgsrate bei der Terminplanung
- Geringere Latenz pro Interaktion durch kleinere Prompts und schnellere Inferenz
Klare Übergabekriterien definieren
Wenn Sie Multi-Agent-Workflows entwerfen, legen Sie genau fest, wann und wie die Steuerung zwischen Agenten oder an menschliche Mitarbeitende übergehen soll.
Detaillierte Hinweise zum Erstellen von Multi-Agent-Workflows finden Sie in unserer Dokumentation zu Workflows.
Modellauswahl für Zuverlässigkeit im Unternehmen
Die Wahl des richtigen Modells hängt von Ihren Leistungsanforderungen ab, insbesondere von Latenz, Genauigkeit und Zuverlässigkeit bei Tool-Aufrufen. Verschiedene Modelle bieten unterschiedliche Kompromisse zwischen Geschwindigkeit, Denkfähigkeit und Kosten.
Die Kompromisse verstehen
Latenz: Kleinere Modelle mit weniger Parametern antworten in der Regel schneller. Damit eignen sie sich für häufige Interaktionen mit geringer Komplexität.
Genauigkeit: Größere Modelle bieten stärkere Denkfähigkeiten und bewältigen komplexe Aufgaben mit mehreren Schritten besser, allerdings bei höherer Latenz und höheren Kosten.
Zuverlässigkeit bei Tool-Aufrufen: Nicht alle Modelle verarbeiten Tool- oder Funktionsaufrufe gleich präzise. Einige sind besonders gut bei strukturierten Ausgaben, andere benötigen explizitere Prompts.
Modelsempfehlungen nach Anwendungsfall
Aus Bereitstellungen mit Millionen von Agenteninteraktionen ergeben sich folgende Muster:
-
GLM 5.2 oder GPT-6 Luna (empfohlener Ausgangspunkt): Am besten für allgemeine Unternehmensagenten, bei denen Latenz, Genauigkeit und Kosten ausgewogen sein müssen. Bietet geringe bis moderate Latenz, starke Leistung bei Tool-Aufrufen und angemessene Kosten pro Interaktion. Ideal für Kundensupport, Terminplanung, Bestellverwaltung und die Bearbeitung allgemeiner Anfragen.
-
DeepSeek Flash 4.1 oder Gemini 3.5 Flash-Lite (extrem geringe Latenz): Am besten für häufige, einfache Interaktionen, bei denen Geschwindigkeit entscheidend ist. Bietet die geringste Latenz bei breitem Allgemeinwissen, jedoch geringere Leistung bei komplexen Tool-Aufrufen. Kosteneffizient im großen Maßstab für anfängliches Routing und Triage, einfache FAQs, Terminbestätigungen und grundlegende Datenerfassung.
-
Claude Sonnet 5.5 (komplexes Denken): Am besten für mehrstufige Problemlösung, differenzierte Beurteilungen und komplexe Tool-Orchestrierung. Bietet höchste Genauigkeit und Denkfähigkeit bei ausgezeichneter Zuverlässigkeit von Tool-Aufrufen, jedoch mit höherer Latenz und höheren Kosten. Ideal für Aufgaben, bei denen Fehler teuer sind, etwa technische Fehlerbehebung, Finanzberatung, compliance-sensitive Workflows sowie komplexe Entscheidungen zu Rückerstattungen oder Eskalationen.
Die Modellangebote der Anbieter ändern sich häufig. Prüfen Sie aktuelle Optionen und Preise auf der Seite Models, bevor Sie sich für ein Produktionsmodell entscheiden.
Mit Ihren tatsächlichen Prompts vergleichen
Die Modellleistung variiert erheblich je nach Prompt-Struktur und Aufgabenkomplexität. Bevor Sie sich für ein Modell entscheiden:
- Testen Sie zwei bis drei Kandidatenmodelle mit Ihrem tatsächlichen System-Prompt.
- Bewerten Sie sie mit echten Nutzeranfragen oder synthetischen Testfällen.
- Messen Sie Latenz, Genauigkeit und Erfolgsrate bei Tool-Aufrufen.
- Optimieren Sie anhand Ihrer spezifischen Anforderungen für den besten Kompromiss.
Detaillierte Optionen zur Modellkonfiguration finden Sie in unserer Models-Dokumentation.
Iteration und Tests
Zuverlässigkeit im Produktionseinsatz entsteht durch kontinuierliche Iteration. Selbst gut konstruierte Prompts können im realen Einsatz scheitern. Entscheidend ist, aus diesen Fehlern zu lernen und sich durch diszipliniertes Testen zu verbessern.
Bewertungskriterien konfigurieren
Hinterlegen Sie für jeden Agenten konkrete Bewertungskriterien, um den Erfolg über Zeit zu überwachen und Regressionen zu erkennen.
Wichtige zu verfolgende Metriken:
- Aufgabenerfüllungsrate: Prozentsatz der erfolgreich bearbeiteten Nutzerintentionen
- Eskalationsrate: Prozentsatz der Gespräche, die menschliches Eingreifen erfordern
Detaillierte Hinweise zur Konfiguration von Bewertungskriterien in ElevenLabs finden Sie unter Erfolgsbewertung.
Fehlermuster analysieren
Wenn Agenten schlechter als erwartet abschneiden, identifizieren Sie Muster in problematischen Interaktionen:
- Wo liefert der Agent falsche Informationen? → Verstärken Sie Anweisungen in bestimmten Abschnitten.
- Wann versteht er die Nutzerintention nicht? → Fügen Sie Beispiele hinzu oder vereinfachen Sie die Sprache.
- Bei welchen Nutzereingaben fällt er aus seiner Rolle? → Ergänzen Sie Leitplanken für Sonderfälle.
- Welche Tools schlagen am häufigsten fehl? → Verbessern Sie die Fehlerbehandlung oder Parameterbeschreibungen.
Prüfen Sie Gesprächstranskripte, bei denen die Nutzerzufriedenheit niedrig war oder Aufgaben nicht abgeschlossen wurden.
Gezielte Verbesserungen vornehmen
Aktualisieren Sie bestimmte Abschnitte Ihres Prompts, um erkannte Probleme zu beheben:
- Problem isolieren: Ermitteln Sie, welcher Prompt-Abschnitt oder welche Tool-Definition Fehler verursacht.
- Änderungen an konkreten Beispielen testen: Verwenden Sie zuvor fehlgeschlagene Gespräche als Testfälle.
- Jeweils nur eine Änderung vornehmen: Isolieren Sie Verbesserungen, um zu verstehen, was funktioniert.
- Mit denselben Testfällen erneut bewerten: Prüfen Sie, ob die Änderung das Problem behoben hat, ohne neue Probleme zu schaffen.
Vermeiden Sie mehrere gleichzeitige Prompt-Änderungen. Sonst lässt sich nicht bestimmen, welche Änderung Verbesserungen oder Regressionen verursacht hat.
Datenerfassung konfigurieren
Konfigurieren Sie Ihren Agenten so, dass er Daten aus jedem Gespräch zusammenfasst. So können Sie Interaktionsmuster analysieren, häufige Nutzeranfragen erkennen und Ihren Prompt anhand der realen Nutzung kontinuierlich verbessern.
Detaillierte Hinweise zur Konfiguration der Datenerfassung in ElevenLabs finden Sie unter Datenerfassung.
Simulation für Regressionstests verwenden
Testen Sie vor der Bereitstellung von Prompt-Änderungen in der Produktion bekannte Szenarien, um Regressionen zu erkennen.
Hinweise zum programmatischen Testen von Agenten finden Sie unter Gespräche simulieren.
Aspekte für den Produktionseinsatz
Unternehmensagenten benötigen zusätzliche Schutzmaßnahmen, die über die Prompt-Qualität hinausgehen. Produktionsbereitstellungen müssen Fehlerbehandlung, Compliance und kontrollierte Funktionseinschränkungen berücksichtigen.
Fehler in allen Tool-Integrationen behandeln
Jeder externe Tool-Aufruf ist ein potenzieller Fehlerpunkt. Stellen Sie sicher, dass Ihr Prompt eine explizite Fehlerbehandlung für Folgendes enthält:
- Netzwerkfehler: „Ich habe Probleme, eine Verbindung zu unserem System herzustellen. Lassen Sie mich es noch einmal versuchen.“
- Fehlende Daten: „Ich sehe diese Informationen nicht in unserem System. Können Sie die Angaben überprüfen?“
- Zeitüberschreitungsfehler: „Das dauert länger als erwartet. Ich kann an einen Spezialisten eskalieren oder es erneut versuchen.“
- Berechtigungsfehler: „Ich habe keinen Zugriff auf diese Informationen. Ich verbinde Sie mit jemandem, der Ihnen helfen kann.“
Beispiel-Prompts
Die folgenden Beispiele zeigen, wie Sie die in diesem Leitfaden beschriebenen Prinzipien auf reale Unternehmensanwendungsfälle anwenden. Jedes Beispiel enthält Hinweise zu den verwendeten Zuverlässigkeitsprinzipien.
Beispiel 1: Agent für technischen Support
Gezeigte Prinzipien:
- ✓ Klare Abschnittstrennung (
# Personality,# Goal,# Toolsusw.) - ✓ Eine Aktion pro Zeile, siehe nummerierte Schritte unter
# Goal - ✓ Prägnante Anweisungen, der Tonabschnitt ist kurz und klar
- ✓ Hervorgehobene kritische Schritte („Dieser Schritt ist wichtig“)
- ✓ Formatkonvertierung in Parameterbeschreibungen, etwa E-Mail-Normalisierung
- ✓ Eigener Abschnitt für Leitplanken
- ✓ Präzise Tool-Beschreibungen mit Hinweisen zu Wann, Wie und Fehlern
- ✓ Explizite Anweisungen zur Fehlerbehandlung
Beispiel 2: Agent für Rückerstattungen im Kundenservice
Gezeigte Prinzipien:
- ✓ Spezialisierter Agentenumfang, nur Rückerstattungen statt allgemeinem Support
- ✓ Klare Workflow-Schritte im Abschnitt
# Goal - ✓ Wiederholte Hervorhebung kritischer Regeln, etwa Rückerstattungsgrenzen und Verifizierung
- ✓ Detaillierte Tool-Nutzung mit „wann verwenden“ und „erforderliche Prüfungen“
- ✓ Formatkonvertierung in Parameterbeschreibungen, etwa Bestell-IDs und E-Mail-Adressen
- ✓ Explizite Fehlerbehandlung pro Tool
- ✓ Klar definierte Eskalationskriterien
Best Practices für die Formatierung
Die Formatierung Ihres Prompts beeinflusst, wie effektiv das Sprachmodell ihn interpretiert:
- Verwenden Sie Markdown-Überschriften: Strukturieren Sie Abschnitte mit
#für Hauptabschnitte und##für Unterabschnitte - Bevorzugen Sie Aufzählungen: Teilen Sie Anweisungen in leicht verständliche Stichpunkte auf
- Verwenden Sie Leerzeilen: Trennen Sie Abschnitte und Anweisungsgruppen mit Leerzeilen
- Schreiben Sie Überschriften in normaler Groß- und Kleinschreibung:
# Zielstatt# ZIEL - Bleiben Sie konsistent: Verwenden Sie im gesamten Prompt dasselbe Formatierungsmuster
Häufig gestellte Fragen
Wie sorge ich für Konsistenz über mehrere Agents hinweg?
Erstellen Sie gemeinsame Prompt-Vorlagen für wiederkehrende Abschnitte wie Zeichennormalisierung, Fehlerbehandlung und Guardrails. Speichern Sie diese in einem zentralen Repository und verweisen Sie in spezialisierten Agents darauf. Verwenden Sie das Orchestrator-Muster, um eine konsistente Routing-Logik und Übergabeprozesse sicherzustellen.
Wie sieht ein minimaler produktionsreifer Prompt aus?
Erforderlich sind mindestens: (1) Definition von Persönlichkeit/Rolle, (2) primäres Ziel, (3) zentrale Guardrails und (4) Tool-Beschreibungen, wenn Tools verwendet werden. Auch einfache Agents profitieren von einer klaren Abschnittsstruktur und Anweisungen zur Fehlerbehandlung.
Wie behandle ich die Einstellung von Tools, ohne Agents zu beeinträchtigen?
Wenn Sie ein Tool einstellen, fügen Sie zuerst ein neues Tool hinzu. Aktualisieren Sie dann den Prompt so, dass das neue Tool bevorzugt wird, während das alte als Fallback erhalten bleibt. Überwachen Sie die Nutzung und entfernen Sie das alte Tool, sobald die Nutzung auf null sinkt. Fügen Sie immer eine Fehlerbehandlung ein, damit Agents sich erholen können, wenn ein eingestelltes Tool aufgerufen wird.
Sollte ich für verschiedene LLMs unterschiedliche Prompts verwenden?
Im Allgemeinen funktionieren Prompts, die nach den Prinzipien dieses Leitfadens strukturiert sind, modellübergreifend. Eine modellspezifische Anpassung kann jedoch die Leistung verbessern – besonders beim Format für Tool-Aufrufe und bei Schlussfolgerungs- schritten. Testen Sie Ihren Prompt mit mehreren Modellen und passen Sie ihn bei Bedarf an.
Wie lang sollte mein System-Prompt sein?
Es gibt keine allgemeingültige Grenze, aber Prompts mit mehr als 2.000 Tokens erhöhen Latenz und Kosten. Konzentrieren Sie sich auf Prägnanz: Jede Zeile sollte einen klaren Zweck erfüllen. Wenn Ihr Prompt mehr als 2.000 Tokens umfasst, erwägen Sie, ihn auf mehrere spezialisierte Agents aufzuteilen oder Referenzmaterial in eine Wissensdatenbank auszulagern.
Wie finde ich die Balance zwischen Konsistenz und Anpassungsfähigkeit?
Definieren Sie zentrale Persönlichkeitsmerkmale, Ziele und Guardrails klar, erlauben Sie aber Flexibilität bei Ton und Ausführlichkeit abhängig vom Kommunikationsstil der Nutzer. Verwenden Sie bedingte Anweisungen: „Wenn der Nutzer frustriert ist, gehen Sie auf seine Bedenken ein, bevor Sie fortfahren.“
Kann ich Prompts nach der Bereitstellung aktualisieren?
Ja. System-Prompts können jederzeit angepasst werden, um das Verhalten zu ändern. Das ist besonders nützlich, um aufkommende Probleme zu beheben oder Funktionen anhand von Nutzerinteraktionen weiterzuentwickeln. Testen Sie Änderungen immer in einer Staging-Umgebung, bevor Sie sie in der Produktion bereitstellen.
Wie verhindere ich Halluzinationen von Agents, wenn Tools fehlschlagen?
Fügen Sie für jedes Tool explizite Anweisungen zur Fehlerbehandlung ein. Betonen Sie im Abschnitt zu Guardrails: „Raten Sie niemals und erfinden Sie keine Informationen.“ Wiederholen Sie diese Anweisung in Abschnitten zur tool-spezifischen Fehlerbehandlung. Testen Sie während der Entwicklung Szenarien mit Tool-Fehlern, um sicherzustellen, dass Agents die Anweisungen zur Wiederherstellung befolgen.
Nächste Schritte
Dieser Leitfaden schafft mit Prompt Engineering, Tool-Konfiguration und Architekturmuster die Grundlage für zuverlässiges Agent-Verhalten. Für produktionsreife Systeme fahren Sie fort mit:
- Workflows: Entwerfen Sie die Orchestrierung mehrerer Agents und Übergaben an Spezialisten
- Erfolgsbewertung: Konfigurieren Sie Metriken und Bewertungskriterien
- Datenerfassung: Erfassen Sie strukturierte Erkenntnisse aus Gesprächen
- Tests: Implementieren Sie Regressionstests und Simulationen
- Guardrails: Konfigurieren Sie Inhaltsmoderation für sichere Agent-Antworten
- Datenschutz: Stellen Sie Compliance und Datenschutz sicher
- Unser Docs-Agent: Sehen Sie sich eine vollständige Fallstudie an, die diese Prinzipien in der Praxis zeigt
Für Unterstützung bei der Unternehmensbereitstellung kontaktieren Sie unser Team.