

Best Practices
Erfahren Sie, wie Sie Sprechweise, Aussprache und Emotionen steuern und Text für Sprache optimieren.
Dieser Leitfaden bietet Techniken, um Text-to-Speech-Ausgaben mit ElevenLabs-Modellen zu verbessern. Experimentieren Sie mit diesen Methoden, um herauszufinden, was für Ihre Anforderungen am besten funktioniert.
Steuerung
Wir arbeiten aktiv am Director’s Mode, damit Sie noch mehr Kontrolle über die Ausgaben erhalten.
Diese Techniken bieten eine praktische Möglichkeit, differenzierte Ergebnisse zu erzielen, bis erweiterte Funktionen wie der Director’s Mode verfügbar sind.
Pausen
Eleven v3 unterstützt keine SSML-Break-Tags. Nutzen Sie die im Abschnitt Prompting Eleven v3 beschriebenen Techniken, um Pausen mit v3 zu steuern.
Verwenden Sie <break time="x.xs" /> für natürliche Pausen von bis zu 3 Sekunden.
Zu viele Break-Tags in einer einzelnen Generierung können Instabilität verursachen. Die KI kann schneller sprechen oder zusätzliche Geräusche oder Audioartefakte erzeugen. Wir arbeiten an einer Lösung.
- Konsistenz: Verwenden Sie
<break>-Tags einheitlich, um einen natürlichen Sprachfluss zu erhalten. Übermäßige Verwendung kann zu Instabilität führen. - Stimmenspezifisches Verhalten: Verschiedene Stimmen können Pausen unterschiedlich behandeln, insbesondere Stimmen, die mit Fülllauten wie „uh“ oder „ah“ trainiert wurden.
Alternativen zu <break> sind Bindestriche (- oder —) für kurze Pausen oder Auslassungspunkte (…) für zögerliche Töne. Diese sind jedoch weniger konsistent.
Aussprache
IPA mit Eleven v3
Das Modell Eleven v3 (eleven_v3) unterstützt die Transkription mit dem Internationalen Phonetischen Alphabet (IPA) nativ in über 70 Sprachen. Damit können Sie die Aussprache von Wörtern und Phrasen präzise steuern, ohne XML-Tags zu verwenden.
Anders als ältere Modelle, die Phonem-Tags im XML-Stil erfordern, versteht v3 IPA-Symbole nativ, wenn Sie sie direkt in Ihrem Text in Schrägstriche einschließen:
Die IPA-Transkription sollte:
- am Anfang und Ende in Schrägstriche (
/) eingeschlossen sein - mit standardmäßigen IPA-Symbolen geschrieben sein
- bei der Übergabe als String-Parameter in doppelte Anführungszeichen eingeschlossen sein
Codebeispiele
Sie können mehrere IPA-Transkriptionen in einem einzelnen Textstring verwenden:
Leistung
Die IPA-Unterstützung von v3 erreicht eine Aussprachekonsistenz von 80–90 %. Sie ist deutlich zuverlässiger als die XML-Phonem-Tags von v2, aber nicht zu 100 % konsistent. Das Modell kann gelegentlich Schwierigkeiten mit bestimmten Wörtern haben oder selbst bei identischen IPA-Transkriptionen unterschiedliche Ausgaben erzeugen. Wir verbessern die Zuverlässigkeit von IPA fortlaufend.
Best Practices
- Verwenden Sie standardmäßige IPA-Symbole aus der Tabelle des Internationalen Phonetischen Alphabets
- Verwenden Sie Betonungszeichen: Hauptbetonung (ˈ) und Nebenbetonung (ˌ) für mehrsilbige Wörter
- Gezielt anwenden: Umschließen Sie nur bestimmte Wörter oder Phrasen, deren Aussprache gesteuert werden muss
- Mit Ihrer Stimme testen: Verschiedene Stimmen können IPA leicht unterschiedlich interpretieren
Fehlerbehebung
Die Aussprache ist weiterhin falsch
Prüfen Sie mit einem IPA-Wörterbuch, ob Ihre IPA-Transkription korrekt ist. Verwenden Sie bei mehrsilbigen Wörtern Betonungszeichen (ˈ für Hauptbetonung, ˌ für Nebenbetonung). Testen Sie verschiedene Stimmen, da manche IPA genauer interpretieren als andere.
Inkonsistente Ergebnisse mit derselben IPA-Transkription
Die IPA-Unterstützung von v3 ist im Allgemeinen zuverlässig, aber nicht perfekt. Das Modell kann gelegentlich selbst bei identischen IPA-Transkriptionen unterschiedliche Ausgaben erzeugen. Wenn Konsistenz entscheidend ist, testen Sie mehrere Generierungen und wählen Sie das beste Ergebnis aus.
Phonem-Tags für v2-Modelle
Geben Sie die Aussprache bei v2-Modellen mit SSML-Phonem-Tags an. Unterstützte Alphabete umfassen CMU Arpabet und das Internationale Phonetische Alphabet (IPA).
Phonem-Tags sind nur mit dem Modell eleven_flash_v2 kompatibel.
Für konsistente und vorhersehbare Ergebnisse mit v2-Modellen empfehlen wir CMU Arpabet. IPA kann zwar effektiv sein, CMU Arpabet bietet jedoch im Allgemeinen zuverlässigere Ergebnisse.
Phonem-Tags funktionieren nur für einzelne Wörter. Wenn Sie einen Vor- und Nachnamen haben, der auf eine bestimmte Weise ausgesprochen werden soll, müssen Sie für jedes Wort ein Phonem-Tag erstellen.
Achten Sie bei mehrsilbigen Wörtern auf die korrekte Betonungsmarkierung, damit die Aussprache präzise bleibt:
Alias-Tags
Für Modelle, die keine Phonem-Tags unterstützen, können Sie versuchen, Wörter phonetischer zu schreiben. Sie können auch verschiedene Tricks einsetzen, etwa Großbuchstaben, Bindestriche, Apostrophe oder sogar einfache Anführungszeichen um einen einzelnen Buchstaben oder mehrere Buchstaben.
Ein Wort wie „trapezii“ könnte beispielsweise als „trapezIi“ geschrieben werden, um das „ii“ im Wort stärker zu betonen.
Sie können das Wort entweder direkt in Ihrem Text ersetzen. Wenn Sie bei der Verwendung eines Aussprachewörterbuchs die Aussprache durch andere Wörter oder Phrasen angeben möchten, können Sie dafür Alias-Tags verwenden. Das kann nützlich sein, wenn Sie mit Multilingual v2 generieren, das keine Phonem-Tags unterstützt. Sie können Aussprachewörterbücher mit ElevenCreative Studio, Synchronisationsstudio und Sprachsynthese über die API verwenden.
Wenn Ihr Text beispielsweise einen Namen enthält, dessen ungewöhnliche Aussprache für die KI schwierig sein könnte, können Sie mit einem Alias-Tag festlegen, wie er ausgesprochen werden soll:
Wenn Sie sicherstellen möchten, dass ein Akronym bei jedem Vorkommen in Ihrem Text auf eine bestimmte Weise gesprochen wird, können Sie dies mit einem Alias-Tag festlegen:
Aussprachewörterbücher
Einige unserer Tools, etwa ElevenCreative Studio und Synchronisationsstudio, ermöglichen es Ihnen, ein Aussprachewörterbuch zu erstellen und hochzuladen. Damit können Sie die Aussprache bestimmter Wörter wie Charakter- oder Markennamen festlegen oder bestimmen, wie Akronyme gelesen werden sollen.
Aussprachewörterbücher ermöglichen diese Funktion, indem Sie eine Lexikon- oder Wörterbuchdatei hochladen, die Wortpaare und ihre Aussprache festlegt – entweder über ein phonetisches Alphabet oder Wortersetzungen.
Immer wenn eines dieser Wörter in einem Projekt vorkommt, spricht das KI-Modell das Wort mit der angegebenen Ersetzung aus.
Um eine Aussprachewörterbuchdatei bereitzustellen, öffnen Sie die Einstellungen eines Projekts und laden Sie eine Datei im TXT- oder im .PLS-Format hoch. Wenn Sie einem Projekt ein Wörterbuch hinzufügen, wird automatisch neu berechnet, welche Teile des Projekts mit der neuen Wörterbuchdatei erneut konvertiert werden müssen. Diese werden als nicht konvertiert markiert.
Derzeit unterstützen wir nur Aussprachewörterbücher, die Ersetzungen mit Phonem- oder Alias-Tags festlegen.
Sowohl Phoneme als auch Aliasse sind Regelsets, die ein gesuchtes Wort oder eine Phrase festlegen, das beziehungsweise die als Graphem bezeichnet wird, sowie die entsprechende Ersetzung. Beachten Sie, dass die Suche zwischen Groß- und Kleinschreibung unterscheidet. Bei der Suche nach einem Ersatzwort in einem Aussprachewörterbuch wird das Wörterbuch von Anfang bis Ende geprüft und nur die allererste Ersetzung verwendet.
Beispiele für Aussprachewörterbücher
Hier sind Beispiele für Aussprachewörterbücher in CMU Arpabet und IPA. Sie enthalten ein Phonem zur Festlegung der Aussprache von „Apple“ und einen Alias, der „UN“ durch „United Nations“ ersetzt:
Zum Erstellen einer .pls-Datei für ein Aussprachewörterbuch stehen einige Open-Source-Tools zur Verfügung:
- Sequitur G2P – Open-Source-Tool, das Aussprachemuster aus Daten lernt und phonetische Transkriptionen erstellen kann.
- Phonetisaurus – Open-Source-G2P-System, das mit bestehenden Wörterbüchern wie CMUdict trainiert wurde.
- eSpeak – Sprachsynthesizer, der Phonem-Transkriptionen aus Text erstellen kann.
- CMU Pronouncing Dictionary – Vorgefertigtes englisches Wörterbuch mit phonetischen Transkriptionen.
Emotion
Vermitteln Sie Emotionen durch erzählerischen Kontext oder explizite Dialog-Tags. So kann die KI den nachzuahmenden Ton und die Emotion besser verstehen.
Explizite Dialog-Tags liefern vorhersehbarere Ergebnisse, als sich ausschließlich auf den Kontext zu verlassen. Das Modell spricht die Hinweise zur emotionalen Darbietung jedoch weiterhin mit. Falls unerwünscht, können diese in der Nachbearbeitung mit einem Audioeditor entfernt werden.
Tempo
Das Tempo des Audios wird stark durch das Audio beeinflusst, das zur Erstellung der Stimme verwendet wird. Beim Erstellen Ihrer Stimme empfehlen wir längere, zusammenhängende Samples, um Probleme wie unnatürlich schnelles Sprechen zu vermeiden.
Um die Geschwindigkeit des generierten Audios zu steuern, können Sie die Geschwindigkeitseinstellung verwenden. Damit können Sie die generierte Sprache beschleunigen oder verlangsamen. Die Geschwindigkeitseinstellung ist für Text to Speech über die Website und API sowie in ElevenCreative Studio und auf der Agents Platform verfügbar. Sie finden sie in den Stimmeinstellungen.
Der Standardwert ist 1.0. Das bedeutet, dass die Geschwindigkeit nicht angepasst wird. Werte unter 1.0 verlangsamen die Stimme bis zu einem Minimum von 0.7. Werte über 1.0 beschleunigen die Stimme bis zu einem Maximum von 1.2. Extreme Werte können die Qualität der generierten Sprache beeinträchtigen.
Das Tempo lässt sich auch durch einen natürlichen, erzählerischen Schreibstil steuern.
Tipps
Häufige Probleme
Inkonsistente Pausen: Stellen Sie sicher, dass für Pausen die Syntax
<break time=“x.xs” />verwendet wird.- Aussprachfehler: Verwenden Sie CMU-Arpabet- oder IPA-Phonem-Tags für eine präzise Aussprache.
Unpassende Emotion: Fügen Sie erzählerischen Kontext oder explizite Tags hinzu, um die Emotion zu steuern. Denken Sie daran, alle Texte zur emotionalen Steuerung in der Nachbearbeitung zu entfernen.
Tipps zur Verbesserung der Ausgabe
Experimentieren Sie mit alternativen Formulierungen, um das gewünschte Tempo oder die gewünschte Emotion zu erzielen. Teilen Sie Prompts für komplexe Soundeffekte in kleinere aufeinanderfolgende Elemente auf und kombinieren Sie die Ergebnisse manuell.
Kreative Kontrolle
Während wir aktiv einen „Director’s Mode“ entwickeln, um Nutzern noch mehr Kontrolle über Ausgaben zu geben, können Sie mit den folgenden Techniken Kreativität und Präzision maximieren:
Erzählerischer Stil
Schreiben Sie Prompts in einem erzählerischen Stil, ähnlich wie Drehbücher, um Ton und Tempo effektiv zu steuern.
Geschichtete Ausgaben
Generieren Sie Soundeffekte oder Sprache in Segmenten und legen Sie sie mit Audiobearbeitungssoftware übereinander, um komplexere Kompositionen zu erstellen.
Phonetische Experimente
Wenn die Aussprache nicht perfekt ist, experimentieren Sie mit alternativen Schreibweisen oder phonetischen Annäherungen, um die gewünschten Ergebnisse zu erzielen.
Textnormalisierung
Bei der Nutzung von Text to Speech mit komplexen Elementen wie Telefonnummern, Postleitzahlen und E-Mails kann es zu falscher Aussprache kommen. Das liegt oft daran, dass diese Elemente nicht im Trainingsdatensatz enthalten sind und kleinere Modelle ihre Aussprache nicht zuverlässig verallgemeinern können. Dieser Leitfaden erklärt, wann diese Abweichungen auftreten und wie Sie die korrekte Aussprache erzielen.
Die Normalisierung ist für alle TTS-Modelle standardmäßig aktiviert und verbessert die Aussprache von Zahlen, Daten und anderen komplexen Textelementen.
Warum lesen Modelle Eingaben unterschiedlich vor?
Bestimmte Modelle sind darauf trainiert, Zahlen und Formulierungen menschlicher vorzulesen. So wird die Formulierung “$1,000,000” vom Modell Eleven Multilingual v2 korrekt als “one million dollars” vorgelesen. Das Modell Eleven Flash v2.5 liest dieselbe Formulierung jedoch als “one thousand thousand dollars” vor.
Der Grund dafür ist, dass Multilingual v2 ein größeres Modell ist und das Vorlesen von Zahlen auf eine für menschliche Zuhörer natürlichere Weise besser verallgemeinern kann. Flash v2.5 ist hingegen deutlich kleiner und kann das daher nicht.
Häufige Beispiele
Text to Speech-Modelle können mit Folgendem Schwierigkeiten haben:
- Telefonnummern (“123-456-7890”)
- Währungen (“$47,345.67”)
- Kalenderereignissen (“2024-01-01”)
- Uhrzeiten (“9:23 AM”)
- Adressen (“123 Main St, Anytown, USA”)
- URLs (“example.com/link/to/resource”)
- Abkürzungen für Einheiten (“TB” statt “Terabyte”)
- Tastenkürzeln (“Ctrl + Z”)
Maßnahmen
Trainierte Modelle verwenden
Am einfachsten lässt sich dies vermeiden, indem Sie ein TTS-Modell verwenden, das Zahlen und Formulierungen menschlicher vorliest, etwa Eleven Multilingual v2. Das ist jedoch nicht immer möglich, beispielsweise wenn geringe Latenz entscheidend ist, etwa bei Conversational Agents.
Normalisierung in LLM-Prompts anwenden
Wenn Sie ein LLM verwenden, um Text für TTS zu erzeugen, können Sie dem Prompt Anweisungen zur Normalisierung hinzufügen.
Klare und eindeutige Prompts verwenden
LLMs reagieren am besten auf strukturierte und eindeutige Anweisungen. Ihr Prompt sollte klar festlegen, dass Text in ein gut vorlesbares Format umgewandelt werden soll.
Verschiedene Zahlenformate verarbeiten
Nicht alle Zahlen werden gleich vorgelesen. Berücksichtigen Sie, wie verschiedene Zahlentypen gesprochen werden sollen:
- Kardinalzahlen: 123 → “one hundred twenty-three”
- Ordinalzahlen: 2nd → “second”
- Geldbeträge: $45.67 → “forty-five dollars and sixty-seven cents”
- Telefonnummern: “123-456-7890” → “one two three, four five six, seven eight nine zero”
- Dezimalzahlen und Brüche: “3.5” → “three point five”, “⅔” → “two-thirds”
- Römische Zahlen: “XIV” → “fourteen” (oder “the fourteenth” bei einem Titel)
Abkürzungen entfernen oder ausschreiben
Gängige Abkürzungen sollten zur besseren Verständlichkeit ausgeschrieben werden:
- “Dr.” → “Doctor”
- “Ave.” → “Avenue”
- “St.” → “Street” (“St. Patrick” sollte jedoch unverändert bleiben)
Sie können im Prompt verlangen, dass sie explizit ausgeschrieben werden:
Erweitere alle Abkürzungen zu ihren vollständig ausgeschriebenen Formen.
Alphanumerische Normalisierung
Nicht jede Normalisierung betrifft Zahlen. Auch bestimmte alphanumerische Formulierungen sollten zur besseren Verständlichkeit normalisiert werden:
- Tastenkürzel: “Ctrl + Z” → “control z”
- Abkürzungen für Einheiten: “100km” → “one hundred kilometers”
- Symbole: “100%” → “one hundred percent”
- URLs: “elevenlabs.io/docs” → “eleven labs dot io slash docs”
- Kalenderereignisse: “2024-01-01” → “January first, two-thousand twenty-four”
Sonderfälle berücksichtigen
Unterschiedliche Kontexte können unterschiedliche Umwandlungen erfordern:
- Daten: “01/02/2023” → “January second, twenty twenty-three” oder “the first of February, twenty twenty-three” (je nach Gebietsschema)
- Uhrzeit: “14:30” → “two thirty PM”
Wenn Sie ein bestimmtes Format benötigen, geben Sie es im Prompt ausdrücklich an.
Alles zusammenführen
Dieser Prompt ist für die meisten Anwendungsfälle ein guter Ausgangspunkt:
Reguläre Ausdrücke zur Vorverarbeitung verwenden
Wenn Sie Code verwenden, um ein LLM zu prompten, können Sie reguläre Ausdrücke nutzen, um den Text vor der Übergabe an das Modell zu normalisieren. Dies ist eine fortgeschrittenere Technik und erfordert Kenntnisse über reguläre Ausdrücke. Hier sind einige einfache Beispiele:
Eleven v3 prompten
Dieser Leitfaden zeigt die effektivsten Tags und Techniken für das Prompting mit Eleven v3, einschließlich Stimmenauswahl, Änderungen der Groß- und Kleinschreibung, Zeichensetzung, Audiotags und Dialogen mit mehreren Sprechern. Experimentieren Sie mit diesen Methoden, um herauszufinden, was für Ihre Stimme und Ihren Anwendungsfall am besten funktioniert.
Eleven v3 unterstützt keine SSML-Break-Tags. Verwenden Sie Audiotags, Satzzeichen (Auslassungspunkte) und die Textstruktur, um Pausen und Sprechtempo mit v3 zu steuern.
Stimmenauswahl
Der wichtigste Parameter für Eleven v3 ist die gewählte Stimme. Sie muss der gewünschten Sprechweise ausreichend ähneln. Wenn die Stimme beispielsweise schreit und Sie das Audiotag [whispering] verwenden, wird es wahrscheinlich nicht gut funktionieren.
Beim Erstellen von IVCs sollten Sie eine größere emotionale Bandbreite als bisher einbeziehen. Daher können Stimmen in der Stimmbibliothek im Vergleich zu den Modellen v2 und v2.5 variablere Ergebnisse liefern. Wir haben eine kuratierte Sammlung von Stimmen für V3 zusammengestellt.
Wählen Sie Stimmen strategisch nach Ihrem geplanten Einsatz:
Emotional vielseitig
Variieren Sie bei ausdrucksstarken IVC-Stimmen die emotionalen Töne in der Aufnahme – nutzen Sie sowohl neutrale als auch dynamische Beispiele.
Gezielte Nische
Behalten Sie bei spezifischen Anwendungsfällen wie Sportkommentaren im gesamten Datensatz eine konsistente Emotion bei.
Neutral
Neutrale Stimmen sind in der Regel über Sprachen und Stile hinweg stabiler und bieten eine zuverlässige Grundleistung.
Professional Voice Clones (PVCs) sind derzeit nicht vollständig für Eleven v3 optimiert. Dadurch kann die Klonqualität im Vergleich zu früheren Modellen geringer ausfallen. In dieser Phase der Forschungsvorschau verwenden Sie für Ihr Projekt am besten einen Instant Voice Clone (IVC) oder eine erstellte Stimme, wenn Sie v3-Funktionen nutzen müssen.
Einstellungen
Stabilität
Der Stabilitätsregler ist die wichtigste Einstellung in v3. Er steuert, wie eng die generierte Stimme am ursprünglichen Referenzaudio bleibt.
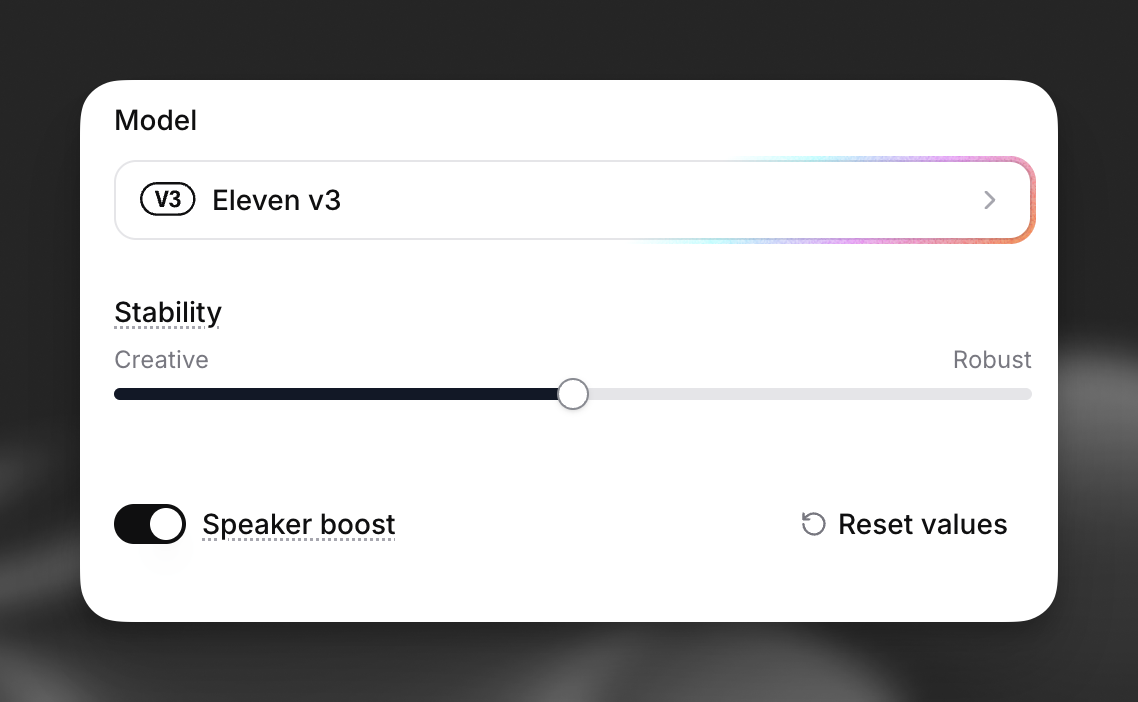
- Kreativ: Emotionaler und ausdrucksstärker, aber anfällig für Halluzinationen.
- Natürlich: Der ursprünglichen Sprachaufnahme am ähnlichsten – ausgewogen und neutral.
- Robust: Sehr stabil, reagiert jedoch weniger auf Anweisungen; konsistent und ähnlich wie v2.
Für maximale Ausdrucksstärke mit Audiotags verwenden Sie die Einstellungen Kreativ oder Natürlich. Robust verringert die Reaktionsfähigkeit auf Anweisungen.
Audiotags
Eleven v3 führt emotionale Steuerung durch Audiotags ein. Sie können Stimmen anweisen zu lachen, zu flüstern, sarkastisch zu sprechen oder Neugier auszudrücken – neben vielen weiteren Stilen. Auch die Geschwindigkeit wird über Audiotags gesteuert.
Die gewählte Stimme und ihre Trainingsbeispiele beeinflussen die Wirksamkeit von Tags. Einige Tags funktionieren mit bestimmten
Stimmen gut, andere möglicherweise nicht. Erwarten Sie nicht, dass eine flüsternde Stimme mit einem
[shout]-Tag plötzlich schreit.
Stimmbezogen
Diese Tags steuern die stimmliche Darbietung und den emotionalen Ausdruck:
[laughs],[laughs harder],[starts laughing],[wheezing][whispers][sighs],[exhales][sarcastic],[curious],[excited],[crying],[snorts],[mischievously]
Soundeffekte
Fügen Sie Umgebungsgeräusche und Effekte hinzu:
[gunshot],[applause],[clapping],[explosion][swallows],[gulps]
Einzigartig und speziell
Experimentelle Tags für kreative Anwendungen:
[strong X accent](ersetzen Sie X durch den gewünschten Akzent)[sings],[woo],[fart]
Einige experimentelle Tags können bei verschiedenen Stimmen weniger konsistent sein. Testen Sie sie vor dem Produktionseinsatz gründlich.
Zeichensetzung
Die Zeichensetzung beeinflusst die Sprechweise in v3 erheblich:
- Auslassungspunkte (…) fügen Pausen und Gewichtung hinzu
- Großschreibung verstärkt die Betonung
- Standardzeichensetzung sorgt für einen natürlichen Sprechrhythmus
Beispiele mit einem Sprecher
Verwenden Sie Tags gezielt und passen Sie sie an den Charakter der Stimme an. Eine meditative Stimme sollte nicht schreien; eine energiegeladene Stimme wird nicht überzeugend flüstern.
Ausdrucksstarker Monolog
Dynamisch und humorvoll
Kundendienstsimulation
Dialog mit mehreren Sprechern
v3 kann Prompts mit mehreren Stimmen effektiv verarbeiten. Weisen Sie jedem Sprecher unterschiedliche Stimmen aus Ihrer Stimmbibliothek zu, um realistische Gespräche zu erstellen.
Dialogbeispiel
Glitch-Komödie
Überlappendes Timing
Eingabe verbessern
In der ElevenLabs-Benutzeroberfläche können Sie durch Klicken auf die Schaltfläche „Enhance“ automatisch passende Audiotags für Ihren Eingabetext generieren. Im Hintergrund wird ein LLM verwendet, das Ihren Eingabetext mit folgendem Prompt verbessert:
Tipps
Tag-Kombinationen
Sie können mehrere Audiotags für komplexe emotionale Sprechweisen kombinieren. Experimentieren Sie mit verschiedenen Kombinationen, um herauszufinden, was für Ihre Stimme am besten funktioniert.
Stimmenabgleich
Passen Sie Tags an den Charakter Ihrer Stimme und ihre Trainingsdaten an. Eine ernste, professionelle Stimme reagiert möglicherweise nicht
gut auf verspielte Tags wie [giggles] oder [mischievously].
Textstruktur
Die Textstruktur beeinflusst die Ausgabe mit v3 stark. Verwenden Sie natürliche Sprechmuster, korrekte Zeichensetzung und einen klaren emotionalen Kontext für optimale Ergebnisse.
Experimentieren
Es gibt wahrscheinlich viele weitere wirksame Tags über diese Liste hinaus. Experimentieren Sie mit beschreibenden emotionalen Zuständen und Handlungen, um herauszufinden, was für Ihren spezifischen Anwendungsfall funktioniert.