

ベストプラクティス
ベストプラクティス
話し方、発音、感情を制御し、テキストを音声向けに最適化する方法を学びます。
このガイドでは、ElevenLabsモデルを使用してテキスト読み上げの出力を向上させるテクニックを紹介します。これらの方法を試して、ニーズに最も適したものを見つけてください。
コントロール
出力をさらに細かくコントロールできるよう、Director’s Mode を積極的に開発しています。
Director’s Mode のような高度な機能が提供されるまで、これらのテクニックを使えばニュアンスのある結果を実用的に得られます。
ポーズ
Eleven v3はSSMLのbreakタグをサポートしていません。v3でポーズを制御するには、Eleven v3のプロンプトセクションで説明しているテクニックを使用してください。
自然なポーズを3秒以内で入れるには、<break time="x.xs" />を使用します。
1回の生成でbreakタグを使いすぎると、不安定になる場合があります。AIが速く話したり、 余分なノイズやオーディオアーティファクトが発生したりする可能性があります。この問題の解決に取り組んでいます。
- **一貫性:**自然な発話の流れを保つため、
<break>タグは一貫して使用してください。過度に使うと不安定になることがあります。 - **音声ごとの挙動:**音声によってポーズの処理は異なります。特に「uh」や「ah」のようなフィラー音で学習された音声では、その傾向が顕著です。
<break>の代わりに、短いポーズにはダッシュ(-または—)、ためらいのあるトーンには省略記号(…)を使用できます。ただし、これらは一貫性に欠けます。
発音
Eleven v3でのIPA
Eleven v3モデル(eleven_v3)は、70以上の言語で国際音声記号(IPA)表記をネイティブにサポートしています。XMLタグを使わずに、単語やフレーズの発音を正確に制御できます。
XML形式のphonemeタグが必要な旧モデルとは異なり、v3はテキスト内でIPA記号をスラッシュで直接囲むとネイティブに理解します。
IPA表記は、次のようにしてください。
- 先頭と末尾をスラッシュ(
/)で囲む - 標準IPA記号を使用する
- 文字列パラメータとして渡す場合は二重引用符で囲む
コード例
1つのテキスト文字列に複数のIPA表記を含めることもできます。
パフォーマンス
v3のIPAサポートでは、発音の一貫性が80〜90%に達します。v2のXML phonemeタグより大幅に信頼性は高いものの、100%一貫するわけではありません。同一のIPA表記でも、特定の単語で問題が生じたり、異なる出力になったりする場合があります。IPAの信頼性は継続的に改善しています。
ベストプラクティス
- 国際音声記号表の標準IPA記号を使用する
- 複数音節の単語には、強勢記号を含める:第1強勢(ˈ)と第2強勢(ˌ)
- 選択的に適用する:発音の制御が必要な特定の単語やフレーズだけを囲む
- 使用する音声でテストする:音声によってIPAの解釈がわずかに異なる場合がある
トラブルシューティング
発音がまだ正しくない
IPA辞書を使用して、IPA表記が正確であることを確認してください。複数音節の単語には、強勢記号(第1強勢はˈ、 第2強勢はˌ)を含めてください。音声によってIPAをより正確に解釈する場合があるため、複数の音声でテストしてください。
同じIPAで結果にばらつきがある
v3のIPAサポートは一般的に信頼できますが、完全ではありません。同一のIPA表記でも、モデルが異なる出力を 生成することがあります。一貫性が重要な場合は、複数回生成して最適な結果を選択してください。
v2モデル向けphonemeタグ
v2モデルでは、SSML phonemeタグを使用して発音を指定します。サポートされるアルファベットには、CMU Arpabetと国際音声記号(IPA)が含まれます。
Phonemeタグは、eleven_flash_v2モデルとのみ互換性があります。
v2モデルで一貫性があり予測可能な結果を得るには、CMU Arpabetの使用をおすすめします。IPAも効果的ですが、一般にCMU Arpabetのほうが信頼性の高いパフォーマンスを提供します。
Phonemeタグは単語ごとにのみ機能します。名と姓からなる名前を特定の方法で発音させたい場合は、各単語にphonemeタグを作成する必要があります。
正確な発音を維持するため、複数音節の単語には正しい強勢マークを付けてください。
エイリアスタグ
Phonemeタグをサポートしていないモデルでは、単語をより発音どおりに書いてみてください。大文字、ダッシュ、アポストロフィ、単一の文字または複数の文字をシングルクォーテーションで囲むなど、さまざまな方法も使えます。
たとえば、「trapezii」のような単語は、単語内の「ii」をより強調するために「trapezIi」と綴ることができます。
テキスト内の単語を直接置き換えることもできます。あるいは、発音辞書を使用して他の単語やフレーズで発音を指定したい場合は、エイリアスタグを使用できます。これは、phonemeタグをサポートしていないMultilingual v2で生成する場合に便利です。発音辞書は、ElevenCreative Studio、ダビングスタジオ、API経由の音声合成で使用できます。
たとえば、テキストにAIが発音に苦労しそうな独特の読み方をする名前が含まれている場合、エイリアスタグを使って希望する発音を指定できます。
テキスト内で頭字語が出現するたびに、常に特定の方法で発音されるようにしたい場合も、エイリアスタグで指定できます。
発音辞書
ElevenCreative Studioやダビングスタジオなどのツールでは、発音辞書を作成してアップロードできます。これにより、キャラクター名やブランド名など特定の単語の発音、または頭字語の読み方を指定できます。
発音辞書では、単語とその発音の組を指定するレキシコンまたは辞書ファイルをアップロードすることで、この機能を利用できます。発音は音声アルファベットまたは単語の置換で指定します。
プロジェクト内でこれらの単語が検出されると、AIモデルは指定された置換を使って単語を発音します。
発音辞書ファイルを提供するには、プロジェクトの設定を開き、TXTまたは.PLS形式のファイルをアップロードしてください。辞書をプロジェクトに追加すると、新しい辞書ファイルを使用して再変換する必要があるプロジェクトの部分が自動的に再計算され、未変換としてマークされます。
現在サポートしているのは、phonemeタグまたはエイリアスタグを使用して置換を指定する発音辞書のみです。
Phonemeとエイリアスはいずれも、検索対象の単語またはフレーズ(書記素と呼ばれます)と、その置換先を指定するルールのセットです。検索では大文字と小文字が区別されることに注意してください。発音辞書で置換語を確認する際、辞書は先頭から末尾までチェックされ、最初に見つかった置換のみが使用されます。
発音辞書の例
以下に、CMU ArpabetとIPAの発音辞書の例を示します。「Apple」の発音を指定するphonemeと、「UN」を「United Nations」に置き換えるエイリアスを含みます。
発音辞書.plsファイルを生成するために、いくつかのオープンソースツールを利用できます。
- Sequitur G2P - データから発音ルールを学習し、音声表記を生成できるオープンソースツール。
- Phonetisaurus - CMUdictなどの既存辞書で学習したオープンソースのG2Pシステム。
- eSpeak - テキストからphoneme表記を生成できる音声合成器。
- CMU Pronouncing Dictionary - 音声表記を含む、事前構築された英語辞書。
感情
物語の文脈または明示的な会話タグを通じて感情を表現します。このアプローチにより、AIは再現すべきトーンと感情を理解しやすくなります。
明示的な会話タグは文脈だけに頼るよりも予測可能な結果をもたらしますが、モデルは感情的な演出指示も発話します。不要な場合は、オーディオエディターを使ったポストプロダクションで削除できます。
話す速さ
オーディオのペースは、音声の作成に使用したオーディオから大きな影響を受けます。音声を作成する際は、不自然に速い発話などのペースの問題を避けるため、長く連続したサンプルを使用することをおすすめします。
生成されるオーディオの速度を制御するには、速度設定を使用できます。これにより、生成される発話の速度を速くしたり遅くしたりできます。速度設定は、ウェブサイトおよびAPIのテキスト読み上げ、ElevenCreative Studio、Agents Platformで利用できます。音声設定にあります。
デフォルト値は1.0で、速度は調整されません。1.0未満の値では音声が遅くなり、最小値は0.7です。1.0を超える値では音声が速くなり、最大値は1.2です。極端な値では、生成される発話の品質に影響する場合があります。
ペースは、自然で物語的なスタイルで書くことでも制御できます。
ヒント
よくある問題
ポーズにばらつきがある:ポーズには
<break time=“x.xs” />構文を使用してください。- 発音エラー:正確な発音にはCMU ArpabetまたはIPA phonemeタグを使用してください。
感情が合わない:感情を導くため、物語の文脈または明示的なタグを追加してください。 ポストプロダクションで感情的な指示テキストを必ず削除してください。
出力を改善するヒント
目的のペースや感情を実現するため、別の表現を試してください。複雑なサウンド エフェクトでは、プロンプトを小さな連続要素に分け、結果を手動で組み合わせてください。
クリエイティブコントロール
出力をさらに細かくコントロールできる「Director’s Mode」を積極的に開発していますが、それまでの間、創造性と精度を最大限に高めるために以下のテクニックを使用できます。
テキスト正規化
電話番号、郵便番号、メールアドレスなどの複雑な項目にテキスト読み上げを使用すると、誤って発音されることがあります。これは多くの場合、特定の項目がトレーニングセットに含まれていないことや、小規模なモデルでは発音方法を十分に一般化できないことが原因です。このガイドでは、こうした違いが生じる場面と、正しく発音させる方法を説明します。
数字、日付、その他の複雑なテキスト要素の発音を改善するため、すべてのTTSモデルでデフォルトで正規化が有効になっています。
モデルによって入力の読み上げ方が異なるのはなぜですか?
一部のモデルは、数字やフレーズをより人間らしく読み上げるようトレーニングされています。たとえば、「$1,000,000」というフレーズは、Eleven Multilingual v2モデルでは「one million dollars」と正しく読み上げられます。一方、Eleven Flash v2.5モデルでは、同じフレーズが「one thousand thousand dollars」と読み上げられます。
これは、Multilingual v2モデルのほうが大規模であり、人間の聞き手にとってより自然な数字の読み上げ方を適切に一般化できるためです。一方、Flash v2.5モデルははるかに小規模なため、それができません。
よくある例
テキスト読み上げモデルでは、次のような項目の処理が難しい場合があります。
- 電話番号(“123-456-7890”)
- 通貨(“$47,345.67”)
- カレンダーイベント(“2024-01-01”)
- 時刻(“9:23 AM”)
- 住所(“123 Main St, Anytown, USA”)
- URL(“example.com/link/to/resource”)
- 単位の略語(“Terabyte”ではなく”TB”)
- ショートカット(“Ctrl + Z”)
対策
トレーニング済みモデルを使用する
最も簡単な対策は、Eleven Multilingual v2モデルのように、数字やフレーズをより人間らしく読み上げるようトレーニングされたTTSモデルを使用することです。ただし、低レイテンシーが重要なユースケース(例:会話型エージェント)では、これが常に可能とは限りません。
LLMプロンプトで正規化を適用する
LLMを使用してTTS用テキストを生成する場合は、プロンプトに正規化の指示を追加できます。
さまざまな数値形式を処理する
すべての数字が同じ方法で読み上げられるわけではありません。数値の種類ごとに、どのように発音すべきかを検討してください。
- 基数:123 → “one hundred twenty-three”
- 序数:2nd → “second”
- 金額:$45.67 → “forty-five dollars and sixty-seven cents”
- 電話番号:“123-456-7890” → “one two three, four five six, seven eight nine zero”
- 小数と分数:“3.5” → “three point five”、“⅔” → “two-thirds”
- ローマ数字:“XIV” → “fourteen”(タイトルの場合は”the fourteenth”)
略語を削除または展開する
わかりやすくするため、一般的な略語は展開してください。
- “Dr.” → “Doctor”
- “Ave.” → “Avenue”
- “St.” → “Street”(ただし”St. Patrick”はそのままにします)
プロンプトで明示的に展開をリクエストできます。
すべての略語を完全な読み上げ形式に展開してください。
すべてを組み合わせる
次のプロンプトは、ほとんどのユースケースに適した出発点になります。
前処理に正規表現を使用する
コードを使用してLLMにプロンプトを渡す場合は、モデルに提供する前に正規表現でテキストを正規化できます。これはより高度な手法であり、正規表現に関する知識が多少必要です。以下に簡単な例を示します。
Eleven v3のプロンプト作成
このガイドでは、音声の選択、大文字・小文字の変更、句読点、オーディオタグ、複数話者の対話など、Eleven v3でプロンプトを作成するための効果的なタグとテクニックを紹介します。これらの方法を試し、特定の音声やユースケースに最適な方法を見つけてください。
Eleven v3はSSMLのbreakタグに対応していません。v3で間や話すペースを調整するには、オーディオタグ、句読点(省略記号)、テキスト構造を使用してください。
音声の選択
Eleven v3で最も重要なパラメーターは、選択する音声です。目的の話し方に十分近い音声である必要があります。たとえば、音声が叫んでいる場合、[whispering]のオーディオタグを使っても、うまく機能しない可能性があります。
IVCを作成する際は、以前より幅広い感情表現を含める必要があります。そのため、ボイスライブラリ内の音声は、v2およびv2.5モデルと比べて結果のばらつきが大きくなる場合があります。V3向けに厳選した音声コレクションをご用意しています。
用途に応じて、戦略的に音声を選択してください:
感情表現が豊か
表現力豊かなIVC音声では、録音全体で感情のトーンに変化をつけてください。ニュートラルなサンプルとダイナミックなサンプルの両方を含めます。
特定用途向け
スポーツ実況など特定のユースケースでは、データセット全体で一貫した感情を維持してください。
ニュートラル
ニュートラルな音声は言語やスタイルを問わず安定しやすく、信頼できるベースライン性能を提供します。
プロフェッショナルボイスクローン(PVC)は現在Eleven v3向けに完全には最適化されていないため、以前のモデルと比べてクローン品質が低下する可能性があります。このリサーチプレビュー段階では、v3の機能を使用する必要がある場合、プロジェクト用にインスタントボイスクローン(IVC)またはデザインされた音声を見つけることをおすすめします。
設定
安定性
安定性スライダーはv3で最も重要な設定で、生成された音声が元の参照オーディオにどれだけ忠実に従うかを制御します。
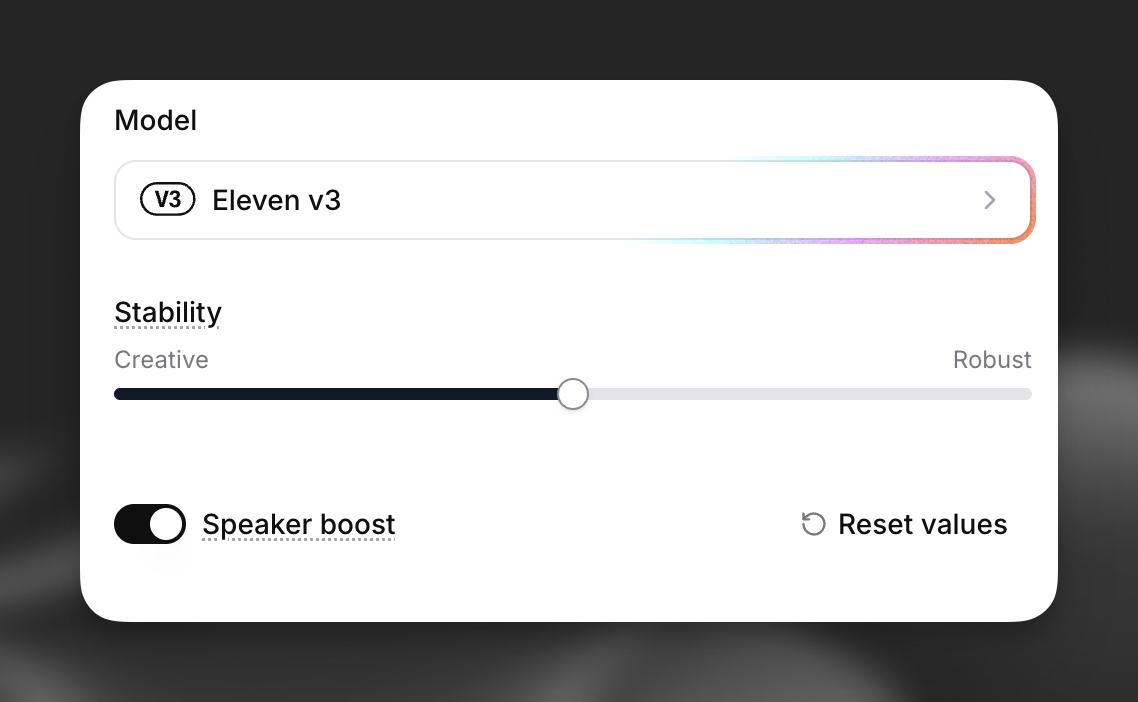
- **クリエイティブ:**より感情豊かで表現力がありますが、ハルシネーションが発生しやすくなります。
- **ナチュラル:**元の音声録音に最も近く、バランスの取れたニュートラルな設定です。
- **ロバスト:**非常に安定していますが、指示的なプロンプトへの反応性は低くなります。一方で、v2に近い一貫性があります。
オーディオタグで最大限の表現力を引き出すには、クリエイティブまたはナチュラル設定を使用してください。ロバストでは、指示的なプロンプトへの反応性が低下します。
オーディオタグ
Eleven v3では、オーディオタグによる感情のコントロールが導入されています。笑う、ささやく、皮肉っぽく話す、好奇心を表すなど、さまざまなスタイルを音声に指示できます。速度もオーディオタグで制御します。
選択する音声とそのトレーニングサンプルは、タグの効果に影響します。特定の音声でうまく機能するタグもあれば、そうでないタグもあります。ささやく音声が[shout]タグで突然叫ぶことは期待しないでください。
音声関連
これらのタグは、声の出し方と感情表現を制御します:
[laughs]、[laughs harder]、[starts laughing]、[wheezing][whispers][sighs]、[exhales][sarcastic]、[curious]、[excited]、[crying]、[snorts]、[mischievously]
サウンドエフェクト
環境音や効果音を追加します:
[gunshot]、[applause]、[clapping]、[explosion][swallows]、[gulps]
ユニークな特殊タグ
クリエイティブな用途向けの実験的なタグ:
[strong X accent](Xを目的のアクセントに置き換え)[sings]、[woo]、[fart]
一部の実験的なタグは、音声によって一貫性が低くなる場合があります。本番環境で使用する前に、十分にテストしてください。
句読点
句読点はv3での話し方に大きく影響します:
- **省略記号(…)**は間と重みを加えます
- 大文字化は強調を強めます
- 標準的な句読点は自然な話すリズムを生み出します
単一話者の例
タグは意図的に使い、音声の個性に合わせてください。瞑想的な音声は叫ぶべきではなく、テンションの高い音声は説得力のあるささやきができません。
表現力豊かなモノローグ
ダイナミックでユーモラス
カスタマーサービスのシミュレーション
複数話者の対話
v3では複数音声のプロンプトを効果的に処理できます。話者ごとにボイスライブラリから異なる音声を割り当てることで、リアルな会話を作成できます。
対話ショーケース
グリッチコメディ
重なり合うタイミング
入力の強化
ElevenLabsのUIでは、「Enhance」ボタンをクリックすると、入力テキストに関連するオーディオタグを自動生成できます。内部では、LLMが以下のプロンプトを使用して入力テキストを強化します:
ヒント
タグの組み合わせ
複雑な感情表現には、複数のオーディオタグを組み合わせることができます。さまざまな組み合わせを試し、音声に最も適した方法を見つけてください。
音声とのマッチング
タグは音声の個性やトレーニングデータに合わせてください。真面目でプロフェッショナルな音声は、[giggles]や[mischievously]のような遊び心のあるタグには適切に反応しない場合があります。
テキスト構造
テキスト構造はv3の出力に強く影響します。最良の結果を得るには、自然な話し方のパターン、適切な句読点、明確な感情的コンテキストを使用してください。
実験
このリスト以外にも効果的なタグは数多くあると考えられます。説明的な感情状態や動作を試し、特定のユースケースに適したものを見つけてください。