

モデル
主力モデル
テキスト読み上げ
スピーチtoテキスト
音声エージェント
音楽
モデルの概要
ElevenLabs APIでは、さまざまなユースケース、品質レベル、パフォーマンス要件に最適化された各種オーディオモデルを提供しています。
† アプリケーションとネットワークのレイテンシを除いた中央値です。レイテンシの 測定方法をご覧ください。
非推奨モデル
music_v1 モデルは非推奨となり、2027年1月31日 に廃止されます。
eleven_text_to_sound_v2 モデルは非推奨となり、2027年3月1日 に廃止されます。サービスを引き続き利用するには、
以下の代替モデルに移行してください。リクエストで model_id を設定していない場合は、代替モデルを
明示的に設定してください。
eleven_turbo_v2_5 および eleven_turbo_v2 モデルは、それぞれ
eleven_flash_v2_5 および eleven_flash_v2 モデルと機能的に同等ですが、Flash
モデルの方が平均レイテンシは低くなります。すべてのユースケースで、TurboモデルよりFlashモデルの使用を
推奨します。
Eleven v4
Eleven v4は最先端の音声合成モデルで、最高品質のオーディオ、豊かな表現力、音声演技を細かく制御する機能を提供します。長いテキストを生成する際も話者の特徴を確実に維持し、高忠実度のボイスクローンに対応します。
このモデルは、次のシーンに適しています。
- キャラクターボイスオーバー:幅広い感情を表現できるため、ゲームやアニメーションに最適です。
- 感情豊かな会話:幅広い感情表現と文脈理解により、自然でリアルな会話を生成します。
- オーディオブック制作:複雑な感情表現を伴う長文のナレーションに最適です。
- 多言語プロジェクト:言語を切り替えても一貫した音声品質を維持します。
Eleven v4は、Text to Dialogue APIから利用できます。
対応言語
Eleven v4モデルファミリーは、以下を含む90以上の言語に対応しています。
アフリカーンス語(af)、アムハラ語(am)、アラビア語(ar)、アルメニア語(hy)、アッサム語(as)、アストゥリアス語(ast)、アゼルバイジャン語(az)、ベラルーシ語(be)、ベンガル語(bn)、ボスニア語(bs)、ブルガリア語(bg)、ビルマ語(my)、広東語(yue)、カタルーニャ語(ca)、セブアノ語(ceb)、クロアチア語(hr)、チェコ語(cs)、デンマーク語(da)、オランダ語(nl)、英語(en)、エストニア語(et)、フィリピノ語(fil)、フィンランド語(fi)、フランス語(fr)、フラニ語(プラール語)(ff)、ガリシア語(gl)、ジョージア語(ka)、ドイツ語(de)、ギリシャ語(el)、グジャラート語(gu)、ハウサ語(ha)、ヘブライ語(he)、ヒンディー語(hi)、ハンガリー語(hu)、アイスランド語(is)、インドネシア語(id)、イタリア語(it)、日本語(ja)、ジャワ語(jv)、カンバ語(kam)、カンナダ語(kn)、カザフ語(kk)、韓国語(ko)、キルギス語(ky)、ラオ語(lo)、ラトビア語(lv)、リンガラ語(ln)、リトアニア語(lt)、ルガンダ語(lg)、ルクセンブルク語(lb)、マケドニア語(mk)、マレー語(ms)、マラヤーラム語(ml)、マルタ語(mt)、中国語(標準中国語)(zh)、マオリ語(mi)、マラーティー語(mr)、モンゴル語(mn)、ネパール語(ne)、ノルウェー語(no)、オック語(oc)、オディア語(or)、パシュトー語(ps)、ペルシャ語(fa)、ポーランド語(pl)、ポルトガル語(pt)、パンジャブ語(pa)、ルーマニア語(ro)、ロシア語(ru)、セルビア語(sr)、ショナ語(sn)、シンド語(sd)、スロバキア語(sk)、スロベニア語(sl)、ソマリ語(so)、ソラニー・クルド語(ckb)、スペイン語(es)、スワヒリ語(sw)、スウェーデン語(sv)、タジク語(tg)、タミル語(ta)、テルグ語(te)、タイ語(th)、トルコ語(tr)、ウクライナ語(uk)、ウルドゥー語(ur)、ウズベク語(uz)、ベトナム語(vi)、ウェールズ語(cy)、ウォロフ語(wo)、ズールー語(zu)。
Eleven v4 Turbo
Eleven v4 Turboは、リアルタイム音声合成向けの最先端モデルです。高品質なオーディオと豊かな表現力を備え、音声の表現方法を細かく制御できます。高忠実度のボイスクローンに対応し、レイテンシの中央値は約100msです。レイテンシの測定方法をご覧ください。
このモデルは、次の用途に適しています。
- サポートエージェント:顧客からの問い合わせをリアルタイムで解決する音声エージェントを構築できます。
- AIアシスタント:幅広い感情表現と文脈理解を備えた、自然でリアルな対話を生成します。
- インタラクティブキャラクター:表現力豊かなキャラクターを使ったオーディオ体験に最適です。
Eleven v4 Turboは、Text to Dialogue WebSocketから利用できます。
対応言語
Eleven v4モデルファミリーは、以下を含む90以上の言語に対応しています。
アフリカーンス語(af)、アムハラ語(am)、アラビア語(ar)、アルメニア語(hy)、アッサム語(as)、アストゥリアス語(ast)、アゼルバイジャン語(az)、ベラルーシ語(be)、ベンガル語(bn)、ボスニア語(bs)、ブルガリア語(bg)、ビルマ語(my)、広東語(yue)、カタルーニャ語(ca)、セブアノ語(ceb)、クロアチア語(hr)、チェコ語(cs)、デンマーク語(da)、オランダ語(nl)、英語(en)、エストニア語(et)、フィリピノ語(fil)、フィンランド語(fi)、フランス語(fr)、フラニ語(プラール語)(ff)、ガリシア語(gl)、ジョージア語(ka)、ドイツ語(de)、ギリシャ語(el)、グジャラート語(gu)、ハウサ語(ha)、ヘブライ語(he)、ヒンディー語(hi)、ハンガリー語(hu)、アイスランド語(is)、インドネシア語(id)、イタリア語(it)、日本語(ja)、ジャワ語(jv)、カンバ語(kam)、カンナダ語(kn)、カザフ語(kk)、韓国語(ko)、キルギス語(ky)、ラオ語(lo)、ラトビア語(lv)、リンガラ語(ln)、リトアニア語(lt)、ルガンダ語(lg)、ルクセンブルク語(lb)、マケドニア語(mk)、マレー語(ms)、マラヤーラム語(ml)、マルタ語(mt)、中国語(標準中国語)(zh)、マオリ語(mi)、マラーティー語(mr)、モンゴル語(mn)、ネパール語(ne)、ノルウェー語(no)、オック語(oc)、オディア語(or)、パシュトー語(ps)、ペルシャ語(fa)、ポーランド語(pl)、ポルトガル語(pt)、パンジャブ語(pa)、ルーマニア語(ro)、ロシア語(ru)、セルビア語(sr)、ショナ語(sn)、シンド語(sd)、スロバキア語(sk)、スロベニア語(sl)、ソマリ語(so)、ソラニー・クルド語(ckb)、スペイン語(es)、スワヒリ語(sw)、スウェーデン語(sv)、タジク語(tg)、タミル語(ta)、テルグ語(te)、タイ語(th)、トルコ語(tr)、ウクライナ語(uk)、ウルドゥー語(ur)、ウズベク語(uz)、ベトナム語(vi)、ウェールズ語(cy)、ウォロフ語(wo)、ズールー語(zu)。
Eleven v3
Eleven v3は、前世代の音声合成モデルです。複数の言語で、幅広い感情表現と文脈理解を備えた自然でリアルな音声を生成します。
Eleven v3では、新しいText to Dialogue APIを利用でき、複数の言語で幅広い感情表現と文脈理解を備えた自然でリアルな対話を生成できます。また、Eleven v3はテキスト読み上げ(TTS)APIでも使用でき、複数の言語で幅広い感情表現と文脈理解を備えた自然でリアルな音声を生成できます。
Text to Dialogue APIの詳細はこちらをご覧ください。
対応言語
Eleven v3モデルは、以下を含む70以上の言語に対応しています:
アフリカーンス語(af)、アラビア語(ar)、アルメニア語(hy)、アッサム語(as)、アストゥリアス語(ast)、アゼルバイジャン語(az)、ベラルーシ語(be)、ベンガル語(bn)、ボスニア語(bs)、ブルガリア語(bg)、ビルマ語(my)、広東語(yue)、カタルーニャ語(ca)、セブアノ語(ceb)、チチェワ語(ny)、クロアチア語(hr)、チェコ語(cs)、デンマーク語(da)、オランダ語(nl)、英語(en)、エストニア語(et)、フィリピン語(fil)、フィンランド語(fi)、フランス語(fr)、ガリシア語(gl)、ジョージア語(ka)、ドイツ語(de)、ギリシャ語(el)、グジャラート語(gu)、ハウサ語(ha)、ヘブライ語(he)、ヒンディー語(hi)、ハンガリー語(hu)、アイスランド語(is)、インドネシア語(id)、アイルランド語(ga)、イタリア語(it)、日本語(ja)、ジャワ語(jv)、カンナダ語(kn)、カザフ語(kk)、キルギス語(ky)、韓国語(ko)、ラトビア語(lv)、リンガラ語(ln)、リトアニア語(lt)、ルクセンブルク語(lb)、マケドニア語(mk)、マレー語(ms)、マラヤーラム語(ml)、マルタ語(mt)、中国語(標準語)(zh)、マオリ語(mi)、マラーティー語(mr)、モンゴル語(mn)、ネパール語(ne)、ノルウェー語(no)、オック語(oc)、オディア語(or)、パシュトー語(ps)、ペルシャ語(fa)、ポーランド語(pl)、ポルトガル語(pt)、パンジャブ語(pa)、ルーマニア語(ro)、ロシア語(ru)、セルビア語(sr)、シンド語(sd)、スロバキア語(sk)、スロベニア語(sl)、ソマリ語(so)、スペイン語(es)、スワヒリ語(sw)、スウェーデン語(sv)、タジク語(tg)、タミル語(ta)、テルグ語(te)、タイ語(th)、トルコ語(tr)、ウクライナ語(uk)、ウルドゥー語(ur)、ウズベク語(uz)、ベトナム語(vi)、ウェールズ語(cy)、ヨルバ語(yo)。
Eleven v3 Conversational
Eleven v3 Conversationalは、リアルタイム音声合成向けの前世代モデルです。複数の言語で、幅広い感情表現と文脈理解を備えた自然でリアルな音声を生成します。
Eleven v3 Conversationalでは、新しいText to Dialogue WebSocketを利用でき、複数の言語で幅広い感情表現と文脈理解を備えた自然でリアルな対話を生成できます。
Eleven v3 Conversationalでは、新しいText to Dialogue WebSocketを利用でき、複数の言語で幅広い感情表現と文脈理解を備えた自然でリアルな対話を生成できます。
Text to Dialogue WebSocketの詳細はこちらをご覧ください。
対応言語
Eleven v3モデルは、以下を含む70以上の言語に対応しています:
アフリカーンス語(af)、アラビア語(ar)、アルメニア語(hy)、アッサム語(as)、アストゥリアス語(ast)、アゼルバイジャン語(az)、ベラルーシ語(be)、ベンガル語(bn)、ボスニア語(bs)、ブルガリア語(bg)、ビルマ語(my)、広東語(yue)、カタルーニャ語(ca)、セブアノ語(ceb)、チチェワ語(ny)、クロアチア語(hr)、チェコ語(cs)、デンマーク語(da)、オランダ語(nl)、英語(en)、エストニア語(et)、フィリピン語(fil)、フィンランド語(fi)、フランス語(fr)、ガリシア語(gl)、ジョージア語(ka)、ドイツ語(de)、ギリシャ語(el)、グジャラート語(gu)、ハウサ語(ha)、ヘブライ語(he)、ヒンディー語(hi)、ハンガリー語(hu)、アイスランド語(is)、インドネシア語(id)、アイルランド語(ga)、イタリア語(it)、日本語(ja)、ジャワ語(jv)、カンナダ語(kn)、カザフ語(kk)、キルギス語(ky)、韓国語(ko)、ラトビア語(lv)、リンガラ語(ln)、リトアニア語(lt)、ルクセンブルク語(lb)、マケドニア語(mk)、マレー語(ms)、マラヤーラム語(ml)、マルタ語(mt)、中国語(標準語)(zh)、マオリ語(mi)、マラーティー語(mr)、モンゴル語(mn)、ネパール語(ne)、ノルウェー語(no)、オック語(oc)、オディア語(or)、パシュトー語(ps)、ペルシャ語(fa)、ポーランド語(pl)、ポルトガル語(pt)、パンジャブ語(pa)、ルーマニア語(ro)、ロシア語(ru)、セルビア語(sr)、シンド語(sd)、スロバキア語(sk)、スロベニア語(sl)、ソマリ語(so)、スペイン語(es)、スワヒリ語(sw)、スウェーデン語(sv)、タジク語(tg)、タミル語(ta)、テルグ語(te)、タイ語(th)、トルコ語(tr)、ウクライナ語(uk)、ウルドゥー語(ur)、ウズベク語(uz)、ベトナム語(vi)、ウェールズ語(cy)、ヨルバ語(yo)。
Multilingual v2
Eleven Multilingual v2は、感情を認識する前世代の音声合成モデルです。複数の言語で、幅広い感情表現と文脈理解を備えた自然でリアルな音声を生成します。
話者固有の特徴やアクセントを維持しながら、対応するすべての言語で一貫した音質と個性を再現します。
このモデルは、高品質で感情のニュアンスに富んだ音声が必要な次の用途に適しています。
- キャラクターのボイスオーバー:感情表現が豊かで、ゲームやアニメーションに最適です。
- プロフェッショナルコンテンツ:企業向けビデオやeラーニング教材に適しています。
- 多言語プロジェクト:言語を切り替えても一貫した音質を維持します。
- 安定した品質:一貫して高品質なオーディオを生成します。
Flashモデルよりレイテンシと文字単価は高くなりますが、リアルな音声が重要なプロジェクトでは、より優れた品質を提供します。
Multilingual v2モデルは、29言語に対応しています。
英語(米国、英国、オーストラリア、カナダ)、日本語、中国語、ドイツ語、ヒンディー語、フランス語(フランス、カナダ)、韓国語、ポルトガル語(ブラジル、ポルトガル)、イタリア語、スペイン語(スペイン、メキシコ)、インドネシア語、オランダ語、トルコ語、フィリピン語、ポーランド語、スウェーデン語、ブルガリア語、ルーマニア語、アラビア語(サウジアラビア、アラブ首長国連邦)、チェコ語、ギリシャ語、フィンランド語、クロアチア語、マレー語、スロバキア語、デンマーク語、タミル語、ウクライナ語、ロシア語。
Flash v2.5
Eleven Flash v2.5は、リアルタイムアプリケーションとAgents Platform向けに設計された低レイテンシの音声合成モデルです。32言語で、レイテンシの中央値約100ms†という高速処理と高品質な音声を実現します。
速度と品質のバランスに優れ、言語を問わず自然な音声と一貫した音声特性を維持できるため、インタラクティブなアプリケーションに最適です。
このモデルは、特に次の用途に適しています。
- Agents Platform:リアルタイム音声エージェントやチャットボットに最適です。
- インタラクティブアプリケーション:即時応答が必要なゲームやアプリケーションに最適です。
- 大規模処理:テキスト読み上げの一括変換を効率的に処理します。
API生成の料金が低く、レイテンシも小さいため、複数の言語で高速かつ信頼性の高い音声合成を必要とする場合に、Flash v2.5は費用対効果の高い選択肢です。
Flash v2.5は、v2モデルのすべての言語に加え、以下を含む32言語に対応しています。
ハンガリー語、ノルウェー語、ベトナム語
† アプリケーションとネットワークのレイテンシを除いた中央値です。レイテンシの 測定方法をご覧ください。
注意事項
数字を含むテキストの正規化
Flash v2.5では、デフォルトで数字が期待どおりに正規化されない場合があります。たとえば、電話番号がユーザーにとって分かりにくい読み方になることがあります。日付や通貨も同様です。
低レイテンシを維持するため、Flash v2.5ではデフォルトで正規化が無効になっています。ただし、エンタープライズのお客様は、リクエストのapply_text_normalizationパラメーターを”on”に設定することで、v2.5モデルのテキスト正規化を有効にできます。
Multilingual v2モデルは数字をより適切に正規化するため、電話番号など、数字の正規化が重要な用途ではこのモデルをおすすめします。
低レイテンシまたはAgents Platformのアプリケーションでは、TTSモデルに渡す前にLLMでテキストを正規化するか、apply_text_normalizationパラメーターを使用することをおすすめします(v2.5モデルではエンタープライズプランのみ)。
モデル選択ガイド
要件やユースケースに最適なモデルについては、モデル選択ガイドをご覧ください。
要件
ユースケース
文字数制限
1回のテキスト読み上げリクエストで対応できる最大文字数は、モデルによって異なります。
Scribe v2
Scribe v2は、90以上の言語を高精度に文字起こしできる最先端の音声認識モデルです。正確な単語単位のタイムスタンプに加え、話者ダイアライゼーションや動的オーディオタグ付けなどの高度な機能を備えています。
このモデルは、高精度なスピーチtoテキスト変換が必要な次の用途に適しています。
- 文字起こしサービス:オーディオやビデオコンテンツのテキスト変換に最適
- 会議の記録:会話の収録と文書化に最適
- コンテンツ分析:オーディオコンテンツの処理と分析に最適
- 多言語認識:90以上の言語で高精度な文字起こしに対応
主な機能:
- 単語単位のタイムスタンプを備えた高精度な文字起こし
- 複数話者のオーディオに対応する話者ダイアライゼーション
- 文脈を補強する動的オーディオタグ付け
- 90以上の言語に対応
- エンティティ検出
- キータームプロンプティング
- 文字起こしの編集
Scribe v2の詳細はこちらをご覧ください。
Scribe v2 Realtime
Scribe v2 Realtimeは、最も高速で高精度なライブ音声認識モデルです。90以上の言語で最先端の精度を実現し、確定した文字起こしが得られるまでの時間の中央値は約150msです。レイテンシの測定方法をご覧ください。
このモデルは、会話形式のユースケースに適しています。
- 会議のライブ文字起こし:リアルタイムの文字起こしに最適
- AIエージェント:ライブ会話に最適
- 多言語認識:言語の自動認識により、90以上の言語で高精度な文字起こしに対応
主な機能:
- 超低レイテンシ:中央値約150ミリ秒で確定した文字起こしを取得
- ストリーミング対応:オーディオをチャンク単位で送信しながら、リアルタイムで文字起こしを受信
- 複数のオーディオ形式:PCM(8kHz~48kHz)とμ-lawエンコーディングに対応
- 音声区間検出(VAD):無音検出に基づいて音声を自動分割
- 手動確定制御:文字起こしセグメントを確定するタイミングを完全に制御
- エンティティ検出
- エンティティの編集
- 文字起こしの編集
Scribe v2 Realtimeの詳細はこちらをご覧ください。
Scribe v2 Medical
Scribe v2 Medicalは、医療および臨床オーディオに特化したバッチ音声認識モデルです。Scribe v2を微調整したモデルで、日常会話ではScribe v2と同等の精度を維持しながら、医薬品名、解剖学、病理学、臨床口述の認識精度を向上させています。Scribe v2と同じスピーチtoテキストAPIを使用し、料金も同じです。model_idにscribe_v2_medicalを指定してください。
使用目的
Scribe v2 Medicalは、デベロッパーや組織がアプリケーションに組み込むためのバッチ型スピーチtoテキストAPIモデルです。医療従事者と患者の会話、口述、受付、ケア調整の通話などの臨床オーディオを、文書化や関連する管理ワークフローで使う下書きの文字起こしに変換します。生成されたテキストは、使用前に医療従事者またはその他の権限を持つユーザーが確認し、修正することを想定しています。Scribe v2 Medicalは、臨床情報の解釈、診断、治療の推奨、臨床上の判断、その他の臨床的な助言を目的としたものではありません。
このモデルは、次の用途に適しています。
- 臨床文書:会話中に医療用語が登場するアンビエント診療記録やメモ
- 口述:医薬品、用量、所見が連続する内容
- 受付および調整の通話:患者が自身の症状を説明する通話(多くは電話)
- コンプライアンスワークフロー:PHIカテゴリー向けのエンティティ検出と組み合わせて使用
主な機能:
- Scribe v2と同じリクエスト形式(
keyterms、entity_detection、no_verbatim、ダイアライゼーション、タイムスタンプ) - 医薬品名、解剖学、病理学用語の認識精度を向上
- 日常会話ではScribe v2と同等の精度を維持
- 90以上の言語に対応
- 複数話者のオーディオに対応する話者ダイアライゼーション
- 動的オーディオタグ付け
- PHIカテゴリーを含むエンティティ検出
Scribe v2 Medicalはバッチモデルです。ライブ文字起こしにはScribe v2 Realtimeを使用してください。
Scribe v2 MedicalはHIPAAの対象であり、エンタープライズのお客様は事業提携契約を締結できるほか、ゼロ保持モード(ZRM)も利用できます。ZRMを有効にすると、各リクエストの完了直後に入力オーディオと出力テキストが削除されます。ElevenLabsには何も保持されず、アプリケーションは完全なAPIレスポンスを受信し、独自の管理下で文字起こしを保持します。
HIPAAへの準拠が必要な企業は、保護対象保健情報を送信する前にElevenLabs 営業チームへ連絡し、事業提携契約(BAA)を締結する必要があります。
スピーチtoテキストの詳細はこちらをご覧ください。
SFX v3
SFX v3(eleven_text_to_sound_v3)は、最新のサウンドエフェクトモデルです。eleven_text_to_sound_v2と同じSound Effects APIを使用します。使用するには、model_idをeleven_text_to_sound_v3に設定してください。デフォルトは引き続きeleven_text_to_sound_v2ですが、すでに非推奨となっており、2027年3月1日に廃止されます。
eleven_text_to_sound_v2と比べて、SFX v3には次の特長があります。
- 「サッカー観衆の歓声、ボールが落ちる音、観衆のブーイング」のように、1つのプロンプト内の複数の指示に従います。
- 「ゴスペル合唱団がハローと歌う」のように、音楽やボーカルを含むプロンプトを処理できます。
- より自然なサウンドを生成します。
- 銅鑼、チャイム、笛などの高周波音でクリッピングが発生しにくくなっています。
結果はプロンプトによって異なるため、切り替える前に実際のプロンプトで両方のモデルを比較してください。
SFX v3はループに対応しています。loopをtrueに設定すると、滑らかにループするサウンドエフェクトを生成できます。
ElevenCreativeでは、SFX v3をSound Effects、Flows、Studioで利用できます。
サウンドエフェクトの詳細はこちらをご覧ください。
Eleven Realtime
Eleven Realtimeは、自然な音声エージェントを構築するための新しいスピーチtoスピーチモデルです。各Realtimeモデルは、音声認識、音声区間検出とターンテイキング、LLM、テキスト読み上げを備えた完全な音声エージェントです。各要素は、1つのシステムとして連携するようElevenLabsが選定し、調整しています。Realtimeモデルを1つ選ぶだけで、コンポーネントを設定することなく、高性能なエージェントを利用できます。
2つのRealtimeモデルを利用できます。
Eleven Realtime v1 Miniは、高速で自然な会話向けに最適化され、次の用途に適しています。
- AIアシスタント:会話そのものがプロダクトとなる、高速で表現力豊かな対話。
- 教育チューター:学習者のペースに合わせた自然なやり取り。
- インタラクティブキャラクター:ゲームやエンターテインメント向けの表現力豊かなキャラクター。
Eleven Realtime v1 Maxは、複雑なタスク向けに最適化され、次の用途に適しています。
- カスタマーサポート:手順に従い、情報を検索する必要がある問い合わせへの対応。
- 見込み顧客の選別:情報を収集し、次のステップを決める構造化された会話。
- 複数ステップのワークフロー:ツールを呼び出して情報を検索したり、操作を実行したりするタスク。
主な機能:
- 1つのモデル選択で、音声認識、ターンテイキング、言語モデル、音声を利用可能
- 自然なターンテイキングと割り込み処理
- ツール呼び出し
- ElevenLabsボイスライブラリのカスタマイズ可能な音声
- 90以上の言語に対応
- インテグレーションを変更せず、モデル選択だけでv1 Miniとv1 Maxを切り替え可能
Eleven RealtimeはElevenAgentsで利用でき、モデルのドロップダウンからRealtimeモデルを選択できます。また、WebSocket経由でOpenAIのRealtime APIとの互換性を持つよう設計されたRealtime APIからも利用できます。すでにOpenAIのRealtime APIを使用している場合は、移行ガイドをご覧ください。
対応言語
Realtimeモデルは90以上の言語に対応しています。Eleven v4の対応言語一覧をご覧ください。
Eleven Realtimeの詳細はこちらをご覧ください。
Eleven Music
Eleven Musicは、スタジオ品質の音楽生成モデルです。自然言語のプロンプトから、あらゆるスタイルの音楽を生成できます。
このモデルは、次の用途に最適です。
- ゲームのサウンドトラック:ゲーム向けの没入感あるサウンドトラックを制作
- ポッドキャストのBGM:プロ品質の音楽でポッドキャストを強化
- マーケティング:広告リールにBGMを追加
主な機能:
- ジャンル、スタイル、構成を完全に制御
- ボーカル付きまたはインストゥルメンタルのみ
- 英語、スペイン語、ドイツ語、日本語など、多言語に対応
- セクションごと、または曲全体のサウンドと歌詞を編集
Eleven Musicの詳細はこちらをご覧ください。
同時実行数と優先度
サブスクリプションプランによって、同時に処理できるリクエスト数と、キュー内でのリクエストの優先度が決まります。 スピーチtoテキストには、より高い同時実行数の上限が設定されています。 同時実行数の上限に達すると、それ以降のリクエストは優先度の低いリクエストとともにキューで処理されます。 実際に増えるレイテンシは通常、約50msにすぎません。
レスポンスヘッダーにはcurrent-concurrent-requestsとmaximum-concurrent-requestsが含まれており、同時実行状況の監視に使用できます。
1分あたりのAPIリクエスト数と同時リクエスト数の違い
1分あたりのAPIリクエスト数 と 同時リクエスト数 は、利用パターンによって変わる別々の指標です。この違いを理解することが重要です。
各リクエストの処理時間やリクエストのバッチ方法によって、1分あたりのAPIリクエスト数と同時リクエスト数は異なる場合があります。
例1:間隔を空けたリクエスト 1件あたり1秒で完了するリクエストを0.33秒間隔で送信し、1分間に180件処理する場合、常に3件が処理中になるため、同時リクエスト数は最大、平均ともに3件です。
例2:一括リクエスト 一方、1件あたり3秒で完了するリクエストを1分間に180件、すべて同時に送信する場合、同時リクエスト数は最大180件、平均9件になります(最初の3秒間は180件が同時に処理され、残りの57秒間は0件です)。
システムでは同時実行数が重視されるため、1分あたりのリクエスト数よりも、各リクエストの処理時間と送信タイミングのパターンが重要です。
エンドポイントへのリクエスト方法は、同時実行数の上限に次のように影響します。
- HTTPでは、各リクエストが個別に同時実行数の上限にカウントされます。
- テキスト読み上げWebSocketでは、モデルがオーディオを生成している時間だけが同時実行数の上限にカウントされます。そのため、開いているWebSocketは、ほとんどの時間で同時実行数の上限にまったくカウントされません。
- Text to Dialogue WebSocketの仕組みは異なります。接続が開いている間、接続ごとに別のプールから1つの対話セッションが確保され、接続経由で生成されるオーディオは通常の同時実行数の上限にはカウントされません。1接続を1セッションとして分かりやすく扱えるように設計されており、対話セッションの上限は、この新しい同時実行方式に合わせて設定されています。Text to Dialogueの同時実行数をご覧ください。
同時実行数の上限について
プランに設定された同時実行数の上限は、同時に処理できる会話、通話、キャラクターのボイスオーバーなどの最大数を示すものではありません。 実際の数は、使用するAI音声やユースケースの特性など、複数の要因によって決まります。
一般的な目安として、同時実行数の上限が5の場合、通常は最大約100件のオーディオ配信を同時に処理できます。
これは、TTSリクエストの処理時間に対してオーディオの生成速度が速いためです。 以下の図は、同時リクエスト数を2件に抑えながら、異なるユーザーとの4件の通話を同時に処理する例です。
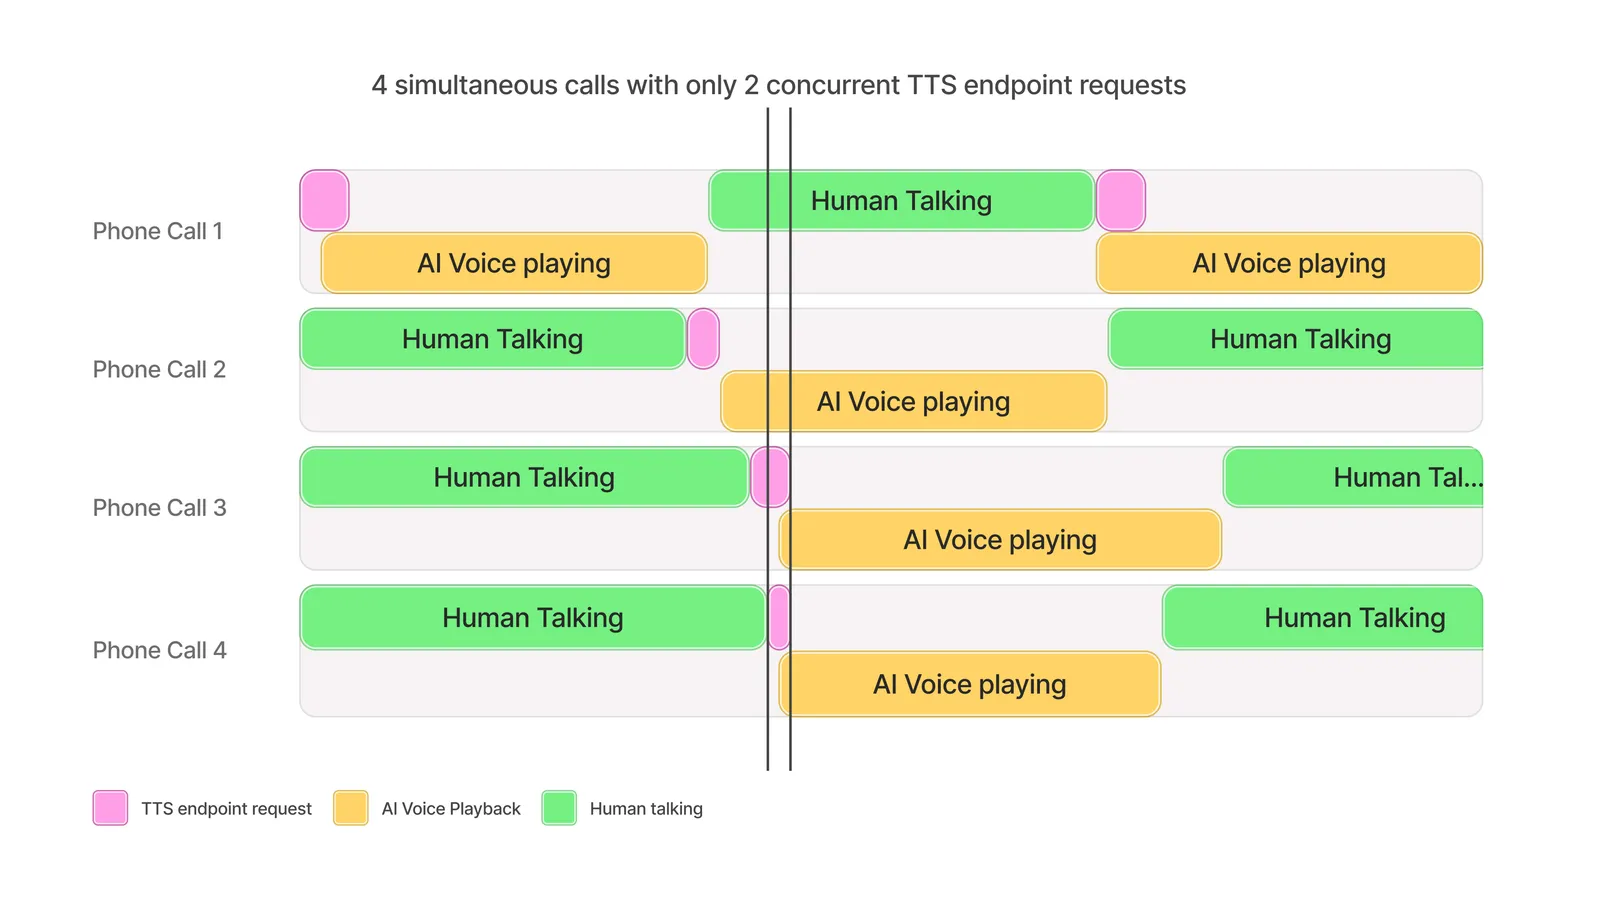
AI音声エージェントの構築
TTSを会話に使用する場合、同時実行数の上限が5なら、AIエージェントと人間の参加者がバランスよく話す会話で約100件の配信を処理できます。
カスタマーサポートのやり取りなど、AIエージェントが人間より話す頻度の低いユースケースでは、100件を超える会話を同時に処理できる場合があります。
キャラクターのボイスオーバー
一般的に、同時実行数の上限が5の場合、100件を超えるキャラクターのボイスオーバーを同時に処理できます。
処理できる数は、キャラクターが話す頻度、間の長さ、セリフ間のゲーム内アクションによって異なります。
ライブ吹き替え
同時に処理できる吹き替えストリーム数は、通常、上記の目安に従います。
配信中に会話のない時間(サウンドトラックや映像シーンなど)がある場合、目安を超える数の吹き替えストリームを同時に処理できる可能性があります。
エンタープライズプランでは、プランの同時実行数の上限を超えても、利用可能なキャパシティに応じてベストエフォートでモデルリクエストが処理される場合があります。ただし、処理速度は低下します。
同時実行数の上限とキューの優先度を引き上げるには、サブスクリプションプランをアップグレードして ください。
エンタープライズのお客様は、アカウントマネージャーに連絡して、同時実行数の上限引き上げをリクエストできます。
Text to Dialogueの同時実行数
Text to Dialogueリクエストは、APIの呼び出し方法に応じて、次の2つの方法で計測されます。
- HTTPエンドポイント(対話を作成と対話をストリーミング)は、他のテキスト読み上げリクエストと同様に、オーディオの生成中、プランの通常の同時実行数の上限にカウントされます。
- Text to Dialogue WebSocketなどの WebSocketエンドポイント は、対話セッション として計測されます。オーディオを生成中かどうかにかかわらず、接続が開いている間は対話セッションが保持されます。
セッション単位の計測により、キャパシティ計画がシンプルになります。1接続が1セッションとなるため、生成処理の有無によって使用量が変動しません。オーディオの生成中だけでなく接続中は常にセッションが保持されるため、対話セッションの上限は、この新しい同時実行方式に合わせて設定されています。
ワークスペースの対話セッションがすべて使用中の状態で接続を開こうとすると、新しい接続はtoo_many_concurrent_requestsエラーで拒否されます。セッションを解放するには、不要になった接続を閉じてください。keep_aliveメッセージを送信しない場合、接続は20秒間操作がないと自動的に閉じます。
対話セッションを監視するには、ダッシュボードのサイドバー下部にある Developers を開き、Analytics タブを選択して、Usageビューの Concurrent requests 指標を確認します。対話セッションは、他の同時リクエストとは別に、TTD Websocket Sessions という独立した系列で表示されます。
同時実行数の上限に対するスケールテスト
スケールテストは、クライアント側のスケーリングに関する問題を特定し、ユースケースに適した同時実行数の上限が設定されているか確認するのに役立ちます。
実際の利用状況にできるだけ近い環境で、エンドツーエンドのワークフローをテストすることを強く推奨します。そのためには、対応可能なユーザー数をシミュレーションして測定する方法が適しています。重要なポイントは次のとおりです。
- 生のリクエストではなく、ユーザーをシミュレーションする
- リクエストを送る前にオーディオの再生、ユーザーの発話、文字起こしの完了を待つなど、一般的なユーザー行動をシミュレーションする
- 数分かけてユーザー数を徐々に増やす
- リクエストのタイミングとサイズにランダム性を加える
- レイテンシ指標とAPIから返されたエラーコードを記録する
たとえば、100件の会話を同時に処理するよう設計されたエージェントシステムをテストする場合、それぞれが会話をシミュレーションする最大100人の「ユーザー」を作成します。一般的な会話では、ユーザーが約10秒間話し、約150文字のTTS API呼び出しを行い、その後ユーザーに約10秒間オーディオを再生するサイクルを繰り返します。そのため、各ユーザーは20秒ごとに150文字のテキストでWebSocketテキスト読み上げ(TTS)APIを呼び出します。このとき、待機時間とリクエストする文字数に多少のランダム性を加えます。テストでは、100人になるまで1秒ごとに1人のユーザーを追加し、全体的な安定性を確認するために合計10分間実行します。
スケールテスト用スクリプトの例
この例では、テストフレームワークとしてlocustを使用し、ElevenLabs APIを直接呼び出します。
上記の例に従い、各ユーザーが20秒ごとに1件のリクエストを送信する会話型エージェントシステムをテストします。