

模型
旗舰模型
文本转语音
语音转文本
语音智能体
音乐
模型概览
ElevenLabs API 提供多种音频模型,针对不同用例、质量等级和性能要求进行了优化。
† 中位数,不包括应用和网络延迟。请参阅延迟计算 方法。
已弃用模型
music_v1 模型已弃用,将于 2027 年 1 月 31 日移除。
eleven_text_to_sound_v2 模型已弃用,将于 2027 年 3 月 1 日移除。请
迁移到下方替代模型,以确保服务持续可用。如果请求中未设置
model_id,请明确将其设为替代模型。
eleven_turbo_v2_5 和 eleven_turbo_v2 模型在功能上分别等同于
eleven_flash_v2_5 和 eleven_flash_v2 模型,但 Flash
模型的平均延迟更低。建议在所有用例中优先使用 Flash 模型,而非 Turbo 模型。
Eleven v4
Eleven v4 是我们最先进的语音合成模型,可提供最高质量的音频、出色的表现力,以及对音色演绎方式的精准控制。Eleven v4 支持高保真语音克隆,在长文本生成中也能可靠保留说话人特征。
该模型适合以下场景:
- 角色旁白配音:情感表现丰富,适合游戏和动画。
- 情感对话:生成自然逼真的对话,具备丰富情感和上下文理解能力。
- 有声书制作:适合需要复杂情感表达的长篇叙述。
- 多语言项目:切换语言时仍能保持一致的音色质量。
可通过文本转对话 API 使用 Eleven v4。
支持的语言
Eleven v4 模型系列支持 90 多种语言,包括:
南非荷兰语(af)、阿姆哈拉语(am)、阿拉伯语(ar)、亚美尼亚语(hy)、阿萨姆语(as)、阿斯图里亚斯语(ast)、阿塞拜疆语(az)、白俄罗斯语(be)、孟加拉语(bn)、波斯尼亚语(bs)、保加利亚语(bg)、缅甸语(my)、粤语(yue)、加泰罗尼亚语(ca)、宿务语(ceb)、克罗地亚语(hr)、捷克语(cs)、丹麦语(da)、荷兰语(nl)、英语(en)、爱沙尼亚语(et)、菲律宾语(fil)、芬兰语(fi)、法语(fr)、富拉语(普拉尔语)(ff)、加利西亚语(gl)、格鲁吉亚语(ka)、德语(de)、希腊语(el)、古吉拉特语(gu)、豪萨语(ha)、希伯来语(he)、印地语(hi)、匈牙利语(hu)、冰岛语(is)、印度尼西亚语(id)、意大利语(it)、日语(ja)、爪哇语(jv)、坎巴语(kam)、卡纳达语(kn)、哈萨克语(kk)、韩语(ko)、吉尔吉斯语(ky)、老挝语(lo)、拉脱维亚语(lv)、林加拉语(ln)、立陶宛语(lt)、卢干达语(lg)、卢森堡语(lb)、马其顿语(mk)、马来语(ms)、马拉雅拉姆语(ml)、马耳他语(mt)、普通话(zh)、毛利语(mi)、马拉地语(mr)、蒙古语(mn)、尼泊尔语(ne)、挪威语(no)、奥克语(oc)、奥里亚语(or)、普什图语(ps)、波斯语(fa)、波兰语(pl)、葡萄牙语(pt)、旁遮普语(pa)、罗马尼亚语(ro)、俄语(ru)、塞尔维亚语(sr)、绍纳语(sn)、信德语(sd)、斯洛伐克语(sk)、斯洛文尼亚语(sl)、索马里语(so)、索拉尼库尔德语(ckb)、西班牙语(es)、斯瓦希里语(sw)、瑞典语(sv)、塔吉克语(tg)、泰米尔语(ta)、泰卢固语(te)、泰语(th)、土耳其语(tr)、乌克兰语(uk)、乌尔都语(ur)、乌兹别克语(uz)、越南语(vi)、威尔士语(cy)、沃洛夫语(wo)、祖鲁语(zu)。
Eleven v4 Turbo
Eleven v4 Turbo 是我们最先进的实时语音合成模型,可提供高质量音频、出色的表现力,以及对音色演绎方式的精准控制。Eleven v4 Turbo 支持高保真语音克隆,中位延迟约为 100ms。请参阅延迟计算方法。
该模型适合以下场景:
- 客服智能体:为可实时解决客户问题的语音智能体提供支持。
- AI 助手:生成自然逼真的对话,具备丰富情感和上下文理解能力。
- 互动角色:非常适合需要富有表现力角色的音频体验。
可通过文本转对话 WebSocket 使用 Eleven v4 Turbo。
支持的语言
Eleven v4 模型系列支持 90 多种语言,包括:
南非荷兰语(af)、阿姆哈拉语(am)、阿拉伯语(ar)、亚美尼亚语(hy)、阿萨姆语(as)、阿斯图里亚斯语(ast)、阿塞拜疆语(az)、白俄罗斯语(be)、孟加拉语(bn)、波斯尼亚语(bs)、保加利亚语(bg)、缅甸语(my)、粤语(yue)、加泰罗尼亚语(ca)、宿务语(ceb)、克罗地亚语(hr)、捷克语(cs)、丹麦语(da)、荷兰语(nl)、英语(en)、爱沙尼亚语(et)、菲律宾语(fil)、芬兰语(fi)、法语(fr)、富拉语(普拉尔语)(ff)、加利西亚语(gl)、格鲁吉亚语(ka)、德语(de)、希腊语(el)、古吉拉特语(gu)、豪萨语(ha)、希伯来语(he)、印地语(hi)、匈牙利语(hu)、冰岛语(is)、印度尼西亚语(id)、意大利语(it)、日语(ja)、爪哇语(jv)、坎巴语(kam)、卡纳达语(kn)、哈萨克语(kk)、韩语(ko)、吉尔吉斯语(ky)、老挝语(lo)、拉脱维亚语(lv)、林加拉语(ln)、立陶宛语(lt)、卢干达语(lg)、卢森堡语(lb)、马其顿语(mk)、马来语(ms)、马拉雅拉姆语(ml)、马耳他语(mt)、普通话(zh)、毛利语(mi)、马拉地语(mr)、蒙古语(mn)、尼泊尔语(ne)、挪威语(no)、奥克语(oc)、奥里亚语(or)、普什图语(ps)、波斯语(fa)、波兰语(pl)、葡萄牙语(pt)、旁遮普语(pa)、罗马尼亚语(ro)、俄语(ru)、塞尔维亚语(sr)、绍纳语(sn)、信德语(sd)、斯洛伐克语(sk)、斯洛文尼亚语(sl)、索马里语(so)、索拉尼库尔德语(ckb)、西班牙语(es)、斯瓦希里语(sw)、瑞典语(sv)、塔吉克语(tg)、泰米尔语(ta)、泰卢固语(te)、泰语(th)、土耳其语(tr)、乌克兰语(uk)、乌尔都语(ur)、乌兹别克语(uz)、越南语(vi)、威尔士语(cy)、沃洛夫语(wo)、祖鲁语(zu)。
Eleven v3
Eleven v3 是我们的上一代语音合成模型,可生成自然逼真的语音,并能在多种语言中呈现丰富情感和上下文理解能力。
Eleven v3 搭配全新的文本转对话 API,可让你在多种语言中生成具备丰富情感和上下文理解能力的自然逼真对话。Eleven v3 也可搭配文本转语音 API 使用,在多种语言中生成具备丰富情感和上下文理解能力的自然逼真语音。
在此处了解更多关于文本转对话 API 的信息。
支持的语言
Eleven v3 模型支持 70 多种语言,包括:
南非荷兰语(af)、阿拉伯语(ar)、亚美尼亚语(hy)、阿萨姆语(as)、阿斯图里亚斯语(ast)、阿塞拜疆语(az)、白俄罗斯语(be)、孟加拉语(bn)、波斯尼亚语(bs)、保加利亚语(bg)、缅甸语(my)、粤语(yue)、加泰罗尼亚语(ca)、宿务语(ceb)、齐切瓦语(ny)、克罗地亚语(hr)、捷克语(cs)、丹麦语(da)、荷兰语(nl)、英语(en)、爱沙尼亚语(et)、菲律宾语(fil)、芬兰语(fi)、法语(fr)、加利西亚语(gl)、格鲁吉亚语(ka)、德语(de)、希腊语(el)、古吉拉特语(gu)、豪萨语(ha)、希伯来语(he)、印地语(hi)、匈牙利语(hu)、冰岛语(is)、印度尼西亚语(id)、爱尔兰语(ga)、意大利语(it)、日语(ja)、爪哇语(jv)、卡纳达语(kn)、哈萨克语(kk)、吉尔吉斯语(ky)、韩语(ko)、拉脱维亚语(lv)、林加拉语(ln)、立陶宛语(lt)、卢森堡语(lb)、马其顿语(mk)、马来语(ms)、马拉雅拉姆语(ml)、马耳他语(mt)、普通话(zh)、毛利语(mi)、马拉地语(mr)、蒙古语(mn)、尼泊尔语(ne)、挪威语(no)、奥克语(oc)、奥里亚语(or)、普什图语(ps)、波斯语(fa)、波兰语(pl)、葡萄牙语(pt)、旁遮普语(pa)、罗马尼亚语(ro)、俄语(ru)、塞尔维亚语(sr)、信德语(sd)、斯洛伐克语(sk)、斯洛文尼亚语(sl)、索马里语(so)、西班牙语(es)、斯瓦希里语(sw)、瑞典语(sv)、塔吉克语(tg)、泰米尔语(ta)、泰卢固语(te)、泰语(th)、土耳其语(tr)、乌克兰语(uk)、乌尔都语(ur)、乌兹别克语(uz)、越南语(vi)、威尔士语(cy)、约鲁巴语(yo)。
Eleven v3 Conversational
Eleven v3 Conversational 是我们的上一代实时语音合成模型。它可在多种语言中生成自然逼真的语音,并具备丰富情感和上下文理解能力。
Eleven v3 Conversational 搭配全新的文本转对话 WebSocket,可让你在多种语言中生成具备丰富情感和上下文理解能力的自然逼真对话。
Eleven v3 Conversational 搭配全新的文本转对话 WebSocket,可让你在多种语言中生成具备丰富情感和上下文理解能力的自然逼真对话。
在此处了解更多关于文本转对话 WebSocket 的信息。
支持的语言
Eleven v3 模型支持 70 多种语言,包括:
南非荷兰语(af)、阿拉伯语(ar)、亚美尼亚语(hy)、阿萨姆语(as)、阿斯图里亚斯语(ast)、阿塞拜疆语(az)、白俄罗斯语(be)、孟加拉语(bn)、波斯尼亚语(bs)、保加利亚语(bg)、缅甸语(my)、粤语(yue)、加泰罗尼亚语(ca)、宿务语(ceb)、齐切瓦语(ny)、克罗地亚语(hr)、捷克语(cs)、丹麦语(da)、荷兰语(nl)、英语(en)、爱沙尼亚语(et)、菲律宾语(fil)、芬兰语(fi)、法语(fr)、加利西亚语(gl)、格鲁吉亚语(ka)、德语(de)、希腊语(el)、古吉拉特语(gu)、豪萨语(ha)、希伯来语(he)、印地语(hi)、匈牙利语(hu)、冰岛语(is)、印度尼西亚语(id)、爱尔兰语(ga)、意大利语(it)、日语(ja)、爪哇语(jv)、卡纳达语(kn)、哈萨克语(kk)、吉尔吉斯语(ky)、韩语(ko)、拉脱维亚语(lv)、林加拉语(ln)、立陶宛语(lt)、卢森堡语(lb)、马其顿语(mk)、马来语(ms)、马拉雅拉姆语(ml)、马耳他语(mt)、普通话(zh)、毛利语(mi)、马拉地语(mr)、蒙古语(mn)、尼泊尔语(ne)、挪威语(no)、奥克语(oc)、奥里亚语(or)、普什图语(ps)、波斯语(fa)、波兰语(pl)、葡萄牙语(pt)、旁遮普语(pa)、罗马尼亚语(ro)、俄语(ru)、塞尔维亚语(sr)、信德语(sd)、斯洛伐克语(sk)、斯洛文尼亚语(sl)、索马里语(so)、西班牙语(es)、斯瓦希里语(sw)、瑞典语(sv)、塔吉克语(tg)、泰米尔语(ta)、泰卢固语(te)、泰语(th)、土耳其语(tr)、乌克兰语(uk)、乌尔都语(ur)、乌兹别克语(uz)、越南语(vi)、威尔士语(cy)、约鲁巴语(yo)。
Multilingual v2
Eleven Multilingual v2 是上一代具备情感感知能力的语音合成模型。它可在多种语言中生成自然逼真的语音,并具备丰富情感和上下文理解能力。
该模型可在所有支持的语言中保持一致的音色质量和个性,同时保留说话人独特的特征和口音。
该模型尤其适合需要高质量、细腻情感表达语音的场景:
- 角色旁白配音:情感表现丰富,适合游戏和动画。
- 专业内容:非常适合企业视频和在线学习材料。
- 多语言项目:切换语言时仍能保持一致的音色质量。
- 稳定质量:生成稳定的高质量音频输出。
虽然其延迟和每字符成本高于 Flash 模型,但对于重视逼真语音的项目,它能提供更出色的质量。
多语言 v2 模型支持 29 种语言:
英语(美国、英国、澳大利亚、加拿大)、日语、中文、德语、印地语、法语(法国、加拿大)、韩语、葡萄牙语(巴西、葡萄牙)、意大利语、西班牙语(西班牙、墨西哥)、印尼语、荷兰语、土耳其语、菲律宾语、波兰语、瑞典语、保加利亚语、罗马尼亚语、阿拉伯语(沙特阿拉伯、阿联酋)、捷克语、希腊语、芬兰语、克罗地亚语、马来语、斯洛伐克语、丹麦语、泰米尔语、乌克兰语和俄语。
Flash v2.5
Eleven Flash v2.5 是一款低延迟语音合成模型,专为实时应用和智能体平台设计。它支持 32 种语言,可提供中位延迟约为 100ms† 的高质量语音。
该模型兼顾速度与质量,十分适合交互式应用,同时可在不同语言间保持自然的输出和一致的音色特征。
该模型尤其适合:
- 智能体平台:非常适合实时语音智能体和聊天机器人。
- 交互式应用:适合需要即时响应的游戏和应用。
- 大规模处理:可高效进行批量文本转语音转换。
Flash v2.5 的 API 生成价格更低、延迟更低,是需要快速可靠的多语言语音合成用户的高性价比选择。
Flash v2.5 支持 32 种语言——包括 v2 模型支持的所有语言,以及:
匈牙利语、挪威语和越南语
† 中位数,不包括应用和网络延迟。请参阅延迟计算 方法。
注意事项
数字文本规范化
使用 Flash v2.5 时,数字默认不会以你预期的方式进行规范化。例如,电话号码的读法可能不够清晰。日期和货币也会受到类似影响。
默认情况下,Flash v2.5 会禁用规范化以保持低延迟。不过,企业版客户现在可在请求中将 apply_text_normalization 参数设为 “on”,为 v2.5 模型启用文本规范化。
Multilingual v2 模型更擅长规范化数字,因此建议将其用于电话号码及其他重视数字规范化的场景。
对于低延迟或智能体平台应用,最佳做法是在将文本传递给 TTS 模型前,让 LLM 规范化文本,或使用 apply_text_normalization 参数(仅限企业版套餐的 v2.5 模型)。
模型选择指南
如需了解哪种模型最符合你的需求和使用场景,请参阅模型选择指南。
需求
使用场景
字符限制
单次文本转语音请求支持的最大字符数因模型而异。
Scribe v3
Scribe v3 是我们针对录制音频推出的最准确语音识别模型。它是 Scribe v2 的后续版本,使用相同的语音转文字 API(POST /v1/speech-to-text)。将 scribe_v3 作为 model_id 传入。
该模型尤其适合:
- 会议和笔记工具:为录制的会议和通话生成带说话人标签的转写文本
- 媒体:带说话人标签和词级时间戳的字幕与说明文字
- 教育:包含带口音或混合语言语音的录制讲座
- 联络中心:用于质量保证和分析的录制通话
与 Scribe v2 相比,Scribe v3 提供:
- 更少的转写错误。在涵盖 102 种语言的 FLEURS 基准测试中,Scribe v3 将词错误率(WER)从 16.94% 降至 12.38%,比 Scribe v2 少 27% 的词错误,并且在每种测试语言中都有提升。
- 更准确的多说话人音频说话人标签。
numbers_format参数,可将数字写为阿拉伯数字(42)或文字(forty-two)。secondary_language_codes参数,可与language_code一同列出音频中预期出现的其他语言,以提高混合语言音频的准确性。
请参阅数字和语言选项,了解如何使用新参数。
ElevenLabs 会先按片段计算 FLEURS WER,再按语言取平均值。因此得出的数值高于常见发布的 语料库级 WER,无法与通过其他方式计算的结果直接比较。
Scribe v3 保留了 Scribe v2 的功能集:
- 支持 90 多种语言
- 说话人分离,最多支持 32 位说话人
- 词级或字符级时间戳
- 音频事件标记
- 关键词提示,最多 1,000 个术语
- 实体检测
- 转写文本编辑
- 无逐字模式
- 导出为 SRT、DOCX、PDF 等更多格式
- 用于异步结果的 Webhook
从 Scribe v2 升级
将 model_id 从 scribe_v2 改为 scribe_v3。现有请求参数无需修改即可继续使用。Scribe v2 仍可使用。
Scribe v3 Live
Scribe v3 Live 是我们最准确的实时语音识别模型。它是 Scribe v2 Realtime 的后续版本,使用相同的实时 WebSocket(wss://api.elevenlabs.io/v1/speech-to-text/realtime)。将 scribe_v3_live 作为 model_id 查询参数传入。
Scribe v3 Live 是一款语音转文字模型。它不同于用于语音智能体的语音转语音模型 Eleven Realtime。
该模型尤其适合:
- 语音智能体和联络中心:在来电者说完一轮时提交内容,而不是在第一次停顿时提交
- 实时字幕:带词级时间戳的实时转写文本
- 教育和语言学习:适用于带口音的说话人及切换语言的说话人
- 听写和助手:通过关键词支持领域词汇
与 Scribe v2 Realtime 相比,Scribe v3 Live 提供:
- 更少的转写错误。在涵盖 73 种语言的 FLEURS 基准测试中,Scribe v3 Live 的语义 WER 比 Scribe v2 Realtime 低 44%。在 Earnings-22(带口音的英语金融通话)中,WER 从 5.99% 降至 3.91%;在 VoxPopuli(欧洲议会演讲)中,则从 2.13% 降至 1.71%。
- 轮次预测。使用
commit_strategy=turn_prediction时,服务器会在模型预测说话人已结束本轮发言时提交片段,而非仅等待静音。 - 多语言模式。使用
multilang_mode=true时,每种语言都会以各自的文字系统转写,包括句中切换语言的情况。 - 关键词库,最多包含 10,000 个术语。除 50 个标准关键词外,模型仅在听到可能匹配的内容时才会使用这些术语。
- 实时说话人分离。使用
diarize=true时,部分转写文本中会显示草稿说话人标签;每条已提交的转写文本后都会跟随一份独立的说话人分离转写文本,不会延迟已提交文本。
Scribe v3 Live 保留了 Scribe v2 Realtime 的功能集:
- 支持 90 多种语言,并自动检测语言
- 流式支持:在实时接收转写文本的同时分块发送音频
- 多种音频格式:PCM(8 kHz 至 48 kHz)和 μ-law 编码
- 手动和语音活动检测(VAD)提交策略
- 词级时间戳
- 使用
secondary_languages将语言检测限制为一组语言 - 关键词提示,最多 50 个术语
- 实体检测
- 转写文本编辑
- 背景音频过滤
从 Scribe v2 Realtime 升级
将 model_id 从 scribe_v2_realtime 改为 scribe_v3_live。默认提交策略仍为 manual,因此在将 commit_strategy 设为 turn_prediction 前,现有集成的行为不会改变。Scribe v2 Realtime 仍可使用。
官方 SDK 尚不支持轮次预测、多语言模式或关键词库。如需使用这些功能,请直接连接 WebSocket API。
Scribe v2
Scribe v2 是我们此前领先的语音识别模型,现已由 Scribe v3 接替。它专为 90 多种语言的准确转写而设计,提供精确的词级时间戳以及说话人分离、动态音频标记等高级功能。
该模型擅长需要准确语音转文字转换的场景:
- 转写服务:非常适合将音频或视频内容转换为文字
- 会议文档:适合捕获并记录对话内容
- 内容分析:适用于音频内容处理和分析
- 多语言识别:支持 90 多种语言的准确转写
主要功能:
- 带词级时间戳的准确转写
- 多说话人音频的说话人分离
- 用于增强上下文的动态音频标记
- 支持 90 多种语言
- 实体检测
- 关键词提示
- 转写文本编辑
在此处详细了解 Scribe v2。
Scribe v2 Realtime
Scribe v2 Realtime 是我们此前领先的实时语音识别模型,现已由 Scribe v3 Live 接替。它可转写 90 多种语言,提交转写文本的中位耗时约为 150ms。请参阅延迟测量方法。
该模型擅长对话场景:
- 实时会议转写:非常适合实时转写
- AI 智能体:适合实时对话
- 多语言识别:支持 90 多种语言的准确转写和自动语言识别
主要功能:
- 超低延迟:获取已提交转写文本的中位延迟约为 150 毫秒
- 流式支持:在实时接收转写文本的同时分块发送音频
- 多种音频格式:支持 PCM(8kHz 至 48kHz)和 μ-law 编码
- 语音活动检测(VAD):基于静音检测自动分割语音
- 手动提交控制:可完全控制何时完成转写片段
- 实体检测
- 实体脱敏
- 转写文本编辑
在此处详细了解 Scribe v2 Realtime。
Scribe v2 Medical
Scribe v2 Medical 是一款专用于医疗和临床音频的批量语音识别模型。它是 Scribe v2 的微调版本,可提升药物名称、解剖学、病理学和临床听写的识别效果,同时保持 Scribe v2 对日常语音的准确性。它与 Scribe v2 使用相同的语音转文字 API,计费标准也相同。将 scribe_v2_medical 作为 model_id 传入。
预期用途
Scribe v2 Medical 是面向开发者和组织的批量语音转文字 API 模型, 可集成到将临床音频(包括医护人员与患者的对话、听写、接诊及护理协调通话) 转换为文档记录和相关行政 workflow 所用转写文本草稿的应用中。生成的文本 须在使用前由医疗专业人员或其他获授权用户审核并修正。Scribe v2 Medical 并非用于解读临床信息,或提供诊断、治疗建议、临床决策或其他临床指导。
该模型尤其适合:
- 临床文档记录:医疗术语在对话中途出现的环境式问诊和笔记
- 听写:包含大量药物、剂量和检查结果的连续内容
- 接诊和协调通话:患者通常通过电话描述自身病情
- 合规 workflow:可结合实体检测识别 PHI 类别
主要功能:
- 与 Scribe v2 的请求格式相同(
keyterms、entity_detection、no_verbatim、说话人分离、时间戳) - 改进药物名称、解剖学和病理学术语识别
- 相比 Scribe v2,日常语音识别效果不降低
- 支持 90 多种语言
- 多说话人音频的说话人分离
- 动态音频标记
- 实体检测,包括 PHI 类别
Scribe v2 Medical 是批量模型。如需实时转写,请使用 Scribe v2 Realtime。
Scribe v2 Medical 符合 HIPAA 要求,企业版客户可签署业务伙伴协议,也可使用零保留模式(ZRM)。启用 ZRM 后,每个请求完成后会立即删除音频输入和文本输出。ElevenLabs 不保留任何内容;应用会收到完整 API 响应,并可在自己的控制下保留转写文本。
需要符合 HIPAA 要求的公司必须先联系 ElevenLabs 销售团队 签署业务伙伴协议(BAA),才能发送受保护的健康信息。
在此处详细了解语音转文字。
SFX v3
SFX v3(eleven_text_to_sound_v3)是我们最新的音效模型。它与 eleven_text_to_sound_v2 使用相同的音效 API:将 model_id 设为 eleven_text_to_sound_v3 即可使用。eleven_text_to_sound_v2 仍是默认模型,但已弃用,并将于 2027 年 3 月 1 日移除。
与 eleven_text_to_sound_v2 相比,SFX v3:
- 可在一个提示词中遵循多条指令,例如“足球观众欢呼,听到球落地,观众发出嘘声”。
- 可处理包含音乐或演唱的提示词,例如“福音合唱团唱 hello”。
- 生成更自然的结果。
- 对锣、钟声和口哨等高频声音更不易出现削波。
结果因提示词而异,因此切换前请使用自己的提示词对比两种模型。
SFX v3 支持循环。将 loop 设为 true,即可生成可平滑循环的音效。
在 ElevenCreative 中,SFX v3 可在音效、Flows 和 Studio 中使用。
在此处详细了解音效。
Eleven Realtime
Eleven Realtime 是一类用于构建自然语音智能体的新型语音转语音模型。每个 Realtime 模型都是完整的语音智能体:语音识别、语音活动检测和轮次管理、LLM 以及文本转语音,均由 ElevenLabs 选择并调优,使其作为一个系统协同工作。选择一个 Realtime 模型,即可通过单一选择获得性能出色的智能体,无需配置任何组件。
现有两种 Realtime 模型。
Eleven Realtime v1 Mini 专为快速自然的对话优化,尤其适合以下场景:
- AI 助手:适合以对话本身为产品的快速、富有表现力的交流。
- 教育辅导:能跟上学习者节奏的自然来回交流。
- 互动角色:适用于游戏和娱乐的富有表现力的角色。
Eleven Realtime v1 Max 专为复杂任务优化,尤其适合以下场景:
- 客户支持:解决需要遵循流程和查找信息的问题。
- 潜在客户筛选:收集信息并决定后续步骤的结构化对话。
- 多步骤 workflow:调用工具查找信息或执行操作的任务。
主要功能:
- 通过一个模型选择即可获得语音识别、轮次管理、语言模型和音色
- 自然的轮次管理和打断处理
- 工具调用
- 可使用 ElevenLabs 声音库中的音色进行自定义
- 支持 90 多种语言
- 通过选择模型即可在 v1 Mini 和 v1 Max 之间切换,无需修改集成
Eleven Realtime 可在 ElevenAgents 中使用:从模型下拉菜单选择 Realtime 模型即可;也可通过 Realtime API 使用,该 API 设计为通过 WebSocket 兼容 OpenAI 的 Realtime API。如果你已在使用 OpenAI 的 Realtime API,请参阅迁移指南。
支持的语言
Realtime 模型支持 90 多种语言。请参阅 Eleven v4 语言列表。
在此处详细了解 Eleven Realtime。
Eleven Music
Eleven Music 是我们的录音室级音乐生成模型。你可以通过自然语言提示词生成任意风格的音乐。
该模型非常适合以下场景:
- 游戏原声:为游戏创作沉浸式原声音乐
- 播客背景音乐:使用专业音乐增强播客效果
- 营销:为广告短片添加背景音乐
主要功能:
- 完全控制流派、风格和结构
- 可生成带人声或纯器乐音乐
- 支持多语言,包括英语、西班牙语、德语、日语等
- 编辑单个段落或整首歌曲的声音和歌词
在此处详细了解 Eleven Music。
并发与优先级
订阅套餐决定可同时处理的请求数量,以及请求在队列中的优先级。 语音转文本的并发上限更高。 达到并发上限后,后续请求会与优先级较低的请求一同排队处理。 通常这只会增加约 50ms 延迟。
要估算流量所需的并发上限,请使用并发估算器。
响应标头包含 current-concurrent-requests 和 maximum-concurrent-requests,可用于监控并发情况。
每分钟 API 请求数与并发请求数
请注意,每分钟 API 请求数和并发请求数是不同的指标,具体取决于使用模式。
每分钟 API 请求数可能不同于并发请求数,因为它取决于每个请求的耗时以及请求的批量发送方式。
示例 1:间隔发送请求 如果每分钟有 180 个请求,每个请求需 1 秒完成,并且每隔 0.33 秒发送一个请求,那么最大并发请求数和平均并发请求数均为 3,因为始终会有 3 个请求在处理中。
示例 2:批量发送请求 但如果使用模式不同,例如每分钟有 180 个请求,每个请求需 3 秒完成,但全部同时发出,那么最大并发请求数为 180,平均并发请求数为 9(该分钟的前 3 秒同时有 180 个请求,后 57 秒则为 0 个请求)。
由于系统关注的是并发量,每分钟请求数的重要性不如每个请求的耗时以及发送模式。
端点请求的方式会影响并发限制:
- 使用 HTTP 时,每个请求都会单独计入并发上限。
- 使用文本转语音 WebSocket 时,只有模型生成音频的时间会计入并发上限。这意味着大多数时候,已打开的 websocket 完全不计入并发上限。
- 文本转对话 WebSocket 的工作方式不同:每个打开的连接都会从独立资源池中预留一个对话会话,直至连接关闭;通过该连接生成的音频不计入标准并发上限。这样更容易理解:一个连接即一个会话,并且对话会话上限经过调整以适应这种新的并发计算方式。请参阅文本转对话并发。
了解并发限制
套餐对应的并发上限不应理解为可同时处理的对话、电话、角色旁白等的最大数量。 实际数量取决于多项因素,包括所使用的具体 AI 语音及使用场景特征。
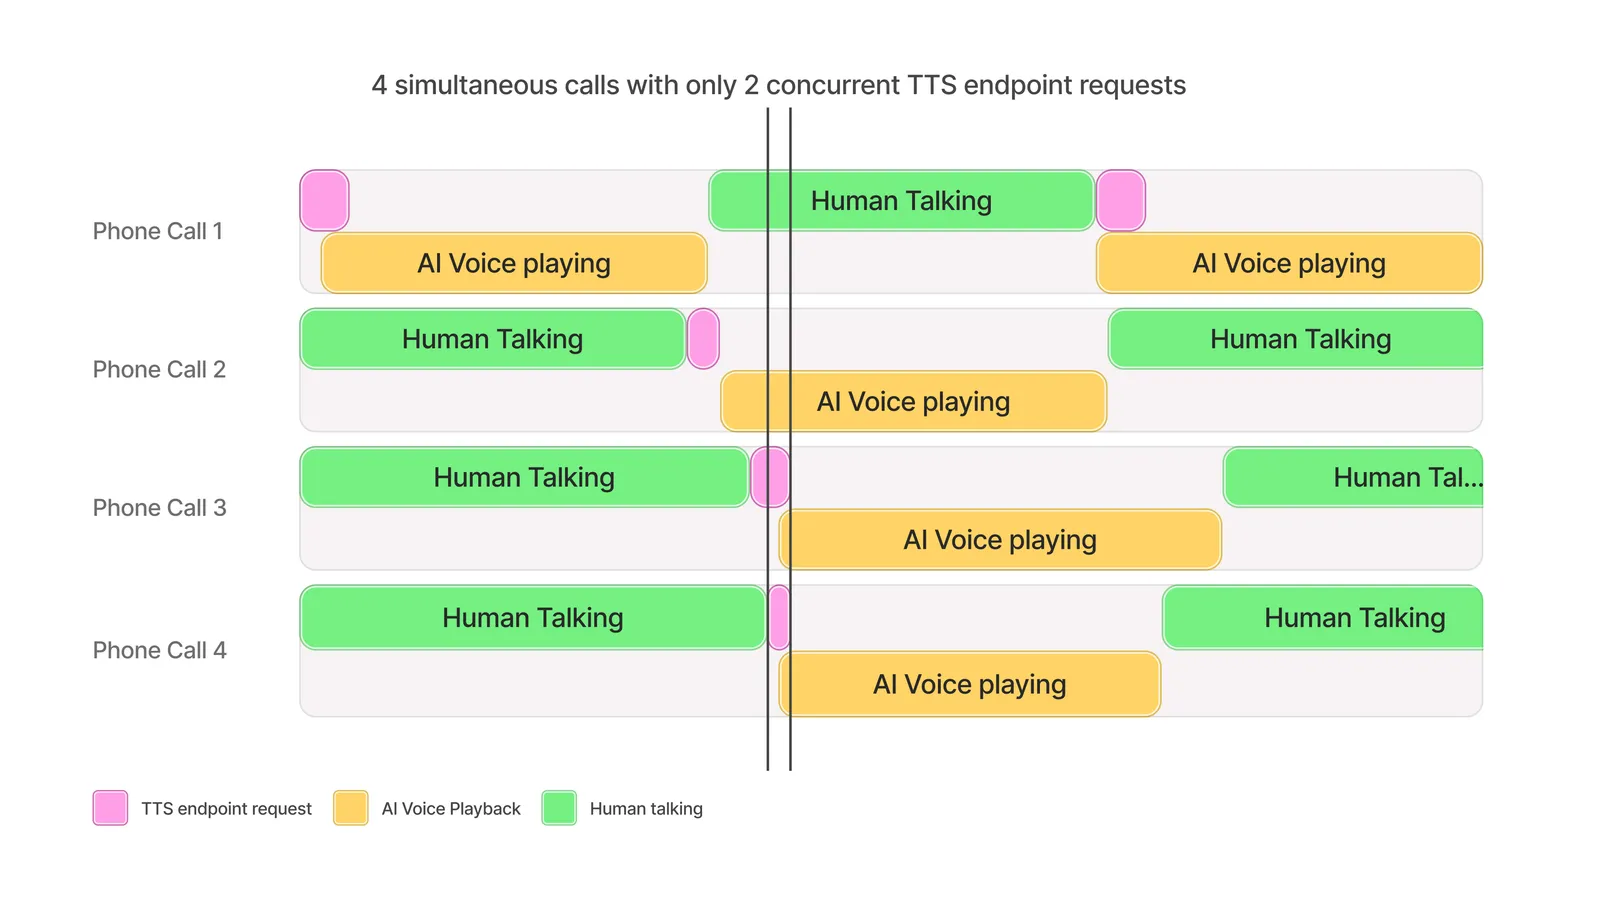
一般来说,并发上限为 5 通常可支持约 100 路同时音频广播。
这是因为,相较于处理 TTS 请求的时间,音频生成速度更快。 下图展示了如何在仅达到 2 个并发请求的情况下,同时支持与不同用户进行的 4 通电话。
构建 AI 语音智能体
如果使用 TTS 进行对话,并发上限为 5 时,可支持约 100 路 AI 智能体与人工参与者之间较为均衡的对话广播。
如果 AI 智能体的发言频率低于人工参与者,例如在客户支持场景中,则可支持超过 100 路同时对话。
角色旁白配音
通常,并发上限为 5 时可支持超过 100 路同时角色旁白配音。
具体数量可能因角色对话频率、停顿时长以及台词之间的游戏内操作而异。
直播配音
并发配音流通常遵循上述经验法则。
如果直播中存在对话停顿时段(例如由于配乐、视觉场景等),则可能支持比建议值更多的同时配音流。
如果在任何时候超出套餐并发限制,且使用企业版套餐,模型请求仍可能根据可用容量以尽力而为的方式成功处理,但速度会较慢。
要提高并发上限和队列优先级,请升级订阅 套餐。
企业版客户可联系客户经理申请更高的并发上限。
文本转对话并发
根据调用 API 的方式,文本转对话请求有两种不同的计量方式:
- HTTP 端点(创建对话和流式对话)会在生成音频期间计入套餐的标准并发上限,与其他文本转语音请求相同。
- WebSocket 端点,例如文本转对话 WebSocket,按对话会话计量。只要连接保持打开,无论是否正在生成音频,都会占用一个对话会话。
基于会话的计量让容量规划更简单:一个连接即一个会话,因此用量不会随生成活动而波动。由于会话在整个连接期间都会被占用,而非仅在生成音频时占用,对话会话上限经过调整以适应这种新的并发计算方式。
如果在工作区所有对话会话均已占用时打开连接,新连接会被拒绝,并返回 too_many_concurrent_requests 错误。要释放会话,请关闭不再需要的连接;除非发送 keep_alive 消息,否则连接在空闲 20 秒后也会自动关闭。
要监控对话会话,请在控制台侧边栏底部打开 开发者,选择 分析 标签页,并在用量视图中查看 并发请求 指标。对话会话会作为独立数据系列 TTD Websocket Sessions 报告,与其他并发请求分开显示。
并发限制压测
压测有助于识别客户端扩展问题,并验证是否已针对使用场景正确设置并发限制。
强烈建议尽可能贴近实际使用情况测试端到端 workflow。推荐通过模拟并测量可支持的用户数量来实现这一点。请注意:
- 模拟用户,而非原始请求
- 模拟典型用户行为,例如在发出请求前,等待音频播放、用户发言或转录完成
- 在数分钟内缓慢增加用户数量
- 为请求时机和请求大小引入随机性
- 记录延迟指标以及 API 返回的所有错误代码
例如,要测试一个旨在支持 100 路同时对话的智能体系统,可创建最多 100 个独立“用户”,每个用户模拟一段对话。对话通常由以下循环组成:用户发言约 10 秒,然后通过 TTS API 请求约 150 个字符,随后向用户播放音频约 10 秒。因此,每个用户应每隔 20 秒通过 websocket 发起一次文本转语音 API 调用,请求 150 个字符的文本,并对等待时间和请求字符数加入少量随机性。测试应每秒启动一个用户,直至达到 100 个用户,然后总共测试 10 分钟,以验证整体稳定性。