

Modelos
Modelos principais
Text to Speech
Speech to Text
Agentes de voz
Música
Visão geral dos modelos
A API da ElevenLabs oferece uma variedade de modelos de áudio otimizados para diferentes casos de uso, níveis de qualidade e requisitos de desempenho.
† Mediana, excluindo a latência do aplicativo e da rede. Veja como a latência é medida.
Modelos descontinuados
O modelo music_v1 está descontinuado e será removido em 31 de janeiro de 2027. O modelo
eleven_text_to_sound_v2 está descontinuado e será removido em 1º de março de 2027. Faça a
migração para os modelos substitutos abaixo para continuar usando o serviço. Se suas solicitações não definem
model_id, defina-o explicitamente como o modelo substituto.
Os modelos eleven_turbo_v2_5 e eleven_turbo_v2 são funcionalmente equivalentes aos modelos
eleven_flash_v2_5 e eleven_flash_v2, respectivamente, exceto que a latência dos modelos Flash
é menor em média. Recomendamos usar os modelos Flash em vez dos modelos Turbo em todos os casos
de uso.
Eleven v4
O Eleven v4 é nosso modelo de síntese de fala de última geração, oferecendo áudio da mais alta qualidade, expressividade e controle sobre a interpretação das vozes. O Eleven v4 oferece suporte à clonagem de voz de alta fidelidade, com preservação confiável do locutor em gerações de textos longos.
Este modelo funciona bem nos seguintes cenários:
- Locuções de personagens: Ideal para jogos e animações devido à sua amplitude emocional.
- Diálogo emocional: Gere diálogos naturais e realistas, com alta amplitude emocional e compreensão contextual.
- Produção de audiolivros: Perfeito para narrações longas com interpretação emocional complexa.
- Projetos multilíngues: Mantém uma qualidade de voz consistente ao alternar entre idiomas.
O Eleven v4 está disponível pela API Text to Dialogue.
Idiomas compatíveis
A família de modelos Eleven v4 oferece suporte a mais de 90 idiomas, incluindo:
Africâner (af), Amárico (am), Árabe (ar), Armênio (hy), Assamês (as), Asturiano (ast), Azerbaijano (az), Bielorrusso (be), Bengali (bn), Bósnio (bs), Búlgaro (bg), Birmanês (my), Cantonês (yue), Catalão (ca), Cebuano (ceb), Croata (hr), Tcheco (cs), Dinamarquês (da), Holandês (nl), Inglês (en), Estoniano (et), Filipino (fil), Finlandês (fi), Francês (fr), Fula (Pulaar) (ff), Galego (gl), Georgiano (ka), Alemão (de), Grego (el), Guzerate (gu), Hauçá (ha), Hebraico (he), Hindi (hi), Húngaro (hu), Islandês (is), Indonésio (id), Italiano (it), Japonês (ja), Javanês (jv), Kamba (kam), Canarês (kn), Cazaque (kk), Coreano (ko), Quirguiz (ky), Laosiano (lo), Letão (lv), Lingala (ln), Lituano (lt), Luganda (lg), Luxemburguês (lb), Macedônio (mk), Malaio (ms), Malaiala (ml), Maltês (mt), Chinês mandarim (zh), Maori (mi), Marata (mr), Mongol (mn), Nepalês (ne), Norueguês (no), Occitano (oc), Odia (or), Pachto (ps), Persa (fa), Polonês (pl), Português (pt), Punjabi (pa), Romeno (ro), Russo (ru), Sérvio (sr), Xona (sn), Sindi (sd), Eslovaco (sk), Esloveno (sl), Somali (so), Curdo sorâni (ckb), Espanhol (es), Suaíli (sw), Sueco (sv), Tajique (tg), Tâmil (ta), Télugo (te), Tailandês (th), Turco (tr), Ucraniano (uk), Urdu (ur), Uzbeque (uz), Vietnamita (vi), Galês (cy), Uolofe (wo), Zulu (zu).
Eleven v4 Turbo
Eleven v4 Turbo é nosso modelo mais avançado para síntese de voz em tempo real, oferecendo áudio de alta qualidade, expressividade e controle sobre a interpretação das vozes. O Eleven v4 Turbo oferece suporte à clonagem de voz de alta fidelidade e tem latência mediana de ~100 ms. Veja como a latência é medida.
Este modelo funciona bem nos seguintes cenários:
- Agentes de suporte: Potencialize agentes de voz que resolvem dúvidas de clientes em tempo real.
- Assistentes de IA: Gere diálogos naturais e realistas com ampla gama emocional e compreensão contextual.
- Personagens interativos: Excelente para experiências de áudio com personagens expressivos.
O Eleven v4 Turbo está disponível pelo WebSocket de Text to Dialogue.
Idiomas compatíveis
A família de modelos Eleven v4 oferece suporte a mais de 90 idiomas, incluindo:
Africâner (af), Amárico (am), Árabe (ar), Armênio (hy), Assamês (as), Asturiano (ast), Azerbaijano (az), Bielorrusso (be), Bengali (bn), Bósnio (bs), Búlgaro (bg), Birmanês (my), Cantonês (yue), Catalão (ca), Cebuano (ceb), Croata (hr), Tcheco (cs), Dinamarquês (da), Holandês (nl), Inglês (en), Estoniano (et), Filipino (fil), Finlandês (fi), Francês (fr), Fula (Pulaar) (ff), Galego (gl), Georgiano (ka), Alemão (de), Grego (el), Guzerate (gu), Hauçá (ha), Hebraico (he), Hindi (hi), Húngaro (hu), Islandês (is), Indonésio (id), Italiano (it), Japonês (ja), Javanês (jv), Kamba (kam), Canarês (kn), Cazaque (kk), Coreano (ko), Quirguiz (ky), Laosiano (lo), Letão (lv), Lingala (ln), Lituano (lt), Luganda (lg), Luxemburguês (lb), Macedônio (mk), Malaio (ms), Malaiala (ml), Maltês (mt), Chinês mandarim (zh), Maori (mi), Marata (mr), Mongol (mn), Nepalês (ne), Norueguês (no), Occitano (oc), Odia (or), Pachto (ps), Persa (fa), Polonês (pl), Português (pt), Punjabi (pa), Romeno (ro), Russo (ru), Sérvio (sr), Xona (sn), Sindi (sd), Eslovaco (sk), Esloveno (sl), Somali (so), Curdo sorâni (ckb), Espanhol (es), Suaíli (sw), Sueco (sv), Tajique (tg), Tâmil (ta), Télugo (te), Tailandês (th), Turco (tr), Ucraniano (uk), Urdu (ur), Uzbeque (uz), Vietnamita (vi), Galês (cy), Uolofe (wo), Zulu (zu).
Eleven v3
O Eleven v3 é nosso modelo de síntese de voz da geração anterior, que produz fala natural e realista com ampla gama emocional e compreensão contextual em vários idiomas.
Com o Eleven v3, chega uma nova API de Text to Dialogue, que permite gerar diálogos naturais e realistas com ampla gama emocional e compreensão contextual em vários idiomas. O Eleven v3 também pode ser usado com a API de Text to Speech para gerar fala natural e realista com ampla gama emocional e compreensão contextual em vários idiomas.
Leia mais sobre a API de Text to Dialogue aqui.
Idiomas compatíveis
O modelo Eleven v3 oferece suporte a mais de 70 idiomas, incluindo:
Africâner (af), árabe (ar), armênio (hy), assamês (as), asturiano (ast), azerbaijano (az), bielorrusso (be), bengali (bn), bósnio (bs), búlgaro (bg), birmanês (my), cantonês (yue), catalão (ca), cebuano (ceb), chichewa (ny), croata (hr), tcheco (cs), dinamarquês (da), holandês (nl), inglês (en), estoniano (et), filipino (fil), finlandês (fi), francês (fr), galego (gl), georgiano (ka), alemão (de), grego (el), guzerate (gu), hauçá (ha), hebraico (he), hindi (hi), húngaro (hu), islandês (is), indonésio (id), irlandês (ga), italiano (it), japonês (ja), javanês (jv), canarês (kn), cazaque (kk), quirguiz (ky), coreano (ko), letão (lv), lingala (ln), lituano (lt), luxemburguês (lb), macedônio (mk), malaio (ms), malaiala (ml), maltês (mt), chinês mandarim (zh), maori (mi), marata (mr), mongol (mn), nepalês (ne), norueguês (no), occitano (oc), odia (or), pachto (ps), persa (fa), polonês (pl), português (pt), punjabi (pa), romeno (ro), russo (ru), sérvio (sr), sindi (sd), eslovaco (sk), esloveno (sl), somali (so), espanhol (es), suaíli (sw), sueco (sv), tadjique (tg), tâmil (ta), telugu (te), tailandês (th), turco (tr), ucraniano (uk), urdu (ur), uzbeque (uz), vietnamita (vi), galês (cy), iorubá (yo).
Eleven v3 Conversational
O Eleven v3 Conversational é nosso modelo da geração anterior para síntese de voz em tempo real. Ele produz fala natural e realista com ampla gama emocional e compreensão contextual em vários idiomas.
Com o Eleven v3 Conversational, chega um novo WebSocket de Text to Dialogue, que permite gerar diálogos naturais e realistas com ampla gama emocional e compreensão contextual em vários idiomas.
Com o Eleven v3 Conversational, chega um novo WebSocket de Text to Dialogue, que permite gerar diálogos naturais e realistas com ampla gama emocional e compreensão contextual em vários idiomas.
Leia mais sobre o WebSocket de Text to Dialogue aqui.
Idiomas compatíveis
O modelo Eleven v3 oferece suporte a mais de 70 idiomas, incluindo:
Africâner (af), árabe (ar), armênio (hy), assamês (as), asturiano (ast), azerbaijano (az), bielorrusso (be), bengali (bn), bósnio (bs), búlgaro (bg), birmanês (my), cantonês (yue), catalão (ca), cebuano (ceb), chichewa (ny), croata (hr), tcheco (cs), dinamarquês (da), holandês (nl), inglês (en), estoniano (et), filipino (fil), finlandês (fi), francês (fr), galego (gl), georgiano (ka), alemão (de), grego (el), guzerate (gu), hauçá (ha), hebraico (he), hindi (hi), húngaro (hu), islandês (is), indonésio (id), irlandês (ga), italiano (it), japonês (ja), javanês (jv), canarês (kn), cazaque (kk), quirguiz (ky), coreano (ko), letão (lv), lingala (ln), lituano (lt), luxemburguês (lb), macedônio (mk), malaio (ms), malaiala (ml), maltês (mt), chinês mandarim (zh), maori (mi), marata (mr), mongol (mn), nepalês (ne), norueguês (no), occitano (oc), odia (or), pachto (ps), persa (fa), polonês (pl), português (pt), punjabi (pa), romeno (ro), russo (ru), sérvio (sr), sindi (sd), eslovaco (sk), esloveno (sl), somali (so), espanhol (es), suaíli (sw), sueco (sv), tadjique (tg), tâmil (ta), telugu (te), tailandês (th), turco (tr), ucraniano (uk), urdu (ur), uzbeque (uz), vietnamita (vi), galês (cy), iorubá (yo).
Multilingual v2
O Eleven Multilingual v2 é um modelo de síntese de voz da geração anterior com percepção emocional. Ele produz fala natural e realista com ampla gama emocional e compreensão contextual em vários idiomas.
O modelo oferece qualidade de voz e personalidade consistentes em todos os idiomas compatíveis, mantendo as características únicas e o sotaque do falante.
Este modelo se destaca em cenários que exigem fala de alta qualidade e com nuances emocionais:
- Locuções de personagens: Ideal para jogos e animações devido à sua gama emocional.
- Conteúdo profissional: Adequado para vídeos corporativos e materiais de e-learning.
- Projetos multilíngues: Mantém uma qualidade de voz consistente ao alternar entre idiomas.
- Qualidade estável: Produz áudio consistente e de alta qualidade.
Embora tenha maior latência e custo por caractere do que os modelos Flash, ele oferece qualidade superior para projetos em que uma fala realista é importante.
Nossos modelos multilíngues v2 oferecem suporte a 29 idiomas:
Inglês (EUA, Reino Unido, Austrália, Canadá), Japonês, Chinês, Alemão, Hindi, Francês (França, Canadá), Coreano, Português (Brasil, Portugal), Italiano, Espanhol (Espanha, México), Indonésio, Holandês, Turco, Filipino, Polonês, Sueco, Búlgaro, Romeno, Árabe (Arábia Saudita, Emirados Árabes Unidos), Tcheco, Grego, Finlandês, Croata, Malaio, Eslovaco, Dinamarquês, Tâmil, Ucraniano e Russo.
Flash v2.5
O Eleven Flash v2.5 é um modelo de síntese de voz de baixa latência projetado para aplicações em tempo real e a Agents Platform. Ele oferece fala de alta qualidade com latência mediana de ~100 ms† em 32 idiomas.
O modelo equilibra velocidade e qualidade, tornando-o ideal para aplicações interativas e mantendo uma saída com som natural e características de voz consistentes entre idiomas.
Este modelo é especialmente adequado para:
- Agents Platform: Perfeito para agentes de voz e chatbots em tempo real.
- Aplicações interativas: Ideal para jogos e aplicações que exigem resposta imediata.
- Processamento em larga escala: Eficiente para conversão em massa de texto em fala.
Com preço mais baixo para gerações pela API e baixa latência, o Flash v2.5 é a opção econômica para quem precisa de síntese de voz rápida e confiável em vários idiomas.
O Flash v2.5 oferece suporte a 32 idiomas — todos os idiomas dos modelos v2, além de:
Húngaro, Norueguês e Vietnamita
† Mediana, excluindo a latência da aplicação e da rede. Veja como a latência é medida.
Considerações
Normalização de texto com números
Ao usar o Flash v2.5, os números não são normalizados por padrão da maneira que você talvez espere. Por exemplo, números de telefone podem ser lidos de uma forma que não fique clara para o usuário. Datas e moedas são afetadas de modo semelhante.
Por padrão, a normalização é desativada no Flash v2.5 para manter a baixa latência. No entanto, clientes Enterprise agora podem ativar a normalização de texto para modelos v2.5 definindo o parâmetro apply_text_normalization como “on” na solicitação.
O modelo Multilingual v2 faz um trabalho melhor ao normalizar números, por isso recomendamos usá-lo para números de telefone e outros casos em que a normalização de números é importante.
Para aplicações de baixa latência ou da Agents Platform, a prática recomendada é fazer com que seu LLM normalize o texto antes de enviá-lo ao modelo TTS ou usar o parâmetro apply_text_normalization (somente planos Enterprise para modelos v2.5).
Guia de seleção de modelos
Para saber qual modelo atende melhor aos seus requisitos e caso de uso, consulte o guia de seleção de modelos.
Requisitos
Caso de uso
Limites de caracteres
O número máximo de caracteres aceitos em uma única solicitação de texto para fala varia conforme o modelo.
Scribe v2
O Scribe v2 é nosso modelo mais avançado de reconhecimento de fala, desenvolvido para transcrição precisa em mais de 90 idiomas. Ele fornece timestamps precisos no nível das palavras e recursos avançados, como diarização de falantes e marcação dinâmica de áudio.
Este modelo se destaca em cenários que exigem conversão precisa de fala em texto:
- Serviços de transcrição: Perfeito para converter conteúdo de áudio/vídeo em texto
- Documentação de reuniões: Ideal para capturar e documentar conversas
- Análise de conteúdo: Adequado para processamento e análise de conteúdo de áudio
- Reconhecimento multilíngue: Oferece suporte a transcrição precisa em mais de 90 idiomas
Principais recursos:
- Transcrição precisa com timestamps no nível das palavras
- Diarização de falantes para áudio com vários falantes
- Marcação dinâmica de áudio para mais contexto
- Suporte a mais de 90 idiomas
- Detecção de entidades
- Orientação por termos-chave
- Edição de transcrições
Leia mais sobre o Scribe v2 aqui.
Scribe v2 Realtime
O Scribe v2 Realtime, nosso modelo mais rápido e preciso de reconhecimento de fala ao vivo, oferece precisão de ponta em mais de 90 idiomas, com tempo mediano até a transcrição confirmada de ~150 ms. Veja como a latência é medida.
Este modelo se destaca em casos de uso conversacionais:
- Transcrição de reuniões ao vivo: Perfeito para transcrição em tempo real
- Agentes de IA: Ideal para conversas ao vivo
- Reconhecimento multilíngue: Oferece suporte a transcrição precisa em mais de 90 idiomas com reconhecimento automático de idioma
Principais recursos:
- Latência ultrabaixa: obtenha transcrições confirmadas com latência mediana de ~150 milissegundos
- Suporte a streaming: envie áudio em partes enquanto recebe transcrições em tempo real
- Vários formatos de áudio: suporte a PCM (de 8 kHz a 48 kHz) e codificação μ-law
- Detecção de atividade de voz (VAD): segmentação automática de fala com base na detecção de silêncio
- Controle manual de confirmação: controle total sobre quando finalizar segmentos de transcrição
- Detecção de entidades
- Redação de entidades
- Edição de transcrições
Leia mais sobre o Scribe v2 Realtime aqui.
Scribe v2 Medical
O Scribe v2 Medical é um modelo de reconhecimento de fala em lote especializado em áudio médico e clínico. É um finetune do Scribe v2 que melhora o reconhecimento de nomes de medicamentos, anatomia, patologia e ditado clínico, mantendo a precisão do Scribe v2 na fala cotidiana. Ele usa a mesma API de Speech to Text do Scribe v2 e é cobrado pela mesma tarifa. Passe scribe_v2_medical como model_id.
Finalidade prevista
O Scribe v2 Medical é um modelo de API de Speech-to-Text em lote para desenvolvedores e organizações integrarem a aplicações que convertem áudio clínico, incluindo conversas entre profissionais de saúde e pacientes, ditados, chamadas de triagem e coordenação de cuidados, em transcrições preliminares para documentação e fluxos de trabalho administrativos relacionados. O texto resultante destina-se à revisão e correção por um profissional de saúde ou outro usuário autorizado antes do uso. O Scribe v2 Medical não se destina a interpretar informações clínicas nem fornecer diagnósticos, recomendações de tratamento, decisões clínicas ou outras orientações clínicas.
Este modelo é adequado para:
- Documentação clínica: Consultas e anotações em ambiente clínico nas quais termos médicos surgem durante a conversa
- Ditado: Sequências densas de medicamentos, dosagens e achados
- Chamadas de triagem e coordenação: Pacientes descrevendo suas próprias condições, geralmente por telefone
- Fluxos de trabalho de conformidade: Combine com a detecção de entidades para categorias de PHI
Principais recursos:
- Mesma estrutura de solicitação do Scribe v2 (
keyterms,entity_detection,no_verbatim, diarização, timestamps) - Reconhecimento aprimorado de nomes de medicamentos, termos de anatomia e patologia
- Sem regressão na fala cotidiana em comparação com o Scribe v2
- Suporte a mais de 90 idiomas
- Diarização de falantes para áudio com vários falantes
- Marcação dinâmica de áudio
- Detecção de entidades, incluindo categorias de PHI
O Scribe v2 Medical é um modelo em lote. Para transcrição ao vivo, use o Scribe v2 Realtime.
O Scribe v2 Medical é elegível para HIPAA, com Acordos de Associado Comercial disponíveis para clientes Enterprise, além do Modo de Retenção Zero (ZRM). Com o ZRM ativado, a entrada de áudio e a saída de texto são excluídas imediatamente após a conclusão de cada solicitação. A ElevenLabs não retém nada, e sua aplicação recebe a resposta completa da API e mantém as transcrições sob seus próprios controles.
Empresas que exigem conformidade com a HIPAA devem entrar em contato com as vendas da ElevenLabs para assinar um Acordo de Associado Comercial (BAA) antes de enviar informações de saúde protegidas.
Leia mais sobre Speech to Text aqui.
SFX v3
O SFX v3 (eleven_text_to_sound_v3) é nosso mais novo modelo de efeitos sonoros. Ele usa a mesma API de Efeitos Sonoros que eleven_text_to_sound_v2: defina model_id como eleven_text_to_sound_v3 para usá-lo. eleven_text_to_sound_v2 ainda é o padrão, mas está obsoleto e será removido em 1º de março de 2027.
Em comparação com eleven_text_to_sound_v2, o SFX v3:
- Segue várias instruções em um único prompt, como “Torcida de futebol comemorando, som de uma bola caindo, torcida vaiando”.
- Processa prompts que incluem música ou vocais, como “Coral gospel cantando olá”.
- Produz resultados com som mais natural.
- Tem menos probabilidade de causar clipping em sons de alta frequência, como gongos, sinos e apitos.
Os resultados variam conforme o prompt, então compare os dois modelos com seus próprios prompts antes de fazer a troca.
O SFX v3 oferece suporte a repetição. Defina loop como true para gerar um efeito sonoro que se repete suavemente.
No ElevenCreative, o SFX v3 está disponível em Efeitos Sonoros, Flows e Estúdio.
Leia mais sobre efeitos sonoros aqui.
Eleven Realtime
O Eleven Realtime é uma nova classe de modelos de Speech to Speech para criar agentes de voz naturais. Cada modelo Realtime é um agente de voz completo: reconhecimento de fala, detecção de atividade de voz e gerenciamento de turnos, LLM e texto para fala, selecionados e ajustados pela ElevenLabs para funcionar juntos como um único sistema. Selecione um modelo Realtime e você terá um agente com bom desempenho a partir de uma única escolha, sem componentes para configurar.
Há dois modelos Realtime disponíveis.
O Eleven Realtime v1 Mini é otimizado para conversas rápidas e naturais e funciona bem nos seguintes cenários:
- Assistentes de IA: Diálogos rápidos e expressivos em que a própria conversa é o produto.
- Tutores educacionais: Interações naturais que acompanham o ritmo do aluno.
- Personagens interativos: Personagens expressivos para jogos e entretenimento.
O Eleven Realtime v1 Max é otimizado para tarefas complexas e funciona bem nos seguintes cenários:
- Suporte ao cliente: Resolução de dúvidas que exigem seguir um processo e buscar informações.
- Qualificação de leads: Conversas estruturadas que coletam informações e definem os próximos passos.
- Fluxos de trabalho com várias etapas: Tarefas que chamam ferramentas para buscar informações ou executar ações.
Principais recursos:
- Reconhecimento de fala, gerenciamento de turnos, modelo de linguagem e voz em uma única escolha de modelo
- Gerenciamento natural de turnos e interrupções
- Chamada de ferramentas
- Vozes personalizáveis da Voice Library da ElevenLabs
- Suporte a mais de 90 idiomas
- Alterne entre v1 Mini e v1 Max com uma seleção de modelo, sem mudar a integração
O Eleven Realtime está disponível no ElevenAgents, onde você seleciona um modelo Realtime no menu suspenso de modelos, e pela API Realtime, projetada para ser compatível com a API Realtime da OpenAI por WebSocket. Se você já usa a API Realtime da OpenAI, consulte o guia de migração.
Idiomas compatíveis
Os modelos Realtime oferecem suporte a mais de 90 idiomas. Veja a lista de idiomas do Eleven v4.
Leia mais sobre o Eleven Realtime aqui.
Eleven Music
O Eleven Music é nosso modelo de geração de música com qualidade de estúdio. Ele permite gerar música de qualquer estilo com prompts em linguagem natural.
Este modelo é excelente para os seguintes cenários:
- Trilhas sonoras de jogos: Crie trilhas imersivas para jogos
- Música de fundo para podcasts: Aprimore podcasts com música profissional
- Marketing: Adicione música de fundo a vídeos de anúncios
Principais recursos:
- Controle completo sobre gênero, estilo e estrutura
- Vocais ou somente instrumental
- Multilíngue, incluindo inglês, espanhol, alemão, japonês e muito mais
- Edite o som e a letra de seções individuais ou da música inteira
Leia mais sobre o Eleven Music aqui.
Simultaneidade e prioridade
Seu plano de assinatura determina quantas solicitações podem ser processadas simultaneamente e o nível de prioridade das suas solicitações na fila. O Speech to Text tem um limite de simultaneidade maior. Quando o limite de simultaneidade é atingido, as solicitações subsequentes são processadas em uma fila junto com solicitações de menor prioridade. Na prática, isso normalmente adiciona apenas cerca de 50 ms de latência.
Os cabeçalhos de resposta incluem current-concurrent-requests e maximum-concurrent-requests, que você pode usar para monitorar sua simultaneidade.
Solicitações da API por minuto vs. solicitações simultâneas
É importante entender que solicitações da API por minuto e solicitações simultâneas são métricas diferentes que dependem dos seus padrões de uso.
As solicitações da API por minuto podem ser diferentes das solicitações simultâneas, pois isso depende da duração de cada solicitação e de como elas são agrupadas.
Exemplo 1: Solicitações espaçadas Se você tivesse 180 solicitações por minuto, cada uma levando 1 segundo para ser concluída, e as enviasse com intervalos de 0,33 segundo, o máximo de solicitações simultâneas seria 3 e a média também seria 3, pois sempre haveria 3 em andamento.
Exemplo 2: Solicitações em lote No entanto, se você tivesse um padrão de uso diferente, como 180 solicitações por minuto, cada uma levando 3 segundos para ser concluída, mas todas disparadas de uma vez, o máximo de solicitações simultâneas seria 180 e a média seria 9 (nos primeiros 3 segundos do minuto haveria 180 solicitações de uma vez; nos 57 segundos finais, 0 solicitações).
Como nosso sistema considera a simultaneidade, as solicitações por minuto são menos importantes do que a duração de cada solicitação e o padrão de quando elas são enviadas.
A forma como as solicitações aos endpoints são feitas afeta os limites de simultaneidade:
- Com HTTP, cada solicitação conta individualmente para seu limite de simultaneidade.
- Com o WebSocket de Text to Speech, somente o tempo em que nosso modelo está gerando áudio conta para seu limite de simultaneidade. Isso significa que, na maior parte do tempo, um websocket aberto não conta para seu limite de simultaneidade.
- Os WebSockets de Text to Dialogue funcionam de forma diferente: cada conexão aberta reserva uma sessão de diálogo de um pool separado enquanto permanecer aberta, e o áudio gerado pela conexão não conta para seu limite padrão de simultaneidade. Isso foi pensado para ser mais fácil de entender: uma conexão equivale a uma sessão, e seus limites de sessão de diálogo são dimensionados para se ajustar a essa nova metodologia de simultaneidade. Consulte simultaneidade do Text to Dialogue.
Entendendo os limites de simultaneidade
O limite de simultaneidade associado ao seu plano não deve ser interpretado como o número máximo de conversas, chamadas telefônicas, locuções de personagens etc. que podem ser atendidas ao mesmo tempo. O número real depende de vários fatores, incluindo as vozes IA específicas usadas e as características do caso de uso.
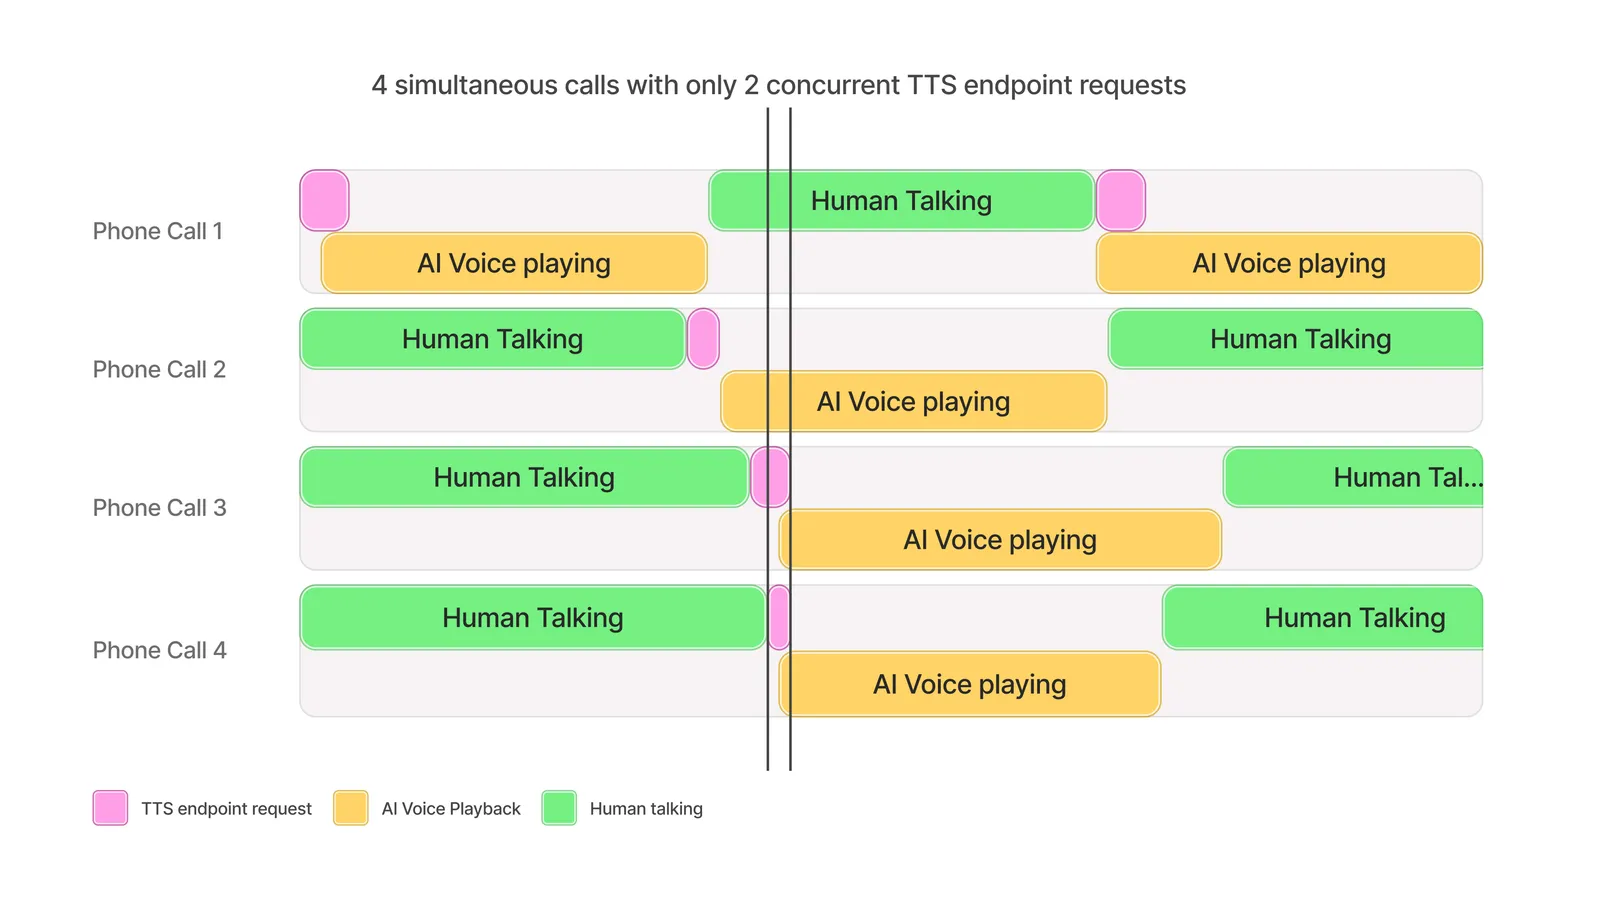
Como regra geral, um limite de simultaneidade de 5 normalmente pode atender a até aproximadamente 100 transmissões de áudio simultâneas.
Isso se deve à velocidade de geração do áudio em relação ao tempo necessário para processar a solicitação de TTS. O diagrama abaixo mostra um exemplo de como 4 chamadas simultâneas com usuários diferentes podem ser atendidas usando apenas 2 solicitações simultâneas.
Criação de agentes de voz IA
Quando o TTS é usado para facilitar diálogos, um limite de simultaneidade de 5 pode atender cerca de 100 transmissões em conversas equilibradas entre agentes de IA e participantes humanos.
Para casos de uso em que o agente de IA fala com menos frequência do que a pessoa, como em interações de suporte ao cliente, mais de 100 conversas simultâneas podem ser atendidas.
Locuções de personagens
Em geral, mais de 100 locuções simultâneas de personagens podem ser atendidas com um limite de simultaneidade de 5.
O número pode variar dependendo da frequência dos diálogos do personagem, da duração das pausas e das ações no jogo entre as falas.
Dublagem ao vivo
Os fluxos simultâneos de dublagem geralmente seguem a estimativa fornecida.
Se a transmissão tiver períodos de pausas na conversa (por exemplo, devido a uma trilha sonora, cenas visuais etc.), pode ser possível ter mais fluxos de dublagem simultâneos do que o sugerido.
Se você exceder os limites de simultaneidade do seu plano em algum momento e estiver no plano Enterprise, as solicitações de modelo ainda poderão ser bem-sucedidas, embora mais lentas, conforme a capacidade disponível e sem garantia.
Para aumentar seu limite de simultaneidade e a prioridade na fila, faça upgrade do seu plano de assinatura.
Clientes Enterprise podem solicitar um limite de simultaneidade maior entrando em contato com seu gerente de conta.
Simultaneidade do Text to Dialogue
As solicitações de Text to Dialogue são medidas de duas formas diferentes, dependendo de como você chama a API:
- Endpoints HTTP (Criar diálogo e Transmitir diálogo) contam para o limite padrão de simultaneidade do seu plano enquanto o áudio é gerado, como qualquer outra solicitação de Text to Speech.
- Endpoints WebSocket, como o WebSocket de Text to Dialogue, são medidos como sessões de diálogo. Uma conexão aberta ocupa uma sessão de diálogo enquanto permanecer aberta, independentemente de o áudio estar sendo gerado no momento.
A medição baseada em sessão simplifica o planejamento de capacidade: uma conexão equivale a uma sessão, então seu uso não varia com a atividade de geração. Como uma sessão é ocupada durante toda a conexão, e não apenas enquanto o áudio é gerado, seus limites de sessão de diálogo são dimensionados para se ajustar a essa nova metodologia de simultaneidade.
Se você abrir uma conexão enquanto todas as sessões de diálogo do seu espaço de trabalho estiverem em uso, a nova conexão será rejeitada com o erro too_many_concurrent_requests. Para liberar sessões, feche as conexões de que você não precisa mais — uma conexão também é fechada automaticamente após 20 segundos de inatividade, a menos que você envie mensagens keep_alive.
Para monitorar as sessões de diálogo, abra Desenvolvedores na parte inferior da barra lateral do painel, selecione a aba Analytics e veja a métrica Solicitações simultâneas na visualização Uso. As sessões de diálogo são informadas em sua própria série, TTD Websocket Sessions, separadas das suas outras solicitações simultâneas.
Teste de carga dos limites de simultaneidade
O teste de carga pode ser útil para identificar problemas de escalabilidade no lado do cliente e verificar se os limites de simultaneidade estão configurados corretamente para seu caso de uso.
É altamente recomendável testar fluxos de trabalho de ponta a ponta o mais próximo possível do uso real. A metodologia recomendada para isso é simular e medir quantos usuários podem ser atendidos. É importante:
- Simular usuários, não solicitações brutas
- Simular o comportamento típico dos usuários, como esperar a reprodução do áudio, a fala do usuário ou a transcrição terminar antes de fazer solicitações
- Aumentar o número de usuários gradualmente ao longo de alguns minutos
- Introduzir aleatoriedade no momento das solicitações e no tamanho delas
- Capturar métricas de latência e eventuais códigos de erro retornados pela API
Por exemplo, para testar um sistema de agentes desenvolvido para atender 100 conversas simultâneas, você criaria até 100 “usuários” individuais, cada um simulando uma conversa. As conversas normalmente consistem em um ciclo repetido de cerca de 10 segundos de fala do usuário, seguido por uma chamada à API de TTS para cerca de 150 caracteres, seguida por cerca de 10 segundos de reprodução de áudio para o usuário. Portanto, cada usuário deve seguir o padrão de fazer uma chamada à API de Text to Speech via websocket para 150 caracteres de texto a cada 20 segundos, introduzindo uma pequena quantidade de aleatoriedade no período de espera e no número de caracteres solicitados. O teste consistiria em iniciar um usuário por segundo até que existam 100 e, então, testar por 10 minutos no total para avaliar a estabilidade geral.
Exemplo de script para teste de carga
Este exemplo usa o locust como framework de teste com chamadas diretas à API da ElevenLabs.
Ele segue o exemplo listado acima, testando um sistema de agente conversacional com cada usuário enviando 1 solicitação a cada 20 segundos.