

Modellen
Toonaangevende modellen
Text to Speech
Speech to Text
Spraakagenten
Muziek
Overzicht van modellen
De ElevenLabs API biedt een reeks audiomodellen die zijn geoptimaliseerd voor verschillende use cases, kwaliteitsniveaus en prestatievereisten.
† Mediaan, exclusief latentie van applicatie en netwerk. Bekijk hoe latentie wordt gemeten.
Verouderde modellen
Het model music_v1 is verouderd en wordt verwijderd op 31 januari 2027. Het
model eleven_text_to_sound_v2 is verouderd en wordt verwijderd op 1 maart 2027. Migreer
naar de onderstaande vervangende modellen om de service te blijven gebruiken. Als je requests geen
model_id instellen, stel deze dan expliciet in op het vervangende model.
De modellen eleven_turbo_v2_5 en eleven_turbo_v2 zijn functioneel gelijk aan respectievelijk de
modellen eleven_flash_v2_5 en eleven_flash_v2, behalve dat de latentie bij de Flash-
modellen gemiddeld lager is. We raden aan om in alle use cases de Flash-modellen te gebruiken in plaats van Turbo-
modellen.
Eleven v4
Eleven v4 is ons toonaangevende model voor spraaksynthese en biedt onze hoogste audiokwaliteit, expressiviteit en controle over hoe stemmen worden uitgevoerd. Eleven v4 ondersteunt stemklonen met hoge getrouwheid en behoudt de spreker betrouwbaar bij lange tekstgeneraties.
Dit model werkt goed in de volgende scenario’s:
- Voice-overs voor personages: Ideaal voor games en animatie dankzij het emotionele bereik.
- Emotionele dialogen: Genereer natuurlijke, levensechte dialogen met een groot emotioneel bereik en contextueel begrip.
- Productie van luisterboeken: Perfect voor lange vertellingen met complexe emotionele voordracht.
- Meertalige projecten: Behoudt consistente stemkwaliteit bij het wisselen van taal.
Eleven v4 is beschikbaar via de Text to Dialogue API.
Ondersteunde talen
De Eleven v4-modelfamilie ondersteunt meer dan 90 talen, waaronder:
Afrikaans (af), Arabisch (ar), Armeens (hy), Assamees (as), Asturisch (ast), Azerbeidzjaans (az), Belarussisch (be), Bengaals (bn), Bosnisch (bs), Bulgaars (bg), Birmaans (my), Kantonees (yue), Catalaans (ca), Cebuano (ceb), Kroatisch (hr), Tsjechisch (cs), Deens (da), Nederlands (nl), Engels (en), Estisch (et), Filipijns (fil), Fins (fi), Frans (fr), Galicisch (gl), Georgisch (ka), Duits (de), Grieks (el), Gujarati (gu), Hausa (ha), Hebreeuws (he), Hindi (hi), Hongaars (hu), IJslands (is), Indonesisch (id), Iers (ga), Italiaans (it), Japans (ja), Javaans (jv), Kannada (kn), Kazachs (kk), Koreaans (ko), Kirgizisch (ky), Lets (lv), Lingala (ln), Litouws (lt), Luxemburgs (lb), Macedonisch (mk), Maleis (ms), Malayalam (ml), Maltees (mt), Mandarijn-Chinees (zh), Māori (mi), Marathi (mr), Mongools (mn), Nepalees (ne), Noors (no), Occitaans (oc), Odia (or), Pasjtoe (ps), Perzisch (fa), Pools (pl), Portugees (pt), Punjabi (pa), Roemeens (ro), Russisch (ru), Servisch (sr), Sindhi (sd), Slowaaks (sk), Sloveens (sl), Somalisch (so), Spaans (es), Swahili (sw), Zweeds (sv), Tadzjieks (tg), Tamil (ta), Telugu (te), Thais (th), Turks (tr), Oekraïens (uk), Urdu (ur), Oezbeeks (uz), Vietnamees (vi), Welsh (cy), Yoruba (yo).
Eleven v4 Turbo
Eleven v4 Turbo is ons toonaangevende model voor realtime spraaksynthese en biedt hoogwaardige audio, expressiviteit en controle over hoe stemmen worden uitgevoerd. Eleven v4 Turbo ondersteunt stemklonen met hoge getrouwheid en heeft een mediane latentie van ~100ms. Bekijk hoe latentie wordt gemeten.
Dit model werkt goed in de volgende scenario’s:
- Supportagenten: Zet stemagenten in die klantvragen realtime oplossen.
- AI-assistenten: Genereer natuurlijke, levensechte dialogen met een groot emotioneel bereik en contextueel begrip.
- Interactieve personages: Uitstekend voor audio-ervaringen met expressieve personages.
Eleven v4 Turbo is beschikbaar via de Text to Dialogue-websocket.
Ondersteunde talen
De Eleven v4-modelfamilie ondersteunt meer dan 90 talen, waaronder:
Afrikaans (af), Arabisch (ar), Armeens (hy), Assamees (as), Asturisch (ast), Azerbeidzjaans (az), Belarussisch (be), Bengaals (bn), Bosnisch (bs), Bulgaars (bg), Birmaans (my), Kantonees (yue), Catalaans (ca), Cebuano (ceb), Kroatisch (hr), Tsjechisch (cs), Deens (da), Nederlands (nl), Engels (en), Estisch (et), Filipijns (fil), Fins (fi), Frans (fr), Galicisch (gl), Georgisch (ka), Duits (de), Grieks (el), Gujarati (gu), Hausa (ha), Hebreeuws (he), Hindi (hi), Hongaars (hu), IJslands (is), Indonesisch (id), Iers (ga), Italiaans (it), Japans (ja), Javaans (jv), Kannada (kn), Kazachs (kk), Koreaans (ko), Kirgizisch (ky), Lets (lv), Lingala (ln), Litouws (lt), Luxemburgs (lb), Macedonisch (mk), Maleis (ms), Malayalam (ml), Maltees (mt), Mandarijn-Chinees (zh), Māori (mi), Marathi (mr), Mongools (mn), Nepalees (ne), Noors (no), Occitaans (oc), Odia (or), Pasjtoe (ps), Perzisch (fa), Pools (pl), Portugees (pt), Punjabi (pa), Roemeens (ro), Russisch (ru), Servisch (sr), Sindhi (sd), Slowaaks (sk), Sloveens (sl), Somalisch (so), Spaans (es), Swahili (sw), Zweeds (sv), Tadzjieks (tg), Tamil (ta), Telugu (te), Thais (th), Turks (tr), Oekraïens (uk), Urdu (ur), Oezbeeks (uz), Vietnamees (vi), Welsh (cy), Yoruba (yo).
Eleven v3
Eleven v3 is ons model voor spraaksynthese van de vorige generatie, dat natuurlijke, levensechte spraak produceert met een groot emotioneel bereik en contextueel begrip in meerdere talen.
Met Eleven v3 komt een nieuwe Text to Dialogue API, waarmee je natuurlijke, levensechte dialogen kunt genereren met een groot emotioneel bereik en contextueel begrip in meerdere talen. Je kunt Eleven v3 ook gebruiken met de Text to Speech API om natuurlijke, levensechte spraak te genereren met een groot emotioneel bereik en contextueel begrip in meerdere talen.
Lees hier meer over de Text to Dialogue API.
Ondersteunde talen
Het Eleven v3-model ondersteunt meer dan 70 talen, waaronder:
Afrikaans (af), Arabisch (ar), Armeens (hy), Assamees (as), Asturisch (ast), Azerbeidzjaans (az), Belarussisch (be), Bengaals (bn), Bosnisch (bs), Bulgaars (bg), Birmaans (my), Kantonees (yue), Catalaans (ca), Cebuano (ceb), Chichewa (ny), Kroatisch (hr), Tsjechisch (cs), Deens (da), Nederlands (nl), Engels (en), Estisch (et), Filipijns (fil), Fins (fi), Frans (fr), Galicisch (gl), Georgisch (ka), Duits (de), Grieks (el), Gujarati (gu), Hausa (ha), Hebreeuws (he), Hindi (hi), Hongaars (hu), IJslands (is), Indonesisch (id), Iers (ga), Italiaans (it), Japans (ja), Javaans (jv), Kannada (kn), Kazachs (kk), Kirgizisch (ky), Koreaans (ko), Lets (lv), Lingala (ln), Litouws (lt), Luxemburgs (lb), Macedonisch (mk), Maleis (ms), Malayalam (ml), Maltees (mt), Mandarijn-Chinees (zh), Māori (mi), Marathi (mr), Mongools (mn), Nepalees (ne), Noors (no), Occitaans (oc), Odia (or), Pasjtoe (ps), Perzisch (fa), Pools (pl), Portugees (pt), Punjabi (pa), Roemeens (ro), Russisch (ru), Servisch (sr), Sindhi (sd), Slowaaks (sk), Sloveens (sl), Somalisch (so), Spaans (es), Swahili (sw), Zweeds (sv), Tadzjieks (tg), Tamil (ta), Telugu (te), Thais (th), Turks (tr), Oekraïens (uk), Urdu (ur), Oezbeeks (uz), Vietnamees (vi), Welsh (cy), Yoruba (yo).
Eleven v3 Conversational
Eleven v3 Conversational is ons model van de vorige generatie voor realtime spraaksynthese. Het produceert natuurlijke, levensechte spraak met een groot emotioneel bereik en contextueel begrip in meerdere talen.
Met Eleven v3 Conversational komt een nieuwe Text to Dialogue WebSocket, waarmee je natuurlijke, levensechte dialogen kunt genereren met een groot emotioneel bereik en contextueel begrip in meerdere talen.
Met Eleven v3 Conversational komt een nieuwe Text to Dialogue WebSocket, waarmee je natuurlijke, levensechte dialogen kunt genereren met een groot emotioneel bereik en contextueel begrip in meerdere talen.
Lees hier meer over de Text to Dialogue WebSocket.
Ondersteunde talen
Het Eleven v3-model ondersteunt meer dan 70 talen, waaronder:
Afrikaans (af), Arabisch (ar), Armeens (hy), Assamees (as), Asturisch (ast), Azerbeidzjaans (az), Belarussisch (be), Bengaals (bn), Bosnisch (bs), Bulgaars (bg), Birmaans (my), Kantonees (yue), Catalaans (ca), Cebuano (ceb), Chichewa (ny), Kroatisch (hr), Tsjechisch (cs), Deens (da), Nederlands (nl), Engels (en), Estisch (et), Filipijns (fil), Fins (fi), Frans (fr), Galicisch (gl), Georgisch (ka), Duits (de), Grieks (el), Gujarati (gu), Hausa (ha), Hebreeuws (he), Hindi (hi), Hongaars (hu), IJslands (is), Indonesisch (id), Iers (ga), Italiaans (it), Japans (ja), Javaans (jv), Kannada (kn), Kazachs (kk), Kirgizisch (ky), Koreaans (ko), Lets (lv), Lingala (ln), Litouws (lt), Luxemburgs (lb), Macedonisch (mk), Maleis (ms), Malayalam (ml), Maltees (mt), Mandarijn-Chinees (zh), Māori (mi), Marathi (mr), Mongools (mn), Nepalees (ne), Noors (no), Occitaans (oc), Odia (or), Pasjtoe (ps), Perzisch (fa), Pools (pl), Portugees (pt), Punjabi (pa), Roemeens (ro), Russisch (ru), Servisch (sr), Sindhi (sd), Slowaaks (sk), Sloveens (sl), Somalisch (so), Spaans (es), Swahili (sw), Zweeds (sv), Tadzjieks (tg), Tamil (ta), Telugu (te), Thais (th), Turks (tr), Oekraïens (uk), Urdu (ur), Oezbeeks (uz), Vietnamees (vi), Welsh (cy), Yoruba (yo).
Multilingual v2
Eleven Multilingual v2 is een model voor spraaksynthese van de vorige generatie dat rekening houdt met emotie. Het produceert natuurlijke, levensechte spraak met een groot emotioneel bereik en contextueel begrip in meerdere talen.
Het model levert consistente stemkwaliteit en persoonlijkheid in alle ondersteunde talen, terwijl de unieke kenmerken en het accent van de spreker behouden blijven.
Dit model blinkt uit in scenario’s die hoogwaardige, emotioneel genuanceerde spraak vereisen:
- Voice-overs voor personages: Ideaal voor games en animatie dankzij het emotionele bereik.
- Professionele content: Zeer geschikt voor bedrijfsvideo’s en e-learningmateriaal.
- Meertalige projecten: Behoudt consistente stemkwaliteit bij het wisselen van taal.
- Stabiele kwaliteit: Produceert consistente audio van hoge kwaliteit.
Hoewel dit model een hogere latentie en kosten per teken heeft dan Flash-modellen, levert het superieure kwaliteit voor projecten waarin levensechte spraak belangrijk is.
Onze meertalige v2-modellen ondersteunen 29 talen:
Engels (VS, VK, Australië, Canada), Japans, Chinees, Duits, Hindi, Frans (Frankrijk, Canada), Koreaans, Portugees (Brazilië, Portugal), Italiaans, Spaans (Spanje, Mexico), Indonesisch, Nederlands, Turks, Filipijns, Pools, Zweeds, Bulgaars, Roemeens, Arabisch (Saoedi-Arabië, VAE), Tsjechisch, Grieks, Fins, Kroatisch, Maleis, Slowaaks, Deens, Tamil, Oekraïens & Russisch.
Flash v2.5
Eleven Flash v2.5 is een model voor spraaksynthese met lage latentie, ontworpen voor realtime applicaties en Agents Platform. Het levert hoogwaardige spraak met een mediane latentie van ~100ms† in 32 talen.
Het model biedt een balans tussen snelheid en kwaliteit, waardoor het ideaal is voor interactieve applicaties, met behoud van natuurlijk klinkende uitvoer en consistente stemkenmerken in verschillende talen.
Dit model is bijzonder geschikt voor:
- Agents Platform: Perfect voor realtime stemagenten en chatbots.
- Interactieve applicaties: Ideaal voor games en applicaties die een onmiddellijke reactie vereisen.
- Verwerking op grote schaal: Efficiënt voor bulkconversie van tekst naar spraak.
Dankzij de lagere prijs voor API-generaties en de lage latentie is Flash v2.5 de kosteneffectieve optie voor iedereen die snelle, betrouwbare spraaksynthese in meerdere talen nodig heeft.
Flash v2.5 ondersteunt 32 talen: alle talen van v2-modellen plus:
Hongaars, Noors & Vietnamees
† Mediaan, exclusief latentie van applicatie en netwerk. Bekijk hoe latentie wordt gemeten.
Aandachtspunten
Tekstnormalisatie met cijfers
Wanneer je Flash v2.5 gebruikt, worden cijfers standaard niet genormaliseerd zoals je misschien verwacht. Telefoonnummers kunnen bijvoorbeeld worden voorgelezen op een manier die niet duidelijk is voor de gebruiker. Datums en valuta worden op vergelijkbare wijze beïnvloed.
Standaard is normalisatie uitgeschakeld voor Flash v2.5 om de lage latentie te behouden. Enterprise-klanten kunnen tekstnormalisatie voor v2.5-modellen nu echter inschakelen door de parameter apply_text_normalization in je request op “on” te zetten.
Het model Multilingual v2 normaliseert cijfers beter, dus we raden aan dit model te gebruiken voor telefoonnummers en andere gevallen waarin cijfernormalisatie belangrijk is.
Voor applicaties met lage latentie of voor Agents Platform is het best practice om je LLM de tekst te laten normaliseren voordat je die aan het TTS-model doorgeeft, of om de parameter apply_text_normalization te gebruiken (alleen Enterprise-abonnementen voor v2.5-modellen).
Gids voor modelselectie
Raadpleeg de gids voor modelselectie voor advies over welk model het beste bij je vereisten en use case past.
Vereisten
Use case
Tekenlimieten
Het maximale aantal tekens dat wordt ondersteund in één text-to-speech-request verschilt per model.
Scribe v2
Scribe v2 is ons geavanceerde spraakherkenningsmodel, ontworpen voor nauwkeurige transcriptie in meer dan 90 talen. Het biedt nauwkeurige timestamps op woordniveau en geavanceerde functies zoals sprekerdiarisatie en dynamische audiotagging.
Dit model blinkt uit in scenario’s die nauwkeurige speech-to-text-conversie vereisen:
- Transcriptieservices: Perfect voor het omzetten van audio- en videocontent naar tekst
- Vergaderdocumentatie: Ideaal voor het vastleggen en documenteren van gesprekken
- Contentanalyse: Geschikt voor het verwerken en analyseren van audiocontent
- Meertalige herkenning: Ondersteunt nauwkeurige transcriptie in meer dan 90 talen
Belangrijkste functies:
- Nauwkeurige transcriptie met timestamps op woordniveau
- Sprekerdiarisatie voor audio met meerdere sprekers
- Dynamische audiotagging voor extra context
- Ondersteuning voor meer dan 90 talen
- Entiteitsdetectie
- Keyterm prompting
- Transcriptbewerking
Lees hier meer over Scribe v2.
Scribe v2 Realtime
Scribe v2 Realtime, ons snelste en nauwkeurigste live-spraakherkenningsmodel, levert geavanceerde nauwkeurigheid in meer dan 90 talen met een mediane tijd tot een vastgelegd transcript van ~150 ms. Bekijk hoe latentie wordt gemeten.
Dit model blinkt uit in conversationele use cases:
- Live transcriptie van vergaderingen: Perfect voor realtime transcriptie
- AI-agents: Ideaal voor live gesprekken
- Meertalige herkenning: Ondersteunt nauwkeurige transcriptie in meer dan 90 talen met automatische taalherkenning
Belangrijkste functies:
- Ultralage latentie: ontvang vastgelegde transcripties met een mediane latentie van ~150 milliseconden
- Streamingondersteuning: verstuur audio in delen terwijl je transcripties in realtime ontvangt
- Meerdere audioformaten: ondersteuning voor PCM (8 kHz tot 48 kHz) en μ-law-codering
- Voice Activity Detection (VAD): automatische spraaksegmentatie op basis van stiltedetectie
- Handmatige commitcontrole: volledige controle over wanneer transcriptsegmenten worden afgerond
- Entiteitsdetectie
- Entiteitsredactie
- Transcriptbewerking
Lees hier meer over Scribe v2 Realtime.
Scribe v2 Medical
Scribe v2 Medical is een batch-spraakherkenningsmodel dat is gespecialiseerd in medische en klinische audio. Het is een finetune van Scribe v2 die de herkenning van medicijnnamen, anatomie, pathologie en klinische dicteeropnamen verbetert, terwijl de nauwkeurigheid van Scribe v2 voor alledaagse spraak behouden blijft. Het gebruikt dezelfde Speech to Text API als Scribe v2 en wordt tegen hetzelfde tarief gefactureerd. Geef scribe_v2_medical door als model_id.
Beoogd gebruik
Scribe v2 Medical is een batchmodel voor de Speech-to-Text API dat ontwikkelaars en organisaties kunnen integreren in applicaties die klinische audio, waaronder zorgverlener-patiëntgesprekken, dicteeropnamen, intake- en zorgcoördinatiegesprekken, omzetten in concepttranscripten voor documentatie en gerelateerde administratieve workflows. De resulterende tekst is bedoeld voor beoordeling en correctie door een zorgprofessional of andere geautoriseerde gebruiker vóór gebruik. Scribe v2 Medical is niet bedoeld om klinische informatie te interpreteren of diagnoses, behandelings- aanbevelingen, klinische beslissingen of andere klinische richtlijnen te geven.
Dit model is zeer geschikt voor:
- Klinische documentatie: Omgevingsgesprekken en notities waarin medische termen tijdens het gesprek naar voren komen
- Dicteren: Dichte reeksen van medicijnen, doseringen en bevindingen
- Intake- en coördinatiegesprekken: Patiënten die hun eigen aandoeningen beschrijven, vaak telefonisch
- Complianceworkflows: Combineer met entiteitsdetectie voor PHI-categorieën
Belangrijkste functies:
- Dezelfde requeststructuur als Scribe v2 (
keyterms,entity_detection,no_verbatim, diarisation, timestamps) - Verbeterde herkenning van medicijnnamen en termen voor anatomie en pathologie
- Geen verslechtering bij alledaagse spraak ten opzichte van Scribe v2
- Ondersteuning voor meer dan 90 talen
- Sprekerdiarisatie voor audio met meerdere sprekers
- Dynamische audiotagging
- Entiteitsdetectie, inclusief PHI-categorieën
Scribe v2 Medical is een batchmodel. Gebruik Scribe v2 Realtime voor live transcriptie.
Scribe v2 Medical komt in aanmerking voor HIPAA, met Business Associate Agreements beschikbaar voor Enterprise-klanten, evenals Zero Retention Mode (ZRM). Als ZRM is ingeschakeld, worden de audio-invoer en tekstuitvoer direct verwijderd nadat elke request is voltooid. ElevenLabs bewaart niets en je applicatie ontvangt de volledige API-response en bewaart transcripties onder je eigen beheer.
Bedrijven die HIPAA-compliance vereisen, moeten contact opnemen met ElevenLabs Sales om een Business Associate Agreement (BAA) te ondertekenen voordat zij beschermde gezondheidsinformatie versturen.
Lees hier meer over Speech to Text.
SFX v3
SFX v3 (eleven_text_to_sound_v3) is ons nieuwste model voor geluidseffecten. Het gebruikt dezelfde Sound Effects API als eleven_text_to_sound_v2: stel model_id in op eleven_text_to_sound_v3 om het te gebruiken. eleven_text_to_sound_v2 is nog steeds de standaard, maar is verouderd en wordt op 1 maart 2027 verwijderd.
Vergeleken met eleven_text_to_sound_v2 biedt SFX v3:
- Het opvolgen van meerdere instructies in één prompt, zoals “Juichend voetbalpubliek, een bal horen vallen, joelend publiek”.
- Het verwerken van prompts met muziek of zang, zoals “Gospelkoor dat hallo zingt”.
- Natuurlijker klinkende resultaten.
- Minder kans op clipping bij hoogfrequente geluiden zoals gongs, klokkenspel en fluitjes.
Resultaten verschillen per prompt, dus vergelijk beide modellen met je eigen prompts voordat je overstapt.
SFX v3 ondersteunt loops. Stel loop in op true om een geluidseffect te genereren dat vloeiend herhaalt.
In ElevenCreative is SFX v3 beschikbaar in Sound Effects, Flows en Studio.
Lees hier meer over geluidseffecten.
Eleven Realtime
Eleven Realtime is een nieuwe klasse Speech to Speech-modellen voor het bouwen van natuurlijke spraakagents. Elk Realtime-model is een complete spraakagent: spraakherkenning, voice activity detection en beurtwisseling, LLM en text to speech, door ElevenLabs geselecteerd en afgestemd om samen als één systeem te werken. Selecteer een Realtime-model en je krijgt met één keuze een goed presterende agent, zonder componenten die je hoeft te configureren.
Er zijn twee Realtime-modellen beschikbaar.
Eleven Realtime v1 Mini is geoptimaliseerd voor snelle, natuurlijke gesprekken en werkt goed in de volgende scenario’s:
- AI-assistenten: Snelle, expressieve dialogen waarin het gesprek zelf het product is.
- Educatieve tutors: Natuurlijke gesprekken die het tempo van de leerling bijhouden.
- Interactieve personages: Expressieve personages voor games en entertainment.
Eleven Realtime v1 Max is geoptimaliseerd voor complexe taken en werkt goed in de volgende scenario’s:
- Klantenservice: Vragen oplossen waarvoor je een proces moet volgen en informatie moet opzoeken.
- Leadkwalificatie: Gestructureerde gesprekken die informatie verzamelen en de volgende stappen bepalen.
- Workflows met meerdere stappen: Taken die tools aanroepen om informatie op te zoeken of acties uit te voeren.
Belangrijkste functies:
- Spraakherkenning, beurtwisseling, taalmodel en stem in één modelkeuze
- Natuurlijke beurtwisseling en verwerking van onderbrekingen
- Tool calling
- Aanpasbare stemmen uit de stemmenbibliotheek van ElevenLabs
- Ondersteuning voor meer dan 90 talen
- Wissel tussen v1 Mini en v1 Max door een ander model te selecteren, zonder je integratie aan te passen
Eleven Realtime is beschikbaar in ElevenAgents, waar je een Realtime-model selecteert in de modeldropdown, en via de Realtime API, die is ontworpen om via WebSocket compatibel te zijn met de Realtime API van OpenAI. Als je de Realtime API van OpenAI al gebruikt, bekijk dan de migratiehandleiding.
Ondersteunde talen
Realtime-modellen ondersteunen meer dan 90 talen. Bekijk de talenlijst voor Eleven v4.
Lees hier meer over Eleven Realtime.
Eleven Music
Eleven Music is ons muziekmodel van studiokwaliteit. Hiermee kun je muziek in elke stijl genereren met prompts in natuurlijke taal.
Dit model is uitstekend voor de volgende scenario’s:
- Soundtracks voor games: Maak meeslepende soundtracks voor games
- Podcastachtergronden: Verrijk podcasts met professionele muziek
- Marketing: Voeg achtergrondmuziek toe aan advertentievideo’s
Belangrijkste functies:
- Volledige controle over genre, stijl en structuur
- Zang of alleen instrumentaal
- Meertalig, waaronder Engels, Spaans, Duits, Japans en meer
- Bewerk het geluid en de songtekst van afzonderlijke secties of het hele nummer
Lees hier meer over Eleven Music.
Gelijktijdigheid en prioriteit
Je abonnementsplan bepaalt hoeveel requests tegelijk kunnen worden verwerkt en het prioriteitsniveau van je requests in de wachtrij. Speech to Text heeft een verhoogde gelijktijdigheidslimiet. Zodra de gelijktijdigheidslimiet is bereikt, worden volgende requests in een wachtrij verwerkt naast requests met een lagere prioriteit. In de praktijk voegt dit doorgaans slechts ~50 ms latentie toe.
De responseheaders bevatten current-concurrent-requests en maximum-concurrent-requests, waarmee je je gelijktijdigheid kunt monitoren.
API-requests per minuut versus gelijktijdige requests
Het is belangrijk om te begrijpen dat API-requests per minuut en gelijktijdige requests verschillende metrics zijn, die afhangen van je gebruikspatronen.
API-requests per minuut kunnen verschillen van gelijktijdige requests, omdat dit afhangt van de duur van elke request en hoe de requests worden gebatcht.
Voorbeeld 1: Gespreide requests Als je 180 requests per minuut had die elk 1 seconde duurden en je ze met telkens 0,33 seconde ertussen verstuurde, zouden het maximale en gemiddelde aantal gelijktijdige requests beide 3 zijn, omdat er altijd 3 actief zouden zijn.
Voorbeeld 2: Gebatchte requests Als je echter een ander gebruikspatroon had, zoals 180 requests per minuut die elk 3 seconden duurden maar allemaal tegelijk werden verstuurd, zouden het maximale aantal gelijktijdige requests 180 en het gemiddelde 9 zijn (in de eerste 3 seconden van de minuut waren er 180 requests tegelijk, in de laatste 57 seconden 0 requests).
Omdat ons systeem kijkt naar gelijktijdigheid, zijn requests per minuut minder belangrijk dan de duur van elke request en het patroon waarin ze worden verstuurd.
De manier waarop endpoint-requests worden gedaan, heeft invloed op gelijktijdigheidslimieten:
- Met HTTP telt elke request afzonderlijk mee voor je gelijktijdigheidslimiet.
- Met de Text to Speech WebSocket telt alleen de tijd waarin ons model audio genereert mee voor je gelijktijdigheidslimiet. Dit betekent dat een open websocket meestal helemaal niet meetelt voor je gelijktijdigheidslimiet.
- De Text to Dialogue WebSockets werken anders: elke open verbinding reserveert één dialoogsessie uit een aparte pool zolang deze open blijft, en audio die via de verbinding wordt gegenereerd telt niet mee voor je standaard gelijktijdigheidslimiet. Dit is ontworpen om eenvoudiger te begrijpen: één verbinding is één sessie, en je limieten voor dialoogsessies zijn afgestemd op deze nieuwe methode voor gelijktijdigheid. Zie Text to Dialogue-gelijktijdigheid.
Gelijktijdigheidslimieten begrijpen
De gelijktijdigheidslimiet van je abonnement moet niet worden gezien als het maximale aantal gelijktijdige gesprekken, telefoongesprekken, voice-overs voor personages enzovoort dat tegelijk kan worden afgehandeld. Het werkelijke aantal hangt af van verschillende factoren, waaronder de specifieke gebruikte AI-stemmen en de kenmerken van de use case.
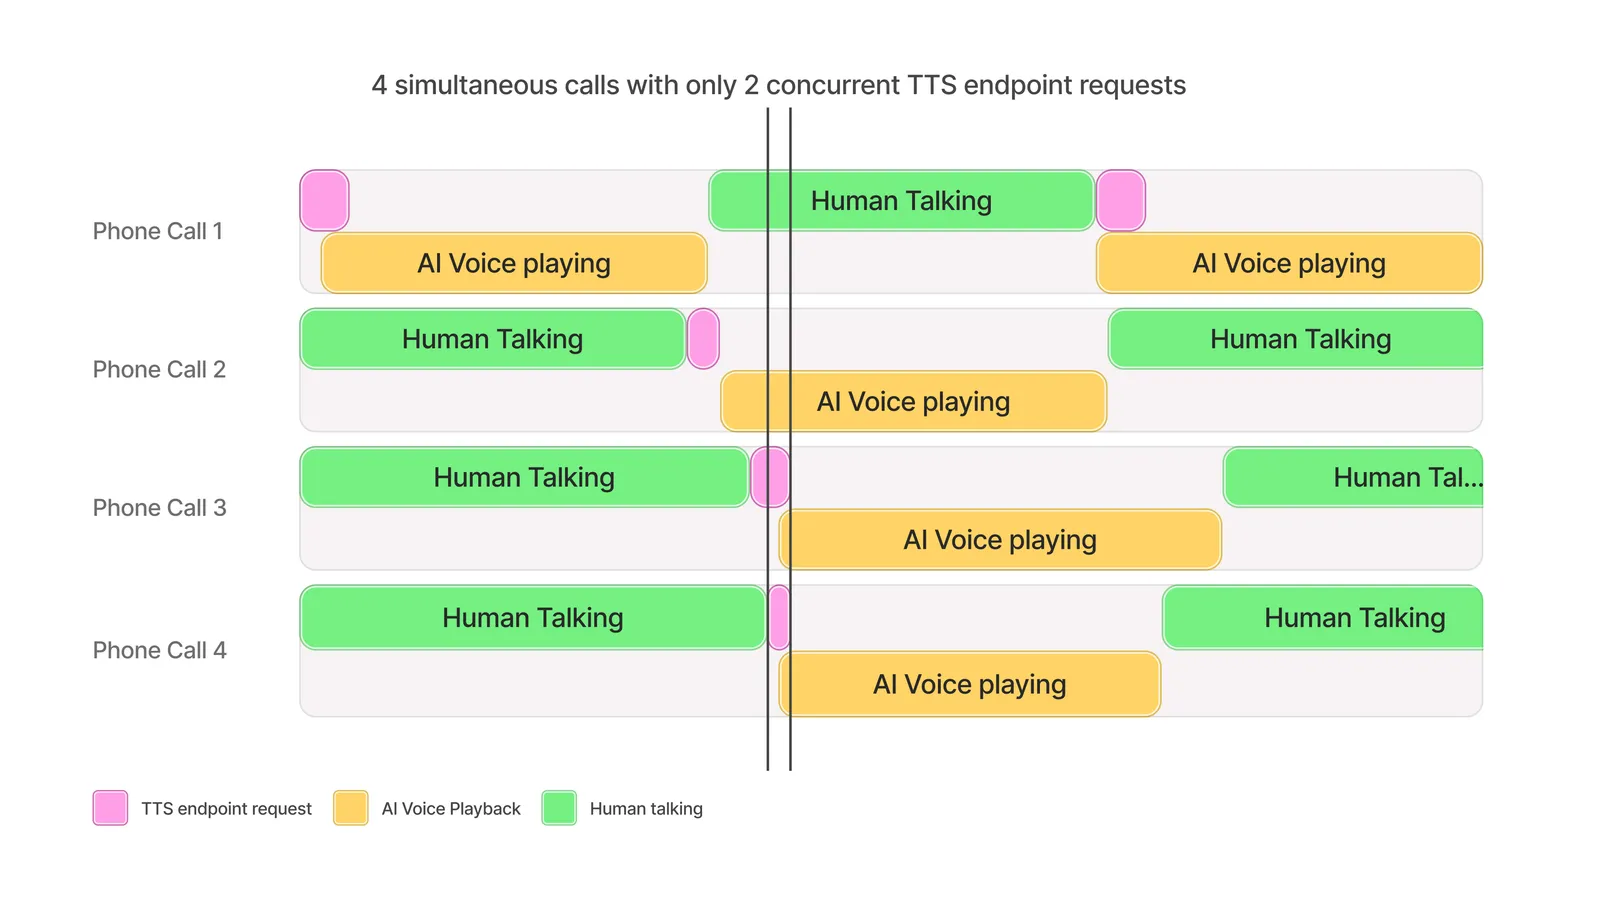
Als algemene vuistregel geldt dat een gelijktijdigheidslimiet van 5 doorgaans tot ongeveer 100 gelijktijdige audio-uitzendingen kan ondersteunen.
Dit komt door de snelheid waarmee audio wordt gegenereerd ten opzichte van de tijd die nodig is om de TTS-request te verwerken. Het onderstaande diagram is een voorbeeld van hoe 4 gelijktijdige gesprekken met verschillende gebruikers mogelijk zijn terwijl er slechts 2 gelijktijdige requests worden bereikt.
AI-stemagents bouwen
Wanneer TTS wordt gebruikt om dialoog mogelijk te maken, kan een gelijktijdigheidslimiet van 5 ongeveer 100 uitzendingen ondersteunen voor evenwichtige gesprekken tussen AI-agents en menselijke deelnemers.
Voor use cases waarin de AI-agent minder vaak spreekt dan de mens, zoals interacties met de klantenservice, kunnen meer dan 100 gelijktijdige gesprekken worden ondersteund.
Voice-overs voor personages
Over het algemeen kunnen meer dan 100 gelijktijdige voice-overs voor personages worden ondersteund met een gelijktijdigheidslimiet van 5.
Het aantal kan variëren afhankelijk van de gespreksfrequentie van het personage, de lengte van pauzes en acties in de game tussen zinnen.
Live nasynchronisatie
Gelijktijdige nasynchronisatiestreams volgen doorgaans de gegeven vuistregel.
Als de uitzending periodes met gesprekspauzes bevat (bijvoorbeeld door een soundtrack, visuele scènes enzovoort), zijn mogelijk meer gelijktijdige nasynchronisatiestreams mogelijk dan voorgesteld.
Als je op enig moment de gelijktijdigheidslimieten van je abonnement overschrijdt en je het Enterprise-abonnement hebt, kunnen modelrequests mogelijk alsnog slagen, zij het langzamer, op basis van best effort en afhankelijk van de beschikbare capaciteit.
Verhoog je gelijktijdigheidslimiet en wachtrijprioriteit door je abonnementsplan te upgraden.
Enterprise-klanten kunnen een hogere gelijktijdigheidslimiet aanvragen via hun accountmanager.
Text to Dialogue-gelijktijdigheid
Text to Dialogue-requests worden op twee verschillende manieren gemeten, afhankelijk van hoe je de API aanroept:
- HTTP-endpoints (Dialoog maken en Dialoog streamen) tellen mee voor de standaard gelijktijdigheidslimiet van je abonnement terwijl audio wordt gegenereerd, net als elke andere Text to Speech-request.
- WebSocket-endpoints zoals de Text to Dialogue WebSocket worden gemeten als dialoogsessies. Een open verbinding bezet een dialoogsessie zolang deze open blijft, ongeacht of er op dat moment audio wordt gegenereerd.
Metingen op basis van sessies houden capaciteitsplanning eenvoudig: één verbinding is één sessie, zodat je gebruik niet fluctueert met generatieactiviteit. Omdat een sessie voor de volledige verbinding wordt bezet in plaats van alleen wanneer audio wordt gegenereerd, zijn je limieten voor dialoogsessies afgestemd op deze nieuwe methode voor gelijktijdigheid.
Als je een verbinding opent terwijl alle dialoogsessies van je workspace in gebruik zijn, wordt de nieuwe verbinding afgewezen met een too_many_concurrent_requests-fout. Sluit verbindingen die je niet meer nodig hebt om sessies vrij te maken — een verbinding sluit ook automatisch na 20 seconden inactiviteit, tenzij je keep_alive-berichten verstuurt.
Om dialoogsessies te monitoren, open je Developers onderaan de dashboardzijbalk, selecteer je het tabblad Analytics en bekijk je de metric Concurrent requests in de gebruiksweergave. Dialoogsessies worden gerapporteerd als een aparte reeks, TTD Websocket Sessions, los van je andere gelijktijdige requests.
Gelijktijdigheidslimieten op schaal testen
Testen op schaal kan nuttig zijn om schaalbaarheidsproblemen aan de clientzijde te identificeren en te verifiëren dat gelijktijdigheidslimieten correct zijn ingesteld voor je use case.
Het wordt sterk aanbevolen om end-to-end-workflows zo dicht mogelijk bij werkelijk gebruik te testen. De aanbevolen methode hiervoor is simuleren en meten hoeveel gebruikers kunnen worden ondersteund. Het is belangrijk om:
- Gebruikers te simuleren, niet onbewerkte requests
- Typisch gebruikersgedrag te simuleren, zoals wachten tot het afspelen van audio, spreken door de gebruiker of transcriptie is voltooid voordat requests worden gedaan
- Het aantal gebruikers gedurende enkele minuten langzaam op te voeren
- Willekeur toe te voegen aan de timing en omvang van requests
- Latenctymetrics en eventuele foutcodes van de API vast te leggen
Als je bijvoorbeeld een agentsysteem wilt testen dat is ontworpen om 100 gelijktijdige gesprekken te ondersteunen, maak je maximaal 100 afzonderlijke “gebruikers” die elk een gesprek simuleren. Gesprekken bestaan doorgaans uit een herhaalde cyclus van ~10 seconden waarin de gebruiker spreekt, gevolgd door een TTS API-call voor ~150 tekens, gevolgd door ~10 seconden waarin audio voor de gebruiker wordt afgespeeld. Daarom moet elke gebruiker elke 20 seconden een websocket Text-to-Speech API-call doen voor 150 tekens tekst, met een kleine hoeveelheid willekeur in de wachttijd en het aantal aangevraagde tekens. De test bestaat uit het starten van één gebruiker per seconde totdat er 100 zijn, en vervolgens in totaal 10 minuten testen om de algehele stabiliteit te testen.
Voorbeeldscript voor testen op schaal
Dit voorbeeld gebruikt locust als testframework met directe API-calls naar de ElevenLabs API.
Het volgt het bovenstaande voorbeeld en test een systeem met een gespreksagent waarbij elke gebruiker elke 20 seconden 1 request verstuurt.