

मॉडल्स
फ्लैगशिप मॉडल्स
टेक्स्ट टू स्पीच
स्पीच टू टेक्स्ट
वॉइस एजेंट्स
म्यूज़िक
मॉडल्स का परिचय
ElevenLabs API अलग-अलग उपयोग के मामलों, गुणवत्ता स्तरों और परफ़ॉर्मेंस आवश्यकताओं के लिए ऑप्टिमाइज़ किए गए कई ऑडियो मॉडल्स देता है।
† माध्यिका, एप्लिकेशन और नेटवर्क लेटेंसी को छोड़कर। लेटेंसी कैसे मापी जाती है देखें।
अप्रचलित मॉडल्स
music_v1 मॉडल अप्रचलित है और इसे 31 जनवरी, 2027 को हटा दिया जाएगा।
eleven_text_to_sound_v2 मॉडल अप्रचलित है और इसे 1 मार्च, 2027 को हटा दिया जाएगा। कृपया
सेवा जारी रखने के लिए नीचे दिए गए रिप्लेसमेंट मॉडल्स पर माइग्रेट करें। अगर आपके अनुरोधों में
model_id सेट नहीं है, तो इसे स्पष्ट रूप से रिप्लेसमेंट मॉडल पर सेट करें।
eleven_turbo_v2_5 और eleven_turbo_v2 मॉडल क्रमशः
eleven_flash_v2_5 और eleven_flash_v2 मॉडल्स के कार्यात्मक रूप से समान हैं, सिवाय इसके कि Flash
मॉडल्स की औसत लेटेंसी कम है। हम सभी उपयोग के मामलों में Turbo मॉडल्स के बजाय Flash मॉडल्स इस्तेमाल करने की सलाह देते हैं।
Eleven v4
Eleven v4 हमारा अत्याधुनिक स्पीच सिंथेसिस मॉडल है, जो हमारी सबसे उच्च गुणवत्ता वाला ऑडियो, अभिव्यक्ति और वॉइस परफ़ॉर्मेंस को नियंत्रित करने की सुविधा देता है। Eleven v4 लंबी टेक्स्ट जनरेशन्स में भरोसेमंद स्पीकर संरक्षण के साथ हाई-फ़िडेलिटी वॉइस क्लोनिंग को सपोर्ट करता है।
यह मॉडल इन स्थितियों में अच्छी तरह काम करता है:
- किरदारों के वॉइसओवर: अपनी भावनात्मक रेंज के कारण गेमिंग और एनीमेशन के लिए आदर्श।
- भावनात्मक संवाद: व्यापक भावनात्मक रेंज और संदर्भ की समझ के साथ प्राकृतिक, इंसान जैसे संवाद जनरेट करें।
- ऑडियोबुक प्रोडक्शन: जटिल भावनात्मक प्रस्तुति वाले लंबे नैरेशन के लिए बेहतरीन।
- मल्टीलिंगुअल प्रोजेक्ट्स: भाषाएं बदलने पर भी एक जैसी वॉइस क्वालिटी बनाए रखता है।
Eleven v4 टेक्स्ट टू डायलॉग API के ज़रिए उपलब्ध है।
समर्थित भाषाएं
Eleven v4 मॉडल परिवार 90+ भाषाओं को सपोर्ट करता है, जिनमें शामिल हैं:
अफ़्रीकांस (af), अम्हारिक (am), अरबी (ar), अर्मेनियाई (hy), असमिया (as), अस्तूरियाई (ast), अज़रबैजानी (az), बेलारूसी (be), बांग्ला (bn), बोस्नियाई (bs), बल्गेरियाई (bg), बर्मी (my), कैंटोनीज़ (yue), कैटलन (ca), सेबुआनो (ceb), क्रोएशियाई (hr), चेक (cs), डेनिश (da), डच (nl), अंग्रेज़ी (en), एस्टोनियाई (et), फ़िलिपीनो (fil), फ़िनिश (fi), फ़्रेंच (fr), फुला (पुलार) (ff), गैलिशियन (gl), जॉर्जियाई (ka), जर्मन (de), यूनानी (el), गुजराती (gu), हौसा (ha), हिब्रू (he), हिंदी (hi), हंगेरियाई (hu), आइसलैंडिक (is), इंडोनेशियाई (id), इतालवी (it), जापानी (ja), जावानीज़ (jv), कांबा (kam), कन्नड़ (kn), कज़ाख़ (kk), कोरियाई (ko), किर्गिज़ (ky), लाओ (lo), लातवियाई (lv), लिंगाला (ln), लिथुआनियाई (lt), लुगांडा (lg), लक्ज़मबर्गिश (lb), मैसेडोनियाई (mk), मलय (ms), मलयालम (ml), माल्टीज़ (mt), मंदारिन चीनी (zh), माओरी (mi), मराठी (mr), मंगोलियाई (mn), नेपाली (ne), नॉर्वेजियन (no), ऑक्सितान (oc), ओड़िया (or), पश्तो (ps), फ़ारसी (fa), पोलिश (pl), पुर्तगाली (pt), पंजाबी (pa), रोमानियाई (ro), रूसी (ru), सर्बियाई (sr), शोना (sn), सिंधी (sd), स्लोवाक (sk), स्लोवेनियाई (sl), सोमाली (so), सोरानी कुर्दिश (ckb), स्पैनिश (es), स्वाहिली (sw), स्वीडिश (sv), ताजिक (tg), तमिल (ta), तेलुगु (te), थाई (th), तुर्की (tr), यूक्रेनी (uk), उर्दू (ur), उज़्बेक (uz), वियतनामी (vi), वेल्श (cy), वोलोफ़ (wo), ज़ुलू (zu).
Eleven v4 Turbo
Eleven v4 Turbo रीयल-टाइम स्पीच सिंथेसिस के लिए हमारा अत्याधुनिक मॉडल है, जो उच्च-गुणवत्ता वाला ऑडियो, अभिव्यक्ति और वॉइस डिलीवरी पर नियंत्रण देता है। Eleven v4 Turbo हाई-फिडेलिटी वॉइस क्लोनिंग को सपोर्ट करता है और इसकी मीडियन लेटेंसी ~100ms है। जानें कि लेटेंसी कैसे मापी जाती है।
यह मॉडल इन स्थितियों में अच्छा काम करता है:
- सपोर्ट एजेंट्स: ऐसे वॉइस एजेंट्स को चलाएं जो रीयल-टाइम में ग्राहकों के सवाल हल करें।
- AI असिस्टेंट्स: व्यापक भावनात्मक रेंज और संदर्भ की समझ के साथ स्वाभाविक, जीवंत संवाद बनाएं।
- इंटरैक्टिव कैरेक्टर्स: अभिव्यक्तिपूर्ण कैरेक्टर्स वाले ऑडियो अनुभवों के लिए बेहतरीन।
Eleven v4 Turbo टेक्स्ट टू डायलॉग websocket के ज़रिए उपलब्ध है।
समर्थित भाषाएं
Eleven v4 मॉडल परिवार 90+ भाषाओं को सपोर्ट करता है, जिनमें शामिल हैं:
अफ़्रीकांस (af), अम्हारिक (am), अरबी (ar), अर्मेनियाई (hy), असमिया (as), अस्तूरियाई (ast), अज़रबैजानी (az), बेलारूसी (be), बांग्ला (bn), बोस्नियाई (bs), बल्गेरियाई (bg), बर्मी (my), कैंटोनीज़ (yue), कैटलन (ca), सेबुआनो (ceb), क्रोएशियाई (hr), चेक (cs), डेनिश (da), डच (nl), अंग्रेज़ी (en), एस्टोनियाई (et), फ़िलिपीनो (fil), फ़िनिश (fi), फ़्रेंच (fr), फुला (पुलार) (ff), गैलिशियन (gl), जॉर्जियाई (ka), जर्मन (de), यूनानी (el), गुजराती (gu), हौसा (ha), हिब्रू (he), हिंदी (hi), हंगेरियाई (hu), आइसलैंडिक (is), इंडोनेशियाई (id), इतालवी (it), जापानी (ja), जावानीज़ (jv), कांबा (kam), कन्नड़ (kn), कज़ाख़ (kk), कोरियाई (ko), किर्गिज़ (ky), लाओ (lo), लातवियाई (lv), लिंगाला (ln), लिथुआनियाई (lt), लुगांडा (lg), लक्ज़मबर्गिश (lb), मैसेडोनियाई (mk), मलय (ms), मलयालम (ml), माल्टीज़ (mt), मंदारिन चीनी (zh), माओरी (mi), मराठी (mr), मंगोलियाई (mn), नेपाली (ne), नॉर्वेजियन (no), ऑक्सितान (oc), ओड़िया (or), पश्तो (ps), फ़ारसी (fa), पोलिश (pl), पुर्तगाली (pt), पंजाबी (pa), रोमानियाई (ro), रूसी (ru), सर्बियाई (sr), शोना (sn), सिंधी (sd), स्लोवाक (sk), स्लोवेनियाई (sl), सोमाली (so), सोरानी कुर्दिश (ckb), स्पैनिश (es), स्वाहिली (sw), स्वीडिश (sv), ताजिक (tg), तमिल (ta), तेलुगु (te), थाई (th), तुर्की (tr), यूक्रेनी (uk), उर्दू (ur), उज़्बेक (uz), वियतनामी (vi), वेल्श (cy), वोलोफ़ (wo), ज़ुलू (zu).
Eleven v3
Eleven v3 हमारा पिछली पीढ़ी का स्पीच सिंथेसिस मॉडल है, जो कई भाषाओं में व्यापक भावनात्मक रेंज और संदर्भ की समझ के साथ स्वाभाविक, जीवंत आवाज़ बनाता है।
Eleven v3 के साथ एक नया टेक्स्ट टू डायलॉग API आता है, जिससे आप कई भाषाओं में व्यापक भावनात्मक रेंज और संदर्भ की समझ के साथ स्वाभाविक, जीवंत संवाद बना सकते हैं। Eleven v3 का इस्तेमाल टेक्स्ट टू स्पीच API के साथ भी किया जा सकता है, जिससे कई भाषाओं में व्यापक भावनात्मक रेंज और संदर्भ की समझ के साथ स्वाभाविक, जीवंत आवाज़ बनाई जा सकती है।
टेक्स्ट टू डायलॉग API के बारे में यहां और पढ़ें।
समर्थित भाषाएं
Eleven v3 मॉडल 70+ भाषाओं को सपोर्ट करता है, जिनमें शामिल हैं:
अफ़्रीकान्स (af), अरबी (ar), आर्मेनियाई (hy), असमिया (as), अस्तूरियाई (ast), अज़रबैजानी (az), बेलारूसी (be), बांग्ला (bn), बोस्नियाई (bs), बुल्गारियाई (bg), बर्मी (my), कैंटोनीज़ (yue), कैटलन (ca), सेबुआनो (ceb), चिचेवा (ny), क्रोएशियाई (hr), चेक (cs), डैनिश (da), डच (nl), अंग्रेज़ी (en), एस्टोनियाई (et), फ़िलिपीनो (fil), फ़िनिश (fi), फ़्रेंच (fr), गैलिशियन (gl), जॉर्जियाई (ka), जर्मन (de), ग्रीक (el), गुजराती (gu), हौसा (ha), हिब्रू (he), हिंदी (hi), हंगेरियन (hu), आइसलैंडिक (is), इंडोनेशियाई (id), आयरिश (ga), इतालवी (it), जापानी (ja), जावानीज़ (jv), कन्नड़ (kn), कज़ाख़ (kk), किर्गिज़ (ky), कोरियाई (ko), लातवियाई (lv), लिंगाला (ln), लिथुआनियाई (lt), लक्ज़मबर्गिश (lb), मैसेडोनियाई (mk), मलय (ms), मलयालम (ml), माल्टीज़ (mt), मंदारिन चीनी (zh), माओरी (mi), मराठी (mr), मंगोलियाई (mn), नेपाली (ne), नॉर्वेजियन (no), ऑक्सितान (oc), ओड़िया (or), पश्तो (ps), फ़ारसी (fa), पोलिश (pl), पुर्तगाली (pt), पंजाबी (pa), रोमानियाई (ro), रूसी (ru), सर्बियाई (sr), सिंधी (sd), स्लोवाक (sk), स्लोवेनियाई (sl), सोमाली (so), स्पैनिश (es), स्वाहिली (sw), स्वीडिश (sv), ताजिक (tg), तमिल (ta), तेलुगु (te), थाई (th), तुर्की (tr), यूक्रेनी (uk), उर्दू (ur), उज़्बेक (uz), वियतनामी (vi), वेल्श (cy), योरूबा (yo)।
Eleven v3 Conversational
Eleven v3 Conversational रीयल-टाइम स्पीच सिंथेसिस के लिए हमारा पिछली पीढ़ी का मॉडल है। यह कई भाषाओं में व्यापक भावनात्मक रेंज और संदर्भ की समझ के साथ स्वाभाविक, जीवंत आवाज़ बनाता है।
Eleven v3 Conversational के साथ एक नया टेक्स्ट टू डायलॉग WebSocket आता है, जिससे आप कई भाषाओं में व्यापक भावनात्मक रेंज और संदर्भ की समझ के साथ स्वाभाविक, जीवंत संवाद बना सकते हैं।
Eleven v3 Conversational के साथ एक नया टेक्स्ट टू डायलॉग WebSocket आता है, जिससे आप कई भाषाओं में व्यापक भावनात्मक रेंज और संदर्भ की समझ के साथ स्वाभाविक, जीवंत संवाद बना सकते हैं।
टेक्स्ट टू डायलॉग WebSocket के बारे में यहां और पढ़ें।
समर्थित भाषाएं
Eleven v3 मॉडल 70+ भाषाओं को सपोर्ट करता है, जिनमें शामिल हैं:
अफ़्रीकान्स (af), अरबी (ar), आर्मेनियाई (hy), असमिया (as), अस्तूरियाई (ast), अज़रबैजानी (az), बेलारूसी (be), बांग्ला (bn), बोस्नियाई (bs), बुल्गारियाई (bg), बर्मी (my), कैंटोनीज़ (yue), कैटलन (ca), सेबुआनो (ceb), चिचेवा (ny), क्रोएशियाई (hr), चेक (cs), डैनिश (da), डच (nl), अंग्रेज़ी (en), एस्टोनियाई (et), फ़िलिपीनो (fil), फ़िनिश (fi), फ़्रेंच (fr), गैलिशियन (gl), जॉर्जियाई (ka), जर्मन (de), ग्रीक (el), गुजराती (gu), हौसा (ha), हिब्रू (he), हिंदी (hi), हंगेरियन (hu), आइसलैंडिक (is), इंडोनेशियाई (id), आयरिश (ga), इतालवी (it), जापानी (ja), जावानीज़ (jv), कन्नड़ (kn), कज़ाख़ (kk), किर्गिज़ (ky), कोरियाई (ko), लातवियाई (lv), लिंगाला (ln), लिथुआनियाई (lt), लक्ज़मबर्गिश (lb), मैसेडोनियाई (mk), मलय (ms), मलयालम (ml), माल्टीज़ (mt), मंदारिन चीनी (zh), माओरी (mi), मराठी (mr), मंगोलियाई (mn), नेपाली (ne), नॉर्वेजियन (no), ऑक्सितान (oc), ओड़िया (or), पश्तो (ps), फ़ारसी (fa), पोलिश (pl), पुर्तगाली (pt), पंजाबी (pa), रोमानियाई (ro), रूसी (ru), सर्बियाई (sr), सिंधी (sd), स्लोवाक (sk), स्लोवेनियाई (sl), सोमाली (so), स्पैनिश (es), स्वाहिली (sw), स्वीडिश (sv), ताजिक (tg), तमिल (ta), तेलुगु (te), थाई (th), तुर्की (tr), यूक्रेनी (uk), उर्दू (ur), उज़्बेक (uz), वियतनामी (vi), वेल्श (cy), योरूबा (yo)।
Multilingual v2
Eleven Multilingual v2 पिछली पीढ़ी का भावनाओं को समझने वाला स्पीच सिंथेसिस मॉडल है। यह कई भाषाओं में व्यापक भावनात्मक रेंज और संदर्भ की समझ के साथ स्वाभाविक, जीवंत आवाज़ बनाता है।
यह मॉडल स्पीकर की विशिष्ट विशेषताओं और एक्सेंट को बनाए रखते हुए सभी समर्थित भाषाओं में लगातार वॉइस क्वालिटी और व्यक्तित्व देता है।
यह मॉडल उन स्थितियों में बेहतरीन है जहां उच्च-गुणवत्ता वाली, भावनात्मक बारीकियों वाली आवाज़ चाहिए:
- कैरेक्टर वॉइसओवर: इसकी भावनात्मक रेंज के कारण गेमिंग और एनीमेशन के लिए आदर्श।
- प्रोफेशनल कंटेंट: कॉर्पोरेट वीडियो और ई-लर्निंग सामग्री के लिए उपयुक्त।
- मल्टीलिंगुअल प्रोजेक्ट्स: भाषा बदलने पर भी लगातार वॉइस क्वालिटी बनाए रखता है।
- स्थिर क्वालिटी: लगातार, उच्च-गुणवत्ता वाला ऑडियो आउटपुट देता है।
हालांकि इसकी लेटेंसी और प्रति कैरेक्टर लागत Flash मॉडल्स से ज़्यादा है, लेकिन जिन प्रोजेक्ट्स में जीवंत आवाज़ महत्वपूर्ण है, उनके लिए यह बेहतर क्वालिटी देता है।
हमारे multilingual v2 मॉडल्स 29 भाषाओं को support करते हैं:
अंग्रेज़ी (USA, UK, ऑस्ट्रेलिया, कनाडा), जापानी, चीनी, जर्मन, हिंदी, फ़्रेंच (फ़्रांस, कनाडा), कोरियाई, पुर्तगाली (ब्राज़ील, पुर्तगाल), इतालवी, स्पेनिश (स्पेन, मेक्सिको), इंडोनेशियाई, डच, तुर्की, फ़िलिपीनो, पोलिश, स्वीडिश, बल्गेरियाई, रोमानियाई, अरबी (सऊदी अरब, UAE), चेक, यूनानी, फ़िनिश, क्रोएशियाई, मलय, स्लोवाक, डेनिश, तमिल, यूक्रेनी और रूसी।
Flash v2.5
Eleven Flash v2.5 कम-लेटेंसी वाला स्पीच सिंथेसिस मॉडल है, जिसे रीयल-टाइम ऐप्लिकेशन और Agents Platform के लिए डिज़ाइन किया गया है। यह 32 भाषाओं में ~100ms† की मीडियन लेटेंसी के साथ उच्च-गुणवत्ता वाली आवाज़ देता है।
यह मॉडल गति और क्वालिटी में संतुलन बनाता है, इसलिए यह इंटरैक्टिव ऐप्लिकेशन के लिए आदर्श है। साथ ही, यह स्वाभाविक आउटपुट और भाषाओं के बीच लगातार वॉइस विशेषताएं बनाए रखता है।
यह मॉडल खास तौर पर इनके लिए उपयुक्त है:
- Agents Platform: रीयल-टाइम वॉइस एजेंट्स और चैटबॉट्स के लिए बेहतरीन।
- इंटरैक्टिव ऐप्लिकेशन: गेम्स और तुरंत प्रतिक्रिया चाहने वाले ऐप्लिकेशन के लिए आदर्श।
- बड़े पैमाने पर प्रोसेसिंग: बड़ी मात्रा में टेक्स्ट-टू-स्पीच कन्वर्ज़न के लिए प्रभावी।
API जनरेशन के लिए इसकी कम कीमत और कम लेटेंसी के साथ, Flash v2.5 कई भाषाओं में तेज़ और भरोसेमंद स्पीच सिंथेसिस चाहने वाले सभी लोगों के लिए किफायती विकल्प है।
Flash v2.5, v2 मॉडल्स की सभी भाषाओं के साथ-साथ 32 भाषाओं को support करता है:
हंगेरियन, नॉर्वेजियन और वियतनामी
† मीडियन, ऐप्लिकेशन और नेटवर्क लेटेंसी को छोड़कर। जानें कि लेटेंसी कैसे मापी जाती है।
ध्यान देने योग्य बातें
संख्याओं के साथ टेक्स्ट नॉर्मलाइज़ेशन
Flash v2.5 का उपयोग करते समय, संख्याएं डिफ़ॉल्ट रूप से आपकी अपेक्षा के अनुसार नॉर्मलाइज़ नहीं होतीं। उदाहरण के लिए, फ़ोन नंबर ऐसे पढ़े जा सकते हैं कि यूज़र के लिए स्पष्ट न हों। तारीखों और मुद्राओं पर भी इसी तरह असर पड़ता है।
कम लेटेंसी बनाए रखने के लिए, Flash v2.5 में डिफ़ॉल्ट रूप से नॉर्मलाइज़ेशन बंद है। हालांकि, Enterprise ग्राहक अब अपने अनुरोध में apply_text_normalization पैरामीटर को “on” पर सेट करके v2.5 मॉडल्स के लिए टेक्स्ट नॉर्मलाइज़ेशन सक्षम कर सकते हैं।
Multilingual v2 मॉडल संख्याओं को नॉर्मलाइज़ करने का बेहतर काम करता है, इसलिए हम फ़ोन नंबरों और अन्य ऐसे मामलों के लिए इसका उपयोग करने की सलाह देते हैं जहां संख्या नॉर्मलाइज़ेशन ज़रूरी है।
कम-लेटेंसी या Agents Platform ऐप्लिकेशन के लिए, सबसे अच्छा तरीका है कि अपने LLM से TTS मॉडल को टेक्स्ट भेजने से पहले उसे नॉर्मलाइज़ करवाएं, या apply_text_normalization पैरामीटर का उपयोग करें (v2.5 मॉडल्स के लिए केवल Enterprise प्लान)।
मॉडल चुनने की गाइड
कौन सा मॉडल आपकी आवश्यकताओं और उपयोग के मामले के लिए सबसे उपयुक्त है, इसके लिए मॉडल चुनने की गाइड देखें।
आवश्यकताएं
उपयोग का मामला
कैरेक्टर सीमाएं
एक टेक्स्ट-टू-स्पीच अनुरोध में समर्थित कैरेक्टर्स की अधिकतम संख्या मॉडल के अनुसार अलग-अलग होती है।
Scribe v2
Scribe v2 हमारा अत्याधुनिक स्पीच रिकग्निशन मॉडल है, जिसे 90+ भाषाओं में सटीक ट्रांसक्रिप्शन के लिए डिज़ाइन किया गया है। यह सटीक शब्द-स्तरीय टाइमस्टैम्प और स्पीकर डायराइज़ेशन तथा डायनामिक ऑडियो टैगिंग जैसी उन्नत सुविधाएं देता है।
यह मॉडल उन स्थितियों में बेहतरीन है जहां सटीक स्पीच-टू-टेक्स्ट कन्वर्ज़न चाहिए:
- ट्रांसक्रिप्शन सेवाएं: ऑडियो/वीडियो कंटेंट को टेक्स्ट में बदलने के लिए बेहतरीन
- मीटिंग डॉक्यूमेंटेशन: बातचीत कैप्चर और डॉक्यूमेंट करने के लिए आदर्श
- कंटेंट विश्लेषण: ऑडियो कंटेंट प्रोसेसिंग और विश्लेषण के लिए उपयुक्त
- मल्टीलिंगुअल रिकग्निशन: 90+ भाषाओं में सटीक ट्रांसक्रिप्शन को सपोर्ट करता है
मुख्य सुविधाएं:
- शब्द-स्तरीय टाइमस्टैम्प के साथ सटीक ट्रांसक्रिप्शन
- कई स्पीकर्स वाले ऑडियो के लिए स्पीकर डायराइज़ेशन
- बेहतर संदर्भ के लिए डायनामिक ऑडियो टैगिंग
- 90+ भाषाओं का सपोर्ट
- एंटिटी डिटेक्शन
- कीटर्म प्रॉम्प्टिंग
- ट्रांसक्रिप्ट एडिटिंग
Scribe v2 के बारे में यहां और पढ़ें।
Scribe v2 Realtime
Scribe v2 Realtime, हमारा सबसे तेज़ और सबसे सटीक लाइव स्पीच रिकग्निशन मॉडल, 90 से अधिक भाषाओं में अत्याधुनिक सटीकता और कमिट किए गए ट्रांसक्रिप्ट तक ~150ms का मीडियन समय देता है। जानें कि लेटेंसी कैसे मापी जाती है।
यह मॉडल संवादात्मक उपयोग के मामलों में बेहतरीन है:
- लाइव मीटिंग ट्रांसक्रिप्शन: रीयल-टाइम ट्रांसक्रिप्शन के लिए बेहतरीन
- AI एजेंट्स: लाइव बातचीत के लिए आदर्श
- मल्टीलिंगुअल रिकग्निशन: स्वचालित भाषा पहचान के साथ 90+ भाषाओं में सटीक ट्रांसक्रिप्शन को सपोर्ट करता है
मुख्य सुविधाएं:
- बेहद कम लेटेंसी: ~150 मिलीसेकंड की मीडियन लेटेंसी के साथ कमिट किए गए ट्रांसक्रिप्ट पाएं
- स्ट्रीमिंग सपोर्ट: रीयल-टाइम में ट्रांसक्रिप्ट पाते हुए ऑडियो को हिस्सों में भेजें
- कई ऑडियो फ़ॉर्मैट: PCM (8kHz से 48kHz) और μ-law एन्कोडिंग का सपोर्ट
- वॉइस एक्टिविटी डिटेक्शन (VAD): साइलेंस डिटेक्शन के आधार पर स्वचालित स्पीच सेगमेंटेशन
- मैन्युअल कमिट कंट्रोल: ट्रांसक्रिप्ट सेगमेंट्स को फ़ाइनल करने के समय पर पूरा नियंत्रण
- एंटिटी डिटेक्शन
- एंटिटी रिडैक्शन
- ट्रांसक्रिप्ट एडिटिंग
Scribe v2 Realtime के बारे में यहां और पढ़ें।
Scribe v2 Medical
Scribe v2 Medical मेडिकल और क्लिनिकल ऑडियो के लिए विशेष रूप से बनाया गया बैच स्पीच रिकग्निशन मॉडल है। यह Scribe v2 का एक फाइनट्यून है, जो रोज़मर्रा की आवाज़ पर Scribe v2 की सटीकता बनाए रखते हुए दवाओं के नाम, एनाटॉमी, पैथोलॉजी और क्लिनिकल डिक्टेशन की पहचान बेहतर करता है। यह Scribe v2 वाले ही स्पीच टू टेक्स्ट API का उपयोग करता है और इसकी बिलिंग भी उसी दर पर होती है। model_id के रूप में scribe_v2_medical भेजें।
उद्देश्य
Scribe v2 Medical डेवलपर्स और संगठनों के लिए एक बैच स्पीच-टू-टेक्स्ट API मॉडल है, जिसे वे ऐसे ऐप्लिकेशन में इंटीग्रेट कर सकते हैं जो क्लिनिकल ऑडियो—जिसमें चिकित्सक-मरीज़ की बातचीत, डिक्टेशन, इंटेक और केयर-कोऑर्डिनेशन कॉल शामिल हैं—को डॉक्यूमेंटेशन और संबंधित प्रशासनिक वर्कफ़्लो के लिए ड्राफ़्ट ट्रांसक्रिप्ट में बदलते हैं। तैयार टेक्स्ट को उपयोग से पहले किसी स्वास्थ्य सेवा पेशेवर या अन्य अधिकृत यूज़र द्वारा समीक्षा और सुधार के लिए बनाया गया है। Scribe v2 Medical का उद्देश्य क्लिनिकल जानकारी की व्याख्या करना या निदान, उपचार की सिफ़ारिशें, क्लिनिकल निर्णय या अन्य क्लिनिकल मार्गदर्शन देना नहीं है।
यह मॉडल इनके लिए उपयुक्त है:
- क्लिनिकल डॉक्यूमेंटेशन: एम्बिएंट एनकाउंटर्स और नोट्स, जहां बातचीत के बीच में मेडिकल शब्द आते हैं
- डिक्टेशन: दवाओं, डोज़ और निष्कर्षों के घने क्रम
- इंटेक और कोऑर्डिनेशन कॉल्स: मरीज़ों द्वारा अपनी स्थितियों का विवरण, अक्सर फ़ोन पर
- कंप्लायंस वर्कफ़्लो: PHI श्रेणियों के लिए एंटिटी डिटेक्शन के साथ मिलाकर उपयोग करें
मुख्य सुविधाएं:
- Scribe v2 जैसा ही अनुरोध स्वरूप (
keyterms,entity_detection,no_verbatim, डायराइज़ेशन, टाइमस्टैम्प) - दवाओं के नाम, एनाटॉमी और पैथोलॉजी शब्दों की बेहतर पहचान
- Scribe v2 की तुलना में रोज़मर्रा की आवाज़ पर कोई गिरावट नहीं
- 90+ भाषाओं का सपोर्ट
- कई स्पीकर्स वाले ऑडियो के लिए स्पीकर डायराइज़ेशन
- डायनामिक ऑडियो टैगिंग
- PHI श्रेणियों सहित एंटिटी डिटेक्शन
Scribe v2 Medical एक बैच मॉडल है। लाइव ट्रांसक्रिप्शन के लिए Scribe v2 Realtime का उपयोग करें।
Scribe v2 Medical HIPAA के लिए पात्र है। Enterprise ग्राहकों के लिए बिज़नेस एसोसिएट एग्रीमेंट्स और ज़ीरो रिटेंशन मोड (ZRM) उपलब्ध हैं। ZRM सक्षम होने पर, हर अनुरोध पूरा होते ही ऑडियो इनपुट और टेक्स्ट आउटपुट हटा दिए जाते हैं। ElevenLabs कुछ भी नहीं रखता, और आपका ऐप्लिकेशन पूरा API रिस्पॉन्स पाता है तथा अपने नियंत्रणों के तहत ट्रांसक्रिप्ट रखता है।
HIPAA अनुपालन चाहने वाली कंपनियों को संरक्षित स्वास्थ्य जानकारी भेजने से पहले बिज़नेस एसोसिएट एग्रीमेंट (BAA) पर हस्ताक्षर करने के लिए ElevenLabs Sales से संपर्क करना होगा।
स्पीच टू टेक्स्ट के बारे में यहां और पढ़ें।
SFX v3
SFX v3 (eleven_text_to_sound_v3) हमारा नया साउंड इफेक्ट्स मॉडल है। यह eleven_text_to_sound_v2 वाले साउंड इफेक्ट्स API का ही उपयोग करता है: इसे इस्तेमाल करने के लिए model_id को eleven_text_to_sound_v3 पर सेट करें। eleven_text_to_sound_v2 अब भी डिफ़ॉल्ट है, लेकिन इसे डिप्रिकेट कर दिया गया है और 1 मार्च, 2027 को हटा दिया जाएगा।
eleven_text_to_sound_v2 की तुलना में, SFX v3:
- एक प्रॉम्प्ट में कई निर्देशों का पालन करता है, जैसे “Football crowd cheering, hearing a ball drop, crowd booing”।
- ऐसे प्रॉम्प्ट संभालता है जिनमें संगीत या वोकल्स शामिल हों, जैसे “Gospel choir singing hello”।
- ज़्यादा स्वाभाविक सुनाई देने वाले परिणाम देता है।
- गोंग, चाइम्स और सीटी जैसी हाई-फ़्रीक्वेंसी आवाज़ों पर क्लिप होने की संभावना कम होती है।
परिणाम प्रॉम्प्ट के आधार पर अलग-अलग होते हैं, इसलिए स्विच करने से पहले दोनों मॉडल्स की तुलना अपने प्रॉम्प्ट्स पर करें।
SFX v3 लूपिंग को सपोर्ट करता है। आसानी से लूप होने वाला साउंड इफेक्ट बनाने के लिए loop को true पर सेट करें।
ElevenCreative में, SFX v3 साउंड इफेक्ट्स, Flows और Studio में उपलब्ध है।
साउंड इफेक्ट्स के बारे में यहां और पढ़ें।
Eleven Realtime
Eleven Realtime प्राकृतिक वॉइस एजेंट्स बनाने के लिए स्पीच टू स्पीच मॉडल्स की एक नई श्रेणी है। हर Realtime मॉडल एक पूरा वॉइस एजेंट है: स्पीच रिकग्निशन, वॉइस एक्टिविटी डिटेक्शन और टर्न-टेकिंग, LLM और टेक्स्ट टू स्पीच, जिन्हें ElevenLabs ने एक सिस्टम के रूप में साथ काम करने के लिए चुना और ट्यून किया है। कोई Realtime मॉडल चुनें और आपको बिना कॉन्फ़िगर करने के लिए किसी कंपोनेंट के, एक ही विकल्प से अच्छा प्रदर्शन करने वाला एजेंट मिल जाता है।
दो Realtime मॉडल उपलब्ध हैं।
Eleven Realtime v1 Mini तेज़, स्वाभाविक बातचीत के लिए ऑप्टिमाइज़्ड है और इन स्थितियों में अच्छा काम करता है:
- AI असिस्टेंट्स: तेज़, अभिव्यक्तिपूर्ण संवाद जहां बातचीत ही प्रोडक्ट है।
- शैक्षिक ट्यूटर्स: स्वाभाविक बातचीत जो सीखने वाले की गति के साथ चलती है।
- इंटरैक्टिव कैरेक्टर्स: गेम्स और मनोरंजन के लिए अभिव्यक्तिपूर्ण कैरेक्टर्स।
Eleven Realtime v1 Max जटिल कार्यों के लिए ऑप्टिमाइज़्ड है और इन स्थितियों में अच्छा काम करता है:
- कस्टमर सपोर्ट: ऐसे सवाल हल करना जिनके लिए किसी प्रक्रिया का पालन और जानकारी खोजना ज़रूरी हो।
- लीड क्वालिफ़िकेशन: ऐसी संरचित बातचीत जो जानकारी जुटाए और अगले कदम तय करे।
- मल्टी-स्टेप वर्कफ़्लो: ऐसे काम जो जानकारी खोजने या कार्रवाई करने के लिए टूल्स कॉल करते हैं।
मुख्य सुविधाएं:
- एक मॉडल विकल्प में स्पीच रिकग्निशन, टर्न-टेकिंग, लैंग्वेज मॉडल और वॉइस
- स्वाभाविक टर्न-टेकिंग और इंटरप्शन हैंडलिंग
- टूल कॉलिंग
- ElevenLabs वॉइस लाइब्रेरी से कस्टमाइज़ की जा सकने वाली वॉइसेस
- 90+ भाषाओं का सपोर्ट
- इंटीग्रेशन बदले बिना, मॉडल चयन के ज़रिए v1 Mini और v1 Max के बीच स्विच करें
Eleven Realtime ElevenAgents में उपलब्ध है, जहां आप मॉडल ड्रॉपडाउन से Realtime मॉडल चुनते हैं। यह Realtime API के ज़रिए भी उपलब्ध है, जिसे WebSocket पर OpenAI के Realtime API के साथ संगत बनाने के लिए डिज़ाइन किया गया है। अगर आप पहले से OpenAI का Realtime API इस्तेमाल कर रहे हैं, तो माइग्रेशन गाइड देखें।
समर्थित भाषाएं
Realtime मॉडल्स 90+ भाषाओं को सपोर्ट करते हैं। Eleven v4 भाषा सूची देखें।
Eleven Realtime के बारे में यहां और पढ़ें।
Eleven Music
Eleven Music हमारा स्टूडियो-ग्रेड म्यूज़िक जनरेशन मॉडल है। इससे आप किसी भी शैली में प्राकृतिक भाषा के प्रॉम्प्ट्स के साथ संगीत बना सकते हैं।
यह मॉडल इन स्थितियों के लिए बेहतरीन है:
- गेम साउंडट्रैक्स: गेम्स के लिए इमर्सिव साउंडट्रैक्स बनाएं
- पॉडकास्ट बैकग्राउंड्स: प्रोफेशनल संगीत के साथ पॉडकास्ट को बेहतर बनाएं
- मार्केटिंग: ऐड रील्स में बैकग्राउंड म्यूज़िक जोड़ें
मुख्य सुविधाएं:
- जॉनर, स्टाइल और संरचना पर पूरा नियंत्रण
- वोकल्स या केवल इंस्ट्रूमेंटल
- अंग्रेज़ी, स्पेनिश, जर्मन, जापानी और अन्य भाषाओं सहित मल्टीलिंगुअल
- अलग-अलग सेक्शंस या पूरे गाने की ध्वनि और लिरिक्स एडिट करें
Eleven Music के बारे में यहां और पढ़ें।
समवर्तीता और प्राथमिकता
आपकी सदस्यता योजना तय करती है कि एक साथ कितने अनुरोध प्रोसेस किए जा सकते हैं और क्यू में आपके अनुरोधों की प्राथमिकता का स्तर क्या होगा। स्पीच टू टेक्स्ट की समवर्तीता सीमा अधिक होती है। समवर्तीता सीमा पूरी होने पर, बाद के अनुरोध कम-प्राथमिकता वाले अनुरोधों के साथ क्यू में प्रोसेस किए जाते हैं। व्यवहार में, इससे आम तौर पर केवल ~50ms की देरी जुड़ती है।
रिस्पॉन्स हेडर में current-concurrent-requests और maximum-concurrent-requests शामिल होते हैं, जिनसे आप अपनी समवर्तीता पर नज़र रख सकते हैं।
प्रति मिनट API अनुरोध बनाम समवर्ती अनुरोध
यह समझना ज़रूरी है कि प्रति मिनट API अनुरोध और समवर्ती अनुरोध अलग-अलग मेट्रिक हैं, जो आपके उपयोग के पैटर्न पर निर्भर करते हैं।
प्रति मिनट API अनुरोध, समवर्ती अनुरोधों से अलग हो सकते हैं, क्योंकि यह हर अनुरोध में लगने वाले समय और अनुरोधों को बैच करने के तरीके पर निर्भर करता है।
उदाहरण 1: अंतराल वाले अनुरोध अगर आपके पास प्रति मिनट 180 अनुरोध हों, जिनमें से हर एक को पूरा होने में 1 सेकंड लगता हो, और आप उन्हें 0.33 सेकंड के अंतर पर भेजें, तो अधिकतम समवर्ती अनुरोध 3 होंगे और औसत भी 3 होगा, क्योंकि हमेशा 3 अनुरोध प्रगति में होंगे।
उदाहरण 2: बैच किए गए अनुरोध लेकिन, अगर आपका उपयोग पैटर्न अलग हो, जैसे प्रति मिनट 180 अनुरोध जिनमें से हर एक को पूरा होने में 3 सेकंड लगते हों, लेकिन वे सभी एक साथ शुरू हों, तो अधिकतम समवर्ती अनुरोध 180 होंगे और औसत 9 होगा (मिनट के पहले 3 सेकंड में एक साथ 180 अनुरोध होंगे, आखिरी 57 सेकंड में 0 अनुरोध होंगे)।
हमारा सिस्टम समवर्तीता को ध्यान में रखता है, इसलिए प्रति मिनट अनुरोधों की संख्या से ज़्यादा यह मायने रखता है कि हर अनुरोध में कितना समय लगता है और उन्हें कब भेजा जाता है।
एंडपॉइंट अनुरोध करने का तरीका समवर्तीता सीमाओं को प्रभावित करता है:
- HTTP के साथ, हर अनुरोध आपकी समवर्तीता सीमा में अलग से गिना जाता है।
- टेक्स्ट टू स्पीच WebSocket के साथ, केवल वह समय आपकी समवर्तीता सीमा में गिना जाता है जब हमारा मॉडल ऑडियो जनरेट कर रहा होता है। इसका मतलब है कि अधिकतर समय खुला websocket आपकी समवर्तीता सीमा में बिल्कुल नहीं गिना जाता।
- टेक्स्ट टू डायलॉग WebSockets अलग तरह से काम करते हैं: हर खुला कनेक्शन खुले रहने तक अलग पूल से एक डायलॉग सेशन आरक्षित रखता है और कनेक्शन पर जनरेट किया गया ऑडियो आपकी सामान्य समवर्तीता सीमा में नहीं गिना जाता। इसे समझना आसान बनाने के लिए डिज़ाइन किया गया है, क्योंकि एक कनेक्शन एक सेशन है, और आपकी डायलॉग सेशन सीमाएं इस नई समवर्तीता पद्धति के अनुसार तय की जाती हैं। टेक्स्ट टू डायलॉग समवर्तीता देखें।
समवर्तीता सीमाओं को समझना
आपकी योजना से जुड़ी समवर्तीता सीमा को एक साथ संभाली जा सकने वाली बातचीत, फोन कॉल, कैरेक्टर वॉइसओवर आदि की अधिकतम संख्या नहीं समझना चाहिए। वास्तविक संख्या कई कारकों पर निर्भर करती है, जिनमें इस्तेमाल की जा रही खास AI वॉइस और उपयोग के मामले की विशेषताएं शामिल हैं।
सामान्य अनुमान के तौर पर, 5 की समवर्तीता सीमा आमतौर पर लगभग 100 एक साथ होने वाले ऑडियो प्रसारणों को सपोर्ट कर सकती है।
ऐसा इसलिए है क्योंकि ऑडियो जनरेट होने में लगने वाली गति, TTS अनुरोध प्रोसेस होने में लगने वाले समय की तुलना में अलग होती है। नीचे दिया गया डायग्राम दिखाता है कि अलग-अलग यूज़र्स के साथ 4 समवर्ती कॉल कैसे केवल 2 समवर्ती अनुरोधों के साथ संचालित की जा सकती हैं।
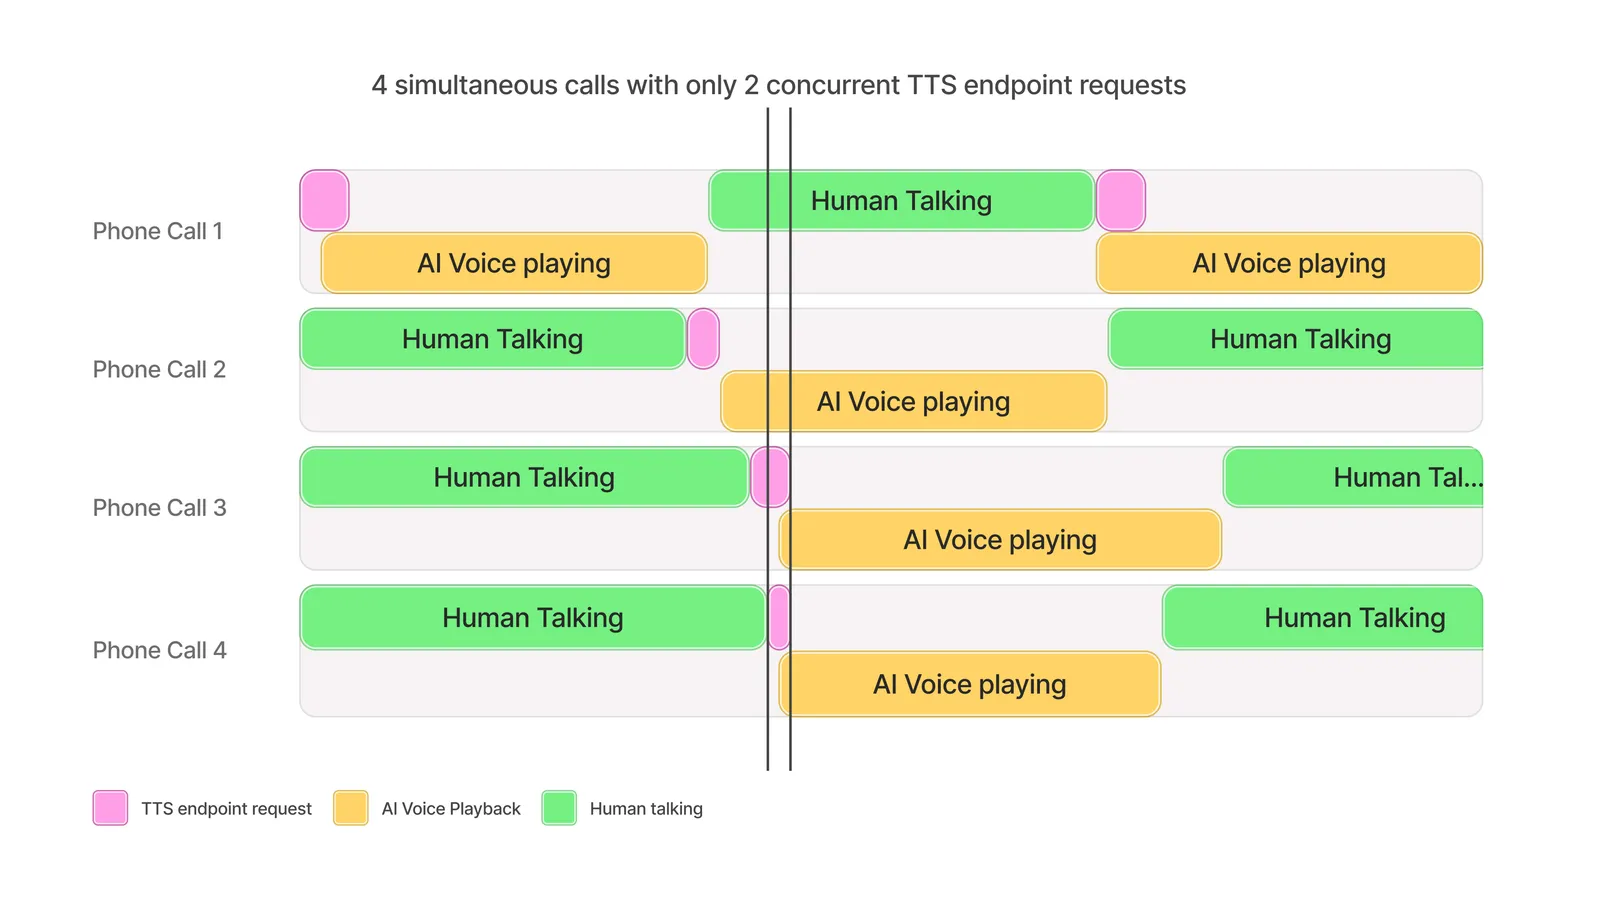
AI वॉइस एजेंट बनाना
जहां TTS का उपयोग डायलॉग संचालित करने के लिए होता है, वहां 5 की समवर्तीता सीमा AI एजेंटों और मानव प्रतिभागियों के बीच संतुलित बातचीत के लिए लगभग 100 प्रसारणों को सपोर्ट कर सकती है।
जिन उपयोग मामलों में AI एजेंट मानव से कम बार बोलता है, जैसे ग्राहक सहायता इंटरैक्शन, वहां 100 से अधिक एक साथ बातचीत को सपोर्ट किया जा सकता है।
कैरेक्टर वॉइसओवर
आम तौर पर, 5 की समवर्तीता सीमा के लिए 100 से अधिक एक साथ कैरेक्टर वॉइसओवर को सपोर्ट किया जा सकता है।
संख्या कैरेक्टर के डायलॉग की आवृत्ति, विराम की अवधि और लाइनों के बीच इन-गेम गतिविधियों के आधार पर बदल सकती है।
लाइव डबिंग
समवर्ती डबिंग स्ट्रीम आम तौर पर दिए गए अनुमान का पालन करती हैं।
अगर प्रसारण में बातचीत के दौरान विराम होते हैं (जैसे साउंडट्रैक, विज़ुअल सीन आदि के कारण), तो सुझाव से अधिक एक साथ डबिंग स्ट्रीम संभव हो सकती हैं।
अगर आप किसी भी समय अपनी योजना की समवर्तीता सीमाएं पार करते हैं और Enterprise योजना पर हैं, तो उपलब्ध क्षमता के आधार पर, सर्वोत्तम प्रयास के तहत मॉडल अनुरोध धीमे होने पर भी सफल हो सकते हैं।
अपनी समवर्तीता सीमा और क्यू प्राथमिकता बढ़ाने के लिए, अपनी सदस्यता योजना अपग्रेड करें।
Enterprise ग्राहक अपने अकाउंट मैनेजर से संपर्क करके अधिक समवर्तीता सीमा का अनुरोध कर सकते हैं।
टेक्स्ट टू डायलॉग समवर्तीता
टेक्स्ट टू डायलॉग अनुरोधों का मीटरिंग दो अलग-अलग तरीकों से होता है, जो इस पर निर्भर करता है कि आप API को कैसे कॉल करते हैं:
- HTTP एंडपॉइंट (डायलॉग बनाएं और डायलॉग स्ट्रीम करें) ऑडियो जनरेट होने के दौरान आपकी योजना की मानक समवर्तीता सीमा में गिने जाते हैं, ठीक किसी अन्य टेक्स्ट टू स्पीच अनुरोध की तरह।
- टेक्स्ट टू डायलॉग WebSocket जैसे WebSocket एंडपॉइंट को डायलॉग सेशन के रूप में मीटर किया जाता है। खुला कनेक्शन, ऑडियो अभी जनरेट हो रहा हो या नहीं, खुले रहने तक एक डायलॉग सेशन रखता है।
सेशन-आधारित मीटरिंग क्षमता नियोजन को आसान रखती है: एक कनेक्शन एक सेशन है, इसलिए आपका उपयोग जनरेशन गतिविधि के साथ नहीं बदलता। सेशन केवल ऑडियो जनरेट होने के दौरान नहीं, बल्कि पूरे कनेक्शन के लिए रखा जाता है, इसलिए आपकी डायलॉग सेशन सीमाएं इस नई समवर्तीता पद्धति के अनुसार तय की जाती हैं।
अगर आप कनेक्शन तब खोलते हैं जब आपके workspace के सभी डायलॉग सेशन उपयोग में हों, तो नया कनेक्शन too_many_concurrent_requests त्रुटि के साथ अस्वीकार कर दिया जाता है। सेशन खाली करने के लिए, जिन कनेक्शनों की अब ज़रूरत नहीं है उन्हें बंद करें — अगर आप keep_alive संदेश नहीं भेजते, तो निष्क्रियता के 20 सेकंड बाद कनेक्शन अपने-आप भी बंद हो जाता है।
डायलॉग सेशन पर नज़र रखने के लिए, डैशबोर्ड साइडबार के सबसे नीचे Developers खोलें, Analytics टैब चुनें और Usage व्यू में Concurrent requests मेट्रिक देखें। डायलॉग सेशन को आपके अन्य समवर्ती अनुरोधों से अलग, अपनी अलग सीरीज़ TTD Websocket Sessions के रूप में रिपोर्ट किया जाता है।
समवर्तीता सीमाओं की स्केल टेस्टिंग
क्लाइंट-साइड स्केलिंग की समस्याएं पहचानने और यह पुष्टि करने के लिए कि आपके उपयोग मामले के लिए समवर्तीता सीमाएं सही ढंग से सेट हैं, स्केल टेस्टिंग उपयोगी हो सकती है।
वास्तविक उपयोग के जितना संभव हो उतना करीब, एंड-टू-एंड वर्कफ़्लो की टेस्टिंग करने की दृढ़ता से सलाह दी जाती है। इसके लिए कितने यूज़र्स को सपोर्ट किया जा सकता है, इसका सिमुलेशन और मापन करना सुझाई गई पद्धति है। यह ज़रूरी है कि आप:
- कच्चे अनुरोधों का नहीं, यूज़र्स का सिमुलेशन करें
- अनुरोध करने से पहले ऑडियो प्लेबैक, यूज़र के बोलने या ट्रांसक्रिप्शन पूरा होने की प्रतीक्षा जैसे सामान्य यूज़र व्यवहार का सिमुलेशन करें
- कुछ मिनटों की अवधि में यूज़र्स की संख्या धीरे-धीरे बढ़ाएं
- अनुरोध के समय और अनुरोधों के आकार में यादृच्छिकता जोड़ें
- API से लौटे लेटेंसी मेट्रिक और किसी भी त्रुटि कोड को कैप्चर करें
उदाहरण के लिए, 100 एक साथ बातचीत को सपोर्ट करने के लिए डिज़ाइन किए गए एजेंट सिस्टम की टेस्टिंग करने के लिए, आप अधिकतम 100 अलग-अलग “यूज़र्स” बनाएंगे, जिनमें हर एक बातचीत का सिमुलेशन करेगा। बातचीत में आम तौर पर ~10 सेकंड यूज़र के बोलने का दोहराव वाला चक्र होता है, उसके बाद ~150 वर्णों के लिए TTS API कॉल और फिर यूज़र को ~10 सेकंड का ऑडियो प्लेबैक होता है। इसलिए, हर यूज़र को हर 20 सेकंड में 150 वर्णों के टेक्स्ट के लिए websocket टेक्स्ट-टू-स्पीच API कॉल करने का पैटर्न अपनाना चाहिए, जिसमें प्रतीक्षा अवधि और मांगे गए वर्णों की संख्या में थोड़ी यादृच्छिकता हो। टेस्ट में हर सेकंड एक यूज़र शुरू किया जाएगा, जब तक 100 यूज़र न हो जाएं, और फिर समग्र स्थिरता जांचने के लिए कुल 10 मिनट तक टेस्ट किया जाएगा।
स्केल टेस्टिंग स्क्रिप्ट का उदाहरण
यह उदाहरण ElevenLabs API पर सीधे API कॉल के साथ locust को टेस्टिंग फ्रेमवर्क के रूप में इस्तेमाल करता है।
यह ऊपर दिए गए उदाहरण का पालन करता है और ऐसे कन्वर्सेशनल एजेंट सिस्टम का परीक्षण करता है जिसमें हर यूज़र हर 20 सेकंड में 1 अनुरोध भेजता है।