

Modèles
Modèles phares
Text to Speech
Speech to Text
Agents vocaux
Musique
Présentation des modèles
L’API ElevenLabs propose une gamme de modèles audio optimisés pour différents cas d’usage, niveaux de qualité et exigences de performances.
† Médiane, hors latence de l’application et du réseau. Découvrez comment la latence est mesurée.
Modèles obsolètes
Le modèle music_v1 est obsolète et sera supprimé le 31 janvier 2027. Le
modèle eleven_text_to_sound_v2 est obsolète et sera supprimé le 1er mars 2027. Veuillez
migrer vers les modèles de remplacement ci-dessous afin de continuer à utiliser le service. Si vos requêtes ne définissent pas
model_id, définissez-le explicitement sur le modèle de remplacement.
Les modèles eleven_turbo_v2_5 et eleven_turbo_v2 sont fonctionnellement équivalents aux
modèles eleven_flash_v2_5 et eleven_flash_v2 respectivement, à l’exception de la latence des modèles Flash,
qui est en moyenne plus faible. Nous recommandons d’utiliser les modèles Flash plutôt que les modèles Turbo dans tous les cas
d’usage.
Eleven v4
Eleven v4 est notre modèle de synthèse vocale de pointe. Il offre notre meilleure qualité audio, une expressivité accrue et un contrôle précis de l’interprétation des voix. Eleven v4 prend en charge le clonage de voix haute fidélité avec une préservation fiable du locuteur sur de longues générations de texte.
Ce modèle est particulièrement adapté aux scénarios suivants :
- Voix off de personnages : idéal pour les jeux et l’animation grâce à son étendue émotionnelle.
- Dialogues émotionnels : générez des dialogues naturels et réalistes, avec une grande étendue émotionnelle et une compréhension du contexte.
- Production de livres audio : parfait pour les narrations longues nécessitant une interprétation émotionnelle complexe.
- Projets multilingues : préserve une qualité vocale homogène lors des changements de langue.
Eleven v4 est disponible via l’API Text to Dialogue.
Langues prises en charge
La famille de modèles Eleven v4 prend en charge plus de 90 langues, dont :
Afrikaans (af), amharique (am), arabe (ar), arménien (hy), assamais (as), asturien (ast), ադրբեջanais (az), biélorusse (be), bengali (bn), bosnien (bs), bulgare (bg), birman (my), cantonais (yue), catalan (ca), cebuano (ceb), croate (hr), tchèque (cs), danois (da), néerlandais (nl), anglais (en), estonien (et), filipino (fil), finnois (fi), français (fr), peul (pulaar) (ff), galicien (gl), géorgien (ka), allemand (de), grec (el), gujarati (gu), haoussa (ha), hébreu (he), hindi (hi), hongrois (hu), islandais (is), indonésien (id), italien (it), japonais (ja), javanais (jv), kamba (kam), kannada (kn), kazakh (kk), coréen (ko), kirghize (ky), lao (lo), letton (lv), lingala (ln), lituanien (lt), luganda (lg), luxembourgeois (lb), macédonien (mk), malais (ms), malayalam (ml), maltais (mt), chinois mandarin (zh), maori (mi), marathi (mr), mongol (mn), népalais (ne), norvégien (no), occitan (oc), odia (or), pachto (ps), persan (fa), polonais (pl), portugais (pt), pendjabi (pa), roumain (ro), russe (ru), serbe (sr), shona (sn), sindhi (sd), slovaque (sk), slovène (sl), somali (so), kurde sorani (ckb), espagnol (es), swahili (sw), suédois (sv), tadjik (tg), tamoul (ta), télougou (te), thaï (th), turc (tr), ukrainien (uk), ourdou (ur), ouzbek (uz), vietnamien (vi), gallois (cy), wolof (wo), zoulou (zu).
Le paramètre language_code accepte les codes à deux lettres de la norme ISO 639-1
pour la plupart des langues. Les langues sans code ISO 639-1 utilisent les codes à trois lettres de la norme ISO
639-3 : asturien (ast), cantonais
(yue), cebuano (ceb), filipino (fil), kamba (kam) et kurde sorani (ckb).
Eleven v4 Turbo
Eleven v4 Turbo est notre modèle de pointe pour la synthèse vocale en temps réel. Il offre une audio de haute qualité, une grande expressivité et un contrôle précis de l’interprétation des voix. Eleven v4 Turbo prend en charge le clonage de voix haute fidélité et présente une latence médiane d’environ 100 ms. Découvrez comment la latence est mesurée.
Ce modèle est particulièrement adapté aux scénarios suivants :
- Agents d’assistance : alimentez des agents vocaux qui résolvent les demandes des clients en temps réel.
- Assistants IA : générez des dialogues naturels et réalistes, avec une grande étendue émotionnelle et une compréhension du contexte.
- Personnages interactifs : excellent pour les expériences audio avec des personnages expressifs.
Eleven v4 Turbo est disponible via le WebSocket Text to Dialogue.
Langues prises en charge
La famille de modèles Eleven v4 prend en charge plus de 90 langues, dont :
Afrikaans (af), amharique (am), arabe (ar), arménien (hy), assamais (as), asturien (ast), ադրբեջanais (az), biélorusse (be), bengali (bn), bosnien (bs), bulgare (bg), birman (my), cantonais (yue), catalan (ca), cebuano (ceb), croate (hr), tchèque (cs), danois (da), néerlandais (nl), anglais (en), estonien (et), filipino (fil), finnois (fi), français (fr), peul (pulaar) (ff), galicien (gl), géorgien (ka), allemand (de), grec (el), gujarati (gu), haoussa (ha), hébreu (he), hindi (hi), hongrois (hu), islandais (is), indonésien (id), italien (it), japonais (ja), javanais (jv), kamba (kam), kannada (kn), kazakh (kk), coréen (ko), kirghize (ky), lao (lo), letton (lv), lingala (ln), lituanien (lt), luganda (lg), luxembourgeois (lb), macédonien (mk), malais (ms), malayalam (ml), maltais (mt), chinois mandarin (zh), maori (mi), marathi (mr), mongol (mn), népalais (ne), norvégien (no), occitan (oc), odia (or), pachto (ps), persan (fa), polonais (pl), portugais (pt), pendjabi (pa), roumain (ro), russe (ru), serbe (sr), shona (sn), sindhi (sd), slovaque (sk), slovène (sl), somali (so), kurde sorani (ckb), espagnol (es), swahili (sw), suédois (sv), tadjik (tg), tamoul (ta), télougou (te), thaï (th), turc (tr), ukrainien (uk), ourdou (ur), ouzbek (uz), vietnamien (vi), gallois (cy), wolof (wo), zoulou (zu).
Le paramètre language_code accepte les codes à deux lettres de la norme ISO 639-1
pour la plupart des langues. Les langues sans code ISO 639-1 utilisent les codes à trois lettres de la norme ISO
639-3 : asturien (ast), cantonais
(yue), cebuano (ceb), filipino (fil), kamba (kam) et kurde sorani (ckb).
Eleven v3
Eleven v3 est notre modèle de synthèse vocale de génération précédente. Il produit une parole naturelle et réaliste, avec une grande étendue émotionnelle et une compréhension du contexte dans plusieurs langues.
Eleven v3 s’accompagne d’une nouvelle API Text to Dialogue, qui vous permet de générer des dialogues naturels et réalistes, avec une grande étendue émotionnelle et une compréhension du contexte dans plusieurs langues. Eleven v3 peut également être utilisé avec l’API Text to Speech pour générer une parole naturelle et réaliste, avec une grande étendue émotionnelle et une compréhension du contexte dans plusieurs langues.
Retrouvez de plus amples informations sur l’API Text to Dialogue ici.
Langues prises en charge
Le modèle Eleven v3 prend en charge plus de 70 langues, notamment :
L’afrikaans (af), l’arabe (ar), l’arménien (hy), l’assamais (as), l’asturien (ast), l’azerbaïdjanais (az), le biélorusse (be), le bengali (bn), le bosnien (bs), le bulgare (bg), le birman (my), le cantonais (yue), le catalan (ca), le cebuano (ceb), le chichewa (ny), le croate (hr), le tchèque (cs), le danois (da), le néerlandais (nl), l’anglais (en), l’estonien (et), le filipino (fil), le finnois (fi), le français (fr), le galicien (gl), le géorgien (ka), l’allemand (de), le grec (el), le gujarati (gu), le haoussa (ha), l’hébreu (he), le hindi (hi), le hongrois (hu), l’islandais (is), l’indonésien (id), l’irlandais (ga), l’italien (it), le japonais (ja), le javanais (jv), le kannada (kn), le kazakh (kk), le kirghize (ky), le coréen (ko), le letton (lv), le lingala (ln), le lituanien (lt), le luxembourgeois (lb), le macédonien (mk), le malais (ms), le malayalam (ml), le maltais (mt), le chinois mandarin (zh), le māori (mi), le marathi (mr), le mongol (mn), le népalais (ne), le norvégien (no), l’occitan (oc), l’odia (or), le pachto (ps), le persan (fa), le polonais (pl), le portugais (pt), le pendjabi (pa), le roumain (ro), le russe (ru), le serbe (sr), le sindhi (sd), le slovaque (sk), le slovène (sl), le somali (so), l’espagnol (es), le swahili (sw), le suédois (sv), le tadjik (tg), le tamoul (ta), le télougou (te), le thaï (th), le turc (tr), l’ukrainien (uk), l’ourdou (ur), l’ouzbek (uz), le vietnamien (vi), le gallois (cy) et le yoruba (yo).
Eleven v3 Conversational
Eleven v3 Conversational est notre modèle de génération précédente pour la synthèse vocale en temps réel. Il produit une parole naturelle et réaliste, avec une grande étendue émotionnelle et une compréhension du contexte dans plusieurs langues.
Eleven v3 Conversational s’accompagne d’un nouveau WebSocket Text to Dialogue, qui vous permet de générer des dialogues naturels et réalistes, avec une grande étendue émotionnelle et une compréhension du contexte dans plusieurs langues.
Eleven v3 Conversational s’accompagne d’un nouveau WebSocket Text to Dialogue, qui vous permet de générer des dialogues naturels et réalistes, avec une grande étendue émotionnelle et une compréhension du contexte dans plusieurs langues.
Retrouvez de plus amples informations sur le WebSocket Text to Dialogue ici.
Langues prises en charge
Le modèle Eleven v3 prend en charge plus de 70 langues, notamment :
L’afrikaans (af), l’arabe (ar), l’arménien (hy), l’assamais (as), l’asturien (ast), l’azerbaïdjanais (az), le biélorusse (be), le bengali (bn), le bosnien (bs), le bulgare (bg), le birman (my), le cantonais (yue), le catalan (ca), le cebuano (ceb), le chichewa (ny), le croate (hr), le tchèque (cs), le danois (da), le néerlandais (nl), l’anglais (en), l’estonien (et), le filipino (fil), le finnois (fi), le français (fr), le galicien (gl), le géorgien (ka), l’allemand (de), le grec (el), le gujarati (gu), le haoussa (ha), l’hébreu (he), le hindi (hi), le hongrois (hu), l’islandais (is), l’indonésien (id), l’irlandais (ga), l’italien (it), le japonais (ja), le javanais (jv), le kannada (kn), le kazakh (kk), le kirghize (ky), le coréen (ko), le letton (lv), le lingala (ln), le lituanien (lt), le luxembourgeois (lb), le macédonien (mk), le malais (ms), le malayalam (ml), le maltais (mt), le chinois mandarin (zh), le māori (mi), le marathi (mr), le mongol (mn), le népalais (ne), le norvégien (no), l’occitan (oc), l’odia (or), le pachto (ps), le persan (fa), le polonais (pl), le portugais (pt), le pendjabi (pa), le roumain (ro), le russe (ru), le serbe (sr), le sindhi (sd), le slovaque (sk), le slovène (sl), le somali (so), l’espagnol (es), le swahili (sw), le suédois (sv), le tadjik (tg), le tamoul (ta), le télougou (te), le thaï (th), le turc (tr), l’ukrainien (uk), l’ourdou (ur), l’ouzbek (uz), le vietnamien (vi), le gallois (cy) et le yoruba (yo).
Multilingual v2
Eleven Multilingual v2 est un modèle de synthèse vocale de génération précédente, sensible aux émotions. Il produit une parole naturelle et réaliste, avec une grande étendue émotionnelle et une compréhension du contexte dans plusieurs langues.
Le modèle offre une qualité vocale et une personnalité homogènes dans toutes les langues prises en charge, tout en préservant les caractéristiques et l’accent propres au locuteur.
Ce modèle excelle dans les scénarios nécessitant une parole de haute qualité aux nuances émotionnelles :
- Voix off de personnages : idéal pour les jeux et l’animation grâce à son étendue émotionnelle.
- Contenu professionnel : adapté aux vidéos d’entreprise et aux supports d’e-learning.
- Projets multilingues : préserve une qualité vocale homogène lors des changements de langue.
- Qualité stable : produit une sortie audio homogène et de haute qualité.
Bien que sa latence et son coût par caractère soient plus élevés que ceux des modèles Flash, il offre une qualité supérieure pour les projets où une parole réaliste est importante.
Nos modèles multilingues v2 prennent en charge 29 langues :
Anglais (États-Unis, Royaume-Uni, Australie, Canada), japonais, chinois, allemand, hindi, français (France, Canada), coréen, portugais (Brésil, Portugal), italien, espagnol (Espagne, Mexique), indonésien, néerlandais, turc, filipino, polonais, suédois, bulgare, roumain, arabe (Arabie saoudite, Émirats arabes unis), tchèque, grec, finnois, croate, malais, slovaque, danois, tamoul, ukrainien et russe.
Flash v2.5
Eleven Flash v2.5 est un modèle de synthèse vocale à faible latence conçu pour les applications en temps réel et Agents Platform. Il produit une parole de haute qualité avec une latence médiane d’environ 100 ms† dans 32 langues.
Le modèle équilibre vitesse et qualité, ce qui le rend idéal pour les applications interactives tout en conservant un rendu naturel et des caractéristiques vocales homogènes dans toutes les langues.
Ce modèle est particulièrement adapté aux usages suivants :
- Agents Platform : parfait pour les agents vocaux et les chatbots en temps réel.
- Applications interactives : idéal pour les jeux et les applications nécessitant une réponse immédiate.
- Traitement à grande échelle : efficace pour la conversion en masse de texte en parole.
Grâce à son tarif plus avantageux pour les générations via API et à sa faible latence, Flash v2.5 constitue une option économique pour tous ceux qui ont besoin d’une synthèse vocale rapide et fiable dans plusieurs langues.
Flash v2.5 prend en charge 32 langues, toutes les langues des modèles v2 ainsi que :
Hongrois, norvégien et vietnamien
† Médiane, hors latence de l’application et du réseau. Découvrez comment la latence est mesurée.
Points à prendre en compte
Normalisation du texte avec des nombres
Lorsque vous utilisez Flash v2.5, les nombres ne sont pas normalisés par défaut comme vous pourriez vous y attendre. Par exemple, les numéros de téléphone peuvent être lus d’une manière peu claire pour l’utilisateur. Les dates et les devises sont affectées de façon similaire.
Par défaut, la normalisation est désactivée pour Flash v2.5 afin de maintenir une faible latence. Toutefois, les clients Enterprise peuvent désormais activer la normalisation du texte pour les modèles v2.5 en définissant le paramètre apply_text_normalization sur « on » dans leur requête.
Le modèle Multilingual v2 normalise mieux les nombres. Nous recommandons donc de l’utiliser pour les numéros de téléphone et les autres cas où la normalisation des nombres est importante.
Pour les applications à faible latence ou Agents Platform, la bonne pratique consiste à demander à votre LLM de normaliser le texte avant de le transmettre au modèle TTS, ou à utiliser le paramètre apply_text_normalization (forfaits Enterprise uniquement pour les modèles v2.5).
Guide de sélection des modèles
Pour savoir quel modèle correspond le mieux à vos besoins et à votre cas d’utilisation, consultez le guide de sélection des modèles.
Besoins
Cas d’utilisation
Limites de caractères
Le nombre maximal de caractères pris en charge dans une seule requête de synthèse vocale varie selon le modèle.
Scribe v3
Scribe v3 est notre modèle de reconnaissance vocale le plus précis pour l’audio enregistré. Il succède à Scribe v2 et utilise la même API Speech to Text (POST /v1/speech-to-text). Transmettez scribe_v3 comme model_id.
Ce modèle est particulièrement adapté aux cas suivants :
- Outils de réunion et de prise de notes : transcriptions de réunions et d’appels enregistrés avec identification des intervenants
- Médias : sous-titres et légendes avec identification des intervenants et horodatages au niveau des mots
- Éducation : cours enregistrés avec des locuteurs ayant un accent ou alternant entre plusieurs langues
- Centres de contact : appels enregistrés pour l’assurance qualité et l’analyse
Par rapport à Scribe v2, Scribe v3 offre :
- Moins d’erreurs de transcription. Sur le benchmark FLEURS couvrant 102 langues, Scribe v3 réduit le taux d’erreur par mot (WER) de 16,94 % à 12,38 %, soit 27 % d’erreurs de mots en moins que Scribe v2, et s’améliore dans chaque langue testée.
- Une identification plus précise des intervenants dans les audios à plusieurs locuteurs.
- Le paramètre
numbers_format, qui écrit les nombres sous forme de chiffres (42) ou de mots (quarante-deux). - Le paramètre
secondary_language_codes, qui répertorie, en complément delanguage_code, les autres langues attendues dans l’audio afin d’améliorer la précision pour les audios multilingues.
Consultez les options de nombres et de langues pour utiliser les nouveaux paramètres.
ElevenLabs calcule le WER FLEURS pour chaque extrait, puis en fait la moyenne par langue. Cela produit des chiffres plus élevés que le WER au niveau du corpus couramment publié. Les chiffres ne sont donc pas comparables aux résultats calculés d’une autre manière.
Scribe v3 conserve les fonctionnalités de Scribe v2 :
- Prise en charge de plus de 90 langues
- Diarisation des intervenants, jusqu’à 32 intervenants
- Horodatages au niveau des mots ou des caractères
- Étiquetage des événements audio
- Guidage par termes clés, jusqu’à 1 000 termes
- Détection d’entités
- Modification de transcription
- Absence de mode verbatim
- Export vers des formats supplémentaires tels que SRT, DOCX et PDF
- Webhooks pour les résultats asynchrones
Passer de Scribe v2 à Scribe v3
Remplacez scribe_v2 par scribe_v3 dans model_id. Les paramètres de requête existants fonctionnent sans modification. Scribe v2 reste disponible.
Scribe v3 Live
Scribe v3 Live est notre modèle de reconnaissance vocale en temps réel le plus précis. Il succède à Scribe v2 Realtime et utilise le même WebSocket en temps réel (wss://api.elevenlabs.io/v1/speech-to-text/realtime). Transmettez scribe_v3_live comme paramètre de requête model_id.
Scribe v3 Live est un modèle de conversion de la parole en texte. Il est distinct d’Eleven Realtime, les modèles de conversion Speech-to-Speech destinés aux agents vocaux.
Ce modèle est particulièrement adapté aux cas suivants :
- Agents vocaux et centres de contact : validation d’un tour de parole lorsque l’appelant a fini de parler, et non à la première pause
- Sous-titrage en direct : transcriptions en temps réel avec horodatages au niveau des mots
- Éducation et apprentissage des langues : locuteurs avec un accent et locuteurs qui changent de langue
- Dictée et assistants : vocabulaire métier grâce aux termes clés
Par rapport à Scribe v2 Realtime, Scribe v3 Live offre :
- Moins d’erreurs de transcription. Sur le benchmark FLEURS couvrant 73 langues, Scribe v3 Live affiche un WER sémantique inférieur de 44 % à celui de Scribe v2 Realtime. Sur Earnings-22, des appels financiers en anglais avec accent, le WER passe de 5,99 % à 3,91 %, et sur VoxPopuli, des discours du Parlement européen, de 2,13 % à 1,71 %.
- La prédiction de tour de parole. Avec
commit_strategy=turn_prediction, le serveur valide un segment lorsque le modèle prédit que le locuteur a terminé son tour de parole, au lieu d’attendre uniquement le silence. - Le mode multilingue. Avec
multilang_mode=true, chaque langue est transcrite dans sa propre écriture, y compris lors des changements au milieu d’une phrase. - Une bibliothèque de termes clés comptant jusqu’à 10 000 termes, que le modèle utilise uniquement lorsqu’il détecte une correspondance probable, en plus des 50 termes clés standards.
- La diarisation en temps réel. Avec
diarize=true, des étiquettes provisoires d’intervenants apparaissent dans les transcriptions partielles, et chaque transcription validée est suivie d’une transcription diarizée distincte, sans retarder le texte validé.
Scribe v3 Live conserve les fonctionnalités de Scribe v2 Realtime :
- Prise en charge de plus de 90 langues, avec détection automatique de la langue
- Prise en charge du streaming : envoyez l’audio par blocs tout en recevant les transcriptions en temps réel
- Plusieurs formats audio : PCM, de 8 kHz à 48 kHz, et encodage μ-law
- Stratégies de validation manuelle et de détection d’activité vocale (VAD)
- Horodatages au niveau des mots
secondary_languagespour limiter la détection de la langue à un ensemble de langues- Guidage par termes clés, jusqu’à 50 termes
- Détection d’entités
- Modification de transcription
- Filtrage du bruit de fond
Passer de Scribe v2 Realtime à Scribe v3 Live
Remplacez scribe_v2_realtime par scribe_v3_live dans model_id. La stratégie de validation par défaut reste manual, de sorte que les intégrations existantes se comportent de la même façon jusqu’à ce que vous définissiez commit_strategy sur turn_prediction. Scribe v2 Realtime reste disponible.
Les SDK officiels ne prennent pas encore en charge la prédiction de tour de parole, le mode multilingue ni la bibliothèque de termes clés. Pour les utiliser, connectez-vous directement à l’API WebSocket.
Scribe v2
Scribe v2 est notre ancien modèle de reconnaissance vocale de pointe, remplacé par Scribe v3. Il est conçu pour une transcription précise dans plus de 90 langues. Il fournit des horodatages précis au niveau des mots et des fonctionnalités avancées telles que la diarisation des intervenants et l’étiquetage audio dynamique.
Ce modèle excelle dans les scénarios nécessitant une conversion parole-texte précise :
- Services de transcription : parfait pour convertir des contenus audio ou vidéo en texte
- Documentation de réunions : idéal pour capturer et documenter les conversations
- Analyse de contenu : adapté au traitement et à l’analyse de contenus audio
- Reconnaissance multilingue : prend en charge une transcription précise dans plus de 90 langues
Fonctionnalités clés :
- Transcription précise avec horodatages au niveau des mots
- Diarisation des intervenants pour les audios à plusieurs locuteurs
- Étiquetage audio dynamique pour un contexte enrichi
- Prise en charge de plus de 90 langues
- Détection d’entités
- Guidage par termes clés
- Modification de transcription
Retrouvez de plus amples informations sur Scribe v2 ici.
Scribe v2 Realtime
Scribe v2 Realtime est notre ancien modèle de reconnaissance vocale en direct de pointe, remplacé par Scribe v3 Live. Il transcrit plus de 90 langues avec un délai médian jusqu’à la transcription validée d’environ 150 ms. Consultez la méthode de mesure de la latence.
Ce modèle excelle dans les cas d’utilisation conversationnels :
- Transcription de réunions en direct : parfaite pour la transcription en temps réel
- Agents IA : idéal pour les conversations en direct
- Reconnaissance multilingue : prend en charge une transcription précise dans plus de 90 langues avec reconnaissance automatique de la langue
Fonctionnalités clés :
- Latence ultra-faible : obtenez des transcriptions validées avec une latence médiane d’environ 150 millisecondes
- Prise en charge du streaming : envoyez l’audio par blocs tout en recevant les transcriptions en temps réel
- Plusieurs formats audio : prise en charge de PCM, de 8 kHz à 48 kHz, et de l’encodage μ-law
- Détection d’activité vocale (VAD) : segmentation automatique de la parole basée sur la détection du silence
- Contrôle manuel de la validation : contrôle total du moment où finaliser les segments de transcription
- Détection d’entités
- Masquage d’entités
- Modification de transcription
Retrouvez de plus amples informations sur Scribe v2 Realtime ici.
Scribe v2 Medical
Scribe v2 Medical est un modèle de reconnaissance vocale par lot spécialisé dans l’audio médical et clinique. Il s’agit d’un ajustement de Scribe v2 qui améliore la reconnaissance des noms de médicaments, de l’anatomie, de la pathologie et de la dictée clinique, tout en conservant la précision de Scribe v2 sur la parole courante. Il utilise la même API Speech to Text que Scribe v2 et est facturé au même tarif. Transmettez scribe_v2_medical comme model_id.
Utilisation prévue
Scribe v2 Medical est un modèle d’API Speech-to-Text par lot destiné aux développeurs et aux organisations qui l’intègrent dans des applications convertissant l’audio clinique, y compris les conversations entre soignants et patients, la dictée, les appels d’admission et de coordination des soins, en brouillons de transcription pour la documentation et les flux de travail administratifs associés. Le texte obtenu est destiné à être révisé et corrigé par un professionnel de santé ou un autre utilisateur autorisé avant utilisation. Scribe v2 Medical n’est pas conçu pour interpréter des informations cliniques ni fournir des diagnostics, des recommandations de traitement, des décisions cliniques ou d’autres conseils cliniques.
Ce modèle est particulièrement adapté aux cas suivants :
- Documentation clinique : consultations ambiantes et notes dans lesquelles des termes médicaux apparaissent au fil de la conversation
- Dictée : séquences denses de médicaments, de dosages et de constatations
- Appels d’admission et de coordination : patients décrivant leurs propres pathologies, souvent par téléphone
- Flux de travail de conformité : associez-le à la détection d’entités pour les catégories de PHI
Fonctionnalités clés :
- Même structure de requête que Scribe v2 (
keyterms,entity_detection,no_verbatim, diarisation, horodatages) - Meilleure reconnaissance des noms de médicaments et des termes d’anatomie et de pathologie
- Aucune régression sur la parole courante par rapport à Scribe v2
- Prise en charge de plus de 90 langues
- Diarisation des intervenants pour les audios à plusieurs locuteurs
- Étiquetage audio dynamique
- Détection d’entités, y compris les catégories de PHI
Scribe v2 Medical est un modèle par lot. Pour la transcription en direct, utilisez Scribe v2 Realtime.
Scribe v2 Medical est éligible à la conformité HIPAA, avec des accords de partenariat commercial disponibles pour les clients Enterprise, ainsi que le mode zéro rétention (ZRM). Lorsque le ZRM est activé, l’entrée audio et la sortie texte sont supprimées immédiatement après la fin de chaque requête. ElevenLabs ne conserve rien, et votre application reçoit la réponse complète de l’API et conserve les transcriptions selon vos propres contrôles.
Les entreprises devant respecter la réglementation HIPAA doivent contacter le service commercial d’ElevenLabs afin de signer un accord de partenariat commercial (BAA) avant d’envoyer des informations de santé protégées.
Retrouvez de plus amples informations sur Speech to Text ici.
SFX v3
SFX v3 (eleven_text_to_sound_v3) est notre tout dernier modèle d’effets sonores. Il utilise la même API Sound Effects que eleven_text_to_sound_v2 : définissez model_id sur eleven_text_to_sound_v3 pour l’utiliser. eleven_text_to_sound_v2 reste le modèle par défaut, mais il est obsolète et sera supprimé le 1er mars 2027.
Par rapport à eleven_text_to_sound_v2, SFX v3 :
- Suit plusieurs instructions dans un même prompt, telles que « Foule de football qui applaudit, bruit d’un ballon qui tombe, foule qui hue ».
- Gère les prompts incluant de la musique ou des voix chantées, tels que « Chœur gospel chantant bonjour ».
- Produit des résultats au rendu plus naturel.
- Est moins susceptible de saturer avec des sons à haute fréquence tels que les gongs, les carillons et les sifflets.
Les résultats varient selon le prompt. Comparez donc les deux modèles avec vos propres prompts avant de changer de modèle.
SFX v3 prend en charge les boucles. Définissez loop sur true pour générer un effet sonore qui se répète de manière fluide.
Dans ElevenCreative, SFX v3 est disponible dans Sound Effects, Flows et Studio.
Retrouvez de plus amples informations sur les effets sonores ici.
Eleven Realtime
Eleven Realtime est une nouvelle catégorie de modèles Speech to Speech permettant de concevoir des agents vocaux naturels. Chaque modèle Realtime est un agent vocal complet : reconnaissance vocale, détection d’activité vocale et gestion des tours de parole, LLM et synthèse vocale, sélectionnés et ajustés par ElevenLabs pour fonctionner ensemble comme un seul système. Sélectionnez un modèle Realtime et obtenez un agent performant à partir d’un seul choix, sans composant à configurer.
Deux modèles Realtime sont disponibles.
Eleven Realtime v1 Mini est optimisé pour des conversations rapides et naturelles, et convient particulièrement aux scénarios suivants :
- Assistants IA : dialogue rapide et expressif où la conversation est elle-même le produit.
- Tuteurs pédagogiques : échanges naturels qui suivent le rythme de l’apprenant.
- Personnages interactifs : personnages expressifs pour les jeux et le divertissement.
Eleven Realtime v1 Max est optimisé pour les tâches complexes, et convient particulièrement aux scénarios suivants :
- Support client : résolution de demandes nécessitant de suivre un processus et de rechercher des informations.
- Qualification de prospects : conversations structurées qui recueillent des informations et déterminent les prochaines étapes.
- Flux de travail à plusieurs étapes : tâches qui appellent des outils pour rechercher des informations ou effectuer des actions.
Fonctionnalités clés :
- Reconnaissance vocale, gestion des tours de parole, modèle de langage et voix réunis dans un seul choix de modèle
- Gestion naturelle des tours de parole et des interruptions
- Appel d’outils
- Voix personnalisables de la Voice Library d’ElevenLabs
- Prise en charge de plus de 90 langues
- Passage de v1 Mini à v1 Max par sélection de modèle, sans modifier l’intégration
Eleven Realtime est disponible dans ElevenAgents, où vous sélectionnez un modèle Realtime dans la liste déroulante des modèles, ainsi que via l’API Realtime, conçue pour être compatible avec l’API Realtime d’OpenAI via WebSocket. Si vous utilisez déjà l’API Realtime d’OpenAI, consultez le guide de migration.
Langues prises en charge
Les modèles Realtime prennent en charge plus de 90 langues. Consultez la liste des langues d’Eleven v4.
Retrouvez de plus amples informations sur Eleven Realtime ici.
Eleven Music
Eleven Music est notre modèle de génération musicale de qualité studio. Il vous permet de générer de la musique dans n’importe quel style à partir de prompts en langage naturel.
Ce modèle est particulièrement adapté aux scénarios suivants :
- Bandes originales de jeux : créez des bandes originales immersives pour les jeux
- Fonds sonores de podcasts : enrichissez les podcasts avec de la musique professionnelle
- Marketing : ajoutez de la musique de fond aux vidéos publicitaires
Fonctionnalités clés :
- Contrôle total du genre, du style et de la structure
- Chant ou instrumental uniquement
- Multilingue, notamment en anglais, espagnol, allemand, japonais et plus encore
- Modifiez le son et les paroles de sections individuelles ou de l’ensemble du morceau
Retrouvez de plus amples informations sur Eleven Music ici.
Requêtes simultanées et priorité
Votre forfait détermine le nombre de requêtes pouvant être traitées simultanément et le niveau de priorité de vos requêtes dans la file d’attente. Speech to Text bénéficie d’une limite de requêtes simultanées plus élevée. Une fois cette limite atteinte, les requêtes suivantes sont traitées dans une file d’attente avec des requêtes de priorité inférieure. En pratique, cela n’ajoute généralement qu’environ 50 ms de latence.
Pour estimer la limite de requêtes simultanées dont votre trafic a besoin, utilisez l’estimateur de requêtes simultanées.
Les en-têtes de réponse incluent current-concurrent-requests et maximum-concurrent-requests, que vous pouvez utiliser pour suivre vos requêtes simultanées.
Requêtes API par minute et requêtes simultanées
Il est important de comprendre que les requêtes API par minute et les requêtes simultanées sont des métriques distinctes qui dépendent de vos habitudes d’utilisation.
Le nombre de requêtes API par minute peut différer du nombre de requêtes simultanées, car il dépend de la durée de chaque requête et de la façon dont les requêtes sont regroupées.
Exemple 1 : requêtes espacées Si vous aviez 180 requêtes par minute, chacune prenant 1 seconde à s’exécuter, et que vous les envoyiez à 0,33 seconde d’intervalle, le nombre maximal et le nombre moyen de requêtes simultanées seraient de 3, puisqu’il y en aurait toujours 3 en cours.
Exemple 2 : requêtes regroupées En revanche, si vous aviez un mode d’utilisation différent, avec 180 requêtes par minute prenant chacune 3 secondes à s’exécuter mais toutes déclenchées en même temps, le nombre maximal de requêtes simultanées serait de 180 et la moyenne serait de 9 (les 3 premières secondes de la minute compteraient 180 requêtes en même temps, les 57 dernières secondes 0 requête).
Notre système étant basé sur les requêtes simultanées, le nombre de requêtes par minute importe moins que la durée de chaque requête et le rythme auquel elles sont envoyées.
La manière dont les requêtes sont effectuées auprès des endpoints a une incidence sur les limites de requêtes simultanées :
- Avec HTTP, chaque requête est comptabilisée individuellement dans votre limite de requêtes simultanées.
- Avec le WebSocket Text to Speech, seul le temps pendant lequel notre modèle génère de l’audio est comptabilisé dans votre limite de requêtes simultanées. Ainsi, la plupart du temps, un websocket ouvert n’est pas du tout comptabilisé dans cette limite.
- Les WebSockets Text to Dialogue fonctionnent différemment : chaque connexion ouverte réserve une session de dialogue issue d’un pool distinct pendant toute sa durée, et l’audio généré via cette connexion n’est pas comptabilisé dans votre limite standard de requêtes simultanées. Ce fonctionnement est plus simple à appréhender : une connexion correspond à une session, et les limites de vos sessions de dialogue sont dimensionnées pour s’adapter à cette nouvelle méthode de gestion des requêtes simultanées. Consultez les requêtes simultanées Text to Dialogue.
Comprendre les limites de requêtes simultanées
La limite de requêtes simultanées associée à votre forfait ne doit pas être interprétée comme le nombre maximal de conversations, d’appels téléphoniques, de voix off de personnages, etc. pouvant être traités simultanément. Le nombre réel dépend de plusieurs facteurs, notamment des voix IA utilisées et des caractéristiques du cas d’utilisation.
En règle générale, une limite de 5 requêtes simultanées peut prendre en charge jusqu’à environ 100 diffusions audio simultanées.
Cela s’explique par la vitesse de génération de l’audio par rapport au temps nécessaire au traitement de la requête TTS. Le diagramme ci-dessous illustre comment 4 appels simultanés avec différents utilisateurs peuvent être pris en charge tout en n’atteignant que 2 requêtes simultanées.
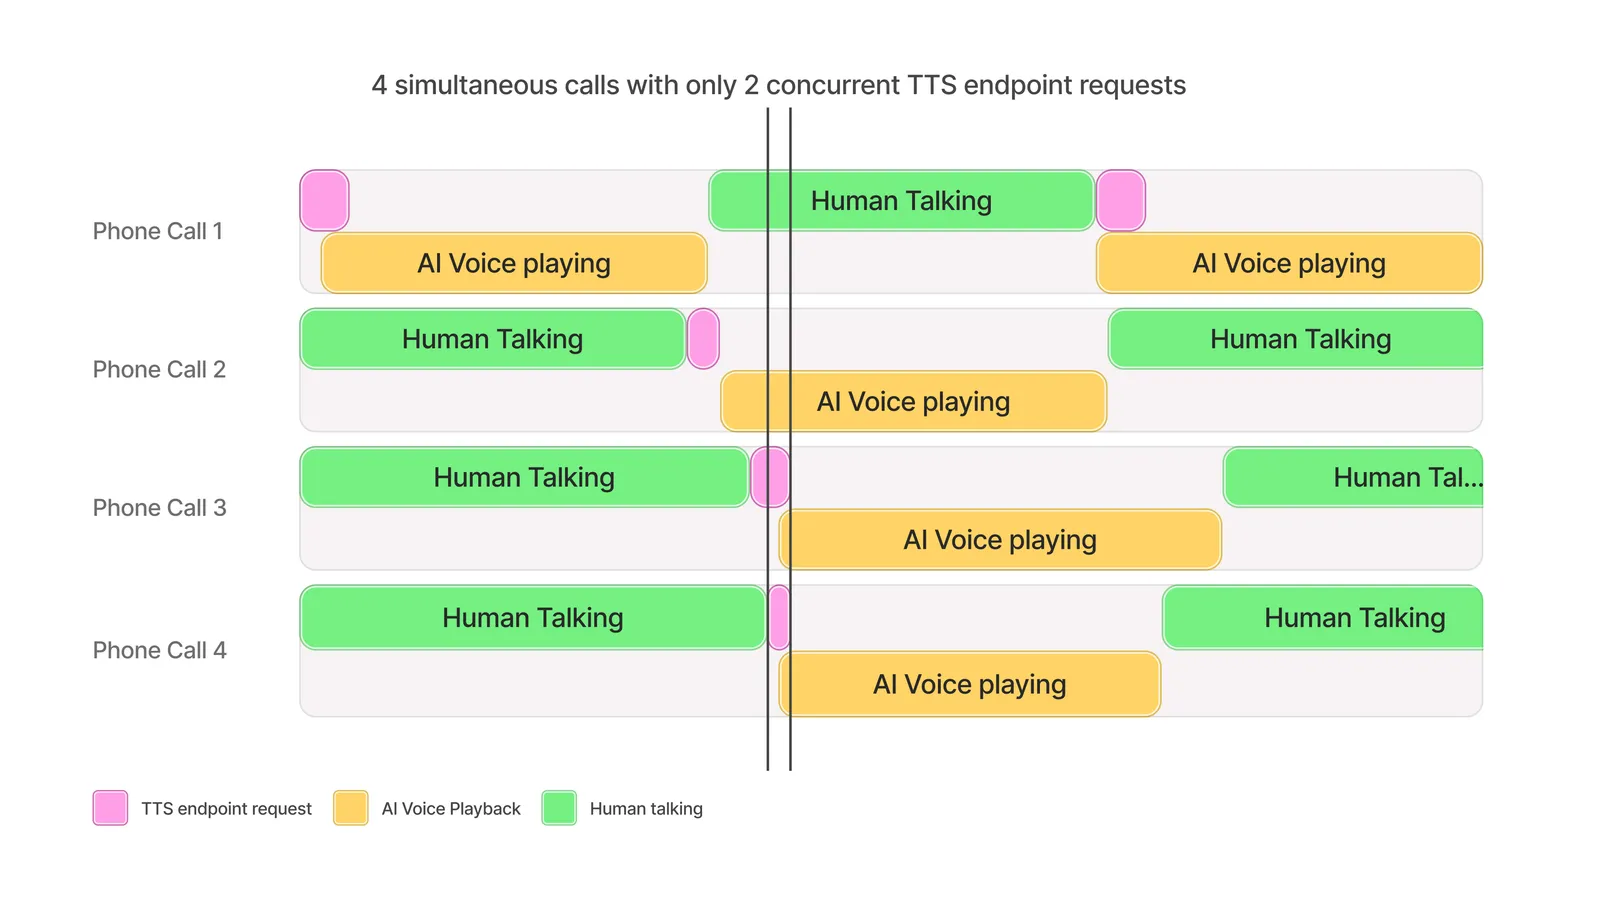
Concevoir des agents vocaux IA
Lorsque le TTS est utilisé pour faciliter un dialogue, une limite de 5 requêtes simultanées peut prendre en charge environ 100 diffusions pour des conversations équilibrées entre des agents IA et des participants humains.
Pour les cas d’utilisation où l’agent IA parle moins souvent que l’interlocuteur humain, comme les interactions avec le support client, plus de 100 conversations simultanées peuvent être prises en charge.
Voix off de personnages
En général, plus de 100 voix off de personnages simultanées peuvent être prises en charge avec une limite de 5 requêtes simultanées.
Ce nombre peut varier selon la fréquence des dialogues du personnage, la durée des pauses et les actions dans le jeu entre les répliques.
Doublage en direct
Les flux de doublage simultanés suivent généralement l’heuristique indiquée.
Si la diffusion comporte des périodes de pauses conversationnelles, par exemple en raison d’une bande-son ou de scènes visuelles, il peut être possible de prendre en charge davantage de flux de doublage simultanés que suggéré.
Si vous dépassez à tout moment les limites de requêtes simultanées de votre forfait et que vous êtes sur le forfait Enterprise, les requêtes de modèle peuvent tout de même aboutir, mais plus lentement, dans la limite des capacités disponibles.
Pour augmenter votre limite de requêtes simultanées et votre priorité dans la file d’attente, mettez à niveau votre forfait d’abonnement.
Les clients Enterprise peuvent demander une limite de requêtes simultanées plus élevée en contactant leur responsable de compte.
Requêtes simultanées Text to Dialogue
Les requêtes Text to Dialogue sont comptabilisées de deux manières différentes selon la façon dont vous appelez l’API :
- Les endpoints HTTP (Créer un dialogue et Diffuser un dialogue) sont comptabilisés dans la limite standard de requêtes simultanées de votre forfait pendant la génération de l’audio, comme toute autre requête Text to Speech.
- Les endpoints WebSocket, comme le WebSocket Text to Dialogue, sont comptabilisés comme des sessions de dialogue. Une connexion ouverte conserve une session de dialogue pendant toute sa durée, que de l’audio soit généré ou non.
La comptabilisation par session simplifie la planification des capacités : une connexion correspond à une session, votre utilisation ne fluctue donc pas selon l’activité de génération. Une session étant conservée pendant toute la connexion plutôt que seulement lors de la génération audio, les limites de vos sessions de dialogue sont dimensionnées pour s’adapter à cette nouvelle méthode de gestion des requêtes simultanées.
Si vous ouvrez une connexion alors que toutes les sessions de dialogue de votre Workspace sont utilisées, la nouvelle connexion est rejetée avec une erreur too_many_concurrent_requests. Pour libérer des sessions, fermez les connexions dont vous n’avez plus besoin. Une connexion se ferme aussi automatiquement après 20 secondes d’inactivité, sauf si vous envoyez des messages keep_alive.
Pour suivre les sessions de dialogue, ouvrez Développeurs en bas de la barre latérale du Dashboard, sélectionnez l’onglet Analytique, puis consultez la métrique Requêtes simultanées dans la vue Utilisation. Les sessions de dialogue sont indiquées dans leur propre série, Sessions Websocket TTD, distincte de vos autres requêtes simultanées.
Tester les limites de requêtes simultanées à grande échelle
Les tests à grande échelle peuvent aider à identifier les problèmes de mise à l’échelle côté client et à vérifier que les limites de requêtes simultanées sont correctement définies pour votre cas d’utilisation.
Il est fortement recommandé de tester les flux de travail de bout en bout au plus près de l’utilisation réelle. Simuler et mesurer le nombre d’utilisateurs pris en charge est la méthode recommandée pour y parvenir. Il est important de :
- Simuler des utilisateurs, et non des requêtes brutes
- Simuler le comportement habituel des utilisateurs, notamment l’attente de la lecture audio, de la prise de parole de l’utilisateur ou de la fin de la transcription avant d’effectuer des requêtes
- Augmenter lentement le nombre d’utilisateurs sur plusieurs minutes
- Introduire de l’aléa dans le moment des requêtes et leur taille
- Collecter les métriques de latence et les éventuels codes d’erreur renvoyés par l’API
Par exemple, pour tester un système d’agents conçu pour prendre en charge 100 conversations simultanées, vous créeriez jusqu’à 100 « utilisateurs » individuels simulant chacun une conversation. Les conversations se composent généralement d’un cycle répété d’environ 10 secondes de parole de l’utilisateur, suivies d’un appel à l’API TTS pour environ 150 caractères, puis d’environ 10 secondes de lecture audio à l’utilisateur. Chaque utilisateur doit donc suivre le modèle consistant à effectuer un appel à l’API Text-to-Speech par websocket pour 150 caractères de texte toutes les 20 secondes, en introduisant une légère variation dans la période d’attente et le nombre de caractères demandés. Le test consisterait à générer un utilisateur par seconde jusqu’à en avoir 100, puis à tester pendant 10 minutes au total afin de vérifier la stabilité globale.
Exemple de script de test à grande échelle
Cet exemple utilise locust comme framework de test avec des appels API directs à l’API ElevenLabs.
Il suit l’exemple présenté ci-dessus et teste un système d’agent conversationnel dans lequel chaque utilisateur envoie 1 requête toutes les 20 secondes.