

모델
플래그십 모델
텍스트 음성 변환
음성 텍스트 변환
음성 에이전트
음악
모델 개요
ElevenLabs API는 다양한 사용 사례, 품질 수준, 성능 요구 사항에 맞게 최적화된 여러 오디오 모델을 제공합니다.
† 애플리케이션 및 네트워크 지연 시간을 제외한 중앙값입니다. 지연 시간 측정 방법을 확인하세요.
지원 중단 모델
music_v1 모델은 지원이 중단되었으며 2027년 1월 31일에 제거됩니다.
eleven_text_to_sound_v2 모델은 지원이 중단되었으며 2027년 3월 1일에 제거됩니다. 서비스를 계속 이용하려면
아래의 대체 모델로 마이그레이션하세요. 요청에서 model_id를 설정하지 않는 경우
대체 모델로 명시적으로 설정하세요.
eleven_turbo_v2_5 및 eleven_turbo_v2 모델은 각각
eleven_flash_v2_5 및 eleven_flash_v2 모델과 기능적으로 동일합니다. 단, Flash
모델의 지연 시간이 평균적으로 더 낮습니다. 모든 사용 사례에서 Turbo 모델보다 Flash 모델을
사용하는 것을 권장합니다.
Eleven v4
Eleven v4는 최고 품질의 오디오, 풍부한 표현력, 음성 연기에 대한 정밀한 제어를 제공하는 최첨단 음성 합성 모델입니다. Eleven v4는 긴 텍스트 생성에서도 화자 특성을 안정적으로 유지하는 고충실도 음성 복제를 지원합니다.
이 모델은 다음과 같은 시나리오에서 뛰어난 성능을 발휘합니다.
- 캐릭터 보이스오버: 폭넓은 감정 표현력으로 게임과 애니메이션에 적합합니다.
- 감정이 풍부한 대화: 높은 감정 표현 범위와 문맥 이해를 바탕으로 자연스럽고 사실적인 대화를 생성합니다.
- 오디오북 제작: 복잡한 감정 전달이 필요한 장편 내레이션에 완벽합니다.
- 다국어 프로젝트: 언어가 전환되어도 일관된 음성 품질을 유지합니다.
Eleven v4는 Text to Dialogue API를 통해 사용할 수 있습니다.
지원 언어
Eleven v4 모델 제품군은 다음을 포함해 90개 이상의 언어를 지원합니다.
아프리칸스어 (af), 암하라어 (am), 아랍어 (ar), 아르메니아어 (hy), 아삼어 (as), 아스투리아스어 (ast), 아제르바이잔어 (az), 벨라루스어 (be), 벵골어 (bn), 보스니아어 (bs), 불가리아어 (bg), 버마어 (my), 광둥어 (yue), 카탈루냐어 (ca), 세부아노어 (ceb), 크로아티아어 (hr), 체코어 (cs), 덴마크어 (da), 네덜란드어 (nl), 영어 (en), 에스토니아어 (et), 필리핀어 (fil), 핀란드어 (fi), 프랑스어 (fr), 풀라어(풀라르) (ff), 갈리시아어 (gl), 조지아어 (ka), 독일어 (de), 그리스어 (el), 구자라트어 (gu), 하우사어 (ha), 히브리어 (he), 힌디어 (hi), 헝가리어 (hu), 아이슬란드어 (is), 인도네시아어 (id), 이탈리아어 (it), 일본어 (ja), 자바어 (jv), 캄바어 (kam), 칸나다어 (kn), 카자흐어 (kk), 한국어 (ko), 키르기스어 (ky), 라오어 (lo), 라트비아어 (lv), 링갈라어 (ln), 리투아니아어 (lt), 루간다어 (lg), 룩셈부르크어 (lb), 마케도니아어 (mk), 말레이어 (ms), 말라얄람어 (ml), 몰타어 (mt), 중국어 만다린 (zh), 마오리어 (mi), 마라티어 (mr), 몽골어 (mn), 네팔어 (ne), 노르웨이어 (no), 오크어 (oc), 오디아어 (or), 파슈토어 (ps), 페르시아어 (fa), 폴란드어 (pl), 포르투갈어 (pt), 펀자브어 (pa), 루마니아어 (ro), 러시아어 (ru), 세르비아어 (sr), 쇼나어 (sn), 신디어 (sd), 슬로바키아어 (sk), 슬로베니아어 (sl), 소말리어 (so), 소라니 쿠르드어 (ckb), 스페인어 (es), 스와힐리어 (sw), 스웨덴어 (sv), 타지크어 (tg), 타밀어 (ta), 텔루구어 (te), 태국어 (th), 튀르키예어 (tr), 우크라이나어 (uk), 우르두어 (ur), 우즈베크어 (uz), 베트남어 (vi), 웨일스어 (cy), 월로프어 (wo), 줄루어 (zu).
Eleven v4 Turbo
Eleven v4 Turbo는 실시간 음성 합성을 위한 최첨단 모델로, 고품질 오디오와 풍부한 표현력, 음성 연기에 대한 정밀한 제어를 제공합니다. Eleven v4 Turbo는 고충실도 음성 복제를 지원하며 중앙값 지연 시간은 약 100ms입니다. 지연 시간 측정 방법을 확인하세요.
이 모델은 다음과 같은 시나리오에서 뛰어난 성능을 발휘합니다.
- 지원 에이전트: 고객 문의를 실시간으로 해결하는 음성 에이전트를 구현합니다.
- AI 어시스턴트: 높은 감정 표현 범위와 문맥 이해를 바탕으로 자연스럽고 사실적인 대화를 생성합니다.
- 인터랙티브 캐릭터: 표현력이 풍부한 캐릭터를 활용하는 오디오 경험에 탁월합니다.
Eleven v4 Turbo는 Text to Dialogue websocket을 통해 사용할 수 있습니다.
지원 언어
Eleven v4 모델 제품군은 다음을 포함해 90개 이상의 언어를 지원합니다.
아프리칸스어 (af), 암하라어 (am), 아랍어 (ar), 아르메니아어 (hy), 아삼어 (as), 아스투리아스어 (ast), 아제르바이잔어 (az), 벨라루스어 (be), 벵골어 (bn), 보스니아어 (bs), 불가리아어 (bg), 버마어 (my), 광둥어 (yue), 카탈루냐어 (ca), 세부아노어 (ceb), 크로아티아어 (hr), 체코어 (cs), 덴마크어 (da), 네덜란드어 (nl), 영어 (en), 에스토니아어 (et), 필리핀어 (fil), 핀란드어 (fi), 프랑스어 (fr), 풀라어(풀라르) (ff), 갈리시아어 (gl), 조지아어 (ka), 독일어 (de), 그리스어 (el), 구자라트어 (gu), 하우사어 (ha), 히브리어 (he), 힌디어 (hi), 헝가리어 (hu), 아이슬란드어 (is), 인도네시아어 (id), 이탈리아어 (it), 일본어 (ja), 자바어 (jv), 캄바어 (kam), 칸나다어 (kn), 카자흐어 (kk), 한국어 (ko), 키르기스어 (ky), 라오어 (lo), 라트비아어 (lv), 링갈라어 (ln), 리투아니아어 (lt), 루간다어 (lg), 룩셈부르크어 (lb), 마케도니아어 (mk), 말레이어 (ms), 말라얄람어 (ml), 몰타어 (mt), 중국어 만다린 (zh), 마오리어 (mi), 마라티어 (mr), 몽골어 (mn), 네팔어 (ne), 노르웨이어 (no), 오크어 (oc), 오디아어 (or), 파슈토어 (ps), 페르시아어 (fa), 폴란드어 (pl), 포르투갈어 (pt), 펀자브어 (pa), 루마니아어 (ro), 러시아어 (ru), 세르비아어 (sr), 쇼나어 (sn), 신디어 (sd), 슬로바키아어 (sk), 슬로베니아어 (sl), 소말리어 (so), 소라니 쿠르드어 (ckb), 스페인어 (es), 스와힐리어 (sw), 스웨덴어 (sv), 타지크어 (tg), 타밀어 (ta), 텔루구어 (te), 태국어 (th), 튀르키예어 (tr), 우크라이나어 (uk), 우르두어 (ur), 우즈베크어 (uz), 베트남어 (vi), 웨일스어 (cy), 월로프어 (wo), 줄루어 (zu).
Eleven v3
Eleven v3는 여러 언어에서 폭넓은 감정 표현과 문맥 이해를 바탕으로 자연스럽고 사실적인 음성을 생성하는 이전 세대 음성 합성 모델입니다.
Eleven v3와 함께 제공되는 새로운 Text to Dialogue API를 사용하면 여러 언어에서 폭넓은 감정 표현과 문맥 이해를 바탕으로 자연스럽고 사실적인 대화를 생성할 수 있습니다. Eleven v3는 Text to Speech API와 함께 사용하여 여러 언어에서 폭넓은 감정 표현과 문맥 이해를 바탕으로 자연스럽고 사실적인 음성을 생성할 수도 있습니다.
Text to Dialogue API에 관한 자세한 내용은 여기에서 확인하세요.
지원 언어
Eleven v3 모델은 다음을 포함해 70개 이상의 언어를 지원합니다:
아프리칸스어(af), 아랍어(ar), 아르메니아어(hy), 아삼어(as), 아스투리아스어(ast), 아제르바이잔어(az), 벨라루스어(be), 벵골어(bn), 보스니아어(bs), 불가리아어(bg), 버마어(my), 광둥어(yue), 카탈루냐어(ca), 세부아노어(ceb), 치체와어(ny), 크로아티아어(hr), 체코어(cs), 덴마크어(da), 네덜란드어(nl), 영어(en), 에스토니아어(et), 필리핀어(fil), 핀란드어(fi), 프랑스어(fr), 갈리시아어(gl), 조지아어(ka), 독일어(de), 그리스어(el), 구자라트어(gu), 하우사어(ha), 히브리어(he), 힌디어(hi), 헝가리어(hu), 아이슬란드어(is), 인도네시아어(id), 아일랜드어(ga), 이탈리아어(it), 일본어(ja), 자바어(jv), 칸나다어(kn), 카자흐어(kk), 키르기스어(ky), 한국어(ko), 라트비아어(lv), 링갈라어(ln), 리투아니아어(lt), 룩셈부르크어(lb), 마케도니아어(mk), 말레이어(ms), 말라얄람어(ml), 몰타어(mt), 중국어(만다린)(zh), 마오리어(mi), 마라티어(mr), 몽골어(mn), 네팔어(ne), 노르웨이어(no), 오크어(oc), 오디아어(or), 파슈토어(ps), 페르시아어(fa), 폴란드어(pl), 포르투갈어(pt), 펀자브어(pa), 루마니아어(ro), 러시아어(ru), 세르비아어(sr), 신디어(sd), 슬로바키아어(sk), 슬로베니아어(sl), 소말리어(so), 스페인어(es), 스와힐리어(sw), 스웨덴어(sv), 타지크어(tg), 타밀어(ta), 텔루구어(te), 태국어(th), 터키어(tr), 우크라이나어(uk), 우르두어(ur), 우즈베크어(uz), 베트남어(vi), 웨일스어(cy), 요루바어(yo).
Eleven v3 Conversational
Eleven v3 Conversational은 실시간 음성 합성을 위한 이전 세대 모델입니다. 여러 언어에서 폭넓은 감정 표현과 문맥 이해를 바탕으로 자연스럽고 사실적인 음성을 생성합니다.
Eleven v3 Conversational과 함께 제공되는 새로운 Text to Dialogue WebSocket을 사용하면 여러 언어에서 폭넓은 감정 표현과 문맥 이해를 바탕으로 자연스럽고 사실적인 대화를 생성할 수 있습니다.
Eleven v3 Conversational과 함께 제공되는 새로운 Text to Dialogue WebSocket을 사용하면 여러 언어에서 폭넓은 감정 표현과 문맥 이해를 바탕으로 자연스럽고 사실적인 대화를 생성할 수 있습니다.
Text to Dialogue WebSocket에 관한 자세한 내용은 여기에서 확인하세요.
지원 언어
Eleven v3 모델은 다음을 포함해 70개 이상의 언어를 지원합니다:
아프리칸스어(af), 아랍어(ar), 아르메니아어(hy), 아삼어(as), 아스투리아스어(ast), 아제르바이잔어(az), 벨라루스어(be), 벵골어(bn), 보스니아어(bs), 불가리아어(bg), 버마어(my), 광둥어(yue), 카탈루냐어(ca), 세부아노어(ceb), 치체와어(ny), 크로아티아어(hr), 체코어(cs), 덴마크어(da), 네덜란드어(nl), 영어(en), 에스토니아어(et), 필리핀어(fil), 핀란드어(fi), 프랑스어(fr), 갈리시아어(gl), 조지아어(ka), 독일어(de), 그리스어(el), 구자라트어(gu), 하우사어(ha), 히브리어(he), 힌디어(hi), 헝가리어(hu), 아이슬란드어(is), 인도네시아어(id), 아일랜드어(ga), 이탈리아어(it), 일본어(ja), 자바어(jv), 칸나다어(kn), 카자흐어(kk), 키르기스어(ky), 한국어(ko), 라트비아어(lv), 링갈라어(ln), 리투아니아어(lt), 룩셈부르크어(lb), 마케도니아어(mk), 말레이어(ms), 말라얄람어(ml), 몰타어(mt), 중국어(만다린)(zh), 마오리어(mi), 마라티어(mr), 몽골어(mn), 네팔어(ne), 노르웨이어(no), 오크어(oc), 오디아어(or), 파슈토어(ps), 페르시아어(fa), 폴란드어(pl), 포르투갈어(pt), 펀자브어(pa), 루마니아어(ro), 러시아어(ru), 세르비아어(sr), 신디어(sd), 슬로바키아어(sk), 슬로베니아어(sl), 소말리어(so), 스페인어(es), 스와힐리어(sw), 스웨덴어(sv), 타지크어(tg), 타밀어(ta), 텔루구어(te), 태국어(th), 터키어(tr), 우크라이나어(uk), 우르두어(ur), 우즈베크어(uz), 베트남어(vi), 웨일스어(cy), 요루바어(yo).
Multilingual v2
Eleven Multilingual v2는 이전 세대의 감정 인식 음성 합성 모델입니다. 여러 언어에서 폭넓은 감정 표현과 문맥 이해를 바탕으로 자연스럽고 사실적인 음성을 생성합니다.
이 모델은 화자의 고유한 특성과 억양을 유지하면서 지원되는 모든 언어에서 일관된 음성 품질과 개성을 제공합니다.
이 모델은 고품질의 미묘한 감정 표현이 필요한 시나리오에서 뛰어난 성능을 발휘합니다.
- 캐릭터 보이스오버: 폭넓은 감정 표현력으로 게임과 애니메이션에 적합합니다.
- 전문 콘텐츠: 기업 비디오와 e-러닝 자료에 적합합니다.
- 다국어 프로젝트: 언어가 전환되어도 일관된 음성 품질을 유지합니다.
- 안정적인 품질: 일관된 고품질 오디오 출력을 제공합니다.
Flash 모델보다 문자당 지연 시간과 비용은 높지만, 사실적인 음성이 중요한 프로젝트에서는 더 뛰어난 품질을 제공합니다.
다국어 v2 모델은 29개 언어를 지원합니다.
영어(미국, 영국, 호주, 캐나다), 일본어, 중국어, 독일어, 힌디어, 프랑스어(프랑스, 캐나다), 한국어, 포르투갈어(브라질, 포르투갈), 이탈리아어, 스페인어(스페인, 멕시코), 인도네시아어, 네덜란드어, 터키어, 필리핀어, 폴란드어, 스웨덴어, 불가리아어, 루마니아어, 아랍어(사우디아라비아, UAE), 체코어, 그리스어, 핀란드어, 크로아티아어, 말레이어, 슬로바키아어, 덴마크어, 타밀어, 우크라이나어 및 러시아어.
Flash v2.5
Eleven Flash v2.5는 실시간 애플리케이션과 Agents Platform을 위해 설계된 저지연 음성 합성 모델입니다. 32개 언어에서 약 100ms†의 중앙값 지연 시간으로 고품질 음성을 제공합니다.
이 모델은 속도와 품질의 균형을 맞춰 자연스러운 출력과 언어 간 일관된 음성 특성을 유지하면서 인터랙티브 애플리케이션에 이상적입니다.
이 모델은 특히 다음 용도에 적합합니다.
- Agents Platform: 실시간 음성 에이전트와 챗봇에 완벽합니다.
- 인터랙티브 애플리케이션: 즉각적인 응답이 필요한 게임과 애플리케이션에 적합합니다.
- 대규모 처리: 대량의 텍스트 음성 변환을 효율적으로 처리합니다.
API 생성에 대한 더 낮은 가격과 낮은 지연 시간을 갖춘 Flash v2.5는 여러 언어에서 빠르고 안정적인 음성 합성이 필요한 모든 사용자에게 비용 효율적인 선택지입니다.
Flash v2.5는 v2 모델의 모든 언어와 다음 언어를 포함해 32개 언어를 지원합니다.
헝가리어, 노르웨이어 및 베트남어
† 애플리케이션 및 네트워크 지연 시간을 제외한 중앙값입니다. 지연 시간 측정 방법을 확인하세요.
고려 사항
숫자 텍스트 정규화
Flash v2.5를 사용할 때 숫자는 예상하는 방식으로 기본 정규화되지 않습니다. 예를 들어 전화번호가 사용자에게 명확하지 않은 방식으로 읽힐 수 있습니다. 날짜와 통화도 비슷한 영향을 받습니다.
낮은 지연 시간을 유지하기 위해 Flash v2.5에서는 기본적으로 정규화가 비활성화되어 있습니다. 하지만 이제 엔터프라이즈 고객은 요청에서 apply_text_normalization 매개변수를 “on”으로 설정하여 v2.5 모델의 텍스트 정규화를 활성화할 수 있습니다.
Multilingual v2 모델은 숫자 정규화를 더 잘 처리하므로, 전화번호 및 숫자 정규화가 중요한 기타 경우에는 이 모델을 사용하는 것이 좋습니다.
저지연 또는 Agents Platform 애플리케이션의 모범 사례는 TTS 모델에 전달하기 전에 LLM이 텍스트를 정규화하도록 하거나, apply_text_normalization 매개변수를 사용하는 것입니다(v2.5 모델에서는 엔터프라이즈 요금제에만 해당).
모델 선택 가이드
요구사항과 사용 사례에 가장 적합한 모델에 대한 안내는 모델 선택 가이드를 참고하세요.
요구사항
사용 사례
문자 수 제한
단일 텍스트 음성 변환 요청에서 지원되는 최대 문자 수는 모델마다 다릅니다.
Scribe v3
Scribe v3는 녹음된 오디오를 위한 가장 정확한 음성 인식 모델입니다. Scribe v2의 후속 모델이며, 동일한 음성 텍스트 변환 API(POST /v1/speech-to-text)를 사용합니다. model_id로 scribe_v3를 전달하세요.
이 모델은 다음 용도에 적합합니다.
- 회의 및 메모 도구: 녹음된 회의와 통화의 화자 라벨이 포함된 트랜스크립트
- 미디어: 화자 라벨 및 단어 단위 타임스탬프가 포함된 자막과 캡션
- 교육: 억양이 있거나 여러 언어가 혼합된 음성이 포함된 녹화 강의
- 컨택 센터: 품질 보증 및 분석을 위한 녹음 통화
Scribe v2와 비교했을 때 Scribe v3는 다음을 제공합니다.
- 더 적은 전사 오류. 102개 언어에 걸친 FLEURS 벤치마크에서 Scribe v3는 단어 오류율(WER)을 16.94%에서 12.38%로 낮춰 Scribe v2보다 단어 오류가 27% 적으며, 테스트한 모든 언어에서 개선되었습니다.
- 다중 화자 오디오에서 더 정확한 화자 라벨.
- 숫자를 숫자(
42) 또는 단어(forty-two)로 표기하는numbers_format파라미터. - 혼합 언어 오디오의 정확도를 높이기 위해
language_code와 함께 오디오에 포함될 것으로 예상되는 다른 언어를 나열하는secondary_language_codes파라미터.
새 파라미터 사용 방법은 숫자 및 언어 옵션을 참고하세요.
ElevenLabs는 클립별로 FLEURS WER을 계산한 후 언어별 평균을 냅니다. 따라서 일반적으로 공개되는 코퍼스 수준 WER보다 높은 수치가 나오므로, 다른 방식으로 계산한 결과와는 비교할 수 없습니다.
Scribe v3는 Scribe v2의 기능 세트를 유지합니다.
- 90개 이상의 언어 지원
- 최대 32명의 화자를 위한 화자 분리
- 단어 단위 또는 문자 단위 타임스탬프
- 오디오 이벤트 태깅
- 최대 1,000개 용어의 키텀 프롬프팅
- 엔터티 감지
- 트랜스크립트 편집
- 축어 모드 미지원
- SRT, DOCX, PDF 등 추가 형식으로 내보내기
- 비동기 결과를 위한 웹훅
Scribe v2에서 업그레이드
model_id를 scribe_v2에서 scribe_v3로 변경하세요. 기존 요청 파라미터는 변경 없이 작동합니다. Scribe v2도 계속 사용할 수 있습니다.
Scribe v3 Live
Scribe v3 Live는 가장 정확한 실시간 음성 인식 모델입니다. Scribe v2 Realtime의 후속 모델이며, 동일한 실시간 WebSocket(wss://api.elevenlabs.io/v1/speech-to-text/realtime)을 사용합니다. model_id 쿼리 파라미터로 scribe_v3_live를 전달하세요.
Scribe v3 Live는 음성 텍스트 변환 모델입니다. 음성 에이전트를 위한 음성 변환 모델인 Eleven Realtime과는 별개입니다.
이 모델은 다음 용도에 적합합니다.
- 음성 에이전트 및 컨택 센터: 첫 번째 침묵이 아닌 통화자가 말을 마쳤을 때 턴 확정
- 실시간 캡션: 단어 단위 타임스탬프를 포함한 실시간 트랜스크립트
- 교육 및 언어 학습: 억양이 있는 화자 및 언어를 전환하는 화자
- 받아쓰기 및 어시스턴트: 키텀을 통한 도메인 어휘
Scribe v2 Realtime과 비교했을 때 Scribe v3 Live는 다음을 제공합니다.
- 더 적은 전사 오류. 73개 언어에 걸친 FLEURS 벤치마크에서 Scribe v3 Live는 Scribe v2 Realtime보다 의미론적 WER이 44% 낮습니다. Earnings-22(억양이 있는 영어 금융 통화)에서는 WER이 5.99%에서 3.91%로, VoxPopuli(유럽 의회 연설)에서는 2.13%에서 1.71%로 감소합니다.
- 턴 예측.
commit_strategy=turn_prediction을 사용하면 서버는 침묵만 기다리지 않고 모델이 화자의 턴이 끝났다고 예측할 때 세그먼트를 확정합니다. - 다국어 모드.
multilang_mode=true를 사용하면 문장 중간의 언어 전환을 포함해 각 언어가 고유 문자 체계로 전사됩니다. - 표준 키텀 50개에 더해, 모델이 일치 가능성이 높은 내용을 들을 때만 사용하는 최대 10,000개 용어의 키텀 라이브러리.
- 실시간 화자 분리.
diarize=true를 사용하면 부분 트랜스크립트에 초안 화자 라벨이 표시되며, 확정된 텍스트를 지연하지 않고 각 확정 트랜스크립트 뒤에 별도의 화자 분리 트랜스크립트가 제공됩니다.
Scribe v3 Live는 Scribe v2 Realtime의 기능 세트를 유지합니다.
- 자동 언어 감지를 포함한 90개 이상의 언어 지원
- 스트리밍 지원: 실시간으로 트랜스크립트를 받으면서 청크 단위로 오디오 전송
- 여러 오디오 형식: PCM(8kHz~48kHz) 및 μ-law 인코딩
- 수동 및 음성 활동 감지(VAD) 확정 전략
- 단어 단위 타임스탬프
- 언어 감지를 특정 언어 집합으로 제한하는
secondary_languages - 최대 50개 용어의 키텀 프롬프팅
- 엔터티 감지
- 트랜스크립트 편집
- 배경 오디오 필터링
Scribe v2 Realtime에서 업그레이드
model_id를 scribe_v2_realtime에서 scribe_v3_live로 변경하세요. 기본 확정 전략은 여전히 manual이므로, commit_strategy를 turn_prediction으로 설정하기 전까지 기존 통합은 동일하게 작동합니다. Scribe v2 Realtime도 계속 사용할 수 있습니다.
공식 SDK는 아직 턴 예측, 다국어 모드 또는 키텀 라이브러리를 지원하지 않습니다. 이를 사용하려면 WebSocket API에 직접 연결하세요.
Scribe v2
Scribe v2는 Scribe v3로 대체된 이전 세대 최고 수준의 음성 인식 모델입니다. 90개 이상의 언어에서 정확한 전사를 제공하도록 설계되었습니다. 정밀한 단어 단위 타임스탬프와 화자 분리, 동적 오디오 태깅 같은 고급 기능을 제공합니다.
이 모델은 정확한 음성 텍스트 변환이 필요한 상황에서 뛰어난 성능을 발휘합니다.
- 전사 서비스: 오디오/비디오 콘텐츠를 텍스트로 변환하는 데 완벽함
- 회의 문서화: 대화를 캡처하고 문서화하는 데 적합함
- 콘텐츠 분석: 오디오 콘텐츠 처리 및 분석에 적합함
- 다국어 인식: 90개 이상의 언어에서 정확한 전사 지원
주요 기능:
- 단어 단위 타임스탬프를 포함한 정확한 전사
- 다중 화자 오디오를 위한 화자 분리
- 향상된 맥락을 위한 동적 오디오 태깅
- 90개 이상의 언어 지원
- 엔터티 감지
- 키텀 프롬프팅
- 트랜스크립트 편집
Scribe v2에 관한 자세한 내용은 여기에서 확인하세요.
Scribe v2 Realtime
Scribe v2 Realtime은 Scribe v3 Live로 대체된 이전 세대 최고 수준의 실시간 음성 인식 모델입니다. 90개 이상의 언어를 전사하며, 트랜스크립트 확정까지의 중앙값 시간은 약 150ms입니다. 지연 시간 측정 방식을 참고하세요.
이 모델은 대화형 사용 사례에서 뛰어난 성능을 발휘합니다.
- 실시간 회의 전사: 실시간 전사에 완벽함
- AI 에이전트: 실시간 대화에 적합함
- 다국어 인식: 자동 언어 인식과 함께 90개 이상의 언어에서 정확한 전사 지원
주요 기능:
- 초저지연: 중앙값 약 150밀리초의 지연 시간으로 확정된 트랜스크립트 제공
- 스트리밍 지원: 실시간으로 트랜스크립트를 받으면서 청크 단위로 오디오 전송
- 여러 오디오 형식: PCM(8kHz~48kHz) 및 μ-law 인코딩 지원
- 음성 활동 감지(VAD): 침묵 감지에 기반한 자동 음성 세분화
- 수동 확정 제어: 트랜스크립트 세그먼트를 최종 확정하는 시점을 완전히 제어
- 엔터티 감지
- 엔터티 마스킹
- 트랜스크립트 편집
Scribe v2 Realtime에 관한 자세한 내용은 여기에서 확인하세요.
Scribe v2 Medical
Scribe v2 Medical은 의료 및 임상 오디오에 특화된 배치 음성 인식 모델입니다. Scribe v2를 Finetune한 모델로, 일상 음성에서는 Scribe v2와 동일한 정확도를 유지하면서 약물명, 해부학, 병리학 및 임상 받아쓰기 인식 성능을 개선합니다. Scribe v2와 동일한 음성 텍스트 변환 API를 사용하며 동일한 요금이 적용됩니다. model_id로 scribe_v2_medical을 전달하세요.
사용 목적
Scribe v2 Medical은 개발자와 조직이 임상의와 환자의 대화, 받아쓰기, 접수 및 진료 조정 통화를 포함한 임상 오디오를 문서화 및 관련 관리 워크플로를 위한 초안 트랜스크립트로 변환하는 애플리케이션에 통합할 수 있도록 제공되는 배치 음성 텍스트 변환 API 모델입니다. 생성된 텍스트는 사용 전에 의료 전문가 또는 기타 권한 있는 사용자가 검토하고 수정해야 합니다. Scribe v2 Medical은 임상 정보를 해석하거나 진단, 치료 권고, 임상 결정 또는 기타 임상 지침을 제공하기 위한 용도가 아닙니다.
이 모델은 다음 용도에 적합합니다.
- 임상 문서화: 대화 중간에 의학 용어가 등장하는 주변 환경 진료 및 메모
- 받아쓰기: 약물, 용량 및 소견이 밀도 높게 이어지는 내용
- 접수 및 조정 통화: 주로 전화로 자신의 상태를 설명하는 환자
- 규정 준수 워크플로: PHI 범주를 위해 엔터티 감지와 결합
주요 기능:
- Scribe v2와 동일한 요청 형식(
keyterms,entity_detection,no_verbatim, 화자 분리, 타임스탬프) - 약물명, 해부학 및 병리학 용어 인식 개선
- Scribe v2 대비 일상 음성 성능 저하 없음
- 90개 이상의 언어 지원
- 다중 화자 오디오를 위한 화자 분리
- 동적 오디오 태깅
- PHI 범주를 포함한 엔터티 감지
Scribe v2 Medical은 배치 모델입니다. 실시간 전사에는 Scribe v2 Realtime을 사용하세요.
Scribe v2 Medical은 HIPAA 적용 대상이며, 엔터프라이즈 고객에게는 비즈니스 제휴 계약(Business Associate Agreement)과 제로 보존 모드(ZRM)를 제공합니다. ZRM을 활성화하면 각 요청이 완료된 직후 오디오 입력과 텍스트 출력이 삭제됩니다. ElevenLabs는 아무것도 보관하지 않으며, 애플리케이션은 전체 API 응답을 수신하고 자체 관리하에 트랜스크립트를 보관합니다.
HIPAA 준수가 필요한 회사는 보호 대상 건강 정보를 전송하기 전에 비즈니스 제휴 계약(BAA)을 체결하기 위해 ElevenLabs 영업팀에 문의해야 합니다.
음성 텍스트 변환에 관한 자세한 내용은 여기에서 확인하세요.
SFX v3
SFX v3(eleven_text_to_sound_v3)는 최신 음향 효과 모델입니다. eleven_text_to_sound_v2와 동일한 음향 효과 API를 사용합니다. 사용하려면 model_id를 eleven_text_to_sound_v3로 설정하세요. eleven_text_to_sound_v2는 여전히 기본값이지만 지원 중단되었으며 2027년 3월 1일에 제거됩니다.
eleven_text_to_sound_v2와 비교했을 때 SFX v3는 다음과 같습니다.
- “Football crowd cheering, hearing a ball drop, crowd booing”처럼 하나의 프롬프트에 포함된 여러 지시 사항을 따릅니다.
- “Gospel choir singing hello”처럼 음악이나 보컬이 포함된 프롬프트를 처리합니다.
- 더 자연스러운 결과를 생성합니다.
- 징, 차임, 휘슬 같은 고주파 사운드에서 클리핑이 발생할 가능성이 더 낮습니다.
결과는 프롬프트에 따라 다르므로 전환하기 전에 자체 프롬프트로 두 모델을 모두 비교하세요.
SFX v3는 루프를 지원합니다. 부드럽게 반복되는 음향 효과를 생성하려면 loop를 true로 설정하세요.
ElevenCreative에서 SFX v3는 음향 효과, Flows 및 Studio에서 사용할 수 있습니다.
음향 효과에 관한 자세한 내용은 여기에서 확인하세요.
Eleven Realtime
Eleven Realtime은 자연스러운 음성 에이전트를 구축하기 위한 새로운 종류의 음성 변환 모델입니다. 각 Realtime 모델은 완전한 음성 에이전트입니다. 음성 인식, 음성 활동 감지 및 턴테이킹, LLM, 텍스트 음성 변환이 하나의 시스템으로 함께 작동하도록 ElevenLabs가 선택하고 조정했습니다. Realtime 모델을 선택하면 구성할 컴포넌트 없이 단 한 번의 선택만으로 우수한 성능의 에이전트를 얻을 수 있습니다.
두 가지 Realtime 모델을 사용할 수 있습니다.
Eleven Realtime v1 Mini는 빠르고 자연스러운 대화에 최적화되어 있으며 다음과 같은 시나리오에 적합합니다.
- AI 어시스턴트: 대화 자체가 제품인 빠르고 풍부한 표현의 대화.
- 교육 튜터: 학습자의 속도에 맞춰 자연스럽게 주고받는 대화.
- 인터랙티브 캐릭터: 게임 및 엔터테인먼트를 위한 표현력 있는 캐릭터.
Eleven Realtime v1 Max는 복잡한 작업에 최적화되어 있으며 다음과 같은 시나리오에 적합합니다.
- 고객 지원: 프로세스를 따르고 정보를 조회해야 하는 문의 해결.
- 리드 검증: 정보를 수집하고 다음 단계를 결정하는 구조화된 대화.
- 다단계 워크플로: 도구를 호출해 정보를 조회하거나 작업을 수행하는 작업.
주요 기능:
- 하나의 모델 선택으로 음성 인식, 턴테이킹, 언어 모델 및 음성 제공
- 자연스러운 턴테이킹 및 인터럽트 처리
- 도구 호출
- ElevenLabs 보이스 라이브러리의 맞춤형 음성
- 90개 이상의 언어 지원
- 통합 변경 없이 모델 선택으로 v1 Mini와 v1 Max 간 전환
Eleven Realtime은 모델 드롭다운에서 Realtime 모델을 선택할 수 있는 ElevenAgents 및 WebSocket을 통해 OpenAI의 Realtime API와 호환되도록 설계된 Realtime API에서 사용할 수 있습니다. 이미 OpenAI의 Realtime API를 사용하고 있다면 마이그레이션 가이드를 참고하세요.
지원 언어
Realtime 모델은 90개 이상의 언어를 지원합니다. Eleven v4 언어 목록을 참고하세요.
Eleven Realtime에 관한 자세한 내용은 여기에서 확인하세요.
Eleven Music
Eleven Music은 스튜디오급 음악 생성 모델입니다. 자연어 프롬프트를 사용해 어떤 스타일이든 음악을 생성할 수 있습니다.
이 모델은 다음과 같은 시나리오에 탁월합니다.
- 게임 사운드트랙: 게임을 위한 몰입감 있는 사운드트랙 제작
- 팟캐스트 배경음: 전문적인 음악으로 팟캐스트 향상
- 마케팅: 광고 릴에 배경 음악 추가
주요 기능:
- 장르, 스타일 및 구조를 완벽하게 제어
- 보컬 또는 연주곡만 선택
- 영어, 스페인어, 독일어, 일본어 등을 포함한 다국어 지원
- 개별 섹션 또는 전체 곡의 사운드와 가사 편집
Eleven Music에 관한 자세한 내용은 여기에서 확인하세요.
동시성 및 우선순위
구독 플랜에 따라 동시에 처리할 수 있는 요청 수와 대기열에서 요청의 우선순위가 결정됩니다. 음성-텍스트 변환은 더 높은 동시성 한도가 적용됩니다. 동시성 한도에 도달하면 이후 요청은 우선순위가 낮은 요청과 함께 대기열에서 처리됩니다. 일반적으로 이로 인해 약 50ms의 지연 시간만 추가됩니다.
트래픽에 필요한 동시성 한도를 추정하려면 동시성 추정기를 사용하세요.
응답 헤더에는 동시성을 모니터링하는 데 사용할 수 있는 current-concurrent-requests 및 maximum-concurrent-requests가 포함됩니다.
분당 API 요청 수와 동시 요청 수
분당 API 요청 수와 동시 요청 수는 사용 패턴에 따라 달라지는 서로 다른 지표라는 점을 이해하는 것이 중요합니다.
분당 API 요청 수는 각 요청의 소요 시간과 요청이 일괄 처리되는 방식에 따라 동시 요청 수와 다를 수 있습니다.
예시 1: 간격을 둔 요청 각각 완료하는 데 1초가 걸리는 분당 180개의 요청을 0.33초 간격으로 보냈다면, 항상 3개의 요청이 진행 중이므로 최대 동시 요청 수와 평균은 모두 3입니다.
예시 2: 일괄 요청 반면 각각 완료하는 데 3초가 걸리는 분당 180개의 요청을 모두 한 번에 실행하는 등 다른 사용 패턴이라면, 최대 동시 요청 수는 180이고 평균은 9입니다(처음 3초 동안은 한 번에 180개의 요청이 있었고, 마지막 57초 동안은 요청이 0개였습니다).
시스템은 동시성을 기준으로 하므로, 분당 요청 수보다 각 요청에 걸리는 시간과 요청이 전송되는 패턴이 더 중요합니다.
엔드포인트 요청 방식은 동시성 한도에 영향을 줍니다.
- HTTP에서는 각 요청이 동시성 한도에 개별적으로 포함됩니다.
- 텍스트 음성 변환 WebSocket에서는 모델이 오디오를 생성하는 시간만 동시성 한도에 포함됩니다. 즉, 대부분의 경우 열린 websocket은 동시성 한도에 전혀 포함되지 않습니다.
- 텍스트-대화 WebSocket은 다르게 작동합니다. 열린 연결마다 열려 있는 동안 별도 풀에서 대화 세션 하나를 예약하며, 연결을 통해 생성된 오디오는 표준 동시성 한도에 포함되지 않습니다. 연결 하나가 세션 하나이므로 이해하기 쉽도록 설계되었으며, 이 새로운 동시성 방식에 맞춰 대화 세션 한도가 조정됩니다. 텍스트-대화 동시성을 참조하세요.
동시성 한도 이해하기
플랜에 연결된 동시성 한도를 동시에 처리할 수 있는 대화, 전화 통화, 캐릭터 보이스오버 등의 최대 수로 해석해서는 안 됩니다. 실제 수는 사용되는 특정 AI 음성과 사용 사례의 특성을 비롯한 여러 요인에 따라 달라집니다.
일반적으로 동시성 한도 5는 약 100개의 동시 오디오 방송을 지원할 수 있습니다.
이는 TTS 요청 처리 시간에 비해 오디오 생성 속도가 빠르기 때문입니다. 아래 다이어그램은 서로 다른 사용자와의 동시 통화 4개를 지원하면서 동시 요청은 2개만 사용하는 예시입니다.
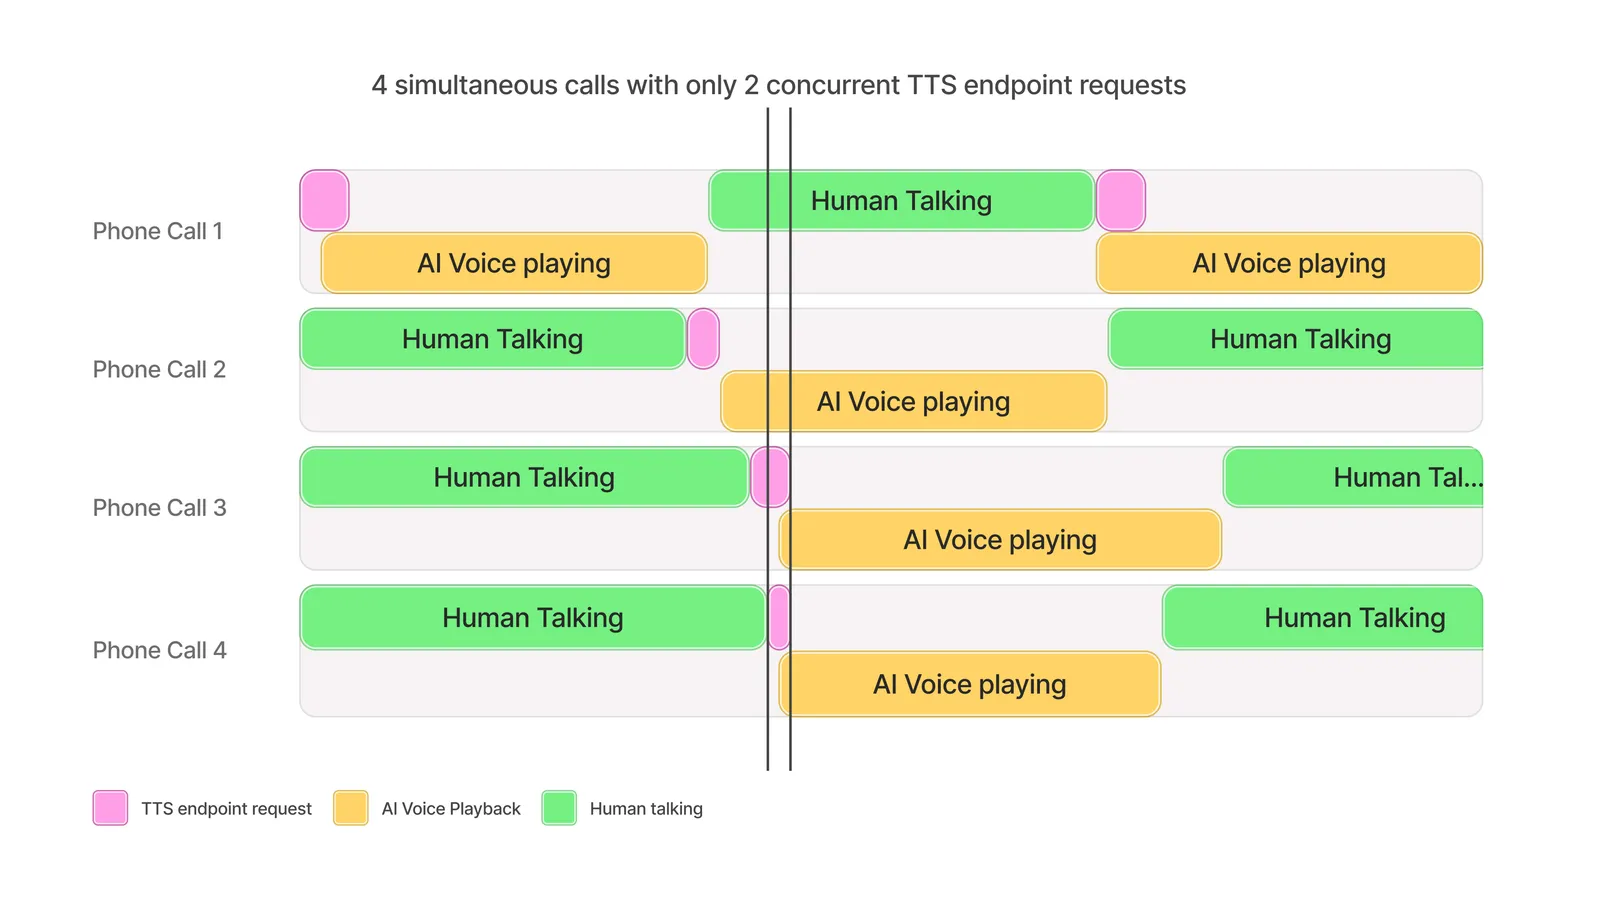
AI 음성 에이전트 구축
TTS를 사용해 대화를 지원하는 경우, 동시성 한도 5는 AI 에이전트와 사람 참여자 간의 균형 잡힌 대화를 위한 약 100개의 방송을 지원할 수 있습니다.
고객 지원 상호작용처럼 AI 에이전트가 사람보다 덜 자주 말하는 사용 사례에서는 100개 이상의 동시 대화를 지원할 수 있습니다.
캐릭터 보이스오버
일반적으로 동시성 한도 5로 100개 이상의 동시 캐릭터 보이스오버를 지원할 수 있습니다.
이 수는 캐릭터의 대화 빈도, 멈춤 길이, 대사 사이의 게임 내 행동에 따라 달라질 수 있습니다.
라이브 더빙
동시 더빙 스트림은 일반적으로 제공된 경험칙을 따릅니다.
방송에 대화가 멈추는 구간(예: 사운드트랙, 시각적 장면 등으로 인한 구간)이 포함된 경우, 제안 수치보다 더 많은 동시 더빙 스트림이 가능할 수 있습니다.
언제든 플랜의 동시성 한도를 초과했고 엔터프라이즈 플랜을 사용 중인 경우, 사용 가능한 용량에 따라 최선의 노력 기준으로 모델 요청이 더 느리게라도 성공할 수 있습니다.
동시성 한도와 대기열 우선순위를 높이려면 구독 플랜을 업그레이드하세요.
엔터프라이즈 고객은 계정 관리자에게 문의하여 더 높은 동시성 한도를 요청할 수 있습니다.
텍스트-대화 동시성
텍스트-대화 요청은 API 호출 방식에 따라 두 가지 방식으로 측정됩니다.
- HTTP 엔드포인트(대화 생성 및 대화 스트리밍)는 다른 텍스트 음성 변환 요청과 마찬가지로 오디오가 생성되는 동안 플랜의 표준 동시성 한도에 포함됩니다.
- 텍스트-대화 WebSocket과 같은 WebSocket 엔드포인트는 대화 세션으로 측정됩니다. 오디오가 현재 생성 중인지와 관계없이 열린 연결은 열려 있는 동안 대화 세션을 점유합니다.
세션 기반 측정은 용량 계획을 간단하게 만듭니다. 연결 하나가 세션 하나이므로 생성 활동에 따라 사용량이 변동하지 않습니다. 오디오 생성 중인 경우에만이 아니라 전체 연결 기간 동안 세션이 점유되므로, 이 새로운 동시성 방식에 맞춰 대화 세션 한도가 조정됩니다.
워크스페이스의 모든 대화 세션을 사용 중일 때 연결을 열면 새 연결은 too_many_concurrent_requests 오류와 함께 거부됩니다. 세션을 확보하려면 더 이상 필요하지 않은 연결을 닫으세요. keep_alive 메시지를 보내지 않으면 연결은 20초간 비활성 상태 후 자동으로 닫힙니다.
대화 세션을 모니터링하려면 대시보드 사이드바 하단에서 개발자를 열고 분석 탭을 선택한 뒤 사용량 보기에서 동시 요청 지표를 확인하세요. 대화 세션은 다른 동시 요청과 분리되어 TTD Websocket Sessions라는 별도 시리즈로 보고됩니다.
동시성 한도 스케일 테스트
스케일 테스트는 클라이언트 측 확장 문제를 파악하고 사용 사례에 맞게 동시성 한도가 올바르게 설정되었는지 검증하는 데 유용합니다.
실제 사용 환경과 최대한 가깝게 엔드투엔드 workflow를 테스트하는 것을 강력히 권장합니다. 이를 위해 지원 가능한 사용자 수를 시뮬레이션하고 측정하는 방법을 권장합니다. 다음 사항이 중요합니다.
- 원시 요청이 아닌 사용자를 시뮬레이션합니다.
- 요청 전 오디오 재생, 사용자 발화 또는 전사가 끝날 때까지 기다리는 등 일반적인 사용자 행동을 시뮬레이션합니다.
- 몇 분에 걸쳐 사용자 수를 천천히 늘립니다.
- 요청 타이밍과 요청 크기에 무작위성을 추가합니다.
- API의 지연 시간 지표와 반환된 모든 오류 코드를 수집합니다.
예를 들어 100개의 동시 대화를 지원하도록 설계된 에이전트 시스템을 테스트하려면, 각각 대화를 시뮬레이션하는 개별 “사용자”를 최대 100명 생성합니다. 대화는 일반적으로 약 10초간의 사용자 발화, 약 150자에 대한 TTS API 호출, 약 10초간의 사용자 오디오 재생이 반복되는 주기로 구성됩니다. 따라서 각 사용자는 20초마다 150자 텍스트에 대한 websocket 텍스트 음성 변환 API 호출을 수행해야 하며, 대기 시간과 요청 문자 수에 약간의 무작위성을 추가해야 합니다. 테스트는 사용자가 100명이 될 때까지 초당 한 명의 사용자를 생성한 다음, 전반적인 안정성을 테스트하기 위해 총 10분간 실행합니다.
스케일 테스트 스크립트 예시
이 예시는 ElevenLabs API를 직접 호출하는 테스트 프레임워크로 locust를 사용합니다.
위에 제시된 예시를 따라, 각 사용자가 20초마다 요청 1개를 보내는 대화형 에이전트 시스템을 테스트합니다.