

Modelle
Flaggschiffmodelle
Text to Speech
Speech to Text
Sprachagenten
Musik
Modellübersicht
Die ElevenLabs API bietet eine Reihe von Audiomodellen, die für unterschiedliche Anwendungsfälle, Qualitätsstufen und Leistungsanforderungen optimiert sind.
† Median, ohne Anwendungs- und Netzwerklatenz. Siehe wie Latenz gemessen wird.
Veraltete Modelle
Das Modell music_v1 ist veraltet und wird am 31. Januar 2027 entfernt. Das
Modell eleven_text_to_sound_v2 ist veraltet und wird am 1. März 2027 entfernt. Bitte
migrieren Sie für den weiteren Service zu den unten aufgeführten Ersatzmodellen. Falls Ihre Anfragen keine
model_id festlegen, setzen Sie sie explizit auf das Ersatzmodell.
Die Modelle eleven_turbo_v2_5 und eleven_turbo_v2 sind funktional gleichwertig mit den
Modellen eleven_flash_v2_5 bzw. eleven_flash_v2, außer dass die Latenz der Flash-
Modelle im Durchschnitt niedriger ist. Wir empfehlen, die Flash-Modelle den Turbo-Modellen in allen Anwendungsfällen
vorzuziehen.
Eleven v4
Eleven v4 ist unser modernstes Sprachsynthesemodell und bietet Audio in unserer höchsten Qualität, ausdrucksstarke Stimmen und umfassende Kontrolle über die Stimmdarbietung. Eleven v4 unterstützt hochpräzises Klonen von KI-Stimmen mit zuverlässiger Sprechererhaltung bei langen Textgenerierungen.
Dieses Modell eignet sich gut für folgende Szenarien:
- Charakter-Voiceovers: Dank seiner emotionalen Bandbreite ideal für Spiele und Animationen.
- Emotionaler Dialog: Generieren Sie natürliche, lebensechte Dialoge mit großer emotionaler Bandbreite und kontextuellem Verständnis.
- Hörbuchproduktion: Ideal für lange Erzählungen mit komplexer emotionaler Darbietung.
- Mehrsprachige Projekte: Bewahrt eine konsistente Stimmqualität bei Sprachwechseln.
Eleven v4 ist über die Text to Dialogue API verfügbar.
Unterstützte Sprachen
Die Eleven-v4-Modellfamilie unterstützt über 90 Sprachen, darunter:
Afrikaans (af), Amharisch (am), Arabisch (ar), Armenisch (hy), Assamisch (as), Asturisch (ast), Aserbaidschanisch (az), Belarussisch (be), Bengalisch (bn), Bosnisch (bs), Bulgarisch (bg), Birmanisch (my), Kantonesisch (yue), Katalanisch (ca), Cebuano (ceb), Kroatisch (hr), Tschechisch (cs), Dänisch (da), Niederländisch (nl), Englisch (en), Estnisch (et), Filipino (fil), Finnisch (fi), Französisch (fr), Fulfulde (Pulaar) (ff), Galicisch (gl), Georgisch (ka), Deutsch (de), Griechisch (el), Gujarati (gu), Hausa (ha), Hebräisch (he), Hindi (hi), Ungarisch (hu), Isländisch (is), Indonesisch (id), Italienisch (it), Japanisch (ja), Javanisch (jv), Kamba (kam), Kannada (kn), Kasachisch (kk), Koreanisch (ko), Kirgisisch (ky), Laotisch (lo), Lettisch (lv), Lingála (ln), Litauisch (lt), Luganda (lg), Luxemburgisch (lb), Mazedonisch (mk), Malaiisch (ms), Malayalam (ml), Maltesisch (mt), Mandarin-Chinesisch (zh), Māori (mi), Marathi (mr), Mongolisch (mn), Nepalesisch (ne), Norwegisch (no), Okzitanisch (oc), Odia (or), Paschtunisch (ps), Persisch (fa), Polnisch (pl), Portugiesisch (pt), Pandschabi (pa), Rumänisch (ro), Russisch (ru), Serbisch (sr), Shona (sn), Sindhi (sd), Slowakisch (sk), Slowenisch (sl), Somali (so), Sorani-Kurdisch (ckb), Spanisch (es), Suaheli (sw), Schwedisch (sv), Tadschikisch (tg), Tamil (ta), Telugu (te), Thailändisch (th), Türkisch (tr), Ukrainisch (uk), Urdu (ur), Usbekisch (uz), Vietnamesisch (vi), Walisisch (cy), Wolof (wo), Zulu (zu).
Eleven v4 Turbo
Eleven v4 Turbo ist unser hochmodernes Modell für Echtzeit-Sprachsynthese. Es liefert hochwertiges Audio, Ausdrucksstärke und Kontrolle über die Wiedergabe von Stimmen. Eleven v4 Turbo unterstützt hochpräzises Klonen von Stimmen und hat eine mediane Latenz von ~100 ms. Informationen zur Messung der Latenz.
Dieses Modell eignet sich gut für folgende Szenarien:
- Support-Agenten: Betreiben Sie Sprachagenten, die Kundenanfragen in Echtzeit lösen.
- KI-Assistenten: Generieren Sie natürliche, lebensechte Dialoge mit großer emotionaler Bandbreite und Kontextverständnis.
- Interaktive Charaktere: Hervorragend für Audioerlebnisse mit ausdrucksstarken Charakteren.
Eleven v4 Turbo ist über den Text to Dialogue-WebSocket verfügbar.
Unterstützte Sprachen
Die Eleven-v4-Modellfamilie unterstützt über 90 Sprachen, darunter:
Afrikaans (af), Amharisch (am), Arabisch (ar), Armenisch (hy), Assamisch (as), Asturisch (ast), Aserbaidschanisch (az), Belarussisch (be), Bengalisch (bn), Bosnisch (bs), Bulgarisch (bg), Birmanisch (my), Kantonesisch (yue), Katalanisch (ca), Cebuano (ceb), Kroatisch (hr), Tschechisch (cs), Dänisch (da), Niederländisch (nl), Englisch (en), Estnisch (et), Filipino (fil), Finnisch (fi), Französisch (fr), Fulfulde (Pulaar) (ff), Galicisch (gl), Georgisch (ka), Deutsch (de), Griechisch (el), Gujarati (gu), Hausa (ha), Hebräisch (he), Hindi (hi), Ungarisch (hu), Isländisch (is), Indonesisch (id), Italienisch (it), Japanisch (ja), Javanisch (jv), Kamba (kam), Kannada (kn), Kasachisch (kk), Koreanisch (ko), Kirgisisch (ky), Laotisch (lo), Lettisch (lv), Lingála (ln), Litauisch (lt), Luganda (lg), Luxemburgisch (lb), Mazedonisch (mk), Malaiisch (ms), Malayalam (ml), Maltesisch (mt), Mandarin-Chinesisch (zh), Māori (mi), Marathi (mr), Mongolisch (mn), Nepalesisch (ne), Norwegisch (no), Okzitanisch (oc), Odia (or), Paschtunisch (ps), Persisch (fa), Polnisch (pl), Portugiesisch (pt), Pandschabi (pa), Rumänisch (ro), Russisch (ru), Serbisch (sr), Shona (sn), Sindhi (sd), Slowakisch (sk), Slowenisch (sl), Somali (so), Sorani-Kurdisch (ckb), Spanisch (es), Suaheli (sw), Schwedisch (sv), Tadschikisch (tg), Tamil (ta), Telugu (te), Thailändisch (th), Türkisch (tr), Ukrainisch (uk), Urdu (ur), Usbekisch (uz), Vietnamesisch (vi), Walisisch (cy), Wolof (wo), Zulu (zu).
Eleven v3
Eleven v3 ist unser Sprachsynthesemodell der vorherigen Generation. Es erzeugt natürliche, lebensechte Sprache mit großer emotionaler Bandbreite und Kontextverständnis in mehreren Sprachen.
Mit Eleven v3 steht eine neue Text to Dialogue API zur Verfügung, mit der Sie natürliche, lebensechte Dialoge mit großer emotionaler Bandbreite und Kontextverständnis in mehreren Sprachen generieren können. Eleven v3 kann auch mit der Text to Speech API verwendet werden, um natürliche, lebensechte Sprache mit großer emotionaler Bandbreite und Kontextverständnis in mehreren Sprachen zu generieren.
Weitere Informationen zur Text to Dialogue API finden Sie hier.
Unterstützte Sprachen
Das Modell Eleven v3 unterstützt über 70 Sprachen, darunter:
Afrikaans (af), Arabisch (ar), Armenisch (hy), Assamesisch (as), Asturisch (ast), Aserbaidschanisch (az), Belarussisch (be), Bengalisch (bn), Bosnisch (bs), Bulgarisch (bg), Birmanisch (my), Kantonesisch (yue), Katalanisch (ca), Cebuano (ceb), Chichewa (ny), Kroatisch (hr), Tschechisch (cs), Dänisch (da), Niederländisch (nl), Englisch (en), Estnisch (et), Filipino (fil), Finnisch (fi), Französisch (fr), Galicisch (gl), Georgisch (ka), Deutsch (de), Griechisch (el), Gujarati (gu), Hausa (ha), Hebräisch (he), Hindi (hi), Ungarisch (hu), Isländisch (is), Indonesisch (id), Irisch (ga), Italienisch (it), Japanisch (ja), Javanisch (jv), Kannada (kn), Kasachisch (kk), Kirgisisch (ky), Koreanisch (ko), Lettisch (lv), Lingala (ln), Litauisch (lt), Luxemburgisch (lb), Mazedonisch (mk), Malaiisch (ms), Malayalam (ml), Maltesisch (mt), Mandarin-Chinesisch (zh), Māori (mi), Marathi (mr), Mongolisch (mn), Nepali (ne), Norwegisch (no), Okzitanisch (oc), Odia (or), Paschtunisch (ps), Persisch (fa), Polnisch (pl), Portugiesisch (pt), Punjabi (pa), Rumänisch (ro), Russisch (ru), Serbisch (sr), Sindhi (sd), Slowakisch (sk), Slowenisch (sl), Somali (so), Spanisch (es), Suaheli (sw), Schwedisch (sv), Tadschikisch (tg), Tamil (ta), Telugu (te), Thailändisch (th), Türkisch (tr), Ukrainisch (uk), Urdu (ur), Usbekisch (uz), Vietnamesisch (vi), Walisisch (cy), Yoruba (yo).
Eleven v3 Conversational
Eleven v3 Conversational ist unser Modell der vorherigen Generation für Echtzeit-Sprachsynthese. Es erzeugt natürliche, lebensechte Sprache mit großer emotionaler Bandbreite und Kontextverständnis in mehreren Sprachen.
Mit Eleven v3 Conversational steht ein neuer Text to Dialogue-WebSocket zur Verfügung, mit dem Sie natürliche, lebensechte Dialoge mit großer emotionaler Bandbreite und Kontextverständnis in mehreren Sprachen generieren können.
Mit Eleven v3 Conversational steht ein neuer Text to Dialogue-WebSocket zur Verfügung, mit dem Sie natürliche, lebensechte Dialoge mit großer emotionaler Bandbreite und Kontextverständnis in mehreren Sprachen generieren können.
Weitere Informationen zum Text to Dialogue-WebSocket finden Sie hier.
Unterstützte Sprachen
Das Modell Eleven v3 unterstützt über 70 Sprachen, darunter:
Afrikaans (af), Arabisch (ar), Armenisch (hy), Assamesisch (as), Asturisch (ast), Aserbaidschanisch (az), Belarussisch (be), Bengalisch (bn), Bosnisch (bs), Bulgarisch (bg), Birmanisch (my), Kantonesisch (yue), Katalanisch (ca), Cebuano (ceb), Chichewa (ny), Kroatisch (hr), Tschechisch (cs), Dänisch (da), Niederländisch (nl), Englisch (en), Estnisch (et), Filipino (fil), Finnisch (fi), Französisch (fr), Galicisch (gl), Georgisch (ka), Deutsch (de), Griechisch (el), Gujarati (gu), Hausa (ha), Hebräisch (he), Hindi (hi), Ungarisch (hu), Isländisch (is), Indonesisch (id), Irisch (ga), Italienisch (it), Japanisch (ja), Javanisch (jv), Kannada (kn), Kasachisch (kk), Kirgisisch (ky), Koreanisch (ko), Lettisch (lv), Lingala (ln), Litauisch (lt), Luxemburgisch (lb), Mazedonisch (mk), Malaiisch (ms), Malayalam (ml), Maltesisch (mt), Mandarin-Chinesisch (zh), Māori (mi), Marathi (mr), Mongolisch (mn), Nepali (ne), Norwegisch (no), Okzitanisch (oc), Odia (or), Paschtunisch (ps), Persisch (fa), Polnisch (pl), Portugiesisch (pt), Punjabi (pa), Rumänisch (ro), Russisch (ru), Serbisch (sr), Sindhi (sd), Slowakisch (sk), Slowenisch (sl), Somali (so), Spanisch (es), Suaheli (sw), Schwedisch (sv), Tadschikisch (tg), Tamil (ta), Telugu (te), Thailändisch (th), Türkisch (tr), Ukrainisch (uk), Urdu (ur), Usbekisch (uz), Vietnamesisch (vi), Walisisch (cy), Yoruba (yo).
Multilingual v2
Eleven Multilingual v2 ist ein emotional sensibles Sprachsynthesemodell der vorherigen Generation. Es erzeugt natürliche, lebensechte Sprache mit großer emotionaler Bandbreite und Kontextverständnis in mehreren Sprachen.
Das Modell liefert in allen unterstützten Sprachen konsistente Stimmqualität und Persönlichkeit und bewahrt dabei die einzigartigen Merkmale und den Akzent der sprechenden Person.
Dieses Modell eignet sich besonders für Szenarien, die hochwertige, emotional nuancierte Sprache erfordern:
- Charakter-Voiceovers: Ideal für Spiele und Animationen dank seiner emotionalen Bandbreite.
- Professionelle Inhalte: Gut geeignet für Unternehmensvideos und E-Learning-Materialien.
- Mehrsprachige Projekte: Bewahrt konsistente Stimmqualität beim Sprachwechsel.
- Stabile Qualität: Erzeugt konsistente, hochwertige Audioausgabe.
Obwohl es eine höhere Latenz und höhere Kosten pro Zeichen als Flash-Modelle hat, bietet es überlegene Qualität für Projekte, bei denen lebensechte Sprache wichtig ist.
Unsere mehrsprachigen v2-Modelle unterstützen 29 Sprachen:
Englisch (USA, UK, Australien, Kanada), Japanisch, Chinesisch, Deutsch, Hindi, Französisch (Frankreich, Kanada), Koreanisch, Portugiesisch (Brasilien, Portugal), Italienisch, Spanisch (Spanien, Mexiko), Indonesisch, Niederländisch, Türkisch, Filipino, Polnisch, Schwedisch, Bulgarisch, Rumänisch, Arabisch (Saudi-Arabien, VAE), Tschechisch, Griechisch, Finnisch, Kroatisch, Malaiisch, Slowakisch, Dänisch, Tamil, Ukrainisch & Russisch.
Flash v2.5
Eleven Flash v2.5 ist ein Sprachsynthesemodell mit niedriger Latenz für Echtzeitanwendungen und die Agents Platform. Es liefert hochwertige Sprache mit einer medianen Latenz von ~100 ms† in 32 Sprachen.
Das Modell vereint Geschwindigkeit und Qualität. Damit ist es ideal für interaktive Anwendungen und bewahrt zugleich natürlich klingende Ausgabe sowie konsistente Stimmmerkmale über alle Sprachen hinweg.
Dieses Modell eignet sich besonders für:
- Agents Platform: Perfekt für Sprachagenten und Chatbots in Echtzeit.
- Interaktive Anwendungen: Ideal für Spiele und Anwendungen, die sofortige Reaktionen erfordern.
- Verarbeitung großer Mengen: Effizient für die Text-to-Speech-Konvertierung großer Textmengen.
Mit seinem niedrigeren Preis für API-Generierungen und geringer Latenz ist Flash v2.5 die kosteneffiziente Option für alle, die schnelle, zuverlässige Sprachsynthese in mehreren Sprachen benötigen.
Flash v2.5 unterstützt 32 Sprachen – alle Sprachen der v2-Modelle sowie:
Ungarisch, Norwegisch & Vietnamesisch
† Median, ohne Anwendungs- und Netzwerklatenz. Informationen zur Messung der Latenz.
Hinweise
Textnormalisierung mit Zahlen
Bei Flash v2.5 werden Zahlen standardmäßig möglicherweise nicht wie erwartet normalisiert. Telefonnummern könnten beispielsweise so vorgelesen werden, dass sie für Nutzende nicht eindeutig sind. Ähnlich betrifft dies Datumsangaben und Währungen.
Standardmäßig ist die Normalisierung für Flash v2.5 deaktiviert, um die niedrige Latenz beizubehalten. Enterprise-Kunden können die Textnormalisierung für v2.5-Modelle jedoch aktivieren, indem sie in ihrer Anfrage den Parameter apply_text_normalization auf “on” setzen.
Das Modell Multilingual v2 normalisiert Zahlen besser. Daher empfehlen wir es für Telefonnummern und andere Fälle, in denen die Zahlennormalisierung wichtig ist.
Für Anwendungen mit niedriger Latenz oder auf der Agents Platform empfiehlt es sich, den Text vor der Übergabe an das TTS-Modell durch Ihr LLM normalisieren zu lassen oder den Parameter apply_text_normalization zu verwenden (bei v2.5-Modellen nur in Enterprise-Tarifen).
Leitfaden zur Modellauswahl
Hinweise dazu, welches Modell am besten zu Ihren Anforderungen und Ihrem Anwendungsfall passt, finden Sie im Leitfaden zur Modellauswahl.
Anforderungen
Anwendungsfall
Zeichenlimits
Die maximale Anzahl unterstützter Zeichen in einer einzelnen Text-to-Speech-Anfrage variiert je nach Modell.
Scribe v2
Scribe v2 ist unser hochmodernes Spracherkennungsmodell für präzise Transkription in über 90 Sprachen. Es bietet genaue Zeitstempel auf Wortebene und erweiterte Funktionen wie Sprecherdiarisierung und dynamische Audio-Tagging.
Dieses Modell eignet sich besonders für Szenarien, die eine präzise Speech-to-Text-Konvertierung erfordern:
- Transkriptionsdienste: Perfekt für die Umwandlung von Audio- und Videoinhalten in Text
- Besprechungsdokumentation: Ideal zum Erfassen und Dokumentieren von Gesprächen
- Inhaltsanalyse: Gut geeignet für die Verarbeitung und Analyse von Audioinhalten
- Mehrsprachige Erkennung: Unterstützt präzise Transkription in über 90 Sprachen
Wichtige Funktionen:
- Präzise Transkription mit Zeitstempeln auf Wortebene
- Sprecherdiarisierung für Audio mit mehreren Sprechenden
- Dynamisches Audio-Tagging für mehr Kontext
- Unterstützung für über 90 Sprachen
- Entitätserkennung
- Keyterm-Prompting
- Bearbeitung von Transkripten
Weitere Informationen zu Scribe v2 finden Sie hier.
Scribe v2 Realtime
Scribe v2 Realtime, unser schnellstes und präzisestes Modell für Live-Spracherkennung, liefert hochmoderne Genauigkeit in über 90 Sprachen mit einer medianen Zeit bis zum bestätigten Transkript von ~150 ms. Informationen zur Messung der Latenz.
Dieses Modell eignet sich besonders für dialogorientierte Anwendungsfälle:
- Live-Transkription von Besprechungen: Perfekt für Echtzeit-Transkription
- KI-Agenten: Ideal für Live-Gespräche
- Mehrsprachige Erkennung: Unterstützt präzise Transkription in über 90 Sprachen mit automatischer Spracherkennung
Wichtige Funktionen:
- Extrem niedrige Latenz: Erhalten Sie bestätigte Transkripte mit einer medianen Latenz von ~150 Millisekunden
- Streaming-Unterstützung: Senden Sie Audio in Abschnitten und erhalten Sie Transkripte in Echtzeit
- Mehrere Audioformate: Unterstützung für PCM (8 kHz bis 48 kHz) und μ-Law-Kodierung
- Voice Activity Detection (VAD): Automatische Sprachsegmentierung anhand von Stilleerkennung
- Manuelle Commit-Steuerung: Volle Kontrolle darüber, wann Transkriptsegmente abgeschlossen werden
- Entitätserkennung
- Schwärzung von Entitäten
- Bearbeitung von Transkripten
Weitere Informationen zu Scribe v2 Realtime finden Sie hier.
Scribe v2 Medical
Scribe v2 Medical ist ein Batch-Spracherkennungsmodell, das auf medizinische und klinische Audiodaten spezialisiert ist. Es ist ein Finetune von Scribe v2, das die Erkennung von Medikamentennamen, Anatomie, Pathologie und klinischen Diktaten verbessert und zugleich die Genauigkeit von Scribe v2 bei Alltagssprache beibehält. Es verwendet dieselbe Speech to Text API wie Scribe v2 und wird zum gleichen Preis abgerechnet. Übergeben Sie scribe_v2_medical als model_id.
Zweckbestimmung
Scribe v2 Medical ist ein Batch-Modell der Speech-to-Text-API für Entwickler und Organisationen, die es in Anwendungen integrieren, welche klinische Audiodaten, einschließlich Gesprächen zwischen medizinischem Personal und Patienten, Diktaten, Erstaufnahme- und Versorgungskoordinationsanrufen, in Entwürfe von Transkripten für Dokumentation und zugehörige administrative Workflows umwandeln. Der resultierende Text ist vor der Verwendung zur Überprüfung und Korrektur durch medizinisches Fachpersonal oder andere autorisierte Nutzende bestimmt. Scribe v2 Medical ist nicht dafür vorgesehen, klinische Informationen zu interpretieren oder Diagnosen, Behandlungsempfehlungen, klinische Entscheidungen oder andere klinische Beratung bereitzustellen.
Dieses Modell eignet sich gut für:
- Klinische Dokumentation: Umgebungsaufnahmen von Behandlungen und Notizen, in denen medizinische Begriffe mitten im Gespräch vorkommen
- Diktate: Dichte Abfolgen von Medikamenten, Dosierungen und Befunden
- Erstaufnahme- und Koordinationsanrufe: Patienten beschreiben ihre eigenen Beschwerden, oft telefonisch
- Compliance-Workflows: Kombinieren Sie es für PHI-Kategorien mit der Entitätserkennung
Wichtige Funktionen:
- Gleiche Anfragestruktur wie Scribe v2 (
keyterms,entity_detection,no_verbatim, Diarisierung, Zeitstempel) - Verbesserte Erkennung von Medikamentennamen sowie Begriffen aus Anatomie und Pathologie
- Keine Verschlechterung bei Alltagssprache gegenüber Scribe v2
- Unterstützung für über 90 Sprachen
- Sprecherdiarisierung für Audio mit mehreren Sprechenden
- Dynamisches Audio-Tagging
- Entitätserkennung, einschließlich PHI-Kategorien
Scribe v2 Medical ist ein Batch-Modell. Verwenden Sie für Live-Transkription Scribe v2 Realtime.
Scribe v2 Medical ist HIPAA-fähig. Enterprise-Kunden stehen Business Associate Agreements sowie der Zero Retention Mode (ZRM) zur Verfügung. Bei aktiviertem ZRM werden Audioeingaben und Textausgaben unmittelbar nach Abschluss jeder Anfrage gelöscht. ElevenLabs speichert nichts, und Ihre Anwendung erhält die vollständige API-Antwort und verwaltet Transkripte unter Ihren eigenen Kontrollen.
Unternehmen, die HIPAA-Konformität benötigen, müssen den ElevenLabs- Vertrieb kontaktieren, um vor dem Senden geschützter Gesundheitsinformationen ein Business Associate Agreement (BAA) zu unterzeichnen.
Weitere Informationen zu Speech to Text finden Sie hier.
SFX v3
SFX v3 (eleven_text_to_sound_v3) ist unser neuestes Modell für Soundeffekte. Es verwendet dieselbe Sound Effects API wie eleven_text_to_sound_v2: Setzen Sie model_id auf eleven_text_to_sound_v3, um es zu verwenden. eleven_text_to_sound_v2 ist weiterhin der Standard, aber veraltet und wird am 1. März 2027 entfernt.
Im Vergleich zu eleven_text_to_sound_v2 bietet SFX v3:
- Mehrere Anweisungen in einem Prompt, etwa „Jubelnde Fußballmenge, ein fallender Ball ist zu hören, die Menge buht“.
- Unterstützung für Prompts mit Musik oder Gesang, etwa „Gospelchor singt Hallo“.
- Natürlichere Ergebnisse.
- Eine geringere Wahrscheinlichkeit für Clipping bei hochfrequenten Klängen wie Gongs, Glöckchen und Pfeifen.
Die Ergebnisse variieren je nach Prompt. Vergleichen Sie daher vor dem Wechsel beide Modelle mit Ihren eigenen Prompts.
SFX v3 unterstützt Loops. Setzen Sie loop auf true, um einen nahtlos wiederholbaren Soundeffekt zu generieren.
In ElevenCreative ist SFX v3 in Soundeffekte, Flows und Studio verfügbar.
Weitere Informationen zu Soundeffekten finden Sie hier.
Eleven Realtime
Eleven Realtime ist eine neue Klasse von Speech-to-Speech-Modellen zum Aufbau natürlicher Sprachagenten. Jedes Realtime-Modell ist ein vollständiger Sprachagent: Spracherkennung, Voice Activity Detection und Sprecherwechsel, LLM sowie Text to Speech, von ElevenLabs ausgewählt und aufeinander abgestimmt, damit sie als ein System zusammenarbeiten. Wählen Sie ein Realtime-Modell, und Sie erhalten durch eine einzige Auswahl einen leistungsfähigen Agenten – ohne zu konfigurierende Komponenten.
Zwei Realtime-Modelle sind verfügbar.
Eleven Realtime v1 Mini ist für schnelle, natürliche Gespräche optimiert und eignet sich gut für folgende Szenarien:
- KI-Assistenten: Schnelle, ausdrucksstarke Dialoge, bei denen das Gespräch selbst das Produkt ist.
- Lernbegleiter: Natürlicher Austausch, der mit dem Tempo der Lernenden Schritt hält.
- Interaktive Charaktere: Ausdrucksstarke Charaktere für Spiele und Unterhaltung.
Eleven Realtime v1 Max ist für komplexe Aufgaben optimiert und eignet sich gut für folgende Szenarien:
- Kundensupport: Lösen von Anfragen, die das Befolgen eines Prozesses und das Nachschlagen von Informationen erfordern.
- Lead-Qualifizierung: Strukturierte Gespräche, die Informationen erfassen und nächste Schritte bestimmen.
- Mehrstufige Workflows: Aufgaben, die Tools zum Nachschlagen von Informationen oder Ausführen von Aktionen aufrufen.
Wichtige Funktionen:
- Spracherkennung, Sprecherwechsel, Sprachmodell und Stimme in einer Modellauswahl
- Natürlicher Sprecherwechsel und Unterbrechungsverarbeitung
- Tool-Aufrufe
- Anpassbare Stimmen aus der ElevenLabs-Stimmbibliothek
- Unterstützung für über 90 Sprachen
- Wechsel zwischen v1 Mini und v1 Max durch Modellauswahl statt durch eine Integrationsänderung
Eleven Realtime ist in ElevenAgents verfügbar, wo Sie ein Realtime-Modell im Modell-Dropdown auswählen, sowie über die Realtime API, die für Kompatibilität mit der Realtime API von OpenAI über WebSocket ausgelegt ist. Wenn Sie die Realtime API von OpenAI bereits verwenden, lesen Sie den Migrationsleitfaden.
Unterstützte Sprachen
Realtime-Modelle unterstützen über 90 Sprachen. Siehe die Sprachliste für Eleven v4.
Weitere Informationen zu Eleven Realtime finden Sie hier.
Eleven Music
Eleven Music ist unser Musikgenerierungsmodell in Studioqualität. Damit können Sie Musik in jedem Stil mit Prompts in natürlicher Sprache generieren.
Dieses Modell eignet sich hervorragend für folgende Szenarien:
- Spiel-Soundtracks: Erstellen Sie immersive Soundtracks für Spiele
- Podcast-Hintergründe: Bereichern Sie Podcasts mit professioneller Musik
- Marketing: Fügen Sie Werbe-Reels Hintergrundmusik hinzu
Wichtige Funktionen:
- Volle Kontrolle über Genre, Stil und Struktur
- Gesang oder rein instrumental
- Mehrsprachig, einschließlich Englisch, Spanisch, Deutsch, Japanisch und weiteren Sprachen
- Bearbeiten Sie Klang und Liedtext einzelner Abschnitte oder des gesamten Songs
Weitere Informationen zu Eleven Music finden Sie hier.
Parallelität und Priorität
Ihr Abonnement bestimmt, wie viele Anfragen gleichzeitig verarbeitet werden können und welche Priorität Ihre Anfragen in der Warteschlange haben. Speech to Text hat ein erhöhtes Parallelitätslimit. Sobald das Parallelitätslimit erreicht ist, werden weitere Anfragen zusammen mit Anfragen niedrigerer Priorität in einer Warteschlange verarbeitet. In der Praxis erhöht dies die Latenz in der Regel nur um etwa 50 ms.
Die Response-Header enthalten current-concurrent-requests und maximum-concurrent-requests, mit denen Sie Ihre Parallelität überwachen können.
API-Anfragen pro Minute im Vergleich zu parallelen Anfragen
Es ist wichtig zu verstehen, dass API-Anfragen pro Minute und parallele Anfragen unterschiedliche Kennzahlen sind, die von Ihrem Nutzungsverhalten abhängen.
API-Anfragen pro Minute können von parallelen Anfragen abweichen, da dies von der Dauer jeder Anfrage und davon abhängt, wie die Anfragen gebündelt werden.
Beispiel 1: Zeitversetzte Anfragen Bei 180 Anfragen pro Minute, die jeweils 1 Sekunde zur Verarbeitung benötigen und im Abstand von jeweils 0,33 Sekunden gesendet werden, läge die maximale Anzahl paralleler Anfragen bei 3 und der Durchschnitt ebenfalls bei 3, da sich immer 3 Anfragen in Bearbeitung befänden.
Beispiel 2: Gebündelte Anfragen Bei einem anderen Nutzungsmuster, etwa 180 Anfragen pro Minute, die jeweils 3 Sekunden zur Verarbeitung benötigen, aber alle gleichzeitig ausgelöst werden, läge die maximale Anzahl paralleler Anfragen bei 180 und der Durchschnitt bei 9 (in den ersten 3 Sekunden der Minute gingen 180 Anfragen gleichzeitig ein, in den letzten 57 Sekunden 0 Anfragen).
Da unser System die Parallelität berücksichtigt, sind Anfragen pro Minute weniger wichtig als die Dauer der einzelnen Anfragen und das Muster, nach dem sie gesendet werden.
Wie Endpoint-Anfragen gestellt werden, wirkt sich auf die Parallelitätslimits aus:
- Bei HTTP zählt jede Anfrage einzeln für Ihr Parallelitätslimit.
- Beim Text to Speech WebSocket zählt nur die Zeit, in der unser Modell Audio generiert, für Ihr Parallelitätslimit. Das bedeutet, dass ein offener WebSocket die meiste Zeit überhaupt nicht für Ihr Parallelitätslimit zählt.
- Die Text to Dialogue WebSockets funktionieren anders: Jede offene Verbindung reserviert eine Dialogsitzung aus einem separaten Pool, solange sie geöffnet bleibt. Über die Verbindung generiertes Audio zählt nicht für Ihr Standard-Parallelitätslimit. Dies lässt sich einfacher nachvollziehen, da eine Verbindung einer Sitzung entspricht. Ihre Limits für Dialogsitzungen sind auf diese neue Parallelitätsmethode ausgelegt. Siehe Text to Dialogue-Parallelität.
Parallelitätslimits verstehen
Das mit Ihrem Tarif verknüpfte Parallelitätslimit sollte nicht als maximale Anzahl gleichzeitig möglicher Gespräche, Telefonanrufe, Charakter-Voiceovers usw. interpretiert werden. Die tatsächliche Anzahl hängt von mehreren Faktoren ab, darunter die verwendeten KI-Stimmen und die Merkmale des Anwendungsfalls.
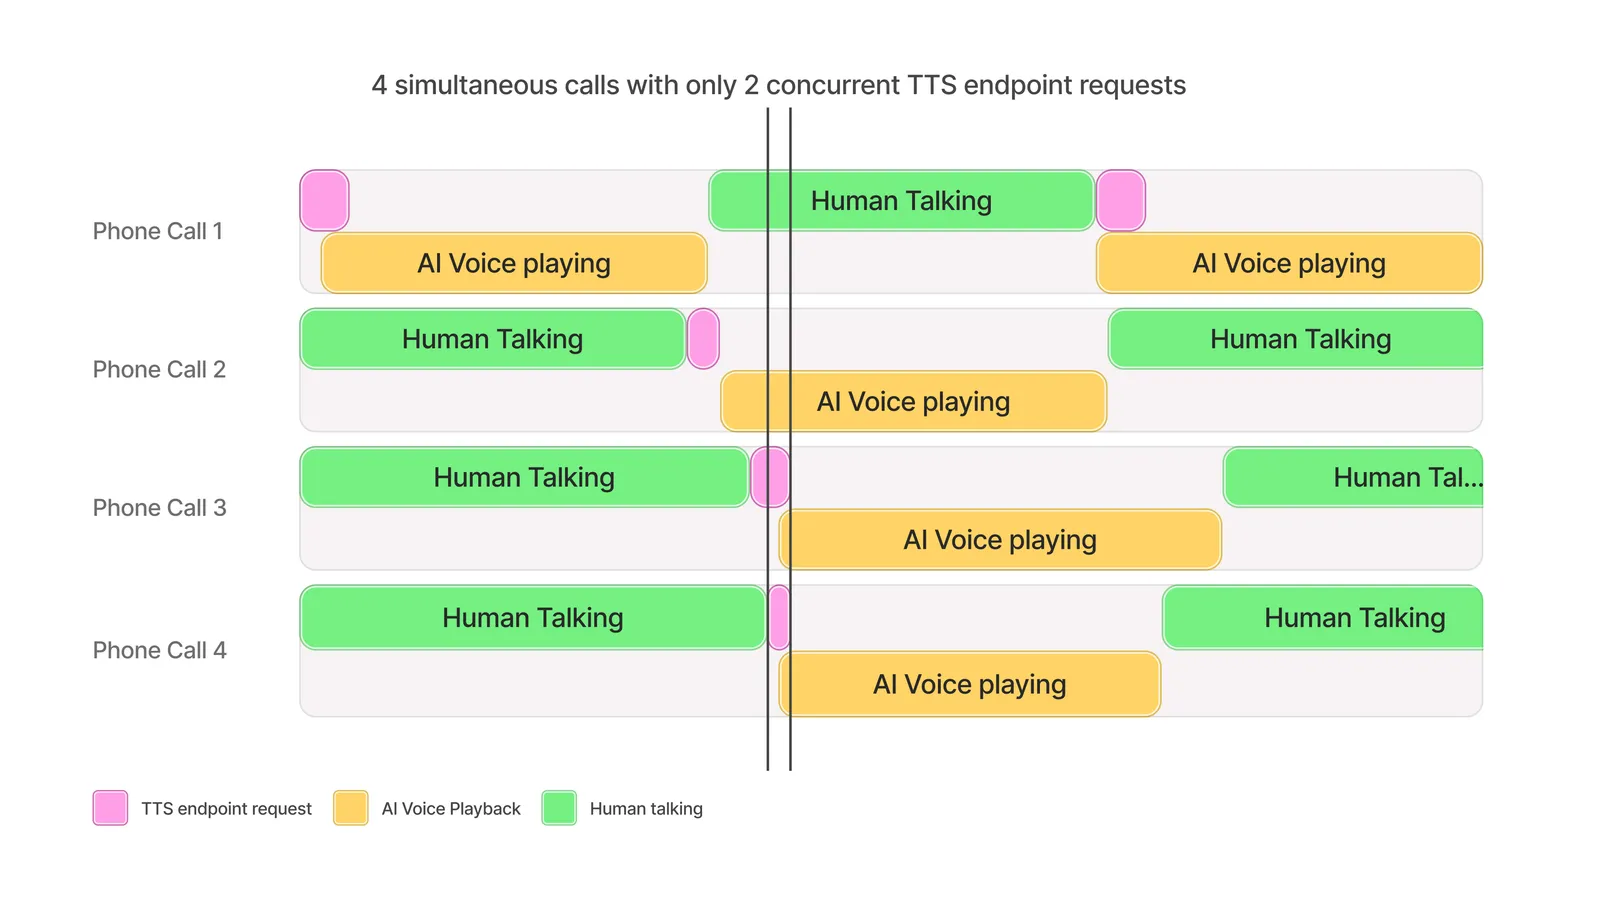
Als Faustregel gilt: Ein Parallelitätslimit von 5 kann in der Regel bis zu etwa 100 gleichzeitige Audioübertragungen unterstützen.
Das liegt an der Geschwindigkeit, mit der Audio generiert wird, im Verhältnis zur Verarbeitungszeit der TTS-Anfrage. Das folgende Diagramm zeigt beispielhaft, wie 4 parallele Anrufe mit verschiedenen Nutzern ermöglicht werden können, während nur 2 parallele Anfragen erreicht werden.
KI-Sprachagenten entwickeln
Wenn TTS zur Unterstützung von Dialogen eingesetzt wird, kann ein Parallelitätslimit von 5 etwa 100 Übertragungen für ausgewogene Gespräche zwischen KI-Agenten und menschlichen Teilnehmenden unterstützen.
Bei Anwendungsfällen, in denen der KI-Agent seltener spricht als der Mensch, etwa bei Kundensupport-Interaktionen, können mehr als 100 gleichzeitige Gespräche unterstützt werden.
Charakter-Voiceovers
Im Allgemeinen können bei einem Parallelitätslimit von 5 mehr als 100 gleichzeitige Charakter-Voiceovers unterstützt werden.
Die Anzahl kann je nach Dialoghäufigkeit des Charakters, Dauer der Pausen und Aktionen im Spiel zwischen den Zeilen variieren.
Live-Synchronisation
Parallele Synchronisationsstreams folgen in der Regel der angegebenen Faustregel.
Wenn die Übertragung Phasen mit Gesprächspausen enthält, etwa aufgrund eines Soundtracks, visueller Szenen usw., sind möglicherweise mehr gleichzeitige Synchronisationsstreams als empfohlen möglich.
Wenn Sie die Parallelitätslimits Ihres Tarifs überschreiten und den Enterprise-Tarif nutzen, können Modellanfragen je nach verfügbarer Kapazität dennoch langsamer und nach bestem Bemühen erfolgreich sein.
Um Ihr Parallelitätslimit und Ihre Warteschlangenpriorität zu erhöhen, upgraden Sie Ihr Abonnement.
Enterprise-Kunden können ein höheres Parallelitätslimit bei ihrem Account Manager anfragen.
Text to Dialogue-Parallelität
Text to Dialogue-Anfragen werden auf zwei unterschiedliche Arten abgerechnet, je nachdem, wie Sie die API aufrufen:
- HTTP-Endpoints (Dialog erstellen und Dialog streamen) zählen während der Audiogenerierung für das Standard-Parallelitätslimit Ihres Tarifs, wie jede andere Text to Speech-Anfrage.
- WebSocket-Endpoints wie der Text to Dialogue WebSocket werden als Dialogsitzungen abgerechnet. Eine offene Verbindung belegt eine Dialogsitzung, solange sie geöffnet bleibt, unabhängig davon, ob gerade Audio generiert wird.
Die sitzungsbasierte Abrechnung vereinfacht die Kapazitätsplanung: Eine Verbindung entspricht einer Sitzung, sodass Ihre Nutzung nicht mit der Generierungsaktivität schwankt. Da eine Sitzung während der gesamten Verbindung belegt wird und nicht nur während der Audiogenerierung, sind Ihre Limits für Dialogsitzungen auf diese neue Parallelitätsmethode ausgelegt.
Wenn Sie eine Verbindung öffnen, während alle Dialogsitzungen Ihres Workspace belegt sind, wird die neue Verbindung mit dem Fehler too_many_concurrent_requests abgelehnt. Um Sitzungen freizugeben, schließen Sie nicht mehr benötigte Verbindungen — eine Verbindung wird außerdem nach 20 Sekunden Inaktivität automatisch geschlossen, sofern Sie keine keep_alive-Nachrichten senden.
Um Dialogsitzungen zu überwachen, öffnen Sie unten in der Dashboard-Seitenleiste Developers, wählen Sie den Tab Analytics und sehen Sie sich in der Nutzungsansicht die Kennzahl Concurrent requests an. Dialogsitzungen werden als eigene Reihe, TTD Websocket Sessions, getrennt von Ihren anderen parallelen Anfragen ausgewiesen.
Parallelitätslimits mit Scale-Tests prüfen
Scale-Tests helfen dabei, Skalierungsprobleme auf Client-Seite zu erkennen und zu prüfen, ob Parallelitätslimits für Ihren Anwendungsfall korrekt eingestellt sind.
Es wird dringend empfohlen, End-to-End-Workflows so nah wie möglich an der realen Nutzung zu testen. Die empfohlene Methode dafür ist, zu simulieren und zu messen, wie viele Nutzer unterstützt werden können. Dabei ist Folgendes wichtig:
- Simulieren Sie Nutzer, nicht einzelne Anfragen
- Simulieren Sie typisches Nutzerverhalten, etwa das Warten auf die Audiowiedergabe, das Sprechen des Nutzers oder den Abschluss der Transkription, bevor Anfragen gestellt werden
- Erhöhen Sie die Anzahl der Nutzer über einen Zeitraum von mehreren Minuten langsam
- Variieren Sie die Zeitpunkte der Anfragen und die Größe der Anfragen zufällig
- Erfassen Sie Latenzkennzahlen und alle von der API zurückgegebenen Fehlercodes
Um beispielsweise ein Agentensystem zu testen, das für 100 gleichzeitige Gespräche ausgelegt ist, würden Sie bis zu 100 einzelne „Nutzer“ erstellen, die jeweils ein Gespräch simulieren. Gespräche bestehen in der Regel aus einem wiederholten Zyklus von etwa 10 Sekunden, in denen der Nutzer spricht, gefolgt von einem TTS-API-Aufruf für etwa 150 Zeichen und anschließend etwa 10 Sekunden Audiowiedergabe für den Nutzer. Daher sollte jeder Nutzer dem Muster folgen, alle 20 Sekunden einen Text-to-Speech-API-Aufruf über WebSocket für 150 Textzeichen durchzuführen. Dabei sollten die Wartezeit und die angeforderte Zeichenzahl leicht zufällig variiert werden. Der Test würde darin bestehen, eine Person pro Sekunde zu starten, bis 100 vorhanden sind, und anschließend insgesamt 10 Minuten lang zu testen, um die allgemeine Stabilität zu prüfen.
Beispiel für ein Scale-Test-Skript
Dieses Beispiel verwendet locust als Test-Framework mit direkten API-Aufrufen an die ElevenLabs API.
Es folgt dem oben aufgeführten Beispiel und testet ein dialogbasiertes Agentensystem, bei dem jeder Nutzer alle 20 Sekunden eine Anfrage sendet.