

Modelos
Modelos principales
Texto a Voz
Voz a Texto
Agentes de voz
Música
Descripción general de los modelos
La API de ElevenLabs ofrece una variedad de modelos de audio optimizados para distintos casos de uso, niveles de calidad y requisitos de rendimiento.
† Mediana, sin incluir la latencia de la aplicación ni de la red. Consulta cómo se mide la latencia.
Modelos obsoletos
El modelo music_v1 está obsoleto y se eliminará el 31 de enero de 2027. El modelo
eleven_text_to_sound_v2 está obsoleto y se eliminará el 1 de marzo de 2027. Migra a los
modelos de sustitución indicados a continuación para mantener el servicio. Si tus solicitudes no establecen
model_id, establécelo explícitamente en el modelo de sustitución.
Los modelos eleven_turbo_v2_5 y eleven_turbo_v2 son funcionalmente equivalentes a los
modelos eleven_flash_v2_5 y eleven_flash_v2, respectivamente, excepto que la latencia de los modelos Flash
es menor de media. Recomendamos usar los modelos Flash en lugar de los modelos Turbo en todos los
casos de uso.
Eleven v4
Eleven v4 es nuestro modelo de síntesis de voz de última generación, que ofrece nuestro audio de mayor calidad, expresividad y control sobre la interpretación de las voces. Eleven v4 permite clonar voces con alta fidelidad y conservar de forma fiable al hablante en generaciones de texto largas.
Este modelo funciona bien en los siguientes casos:
- Locuciones de personajes: Ideal para videojuegos y animación por su rango emocional.
- Diálogo emocional: Genera diálogos naturales y realistas con un amplio rango emocional y comprensión del contexto.
- Producción de audiolibros: Perfecto para narraciones largas con una interpretación emocional compleja.
- Proyectos multilingües: Mantiene una calidad de voz consistente al cambiar de idioma.
Eleven v4 está disponible mediante la API de Texto a Diálogo.
Idiomas compatibles
La familia de modelos Eleven v4 admite más de 90 idiomas, entre ellos:
Afrikáans (af), amárico (am), árabe (ar), armenio (hy), asamés (as), asturiano (ast), azerbaiyano (az), bielorruso (be), bengalí (bn), bosnio (bs), búlgaro (bg), birmano (my), cantonés (yue), catalán (ca), cebuano (ceb), croata (hr), checo (cs), danés (da), neerlandés (nl), inglés (en), estonio (et), filipino (fil), finés (fi), francés (fr), fula (pulaar) (ff), gallego (gl), georgiano (ka), alemán (de), griego (el), guyaratí (gu), hausa (ha), hebreo (he), hindi (hi), húngaro (hu), islandés (is), indonesio (id), italiano (it), japonés (ja), javanés (jv), kamba (kam), canarés (kn), kazajo (kk), coreano (ko), kirguís (ky), lao (lo), letón (lv), lingala (ln), lituano (lt), luganda (lg), luxemburgués (lb), macedonio (mk), malayo (ms), malayalam (ml), maltés (mt), chino mandarín (zh), maorí (mi), maratí (mr), mongol (mn), nepalí (ne), noruego (no), occitano (oc), odia (or), pastún (ps), persa (fa), polaco (pl), portugués (pt), panyabí (pa), rumano (ro), ruso (ru), serbio (sr), shona (sn), sindhi (sd), eslovaco (sk), esloveno (sl), somalí (so), kurdo soraní (ckb), español (es), suajili (sw), sueco (sv), tayiko (tg), tamil (ta), télugu (te), tailandés (th), turco (tr), ucraniano (uk), urdu (ur), uzbeko (uz), vietnamita (vi), galés (cy), wólof (wo), zulú (zu).
Eleven v4 Turbo
Eleven v4 Turbo es nuestro modelo de última generación para la síntesis de voz en tiempo real, que ofrece audio de alta calidad, expresividad y control sobre la interpretación de las voces. Eleven v4 Turbo admite clonación de voz de alta fidelidad y tiene una latencia mediana de ~100 ms. Consulta cómo se mide la latencia.
Este modelo funciona bien en los siguientes escenarios:
- Agentes de soporte: Impulsa agentes de voz que resuelven consultas de clientes en tiempo real.
- Asistentes de IA: Genera diálogos naturales y realistas con un amplio rango emocional y comprensión contextual.
- Personajes interactivos: Excelente para experiencias de audio con personajes expresivos.
Eleven v4 Turbo está disponible a través del websocket de Texto a Diálogo.
Idiomas compatibles
La familia de modelos Eleven v4 admite más de 90 idiomas, entre ellos:
Afrikáans (af), amárico (am), árabe (ar), armenio (hy), asamés (as), asturiano (ast), azerbaiyano (az), bielorruso (be), bengalí (bn), bosnio (bs), búlgaro (bg), birmano (my), cantonés (yue), catalán (ca), cebuano (ceb), croata (hr), checo (cs), danés (da), neerlandés (nl), inglés (en), estonio (et), filipino (fil), finés (fi), francés (fr), fula (pulaar) (ff), gallego (gl), georgiano (ka), alemán (de), griego (el), guyaratí (gu), hausa (ha), hebreo (he), hindi (hi), húngaro (hu), islandés (is), indonesio (id), italiano (it), japonés (ja), javanés (jv), kamba (kam), canarés (kn), kazajo (kk), coreano (ko), kirguís (ky), lao (lo), letón (lv), lingala (ln), lituano (lt), luganda (lg), luxemburgués (lb), macedonio (mk), malayo (ms), malayalam (ml), maltés (mt), chino mandarín (zh), maorí (mi), maratí (mr), mongol (mn), nepalí (ne), noruego (no), occitano (oc), odia (or), pastún (ps), persa (fa), polaco (pl), portugués (pt), panyabí (pa), rumano (ro), ruso (ru), serbio (sr), shona (sn), sindhi (sd), eslovaco (sk), esloveno (sl), somalí (so), kurdo soraní (ckb), español (es), suajili (sw), sueco (sv), tayiko (tg), tamil (ta), télugu (te), tailandés (th), turco (tr), ucraniano (uk), urdu (ur), uzbeko (uz), vietnamita (vi), galés (cy), wólof (wo), zulú (zu).
Eleven v3
Eleven v3 es nuestro modelo de síntesis de voz de la generación anterior, que produce voz natural y realista con un amplio rango emocional y comprensión contextual en varios idiomas.
Con Eleven v3 llega una nueva API de Texto a Diálogo, que te permite generar diálogos naturales y realistas con un amplio rango emocional y comprensión contextual en varios idiomas. Eleven v3 también se puede usar con la API de Texto a Voz para generar voz natural y realista con un amplio rango emocional y comprensión contextual en varios idiomas.
Lee más sobre la API de Texto a Diálogo aquí.
Idiomas compatibles
El modelo Eleven v3 admite más de 70 idiomas, entre ellos:
Afrikáans (af), árabe (ar), armenio (hy), asamés (as), asturiano (ast), azerbaiyano (az), bielorruso (be), bengalí (bn), bosnio (bs), búlgaro (bg), birmano (my), cantonés (yue), catalán (ca), cebuano (ceb), chichewa (ny), croata (hr), checo (cs), danés (da), neerlandés (nl), inglés (en), estonio (et), filipino (fil), finés (fi), francés (fr), gallego (gl), georgiano (ka), alemán (de), griego (el), guyaratí (gu), hausa (ha), hebreo (he), hindi (hi), húngaro (hu), islandés (is), indonesio (id), irlandés (ga), italiano (it), japonés (ja), javanés (jv), canarés (kn), kazajo (kk), kirguís (ky), coreano (ko), letón (lv), lingala (ln), lituano (lt), luxemburgués (lb), macedonio (mk), malayo (ms), malayalam (ml), maltés (mt), chino mandarín (zh), maorí (mi), maratí (mr), mongol (mn), nepalí (ne), noruego (no), occitano (oc), odia (or), pastún (ps), persa (fa), polaco (pl), portugués (pt), punyabí (pa), rumano (ro), ruso (ru), serbio (sr), sindhi (sd), eslovaco (sk), esloveno (sl), somalí (so), español (es), suajili (sw), sueco (sv), tayiko (tg), tamil (ta), telugu (te), tailandés (th), turco (tr), ucraniano (uk), urdu (ur), uzbeko (uz), vietnamita (vi), galés (cy), yoruba (yo).
Eleven v3 Conversational
Eleven v3 Conversational es nuestro modelo de generación anterior para la síntesis de voz en tiempo real. Produce voz natural y realista con un amplio rango emocional y comprensión contextual en varios idiomas.
Con Eleven v3 Conversational llega un nuevo WebSocket de Texto a Diálogo, que te permite generar diálogos naturales y realistas con un amplio rango emocional y comprensión contextual en varios idiomas.
Con Eleven v3 Conversational llega un nuevo WebSocket de Texto a Diálogo, que te permite generar diálogos naturales y realistas con un amplio rango emocional y comprensión contextual en varios idiomas.
Lee más sobre el WebSocket de Texto a Diálogo aquí.
Idiomas compatibles
El modelo Eleven v3 admite más de 70 idiomas, entre ellos:
Afrikáans (af), árabe (ar), armenio (hy), asamés (as), asturiano (ast), azerbaiyano (az), bielorruso (be), bengalí (bn), bosnio (bs), búlgaro (bg), birmano (my), cantonés (yue), catalán (ca), cebuano (ceb), chichewa (ny), croata (hr), checo (cs), danés (da), neerlandés (nl), inglés (en), estonio (et), filipino (fil), finés (fi), francés (fr), gallego (gl), georgiano (ka), alemán (de), griego (el), guyaratí (gu), hausa (ha), hebreo (he), hindi (hi), húngaro (hu), islandés (is), indonesio (id), irlandés (ga), italiano (it), japonés (ja), javanés (jv), canarés (kn), kazajo (kk), kirguís (ky), coreano (ko), letón (lv), lingala (ln), lituano (lt), luxemburgués (lb), macedonio (mk), malayo (ms), malayalam (ml), maltés (mt), chino mandarín (zh), maorí (mi), maratí (mr), mongol (mn), nepalí (ne), noruego (no), occitano (oc), odia (or), pastún (ps), persa (fa), polaco (pl), portugués (pt), punyabí (pa), rumano (ro), ruso (ru), serbio (sr), sindhi (sd), eslovaco (sk), esloveno (sl), somalí (so), español (es), suajili (sw), sueco (sv), tayiko (tg), tamil (ta), telugu (te), tailandés (th), turco (tr), ucraniano (uk), urdu (ur), uzbeko (uz), vietnamita (vi), galés (cy), yoruba (yo).
Multilingual v2
Eleven Multilingual v2 es un modelo de síntesis de voz de generación anterior con reconocimiento emocional. Produce voz natural y realista con un amplio rango emocional y comprensión contextual en varios idiomas.
El modelo ofrece una calidad de voz y una personalidad coherentes en todos los idiomas compatibles, manteniendo las características únicas y el acento del hablante.
Este modelo destaca en escenarios que requieren voz de alta calidad y con matices emocionales:
- Locuciones de personajes: Ideal para videojuegos y animación gracias a su rango emocional.
- Contenido profesional: Muy adecuado para vídeos corporativos y materiales de e-learning.
- Proyectos multilingües: Mantiene una calidad de voz coherente al cambiar de idioma.
- Calidad estable: Produce una salida de audio coherente y de alta calidad.
Aunque tiene una latencia y un coste por carácter superiores a los modelos Flash, ofrece una calidad superior para proyectos en los que una voz realista es importante.
Nuestros modelos multilingües v2 son compatibles con 29 idiomas:
Inglés (EE. UU., Reino Unido, Australia, Canadá), japonés, chino, alemán, hindi, francés (Francia, Canadá), coreano, portugués (Brasil, Portugal), italiano, español (España, México), indonesio, neerlandés, turco, filipino, polaco, sueco, búlgaro, rumano, árabe (Arabia Saudí, EAU), checo, griego, finés, croata, malayo, eslovaco, danés, tamil, ucraniano y ruso.
Flash v2.5
Eleven Flash v2.5 es un modelo de síntesis de voz de baja latencia diseñado para aplicaciones en tiempo real y Agents Platform. Ofrece voz de alta calidad con una latencia mediana de ~100 ms† en 32 idiomas.
El modelo equilibra velocidad y calidad, por lo que es ideal para aplicaciones interactivas, a la vez que mantiene una salida de sonido natural y características de voz coherentes entre idiomas.
Este modelo es especialmente adecuado para:
- Agents Platform: Perfecto para agentes de voz y chatbots en tiempo real.
- Aplicaciones interactivas: Ideal para juegos y aplicaciones que requieren una respuesta inmediata.
- Procesamiento a gran escala: Eficiente para la conversión masiva de texto a voz.
Con su menor precio para generaciones mediante API y su baja latencia, Flash v2.5 es la opción rentable para cualquiera que necesite síntesis de voz rápida y fiable en varios idiomas.
Flash v2.5 es compatible con 32 idiomas: todos los idiomas de los modelos v2, además de:
Húngaro, noruego y vietnamita
† Mediana, sin incluir la latencia de la aplicación y la red. Consulta cómo se mide la latencia .
Consideraciones
Normalización de texto con números
Al usar Flash v2.5, los números no se normalizan de forma predeterminada como cabría esperar. Por ejemplo, los números de teléfono podrían leerse de una forma que no resulte clara para el usuario. Las fechas y las divisas se ven afectadas de forma similar.
De forma predeterminada, la normalización está desactivada para Flash v2.5 con el fin de mantener la baja latencia. Sin embargo, los clientes Enterprise ya pueden activar la normalización de texto para los modelos v2.5 estableciendo el parámetro apply_text_normalization en “on” en su solicitud.
El modelo Multilingual v2 normaliza mejor los números, por lo que recomendamos usarlo para números de teléfono y otros casos en los que la normalización de números sea importante.
Para aplicaciones de baja latencia o de Agents Platform, la práctica recomendada es que tu LLM normalice el texto antes de enviarlo al modelo TTS, o usar el parámetro apply_text_normalization (solo planes Enterprise para modelos v2.5).
Guía de selección de modelos
Para saber qué modelo se adapta mejor a tus requisitos y caso de uso, consulta la guía de selección de modelos.
Requisitos
Caso de uso
Límites de caracteres
El número máximo de caracteres admitidos en una única solicitud de texto a voz varía según el modelo.
Scribe v2
Scribe v2 es nuestro modelo de reconocimiento de voz de última generación, diseñado para una transcripción precisa en más de 90 idiomas. Ofrece marcas de tiempo precisas a nivel de palabra y funciones avanzadas como la diarización de hablantes y el etiquetado dinámico de audio.
Este modelo destaca en escenarios que requieren una conversión precisa de voz a texto:
- Servicios de transcripción: Perfecto para convertir contenido de audio y vídeo en texto
- Documentación de reuniones: Ideal para capturar y documentar conversaciones
- Análisis de contenido: Muy adecuado para el procesamiento y análisis de contenido de audio
- Reconocimiento multilingüe: Admite transcripción precisa en más de 90 idiomas
Características principales:
- Transcripción precisa con marcas de tiempo a nivel de palabra
- Diarización de hablantes para audio con varios hablantes
- Etiquetado dinámico de audio para mejorar el contexto
- Compatibilidad con más de 90 idiomas
- Detección de entidades
- Prompting de términos clave
- Edición de transcripciones
Lee más sobre Scribe v2 aquí.
Scribe v2 Realtime
Scribe v2 Realtime, nuestro modelo de reconocimiento de voz en directo más rápido y preciso, ofrece una precisión de última generación en más de 90 idiomas, con un tiempo mediano hasta la transcripción confirmada de ~150 ms. Consulta cómo se mide la latencia.
Este modelo destaca en casos de uso conversacionales:
- Transcripción de reuniones en directo: Perfecto para transcripción en tiempo real
- Agentes de IA: Ideal para conversaciones en directo
- Reconocimiento multilingüe: Admite transcripción precisa en más de 90 idiomas con reconocimiento automático de idioma
Características principales:
- Latencia ultrabaja: obtén transcripciones confirmadas con una latencia mediana de ~150 milisegundos
- Compatibilidad con streaming: envía audio en fragmentos mientras recibes transcripciones en tiempo real
- Varios formatos de audio: compatibilidad con codificación PCM (de 8 kHz a 48 kHz) y μ-law
- Detección de actividad de voz (VAD): segmentación automática de voz basada en la detección de silencios
- Control de confirmación manual: control total sobre cuándo finalizar los segmentos de la transcripción
- Detección de entidades
- Redacción de entidades
- Edición de transcripciones
Lee más sobre Scribe v2 Realtime aquí.
Scribe v2 Medical
Scribe v2 Medical es un modelo de reconocimiento de voz por lotes especializado en audio médico y clínico. Es un ajuste fino de Scribe v2 que mejora el reconocimiento de nombres de medicamentos, anatomía, patología y dictado clínico, al tiempo que iguala la precisión de Scribe v2 en el habla cotidiana. Utiliza la misma API de Voz a Texto que Scribe v2 y se factura con la misma tarifa. Pasa scribe_v2_medical como model_id.
Uso previsto
Scribe v2 Medical es un modelo de API de voz a texto por lotes para que desarrolladores y organizaciones lo integren en aplicaciones que convierten audio clínico, incluidas conversaciones entre profesionales sanitarios y pacientes, dictados, llamadas de admisión y coordinación asistencial, en borradores de transcripciones para documentación y flujos de trabajo administrativos relacionados. El texto resultante está destinado a la revisión y corrección por parte de un profesional sanitario u otro usuario autorizado antes de su uso. Scribe v2 Medical no está destinado a interpretar información clínica ni a proporcionar diagnósticos, recomendaciones de tratamiento, decisiones clínicas u otra orientación clínica.
Este modelo es muy adecuado para:
- Documentación clínica: Consultas ambientales y notas en las que aparecen términos médicos a mitad de la conversación
- Dictado: Secuencias densas de medicamentos, dosis y hallazgos
- Llamadas de admisión y coordinación: Pacientes que describen sus propias afecciones, a menudo por teléfono
- Flujos de trabajo de cumplimiento normativo: Combínalo con la detección de entidades para categorías de PHI
Características principales:
- Misma estructura de solicitud que Scribe v2 (
keyterms,entity_detection,no_verbatim, diarización, marcas de tiempo) - Mejor reconocimiento de nombres de medicamentos y términos de anatomía y patología
- Sin pérdida de precisión en el habla cotidiana frente a Scribe v2
- Compatibilidad con más de 90 idiomas
- Diarización de hablantes para audio con varios hablantes
- Etiquetado dinámico de audio
- Detección de entidades, incluidas categorías de PHI
Scribe v2 Medical es un modelo por lotes. Para transcripción en directo, utiliza Scribe v2 Realtime.
Scribe v2 Medical es apto para HIPAA, con acuerdos de asociado comercial disponibles para clientes Enterprise, así como el modo de retención cero (ZRM). Con ZRM activado, la entrada de audio y la salida de texto se eliminan inmediatamente después de completar cada solicitud. ElevenLabs no conserva nada, y tu aplicación recibe la respuesta completa de la API y conserva las transcripciones bajo tus propios controles.
Las empresas que requieran cumplimiento de HIPAA deben contactar con Ventas de ElevenLabs para firmar un acuerdo de asociado comercial (BAA) antes de enviar información sanitaria protegida.
Lee más sobre Voz a Texto aquí.
SFX v3
SFX v3 (eleven_text_to_sound_v3) es nuestro modelo más reciente de efectos de sonido. Utiliza la misma API de Efectos de Sonido que eleven_text_to_sound_v2: establece model_id en eleven_text_to_sound_v3 para usarlo. eleven_text_to_sound_v2 sigue siendo el predeterminado, pero está obsoleto y se eliminará el 1 de marzo de 2027.
En comparación con eleven_text_to_sound_v2, SFX v3:
- Sigue varias instrucciones en un solo prompt, como «Multitud de fútbol animando, se oye caer un balón, la multitud abuchea».
- Gestiona prompts que incluyen música o voces, como «Coro góspel cantando hola».
- Produce resultados con un sonido más natural.
- Tiene menos probabilidades de recortar sonidos de alta frecuencia, como gongs, campanillas y silbatos.
Los resultados varían según el prompt, así que compara ambos modelos con tus propios prompts antes de cambiar.
SFX v3 admite repetición en bucle. Establece loop en true para generar un efecto de sonido que se repita de forma fluida.
En ElevenCreative, SFX v3 está disponible en Efectos de Sonido, Flows y Studio.
Lee más sobre efectos de sonido aquí.
Eleven Realtime
Eleven Realtime es una nueva clase de modelos de Voz a Voz para crear agentes de voz naturales. Cada modelo Realtime es un agente de voz completo: reconocimiento de voz, detección de actividad de voz y gestión de turnos, LLM y texto a voz, seleccionados y ajustados por ElevenLabs para funcionar juntos como un único sistema. Selecciona un modelo Realtime y obtendrás un agente con buen rendimiento con una sola elección, sin componentes que configurar.
Hay disponibles dos modelos Realtime.
Eleven Realtime v1 Mini está optimizado para conversaciones rápidas y naturales, y funciona bien en los siguientes escenarios:
- Asistentes de IA: Diálogos rápidos y expresivos en los que la conversación es el producto.
- Tutores educativos: Interacción natural que sigue el ritmo del alumno.
- Personajes interactivos: Personajes expresivos para juegos y entretenimiento.
Eleven Realtime v1 Max está optimizado para tareas complejas y funciona bien en los siguientes escenarios:
- Atención al cliente: Resolución de consultas que requieren seguir un proceso y buscar información.
- Cualificación de leads: Conversaciones estructuradas que recopilan información y deciden los siguientes pasos.
- Flujos de trabajo de varios pasos: Tareas que llaman a herramientas para buscar información o realizar acciones.
Características principales:
- Reconocimiento de voz, gestión de turnos, modelo de lenguaje y voz en una sola elección de modelo
- Gestión natural de turnos e interrupciones
- Llamadas a herramientas
- Voces personalizables de la biblioteca de voces de ElevenLabs
- Compatibilidad con más de 90 idiomas
- Cambia entre v1 Mini y v1 Max con una selección de modelo, sin cambiar la integración
Eleven Realtime está disponible en ElevenAgents, donde seleccionas un modelo Realtime en el menú desplegable de modelos, y a través de la API Realtime, diseñada para ser compatible con la API Realtime de OpenAI mediante WebSocket. Si ya utilizas la API Realtime de OpenAI, consulta la guía de migración.
Idiomas compatibles
Los modelos Realtime admiten más de 90 idiomas. Consulta la lista de idiomas de Eleven v4.
Lee más sobre Eleven Realtime aquí.
Eleven Music
Eleven Music es nuestro modelo de generación de música con calidad de estudio. Te permite generar música en cualquier estilo con prompts en lenguaje natural.
Este modelo es excelente para los siguientes escenarios:
- Bandas sonoras para juegos: Crea bandas sonoras inmersivas para juegos
- Fondos para podcasts: Mejora podcasts con música profesional
- Marketing: Añade música de fondo a reels publicitarios
Características principales:
- Control total sobre el género, el estilo y la estructura
- Voz o solo instrumental
- Multilingüe, incluidos inglés, español, alemán, japonés y más
- Edita el sonido y la letra de secciones individuales o de toda la canción
Lee más sobre Eleven Music aquí.
Concurrencia y prioridad
Tu plan de suscripción determina cuántas solicitudes se pueden procesar simultáneamente y el nivel de prioridad de tus solicitudes en la cola. Voz a Texto tiene un límite de concurrencia mayor. Una vez alcanzado el límite de concurrencia, las solicitudes posteriores se procesan en una cola junto con solicitudes de menor prioridad. En la práctica, esto normalmente solo añade unos 50 ms de latencia.
Las cabeceras de respuesta incluyen current-concurrent-requests y maximum-concurrent-requests, que puedes usar para supervisar tu concurrencia.
Solicitudes de API por minuto frente a solicitudes simultáneas
Es importante entender que las solicitudes de API por minuto y las solicitudes simultáneas son métricas diferentes que dependen de tus patrones de uso.
Las solicitudes de API por minuto pueden diferir de las solicitudes simultáneas, ya que dependen de la duración de cada solicitud y de cómo se agrupan las solicitudes.
Ejemplo 1: Solicitudes espaciadas Si tuvieras 180 solicitudes por minuto, cada una tardara 1 segundo en completarse y las enviaras con 0,33 segundos de separación, el máximo de solicitudes simultáneas sería 3 y la media también sería 3, ya que siempre habría 3 en curso.
Ejemplo 2: Solicitudes por lotes Sin embargo, si tuvieras un patrón de uso distinto, como 180 solicitudes por minuto que tardaran 3 segundos en completarse, pero todas se enviaran a la vez, el máximo de solicitudes simultáneas sería 180 y la media sería 9 (en los primeros 3 segundos del minuto habría 180 solicitudes a la vez y en los últimos 57 segundos habría 0 solicitudes).
Como nuestro sistema tiene en cuenta la concurrencia, las solicitudes por minuto importan menos que la duración de cada solicitud y el patrón con el que se envían.
La forma de realizar solicitudes a rutas de API afecta a los límites de concurrencia:
- Con HTTP, cada solicitud cuenta individualmente para tu límite de concurrencia.
- Con WebSocket de Texto a Voz, solo cuenta para tu límite de concurrencia el tiempo durante el que nuestro modelo genera audio. Esto significa que, durante la mayor parte del tiempo, un websocket abierto no cuenta en absoluto para tu límite de concurrencia.
- Los WebSockets de Texto a Diálogo funcionan de forma diferente: cada conexión abierta reserva una sesión de diálogo de un grupo independiente mientras permanezca abierta, y el audio generado a través de la conexión no cuenta para tu límite de concurrencia estándar. Esto está diseñado para que sea más fácil de entender: una conexión es una sesión, y los límites de sesiones de diálogo están dimensionados para adaptarse a esta nueva metodología de concurrencia. Consulta la concurrencia de Texto a Diálogo.
Entender los límites de concurrencia
El límite de concurrencia asociado a tu plan no debe interpretarse como el número máximo de conversaciones simultáneas, llamadas telefónicas, locuciones de personajes, etc., que se pueden gestionar a la vez. El número real depende de varios factores, incluidas las voces IA específicas utilizadas y las características del caso de uso.
Como regla general, un límite de concurrencia de 5 suele poder admitir aproximadamente hasta 100 retransmisiones de audio simultáneas.
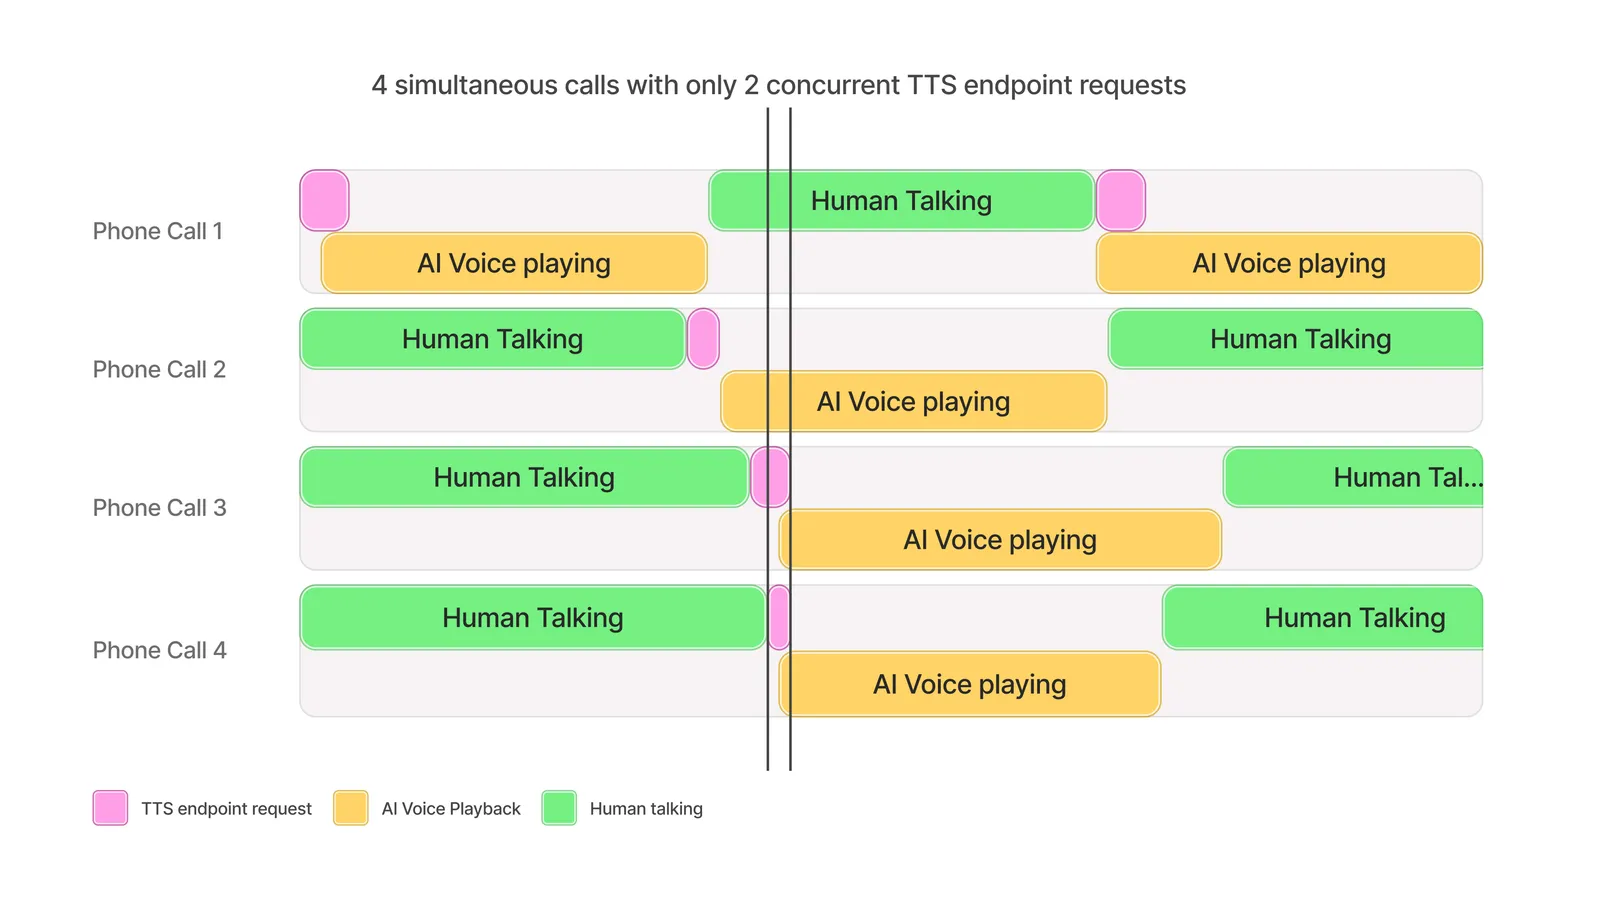
Esto se debe a la velocidad a la que se genera el audio en relación con el tiempo que tarda en procesarse la solicitud de TTS. El siguiente diagrama muestra un ejemplo de cómo se pueden facilitar 4 llamadas simultáneas con distintos usuarios mientras solo se alcanzan 2 solicitudes simultáneas.
Creación de agentes de voz IA
Cuando se utiliza TTS para facilitar el diálogo, un límite de concurrencia de 5 puede admitir unas 100 retransmisiones en conversaciones equilibradas entre agentes de IA y participantes humanos.
En casos de uso en los que el agente de IA habla con menos frecuencia que la persona, como las interacciones de atención al cliente, se podrían admitir más de 100 conversaciones simultáneas.
Locuciones de personajes
Por lo general, se pueden admitir más de 100 locuciones de personajes simultáneas con un límite de concurrencia de 5.
El número puede variar según la frecuencia de los diálogos del personaje, la duración de las pausas y las acciones dentro del juego entre líneas.
Doblaje en directo
Las retransmisiones de doblaje simultáneas suelen seguir la regla general proporcionada.
Si la retransmisión incluye periodos de pausas conversacionales (por ejemplo, debido a una banda sonora, escenas visuales, etc.), podrían ser posibles más retransmisiones de doblaje simultáneas de las sugeridas.
Si superas en algún momento los límites de concurrencia de tu plan y tienes el plan Enterprise, las solicitudes al modelo podrían seguir procesándose, aunque más lentamente, según la capacidad disponible y sin garantías.
Para aumentar tu límite de concurrencia y la prioridad en la cola, mejora tu plan de suscripción.
Los clientes Enterprise pueden solicitar un límite de concurrencia mayor contactando con su gestor de cuenta.
Concurrencia de Texto a Diálogo
Las solicitudes de Texto a Diálogo se miden de dos formas diferentes según cómo llames a la API:
- Las rutas HTTP (Crear diálogo y Transmitir diálogo) cuentan para el límite de concurrencia estándar de tu plan mientras se genera audio, como cualquier otra solicitud de Texto a Voz.
- Las rutas WebSocket, como el WebSocket de Texto a Diálogo, se miden como sesiones de diálogo. Una conexión abierta mantiene una sesión de diálogo mientras permanezca abierta, se esté generando audio en ese momento o no.
La medición basada en sesiones simplifica la planificación de capacidad: una conexión es una sesión, por lo que tu uso no fluctúa según la actividad de generación. Como se mantiene una sesión durante toda la conexión y no solo mientras se genera audio, los límites de sesiones de diálogo están dimensionados para adaptarse a esta nueva metodología de concurrencia.
Si abres una conexión cuando todas las sesiones de diálogo de tu espacio de trabajo están en uso, la nueva conexión se rechaza con un error too_many_concurrent_requests. Para liberar sesiones, cierra las conexiones que ya no necesites; una conexión también se cierra automáticamente tras 20 segundos de inactividad, a menos que envíes mensajes keep_alive.
Para supervisar las sesiones de diálogo, abre Desarrolladores en la parte inferior de la barra lateral del panel de control, selecciona la pestaña Analítica y consulta la métrica Solicitudes simultáneas en la vista Uso. Las sesiones de diálogo se muestran como su propia serie, Sesiones WebSocket de TTD, separada de tus demás solicitudes simultáneas.
Pruebas de carga de los límites de concurrencia
Las pruebas de carga pueden ser útiles para identificar problemas de escalado del lado del cliente y verificar que los límites de concurrencia estén configurados correctamente para tu caso de uso.
Recomendamos encarecidamente probar flujos de trabajo de principio a fin lo más parecidos posible al uso real. La metodología recomendada para conseguirlo consiste en simular y medir cuántos usuarios se pueden admitir. Es importante:
- Simular usuarios, no solicitudes sin procesar
- Simular comportamientos típicos de usuario, como esperar a que termine la reproducción de audio, que el usuario hable o que finalice la transcripción antes de realizar solicitudes
- Aumentar el número de usuarios lentamente durante varios minutos
- Introducir aleatoriedad en los tiempos de las solicitudes y en su tamaño
- Recopilar métricas de latencia y cualquier código de error devuelto por la API
Por ejemplo, para probar un sistema de agentes diseñado para admitir 100 conversaciones simultáneas, crearías hasta 100 «usuarios» individuales, cada uno simulando una conversación. Las conversaciones suelen consistir en un ciclo repetitivo de unos 10 segundos de conversación del usuario, seguidos de una llamada a la API de TTS para unos 150 caracteres, seguida de unos 10 segundos de reproducción de audio para el usuario. Por tanto, cada usuario debería seguir el patrón de realizar una llamada a la API WebSocket de Texto a Voz para 150 caracteres de texto cada 20 segundos, introduciendo una pequeña cantidad de aleatoriedad en el periodo de espera y el número de caracteres solicitados. La prueba consistiría en generar un usuario por segundo hasta alcanzar los 100 y, después, realizar pruebas durante un total de 10 minutos para comprobar la estabilidad general.
Ejemplo de script para pruebas de carga
Este ejemplo usa locust como framework de pruebas con llamadas directas a la API de ElevenLabs.
Sigue el ejemplo indicado anteriormente y prueba un sistema de agentes conversacionales en el que cada usuario envía 1 solicitud cada 20 segundos.