

Modelli
Modelli di punta
Text to Speech
Speech to Text
Agenti vocali
Musica
Panoramica dei modelli
L’API di ElevenLabs offre una gamma di modelli audio ottimizzati per diversi casi d’uso, livelli di qualità e requisiti di prestazioni.
† Mediana, escluse la latenza dell’applicazione e della rete. Scopri come viene misurata la latenza.
Modelli deprecati
Il modello music_v1 è deprecato e verrà rimosso il 31 gennaio 2027. Il
modello eleven_text_to_sound_v2 è deprecato e verrà rimosso il 1° marzo 2027. Esegui la migrazione
ai modelli sostitutivi riportati sotto per continuare a usare il servizio. Se le tue richieste non impostano
model_id, impostalo esplicitamente sul modello sostitutivo.
I modelli eleven_turbo_v2_5 e eleven_turbo_v2 sono funzionalmente equivalenti rispettivamente ai
modelli eleven_flash_v2_5 e eleven_flash_v2, tranne per il fatto che la latenza dei modelli Flash
è in media inferiore. Consigliamo di usare i modelli Flash anziché i modelli Turbo in tutti i
casi d’uso.
Eleven v4
Eleven v4 è il nostro modello all’avanguardia per la sintesi vocale, che offre audio di qualità superiore, espressività e controllo sull’interpretazione delle voci. Eleven v4 supporta la clonazione vocale ad alta fedeltà, preservando in modo affidabile il parlante anche nelle generazioni di testi lunghi.
Questo modello funziona bene nei seguenti scenari:
- Voci fuori campo per personaggi: ideale per giochi e animazioni grazie alla sua gamma emotiva.
- Dialoghi emozionali: genera dialoghi naturali e realistici, con un’ampia gamma emotiva e comprensione del contesto.
- Produzione di audiolibri: perfetto per narrazioni lunghe con interpretazioni emotive complesse.
- Progetti multilingue: mantiene una qualità vocale costante nei cambi di lingua.
Eleven v4 è disponibile tramite l’API Text to Dialogue.
Lingue supportate
La famiglia di modelli Eleven v4 supporta più di 90 lingue, tra cui:
Afrikaans (af), Amarico (am), Arabo (ar), Armeno (hy), Assamese (as), Asturiano (ast), Azero (az), Bielorusso (be), Bengali (bn), Bosniaco (bs), Bulgaro (bg), Birmano (my), Cantonese (yue), Catalano (ca), Cebuano (ceb), Croato (hr), Ceco (cs), Danese (da), Olandese (nl), Inglese (en), Estone (et), Filippino (fil), Finlandese (fi), Francese (fr), Fulah (Pulaar) (ff), Galiziano (gl), Georgiano (ka), Tedesco (de), Greco (el), Gujarati (gu), Hausa (ha), Ebraico (he), Hindi (hi), Ungherese (hu), Islandese (is), Indonesiano (id), Italiano (it), Giapponese (ja), Giavanese (jv), Kamba (kam), Kannada (kn), Kazako (kk), Coreano (ko), Kirghiso (ky), Lao (lo), Lettone (lv), Lingala (ln), Lituano (lt), Luganda (lg), Lussemburghese (lb), Macedone (mk), Malese (ms), Malayalam (ml), Maltese (mt), Cinese mandarino (zh), Māori (mi), Marathi (mr), Mongolo (mn), Nepalese (ne), Norvegese (no), Occitano (oc), Odia (or), Pashto (ps), Persiano (fa), Polacco (pl), Portoghese (pt), Punjabi (pa), Rumeno (ro), Russo (ru), Serbo (sr), Shona (sn), Sindhi (sd), Slovacco (sk), Sloveno (sl), Somalo (so), Curdo sorani (ckb), Spagnolo (es), Swahili (sw), Svedese (sv), Tagico (tg), Tamil (ta), Telugu (te), Thailandese (th), Turco (tr), Ucraino (uk), Urdu (ur), Uzbeko (uz), Vietnamita (vi), Gallese (cy), Wolof (wo), Zulu (zu).
Eleven v4 Turbo
Eleven v4 Turbo è il nostro modello all’avanguardia per la sintesi vocale in tempo reale e offre audio di alta qualità, espressività e controllo sull’interpretazione delle voci. Eleven v4 Turbo supporta la clonazione vocale ad alta fedeltà e ha una latenza mediana di ~100 ms. Scopri come viene misurata la latenza.
Questo modello funziona bene nei seguenti scenari:
- Agenti di supporto: alimenta agenti vocali che risolvono le richieste dei clienti in tempo reale.
- Assistenti IA: genera dialoghi naturali e realistici, con un’ampia gamma emotiva e comprensione del contesto.
- Personaggi interattivi: eccellente per esperienze audio con personaggi espressivi.
Eleven v4 Turbo è disponibile tramite il websocket Text to Dialogue.
Lingue supportate
La famiglia di modelli Eleven v4 supporta più di 90 lingue, tra cui:
Afrikaans (af), Amarico (am), Arabo (ar), Armeno (hy), Assamese (as), Asturiano (ast), Azero (az), Bielorusso (be), Bengali (bn), Bosniaco (bs), Bulgaro (bg), Birmano (my), Cantonese (yue), Catalano (ca), Cebuano (ceb), Croato (hr), Ceco (cs), Danese (da), Olandese (nl), Inglese (en), Estone (et), Filippino (fil), Finlandese (fi), Francese (fr), Fulah (Pulaar) (ff), Galiziano (gl), Georgiano (ka), Tedesco (de), Greco (el), Gujarati (gu), Hausa (ha), Ebraico (he), Hindi (hi), Ungherese (hu), Islandese (is), Indonesiano (id), Italiano (it), Giapponese (ja), Giavanese (jv), Kamba (kam), Kannada (kn), Kazako (kk), Coreano (ko), Kirghiso (ky), Lao (lo), Lettone (lv), Lingala (ln), Lituano (lt), Luganda (lg), Lussemburghese (lb), Macedone (mk), Malese (ms), Malayalam (ml), Maltese (mt), Cinese mandarino (zh), Māori (mi), Marathi (mr), Mongolo (mn), Nepalese (ne), Norvegese (no), Occitano (oc), Odia (or), Pashto (ps), Persiano (fa), Polacco (pl), Portoghese (pt), Punjabi (pa), Rumeno (ro), Russo (ru), Serbo (sr), Shona (sn), Sindhi (sd), Slovacco (sk), Sloveno (sl), Somalo (so), Curdo sorani (ckb), Spagnolo (es), Swahili (sw), Svedese (sv), Tagico (tg), Tamil (ta), Telugu (te), Thailandese (th), Turco (tr), Ucraino (uk), Urdu (ur), Uzbeko (uz), Vietnamita (vi), Gallese (cy), Wolof (wo), Zulu (zu).
Eleven v3
Eleven v3 è il nostro modello di sintesi vocale della generazione precedente, che produce un parlato naturale e realistico con un’ampia gamma emotiva e comprensione del contesto in più lingue.
Con Eleven v3 arriva una nuova API Text to Dialogue, che ti consente di generare dialoghi naturali e realistici con un’ampia gamma emotiva e comprensione del contesto in più lingue. Puoi usare Eleven v3 anche con l’API Text to Speech per generare parlato naturale e realistico con un’ampia gamma emotiva e comprensione del contesto in più lingue.
Scopri di più sull’API Text to Dialogue qui.
Lingue supportate
Il modello Eleven v3 supporta oltre 70 lingue, tra cui:
Afrikaans (af), arabo (ar), armeno (hy), assamese (as), asturiano (ast), azero (az), bielorusso (be), bengalese (bn), bosniaco (bs), bulgaro (bg), birmano (my), cantonese (yue), catalano (ca), cebuano (ceb), chichewa (ny), croato (hr), ceco (cs), danese (da), olandese (nl), inglese (en), estone (et), filippino (fil), finlandese (fi), francese (fr), galiziano (gl), georgiano (ka), tedesco (de), greco (el), gujarati (gu), hausa (ha), ebraico (he), hindi (hi), ungherese (hu), islandese (is), indonesiano (id), irlandese (ga), italiano (it), giapponese (ja), giavanese (jv), kannada (kn), kazako (kk), kirghiso (ky), coreano (ko), lettone (lv), lingala (ln), lituano (lt), lussemburghese (lb), macedone (mk), malese (ms), malayalam (ml), maltese (mt), cinese mandarino (zh), māori (mi), marathi (mr), mongolo (mn), nepalese (ne), norvegese (no), occitano (oc), odia (or), pashtu (ps), persiano (fa), polacco (pl), portoghese (pt), punjabi (pa), rumeno (ro), russo (ru), serbo (sr), sindhi (sd), slovacco (sk), sloveno (sl), somalo (so), spagnolo (es), swahili (sw), svedese (sv), tagico (tg), tamil (ta), telugu (te), thai (th), turco (tr), ucraino (uk), urdu (ur), uzbeko (uz), vietnamita (vi), gallese (cy), yoruba (yo).
Eleven v3 Conversational
Eleven v3 Conversational è il nostro modello di generazione precedente per la sintesi vocale in tempo reale. Produce un parlato naturale e realistico con un’ampia gamma emotiva e comprensione del contesto in più lingue.
Con Eleven v3 Conversational arriva un nuovo WebSocket Text to Dialogue, che ti consente di generare dialoghi naturali e realistici con un’ampia gamma emotiva e comprensione del contesto in più lingue.
Con Eleven v3 Conversational arriva un nuovo WebSocket Text to Dialogue, che ti consente di generare dialoghi naturali e realistici con un’ampia gamma emotiva e comprensione del contesto in più lingue.
Scopri di più sul WebSocket Text to Dialogue qui.
Lingue supportate
Il modello Eleven v3 supporta oltre 70 lingue, tra cui:
Afrikaans (af), arabo (ar), armeno (hy), assamese (as), asturiano (ast), azero (az), bielorusso (be), bengalese (bn), bosniaco (bs), bulgaro (bg), birmano (my), cantonese (yue), catalano (ca), cebuano (ceb), chichewa (ny), croato (hr), ceco (cs), danese (da), olandese (nl), inglese (en), estone (et), filippino (fil), finlandese (fi), francese (fr), galiziano (gl), georgiano (ka), tedesco (de), greco (el), gujarati (gu), hausa (ha), ebraico (he), hindi (hi), ungherese (hu), islandese (is), indonesiano (id), irlandese (ga), italiano (it), giapponese (ja), giavanese (jv), kannada (kn), kazako (kk), kirghiso (ky), coreano (ko), lettone (lv), lingala (ln), lituano (lt), lussemburghese (lb), macedone (mk), malese (ms), malayalam (ml), maltese (mt), cinese mandarino (zh), māori (mi), marathi (mr), mongolo (mn), nepalese (ne), norvegese (no), occitano (oc), odia (or), pashtu (ps), persiano (fa), polacco (pl), portoghese (pt), punjabi (pa), rumeno (ro), russo (ru), serbo (sr), sindhi (sd), slovacco (sk), sloveno (sl), somalo (so), spagnolo (es), swahili (sw), svedese (sv), tagico (tg), tamil (ta), telugu (te), thai (th), turco (tr), ucraino (uk), urdu (ur), uzbeko (uz), vietnamita (vi), gallese (cy), yoruba (yo).
Multilingual v2
Eleven Multilingual v2 è un modello di sintesi vocale della generazione precedente, sensibile alle emozioni. Produce un parlato naturale e realistico con un’ampia gamma emotiva e comprensione del contesto in più lingue.
Il modello offre qualità e personalità vocali costanti in tutte le lingue supportate, preservando al contempo le caratteristiche uniche e l’accento del parlante.
Questo modello eccelle negli scenari che richiedono un parlato di alta qualità e ricco di sfumature emotive:
- Voci fuori campo per personaggi: ideale per giochi e animazioni grazie alla sua gamma emotiva.
- Contenuti professionali: adatto a video aziendali e materiali di e-learning.
- Progetti multilingue: mantiene una qualità vocale costante nei cambi di lingua.
- Qualità stabile: produce un output audio costante e di alta qualità.
Anche se ha una latenza e un costo per carattere più elevati rispetto ai modelli Flash, offre una qualità superiore per i progetti in cui è importante un parlato realistico.
I nostri modelli multilingue v2 supportano 29 lingue:
inglese (Stati Uniti, Regno Unito, Australia, Canada), giapponese, cinese, tedesco, hindi, francese (Francia, Canada), coreano, portoghese (Brasile, Portogallo), italiano, spagnolo (Spagna, Messico), indonesiano, olandese, turco, filippino, polacco, svedese, bulgaro, rumeno, arabo (Arabia Saudita, Emirati Arabi Uniti), ceco, greco, finlandese, croato, malese, slovacco, danese, tamil, ucraino e russo.
Flash v2.5
Eleven Flash v2.5 è un modello di sintesi vocale a bassa latenza progettato per applicazioni in tempo reale e Agents Platform. Offre parlato di alta qualità con una latenza mediana di ~100 ms† in 32 lingue.
Il modello bilancia velocità e qualità, risultando ideale per le applicazioni interattive e mantenendo un output dal suono naturale e caratteristiche vocali coerenti tra le lingue.
Questo modello è particolarmente adatto per:
- Agents Platform: perfetto per agenti vocali e chatbot in tempo reale.
- Applicazioni interattive: ideale per giochi e applicazioni che richiedono una risposta immediata.
- Elaborazione su larga scala: efficiente per la conversione in blocco da testo a parlato.
Grazie al prezzo più basso per le generazioni API e alla bassa latenza, Flash v2.5 è l’opzione conveniente per chiunque abbia bisogno di una sintesi vocale rapida e affidabile in più lingue.
Flash v2.5 supporta 32 lingue: tutte le lingue dei modelli v2, più:
ungherese, norvegese e vietnamita
† Mediana, escluse la latenza dell’applicazione e della rete. Scopri come viene misurata la latenza.
Considerazioni
Normalizzazione del testo con numeri
Quando usi Flash v2.5, i numeri non vengono normalizzati per impostazione predefinita nel modo che potresti aspettarti. Ad esempio, i numeri di telefono potrebbero essere letti in modo poco chiaro per l’utente. Date e valute sono interessate in modo simile.
Per impostazione predefinita, la normalizzazione è disattivata per Flash v2.5 al fine di mantenere la bassa latenza. Tuttavia, i clienti Enterprise possono ora abilitare la normalizzazione del testo per i modelli v2.5 impostando il parametro apply_text_normalization su “on” nella richiesta.
Il modello Multilingual v2 normalizza meglio i numeri, quindi ne consigliamo l’uso per i numeri di telefono e altri casi in cui la normalizzazione dei numeri è importante.
Per le applicazioni a bassa latenza o di Agents Platform, la buona pratica è fare in modo che il tuo LLM normalizzi il testo prima di passarlo al modello TTS, oppure usare il parametro apply_text_normalization (solo per i piani Enterprise sui modelli v2.5).
Guida alla selezione dei modelli
Per sapere quale modello si adatta meglio alle tue esigenze e al tuo caso d’uso, consulta la guida alla selezione dei modelli.
Requisiti
Caso d'uso
Limiti di caratteri
Il numero massimo di caratteri supportati in una singola richiesta di sintesi vocale varia in base al modello.
Scribe v3
Scribe v3 è il nostro modello di riconoscimento vocale più accurato per l’audio registrato. È il successore di Scribe v2 e utilizza la stessa API Speech to Text (POST /v1/speech-to-text). Passa scribe_v3 come model_id.
Questo modello è adatto per:
- Strumenti per riunioni e appunti: trascrizioni con etichette dei parlanti di riunioni e chiamate registrate
- Media: sottotitoli e didascalie con etichette dei parlanti e timestamp a livello di parola
- Istruzione: lezioni registrate con parlato accentato o misto in più lingue
- Contact center: chiamate registrate per il controllo qualità e l’analisi
Rispetto a Scribe v2, Scribe v3 offre:
- Meno errori di trascrizione. Nel benchmark FLEURS su 102 lingue, Scribe v3 riduce il tasso di errore per parola (WER) dal 16,94% al 12,38%, ovvero il 27% di errori per parola in meno rispetto a Scribe v2, e migliora in ogni lingua testata.
- Etichette dei parlanti più accurate nell’audio con più parlanti.
- Il parametro
numbers_format, che scrive i numeri in cifre (42) o in lettere (quarantadue). - Il parametro
secondary_language_codes, che elenca le altre lingue previste nell’audio insieme alanguage_codeper migliorare l’accuratezza nell’audio multilingue.
Consulta le opzioni per numeri e lingue per usare i nuovi parametri.
ElevenLabs calcola il WER FLEURS per clip e poi ne calcola la media per lingua. Questo produce valori più alti del WER a livello di corpus comunemente pubblicato, quindi i numeri non sono comparabili con risultati calcolati in altro modo.
Scribe v3 mantiene le funzionalità di Scribe v2:
- Supporto per oltre 90 lingue
- Diarizzazione dei parlanti, fino a 32 parlanti
- Timestamp a livello di parola o di carattere
- Tagging degli eventi audio
- Prompting di termini chiave, fino a 1.000 termini
- Rilevamento delle entità
- Modifica delle trascrizioni
- Nessuna modalità letterale
- Esportazione in formati aggiuntivi come SRT, DOCX e PDF
- Webhook per risultati asincroni
Passare da Scribe v2
Modifica model_id da scribe_v2 a scribe_v3. I parametri delle richieste esistenti funzionano senza modifiche. Scribe v2 rimane disponibile.
Scribe v3 Live
Scribe v3 Live è il nostro modello di riconoscimento vocale in tempo reale più accurato. È il successore di Scribe v2 Realtime e utilizza lo stesso WebSocket in tempo reale (wss://api.elevenlabs.io/v1/speech-to-text/realtime). Passa scribe_v3_live come parametro query model_id.
Scribe v3 Live è un modello Speech to Text. È separato da Eleven Realtime, i modelli Speech to Speech per agenti vocali.
Questo modello è adatto per:
- Agenti vocali e contact center: confermare un turno quando chi chiama ha finito di parlare, non alla prima pausa
- Sottotitolazione in tempo reale: trascrizioni in tempo reale con timestamp a livello di parola
- Istruzione e apprendimento linguistico: parlanti con accenti e parlanti che alternano le lingue
- Dettatura e assistenti: vocabolario specifico del dominio tramite termini chiave
Rispetto a Scribe v2 Realtime, Scribe v3 Live offre:
- Meno errori di trascrizione. Nel benchmark FLEURS su 73 lingue, Scribe v3 Live ha un WER semantico inferiore del 44% rispetto a Scribe v2 Realtime. Su Earnings-22 (chiamate finanziarie in inglese con accento), il WER scende dal 5,99% al 3,91%, e su VoxPopuli (interventi del Parlamento europeo) dal 2,13% all’1,71%.
- Previsione del turno. Con
commit_strategy=turn_prediction, il server conferma un segmento quando il modello prevede che il parlante abbia terminato il proprio turno, invece di attendere solo il silenzio. - Modalità multilingue. Con
multilang_mode=true, ogni lingua viene trascritta nel proprio sistema di scrittura, compresi i cambi di lingua a metà frase. - Una libreria di termini chiave fino a 10.000 termini, che il modello usa solo quando rileva una corrispondenza probabile, in aggiunta ai 50 termini chiave standard.
- Diarizzazione in tempo reale. Con
diarize=true, le etichette provvisorie dei parlanti compaiono nelle trascrizioni parziali e ogni trascrizione confermata è seguita da una trascrizione diarizzata separata, senza ritardare il testo confermato.
Scribe v3 Live mantiene le funzionalità di Scribe v2 Realtime:
- Supporto per oltre 90 lingue, con rilevamento automatico della lingua
- Supporto streaming: invia l’audio in blocchi mentre ricevi le trascrizioni in tempo reale
- Più formati audio: PCM (da 8 kHz a 48 kHz) e codifica μ-law
- Strategie di conferma manuale e Voice Activity Detection (VAD)
- Timestamp a livello di parola
secondary_languagesper limitare il rilevamento della lingua a un insieme di lingue- Prompting di termini chiave, fino a 50 termini
- Rilevamento delle entità
- Modifica delle trascrizioni
- Filtro dell’audio di sottofondo
Passare da Scribe v2 Realtime
Modifica model_id da scribe_v2_realtime a scribe_v3_live. La strategia di conferma predefinita rimane manual, quindi le integrazioni esistenti si comportano allo stesso modo finché non imposti commit_strategy su turn_prediction. Scribe v2 Realtime rimane disponibile.
Gli SDK ufficiali non supportano ancora la previsione del turno, la modalità multilingue o la libreria di termini chiave. Per usarli, connettiti direttamente alla WebSocket API.
Scribe v2
Scribe v2 è il nostro precedente modello di riconoscimento vocale all’avanguardia, sostituito da Scribe v3. È progettato per una trascrizione accurata in oltre 90 lingue. Fornisce timestamp precisi a livello di parola e funzionalità avanzate come la diarizzazione dei parlanti e il tagging audio dinamico.
Questo modello eccelle negli scenari che richiedono una conversione accurata da voce a testo:
- Servizi di trascrizione: perfetto per convertire contenuti audio/video in testo
- Documentazione delle riunioni: ideale per acquisire e documentare le conversazioni
- Analisi dei contenuti: adatto all’elaborazione e all’analisi dei contenuti audio
- Riconoscimento multilingue: supporta trascrizioni accurate in oltre 90 lingue
Funzionalità principali:
- Trascrizione accurata con timestamp a livello di parola
- Diarizzazione dei parlanti per audio con più parlanti
- Tagging audio dinamico per un contesto migliore
- Supporto per oltre 90 lingue
- Rilevamento delle entità
- Prompting di termini chiave
- Modifica delle trascrizioni
Scopri di più su Scribe v2 qui.
Scribe v2 Realtime
Scribe v2 Realtime è il nostro precedente modello di riconoscimento vocale live all’avanguardia, sostituito da Scribe v3 Live. Trascrive oltre 90 lingue con un tempo mediano per la trascrizione confermata di ~150 ms. Scopri come viene misurata la latenza.
Questo modello eccelle nei casi d’uso conversazionali:
- Trascrizione di riunioni live: perfetto per la trascrizione in tempo reale
- Agenti IA: ideale per conversazioni live
- Riconoscimento multilingue: supporta trascrizioni accurate in oltre 90 lingue con riconoscimento automatico della lingua
Funzionalità principali:
- Latenza ultra-bassa: ottieni trascrizioni confermate con una latenza mediana di ~150 millisecondi
- Supporto streaming: invia l’audio in blocchi mentre ricevi le trascrizioni in tempo reale
- Più formati audio: supporto per PCM (da 8 kHz a 48 kHz) e codifica μ-law
- Voice Activity Detection (VAD): segmentazione automatica del parlato basata sul rilevamento del silenzio
- Controllo manuale della conferma: pieno controllo su quando finalizzare i segmenti della trascrizione
- Rilevamento delle entità
- Oscuramento delle entità
- Modifica delle trascrizioni
Scopri di più su Scribe v2 Realtime qui.
Scribe v2 Medical
Scribe v2 Medical è un modello batch di riconoscimento vocale specializzato per l’audio medico e clinico. È un fine-tune di Scribe v2 che migliora il riconoscimento di nomi di farmaci, anatomia, patologia e dettatura clinica, mantenendo l’accuratezza di Scribe v2 nel parlato quotidiano. Utilizza la stessa API Speech to Text di Scribe v2 e viene fatturato alla stessa tariffa. Passa scribe_v2_medical come model_id.
Destinazione d’uso
Scribe v2 Medical è un modello batch dell’API Speech-to-Text destinato a sviluppatori e organizzazioni che vogliono integrarlo in applicazioni che convertono audio clinico, comprese conversazioni tra medico e paziente, dettature, chiamate di accettazione e coordinamento dell’assistenza, in bozze di trascrizioni per documentazione e workflow amministrativi correlati. Il testo risultante è destinato alla revisione e correzione da parte di un professionista sanitario o di un altro utente autorizzato prima dell’uso. Scribe v2 Medical non è destinato a interpretare informazioni cliniche né a fornire diagnosi, raccomandazioni terapeutiche, decisioni cliniche o altre indicazioni cliniche.
Questo modello è adatto per:
- Documentazione clinica: consulti ambientali e note in cui i termini medici emergono nel corso della conversazione
- Dettatura: sequenze dense di farmaci, dosaggi e risultati clinici
- Chiamate di accettazione e coordinamento: pazienti che descrivono le proprie condizioni, spesso al telefono
- Workflow di conformità: combina il rilevamento delle entità per le categorie PHI
Funzionalità principali:
- Stessa struttura delle richieste di Scribe v2 (
keyterms,entity_detection,no_verbatim, diarizzazione, timestamp) - Riconoscimento migliorato dei nomi dei farmaci e dei termini di anatomia e patologia
- Nessuna regressione nel parlato quotidiano rispetto a Scribe v2
- Supporto per oltre 90 lingue
- Diarizzazione dei parlanti per audio con più parlanti
- Tagging audio dinamico
- Rilevamento delle entità, comprese le categorie PHI
Scribe v2 Medical è un modello batch. Per la trascrizione live, usa Scribe v2 Realtime.
Scribe v2 Medical è idoneo all’HIPAA, con Business Associate Agreement disponibili per i clienti Enterprise e la modalità Zero Retention Mode (ZRM). Con ZRM attivata, l’input audio e l’output di testo vengono eliminati immediatamente al termine di ogni richiesta. ElevenLabs non conserva nulla e la tua applicazione riceve la risposta API completa e conserva le trascrizioni sotto i tuoi controlli.
Le aziende che richiedono la conformità HIPAA devono contattare le vendite di ElevenLabs per firmare un Business Associate Agreement (BAA) prima di inviare informazioni sanitarie protette.
Scopri di più su Speech to Text qui.
SFX v3
SFX v3 (eleven_text_to_sound_v3) è il nostro nuovo modello per effetti sonori. Utilizza la stessa API Effetti Sonori di eleven_text_to_sound_v2: per usarlo, imposta model_id su eleven_text_to_sound_v3. eleven_text_to_sound_v2 è ancora il modello predefinito, ma è deprecato e verrà rimosso il 1° marzo 2027.
Rispetto a eleven_text_to_sound_v2, SFX v3:
- Segue più istruzioni in un unico prompt, ad esempio “Folla a una partita di calcio che esulta, si sente cadere una palla, la folla fischia”.
- Gestisce prompt che includono musica o voce, ad esempio “Coro gospel che canta ciao”.
- Produce risultati dal suono più naturale.
- Ha meno probabilità di distorcere i suoni ad alta frequenza come gong, campanelli e fischietti.
I risultati variano in base al prompt, quindi confronta entrambi i modelli sui tuoi prompt prima di passare all’altro.
SFX v3 supporta il looping. Imposta loop su true per generare un effetto sonoro che si ripete in modo fluido.
In ElevenCreative, SFX v3 è disponibile in Effetti Sonori, Flows e Studio.
Scopri di più sugli effetti sonori qui.
Eleven Realtime
Eleven Realtime è una nuova classe di modelli Speech to Speech per creare agenti vocali naturali. Ogni modello Realtime è un agente vocale completo: riconoscimento vocale, rilevamento dell’attività vocale e gestione dei turni, LLM e sintesi vocale, selezionati e ottimizzati da ElevenLabs per funzionare insieme come un unico sistema. Seleziona un modello Realtime e ottieni un agente dalle ottime prestazioni con un’unica scelta, senza componenti da configurare.
Sono disponibili due modelli Realtime.
Eleven Realtime v1 Mini è ottimizzato per conversazioni rapide e naturali e funziona bene nei seguenti scenari:
- Assistenti IA: dialoghi rapidi ed espressivi in cui la conversazione stessa è il prodotto.
- Tutor educativi: uno scambio naturale che segue il ritmo di apprendimento.
- Personaggi interattivi: personaggi espressivi per giochi e intrattenimento.
Eleven Realtime v1 Max è ottimizzato per attività complesse e funziona bene nei seguenti scenari:
- Assistenza clienti: risolvere richieste che richiedono di seguire un processo e cercare informazioni.
- Qualificazione dei lead: conversazioni strutturate che raccolgono informazioni e decidono i passaggi successivi.
- Workflow in più passaggi: attività che chiamano strumenti per cercare informazioni o eseguire azioni.
Funzionalità principali:
- Riconoscimento vocale, gestione dei turni, modello linguistico e voce in un’unica scelta del modello
- Gestione naturale dei turni e delle interruzioni
- Chiamata di strumenti
- Voci personalizzabili dalla Voice Library di ElevenLabs
- Supporto per oltre 90 lingue
- Passa da v1 Mini a v1 Max con una selezione del modello, senza modificare l’integrazione
Eleven Realtime è disponibile in ElevenAgents, dove selezioni un modello Realtime dal menu a discesa dei modelli, e tramite la Realtime API, progettata per essere compatibile con la Realtime API di OpenAI via WebSocket. Se usi già la Realtime API di OpenAI, consulta la guida alla migrazione.
Lingue supportate
I modelli Realtime supportano oltre 90 lingue. Consulta l’elenco delle lingue di Eleven v4.
Scopri di più su Eleven Realtime qui.
Eleven Music
Eleven Music è il nostro modello di generazione musicale di qualità da studio. Ti consente di generare musica di qualsiasi stile con prompt in linguaggio naturale.
Questo modello è eccellente per i seguenti scenari:
- Colonne sonore per giochi: crea colonne sonore coinvolgenti per i giochi
- Sottofondi per podcast: migliora i podcast con musica professionale
- Marketing: aggiungi musica di sottofondo ai reel pubblicitari
Funzionalità principali:
- Controllo completo su genere, stile e struttura
- Voce o solo strumentale
- Multilingue, tra cui inglese, spagnolo, tedesco, giapponese e altre lingue
- Modifica il suono e il testo delle singole sezioni o dell’intera canzone
Scopri di più su Eleven Music qui.
Concorrenza e priorità
Il tuo piano di abbonamento determina quante richieste possono essere elaborate contemporaneamente e il livello di priorità delle tue richieste nella coda. Speech to Text ha un limite di concorrenza più elevato. Una volta raggiunto il limite di concorrenza, le richieste successive vengono elaborate in una coda insieme alle richieste a priorità più bassa. In pratica, questo aggiunge in genere solo ~50 ms di latenza.
Per stimare il limite di concorrenza necessario per il tuo traffico, usa lo stimatore di concorrenza.
Gli header della risposta includono current-concurrent-requests e maximum-concurrent-requests, che puoi usare per monitorare la concorrenza.
Richieste API al minuto e richieste simultanee
È importante capire che le richieste API al minuto e le richieste simultanee sono metriche diverse, che dipendono dai tuoi modelli di utilizzo.
Le richieste API al minuto possono essere diverse dalle richieste simultanee, poiché dipendono dalla durata di ogni richiesta e da come le richieste vengono raggruppate.
Esempio 1: richieste distanziate Se avessi 180 richieste al minuto, ciascuna della durata di 1 secondo, e le inviassi a intervalli di 0,33 secondi, il numero massimo e medio di richieste simultanee sarebbe 3, perché ce ne sarebbero sempre 3 in corso.
Esempio 2: richieste in batch Se invece avessi un modello di utilizzo diverso, ad esempio 180 richieste al minuto, ciascuna della durata di 3 secondi, ma tutte avviate contemporaneamente, il numero massimo di richieste simultanee sarebbe 180 e la media sarebbe 9 (nei primi 3 secondi del minuto ci sarebbero 180 richieste contemporaneamente, negli ultimi 57 secondi 0 richieste).
Poiché il nostro sistema considera la concorrenza, le richieste al minuto sono meno importanti della durata di ciascuna richiesta e del modello con cui vengono inviate.
Il modo in cui vengono effettuate le richieste agli endpoint influisce sui limiti di concorrenza:
- Con HTTP, ogni richiesta conta singolarmente ai fini del limite di concorrenza.
- Con il WebSocket Text to Speech, solo il tempo durante il quale il nostro modello genera audio conta ai fini del limite di concorrenza. Ciò significa che, per la maggior parte del tempo, un websocket aperto non incide affatto sul limite di concorrenza.
- I WebSocket Text to Dialogue funzionano diversamente: ogni connessione aperta riserva una sessione di dialogo da un pool separato per tutto il tempo in cui rimane aperta e l’audio generato tramite la connessione non conta ai fini del limite di concorrenza standard. Questo approccio è pensato per essere più semplice da comprendere: una connessione corrisponde a una sessione e i limiti delle sessioni di dialogo sono dimensionati per adattarsi a questa nuova metodologia di concorrenza. Consulta concorrenza di Text to Dialogue.
Comprendere i limiti di concorrenza
Il limite di concorrenza associato al tuo piano non deve essere interpretato come il numero massimo di conversazioni simultanee, chiamate telefoniche, voci fuori campo di personaggi e così via che possono essere gestite contemporaneamente. Il numero effettivo dipende da diversi fattori, tra cui le voci IA specifiche utilizzate e le caratteristiche del caso d’uso.
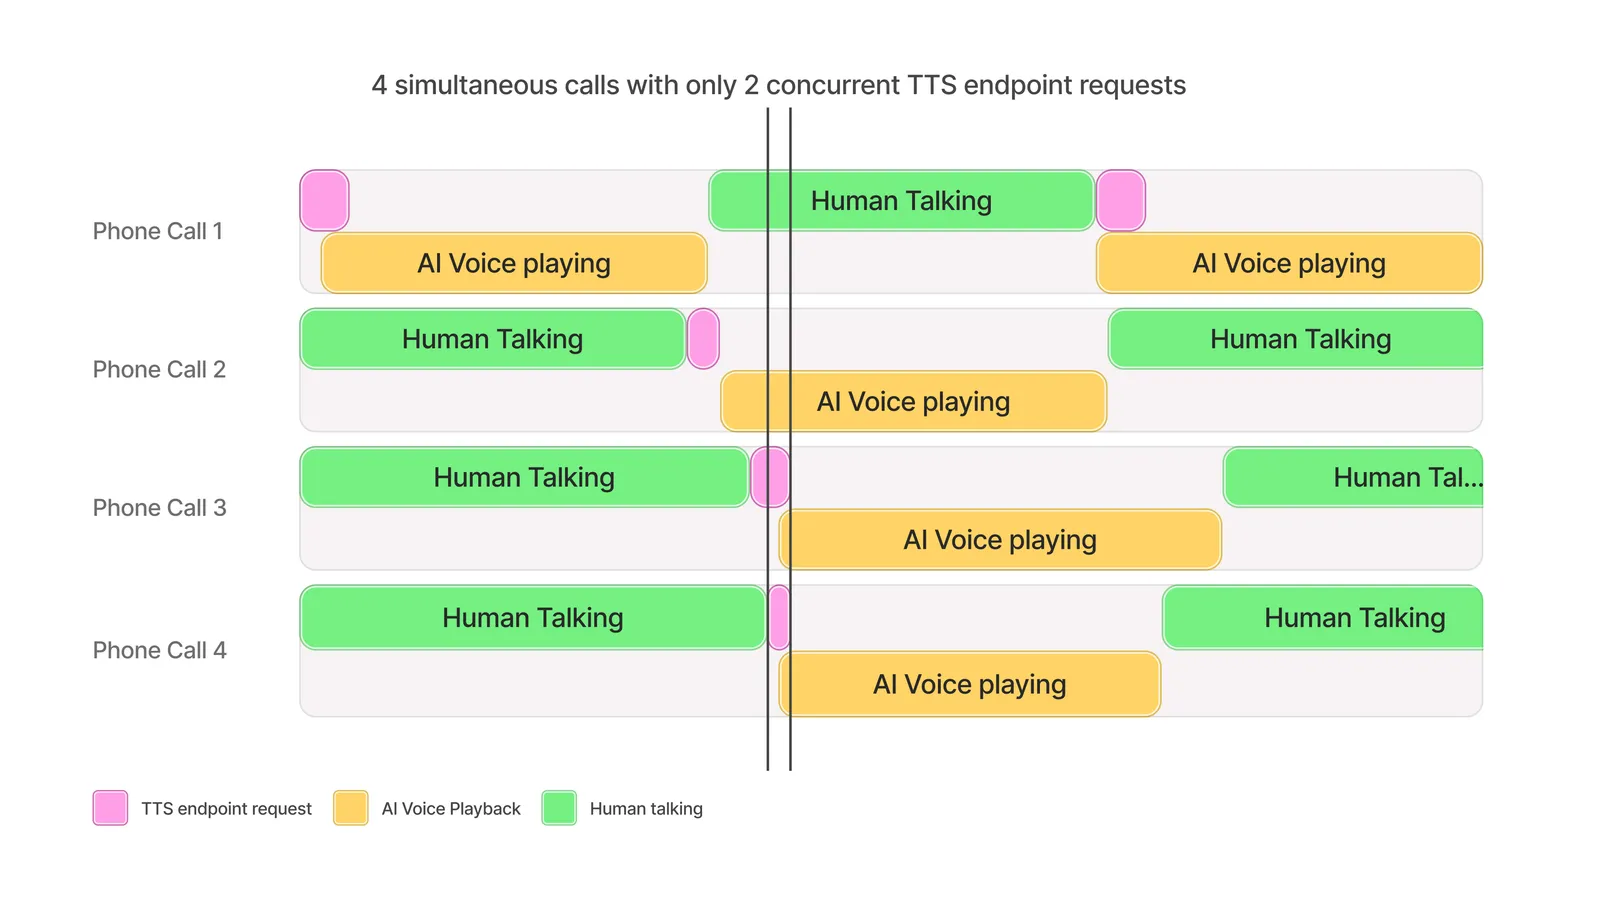
Come regola generale, un limite di concorrenza pari a 5 può in genere supportare fino a circa 100 trasmissioni audio simultanee.
Questo dipende dalla velocità di generazione dell’audio rispetto al tempo necessario per elaborare la richiesta TTS. Il diagramma seguente mostra un esempio di come sia possibile gestire 4 chiamate simultanee con utenti diversi, raggiungendo solo 2 richieste simultanee.
Creare agenti vocali IA
Quando il TTS viene utilizzato per facilitare il dialogo, un limite di concorrenza pari a 5 può supportare circa 100 trasmissioni per conversazioni equilibrate tra agenti IA e partecipanti umani.
Per casi d’uso in cui l’agente IA parla meno frequentemente dell’utente umano, come le interazioni con l’assistenza clienti, potrebbero essere supportate più di 100 conversazioni simultanee.
Voci fuori campo di personaggi
In genere, con un limite di concorrenza pari a 5 è possibile supportare più di 100 voci fuori campo di personaggi simultanee.
Il numero può variare in base alla frequenza dei dialoghi del personaggio, alla durata delle pause e alle azioni di gioco tra una battuta e l’altra.
Doppiaggio dal vivo
I flussi di doppiaggio simultanei seguono generalmente l’euristica indicata.
Se la trasmissione include periodi di pause conversazionali, ad esempio a causa di una colonna sonora, scene visive e così via, potrebbero essere possibili più flussi di doppiaggio simultanei rispetto a quanto suggerito.
Se in qualsiasi momento superi i limiti di concorrenza del tuo piano e usi il piano Enterprise, le richieste al modello potrebbero comunque riuscire, anche se più lentamente, sulla base delle risorse disponibili e senza garanzia.
Per aumentare il limite di concorrenza e la priorità in coda, aggiorna il tuo piano di abbonamento.
I clienti Enterprise possono richiedere un limite di concorrenza più elevato contattando il proprio account manager.
Concorrenza di Text to Dialogue
Le richieste Text to Dialogue vengono misurate in due modi diversi, a seconda di come chiami l’API:
- Gli endpoint HTTP (Crea dialogo e Trasmetti dialogo) contano ai fini del limite di concorrenza standard del tuo piano durante la generazione dell’audio, come qualsiasi altra richiesta Text to Speech.
- Gli endpoint WebSocket, come il WebSocket Text to Dialogue, vengono misurati come sessioni di dialogo. Una connessione aperta occupa una sessione di dialogo per tutto il tempo in cui rimane aperta, indipendentemente dal fatto che l’audio venga generato in quel momento.
La misurazione basata sulle sessioni semplifica la pianificazione della capacità: una connessione corrisponde a una sessione, quindi l’utilizzo non oscilla in base all’attività di generazione. Poiché una sessione viene mantenuta per l’intera connessione anziché solo durante la generazione dell’audio, i limiti delle sessioni di dialogo sono dimensionati per adattarsi a questa nuova metodologia di concorrenza.
Se apri una connessione mentre tutte le sessioni di dialogo del workspace sono in uso, la nuova connessione viene rifiutata con un errore too_many_concurrent_requests. Per liberare sessioni, chiudi le connessioni che non ti servono più: una connessione si chiude automaticamente anche dopo 20 secondi di inattività, a meno che non invii messaggi keep_alive.
Per monitorare le sessioni di dialogo, apri Sviluppatori in fondo alla barra laterale della dashboard, seleziona la scheda Analytics e visualizza la metrica Richieste simultanee nella vista Utilizzo. Le sessioni di dialogo sono riportate come serie distinta, Sessioni Websocket TTD, separata dalle altre richieste simultanee.
Limiti di concorrenza per i test di scalabilità
I test di scalabilità possono essere utili per individuare problemi di scalabilità lato client e verificare che i limiti di concorrenza siano impostati correttamente per il tuo caso d’uso.
Ti consigliamo vivamente di testare workflow end-to-end il più possibile vicini all’utilizzo reale; la metodologia consigliata per riuscirci è simulare e misurare quanti utenti possono essere supportati. È importante:
- Simulare utenti, non richieste grezze
- Simulare il comportamento tipico degli utenti, ad esempio attendendo il termine della riproduzione audio, del parlato dell’utente o della trascrizione prima di effettuare richieste
- Aumentare lentamente il numero di utenti nell’arco di alcuni minuti
- Introdurre casualità nelle tempistiche e nelle dimensioni delle richieste
- Raccogliere metriche di latenza ed eventuali codici di errore restituiti dall’API
Ad esempio, per testare un sistema di agenti progettato per supportare 100 conversazioni simultanee, creeresti fino a 100 singoli “utenti”, ognuno dei quali simula una conversazione. Le conversazioni consistono in genere in un ciclo ripetuto di circa 10 secondi di parlato dell’utente, seguiti da una chiamata API TTS per circa 150 caratteri, seguita da circa 10 secondi di riproduzione audio per l’utente. Pertanto, ogni utente dovrebbe seguire lo schema di effettuare una chiamata API Text-to-Speech websocket per 150 caratteri di testo ogni 20 secondi, introducendo una piccola dose di casualità nel periodo di attesa e nel numero di caratteri richiesti. Il test consisterebbe nell’avviare un utente al secondo fino a raggiungere 100 utenti, quindi eseguire il test per un totale di 10 minuti per verificarne la stabilità complessiva.
Esempio di script per test di scalabilità
Questo esempio usa locust come framework di test con chiamate API dirette all’API ElevenLabs.
Segue l’esempio indicato sopra, testando un sistema di agenti conversazionali in cui ogni utente invia 1 richiesta ogni 20 secondi.