

Modele
Flagowe modele
Text to Speech
Speech to Text
Agenci głosowi
Muzyka
Przegląd modeli
API ElevenLabs oferuje szereg modeli audio zoptymalizowanych pod różne zastosowania, poziomy jakości i wymagania wydajnościowe.
† Mediana, z wyłączeniem opóźnień aplikacji i sieci. Zobacz, jak mierzymy opóźnienie.
Wycofane modele
Model music_v1 jest wycofany i zostanie usunięty 31 stycznia 2027 r.
Model eleven_text_to_sound_v2 jest wycofany i zostanie usunięty 1 marca 2027 r. Aby dalej korzystać z usługi,
przejdź na poniższe modele zastępcze. Jeśli w żądaniach nie ustawiasz
model_id, ustaw go jawnie na model zastępczy.
Modele eleven_turbo_v2_5 i eleven_turbo_v2 są funkcjonalnie równoważne odpowiednio
modelom eleven_flash_v2_5 i eleven_flash_v2, z wyjątkiem tego, że modele Flash mają średnio
niższe opóźnienie. Zalecamy używanie modeli Flash zamiast Turbo we wszystkich
zastosowaniach.
Eleven v4
Eleven v4 to nasz najnowocześniejszy model syntezy mowy, oferujący audio najwyższej jakości, ekspresję i kontrolę nad sposobem odtwarzania głosu. Eleven v4 obsługuje klonowanie głosu o wysokiej wierności, niezawodnie zachowując cechy mówcy w długich generacjach tekstu.
Model sprawdza się w tych scenariuszach:
- Głosy postaci: Idealny do gier i animacji dzięki szerokiemu zakresowi emocji.
- Emocjonalne dialogi: Generuj naturalne, realistyczne dialogi o szerokim zakresie emocji i ze zrozumieniem kontekstu.
- Produkcja audiobooków: Doskonały do długiej narracji o złożonym przekazie emocjonalnym.
- Projekty wielojęzyczne: Utrzymuje spójną jakość głosu przy zmianie języków.
Eleven v4 jest dostępny przez Text to Dialogue API.
Obsługiwane języki
Rodzina modeli Eleven v4 obsługuje ponad 90 języków, w tym:
Afrikaans (af), amharski (am), arabski (ar), ormiański (hy), asamski (as), asturyjski (ast), azerski (az), białoruski (be), bengalski (bn), bośniacki (bs), bułgarski (bg), birmański (my), kantoński (yue), kataloński (ca), cebuański (ceb), chorwacki (hr), czeski (cs), duński (da), niderlandzki (nl), angielski (en), estoński (et), filipiński (fil), fiński (fi), francuski (fr), fulani (pulaar) (ff), galicyjski (gl), gruziński (ka), niemiecki (de), grecki (el), gudźaracki (gu), hausa (ha), hebrajski (he), hindi (hi), węgierski (hu), islandzki (is), indonezyjski (id), włoski (it), japoński (ja), jawajski (jv), kamba (kam), kannada (kn), kazachski (kk), koreański (ko), kirgiski (ky), lao (lo), łotewski (lv), lingala (ln), litewski (lt), luganda (lg), luksemburski (lb), macedoński (mk), malajski (ms), malajalam (ml), maltański (mt), chiński mandaryński (zh), maoryski (mi), marathi (mr), mongolski (mn), nepalski (ne), norweski (no), oksytański (oc), orija (or), paszto (ps), perski (fa), polski (pl), portugalski (pt), pendżabski (pa), rumuński (ro), rosyjski (ru), serbski (sr), szona (sn), sindhi (sd), słowacki (sk), słoweński (sl), somalijski (so), kurdyjski sorani (ckb), hiszpański (es), suahili (sw), szwedzki (sv), tadżycki (tg), tamilski (ta), telugu (te), tajski (th), turecki (tr), ukraiński (uk), urdu (ur), uzbecki (uz), wietnamski (vi), walijski (cy), wolof (wo), zulu (zu).
Eleven v4 Turbo
Eleven v4 Turbo to nasz najnowocześniejszy model syntezy mowy w czasie rzeczywistym, oferujący wysoką jakość audio, ekspresję i kontrolę nad sposobem odtwarzania głosu. Eleven v4 Turbo obsługuje klonowanie głosu o wysokiej wierności i ma medianę opóźnienia wynoszącą ~100 ms. Zobacz, jak mierzymy opóźnienie.
Model sprawdza się w tych scenariuszach:
- Agenci wsparcia: Twórz agentów głosowych, którzy rozwiązują zapytania klientów w czasie rzeczywistym.
- Asystenci AI: Generuj naturalne, realistyczne dialogi o szerokim zakresie emocji i ze zrozumieniem kontekstu.
- Interaktywne postaci: Doskonały do doświadczeń audio z ekspresyjnymi postaciami.
Eleven v4 Turbo jest dostępny przez Text to Dialogue websocket.
Obsługiwane języki
Rodzina modeli Eleven v4 obsługuje ponad 90 języków, w tym:
Afrikaans (af), amharski (am), arabski (ar), ormiański (hy), asamski (as), asturyjski (ast), azerski (az), białoruski (be), bengalski (bn), bośniacki (bs), bułgarski (bg), birmański (my), kantoński (yue), kataloński (ca), cebuański (ceb), chorwacki (hr), czeski (cs), duński (da), niderlandzki (nl), angielski (en), estoński (et), filipiński (fil), fiński (fi), francuski (fr), fulani (pulaar) (ff), galicyjski (gl), gruziński (ka), niemiecki (de), grecki (el), gudźaracki (gu), hausa (ha), hebrajski (he), hindi (hi), węgierski (hu), islandzki (is), indonezyjski (id), włoski (it), japoński (ja), jawajski (jv), kamba (kam), kannada (kn), kazachski (kk), koreański (ko), kirgiski (ky), lao (lo), łotewski (lv), lingala (ln), litewski (lt), luganda (lg), luksemburski (lb), macedoński (mk), malajski (ms), malajalam (ml), maltański (mt), chiński mandaryński (zh), maoryski (mi), marathi (mr), mongolski (mn), nepalski (ne), norweski (no), oksytański (oc), orija (or), paszto (ps), perski (fa), polski (pl), portugalski (pt), pendżabski (pa), rumuński (ro), rosyjski (ru), serbski (sr), szona (sn), sindhi (sd), słowacki (sk), słoweński (sl), somalijski (so), kurdyjski sorani (ckb), hiszpański (es), suahili (sw), szwedzki (sv), tadżycki (tg), tamilski (ta), telugu (te), tajski (th), turecki (tr), ukraiński (uk), urdu (ur), uzbecki (uz), wietnamski (vi), walijski (cy), wolof (wo), zulu (zu).
Eleven v3
Eleven v3 to nasz model syntezy mowy poprzedniej generacji, który tworzy naturalną, realistyczną mowę o szerokim zakresie emocji i ze zrozumieniem kontekstu w wielu językach.
Eleven v3 wprowadza nowe Text to Dialogue API, które pozwala generować naturalne, realistyczne dialogi o szerokim zakresie emocji i ze zrozumieniem kontekstu w wielu językach. Eleven v3 można też używać z Text to Speech API do generowania naturalnej, realistycznej mowy o szerokim zakresie emocji i ze zrozumieniem kontekstu w wielu językach.
Więcej o Text to Dialogue API przeczytasz tutaj.
Obsługiwane języki
Model Eleven v3 obsługuje ponad 70 języków, w tym:
Afrikaans (af), arabski (ar), ormiański (hy), asamski (as), asturyjski (ast), azerski (az), białoruski (be), bengalski (bn), bośniacki (bs), bułgarski (bg), birmański (my), kantoński (yue), kataloński (ca), cebuański (ceb), cziczewa (ny), chorwacki (hr), czeski (cs), duński (da), niderlandzki (nl), angielski (en), estoński (et), filipiński (fil), fiński (fi), francuski (fr), galicyjski (gl), gruziński (ka), niemiecki (de), grecki (el), gudźarati (gu), hausa (ha), hebrajski (he), hindi (hi), węgierski (hu), islandzki (is), indonezyjski (id), irlandzki (ga), włoski (it), japoński (ja), jawajski (jv), kannada (kn), kazachski (kk), kirgiski (ky), koreański (ko), łotewski (lv), lingala (ln), litewski (lt), luksemburski (lb), macedoński (mk), malajski (ms), malajalam (ml), maltański (mt), mandaryński chiński (zh), maoryski (mi), marathi (mr), mongolski (mn), nepalski (ne), norweski (no), oksytański (oc), orija (or), paszto (ps), perski (fa), polski (pl), portugalski (pt), pendżabski (pa), rumuński (ro), rosyjski (ru), serbski (sr), sindhi (sd), słowacki (sk), słoweński (sl), somalijski (so), hiszpański (es), suahili (sw), szwedzki (sv), tadżycki (tg), tamilski (ta), telugu (te), tajski (th), turecki (tr), ukraiński (uk), urdu (ur), uzbecki (uz), wietnamski (vi), walijski (cy), joruba (yo).
Eleven v3 Conversational
Eleven v3 Conversational to nasz model syntezy mowy w czasie rzeczywistym poprzedniej generacji. Tworzy naturalną, realistyczną mowę o szerokim zakresie emocji i ze zrozumieniem kontekstu w wielu językach.
Eleven v3 Conversational wprowadza nowy Text to Dialogue WebSocket, który pozwala generować naturalne, realistyczne dialogi o szerokim zakresie emocji i ze zrozumieniem kontekstu w wielu językach.
Eleven v3 Conversational wprowadza nowy Text to Dialogue WebSocket, który pozwala generować naturalne, realistyczne dialogi o szerokim zakresie emocji i ze zrozumieniem kontekstu w wielu językach.
Więcej o Text to Dialogue WebSocket przeczytasz tutaj.
Obsługiwane języki
Model Eleven v3 obsługuje ponad 70 języków, w tym:
Afrikaans (af), arabski (ar), ormiański (hy), asamski (as), asturyjski (ast), azerski (az), białoruski (be), bengalski (bn), bośniacki (bs), bułgarski (bg), birmański (my), kantoński (yue), kataloński (ca), cebuański (ceb), cziczewa (ny), chorwacki (hr), czeski (cs), duński (da), niderlandzki (nl), angielski (en), estoński (et), filipiński (fil), fiński (fi), francuski (fr), galicyjski (gl), gruziński (ka), niemiecki (de), grecki (el), gudźarati (gu), hausa (ha), hebrajski (he), hindi (hi), węgierski (hu), islandzki (is), indonezyjski (id), irlandzki (ga), włoski (it), japoński (ja), jawajski (jv), kannada (kn), kazachski (kk), kirgiski (ky), koreański (ko), łotewski (lv), lingala (ln), litewski (lt), luksemburski (lb), macedoński (mk), malajski (ms), malajalam (ml), maltański (mt), mandaryński chiński (zh), maoryski (mi), marathi (mr), mongolski (mn), nepalski (ne), norweski (no), oksytański (oc), orija (or), paszto (ps), perski (fa), polski (pl), portugalski (pt), pendżabski (pa), rumuński (ro), rosyjski (ru), serbski (sr), sindhi (sd), słowacki (sk), słoweński (sl), somalijski (so), hiszpański (es), suahili (sw), szwedzki (sv), tadżycki (tg), tamilski (ta), telugu (te), tajski (th), turecki (tr), ukraiński (uk), urdu (ur), uzbecki (uz), wietnamski (vi), walijski (cy), joruba (yo).
Multilingual v2
Eleven Multilingual v2 to model syntezy mowy poprzedniej generacji, uwzględniający emocje. Tworzy naturalną, realistyczną mowę o szerokim zakresie emocji i ze zrozumieniem kontekstu w wielu językach.
Model zapewnia spójną jakość i osobowość głosu we wszystkich obsługiwanych językach, zachowując unikalne cechy i akcent mówcy.
Model wyróżnia się w scenariuszach wymagających wysokiej jakości mowy z niuansami emocjonalnymi:
- Głosy postaci: Idealny do gier i animacji dzięki szerokiemu zakresowi emocji.
- Profesjonalne treści: Dobrze sprawdza się w filmach firmowych i materiałach e-learningowych.
- Projekty wielojęzyczne: Utrzymuje spójną jakość głosu przy zmianie języków.
- Stabilna jakość: Zapewnia spójne audio wysokiej jakości.
Ma wyższe opóźnienie i koszt na znak niż modele Flash, ale oferuje lepszą jakość w projektach, gdzie liczy się realistyczna mowa.
Nasze wielojęzyczne modele v2 obsługują 29 języków:
angielski (USA, Wielka Brytania, Australia, Kanada), japoński, chiński, niemiecki, hindi, francuski (Francja, Kanada), koreański, portugalski (Brazylia, Portugalia), włoski, hiszpański (Hiszpania, Meksyk), indonezyjski, niderlandzki, turecki, filipiński, polski, szwedzki, bułgarski, rumuński, arabski (Arabia Saudyjska, ZEA), czeski, grecki, fiński, chorwacki, malajski, słowacki, duński, tamilski, ukraiński i rosyjski.
Flash v2.5
Eleven Flash v2.5 to model syntezy mowy o niskim opóźnieniu, zaprojektowany do aplikacji czasu rzeczywistego i Agents Platform. Zapewnia wysokiej jakości mowę z medianą opóźnienia ~100 ms† w 32 językach.
Model równoważy szybkość i jakość, dzięki czemu idealnie nadaje się do aplikacji interaktywnych, zachowując naturalne brzmienie i spójne cechy głosu w różnych językach.
Model szczególnie dobrze sprawdza się w:
- Agents Platform: Doskonały do agentów głosowych i chatbotów działających w czasie rzeczywistym.
- Aplikacjach interaktywnych: Idealny do gier i aplikacji wymagających natychmiastowej reakcji.
- Przetwarzaniu na dużą skalę: Wydajny przy masowej zamianie tekstu na mowę.
Dzięki niższej cenie generacji API i niskiemu opóźnieniu Flash v2.5 to opłacalny wybór dla każdego, kto potrzebuje szybkiej i niezawodnej syntezy mowy w wielu językach.
Flash v2.5 obsługuje 32 języki — wszystkie języki z modeli v2 oraz:
węgierski, norweski i wietnamski
† Mediana, z wyłączeniem opóźnień aplikacji i sieci. Zobacz, jak mierzymy opóźnienie.
Uwagi
Normalizacja tekstu z liczbami
W Flash v2.5 liczby domyślnie nie są normalizowane tak, jak możesz się tego spodziewać. Na przykład numery telefonów mogą być odczytywane w sposób niejasny dla użytkownika. Podobnie jest z datami i walutami.
Domyślnie normalizacja jest wyłączona w Flash v2.5, aby zachować niskie opóźnienie. Klienci Enterprise mogą jednak włączyć normalizację tekstu dla modeli v2.5, ustawiając w żądaniu parametr apply_text_normalization na “on”.
Model Multilingual v2 lepiej normalizuje liczby, dlatego zalecamy go dla numerów telefonów i innych przypadków, w których normalizacja liczb jest ważna.
W aplikacjach o niskim opóźnieniu lub aplikacjach Agents Platform najlepiej zlecić LLM normalizację tekstu przed przekazaniem go do modelu TTS albo użyć parametru apply_text_normalization (dla modeli v2.5 tylko w planach Enterprise).
Przewodnik po wyborze modelu
Aby dowiedzieć się, który model najlepiej pasuje do twoich wymagań i zastosowania, zobacz przewodnik po wyborze modelu.
Wymagania
Zastosowanie
Limity znaków
Maksymalna liczba znaków obsługiwana w pojedynczym żądaniu zamiany tekstu na mowę zależy od modelu.
Scribe v3
Scribe v3 to nasz najdokładniejszy model rozpoznawania mowy dla nagranego audio. Jest następcą Scribe v2 i korzysta z tego samego API Speech to Text (POST /v1/speech-to-text). Przekaż scribe_v3 jako model_id.
Model sprawdza się w przypadku:
- Narzędzi do spotkań i notatek: Transkrypcje nagranych spotkań i rozmów z oznaczeniem mówców
- Mediów: Napisy i podpisy z oznaczeniem mówców oraz znacznikami czasu na poziomie słów
- Edukacji: Nagrane wykłady z mową z akcentem lub mieszaną językowo
- Centrów kontaktowych: Nagrane rozmowy do kontroli jakości i analiz
W porównaniu z Scribe v2, Scribe v3 oferuje:
- Mniej błędów transkrypcji. W benchmarku FLEURS dla 102 języków Scribe v3 obniża współczynnik błędów słów (WER) z 16,94% do 12,38%, czyli o 27% mniej błędów słów niż Scribe v2, i poprawia wyniki w każdym testowanym języku.
- Dokładniejsze oznaczenia mówców w audio z wieloma osobami.
- Parametr
numbers_format, który zapisuje liczby cyframi (42) lub słowami (czterdzieści dwa). - Parametr
secondary_language_codes, który wymienia inne języki spodziewane w audio oboklanguage_code, aby zwiększyć dokładność w audio wielojęzycznym.
Zobacz opcje liczb i języków, aby użyć nowych parametrów.
ElevenLabs oblicza FLEURS WER dla każdego klipu, a następnie wyciąga średnią dla języka. Daje to wyższe wartości niż powszechnie publikowany WER dla całego korpusu, więc liczb nie można porównywać z wynikami obliczonymi inaczej.
Scribe v3 zachowuje zestaw funkcji Scribe v2:
- Obsługa ponad 90 języków
- Diarizacja mówców, do 32 mówców
- Znaczniki czasu na poziomie słów lub znaków
- Tagowanie zdarzeń audio
- Podpowiedzi keyterm, do 1000 terminów
- Wykrywanie encji
- Edycja transkrypcji
- Brak trybu dosłownego
- Eksport do dodatkowych formatów, takich jak SRT, DOCX i PDF
- Webhooki dla wyników asynchronicznych
Aktualizacja z Scribe v2
Zmień model_id z scribe_v2 na scribe_v3. Dotychczasowe parametry żądania działają bez zmian. Scribe v2 pozostaje dostępny.
Scribe v3 Live
Scribe v3 Live to nasz najdokładniejszy model rozpoznawania mowy w czasie rzeczywistym. Jest następcą Scribe v2 Realtime i korzysta z tego samego WebSocketu czasu rzeczywistego (wss://api.elevenlabs.io/v1/speech-to-text/realtime). Przekaż scribe_v3_live jako parametr zapytania model_id.
Scribe v3 Live to model zamiany mowy na tekst. Jest oddzielony od Eleven Realtime, modeli zamiany mowy na mowę dla agentów głosowych.
Model sprawdza się w przypadku:
- Agentów głosowych i centrów kontaktowych: Zatwierdzanie tury, gdy rozmówca skończy mówić, a nie przy pierwszej pauzie
- Napisów na żywo: Transkrypcje w czasie rzeczywistym ze znacznikami czasu na poziomie słów
- Edukacji i nauki języków: Mówcy z akcentem oraz mówcy przełączający języki
- Dyktowania i asystentów: Słownictwo branżowe dzięki keytermom
W porównaniu z Scribe v2 Realtime, Scribe v3 Live oferuje:
- Mniej błędów transkrypcji. W benchmarku FLEURS dla 73 języków Scribe v3 Live ma o 44% niższy semantyczny WER niż Scribe v2 Realtime. W Earnings-22 (angielskie rozmowy finansowe z akcentem) WER spada z 5,99% do 3,91%, a w VoxPopuli (wypowiedzi w Parlamencie Europejskim) z 2,13% do 1,71%.
- Przewidywanie tury. Przy
commit_strategy=turn_predictionserwer zatwierdza segment, gdy model przewidzi, że mówca zakończył swoją turę, zamiast czekać wyłącznie na ciszę. - Tryb wielojęzyczny. Przy
multilang_mode=truekażdy język jest transkrybowany własnym pismem, także po zmianie języka w środku zdania. - Bibliotekę keytermów zawierającą do 10 000 terminów, z których model korzysta tylko wtedy, gdy usłyszy prawdopodobne dopasowanie, oprócz 50 standardowych keytermów.
- Diarizację w czasie rzeczywistym. Przy
diarize=truerobocze oznaczenia mówców pojawiają się w częściowych transkrypcjach, a po każdej zatwierdzonej transkrypcji pojawia się osobna transkrypcja z diarizacją, bez opóźniania zatwierdzonego tekstu.
Scribe v3 Live zachowuje zestaw funkcji Scribe v2 Realtime:
- Obsługa ponad 90 języków z automatycznym wykrywaniem języka
- Obsługa streamingu: wysyłaj audio w fragmentach i odbieraj transkrypcje w czasie rzeczywistym
- Wiele formatów audio: PCM (od 8 kHz do 48 kHz) i kodowanie μ-law
- Ręczne strategie zatwierdzania i Voice Activity Detection (VAD)
- Znaczniki czasu na poziomie słów
secondary_languagesdo ograniczenia wykrywania języka do zestawu języków- Podpowiedzi keyterm, do 50 terminów
- Wykrywanie encji
- Edycja transkrypcji
- Filtrowanie dźwięków w tle
Aktualizacja z Scribe v2 Realtime
Zmień model_id z scribe_v2_realtime na scribe_v3_live. Domyślną strategią zatwierdzania nadal jest manual, więc istniejące integracje działają tak samo, dopóki nie ustawisz commit_strategy na turn_prediction. Scribe v2 Realtime pozostaje dostępny.
Oficjalne SDK nie obsługują jeszcze przewidywania tury, trybu wielojęzycznego ani biblioteki keytermów. Aby z nich korzystać, połącz się bezpośrednio z API WebSocket.
Scribe v2
Scribe v2 to nasz poprzedni najnowocześniejszy model rozpoznawania mowy, zastąpiony przez Scribe v3. Zaprojektowano go do dokładnej transkrypcji w ponad 90 językach. Zapewnia precyzyjne znaczniki czasu na poziomie słów oraz zaawansowane funkcje, takie jak diarizacja mówców i dynamiczne tagowanie audio.
Model świetnie sprawdza się tam, gdzie potrzebna jest dokładna zamiana mowy na tekst:
- Usługi transkrypcji: Idealny do konwersji treści audio/wideo na tekst
- Dokumentacja spotkań: Idealny do rejestrowania i dokumentowania rozmów
- Analiza treści: Dobrze nadaje się do przetwarzania i analizy treści audio
- Rozpoznawanie wielojęzyczne: Obsługuje dokładną transkrypcję w ponad 90 językach
Najważniejsze funkcje:
- Dokładna transkrypcja ze znacznikami czasu na poziomie słów
- Diarizacja mówców dla audio z wieloma osobami
- Dynamiczne tagowanie audio dla lepszego kontekstu
- Obsługa ponad 90 języków
- Wykrywanie encji
- Podpowiedzi keyterm
- Edycja transkrypcji
Więcej o Scribe v2 przeczytasz tutaj.
Scribe v2 Realtime
Scribe v2 Realtime to nasz poprzedni najnowocześniejszy model rozpoznawania mowy na żywo, zastąpiony przez Scribe v3 Live. Transkrybuje ponad 90 języków, a mediana czasu do zatwierdzonej transkrypcji wynosi ~150 ms. Zobacz, jak mierzymy opóźnienie.
Model świetnie sprawdza się w zastosowaniach konwersacyjnych:
- Transkrypcja spotkań na żywo: Idealny do transkrypcji w czasie rzeczywistym
- Agenci AI: Idealny do rozmów na żywo
- Rozpoznawanie wielojęzyczne: Obsługuje dokładną transkrypcję w ponad 90 językach z automatycznym rozpoznawaniem języka
Najważniejsze funkcje:
- Bardzo niskie opóźnienie: otrzymuj zatwierdzone transkrypcje z medianą opóźnienia ~150 milisekund
- Obsługa streamingu: wysyłaj audio w fragmentach i odbieraj transkrypcje w czasie rzeczywistym
- Wiele formatów audio: obsługa PCM (od 8 kHz do 48 kHz) i kodowania μ-law
- Voice Activity Detection (VAD): automatyczne segmentowanie mowy na podstawie wykrywania ciszy
- Ręczna kontrola zatwierdzania: pełna kontrola nad finalizowaniem segmentów transkrypcji
- Wykrywanie encji
- Redakcja encji
- Edycja transkrypcji
Więcej o Scribe v2 Realtime przeczytasz tutaj.
Scribe v2 Medical
Scribe v2 Medical to wsadowy model rozpoznawania mowy wyspecjalizowany w audio medycznym i klinicznym. To Finetune Scribe v2, który poprawia rozpoznawanie nazw leków, anatomii, patologii i dyktowania klinicznego, zachowując dokładność Scribe v2 w codziennej mowie. Korzysta z tego samego API Speech to Text co Scribe v2 i jest rozliczany w tej samej stawce. Przekaż scribe_v2_medical jako model_id.
Przeznaczenie
Scribe v2 Medical to wsadowy model API Speech-to-Text przeznaczony dla deweloperów i organizacji do integracji z aplikacjami, które przekształcają audio kliniczne, w tym rozmowy lekarzy z pacjentami, dyktowanie oraz rozmowy dotyczące przyjęć i koordynacji opieki, w robocze transkrypcje do dokumentacji i powiązanych procesów administracyjnych. Powstały tekst jest przeznaczony do weryfikacji i korekty przez pracownika ochrony zdrowia lub innego upoważnionego użytkownika przed użyciem. Scribe v2 Medical nie jest przeznaczony do interpretowania informacji klinicznych ani udzielania diagnoz, zaleceń terapeutycznych, podejmowania decyzji klinicznych czy innego rodzaju wskazówek klinicznych.
Model sprawdza się w przypadku:
- Dokumentacji klinicznej: Wizyty i notatki, w których terminy medyczne pojawiają się w trakcie rozmowy
- Dyktowania: Gęste sekwencje leków, dawek i ustaleń
- Rozmów dotyczących przyjęć i koordynacji: Pacjenci opisujący własne dolegliwości, często przez telefon
- Procesów zgodności: Połącz z wykrywaniem encji dla kategorii PHI
Najważniejsze funkcje:
- Taka sama struktura żądania jak w Scribe v2 (
keyterms,entity_detection,no_verbatim, diarizacja, znaczniki czasu) - Lepsze rozpoznawanie nazw leków oraz terminów anatomicznych i patologicznych
- Bez pogorszenia wyników dla codziennej mowy w porównaniu z Scribe v2
- Obsługa ponad 90 języków
- Diarizacja mówców dla audio z wieloma osobami
- Dynamiczne tagowanie audio
- Wykrywanie encji, w tym kategorii PHI
Scribe v2 Medical to model wsadowy. Do transkrypcji na żywo użyj Scribe v2 Realtime.
Scribe v2 Medical kwalifikuje się do HIPAA; dla klientów Enterprise dostępne są umowy Business Associate Agreement oraz Zero Retention Mode (ZRM). Gdy ZRM jest włączony, wejściowe audio i wyjściowy tekst są usuwane natychmiast po zakończeniu każdego żądania. ElevenLabs niczego nie przechowuje, a twoja aplikacja otrzymuje pełną odpowiedź API i zachowuje transkrypcje pod własną kontrolą.
Firmy wymagające zgodności z HIPAA muszą skontaktować się z działem sprzedaży ElevenLabs Sales, aby podpisać Business Associate Agreement (BAA) przed wysłaniem chronionych informacji zdrowotnych.
Więcej o Speech to Text przeczytasz tutaj.
SFX v3
SFX v3 (eleven_text_to_sound_v3) to nasz najnowszy model efektów dźwiękowych. Korzysta z tego samego API Sound Effects co eleven_text_to_sound_v2: aby go użyć, ustaw model_id na eleven_text_to_sound_v3. eleven_text_to_sound_v2 nadal jest modelem domyślnym, ale jest przestarzały i zostanie usunięty 1 marca 2027 r.
W porównaniu z eleven_text_to_sound_v2, SFX v3:
- Wykonuje kilka instrukcji w jednym promptcie, np. „Kibice piłkarscy wiwatują, słychać upadającą piłkę, tłum buczy”.
- Obsługuje prompty zawierające muzykę lub wokale, np. „Chór gospel śpiewający dzień dobry”.
- Generuje bardziej naturalnie brzmiące wyniki.
- Rzadziej powoduje clipping przy dźwiękach o wysokiej częstotliwości, takich jak gongi, dzwonki i gwizdki.
Wyniki zależą od promptu, dlatego przed zmianą porównaj oba modele na własnych promptach.
SFX v3 obsługuje zapętlanie. Ustaw loop na true, aby wygenerować efekt dźwiękowy, który płynnie się zapętla.
W ElevenCreative SFX v3 jest dostępny w Sound Effects, Flows i Studio.
Więcej o efektach dźwiękowych przeczytasz tutaj.
Eleven Realtime
Eleven Realtime to nowa klasa modeli Speech to Speech do tworzenia naturalnych agentów głosowych. Każdy model Realtime to kompletny agent głosowy: rozpoznawanie mowy, wykrywanie aktywności głosowej i obsługa tur, LLM oraz zamiana tekstu na mowę, wybrane i dostrojone przez ElevenLabs tak, by współpracowały jako jeden system. Wybierz model Realtime, a otrzymasz dobrze działającego agenta dzięki jednej decyzji, bez komponentów do konfiguracji.
Dostępne są dwa modele Realtime.
Eleven Realtime v1 Mini jest zoptymalizowany pod szybkie, naturalne rozmowy i dobrze sprawdza się w następujących sytuacjach:
- Asystenci AI: Szybki, ekspresyjny dialog, w którym sama rozmowa jest produktem.
- Korepetytorzy edukacyjni: Naturalna wymiana zdań, która dotrzymuje kroku uczącemu się.
- Interaktywne postacie: Ekspresyjne postacie do gier i rozrywki.
Eleven Realtime v1 Max jest zoptymalizowany pod złożone zadania i dobrze sprawdza się w następujących sytuacjach:
- Obsługa klienta: Rozwiązywanie zapytań wymagających realizacji procesu i wyszukiwania informacji.
- Kwalifikacja leadów: Ustrukturyzowane rozmowy, które zbierają informacje i określają kolejne kroki.
- Wieloetapowe workflow: Zadania, które wywołują narzędzia, aby wyszukiwać informacje lub wykonywać działania.
Najważniejsze funkcje:
- Rozpoznawanie mowy, obsługa tur, model językowy i głos w jednym wyborze modelu
- Naturalna obsługa tur i przerwań
- Wywoływanie narzędzi
- Konfigurowalne głosy z biblioteki głosów ElevenLabs
- Obsługa ponad 90 języków
- Przełączanie między v1 Mini a v1 Max przez wybór modelu, bez zmiany integracji
Eleven Realtime jest dostępny w ElevenAgents, gdzie wybierasz model Realtime z listy modeli, oraz przez Realtime API, zaprojektowane tak, by było zgodne z Realtime API OpenAI przez WebSocket. Jeśli już korzystasz z Realtime API OpenAI, zobacz przewodnik migracji.
Obsługiwane języki
Modele Realtime obsługują ponad 90 języków. Zobacz listę języków Eleven v4.
Więcej o Eleven Realtime przeczytasz tutaj.
Eleven Music
Eleven Music to nasz studyjnej jakości model generowania muzyki. Umożliwia generowanie muzyki w dowolnym stylu za pomocą promptów w języku naturalnym.
Model doskonale sprawdza się w następujących sytuacjach:
- Ścieżki dźwiękowe do gier: Twórz wciągające ścieżki dźwiękowe do gier
- Tła do podcastów: Ulepsz podcasty profesjonalną muzyką
- Marketing: Dodawaj muzykę w tle do rolek reklamowych
Najważniejsze funkcje:
- Pełna kontrola nad gatunkiem, stylem i strukturą
- Wokale lub sama muzyka instrumentalna
- Wiele języków, w tym angielski, hiszpański, niemiecki, japoński i inne
- Edytuj dźwięk i tekst poszczególnych części lub całego utworu
Więcej o Eleven Music przeczytasz tutaj.
Współbieżność i priorytet
Twój plan subskrypcji określa, ile żądań można przetwarzać jednocześnie oraz poziom priorytetu żądań w kolejce. Speech to Text ma wyższy limit współbieżności. Po osiągnięciu limitu współbieżności kolejne żądania są przetwarzane w kolejce razem z żądaniami o niższym priorytecie. W praktyce zwykle dodaje to tylko około 50 ms opóźnienia.
Aby oszacować potrzebny limit współbieżności dla swojego ruchu, użyj kalkulatora współbieżności.
Nagłówki odpowiedzi zawierają current-concurrent-requests i maximum-concurrent-requests, których możesz używać do monitorowania współbieżności.
Żądania API na minutę a żądania współbieżne
Ważne jest, aby rozumieć, że żądania API na minutę i żądania współbieżne to różne metryki zależne od sposobu użycia.
Liczba żądań API na minutę może różnić się od liczby żądań współbieżnych, ponieważ zależy od czasu trwania każdego żądania i sposobu ich grupowania.
Przykład 1: Żądania rozłożone w czasie Jeśli masz 180 żądań na minutę, z których każde kończy się po 1 sekundzie, i wysyłasz je co 0,33 sekundy, maksymalna i średnia liczba żądań współbieżnych wyniesie 3, ponieważ zawsze będą trwały 3 żądania.
Przykład 2: Żądania wsadowe Jeśli jednak masz inny wzorzec użycia, na przykład 180 żądań na minutę, z których każde kończy się po 3 sekundach, ale wszystkie są wysyłane naraz, maksymalna liczba żądań współbieżnych wyniesie 180, a średnia 9 (w pierwszych 3 sekundach minuty było naraz 180 żądań, a przez ostatnie 57 sekund — 0 żądań).
Ponieważ nasz system uwzględnia współbieżność, liczba żądań na minutę ma mniejsze znaczenie niż czas trwania każdego żądania i moment ich wysłania.
Sposób wysyłania żądań do endpointów wpływa na limity współbieżności:
- W HTTP każde żądanie osobno wlicza się do limitu współbieżności.
- W WebSocket Text to Speech do limitu współbieżności wlicza się tylko czas, w którym nasz model generuje audio. Oznacza to, że przez większość czasu otwarty websocket w ogóle nie wlicza się do tego limitu.
- WebSockety Text to Dialogue działają inaczej: każde otwarte połączenie rezerwuje jedną sesję dialogową z osobnej puli na cały czas jego trwania, a audio generowane przez połączenie nie wlicza się do standardowego limitu współbieżności. Dzięki temu łatwiej to zrozumieć: jedno połączenie to jedna sesja, a limity sesji dialogowych są dostosowane do tej nowej metody współbieżności. Zobacz współbieżność Text to Dialogue.
Jak rozumieć limity współbieżności
Limitu współbieżności przypisanego do twojego planu nie należy interpretować jako maksymalnej liczby jednoczesnych rozmów, połączeń telefonicznych, nałożonych głosów postaci itp., które można obsłużyć naraz. Rzeczywista liczba zależy od kilku czynników, w tym użytych głosów AI i specyfiki zastosowania.
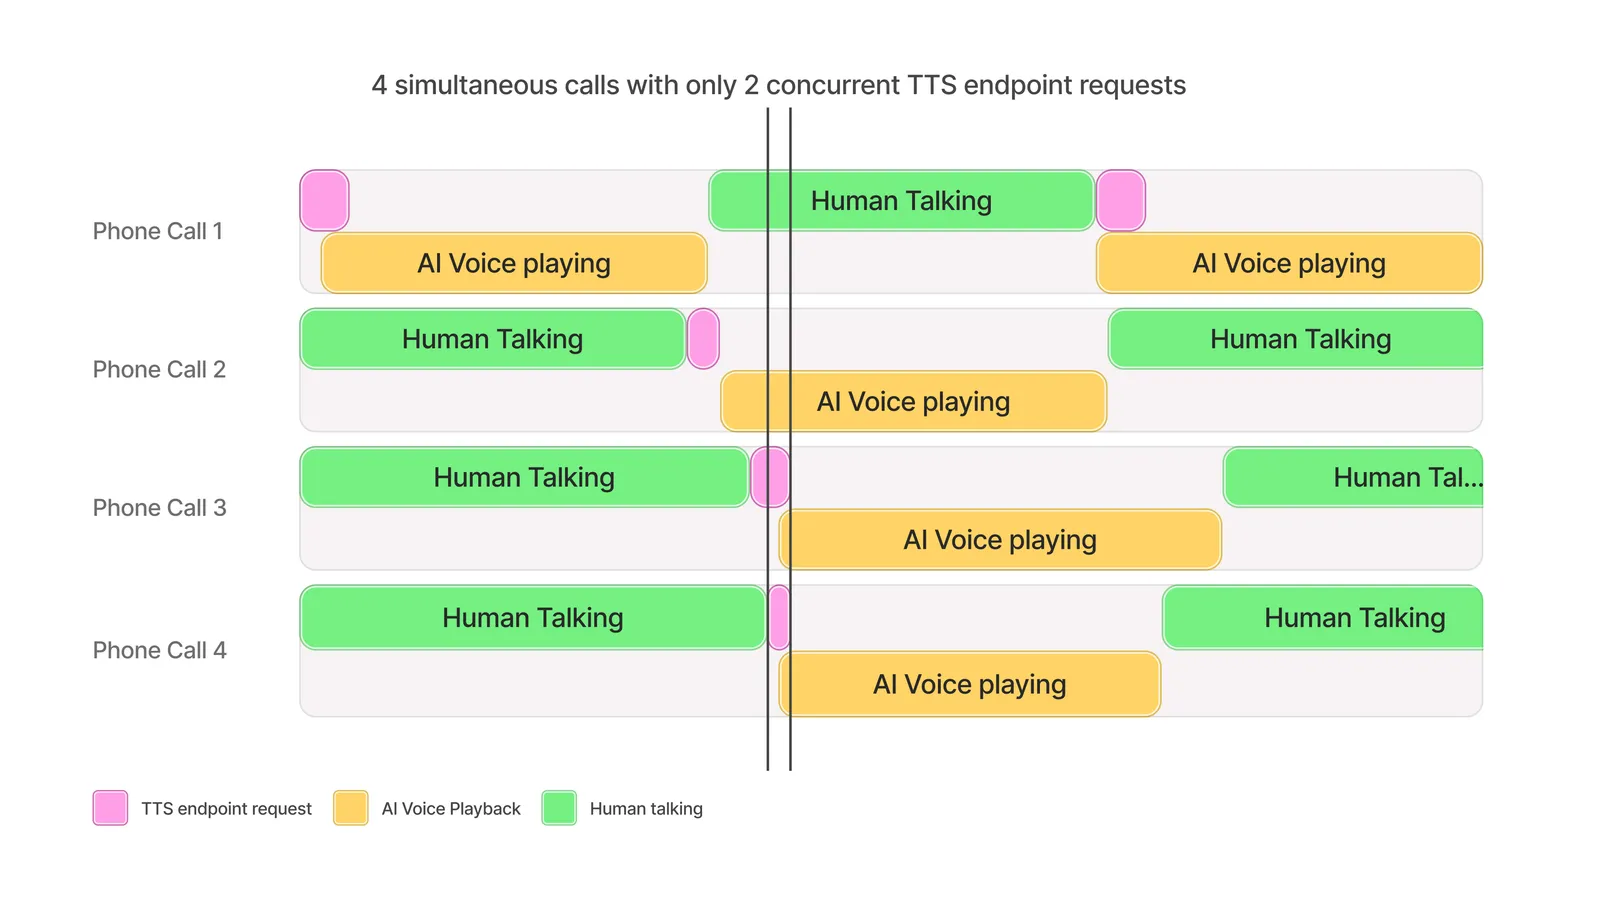
Zasadniczo limit współbieżności wynoszący 5 może zazwyczaj obsłużyć około 100 jednoczesnych transmisji audio.
Wynika to z szybkości generowania audio w porównaniu z czasem przetwarzania żądania TTS. Poniższy diagram pokazuje przykład obsługi 4 jednoczesnych rozmów z różnymi użytkownikami przy zaledwie 2 jednoczesnych żądaniach.
Tworzenie agentów głosowych AI
Gdy TTS służy do prowadzenia dialogu, limit współbieżności wynoszący 5 może obsłużyć około 100 transmisji przy zrównoważonych rozmowach między agentami AI a ludźmi.
W zastosowaniach, w których agent AI mówi rzadziej niż człowiek, na przykład w kontaktach z obsługą klienta, można obsłużyć ponad 100 jednoczesnych rozmów.
Nałożone głosy postaci
Zwykle przy limicie współbieżności wynoszącym 5 można obsłużyć ponad 100 jednoczesnych nałożonych głosów postaci.
Liczba może się różnić zależnie od częstotliwości dialogów postaci, długości przerw i działań w grze między kwestiami.
Dubbing na żywo
Jednoczesne strumienie dubbingu zwykle odpowiadają podanej regule orientacyjnej.
Jeśli transmisja zawiera okresy przerw w rozmowie, np. z powodu ścieżki dźwiękowej, scen wizualnych itp., możliwa może być większa liczba jednoczesnych strumieni dubbingu niż sugerowana.
Jeśli w dowolnym momencie przekroczysz limity współbieżności swojego planu i korzystasz z planu Enterprise, żądania modelu mogą nadal się powieść, choć wolniej, zależnie od dostępnej pojemności i na zasadzie best effort.
Aby zwiększyć limit współbieżności i priorytet w kolejce, ulepsz swój plan subskrypcji.
Klienci Enterprise mogą poprosić o wyższy limit współbieżności, kontaktując się z opiekunem konta.
Współbieżność Text to Dialogue
Żądania Text to Dialogue są rozliczane na dwa różne sposoby, zależnie od tego, jak wywołujesz API:
- Endpointy HTTP (Create dialogue i Stream dialogue) wliczają się do standardowego limitu współbieżności twojego planu podczas generowania audio, tak jak każde inne żądanie Text to Speech.
- Endpointy WebSocket, takie jak Text to Dialogue WebSocket, są rozliczane jako sesje dialogowe. Otwarte połączenie zajmuje sesję dialogową przez cały czas jego trwania, niezależnie od tego, czy audio jest obecnie generowane.
Rozliczanie oparte na sesjach ułatwia planowanie pojemności: jedno połączenie to jedna sesja, więc wykorzystanie nie zmienia się wraz z aktywnością generowania. Ponieważ sesja jest zajęta przez cały czas połączenia, a nie tylko podczas generowania audio, limity sesji dialogowych są dostosowane do tej nowej metody współbieżności.
Jeśli otworzysz połączenie, gdy wszystkie sesje dialogowe w obszarze roboczym są używane, nowe połączenie zostanie odrzucone z błędem too_many_concurrent_requests. Aby zwolnić sesje, zamknij niepotrzebne połączenia — połączenie zamknie się też automatycznie po 20 sekundach bezczynności, chyba że wysyłasz wiadomości keep_alive.
Aby monitorować sesje dialogowe, otwórz Developers na dole paska bocznego panelu, wybierz kartę Analytics i zobacz metrykę Concurrent requests w widoku Usage. Sesje dialogowe są raportowane jako osobna seria, TTD Websocket Sessions, oddzielnie od innych żądań współbieżnych.
Testowanie limitów współbieżności na dużą skalę
Testy na dużą skalę mogą pomóc wykryć problemy ze skalowaniem po stronie klienta i sprawdzić, czy limity współbieżności są prawidłowo ustawione dla twojego zastosowania.
Zdecydowanie zalecamy testowanie workflow end-to-end jak najbliższych rzeczywistemu użyciu. Najlepiej symulować i mierzyć liczbę obsługiwanych użytkowników. Ważne jest, aby:
- Symulować użytkowników, a nie surowe żądania
- Symulować typowe zachowania użytkowników, takie jak oczekiwanie na odtworzenie audio, zakończenie mówienia przez użytkownika lub transkrypcji przed wysłaniem żądań
- Powoli zwiększać liczbę użytkowników przez kilka minut
- Wprowadzać losowość do czasu żądań i ich rozmiaru
- Rejestrować metryki opóźnień i wszystkie kody błędów zwracane przez API
Na przykład, aby przetestować system agentów zaprojektowany do obsługi 100 jednoczesnych rozmów, utwórz do 100 osobnych „użytkowników”, z których każdy symuluje rozmowę. Rozmowy zwykle składają się z powtarzalnego cyklu: około 10 sekund mówienia użytkownika, następnie wywołanie TTS API dla około 150 znaków, a potem około 10 sekund odtwarzania audio użytkownikowi. Dlatego każdy użytkownik powinien co 20 sekund wykonywać wywołanie WebSocket Text-to-Speech API dla 150 znaków tekstu, z niewielką losowością w czasie oczekiwania i liczbie żądanych znaków. Test polegałby na uruchamianiu jednego użytkownika na sekundę, aż będzie ich 100, a następnie na testowaniu przez łącznie 10 minut, aby sprawdzić ogólną stabilność.
Przykładowy skrypt do testów na dużą skalę
Ten przykład używa locust jako frameworka testowego z bezpośrednimi wywołaniami API ElevenLabs.
Jest zgodny z powyższym przykładem i testuje system agenta konwersacyjnego, w którym każdy użytkownik wysyła 1 żądanie co 20 sekund.