

Modeller
Flaggskeppsmodeller
Text to Speech
Speech to Text
Röstassistenter
Musik
Modellöversikt
ElevenLabs API erbjuder en rad ljudmodeller som är optimerade för olika användningsområden, kvalitetsnivåer och prestandakrav.
† Median, exklusive program- och nätverkslatens. Se hur latens mäts.
Utfasade modeller
Modellen music_v1 är utfasad och tas bort den 31 januari 2027. Modellen
eleven_text_to_sound_v2 är utfasad och tas bort den 1 mars 2027. Migrera
till ersättningsmodellerna nedan för fortsatt tjänst. Om dina förfrågningar inte anger
model_id ska du ange ersättningsmodellen uttryckligen.
Modellerna eleven_turbo_v2_5 och eleven_turbo_v2 är funktionellt likvärdiga med
modellerna eleven_flash_v2_5 respektive eleven_flash_v2, förutom att latensen för Flash-
modellerna i genomsnitt är lägre. Vi rekommenderar att du använder Flash-modellerna i stället för Turbo-modellerna i alla
användningsfall.
Eleven v4
Eleven v4 är vår marknadsledande talsyntesmodell som levererar vårt ljud av högsta kvalitet, stor uttrycksfullhet och kontroll över hur röster framförs. Eleven v4 stöder röstkloning med hög kvalitet och bevarar talarens röst på ett tillförlitligt sätt även i långa textgenereringar.
Modellen fungerar bra i följande scenarier:
- Röstpålägg för karaktärer: Perfekt för spel och animation tack vare sitt känslomässiga omfång.
- Känslomässig dialog: Generera naturlig, verklighetstrogen dialog med stort känslomässigt omfång och kontextförståelse.
- Ljudboksproduktion: Perfekt för lång berättarröst med komplex känslomässig leverans.
- Flerspråkiga projekt: Bibehåller jämn röstkvalitet vid språkbyten.
Eleven v4 är tillgänglig via Text to Dialogue API.
Språk som stöds
Modellfamiljen Eleven v4 har stöd för över 90 språk, bland annat:
Afrikaans (af), amhariska (am), arabiska (ar), armeniska (hy), assamesiska (as), asturiska (ast), azerbajdzjanska (az), belarusiska (be), bengaliska (bn), bosniska (bs), bulgariska (bg), burmesiska (my), kantonesiska (yue), katalanska (ca), cebuano (ceb), kroatiska (hr), tjeckiska (cs), danska (da), nederländska (nl), engelska (en), estniska (et), filippinska (fil), finska (fi), franska (fr), fulfulde (pulaar) (ff), galiciska (gl), georgiska (ka), tyska (de), grekiska (el), gujarati (gu), hausa (ha), hebreiska (he), hindi (hi), ungerska (hu), isländska (is), indonesiska (id), italienska (it), japanska (ja), javanesiska (jv), kamba (kam), kannada (kn), kazakiska (kk), koreanska (ko), kirgiziska (ky), lao (lo), lettiska (lv), lingala (ln), litauiska (lt), luganda (lg), luxemburgiska (lb), makedonska (mk), malajiska (ms), malayalam (ml), maltesiska (mt), mandarin (zh), maori (mi), marathi (mr), mongoliska (mn), nepalesiska (ne), norska (no), occitanska (oc), odia (or), pashto (ps), persiska (fa), polska (pl), portugisiska (pt), punjabi (pa), rumänska (ro), ryska (ru), serbiska (sr), shona (sn), sindhi (sd), slovakiska (sk), slovenska (sl), somaliska (so), soranisk kurdiska (ckb), spanska (es), swahili (sw), svenska (sv), tadzjikiska (tg), tamil (ta), telugu (te), thailändska (th), turkiska (tr), ukrainska (uk), urdu (ur), uzbekiska (uz), vietnamesiska (vi), walesiska (cy), wolof (wo), zulu (zu).
Eleven v4 Turbo
Eleven v4 Turbo är vår marknadsledande modell för talsyntes i realtid som levererar ljud av hög kvalitet, stor uttrycksfullhet och kontroll över hur röster framförs. Eleven v4 Turbo stöder röstkloning med hög kvalitet och har en medianlatens på ~100 ms. Se hur latens mäts.
Modellen fungerar bra i följande scenarier:
- Supportassistenter: Driv röstassistenter som löser kundfrågor i realtid.
- AI-assistentar: Generera naturlig, verklighetstrogen dialog med stort känslomässigt omfång och kontextförståelse.
- Interaktiva karaktärer: Utmärkt för ljudupplevelser med uttrycksfulla karaktärer.
Eleven v4 Turbo är tillgänglig via Text to Dialogue-websocket.
Språk som stöds
Modellfamiljen Eleven v4 har stöd för över 90 språk, bland annat:
Afrikaans (af), amhariska (am), arabiska (ar), armeniska (hy), assamesiska (as), asturiska (ast), azerbajdzjanska (az), belarusiska (be), bengaliska (bn), bosniska (bs), bulgariska (bg), burmesiska (my), kantonesiska (yue), katalanska (ca), cebuano (ceb), kroatiska (hr), tjeckiska (cs), danska (da), nederländska (nl), engelska (en), estniska (et), filippinska (fil), finska (fi), franska (fr), fulfulde (pulaar) (ff), galiciska (gl), georgiska (ka), tyska (de), grekiska (el), gujarati (gu), hausa (ha), hebreiska (he), hindi (hi), ungerska (hu), isländska (is), indonesiska (id), italienska (it), japanska (ja), javanesiska (jv), kamba (kam), kannada (kn), kazakiska (kk), koreanska (ko), kirgiziska (ky), lao (lo), lettiska (lv), lingala (ln), litauiska (lt), luganda (lg), luxemburgiska (lb), makedonska (mk), malajiska (ms), malayalam (ml), maltesiska (mt), mandarin (zh), maori (mi), marathi (mr), mongoliska (mn), nepalesiska (ne), norska (no), occitanska (oc), odia (or), pashto (ps), persiska (fa), polska (pl), portugisiska (pt), punjabi (pa), rumänska (ro), ryska (ru), serbiska (sr), shona (sn), sindhi (sd), slovakiska (sk), slovenska (sl), somaliska (so), soranisk kurdiska (ckb), spanska (es), swahili (sw), svenska (sv), tadzjikiska (tg), tamil (ta), telugu (te), thailändska (th), turkiska (tr), ukrainska (uk), urdu (ur), uzbekiska (uz), vietnamesiska (vi), walesiska (cy), wolof (wo), zulu (zu).
Eleven v3
Eleven v3 är vår tidigare generations talsyntesmodell som skapar naturligt, verklighetstroget tal med stort känslomässigt omfång och kontextförståelse på flera språk.
Med Eleven v3 kommer ett nytt Text to Dialogue API som låter dig generera naturlig, verklighetstrogen dialog med stort känslomässigt omfång och kontextförståelse på flera språk. Eleven v3 kan också användas med Text to Speech API för att generera naturligt, verklighetstroget tal med stort känslomässigt omfång och kontextförståelse på flera språk.
Läs mer om Text to Dialogue API här.
Språk som stöds
Modellen Eleven v3 stöder över 70 språk, bland annat:
Afrikaans (af), arabiska (ar), armeniska (hy), assamesiska (as), asturiska (ast), azerbajdzjanska (az), belarusiska (be), bengaliska (bn), bosniska (bs), bulgariska (bg), burmesiska (my), kantonesiska (yue), katalanska (ca), cebuano (ceb), chichewa (ny), kroatiska (hr), tjeckiska (cs), danska (da), nederländska (nl), engelska (en), estniska (et), filippinska (fil), finska (fi), franska (fr), galiciska (gl), georgiska (ka), tyska (de), grekiska (el), gujarati (gu), hausa (ha), hebreiska (he), hindi (hi), ungerska (hu), isländska (is), indonesiska (id), iriska (ga), italienska (it), japanska (ja), javanesiska (jv), kannada (kn), kazakiska (kk), kirgiziska (ky), koreanska (ko), lettiska (lv), lingala (ln), litauiska (lt), luxemburgiska (lb), makedonska (mk), malajiska (ms), malayalam (ml), maltesiska (mt), mandarin (zh), maori (mi), marathi (mr), mongoliska (mn), nepalesiska (ne), norska (no), occitanska (oc), odia (or), pashto (ps), persiska (fa), polska (pl), portugisiska (pt), punjabi (pa), rumänska (ro), ryska (ru), serbiska (sr), sindhi (sd), slovakiska (sk), slovenska (sl), somaliska (so), spanska (es), swahili (sw), svenska (sv), tadzjikiska (tg), tamil (ta), telugu (te), thailändska (th), turkiska (tr), ukrainska (uk), urdu (ur), uzbekiska (uz), vietnamesiska (vi), walesiska (cy), yoruba (yo).
Eleven v3 Conversational
Eleven v3 Conversational är vår tidigare generations modell för talsyntes i realtid. Den skapar naturligt, verklighetstroget tal med stort känslomässigt omfång och kontextförståelse på flera språk.
Med Eleven v3 Conversational kommer en ny Text to Dialogue WebSocket som låter dig generera naturlig, verklighetstrogen dialog med stort känslomässigt omfång och kontextförståelse på flera språk.
Med Eleven v3 Conversational kommer en ny Text to Dialogue WebSocket som låter dig generera naturlig, verklighetstrogen dialog med stort känslomässigt omfång och kontextförståelse på flera språk.
Läs mer om Text to Dialogue WebSocket här.
Språk som stöds
Modellen Eleven v3 stöder över 70 språk, bland annat:
Afrikaans (af), arabiska (ar), armeniska (hy), assamesiska (as), asturiska (ast), azerbajdzjanska (az), belarusiska (be), bengaliska (bn), bosniska (bs), bulgariska (bg), burmesiska (my), kantonesiska (yue), katalanska (ca), cebuano (ceb), chichewa (ny), kroatiska (hr), tjeckiska (cs), danska (da), nederländska (nl), engelska (en), estniska (et), filippinska (fil), finska (fi), franska (fr), galiciska (gl), georgiska (ka), tyska (de), grekiska (el), gujarati (gu), hausa (ha), hebreiska (he), hindi (hi), ungerska (hu), isländska (is), indonesiska (id), iriska (ga), italienska (it), japanska (ja), javanesiska (jv), kannada (kn), kazakiska (kk), kirgiziska (ky), koreanska (ko), lettiska (lv), lingala (ln), litauiska (lt), luxemburgiska (lb), makedonska (mk), malajiska (ms), malayalam (ml), maltesiska (mt), mandarin (zh), maori (mi), marathi (mr), mongoliska (mn), nepalesiska (ne), norska (no), occitanska (oc), odia (or), pashto (ps), persiska (fa), polska (pl), portugisiska (pt), punjabi (pa), rumänska (ro), ryska (ru), serbiska (sr), sindhi (sd), slovakiska (sk), slovenska (sl), somaliska (so), spanska (es), swahili (sw), svenska (sv), tadzjikiska (tg), tamil (ta), telugu (te), thailändska (th), turkiska (tr), ukrainska (uk), urdu (ur), uzbekiska (uz), vietnamesiska (vi), walesiska (cy), yoruba (yo).
Multilingual v2
Eleven Multilingual v2 är en talsyntesmodell från en tidigare generation med förståelse för känslor. Den skapar naturligt, verklighetstroget tal med stort känslomässigt omfång och kontextförståelse på flera språk.
Modellen ger jämn röstkvalitet och personlighet på alla språk som stöds, samtidigt som den behåller talarens unika egenskaper och accent.
Modellen utmärker sig i scenarier som kräver högkvalitativt tal med känslomässiga nyanser:
- Röstpålägg för karaktärer: Perfekt för spel och animation tack vare sitt känslomässiga omfång.
- Professionellt innehåll: Passar bra för företagsvideor och e-learningmaterial.
- Flerspråkiga projekt: Bibehåller jämn röstkvalitet vid språkbyten.
- Stabil kvalitet: Skapar jämn ljudutmatning av hög kvalitet.
Den har högre latens och kostnad per tecken än Flash-modeller, men ger överlägsen kvalitet för projekt där verklighetstroget tal är viktigt.
Våra flerspråkiga v2-modeller har stöd för 29 språk:
Engelska (USA, Storbritannien, Australien, Kanada), japanska, kinesiska, tyska, hindi, franska (Frankrike, Kanada), koreanska, portugisiska (Brasilien, Portugal), italienska, spanska (Spanien, Mexiko), indonesiska, nederländska, turkiska, filippinska, polska, svenska, bulgariska, rumänska, arabiska (Saudiarabien, Förenade Arabemiraten), tjeckiska, grekiska, finska, kroatiska, malajiska, slovakiska, danska, tamil, ukrainska och ryska.
Flash v2.5
Eleven Flash v2.5 är en talsyntesmodell med låg latens, utformad för realtidsapplikationer och Agents Platform. Den levererar högkvalitativt tal med en medianlatens på ~100 ms† på 32 språk.
Modellen balanserar hastighet och kvalitet, vilket gör den idealisk för interaktiva applikationer samtidigt som den behåller naturligt ljudande resultat och jämna röstegenskaper mellan språk.
Modellen passar särskilt bra för:
- Agents Platform: Perfekt för röstassistenter och chattbottar i realtid.
- Interaktiva applikationer: Perfekt för spel och applikationer som kräver omedelbar respons.
- Bearbetning i stor skala: Effektiv för masskonvertering från text till tal.
Med sitt lägre pris för API-genereringar och sin låga latens är Flash v2.5 det kostnadseffektiva alternativet för alla som behöver snabb och tillförlitlig talsyntes på flera språk.
Flash v2.5 har stöd för 32 språk – alla språk från v2-modellerna samt:
Ungerska, norska och vietnamesiska
† Median, exklusive program- och nätverkslatens. Se hur latens mäts.
Att tänka på
Textnormalisering med siffror
När du använder Flash v2.5 normaliseras inte siffror som standard på det sätt du kanske förväntar dig. Telefonnummer kan till exempel läsas upp på ett sätt som inte är tydligt för användaren. Datum och valutor påverkas på liknande sätt.
Som standard är normalisering inaktiverad för Flash v2.5 för att behålla den låga latensen. Enterprise-kunder kan dock nu aktivera textnormalisering för v2.5-modeller genom att ange parametern apply_text_normalization till “on” i din förfrågan.
Modellen Multilingual v2 är bättre på att normalisera siffror, så vi rekommenderar att du använder den för telefonnummer och andra fall där siffernormalisering är viktigt.
För applikationer med låg latens eller på Agents Platform är bästa praxis att låta din LLM normalisera texten innan du skickar den till TTS-modellen, eller använda parametern apply_text_normalization (endast Enterprise-planer för v2.5-modeller).
Guide för modellval
För vägledning om vilken modell som passar bäst för dina krav och användningsområden, se guiden för modellval.
Krav
Användningsområde
Teckengränser
Det maximala antalet tecken som stöds i en enskild text-till-tal-begäran varierar beroende på modell.
Scribe v3
Scribe v3 är vår mest exakta taligenkänningsmodell för inspelat ljud. Den efterträder Scribe v2 och använder samma Speech to Text API (POST /v1/speech-to-text). Ange scribe_v3 som model_id.
Den här modellen passar bra för:
- Mötes- och anteckningsverktyg: Transkriptioner med talaretiketter från inspelade möten och samtal
- Media: Undertexter och bildtexter med talaretiketter och tidsstämplar på ordnivå
- Utbildning: Inspelade föreläsningar med tal med accent eller blandade språk
- Kontaktcenter: Inspelade samtal för kvalitetssäkring och analys
Jämfört med Scribe v2 erbjuder Scribe v3:
- Färre transkriptionsfel. I FLEURS-riktmärket för 102 språk sänker Scribe v3 ordfelfrekvensen (WER) från 16,94 % till 12,38 %, vilket innebär 27 % färre ordfel än Scribe v2, och förbättrar resultaten för alla testade språk.
- Mer korrekta talaretiketter i ljud med flera talare.
- Parametern
numbers_format, som skriver siffror som numeriska tecken (42) eller ord (fyrtiotvå). - Parametern
secondary_language_codes, som listar andra språk som förväntas i ljudet tillsammans medlanguage_codeför att förbättra noggrannheten för ljud med blandade språk.
Se alternativ för siffror och språk för att använda de nya parametrarna.
ElevenLabs beräknar FLEURS WER per klipp och tar sedan genomsnittet per språk. Detta ger högre siffror än WER på korpusnivå som vanligtvis publiceras, så siffrorna är inte jämförbara med resultat som beräknats på andra sätt.
Scribe v3 behåller funktionerna från Scribe v2:
- Stöd för över 90 språk
- Talardiarisering, upp till 32 talare
- Tidsstämplar på ord- eller teckennivå
- Taggning av ljudhändelser
- Keyterm-promptning, upp till 1 000 termer
- Entitetsidentifiering
- Transkriptredigering
- Inget ordagrant läge
- Export till ytterligare format som SRT, DOCX och PDF
- Webhooks för asynkrona resultat
Uppgradera från Scribe v2
Ändra model_id från scribe_v2 till scribe_v3. Befintliga begärandeparametrar fungerar utan ändringar. Scribe v2 är fortsatt tillgänglig.
Scribe v3 Live
Scribe v3 Live är vår mest exakta taligenkänningsmodell i realtid. Den efterträder Scribe v2 Realtime och använder samma WebSocket för realtid (wss://api.elevenlabs.io/v1/speech-to-text/realtime). Ange scribe_v3_live som frågeparametern model_id.
Scribe v3 Live är en tal-till-text-modell. Den är separat från Eleven Realtime, Speech-to-Speech-modellerna för röstagenter.
Den här modellen passar bra för:
- Röstagenter och kontaktcenter: Bekräfta en tur när uppringaren har talat klart, inte vid den första pausen
- Liveundertextning: Transkriptioner i realtid med tidsstämplar på ordnivå
- Utbildning och språkinlärning: Talare med accenter och talare som byter språk
- Diktering och assistenter: Domänspecifik vokabulär via nyckeltermer
Jämfört med Scribe v2 Realtime erbjuder Scribe v3 Live:
- Färre transkriptionsfel. I FLEURS-riktmärket för 73 språk har Scribe v3 Live 44 % lägre semantisk WER än Scribe v2 Realtime. För Earnings-22 (finansiella samtal på engelska med accent) sjunker WER från 5,99 % till 3,91 %, och för VoxPopuli (tal i Europaparlamentet) från 2,13 % till 1,71 %.
- Turförutsägelse. Med
commit_strategy=turn_predictionbekräftar servern ett segment när modellen förutspår att talaren har avslutat sin tur, i stället för att enbart vänta på tystnad. - Flerspråkigt läge. Med
multilang_mode=truetranskriberas varje språk med sitt eget skriftsystem, även vid byten mitt i en mening. - Ett bibliotek med nyckeltermer med upp till 10 000 termer som modellen endast använder när den hör en trolig matchning, utöver de 50 vanliga nyckeltermerna.
- Diarisering i realtid. Med
diarize=truevisas preliminära talaretiketter i partiella transkriptioner, och varje bekräftad transkription följs av en separat diariserad transkription utan att fördröja den bekräftade texten.
Scribe v3 Live behåller funktionerna från Scribe v2 Realtime:
- Stöd för över 90 språk, med automatisk språkidentifiering
- Stöd för streaming: skicka ljud i segment medan du tar emot transkriptioner i realtid
- Flera ljudformat: PCM (8 kHz till 48 kHz) och μ-law-kodning
- Manuella bekräftelsestrategier och bekräftelsestrategier med Voice Activity Detection (VAD)
- Tidsstämplar på ordnivå
secondary_languagesför att begränsa språkidentifieringen till en uppsättning språk- Keyterm-promptning, upp till 50 termer
- Entitetsidentifiering
- Transkriptredigering
- Filtrering av bakgrundsljud
Uppgradera från Scribe v2 Realtime
Ändra model_id från scribe_v2_realtime till scribe_v3_live. Standardstrategin för bekräftelse är fortfarande manual, så befintliga integrationer fungerar på samma sätt tills du anger commit_strategy till turn_prediction. Scribe v2 Realtime är fortsatt tillgänglig.
De officiella SDK:erna stöder ännu inte turförutsägelse, flerspråkigt läge eller biblioteket med nyckeltermer. För att använda dem ansluter du direkt till WebSocket API:t.
Scribe v2
Scribe v2 är vår tidigare ledande taligenkänningsmodell, som efterträds av Scribe v3. Den är utformad för korrekt transkribering på över 90 språk. Den erbjuder exakta tidsstämplar på ordnivå och avancerade funktioner som talardiarisering och dynamisk ljudtaggning.
Den här modellen är särskilt bra i situationer som kräver korrekt tal-till-text-konvertering:
- Transkriptionstjänster: Perfekt för att konvertera ljud- och videoinnehåll till text
- Mötesdokumentation: Perfekt för att fånga upp och dokumentera samtal
- Innehållsanalys: Väl lämpad för bearbetning och analys av ljudinnehåll
- Flerspråkig igenkänning: Stöder korrekt transkribering på över 90 språk
Viktiga funktioner:
- Korrekt transkribering med tidsstämplar på ordnivå
- Talardiarisering för ljud med flera talare
- Dynamisk ljudtaggning för mer kontext
- Stöd för över 90 språk
- Entitetsidentifiering
- Keyterm-promptning
- Transkriptredigering
Läs mer om Scribe v2 här.
Scribe v2 Realtime
Scribe v2 Realtime är vår tidigare ledande modell för taligenkänning live, som efterträds av Scribe v3 Live. Den transkriberar över 90 språk med en mediantid till bekräftad transkription på ~150 ms. Se hur latens mäts.
Den här modellen är särskilt bra för konversationsbaserade användningsområden:
- Live-transkribering av möten: Perfekt för transkribering i realtid
- AI-agenter: Perfekt för livesamtal
- Flerspråkig igenkänning: Stöder korrekt transkribering på över 90 språk med automatisk språkigenkänning
Viktiga funktioner:
- Mycket låg latens: Få bekräftade transkriptioner med en medianlatens på ~150 millisekunder
- Stöd för streaming: Skicka ljud i segment medan du tar emot transkriptioner i realtid
- Flera ljudformat: Stöd för PCM (8 kHz till 48 kHz) och μ-law-kodning
- Voice Activity Detection (VAD): Automatisk segmentering av tal baserat på tystnadsidentifiering
- Manuell bekräftelsekontroll: Full kontroll över när transkriptsegment ska slutföras
- Entitetsidentifiering
- Maskering av entiteter
- Transkriptredigering
Läs mer om Scribe v2 Realtime här.
Scribe v2 Medical
Scribe v2 Medical är en batchmodell för taligenkänning som är specialiserad på medicinskt och kliniskt ljud. Det är en finjustering av Scribe v2 som förbättrar igenkänningen av läkemedelsnamn, anatomi, patologi och klinisk diktering, samtidigt som den matchar Scribe v2:s noggrannhet för vardagligt tal. Den använder samma Speech to Text API som Scribe v2 och debiteras enligt samma taxa. Ange scribe_v2_medical som model_id.
Avsett ändamål
Scribe v2 Medical är en batchmodell för Speech-to-Text API:t som utvecklare och organisationer kan integrera i applikationer som konverterar kliniskt ljud, inklusive samtal mellan vårdpersonal och patienter, diktering, inskrivnings- och vårdsamordningssamtal, till utkast av transkriptioner för dokumentation och relaterade administrativa arbetsflöden. Den resulterande texten är avsedd att granskas och korrigeras av vårdpersonal eller annan behörig användare före användning. Scribe v2 Medical är inte avsedd att tolka klinisk information eller ge diagnoser, behandlings- rekommendationer, kliniska beslut eller annan klinisk vägledning.
Den här modellen passar bra för:
- Klinisk dokumentation: Omgivningsinspelade besök och anteckningar där medicinska termer förekommer mitt i samtalet
- Diktering: Täta sekvenser av läkemedel, doseringar och fynd
- Inskrivnings- och samordningssamtal: Patienter som beskriver sina egna tillstånd, ofta via telefon
- Arbetsflöden för efterlevnad: Kombinera med entitetsidentifiering för PHI-kategorier
Viktiga funktioner:
- Samma begärandeformat som Scribe v2 (
keyterms,entity_detection,no_verbatim, diarisering, tidsstämplar) - Förbättrad igenkänning av läkemedelsnamn samt anatomiska och patologiska termer
- Ingen försämring av vardagligt tal jämfört med Scribe v2
- Stöd för över 90 språk
- Talardiarisering för ljud med flera talare
- Dynamisk ljudtaggning
- Entitetsidentifiering, inklusive PHI-kategorier
Scribe v2 Medical är en batchmodell. Använd Scribe v2 Realtime för live-transkribering.
Scribe v2 Medical är berättigad för HIPAA, med Business Associate Agreements tillgängliga för Enterprise-kunder samt Zero Retention Mode (ZRM). När ZRM är aktiverat raderas ljudinmatning och textutdata direkt efter att varje begäran har slutförts. ElevenLabs behåller ingenting, och din applikation tar emot hela API-svaret och behåller transkriptioner under din egen kontroll.
Företag som behöver HIPAA-efterlevnad måste kontakta ElevenLabs Sales för att underteckna ett Business Associate Agreement (BAA) innan de skickar skyddad hälsoinformation.
Läs mer om Speech to Text här.
SFX v3
SFX v3 (eleven_text_to_sound_v3) är vår senaste modell för ljudeffekter. Den använder samma Sound Effects API som eleven_text_to_sound_v2: ange model_id till eleven_text_to_sound_v3 för att använda den. eleven_text_to_sound_v2 är fortfarande standard, men är föråldrad och tas bort den 1 mars 2027.
Jämfört med eleven_text_to_sound_v2:
- Följer SFX v3 flera instruktioner i en prompt, till exempel “Fotbollspublik jublar, hör en boll falla, publiken buar”.
- Hanterar promptar som innehåller musik eller sång, till exempel “Gospelkör sjunger hej”.
- Ger mer naturligt klingande resultat.
- Är mindre benägen att klippa vid högfrekventa ljud som gongar, klockspel och visslingar.
Resultaten varierar beroende på prompt, så jämför båda modellerna med dina egna promptar innan du byter.
SFX v3 stöder loopning. Ange loop till true för att skapa en ljudeffekt som loopar sömlöst.
I ElevenCreative är SFX v3 tillgänglig i Sound Effects, Flows och Studio.
Läs mer om ljudeffekter här.
Eleven Realtime
Eleven Realtime är en ny klass av Speech-to-Speech-modeller för att bygga naturliga röstagenter. Varje Realtime-modell är en komplett röstagent: taligenkänning, röstaktivitetsidentifiering och turordning, LLM och text till tal, som ElevenLabs väljer ut och finjusterar för att fungera tillsammans som ett system. Välj en Realtime-modell så får du en välfungerande agent med ett enda val, utan några komponenter att konfigurera.
Två Realtime-modeller finns tillgängliga.
Eleven Realtime v1 Mini är optimerad för snabba, naturliga samtal och fungerar bra i följande situationer:
- AI-assistenter: Snabb, uttrycksfull dialog där själva samtalet är produkten.
- Utbildningshandledare: Naturlig växelverkan som hänger med i elevens tempo.
- Interaktiva karaktärer: Uttrycksfulla karaktärer för spel och underhållning.
Eleven Realtime v1 Max är optimerad för komplexa uppgifter och fungerar bra i följande situationer:
- Kundsupport: Lösa frågor som kräver att man följer en process och söker upp information.
- Leadkvalificering: Strukturerade samtal som samlar in information och bestämmer nästa steg.
- Arbetsflöden i flera steg: Uppgifter som anropar verktyg för att söka upp information eller utföra åtgärder.
Viktiga funktioner:
- Taligenkänning, turordning, språkmodell och röst i ett modellval
- Naturlig turordning och hantering av avbrott
- Verktygsanrop
- Anpassningsbara röster från ElevenLabs röstbibliotek
- Stöd för över 90 språk
- Växla mellan v1 Mini och v1 Max med ett modellval, inte en integrationsändring
Eleven Realtime finns tillgänglig i ElevenAgents, där du väljer en Realtime-modell i modellrullgardinsmenyn, och via Realtime API:t, som är utformat för att vara kompatibelt med OpenAI:s Realtime API över WebSocket. Om du redan använder OpenAI:s Realtime API, se migreringsguiden.
Språk som stöds
Realtime-modeller stöder över 90 språk. Se språklistan för Eleven v4.
Läs mer om Eleven Realtime här.
Eleven Music
Eleven Music är vår musikgenereringsmodell i studiokvalitet. Den låter dig skapa musik i valfri stil med promptar på naturligt språk.
Den här modellen passar utmärkt för följande situationer:
- Spelljudspår: Skapa fängslande ljudspår för spel
- Podcastbakgrunder: Förbättra poddar med professionell musik
- Marknadsföring: Lägg till bakgrundsmusik i reklamvideor
Viktiga funktioner:
- Full kontroll över genre, stil och struktur
- Sång eller bara instrumentalt
- Flerspråkig, inklusive engelska, spanska, tyska, japanska och fler språk
- Redigera ljudet och låttexten i enskilda delar eller hela låten
Läs mer om Eleven Music här.
Samtidighet och prioritet
Din prenumerationsplan avgör hur många förfrågningar som kan behandlas samtidigt och dina förfrågningars prioritetsnivå i kön. Speech to Text har en högre samtidighetsgräns. När samtidighetsgränsen nås behandlas efterföljande förfrågningar i en kö tillsammans med förfrågningar med lägre prioritet. I praktiken innebär detta vanligtvis bara cirka 50 ms extra latens.
Använd samtidighetskalkylatorn för att uppskatta den samtidighetsgräns din trafik behöver.
Svarsheaders innehåller current-concurrent-requests och maximum-concurrent-requests, som du kan använda för att övervaka samtidigheten.
API-förfrågningar per minut jämfört med samtidiga förfrågningar
Det är viktigt att förstå att API-förfrågningar per minut och samtidiga förfrågningar är olika mått som beror på dina användningsmönster.
API-förfrågningar per minut kan skilja sig från samtidiga förfrågningar eftersom det beror på hur lång tid varje förfrågan tar och hur förfrågningarna grupperas.
Exempel 1: Förfrågningar med mellanrum Om du hade 180 förfrågningar per minut som var och en tog 1 sekund att slutföra och du skickade dem med 0,33 sekunders mellanrum, skulle det maximala antalet samtidiga förfrågningar vara 3 och genomsnittet skulle vara 3, eftersom det alltid skulle finnas 3 pågående förfrågningar.
Exempel 2: Grupperade förfrågningar Men om du hade ett annat användningsmönster, exempelvis 180 förfrågningar per minut som var och en tog 3 sekunder att slutföra men alla skickades samtidigt, skulle det maximala antalet samtidiga förfrågningar vara 180 och genomsnittet skulle vara 9 (under minutens första 3 sekunder fanns 180 förfrågningar samtidigt, under de sista 57 sekunderna fanns 0 förfrågningar).
Eftersom vårt system fokuserar på samtidighet spelar förfrågningar per minut mindre roll än hur lång tid varje förfrågan tar och mönstret för när de skickas.
Hur förfrågningar till endpointar görs påverkar samtidighetsgränserna:
- Med HTTP räknas varje förfrågan individuellt mot din samtidighetsgräns.
- Med Text to Speech WebSocket räknas endast tiden då vår modell genererar ljud mot din samtidighetsgräns. Det betyder att en öppen websocket oftast inte räknas mot din samtidighetsgräns alls.
- Text to Dialogue WebSockets fungerar annorlunda: varje öppen anslutning reserverar en dialogsession från en separat pool så länge den är öppen, och ljud som genereras via anslutningen räknas inte mot din vanliga samtidighetsgräns. Detta är utformat för att vara enklare att förstå eftersom en anslutning är en session, och dina gränser för dialogsessioner är anpassade till denna nya metod för samtidighet. Se samtidighet för Text to Dialogue.
Förstå samtidighetsgränser
Samtidighetsgränsen för din plan bör inte tolkas som det maximala antalet samtidiga konversationer, telefonsamtal, röstinspelningar för karaktärer och liknande som kan hanteras på en gång. Det faktiska antalet beror på flera faktorer, bland annat vilka specifika AI-röster som används och användningsfallets egenskaper.
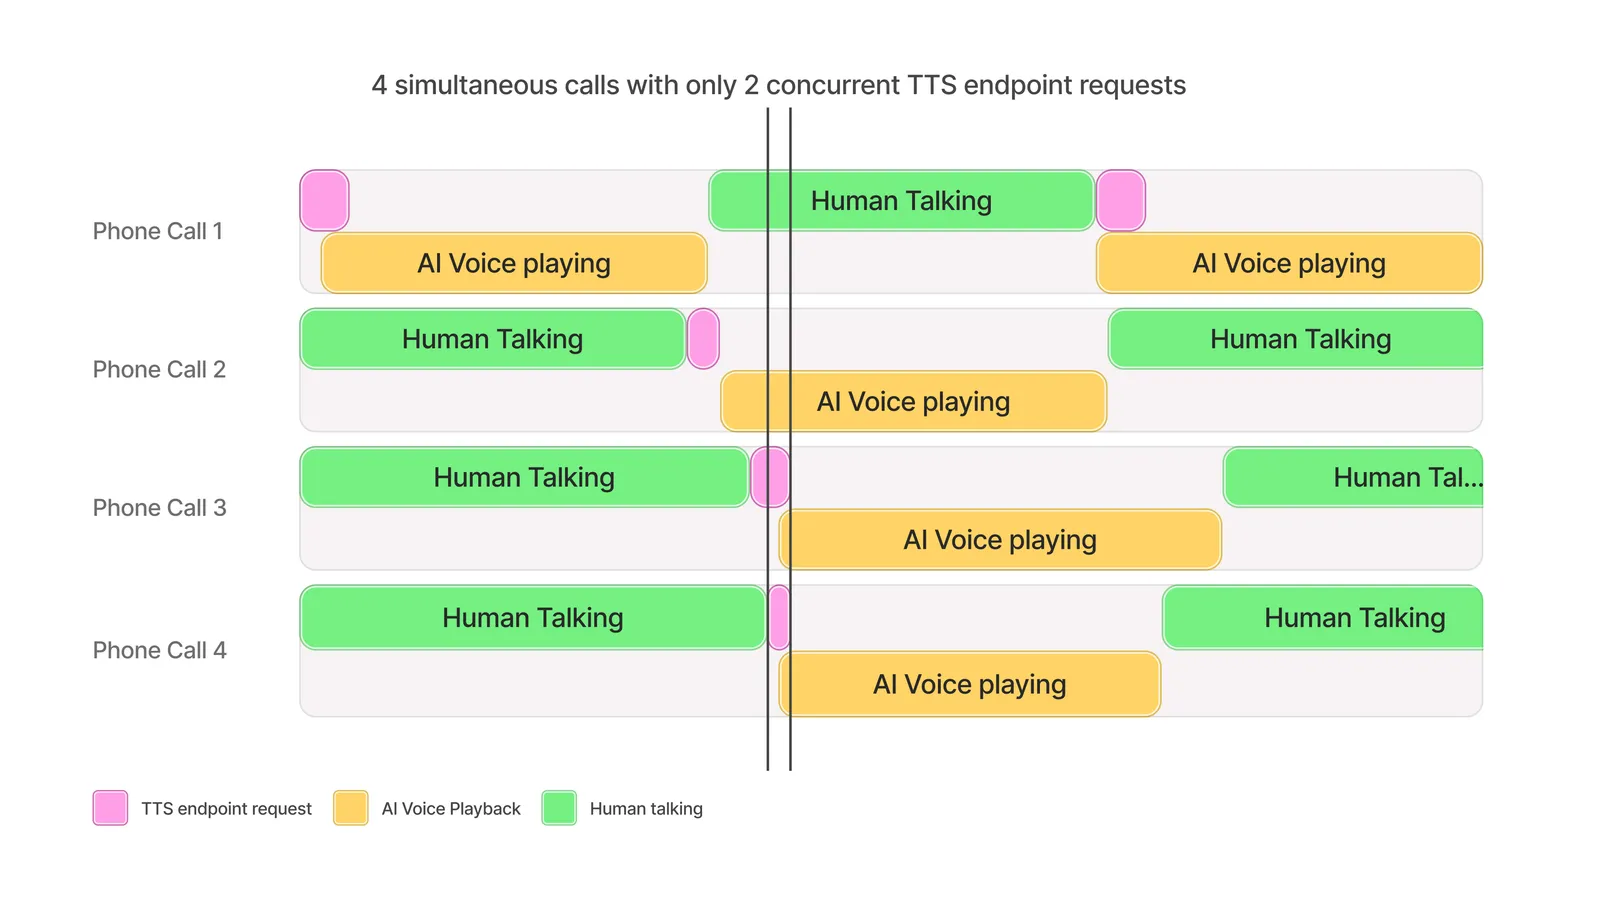
Som en generell tumregel kan en samtidighetsgräns på 5 vanligtvis stödja upp till cirka 100 samtidiga ljudsändningar.
Detta beror på hastigheten med vilken ljud genereras i förhållande till tiden det tar att behandla TTS-förfrågan. Diagrammet nedan visar ett exempel på hur 4 samtidiga samtal med olika användare kan hanteras samtidigt som endast 2 samtidiga förfrågningar används.
Bygga AI-röstassistenter
När TTS används för att möjliggöra dialog kan en samtidighetsgräns på 5 stödja omkring 100 sändningar vid balanserade konversationer mellan AI-agenter och mänskliga deltagare.
För användningsfall där AI-agenten talar mer sällan än människan, till exempel kundsupportinteraktioner, kan fler än 100 samtidiga konversationer stödjas.
Röstinspelningar för karaktärer
Generellt kan fler än 100 samtidiga röstinspelningar för karaktärer stödjas med en samtidighetsgräns på 5.
Antalet kan variera beroende på karaktärens dialogfrekvens, pausernas längd och handlingar i spelet mellan replikerna.
Live-dubbning
Samtidiga dubbningsströmmar följer vanligtvis den angivna tumregeln.
Om sändningen innehåller perioder med pauser i konversationen (t.ex. på grund av ett soundtrack, visuella scener eller liknande) kan fler samtidiga dubbningsströmmar än rekommendationen vara möjliga.
Om du vid något tillfälle överskrider din plans samtidighetsgränser och har Enterprise-planen kan modellförfrågningar ändå lyckas, om än långsammare, i mån av tillgänglig kapacitet.
För att höja din samtidighetsgräns och köprioritet kan du uppgradera din prenumerationsplan.
Enterprise-kunder kan begära en högre samtidighetsgräns genom att kontakta sin account manager.
Samtidighet för Text to Dialogue
Text to Dialogue-förfrågningar mäts på två olika sätt beroende på hur du anropar API:et:
- HTTP-endpointar (Skapa dialog och Streama dialog) räknas mot din plans vanliga samtidighetsgräns medan ljud genereras, precis som andra Text to Speech-förfrågningar.
- WebSocket-endpointar, som Text to Dialogue WebSocket, mäts som dialogsessioner. En öppen anslutning upptar en dialogsession så länge den är öppen, oavsett om ljud genereras just nu eller inte.
Sessionsbaserad mätning gör kapacitetsplaneringen enkel: en anslutning är en session, så din användning varierar inte med genereringsaktiviteten. Eftersom en session hålls under hela anslutningen i stället för endast medan ljud genereras är gränserna för dina dialogsessioner anpassade till denna nya metod för samtidighet.
Om du öppnar en anslutning medan alla arbetsytans dialogsessioner används nekas den nya anslutningen med felet too_many_concurrent_requests. Stäng anslutningar du inte längre behöver för att frigöra sessioner — en anslutning stängs också automatiskt efter 20 sekunders inaktivitet om du inte skickar keep_alive-meddelanden.
För att övervaka dialogsessioner öppnar du Developers längst ned i sidofältet på instrumentpanelen, väljer fliken Analytics och visar måttet Concurrent requests i användningsvyn. Dialogsessioner rapporteras som en egen serie, TTD Websocket Sessions, separat från dina övriga samtidiga förfrågningar.
Samtidighetsgränser vid skaltestning
Skaltestning kan vara användbar för att identifiera skalningsproblem på klientsidan och verifiera att samtidighetsgränserna är korrekt inställda för ditt användningsfall.
Vi rekommenderar starkt att du testar end-to-end-workflows så nära verklig användning som möjligt. Den rekommenderade metoden är att simulera och mäta hur många användare som kan stödjas. Det är viktigt att:
- Simulera användare, inte råa förfrågningar
- Simulera typiskt användarbeteende, som att vänta på att ljuduppspelning, användarens tal eller transkribering ska bli klar innan förfrågningar görs
- Öka antalet användare långsamt under flera minuter
- Lägga till slumpmässighet i tidpunkterna för förfrågningar och i förfrågningarnas storlek
- Samla in latensmått och eventuella felkoder som returneras från API:et
För att till exempel testa ett agentsystem som är utformat för att stödja 100 samtidiga konversationer skapar du upp till 100 enskilda “användare” som var och en simulerar en konversation. Konversationer består vanligtvis av en upprepad cykel med cirka 10 sekunder där användaren talar, följt av ett anrop till TTS API för cirka 150 tecken, följt av cirka 10 sekunders ljuduppspelning för användaren. Varje användare bör därför följa mönstret att göra ett Text-to-Speech API-anrop via websocket för 150 tecken text var 20:e sekund, med en liten mängd slumpmässighet i väntetiden och antalet begärda tecken. Testet skulle bestå av att starta en användare per sekund tills 100 finns och sedan testa i totalt 10 minuter för att kontrollera den övergripande stabiliteten.
Exempel på skript för skaltestning
Det här exemplet använder locust som testramverk med direkta API-anrop till ElevenLabs API.
Det följer exemplet ovan och testar ett konversationsagentsystem där varje användare skickar 1 förfrågan var 20:e sekund.