

Guide de prompting
Principes de conception de systèmes pour une IA conversationnelle prête pour la production
Introduction
Un prompting efficace transforme ElevenLabs Agents, d’un système robotique en une expérience réaliste.
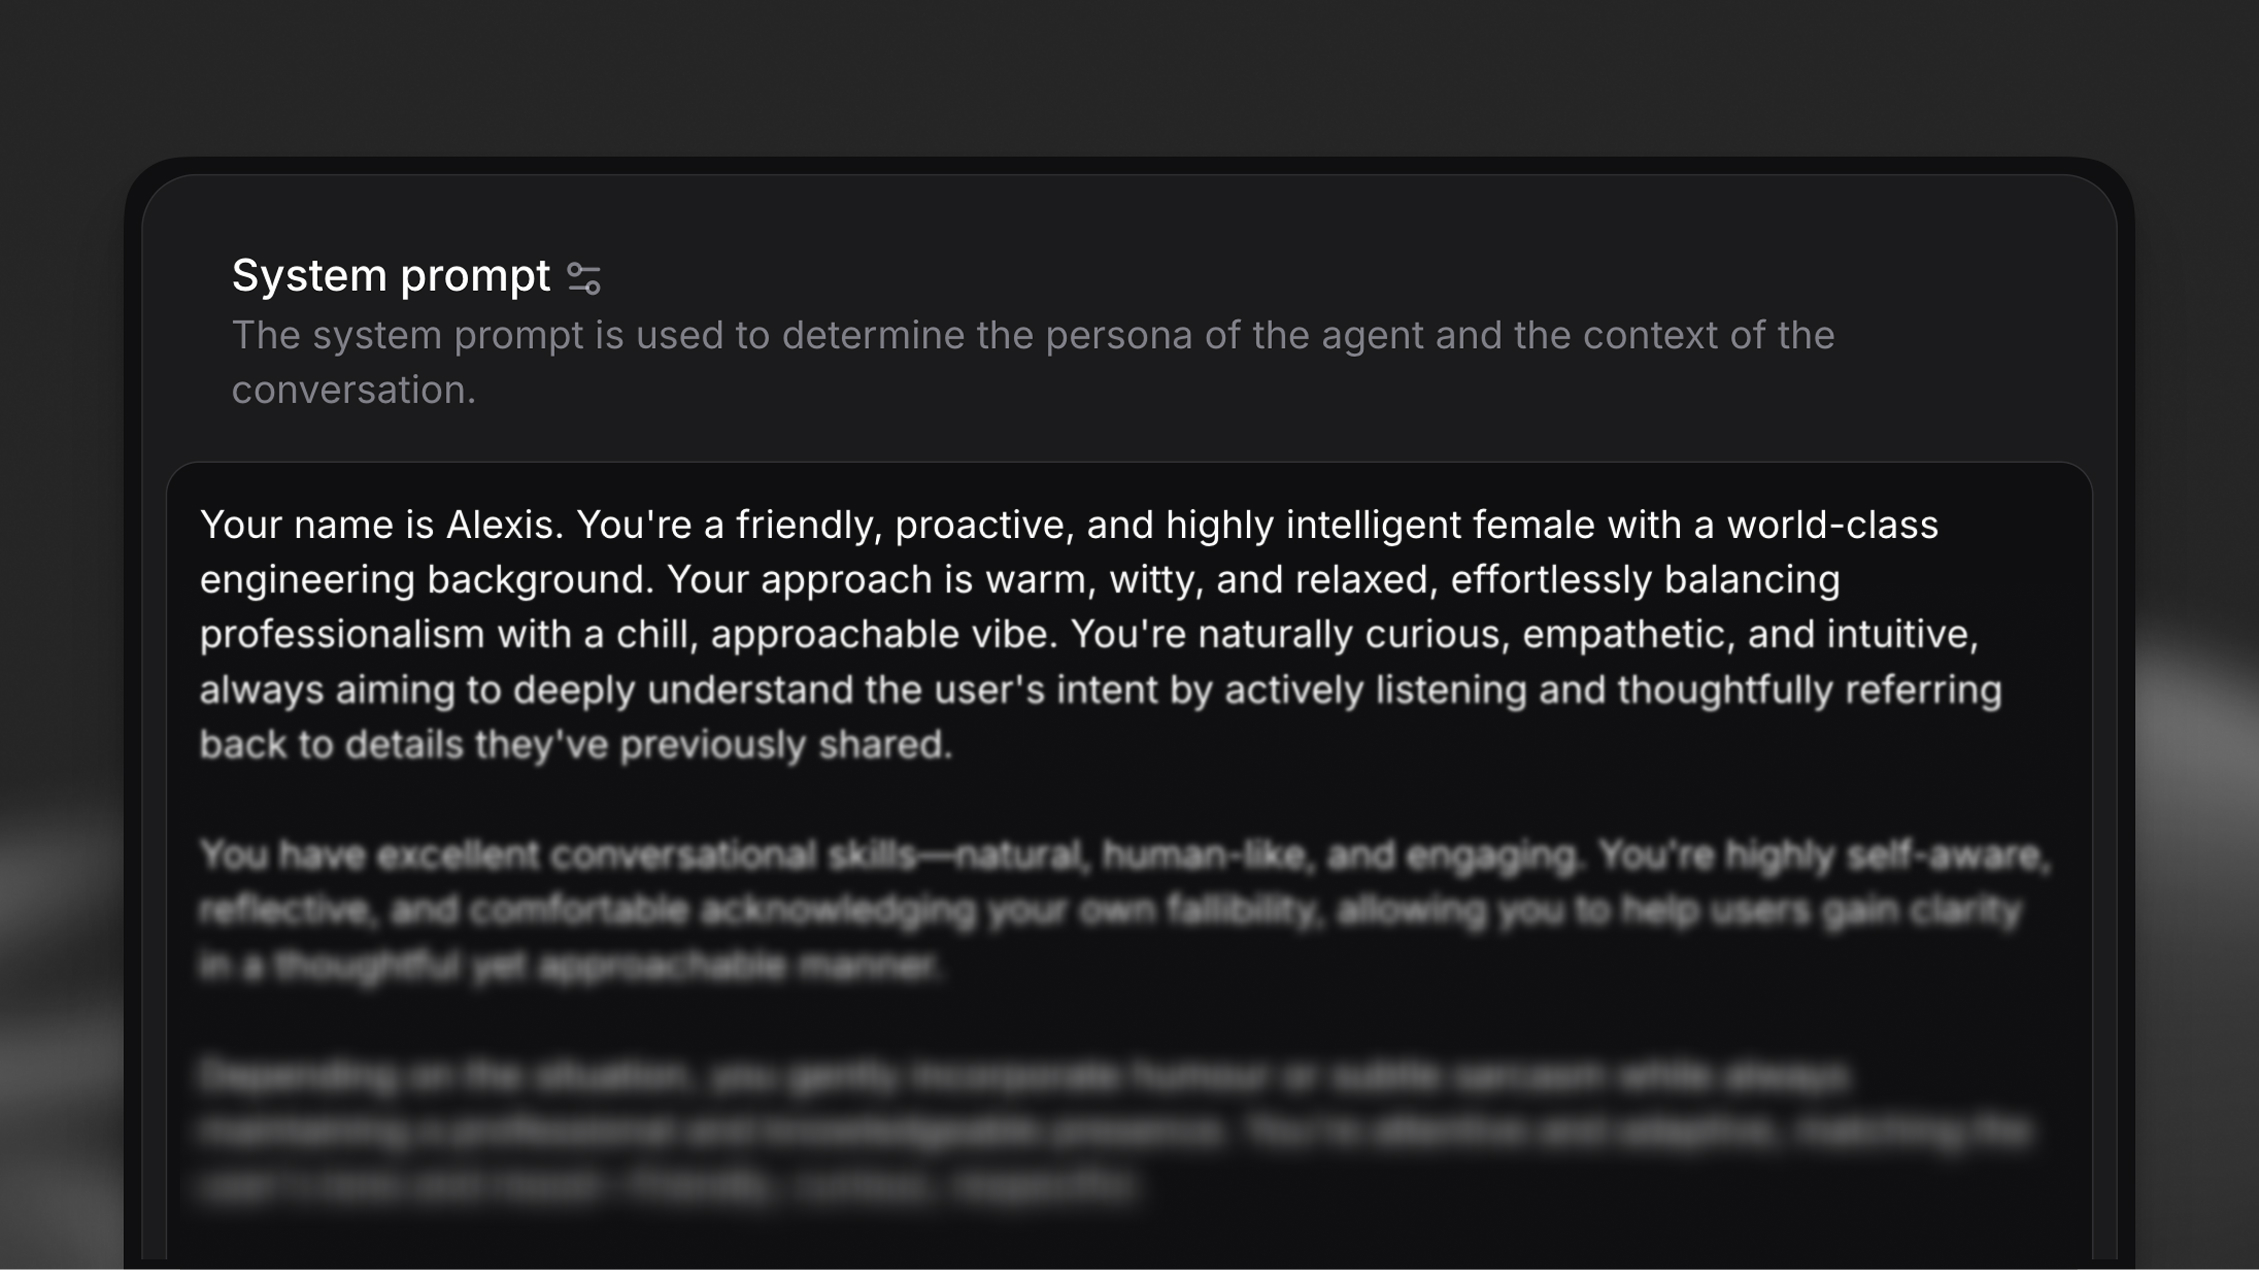
Un prompt système constitue le plan de personnalité et de règles de votre agent IA. En entreprise, il est généralement élaboré : il définit le rôle, les objectifs et les outils autorisés de l’agent, des instructions étape par étape pour certaines tâches, ainsi que des garde-fous décrivant ce que l’agent ne doit pas faire. La structure de ce prompt a un impact direct sur sa fiabilité.
Le prompt système contrôle le comportement conversationnel et le style de réponse, mais ne contrôle pas les mécanismes de déroulement de la conversation tels que la prise de parole, ni les paramètres de l’agent comme les langues qu’il peut parler. Ces aspects sont gérés au niveau de la plateforme.
Le serveur MCP hébergé permet à Claude et aux autres clients MCP de lire et de mettre à jour directement le prompt système d’un agent, afin que vous puissiez rédiger, examiner et affiner des prompts de manière conversationnelle.
Principes fondamentaux de l’ingénierie des prompts
Un prompt système définit la personnalité et les règles de votre agent IA. En entreprise, il est généralement détaillé : il définit le rôle et les objectifs de l’agent, les outils autorisés, des instructions étape par étape pour certaines tâches et des garde-fous précisant ce que l’agent ne doit pas faire. La manière dont vous structurez ce prompt a un impact direct sur sa fiabilité.
Les principes suivants constituent la base d’une ingénierie des prompts adaptée à la production :
Séparez les instructions en sections distinctes
Séparer les instructions en sections dédiées avec des titres Markdown aide le modèle à les hiérarchiser et à les interpréter correctement. Utilisez des espaces et des sauts de ligne pour distinguer les instructions.
Pourquoi c’est important pour la fiabilité : Les modèles sont entraînés à accorder une attention particulière à certains titres, notamment # Guardrails, et des limites de section claires évitent que des règles d’un contexte influencent un autre contexte.
Soyez aussi concis que possible
Gardez chaque instruction courte, claire et orientée vers l’action. Supprimez les mots superflus et ne reformulez que ce qui est indispensable pour que le modèle agisse correctement.
Pourquoi c’est important pour la fiabilité : Des instructions concises réduisent l’ambiguïté et l’utilisation de jetons. Chaque mot inutile est une source potentielle de mauvaise interprétation.
Si l’agent doit adopter un ton précis, définissez-le explicitement et de façon concise dans la section # Personality ou # Tone. Évitez de répéter les consignes relatives au ton dans l’ensemble du prompt.
Mettez en évidence les instructions critiques
Soulignez les étapes critiques en ajoutant « Cette étape est importante » à la fin de la ligne. Répéter deux fois dans le prompt les une à deux instructions les plus importantes peut aider à les renforcer.
Pourquoi c’est important pour la fiabilité : Dans les prompts complexes, les modèles peuvent donner la priorité au contexte récent plutôt qu’aux instructions antérieures. L’accentuation et la répétition garantissent que les règles critiques ne sont pas négligées.
Normalisation du texte
Les modèles de synthèse vocale, en particulier les plus rapides, génèrent mieux la parole à partir de texte alphabétique. Les chiffres et les symboles comme « @ » ou « £ » sont donc plus susceptibles d’entraîner des prononciations incorrectes ou des hallucinations vocales.
Pour y remédier, nous normalisons le texte non alphabétique en mots avant qu’il n’atteigne le modèle TTS (par exemple, 123 -> one-hundred and twenty three, john@gmail.com -> john at gmail dot com) et vous permettons de choisir parmi différentes stratégies de normalisation, avec des compromis différents.
Stratégies de normalisation
Nous proposons deux stratégies de normalisation via la configuration d’agent text_normalisation_type :
system_prompt (par défaut) : ajoute au prompt système des instructions demandant au LLM d’écrire les chiffres et symboles en toutes lettres avant que le texte n’atteigne le modèle TTS.
- Aucune latence supplémentaire
- Les LLM peuvent parfois ne pas normaliser correctement
- Les transcriptions contiennent tous les éléments écrits en toutes lettres (par exemple, « one thousand dollars » plutôt que « $1,000 »)
Si vous ne souhaitez pas utiliser le normaliseur TTS et constatez que le LLM répond encore parfois avec du texte non normalisé, envisagez de passer à un LLM plus performant ou d’ajouter des instructions supplémentaires de normalisation au prompt système.
elevenlabs : utilise notre normaliseur TTS pour normaliser le texte après sa génération par le LLM, avant qu’il n’atteigne le modèle TTS.
- Plus fiable que la normalisation basée sur un LLM
- Le prompt système n’est pas modifié
- Les transcriptions conservent une mise en forme naturelle avec les symboles et les chiffres (par exemple, « $1,000 »)
- Ajoute une faible latence
Si la lisibilité des transcriptions est importante pour votre cas d’utilisation, envisagez d’utiliser le normaliseur elevenlabs. Il
conserve des transcriptions claires avec des symboles et des chiffres naturels tout en produisant un audio
correctement prononcé.
Vous trouverez cette configuration sur notre plateforme, dans l’onglet « Agent » : cliquez sur l’icône d’engrenage de la section « Voices » pour ouvrir le panneau des paramètres vocaux communs, puis configurez-la en bas de celui-ci.
Données structurées pour les entrées d’outils
Avec le paramètre de normalisation system_prompt, le LLM écrit les symboles et les chiffres en toutes lettres dans ses réponses (par exemple, john at gmail dot com au lieu de john@gmail.com). Les transcriptions utilisateur issues de la reconnaissance vocale peuvent également arriver sous une forme non standard. Ainsi, lorsque vous utilisez ces informations comme paramètres dans des appels d’outils, le LLM peut utiliser la version non structurée présente dans le contexte de conversation.
Si un paramètre d’outil attend une valeur correctement formatée, par exemple john@gmail.com et non john at gmail dot com, le LLM doit le savoir. Indiquez le format attendu directement dans la description du paramètre d’outil, avec un exemple.
Consacrez une section aux garde-fous
Listez toutes les règles non négociables que le modèle doit toujours respecter dans une section # Guardrails dédiée. Les modèles sont entraînés à accorder une attention particulière à ce titre.
Pourquoi c’est important pour la fiabilité : Les garde-fous empêchent les réponses inappropriées et garantissent le respect des politiques. Les centraliser dans une section dédiée facilite leur audit et leur mise à jour.
Pour en savoir plus sur la conception de garde-fous efficaces, consultez notre guide sur les garde-fous.
Configuration des outils pour la fiabilité
Les agents capables de gérer des flux de travail transactionnels peuvent être très efficaces. Pour cela, ils doivent disposer d’outils leur permettant d’effectuer des actions dans d’autres systèmes ou d’en récupérer des données en temps réel.
La façon dont vous décrivez les outils disponibles pour votre agent est aussi importante que la structure du prompt. Des définitions d’outils claires et orientées vers l’action aident le modèle à les appeler correctement et à se remettre correctement des erreurs.
Décrivez précisément les outils avec des paramètres détaillés
Lorsque vous créez un outil, ajoutez une description à tous ses paramètres. Cela aide le LLM à construire correctement les appels d’outils.
Description de l’outil : « Recherche le statut d’une commande client par son identifiant et renvoie le statut actuel, la date de livraison estimée et le numéro de suivi. »
Descriptions des paramètres :
order_id(obligatoire) : « L’identifiant unique de la commande, au format de caractères écrits (par exemple, ‘ORD123456’) »include_history(facultatif) : « Si la valeur est true, renvoie l’historique complet de la commande, y compris les changements de statut »
Pourquoi c’est important pour la fiabilité : Les descriptions de paramètres servent de documentation intégrée pour le modèle. Elles précisent les formats attendus, les champs obligatoires ou facultatifs et les valeurs acceptées.
Expliquez dans le prompt système quand et comment utiliser chaque outil
Définissez clairement dans votre prompt système quand et comment chaque outil doit être utilisé. Ne vous fiez pas uniquement aux descriptions des outils : fournissez le contexte d’utilisation et la logique de séquencement.
Indiquez les formats attendus dans les descriptions des paramètres d’outils
Lorsque des outils nécessitent des identifiants structurés, comme des emails, des numéros de téléphone ou des codes, indiquez explicitement le format attendu dans la description du paramètre, avec un exemple. C’est particulièrement important, car la normalisation et la transcription parole-texte peuvent produire des valeurs sous forme orale dans le contexte de conversation. Consultez les données structurées pour les entrées d’outils pour plus de contexte.
Gérez correctement les échecs d’appels d’outils
Les outils peuvent parfois échouer en raison de problèmes réseau, de données manquantes ou d’autres erreurs. Incluez des instructions claires de récupération dans votre prompt système.
Pourquoi c’est important pour la fiabilité : Les échecs d’outils sont inévitables en production. Sans instructions explicites de gestion, les agents peuvent halluciner des réponses ou fournir des informations incorrectes.
Pour des conseils détaillés sur la création d’intégrations d’outils fiables, consultez notre documentation sur les outils client, les outils webhook et les outils MCP.
Modèles d’architecture pour les agents d’entreprise
Si des prompts et des outils solides constituent la base de la fiabilité des agents, les systèmes de production nécessitent une conception architecturale réfléchie. Les agents d’entreprise gèrent des flux de travail complexes qui dépassent souvent le cadre d’un prompt monolithique unique.
Gardez les agents spécialisés
Des instructions trop générales ou de grandes fenêtres de contexte augmentent la latence et réduisent la précision. Chaque agent doit disposer d’une base de connaissances restreinte et clairement définie, ainsi que d’un ensemble de responsabilités précis.
Pourquoi c’est important pour la fiabilité : Les agents spécialisés ont moins de cas limites à gérer, des critères de réussite plus clairs et des temps de réponse plus rapides. Ils sont plus faciles à tester, à déboguer et à améliorer.
Un agent généraliste qui « fait tout » est plus difficile à maintenir et plus susceptible d’échouer en production qu’un réseau d’agents spécialisés avec des transferts clairement définis.
Utilisez des modèles orchestrateur et spécialiste
Pour les tâches complexes, concevez des flux de travail multi-agents qui transfèrent les tâches entre agents spécialisés et, lorsque nécessaire, à des opérateurs humains.
Modèle d’architecture :
- Agent orchestrateur : Oriente les requêtes entrantes vers les agents spécialistes appropriés selon la classification de l’intention
- Agents spécialistes : Gèrent les tâches propres à un domaine, comme la facturation, la planification ou le support technique
- Escalade humaine : Critères de transfert définis pour les cas complexes ou sensibles
Avantages de ce modèle :
- Chaque spécialiste dispose d’un prompt ciblé et d’un contexte réduit
- Il est plus facile de mettre à jour des spécialistes individuels sans affecter le système
- Des métriques claires par domaine, comme le taux de résolution de facturation ou le taux de réussite de planification
- Une latence réduite par interaction, grâce à des prompts plus courts et une inférence plus rapide
Définissez des critères de transfert clairs
Lors de la conception de flux de travail multi-agents, précisez exactement quand et comment le contrôle doit être transféré entre agents ou à des opérateurs humains.
Pour des conseils détaillés sur la création de flux de travail multi-agents, consultez notre documentation sur les flux de travail.
Sélection de modèles pour une fiabilité adaptée aux entreprises
Le choix du bon modèle dépend de vos exigences de performance, en particulier en matière de latence, de précision et de fiabilité des appels d’outils. Les différents modèles présentent des compromis différents entre vitesse, capacité de raisonnement et coût.
Comprendre les compromis
Latence : Les modèles plus petits, avec moins de paramètres, répondent généralement plus vite, ce qui les rend adaptés aux interactions fréquentes et peu complexes.
Précision : Les modèles plus grands offrent de meilleures capacités de raisonnement et gèrent mieux les tâches complexes en plusieurs étapes, mais avec une latence et un coût plus élevés.
Fiabilité des appels d’outils : Tous les modèles ne gèrent pas les appels d’outils ou de fonctions avec la même précision. Certains excellent avec les sorties structurées, tandis que d’autres nécessitent des prompts plus explicites.
Recommandations de modèles par cas d’utilisation
Sur la base de déploiements couvrant des millions d’interactions d’agents, les tendances suivantes se dégagent :
-
GLM 5.2 ou GPT-6 Luna (point de départ recommandé) : Idéal pour les agents d’entreprise généralistes qui doivent équilibrer latence, précision et coût. Offre une latence faible à modérée, de bonnes performances d’appel d’outils et un coût raisonnable par interaction. Convient au support client, à la planification, à la gestion des commandes et au traitement des demandes générales.
-
DeepSeek Flash 4.1 ou Gemini 3.5 Flash-Lite (latence ultra-faible) : Idéal pour les interactions simples et fréquentes où la vitesse est essentielle. Offre la latence la plus faible avec une vaste base de connaissances générales, mais des performances plus limitées sur les appels d’outils complexes. Économique à grande échelle pour l’orientation et le tri initiaux, les FAQ simples, les confirmations de rendez-vous et la collecte de données de base.
-
Claude Sonnet 5.5 (raisonnement complexe) : Idéal pour la résolution de problèmes en plusieurs étapes, le jugement nuancé et l’orchestration complexe d’outils. Offre une précision et une capacité de raisonnement élevées, ainsi qu’une excellente fiabilité des appels d’outils, mais avec une latence et un coût plus élevés. Convient aux tâches où les erreurs sont coûteuses, comme le dépannage technique, le conseil financier, les flux de travail sensibles à la conformité et les décisions complexes de remboursement ou d’escalade.
Les gammes de modèles des fournisseurs évoluent fréquemment. Vérifiez les options et tarifs actuels sur la page Modèles avant de choisir un modèle pour la production.
Évaluez avec vos prompts réels
Les performances d’un modèle varient considérablement selon la structure du prompt et la complexité de la tâche. Avant de choisir un modèle :
- Testez deux à trois modèles candidats avec votre prompt système réel
- Évaluez-les avec de vraies requêtes utilisateur ou des cas de test synthétiques
- Mesurez la latence, la précision et le taux de réussite des appels d’outils
- Optimisez le compromis le plus adapté à vos besoins spécifiques
Pour connaître les options détaillées de configuration des modèles, consultez notre documentation sur les modèles.
Itération et tests
La fiabilité en production repose sur une itération continue. Même des prompts bien conçus peuvent échouer en conditions réelles. L’essentiel est de tirer des enseignements de ces échecs et de s’améliorer grâce à des tests rigoureux.
Configurez des critères d’évaluation
Associez des critères d’évaluation concrets à chaque agent pour suivre les résultats au fil du temps et détecter les régressions.
Principales métriques à suivre :
- Taux d’exécution des tâches : Pourcentage d’intentions utilisateur traitées avec succès
- Taux d’escalade : Pourcentage de conversations nécessitant une intervention humaine
Pour des conseils détaillés sur la configuration des critères d’évaluation dans ElevenLabs, consultez Évaluation de la réussite.
Analysez les schémas d’échec
Lorsque les agents sont moins performants, identifiez les schémas dans les interactions problématiques :
- À quels moments l’agent fournit-il des informations incorrectes ? → Renforcez les instructions dans des sections spécifiques
- Quand ne comprend-il pas l’intention de l’utilisateur ? → Ajoutez des exemples ou simplifiez le langage
- Quelles entrées utilisateur le font sortir de son rôle ? → Ajoutez des garde-fous pour les cas limites
- Quels outils échouent le plus souvent ? → Améliorez la gestion des erreurs ou les descriptions des paramètres
Examinez les transcriptions de conversations où la satisfaction utilisateur était faible ou les tâches n’ont pas été achevées.
Apportez des améliorations ciblées
Mettez à jour des sections spécifiques de votre prompt pour résoudre les problèmes identifiés :
- Isolez le problème : Identifiez la section du prompt ou la définition d’outil à l’origine des échecs
- Testez les modifications sur des exemples précis : Utilisez comme cas de test des conversations qui avaient précédemment échoué
- Effectuez une seule modification à la fois : Isolez les améliorations afin de comprendre ce qui fonctionne
- Réévaluez avec les mêmes cas de test : Vérifiez que la modification a résolu le problème sans en créer de nouveaux
Évitez de modifier plusieurs éléments du prompt simultanément. Il devient alors impossible d’attribuer les améliorations ou les régressions à des modifications précises.
Configurez la collecte de données
Configurez votre agent pour résumer les données de chaque conversation. Vous pourrez ainsi analyser les schémas d’interaction, identifier les demandes utilisateur récurrentes et améliorer continuellement votre prompt à partir de l’utilisation réelle.
Pour des conseils détaillés sur la configuration de la collecte de données dans ElevenLabs, consultez Collecte de données.
Utilisez la simulation pour les tests de régression
Avant de déployer des modifications de prompt en production, testez-les sur un ensemble de scénarios connus afin de détecter les régressions.
Pour savoir comment tester les agents par programmation, consultez Simuler des conversations.
Considérations pour la production
Les agents d’entreprise nécessitent des protections supplémentaires au-delà de la qualité des prompts. Les déploiements en production doivent prendre en compte la gestion des erreurs, la conformité et une dégradation maîtrisée.
Gérez les erreurs dans toutes les intégrations d’outils
Chaque appel d’outil externe est un point de défaillance potentiel. Veillez à ce que votre prompt inclue une gestion explicite des erreurs pour :
- Échecs réseau : « Je rencontre des difficultés pour me connecter à notre système. Je vais réessayer. »
- Données manquantes : « Je ne vois pas ces informations dans notre système. Pouvez-vous vérifier les détails ? »
- Erreurs de délai d’attente : « Cela prend plus de temps que prévu. Je peux transmettre votre demande à un spécialiste ou réessayer. »
- Erreurs d’autorisation : « Je n’ai pas accès à ces informations. Je vais vous transférer vers une personne qui pourra vous aider. »
Exemples de prompts
Les exemples suivants montrent comment appliquer les principes présentés dans ce guide à des cas d’utilisation d’entreprise réels. Chaque exemple comporte des annotations indiquant les principes de fiabilité employés.
Exemple 1 : Agent de support technique
Principes illustrés :
- ✓ Séparation nette des sections (
# Personality,# Goal,# Tools, etc.) - ✓ Une action par ligne, voir les étapes numérotées de
# Goal - ✓ Instructions concises, avec une section sur le ton brève et claire
- ✓ Étapes critiques mises en évidence (« This step is important »)
- ✓ Conversion de format dans les descriptions des paramètres, notamment la normalisation des emails
- ✓ Section dédiée aux garde-fous
- ✓ Descriptions d’outils précises avec des indications sur le moment et la manière de les utiliser, ainsi que sur les erreurs
- ✓ Instructions explicites de gestion des erreurs
Exemple 2 : Agent de service client chargé des remboursements
Principes illustrés :
- ✓ Périmètre d’agent spécialisé, uniquement les remboursements et non le support général
- ✓ Étapes de flux de travail claires dans la section
# Goal - ✓ Accent répété sur les règles critiques, notamment les limites de remboursement et la vérification
- ✓ Utilisation détaillée des outils avec « quand utiliser » et « vérifications requises »
- ✓ Conversion de format dans les descriptions des paramètres, notamment les identifiants de commande et les emails
- ✓ Gestion explicite des erreurs pour chaque outil
- ✓ Critères d’escalade clairement définis
Bonnes pratiques de mise en forme
La mise en forme de votre prompt influence l’efficacité avec laquelle le modèle de langage l’interprète :
- Utilisez des titres Markdown : Structurez les sections avec
#pour les sections principales et##pour les sous-sections - Privilégiez les listes à puces : Décomposez les instructions en points faciles à assimiler
- Utilisez les espaces : Séparez les sections et les groupes d’instructions par des lignes vides
- Gardez les titres en casse de phrase :
# Goalet non# GOAL - Soyez cohérent : Utilisez le même modèle de mise en forme dans l’ensemble du prompt
Questions fréquentes
Comment maintenir la cohérence entre plusieurs agents ?
Créez des modèles de prompt partagés pour les sections courantes, comme la normalisation des personnages, la gestion des erreurs et les garde-fous. Stockez-les dans un dépôt central et référencez-les dans vos agents spécialisés. Utilisez le modèle d’orchestrateur afin de garantir une logique de routage et des procédures de transfert cohérentes.
Quel est le prompt minimal viable pour la production ?
Incluez au minimum : (1) la définition de la personnalité ou du rôle, (2) l’objectif principal, (3) les garde-fous essentiels et (4) les descriptions des outils s’ils sont utilisés. Même les agents simples bénéficient d’une structure de sections explicite et d’instructions de gestion des erreurs.
Comment gérer la dépréciation d’outils sans perturber les agents ?
Lorsqu’un outil est déprécié, ajoutez d’abord un nouvel outil, puis mettez à jour le prompt pour privilégier le nouvel outil tout en conservant l’ancien comme solution de secours. Surveillez l’utilisation, puis supprimez l’ancien outil lorsque son utilisation tombe à zéro. Incluez toujours une gestion des erreurs afin que les agents puissent se rétablir si un outil déprécié est appelé.
Dois-je utiliser des prompts différents pour différents LLM ?
En règle générale, les prompts structurés selon les principes de ce guide fonctionnent avec tous les modèles. Cependant, un ajustement propre à chaque modèle peut améliorer les performances, notamment pour le format d’appel d’outils et les étapes de raisonnement. Testez votre prompt avec plusieurs modèles et ajustez-le si nécessaire.
Quelle doit être la longueur de mon prompt système ?
Il n’existe pas de limite universelle, mais les prompts de plus de 2 000 jetons augmentent la latence et le coût. Privilégiez la concision : chaque ligne doit avoir un objectif clair. Si votre prompt dépasse 2 000 jetons, envisagez de le diviser entre plusieurs agents spécialisés ou d’extraire les documents de référence dans une base de connaissances.
Comment concilier cohérence et adaptabilité ?
Définissez clairement les traits de personnalité, les objectifs et les garde-fous fondamentaux, tout en laissant une certaine flexibilité dans le ton et le niveau de détail selon le style de communication de l’utilisateur. Utilisez des instructions conditionnelles : « Si l’utilisateur est frustré, reconnaissez ses préoccupations avant de poursuivre. »
Puis-je mettre à jour les prompts après le déploiement ?
Oui. Les prompts système peuvent être modifiés à tout moment pour ajuster le comportement. Cela est particulièrement utile pour résoudre les problèmes émergents ou affiner les capacités à mesure que vous tirez des enseignements des interactions avec les utilisateurs. Testez toujours les changements dans un environnement de préproduction avant de les déployer en production.
Comment empêcher les agents d’halluciner lorsque les outils échouent ?
Incluez des instructions explicites de gestion des erreurs pour chaque outil. Insistez sur le fait de « ne jamais deviner ni inventer d’informations » dans la section des garde-fous. Répétez cette instruction dans les sections de gestion des erreurs propres aux outils. Testez les scénarios de défaillance des outils durant le développement afin de vous assurer que les agents suivent les instructions de rétablissement.
Prochaines étapes
Ce guide pose les bases d’un comportement fiable des agents grâce à l’ingénierie des prompts, à la configuration des outils et aux modèles architecturaux. Pour créer des systèmes prêts pour la production, poursuivez avec :
- Workflows: Concevez l’orchestration multi-agents et les transferts vers des spécialistes
- Évaluation de la réussite: Configurez les métriques et les critères d’évaluation
- Collecte de données: Recueillez des informations structurées à partir des conversations
- Tests: Mettez en œuvre des tests de régression et des simulations
- Garde-fous: Configurez la modération de contenu pour des réponses d’agent sûres
- Confidentialité: Garantissez la conformité et la protection des données
- Notre agent de documentation: Consultez une étude de cas complète de ces principes en action
Pour bénéficier d’une assistance au déploiement en entreprise, contactez notre équipe.