

Intégrez votre propre modèle
Connectez un agent à votre propre LLM ou hébergez votre propre serveur.
Custom LLM vous permet de connecter vos conversations à votre propre LLM via un endpoint externe. ElevenLabs prend également en charge les LLM intégrés nativement
Les LLM personnalisés vous permettent d’utiliser votre propre clé API OpenAI ou d’exécuter un serveur LLM entièrement personnalisé.
Un LLM personnalisé ne peut pas être utilisé avec un modèle Realtime.
Vue d’ensemble
Par défaut, nous utilisons nos propres identifiants internes pour des modèles populaires comme OpenAI. Pour utiliser un serveur LLM personnalisé, celui-ci doit respecter l’une des structures de requête/réponse compatibles avec OpenAI suivantes :
- API Chat Completions (
/v1/chat/completions) - API Responses (
/v1/responses)
L’API Responses est le format d’API plus récent d’OpenAI et prend en charge des fonctionnalités supplémentaires. Les deux formats d’API sont entièrement pris en charge pour l’intégration de LLM personnalisés.
Les guides suivants couvrent les deux cas d’usage :
- Utiliser votre propre clé OpenAI : utilisez votre propre clé API OpenAI avec notre plateforme.
- Serveur LLM personnalisé : hébergez et connectez votre propre implémentation de serveur LLM.
Vous apprendrez à :
- Stocker votre clé API OpenAI dans ElevenLabs
- Héberger un serveur qui reproduit l’endpoint Chat Completions ou Responses d’OpenAI
- Diriger ElevenLabs vers votre endpoint personnalisé
- Transmettre des paramètres supplémentaires à votre LLM selon vos besoins
Résumé du raisonnement
Votre endpoint doit renvoyer le raisonnement séparément de la réponse finale. ElevenLabs ne génère pas le raisonnement à partir de la réponse finale.
Pour demander le raisonnement à un endpoint pris en charge, activez Résumé du raisonnement dans les paramètres LLM de l’agent ou définissez enable_reasoning_summary via l’API.
Renvoyer le raisonnement
Utilisez le format correspondant à votre endpoint :
API Chat Completions
API Responses
Diffusez le raisonnement dans le champ reasoning ou reasoning_content de chaque delta de réponse.
Pour les endpoints compatibles avec Gemini, ElevenLabs demande les réflexions avec
google.thinking_config.include_thoughts et lit le contenu marqué avec
extra_content.google.thought.
Consultez Résumé du raisonnement pour connaître le stockage, la diffusion et les limites.
Utiliser votre propre clé OpenAI
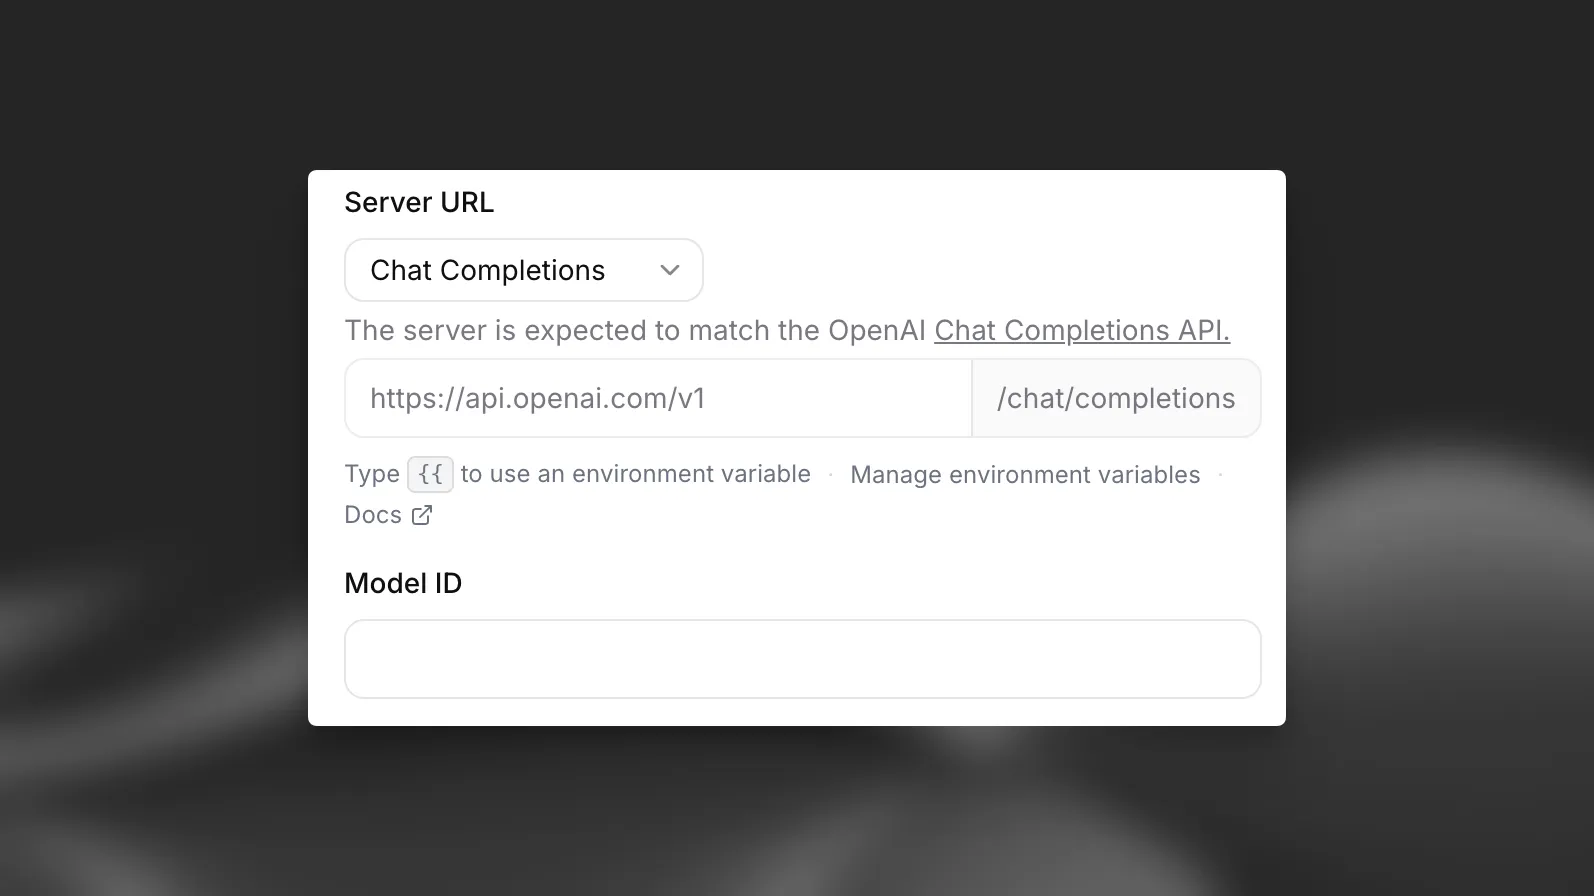
Pour intégrer une clé OpenAI personnalisée, mettez à jour les paramètres de votre agent dans le Dashboard ElevenLabs afin de le diriger vers votre serveur LLM personnalisé, puis créez un secret contenant votre OPENAI_API_KEY :
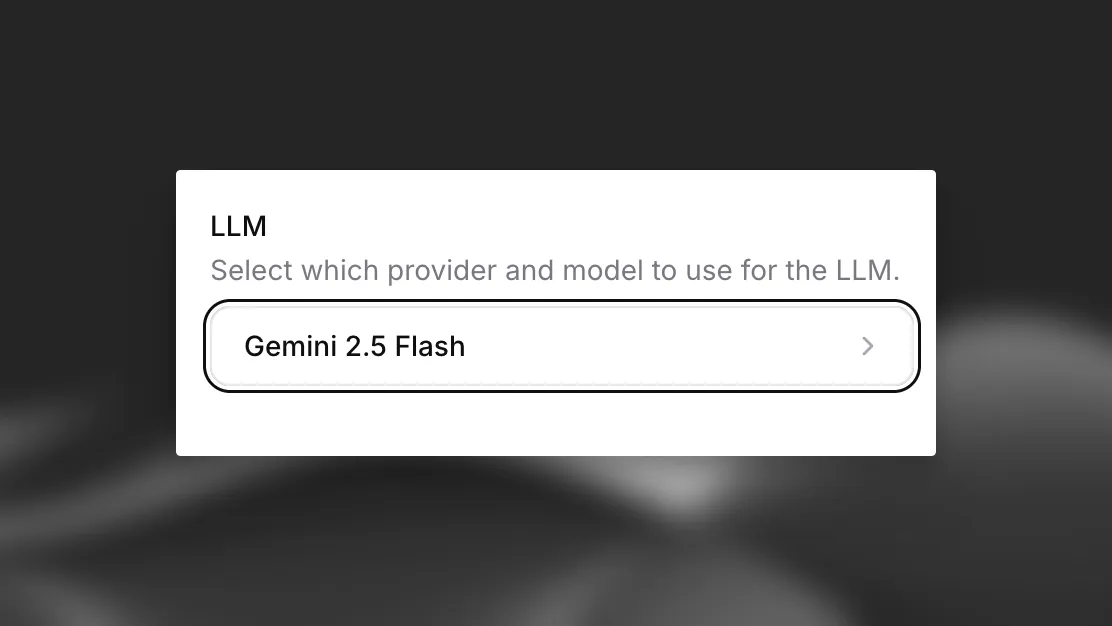
Dans les paramètres de votre agent du Dashboard ElevenLabs, sélectionnez « Custom LLM » dans le menu déroulant « LLM » à droite.
Serveur LLM personnalisé
Pour utiliser un serveur LLM personnalisé, configurez un endpoint de serveur compatible suivant le format d’OpenAI. Vous pouvez implémenter l’API Chat Completions (/v1/chat/completions) ou l’API Responses (/v1/responses).
Les deux endpoints doivent renvoyer des réponses au format SSE (Server-Sent Events) avec Content-Type: text/event-stream.
API Chat Completions
API Responses
L’API Chat Completions utilise l’endpoint /v1/chat/completions.
Chaque segment doit être formaté comme data: {json}\n\n et le flux doit se terminer par data: [DONE]\n\n.
Voici un exemple d’implémentation de serveur :
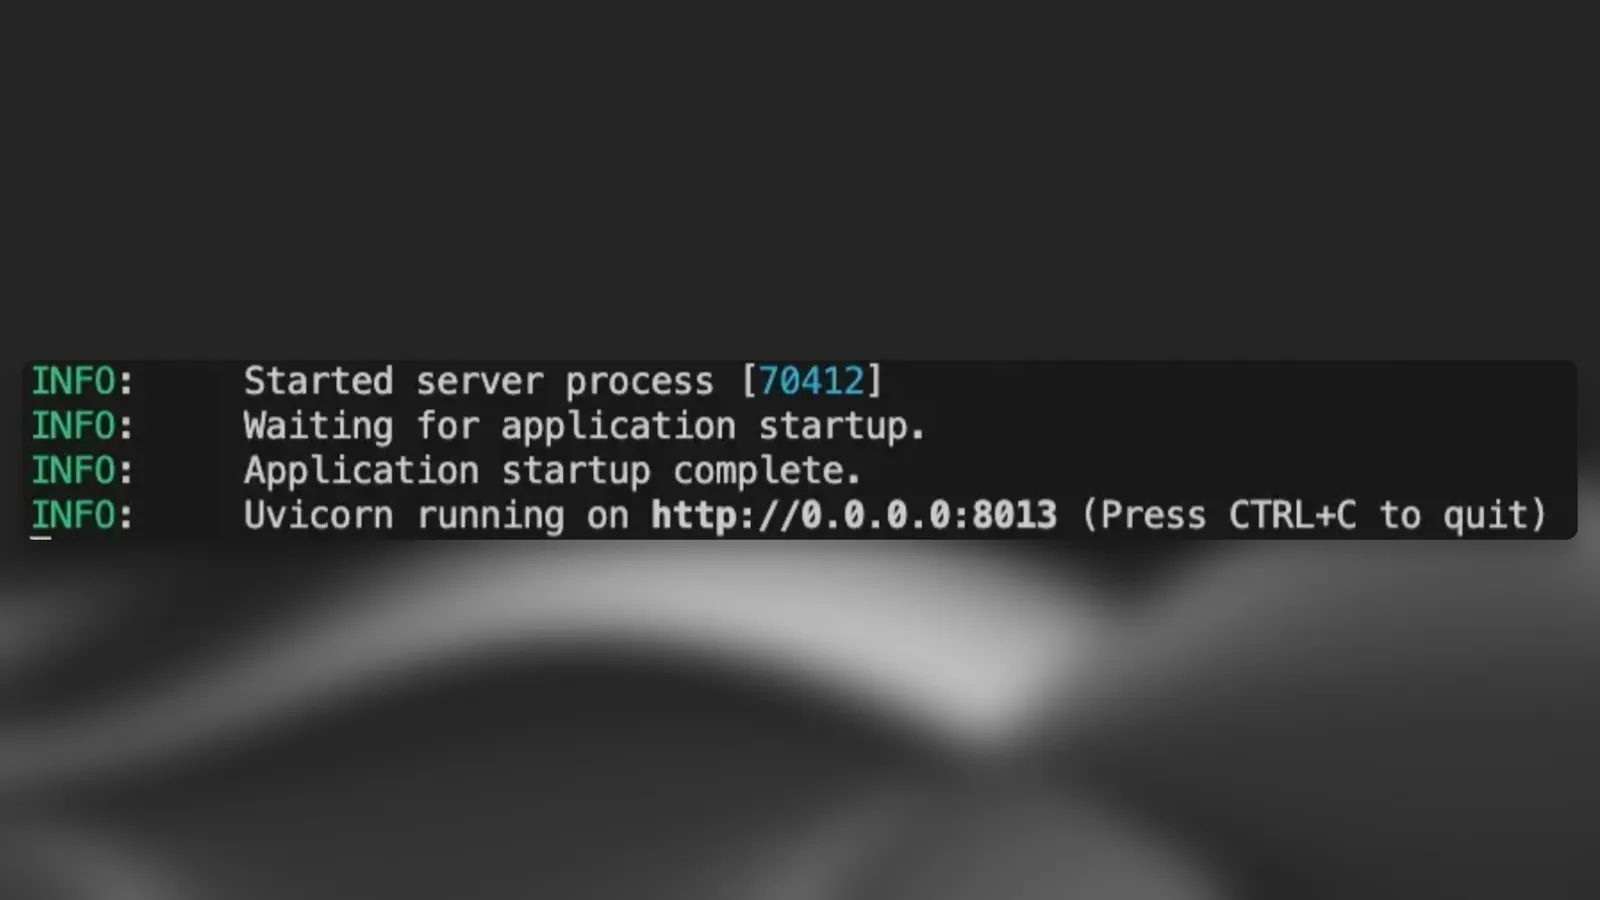
Exécutez ce code ou le code de votre propre serveur.
Configurer une URL publique pour votre serveur
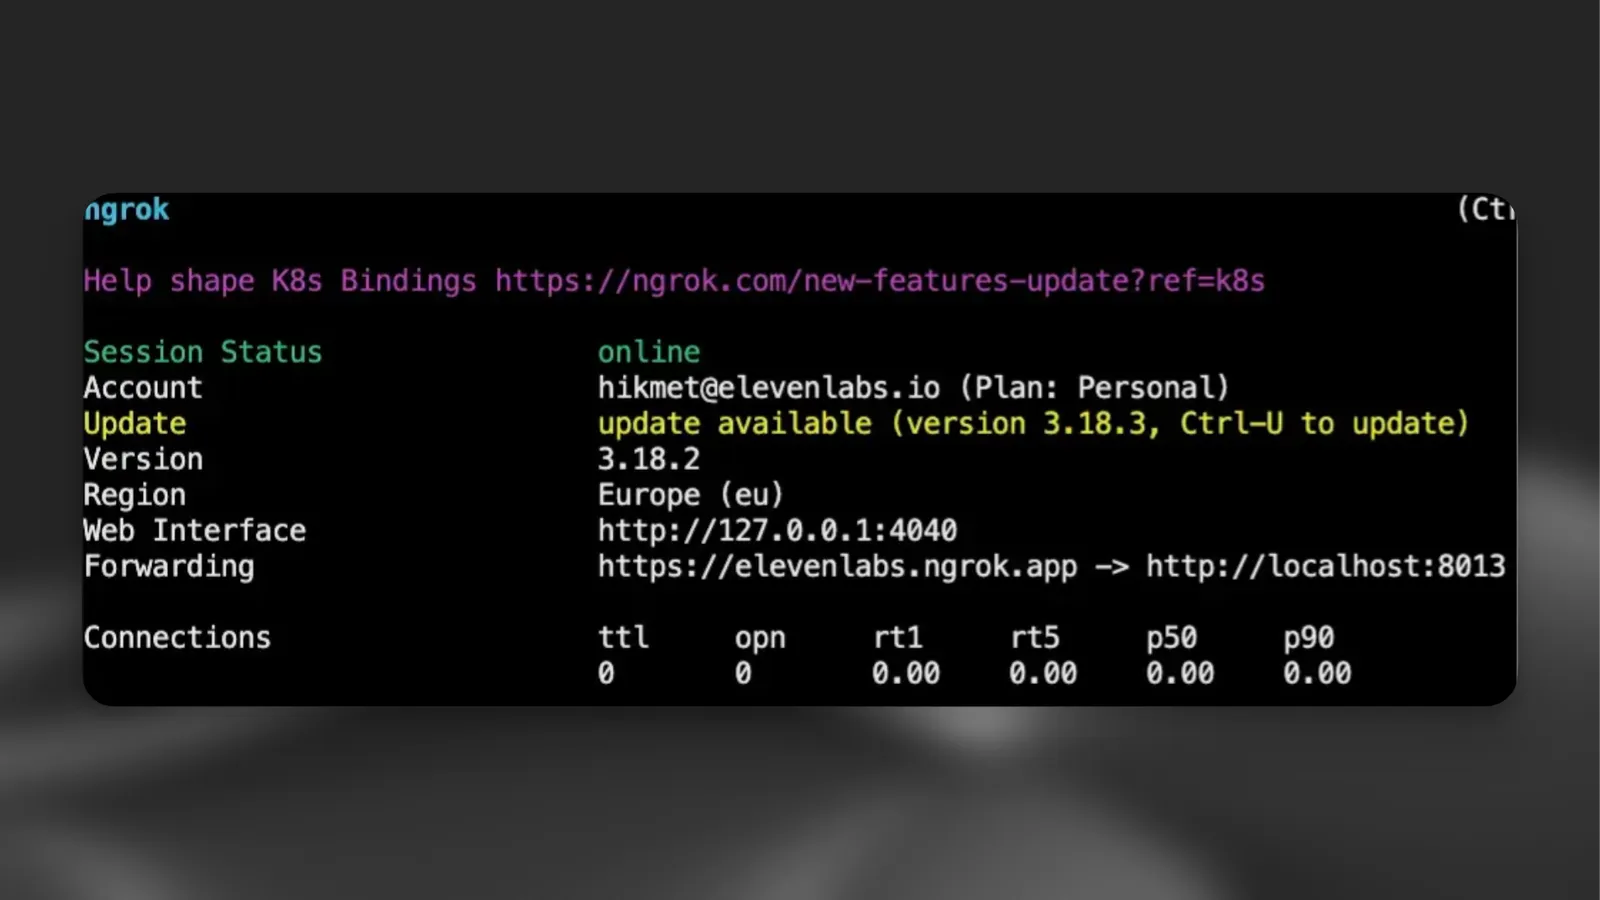
Pour rendre votre serveur accessible, créez une URL publique à l’aide d’un outil de tunneling tel que ngrok :
Configurer CustomLLM d’ElevenLabs
Mettez ensuite à jour les paramètres de votre agent dans le Dashboard ElevenLabs afin de le diriger vers votre serveur LLM personnalisé.
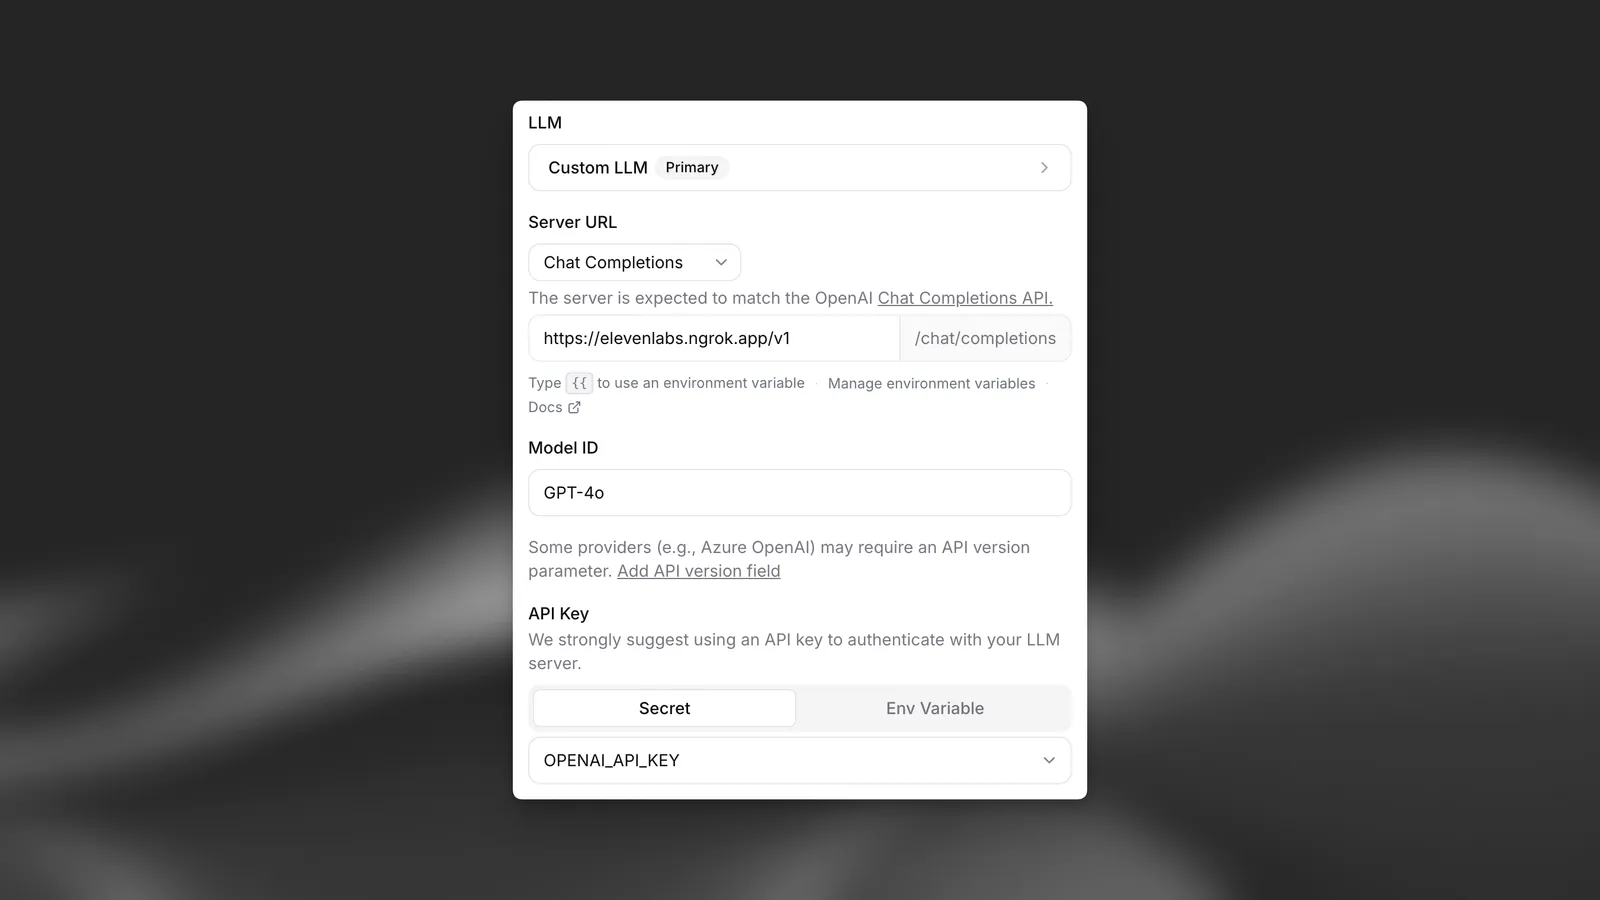
Dirigez l’URL de votre serveur vers l’endpoint ngrok et définissez « Limit token usage » sur 5000.
Vous pouvez désormais commencer à interagir avec votre agent à l’aide de votre propre serveur LLM.
Optimisation pour les LLM à traitement lent
Si votre LLM personnalisé présente des temps de traitement lents, peut-être en raison d’un raisonnement agentique ou d’exigences de prétraitement, vous pouvez améliorer la fluidité des échanges en intégrant des mots tampons dans vos réponses en streaming. Cette technique aide à maintenir une prosodie naturelle pendant que votre LLM génère la réponse complète.
Mots tampons
Lorsque votre LLM a besoin de plus de temps pour traiter la réponse complète, renvoyez une réponse initiale se terminant par "... " (des points de suspension suivis d’une espace). Cela permet au système Text to Speech de maintenir un flux naturel tout en gardant l’échange dynamique.
Cela crée des pauses naturelles qui s’enchaînent bien avec le contenu suivant, sur lequel le LLM peut raisonner plus longtemps. L’espace supplémentaire est essentielle pour éviter que le contenu suivant soit ajouté à « … », ce qui pourrait entraîner des distorsions audio.
Implémentation
Voici comment modifier votre serveur LLM personnalisé pour implémenter des mots tampons :
Intégration des outils système
Votre LLM personnalisé peut déclencher des outils système pour contrôler le flux et l’état de la conversation. Ces outils sont automatiquement inclus dans le paramètre tools de vos requêtes de complétion de chat lorsqu’ils sont configurés dans votre agent.
Fonctionnement des outils système
- Décision du LLM : votre LLM personnalisé décide quand appeler ces outils selon le contexte de la conversation
- Réponse de l’outil : le LLM répond avec des appels de fonction au format OpenAI standard
- Traitement côté backend : ElevenLabs traite les appels d’outils et met à jour l’état de la conversation
Pour en savoir plus sur les outils système, consultez notre guide.
Outils système disponibles
Terminer l'appel
Objectif : terminer automatiquement les conversations lorsque les conditions appropriées sont réunies.
Conditions de déclenchement : le LLM doit appeler cet outil lorsque :
- La tâche principale est terminée et l’utilisateur est satisfait
- La conversation atteint une conclusion naturelle, d’un commun accord
- L’utilisateur indique explicitement vouloir terminer la conversation
Paramètres :
reason(chaîne, obligatoire) : la raison de la fin de l’appelmessage(chaîne, facultatif) : un message d’au revoir à envoyer à l’utilisateur avant de terminer l’appel
Format d’appel de fonction :
Implémentation : configurez cet outil comme outil système dans les paramètres de votre agent. Le LLM recevra des instructions détaillées sur le moment où appeler cette fonction.
En savoir plus : outil de fin d’appel
Détection de la langue
Objectif : passer automatiquement à la langue détectée de l’utilisateur pendant les conversations.
Conditions de déclenchement : le LLM doit appeler cet outil lorsque :
- L’utilisateur parle dans une langue différente de la langue actuelle de la conversation
- L’utilisateur demande explicitement à changer de langue
- La conversation nécessite une prise en charge multilingue
Paramètres :
reason(chaîne, obligatoire) : la raison du changement de languelanguage(chaîne, obligatoire) : le code de la langue vers laquelle passer, qui doit figurer dans la liste des langues prises en charge
Format d’appel de fonction :
Implémentation : configurez les langues prises en charge dans les paramètres de l’agent et ajoutez l’outil système de détection de la langue. L’agent adaptera automatiquement sa voix et ses réponses aux langues détectées.
En savoir plus : outil de détection de la langue
Transfert d'agent
Objectif : transférer les conversations entre agents IA spécialisés selon les besoins de l’utilisateur.
Conditions de déclenchement : le LLM doit appeler cet outil lorsque :
- La demande de l’utilisateur nécessite des connaissances spécialisées ou des capacités d’agent différentes
- L’agent actuel ne peut pas traiter la demande de manière adéquate
- Le flux de la conversation indique qu’un autre type d’agent est nécessaire
Paramètres :
reason(chaîne, facultatif) : la raison du transfert d’agentagent_number(entier, obligatoire) : le numéro, indexé à partir de zéro, de l’agent vers lequel transférer la conversation, selon les règles de transfert configurées
Format d’appel de fonction :
Implémentation : définissez des règles de transfert associant des conditions à des identifiants d’agent spécifiques. Configurez les agents vers lesquels l’agent actuel peut transférer la conversation. Les agents sont référencés par des numéros indexés à partir de zéro dans la configuration de transfert.
En savoir plus : outil de transfert d’agent
Transfert vers un intervenant humain
Objectif : transférer de manière fluide les conversations à des intervenants humains lorsque l’assistance IA ne suffit pas.
Conditions de déclenchement : le LLM doit appeler cet outil lorsque :
- Des problèmes complexes nécessitent un jugement humain
- L’utilisateur demande explicitement une assistance humaine
- L’IA atteint les limites de ses capacités pour la demande spécifique
- Des protocoles d’escalade sont déclenchés
Paramètres :
reason(chaîne, facultatif) : la raison du transferttransfer_number(chaîne, obligatoire) : le numéro de téléphone vers lequel transférer l’appel, qui doit correspondre à l’un des numéros configurésclient_message(chaîne, obligatoire) : message lu au client pendant l’attente du transfertagent_message(chaîne, obligatoire) : message destiné à l’intervenant humain qui reçoit l’appel
Format d’appel de fonction :
Implémentation : configurez les numéros de téléphone et les conditions de transfert. Définissez des messages pour le client et pour l’intervenant humain qui reçoit l’appel. Fonctionne avec Twilio et le trunking SIP.
En savoir plus : outil de transfert vers un intervenant humain
Ignorer le tour
Objectif : permettre à l’agent de faire une pause et d’attendre la saisie de l’utilisateur sans parler.
Conditions de déclenchement : le LLM doit appeler cet outil lorsque :
- L’utilisateur indique avoir besoin d’un moment (« Donnez-moi une seconde », « Laissez-moi réfléchir »)
- L’utilisateur demande une pause dans le flux de la conversation
- L’agent détecte que l’utilisateur a besoin de temps pour traiter les informations
Paramètres :
reason(chaîne, facultatif) : raison libre expliquant pourquoi la pause est nécessaire
Format d’appel de fonction :
Implémentation : aucune configuration supplémentaire n’est nécessaire. L’outil indique simplement à l’agent de rester silencieux jusqu’à ce que l’utilisateur parle de nouveau.
En savoir plus : outil pour ignorer le tour
Détection de messagerie vocale
Paramètres :
reason(chaîne, obligatoire) : raison de la détection de messagerie vocale (par exemple, « message d’accueil automatisé détecté », « aucune réponse humaine »)
Format d’appel de fonction :
En savoir plus : outil de détection de messagerie vocale
Exemple de requête avec des outils système
Lorsque des outils système sont configurés, votre LLM personnalisé reçoit des requêtes incluant les outils au format OpenAI standard :
Votre LLM personnalisé doit prendre en charge les appels de fonction pour utiliser les outils système. Assurez-vous que votre modèle peut générer des réponses d’appel de fonction correctes au format OpenAI.
Fonctionnalités supplémentaires
Paramètres de LLM personnalisé
Vous pouvez transmettre des paramètres supplémentaires à votre implémentation de LLM personnalisé.
Python
Exemple de requête
Avec cette configuration de message personnalisé, votre LLM reçoit des requêtes au format suivant :