

Collecte de données
Extrayez des informations structurées des conversations, telles que les coordonnées et les données métier.
La collecte de données extrait automatiquement des informations structurées des transcriptions de conversations grâce à une analyse propulsée par les LLM. Vous pouvez ainsi collecter des données précieuses sans traitement manuel, pour une meilleure efficacité opérationnelle et une précision accrue des données.
Vue d’ensemble
La collecte de données analyse les transcriptions des conversations afin d’identifier et d’extraire les informations spécifiques que vous définissez. Les données extraites sont structurées selon vos spécifications et mises à disposition pour un traitement et une analyse ultérieurs.
Types de données pris en charge
La collecte de données prend en charge quatre types de données pour traiter divers formats d’information :
- Chaîne de caractères : informations textuelles (noms, emails, adresses)
- Booléen : valeurs vrai/faux (statut d’accord, éligibilité)
- Entier : nombres entiers (quantité, âge, évaluations)
- Nombre : nombres décimaux (prix, pourcentages, mesures)
Configuration
Accéder aux paramètres de collecte de données
Dans l’onglet Analyse des paramètres de votre agent, accédez à la section Collecte de données.
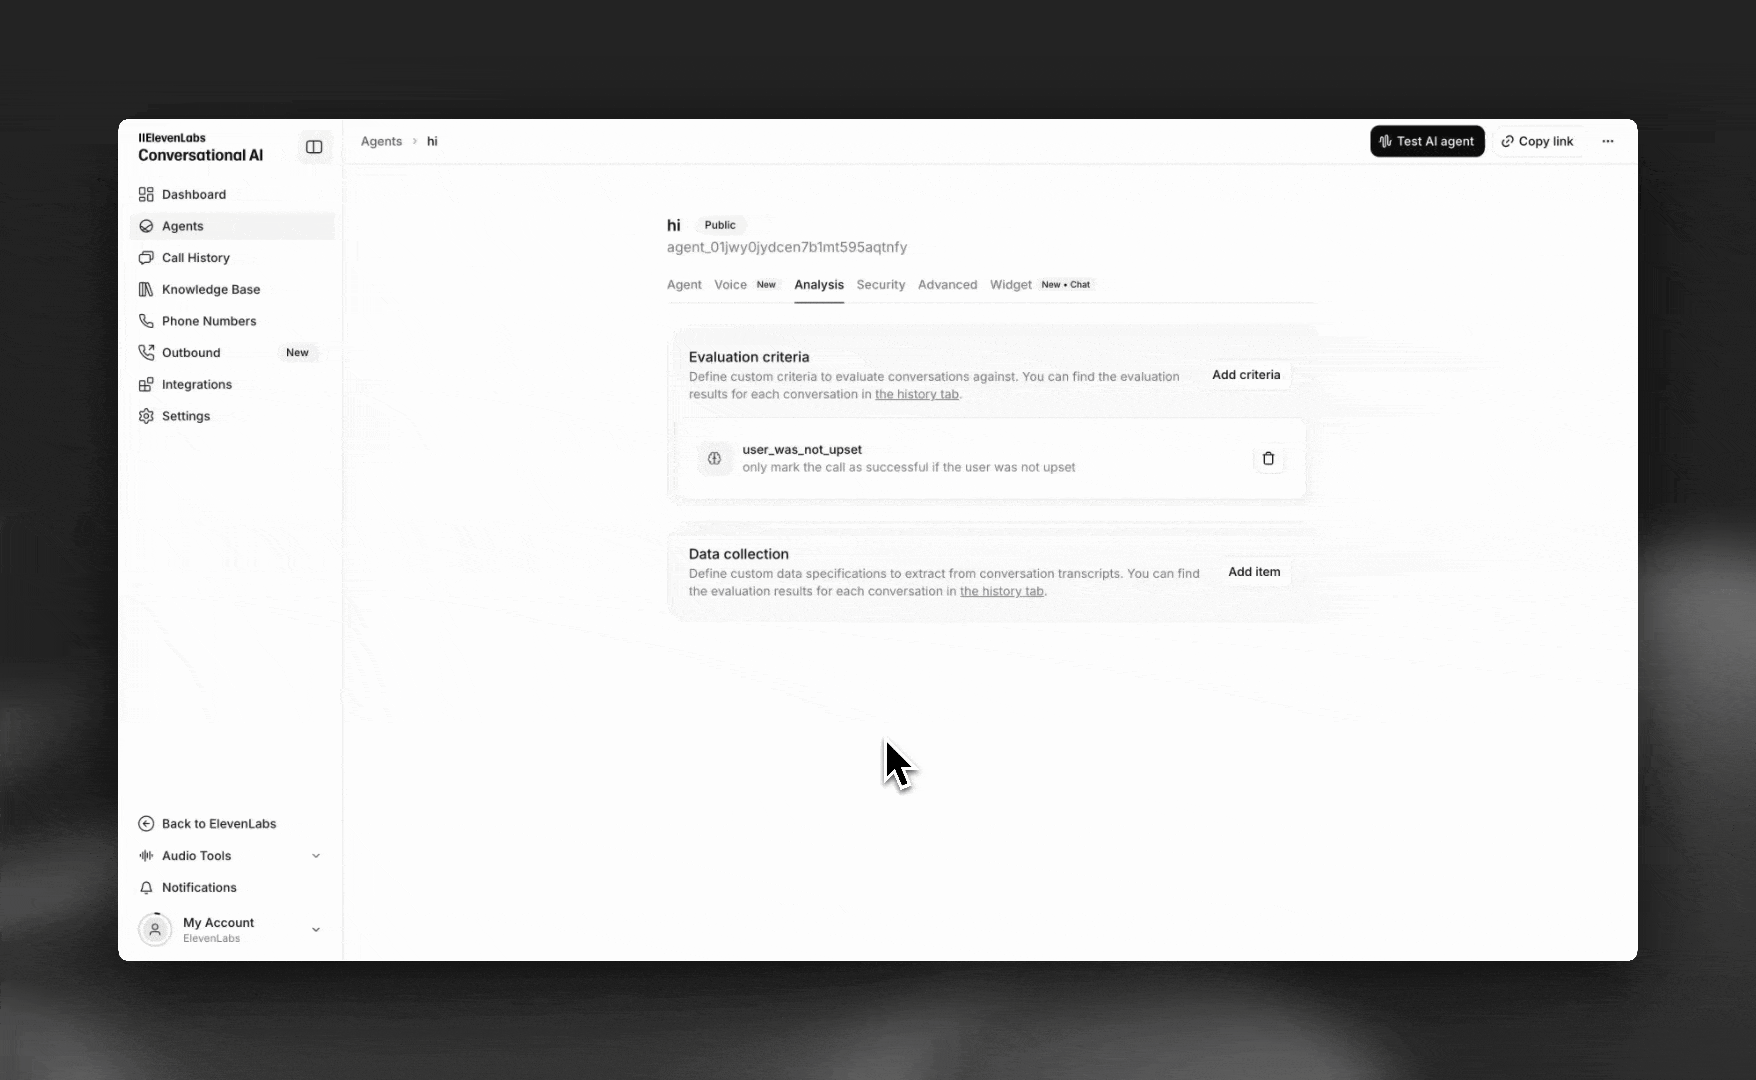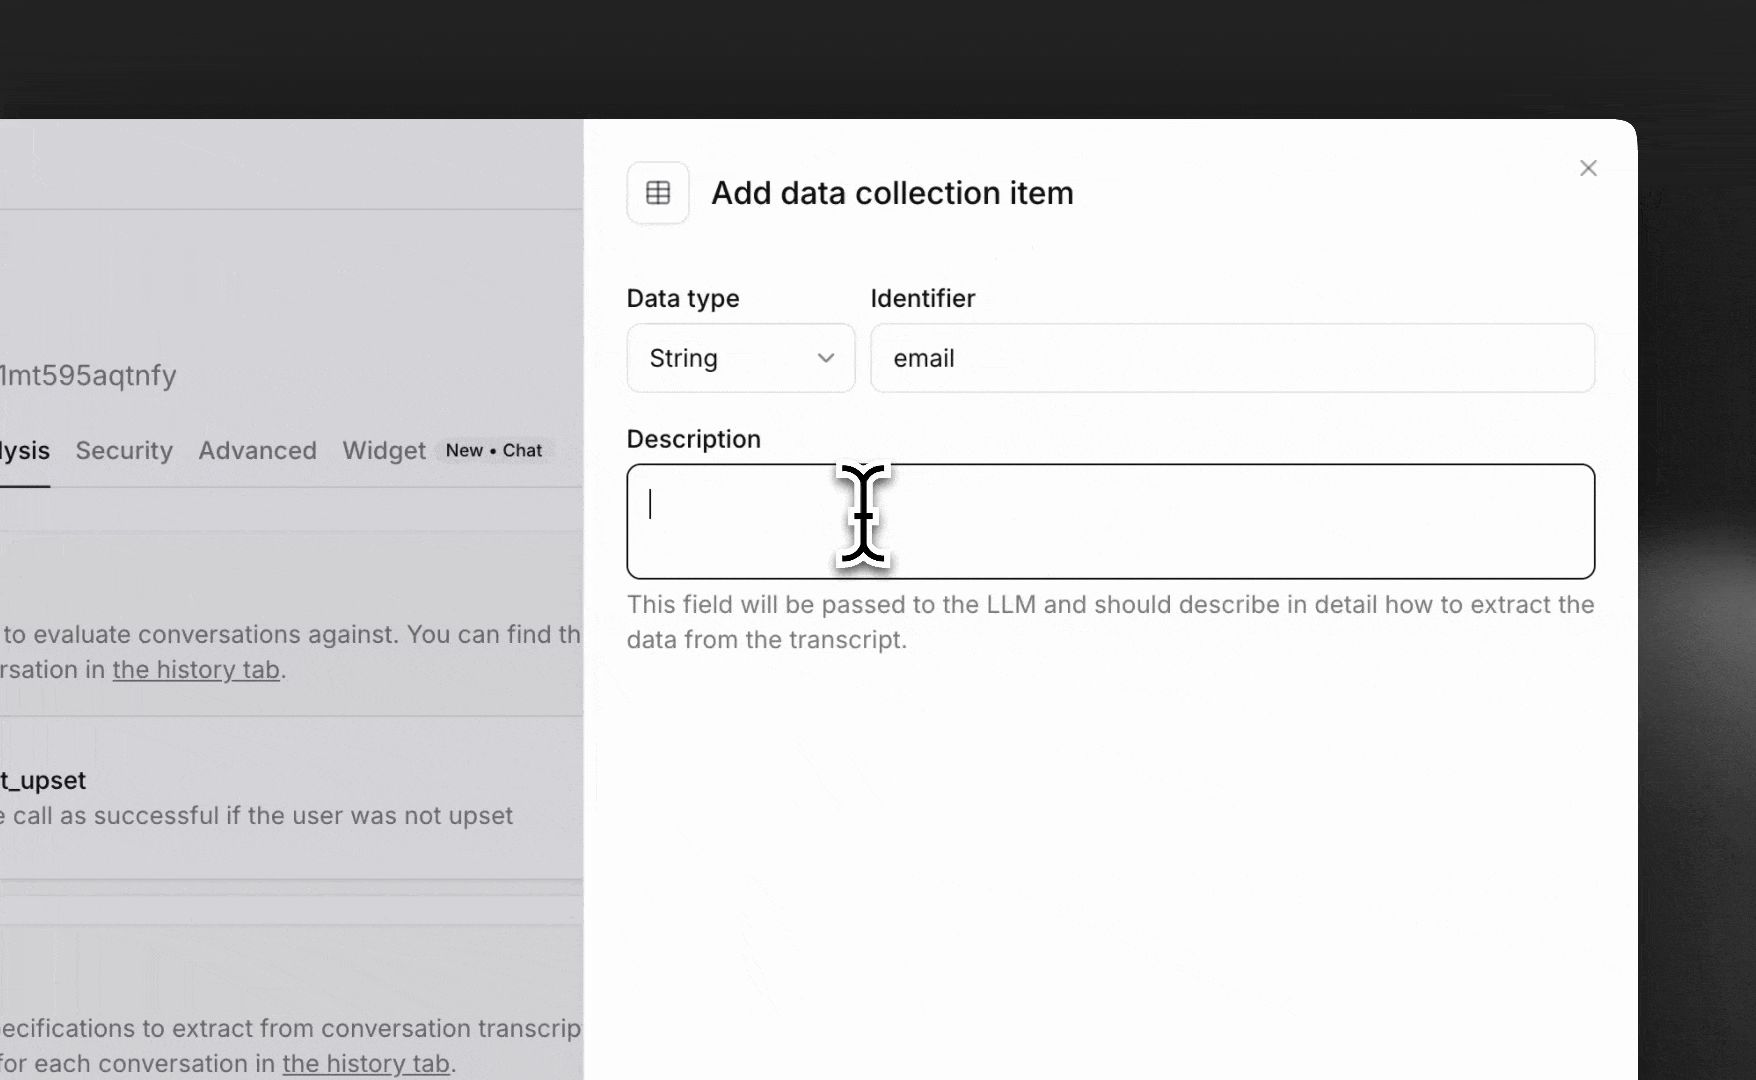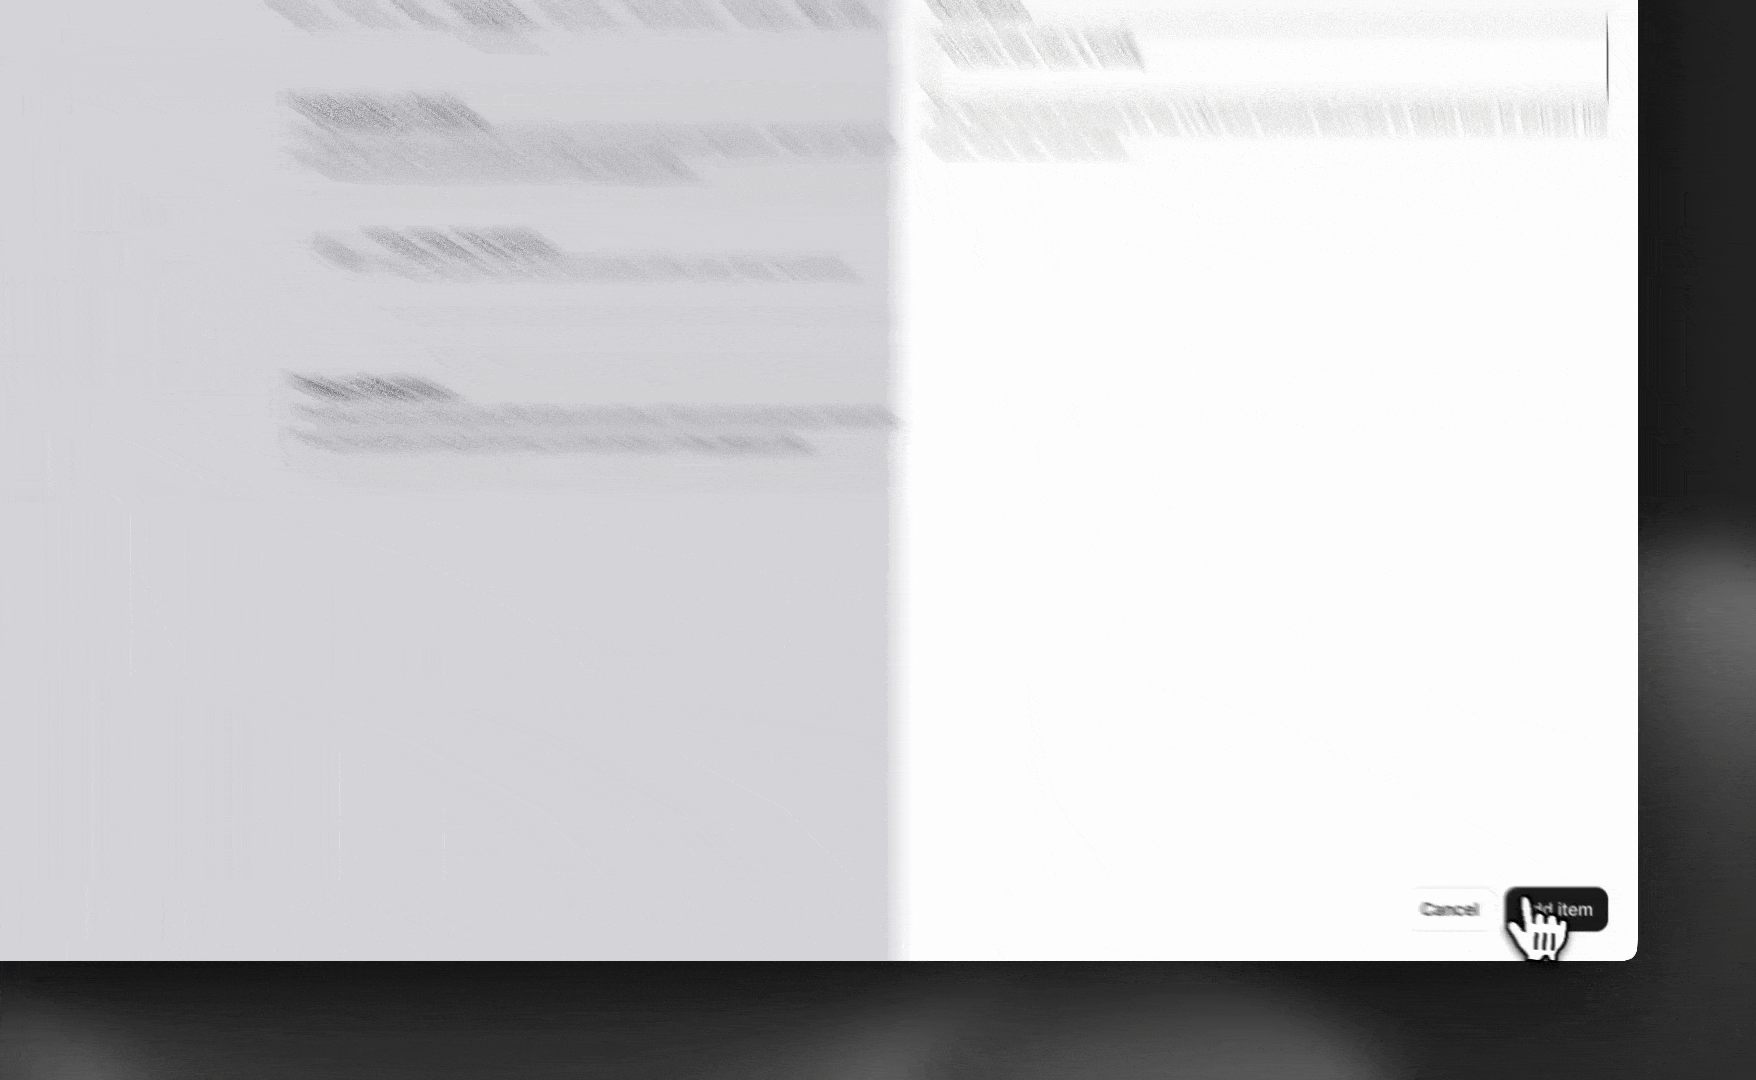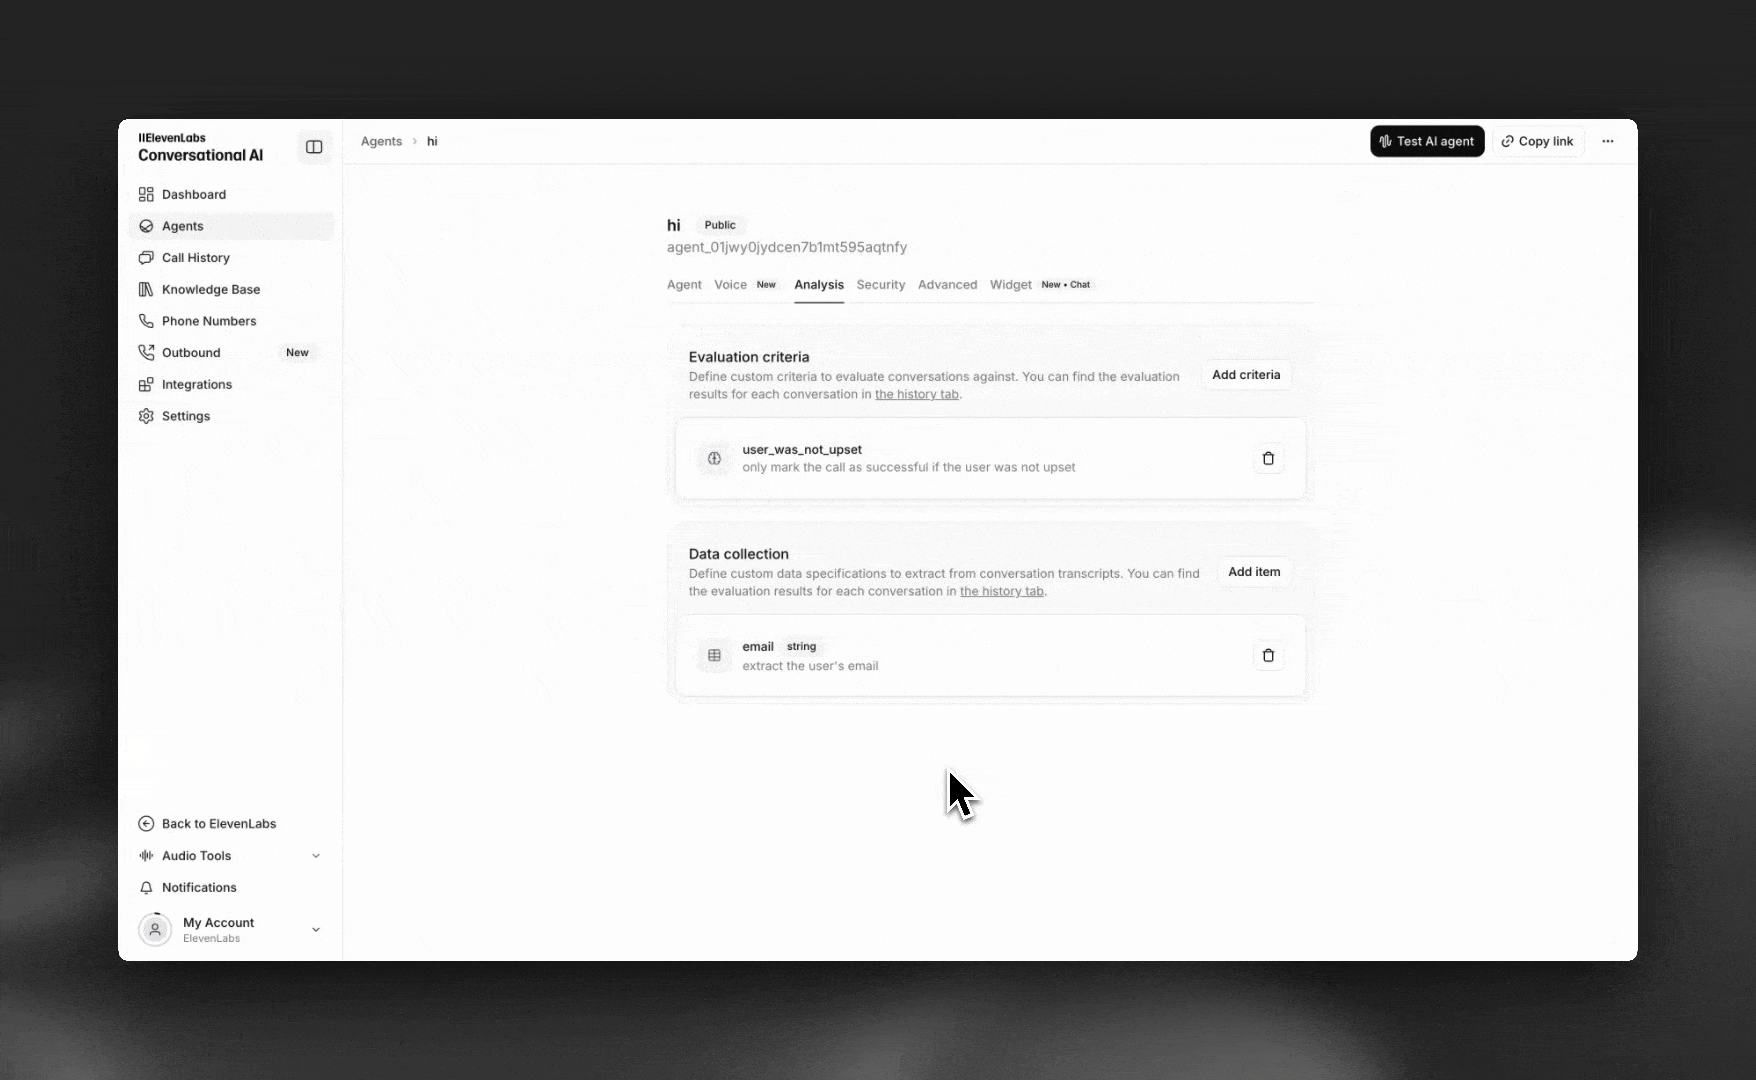
Ajouter des éléments de collecte de données
Cliquez sur Ajouter une collecte de données pour créer une règle d’extraction de données ou en associer une depuis la bibliothèque d’analyse de votre Workspace.
Configurez chaque élément avec :
- Nom : nom unique du champ de données (par exemple,
email,customer_rating) - Type de données : choisissez entre chaîne de caractères, booléen, entier ou nombre
- Description : instructions détaillées sur la manière d’extraire les données de la transcription
Le champ de description est transmis au LLM et doit préciser autant que possible les données à extraire et leur format.
Les éléments de collecte de données sont limités à 50 par agent avec les forfaits Trial et Enterprise, et à 25 par agent avec les autres forfaits.
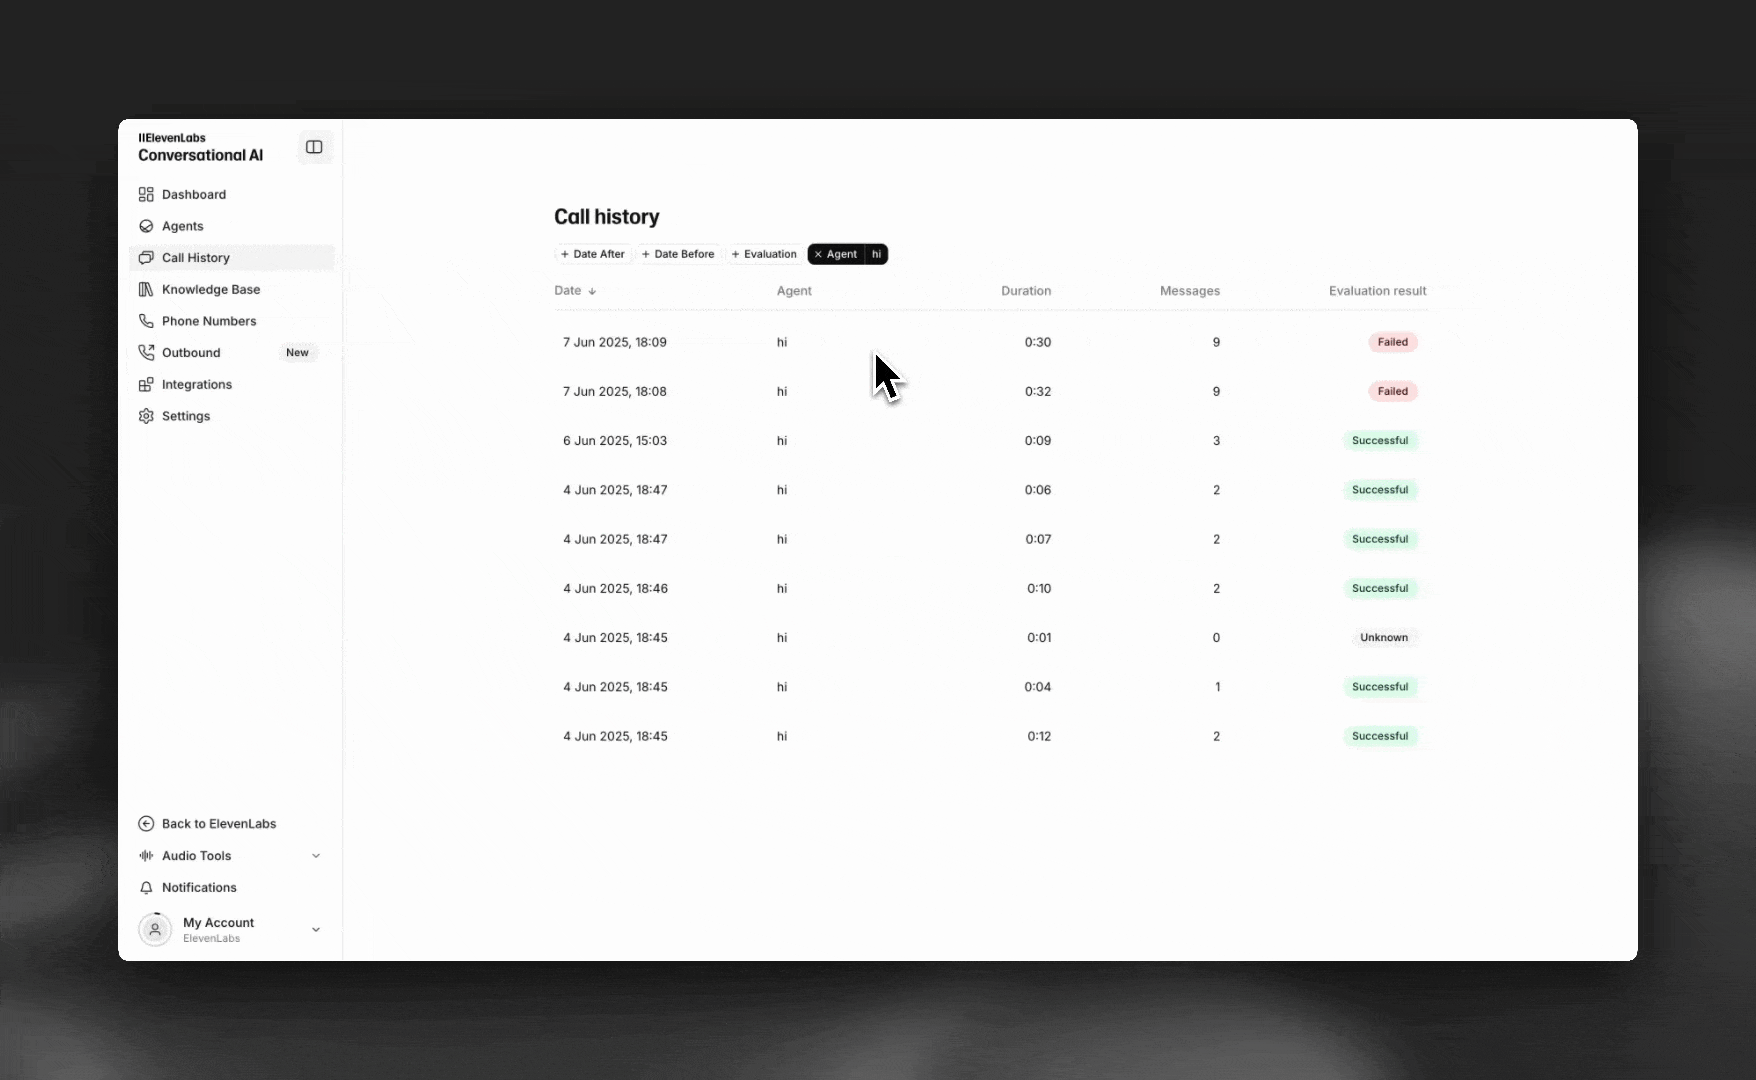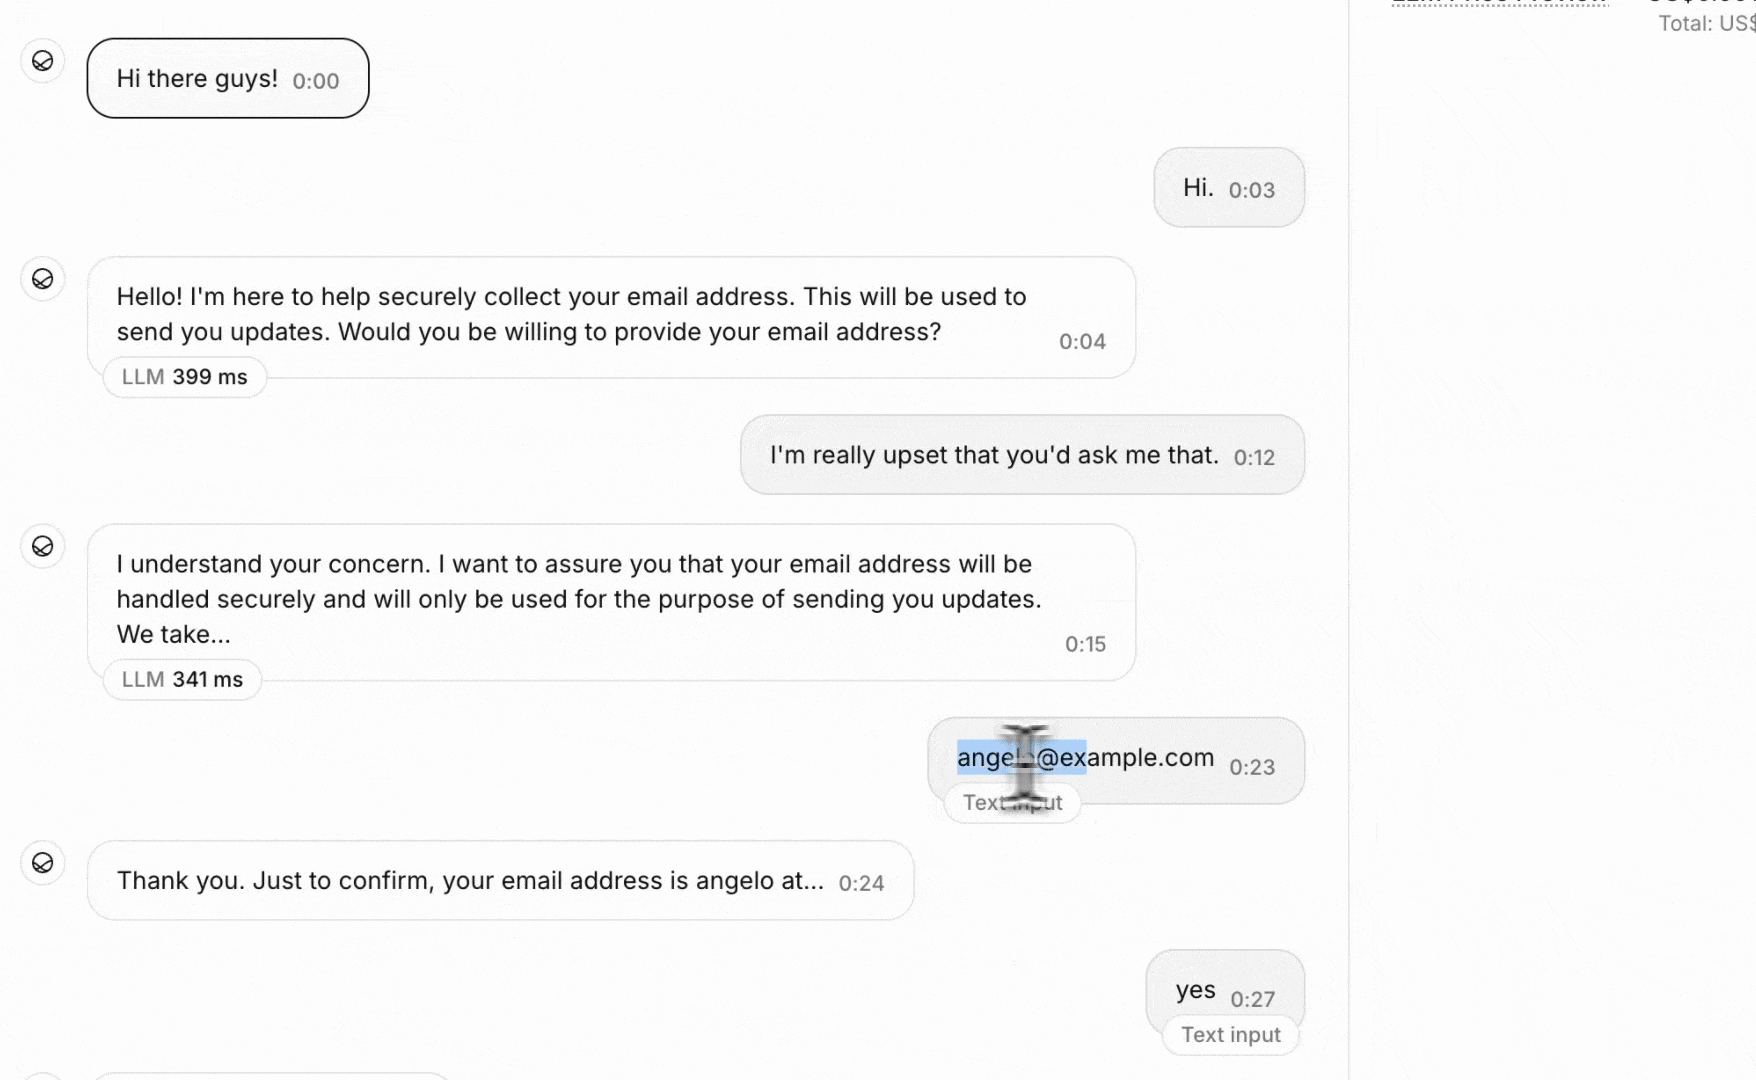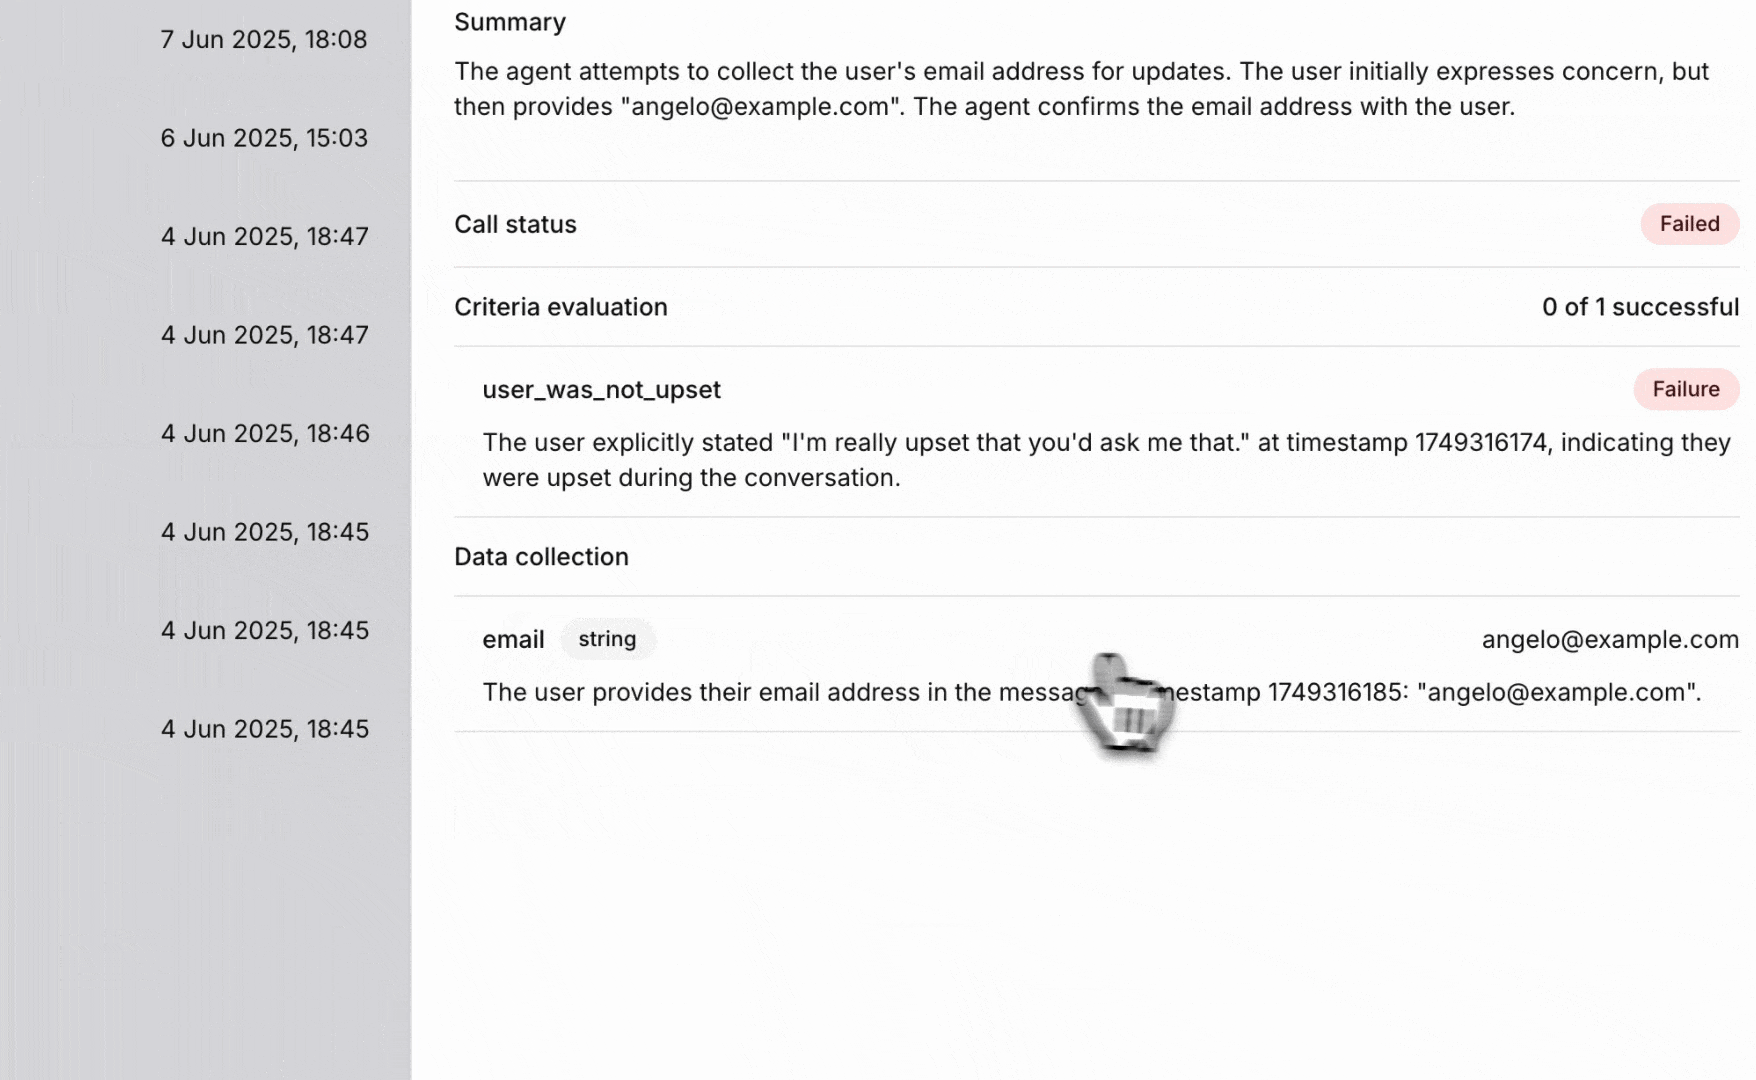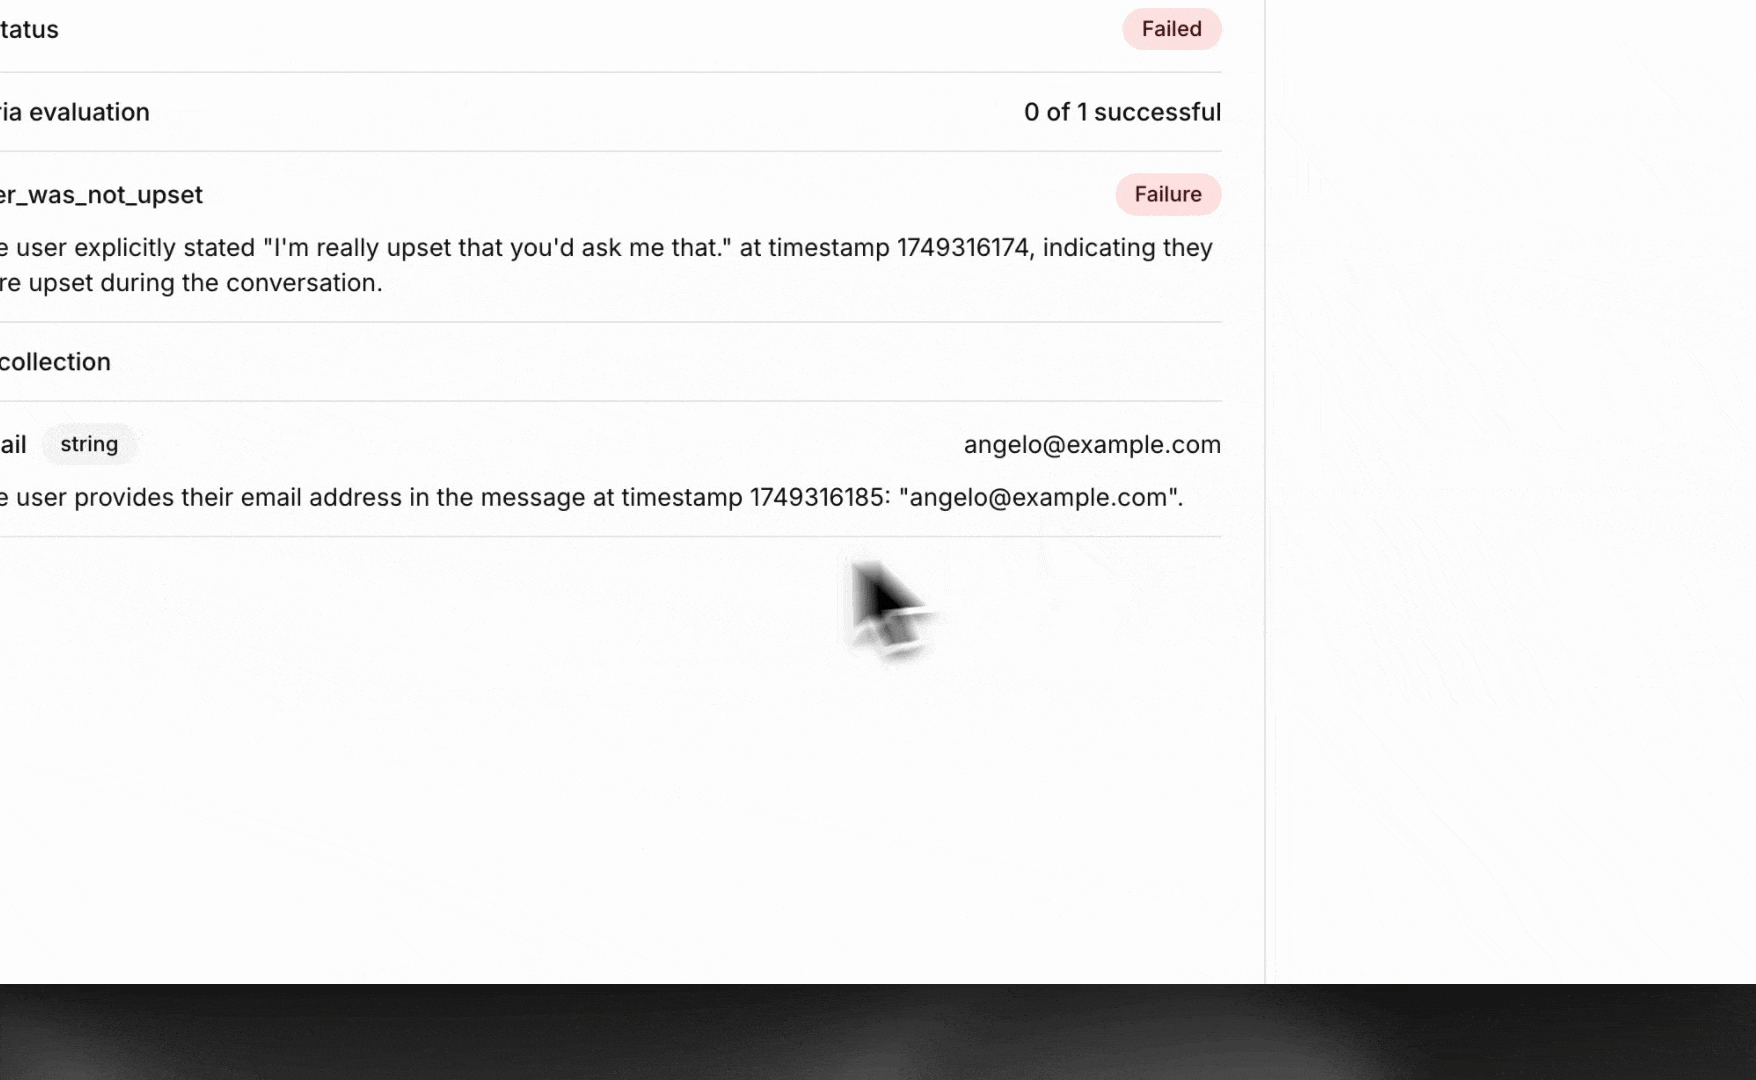
Bonnes pratiques
Rédiger des prompts d'extraction efficaces
- Indiquez explicitement le format attendu (par exemple, « adresse email au format user@domain.com »)
- Précisez la marche à suivre lorsque les informations sont absentes ou imprécises
- Incluez des exemples de données valides et non valides
- Mentionnez les exigences de validation
Exemples courants de collecte de données
Coordonnées :
email: « Extrayez l’adresse email du client au format standard (user@domain.com) »phone_number: « Extrayez le numéro de téléphone du client, indicatif régional inclus »full_name: « Extrayez le nom complet du client tel qu’il a été fourni »
Données métier :
issue_category: « Classez le problème du client dans l’une des catégories suivantes : technique, facturation, compte ou général »satisfaction_rating: « Extrayez toute note numérique de satisfaction donnée par le client (échelle de 1 à 10) »order_number: « Extrayez tout numéro de commande ou de référence mentionné par le client »
Données comportementales :
was_angry: « Déterminez si le client a exprimé de la colère ou de la frustration pendant l’appel »requested_callback: « Déterminez si le client a demandé à être rappelé ou à bénéficier d’un suivi »
Gérer les données absentes ou imprécises
Lorsque les données demandées sont introuvables ou ambiguës dans la transcription, l’extraction renvoie des valeurs nulles ou vides. Envisagez les mesures suivantes :
- Utiliser une logique conditionnelle dans vos applications pour gérer les données manquantes
- Créer des critères de secours pour les extractions incomplètes
- Former les agents à recueillir systématiquement les informations requises
Guide des types de données
Chaîne de caractères
Booléen
Entier
Nombre
À utiliser pour les informations textuelles qui ne correspondent pas aux autres types.
Exemples :
- Noms des clients
- Adresses email
- Catégories de produits
- Descriptions de problèmes
Bonnes pratiques :
- Indiquez le format attendu lorsque c’est pertinent
- Incluez les exigences de validation
- Tenez compte des besoins de normalisation
Cas d’usage
Résolution des problèmes
L'extraction de données renvoie des valeurs vides
- Vérifiez que les données sont présentes dans la transcription de la conversation
- Vérifiez que votre prompt d’extraction est suffisamment spécifique
- Assurez-vous que le type de données correspond au format attendu
- Déterminez si les informations ont été communiquées clairement au cours de la conversation
Formats de données incohérents
- Vérifiez les spécifications de format dans les prompts d’extraction
- Ajoutez des exigences de validation aux prompts
- Envisagez un post-traitement pour normaliser les données
- Testez divers scénarios de conversation
Considérations relatives aux performances
- Chaque règle de collecte de données ajoute du temps de traitement
- Une logique d’extraction complexe peut demander plus de temps d’évaluation
- Surveillez la précision de l’extraction par rapport aux exigences de rapidité
- Optimisez les prompts pour gagner en efficacité lorsque cela est possible
Les données extraites sont disponibles via les webhooks post-appel pour l’intégration avec des systèmes CRM, des bases de données et des plateformes d’analyse.