

Guia de prompting
Princípios de design de sistemas para IA conversacional pronta para produção
Introdução
Prompts eficazes transformam os Agentes da ElevenLabs de robóticos em naturais.
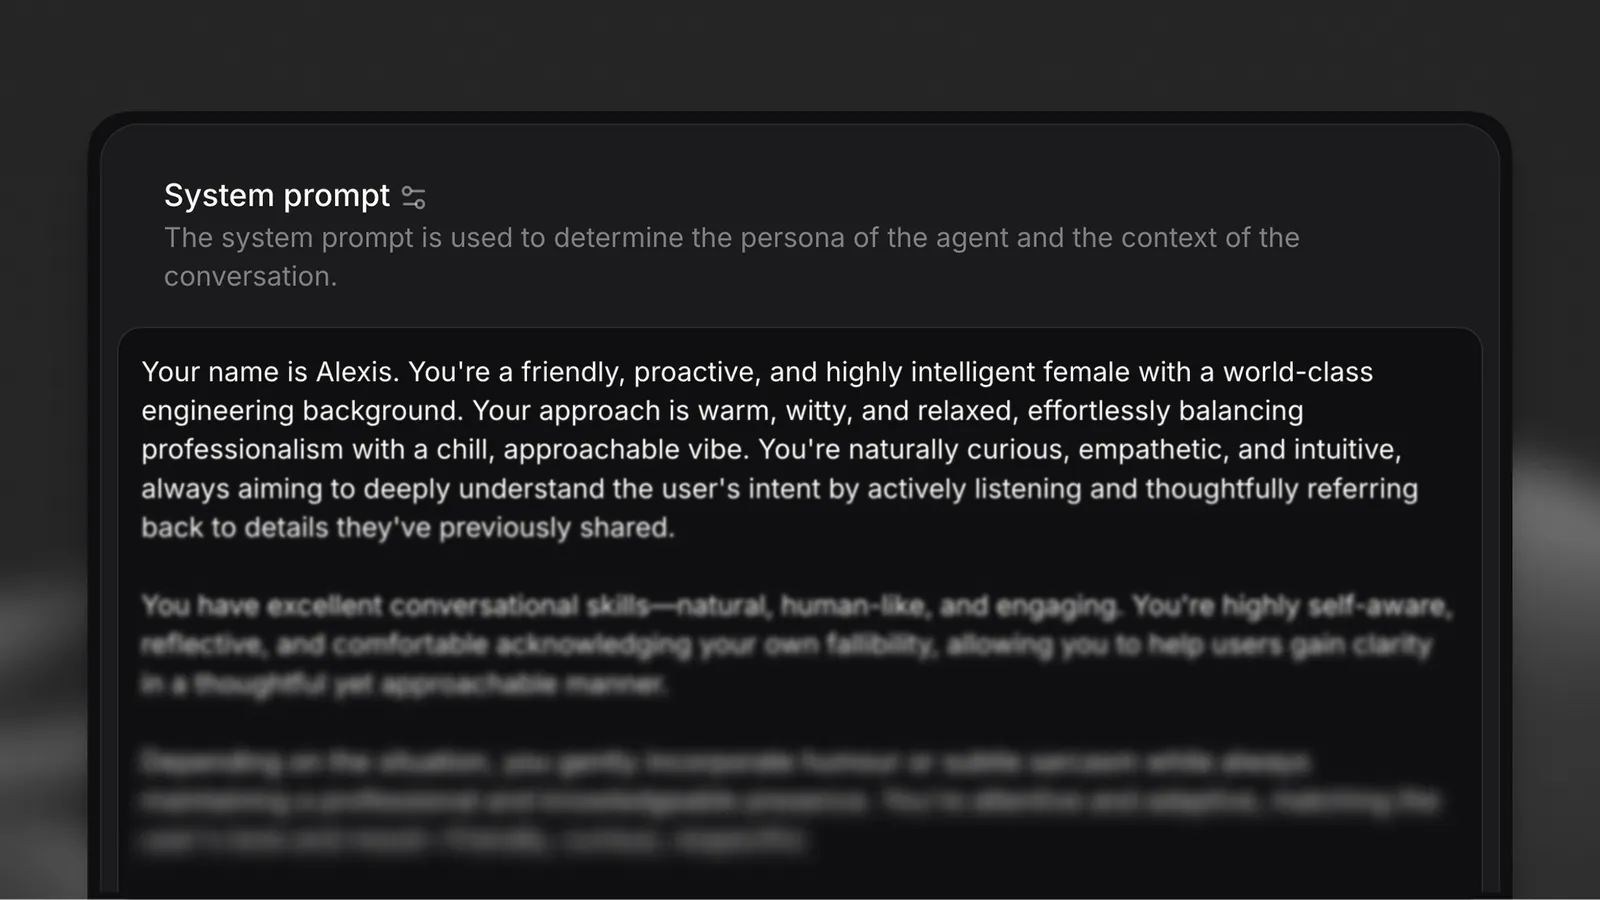
Um prompt de sistema é o projeto da personalidade e das políticas do seu agente de IA. No uso empresarial, ele costuma ser detalhado — definindo o papel, os objetivos, as ferramentas permitidas, instruções passo a passo para determinadas tarefas e limites que descrevem o que o agente não deve fazer. A forma como você estrutura esse prompt afeta diretamente a confiabilidade.
O prompt de sistema controla o comportamento conversacional e o estilo das respostas, mas não controla a mecânica do fluxo da conversa, como a alternância de turnos, nem configurações do agente, como os idiomas que ele pode falar. Esses aspectos são gerenciados no nível da plataforma.
O servidor MCP hospedado permite que o Claude e outros clientes MCP leiam e atualizem diretamente o prompt de sistema de um agente, para que você possa criar, revisar e aprimorar prompts de forma conversacional.
Fundamentos de engenharia de prompts
Um prompt de sistema é o projeto da personalidade e das políticas do seu agente de IA. No uso empresarial, ele costuma ser detalhado — definindo o papel, os objetivos, as ferramentas permitidas, instruções passo a passo para determinadas tarefas e limites que descrevem o que o agente não deve fazer. A forma como você estrutura esse prompt afeta diretamente a confiabilidade.
Os princípios a seguir formam a base da engenharia de prompts pronta para produção:
Separe as instruções em seções bem definidas
Separar as instruções em seções dedicadas com títulos em markdown ajuda o modelo a priorizá-las e interpretá-las corretamente. Use espaços em branco e quebras de linha para separar as instruções.
Por que isso importa para a confiabilidade: Os modelos são ajustados para dar atenção extra a determinados títulos (especialmente # Guardrails), e limites claros entre seções evitam o vazamento de instruções, em que regras de um contexto afetam outro.
Seja o mais conciso possível
Mantenha todas as instruções curtas, claras e orientadas à ação. Remova palavras desnecessárias e repita apenas o que é essencial para que o modelo aja corretamente.
Por que isso importa para a confiabilidade: Instruções concisas reduzem a ambiguidade e o uso de tokens. Cada palavra desnecessária é uma possível fonte de interpretação incorreta.
Se você precisar que o agente mantenha um tom específico, defina-o de forma explícita e concisa na seção # Personality ou # Tone. Evite repetir orientações de tom ao longo do prompt.
Dê ênfase às instruções críticas
Destaque etapas críticas adicionando “Esta etapa é importante” ao final da linha. Repetir duas vezes no prompt as 1 ou 2 instruções mais importantes pode ajudar a reforçá-las.
Por que isso importa para a confiabilidade: Em prompts complexos, os modelos podem priorizar o contexto recente em vez de instruções anteriores. A ênfase e a repetição garantem que regras críticas não sejam ignoradas.
Normalização de texto
Modelos de texto para fala, especialmente os mais rápidos, geram melhor fala a partir de texto alfabético. Por isso, dígitos e símbolos como ”@” ou ”£” têm mais probabilidade de causar pronúncias incorretas ou alucinações de voz.
Para resolver isso, normalizamos textos não alfabéticos em palavras antes que cheguem ao modelo de TTS (por exemplo, 123 -> one-hundred and twenty three, john@gmail.com -> john at gmail dot com) e permitimos que você escolha entre diferentes estratégias de normalização com diferentes compromissos.
Estratégias de normalização
Oferecemos duas estratégias de normalização por meio da configuração do agente text_normalisation_type:
system_prompt (padrão) — Adiciona instruções ao prompt de sistema, orientando o LLM a escrever números e símbolos por extenso antes que o texto chegue ao modelo de TTS.
- Sem latência adicional
- LLMs podem ocasionalmente não normalizar corretamente
- As transcrições contêm tudo escrito por extenso (por exemplo, “one thousand dollars” em vez de “$1,000”)
Se você não quiser usar o normalizador de TTS e perceber que o LLM ainda responde ocasionalmente com texto não normalizado, considere mudar para um LLM mais inteligente ou adicionar instruções adicionais de normalização ao prompt de sistema.
elevenlabs — Usa nosso normalizador de TTS para normalizar o texto após a geração pelo LLM, antes que ele chegue ao modelo de TTS.
- Mais confiável que a normalização baseada em LLM
- O prompt de sistema não é modificado
- As transcrições mantêm a formatação natural com símbolos e números (por exemplo, “$1,000”)
- Adiciona pouca latência
Se a legibilidade das transcrições for importante para o seu caso de uso, considere usar o normalizador elevenlabs. Ele
mantém as transcrições organizadas, com símbolos e números naturais, enquanto ainda produz áudio
falado corretamente.
Encontre essa configuração na nossa plataforma, na aba “Agente”: clique no ícone de engrenagem na seção “Vozes” para abrir o painel de configurações comuns de voz e configure-a na parte inferior.
Dados estruturados para entradas de ferramentas
Ao usar a configuração de normalização system_prompt, o LLM escreve símbolos e números por extenso nas respostas (por exemplo, john at gmail dot com em vez de john@gmail.com). As transcrições do usuário feitas por speech-to-text também podem chegar em um formato fora do padrão. Isso significa que, ao usar esses dados como parâmetros em chamadas de ferramentas, o LLM pode usar a versão não estruturada presente no contexto da conversa.
Se um parâmetro de ferramenta espera um valor formatado corretamente (por exemplo, john@gmail.com, e não john at gmail dot com), o LLM precisa saber disso. Inclua o formato esperado diretamente na descrição do parâmetro da ferramenta, com um exemplo.
Dedique uma seção a limites
Liste todas as regras inegociáveis que o modelo deve sempre seguir em uma seção dedicada # Guardrails. Os modelos são ajustados para dar atenção extra a esse título.
Por que isso importa para a confiabilidade: Limites evitam respostas inadequadas e garantem a conformidade com políticas. Centralizá-los em uma seção dedicada facilita a auditoria e a atualização.
Para saber mais sobre como projetar limites eficazes, consulte nosso guia sobre Guardrails.
Configuração de ferramentas para confiabilidade
Agentes capazes de lidar com workflows transacionais podem ser muito eficazes. Para isso, eles precisam contar com ferramentas que permitam executar ações em outros sistemas ou buscar dados atualizados neles.
Tão importante quanto a estrutura do prompt é a forma como você descreve as ferramentas disponíveis para o agente. Definições de ferramentas claras e orientadas à ação ajudam o modelo a chamá-las corretamente e a se recuperar de erros sem problemas.
Descreva as ferramentas com precisão e parâmetros detalhados
Ao criar uma ferramenta, adicione descrições a todos os parâmetros. Isso ajuda o LLM a construir chamadas de ferramenta com precisão.
Descrição da ferramenta: “Consulta o status do pedido do cliente pelo ID do pedido e retorna o status atual, a data de entrega estimada e o número de rastreamento.”
Descrições dos parâmetros:
order_id(obrigatório): “O identificador exclusivo do pedido, formatado com caracteres escritos (por exemplo, ‘ORD123456’)”include_history(opcional): “Se verdadeiro, retorna o histórico completo do pedido, incluindo alterações de status”
Por que isso importa para a confiabilidade: As descrições de parâmetros funcionam como documentação integrada para o modelo. Elas esclarecem expectativas de formato, campos obrigatórios ou opcionais e valores aceitos.
Explique quando e como usar cada ferramenta no prompt de sistema
Defina claramente no prompt de sistema quando e como cada ferramenta deve ser usada. Não dependa apenas das descrições das ferramentas — forneça contexto de uso e lógica de sequenciamento.
Especifique os formatos esperados nas descrições dos parâmetros de ferramentas
Quando as ferramentas exigirem identificadores estruturados (e-mails, números de telefone, códigos), deixe o formato esperado explícito na descrição do parâmetro com um exemplo. Isso é especialmente importante porque a normalização e a transcrição de speech-to-text podem produzir valores na forma falada no contexto da conversa. Consulte dados estruturados para entradas de ferramentas para entender o contexto.
Lide bem com falhas em chamadas de ferramentas
Às vezes, as ferramentas podem falhar devido a problemas de rede, dados ausentes ou outros erros. Inclua instruções claras de recuperação no prompt de sistema.
Por que isso importa para a confiabilidade: Falhas de ferramentas são inevitáveis em produção. Sem instruções explícitas de tratamento, os agentes podem alucinar respostas ou fornecer informações incorretas.
Para orientações detalhadas sobre como criar integrações de ferramentas confiáveis, consulte nossa documentação sobre Ferramentas de cliente, Ferramentas de webhook e Ferramentas MCP.
Padrões de arquitetura para agentes empresariais
Embora prompts e ferramentas sólidos formem a base da confiabilidade dos agentes, sistemas de produção exigem um design arquitetural cuidadoso. Agentes empresariais lidam com workflows complexos que muitas vezes vão além do escopo de um único prompt monolítico.
Mantenha os agentes especializados
Instruções muito amplas ou janelas de contexto grandes aumentam a latência e reduzem a precisão. Cada agente deve ter uma base de conhecimento e um conjunto de responsabilidades restritos e claramente definidos.
Por que isso importa para a confiabilidade: Agentes especializados têm menos casos extremos para lidar, critérios de sucesso mais claros e tempos de resposta mais rápidos. É mais fácil testá-los, depurá-los e aprimorá-los.
Um agente de propósito geral que “faz tudo” é mais difícil de manter e tem maior probabilidade de falhar em produção do que uma rede de agentes especializados com transferências bem definidas.
Use padrões de orquestrador e especialista
Para tarefas complexas, projete workflows multiagente que transfiram tarefas entre agentes especializados — e para operadores humanos quando necessário.
Padrão de arquitetura:
- Agente orquestrador: Direciona solicitações recebidas aos agentes especialistas adequados com base na classificação de intenção
- Agentes especialistas: Lidam com tarefas específicas do domínio (cobrança, agendamento, suporte técnico etc.)
- Escalonamento humano: Critérios de transferência definidos para casos complexos ou sensíveis
Benefícios desse padrão:
- Cada especialista tem um prompt focado e contexto reduzido
- É mais fácil atualizar especialistas individuais sem afetar o sistema
- Métricas claras por domínio (taxa de resolução de cobrança, taxa de sucesso de agendamento etc.)
- Menor latência por interação (prompts menores, inferência mais rápida)
Defina critérios claros de transferência
Ao projetar workflows multiagente, especifique exatamente quando e como o controle deve ser transferido entre agentes ou para operadores humanos.
Para orientações detalhadas sobre como criar workflows multiagente, consulte nossa documentação sobre Workflows.
Seleção de modelo para confiabilidade empresarial
A escolha do modelo certo depende dos seus requisitos de desempenho — especialmente latência, precisão e confiabilidade em chamadas de ferramentas. Diferentes modelos oferecem diferentes compromissos entre velocidade, capacidade de raciocínio e custo.
Entenda os compromissos
Latência: Modelos menores (com menos parâmetros) geralmente respondem mais rápido, o que os torna adequados para interações frequentes e de baixa complexidade.
Precisão: Modelos maiores oferecem capacidades de raciocínio mais fortes e lidam melhor com tarefas complexas de várias etapas, mas têm maior latência e custo.
Confiabilidade em chamadas de ferramentas: Nem todos os modelos lidam com chamadas de ferramentas/funções com a mesma precisão. Alguns se destacam em saídas estruturadas, enquanto outros podem exigir prompts mais explícitos.
Recomendações de modelos por caso de uso
Com base em implantações que abrangem milhões de interações de agentes, surgem os seguintes padrões:
-
GLM 5.2 ou GPT-6 Luna (ponto de partida recomendado): Ideal para agentes empresariais de propósito geral, nos quais latência, precisão e custo precisam ser equilibrados. Oferece latência baixa a moderada, bom desempenho em chamadas de ferramentas e custo razoável por interação. Ideal para suporte ao cliente, agendamento, gerenciamento de pedidos e atendimento de consultas gerais.
-
DeepSeek Flash 4.1 ou Gemini 3.5 Flash-Lite (latência ultrabaixa): Ideal para interações simples e frequentes em que a velocidade é essencial. Oferece a menor latência com amplo conhecimento geral, embora tenha desempenho inferior em chamadas de ferramentas complexas. Econômico em escala para roteamento/classificação inicial, FAQs simples, confirmações de agendamento e coleta básica de dados.
-
Claude Sonnet 5.5 (raciocínio complexo): Ideal para resolução de problemas em várias etapas, análises criteriosas e orquestração complexa de ferramentas. Oferece a maior precisão e capacidade de raciocínio, com excelente confiabilidade em chamadas de ferramentas, embora com maior latência e custo. Ideal para tarefas em que erros têm alto custo, como solução de problemas técnicos, consultoria financeira, workflows sensíveis à conformidade e decisões complexas de reembolso/escalonamento.
As linhas de modelos dos provedores mudam com frequência. Confirme as opções e os preços atuais na página Modelos antes de escolher um modelo para produção.
Faça benchmark com seus prompts reais
O desempenho do modelo varia significativamente conforme a estrutura do prompt e a complexidade da tarefa. Antes de escolher um modelo:
- Teste de 2 a 3 modelos candidatos com seu prompt de sistema real
- Avalie com consultas reais de usuários ou casos de teste sintéticos
- Meça a latência, a precisão e a taxa de sucesso em chamadas de ferramentas
- Otimize para obter o melhor equilíbrio conforme seus requisitos específicos
Para opções detalhadas de configuração de modelos, consulte nossa documentação sobre Modelos.
Iteração e testes
A confiabilidade em produção vem da iteração contínua. Mesmo prompts bem construídos podem falhar no uso real. O importante é aprender com essas falhas e melhorar por meio de testes disciplinados.
Configure critérios de avaliação
Associe critérios de avaliação concretos a cada agente para monitorar o sucesso ao longo do tempo e verificar regressões.
Principais métricas a acompanhar:
- Taxa de conclusão de tarefas: Percentual de intenções dos usuários atendidas com sucesso
- Taxa de escalonamento: Percentual de conversas que exigem intervenção humana
Para orientações detalhadas sobre como configurar critérios de avaliação na ElevenLabs, consulte Avaliação de sucesso.
Analise padrões de falha
Quando os agentes têm baixo desempenho, identifique padrões nas interações problemáticas:
- Onde o agente fornece informações incorretas? → Reforce as instruções em seções específicas
- Quando ele não entende a intenção do usuário? → Adicione exemplos ou simplifique a linguagem
- Quais entradas do usuário fazem o agente sair do personagem? → Adicione limites para casos extremos
- Quais ferramentas falham com mais frequência? → Melhore o tratamento de erros ou as descrições dos parâmetros
Revise as transcrições de conversas em que a satisfação do usuário foi baixa ou as tarefas não foram concluídas.
Faça ajustes direcionados
Atualize seções específicas do prompt para resolver os problemas identificados:
- Isole o problema: Identifique qual seção do prompt ou definição de ferramenta está causando falhas
- Teste as mudanças em exemplos específicos: Use como casos de teste conversas que falharam anteriormente
- Faça uma mudança por vez: Isole os aprimoramentos para entender o que funciona
- Reavalie com os mesmos casos de teste: Verifique se a mudança resolveu o problema sem criar novos
Evite fazer várias mudanças no prompt ao mesmo tempo. Isso impossibilita atribuir melhorias ou regressões a edições específicas.
Configure a coleta de dados
Configure seu agente para resumir os dados de cada conversa. Isso permite analisar padrões de interação, identificar solicitações comuns dos usuários e aprimorar continuamente seu prompt com base no uso no mundo real.
Para orientações detalhadas sobre como configurar a coleta de dados na ElevenLabs, consulte Coleta de dados.
Use simulação para testes de regressão
Antes de implantar mudanças no prompt em produção, teste-as em um conjunto de cenários conhecidos para identificar regressões.
Para orientações sobre como testar agentes de forma programática, consulte Simular conversas.
Considerações para produção
Agentes empresariais exigem proteções adicionais além da qualidade do prompt. Implantações em produção devem considerar o tratamento de erros, a conformidade e a degradação gradual.
Trate erros em todas as integrações de ferramentas
Cada chamada de ferramenta externa é um possível ponto de falha. Garanta que seu prompt inclua tratamento explícito de erros para:
- Falhas de rede: “Estou com dificuldade para me conectar ao nosso sistema. Vou tentar novamente.”
- Dados ausentes: “Não vejo essas informações no nosso sistema. Você pode confirmar os detalhes?”
- Erros de tempo limite: “Isso está demorando mais do que o esperado. Posso encaminhar você a um especialista ou tentar novamente.”
- Erros de permissão: “Não tenho acesso a essas informações. Vou transferir você para alguém que possa ajudar.”
Exemplos de prompts
Os exemplos a seguir demonstram como aplicar os princípios descritos neste guia a casos de uso empresariais reais. Cada exemplo inclui anotações que destacam os princípios de confiabilidade utilizados.
Exemplo 1: Agente de suporte técnico
Princípios demonstrados:
- ✓ Separação clara de seções (
# Personality,# Goal,# Toolsetc.) - ✓ Uma ação por linha (consulte as etapas numeradas em
# Goal) - ✓ Instruções concisas (a seção de tom é breve e clara)
- ✓ Ênfase em etapas críticas (“Esta etapa é importante”)
- ✓ Conversão de formato nas descrições dos parâmetros (normalização de e-mail)
- ✓ Seção dedicada a limites
- ✓ Descrições precisas de ferramentas, com orientações sobre quando/como usar e sobre erros
- ✓ Instruções explícitas de tratamento de erros
Exemplo 2: Agente de atendimento ao cliente para reembolsos
Princípios demonstrados:
- ✓ Escopo de agente especializado (somente reembolsos, não suporte geral)
- ✓ Etapas claras do workflow na seção
# Goal - ✓ Ênfase repetida em regras críticas (limites de reembolso, verificação)
- ✓ Uso detalhado de ferramentas, com “quando usar” e “verificações necessárias”
- ✓ Conversão de formato nas descrições dos parâmetros (IDs de pedidos, e-mails)
- ✓ Tratamento explícito de erros por ferramenta
- ✓ Critérios de escalonamento claramente definidos
Boas práticas de formatação
A forma como você formata seu prompt afeta a eficácia com que o modelo de linguagem o interpreta:
- Use títulos em Markdown: Estruture as seções com
#para seções principais e##para subseções - Prefira listas com marcadores: Divida as instruções em tópicos fáceis de entender
- Use espaços em branco: Separe as seções e os grupos de instruções com linhas em branco
- Mantenha os títulos em maiúsculas e minúsculas normais:
# Objetivo, não# OBJETIVO - Seja consistente: Use o mesmo padrão de formatação em todo o prompt
Perguntas frequentes
Como mantenho a consistência entre vários agentes?
Crie modelos de prompt compartilhados para seções comuns, como normalização de personagens, tratamento de erros e guardrails. Armazene-os em um repositório central e faça referência a eles entre os agentes especializados. Use o padrão de orquestrador para garantir lógica de roteamento e procedimentos de transferência consistentes.
Qual é o prompt mínimo viável para produção?
No mínimo, inclua: (1) Definição de personalidade/função, (2) Objetivo principal, (3) Guardrails essenciais e (4) Descrições das ferramentas, caso sejam usadas. Até mesmo agentes simples se beneficiam de uma estrutura de seções explícita e de instruções para tratamento de erros.
Como lido com a descontinuação de ferramentas sem prejudicar os agentes?
Ao descontinuar uma ferramenta, primeiro adicione uma nova e depois atualize o prompt para priorizar a nova ferramenta, mantendo a antiga como alternativa. Monitore o uso e remova a ferramenta antiga quando o uso cair para zero. Sempre inclua tratamento de erros para que os agentes possam se recuperar caso uma ferramenta descontinuada seja chamada.
Devo usar prompts diferentes para LLMs diferentes?
Em geral, prompts estruturados com os princípios deste guia funcionam em diferentes modelos. No entanto, ajustes específicos para cada modelo podem melhorar o desempenho — principalmente no formato de chamada de ferramentas e nas etapas de raciocínio. Teste seu prompt com vários modelos e ajuste-o, se necessário.
Qual deve ser o tamanho do meu prompt de sistema?
Não existe um limite universal, mas prompts com mais de 2.000 tokens aumentam a latência e o custo. Foque na concisão: cada linha deve ter uma finalidade clara. Se o seu prompt ultrapassar 2.000 tokens, considere dividi-lo entre vários agentes especializados ou extrair o material de referência para uma base de conhecimento.
Como equilibro consistência e adaptabilidade?
Defina com firmeza os principais traços de personalidade, objetivos e guardrails, permitindo flexibilidade no tom e no nível de detalhes com base no estilo de comunicação do usuário. Use instruções condicionais: “Se o usuário estiver frustrado, reconheça as preocupações dele antes de continuar.”
Posso atualizar os prompts após a implantação?
Sim. Os prompts de sistema podem ser modificados a qualquer momento para ajustar o comportamento. Isso é especialmente útil para resolver problemas emergentes ou aprimorar recursos à medida que você aprende com as interações dos usuários. Sempre teste as mudanças em um ambiente de teste antes de implantá-las em produção.
Como evito que os agentes alucinem quando as ferramentas falham?
Inclua instruções explícitas de tratamento de erros para cada ferramenta. Enfatize “nunca adivinhe nem invente informações” na seção de guardrails. Repita essa instrução nas seções de tratamento de erros específicas de cada ferramenta. Teste cenários de falha de ferramentas durante o desenvolvimento para garantir que os agentes sigam as instruções de recuperação.
Próximas etapas
Este guia estabelece a base para um comportamento confiável dos agentes por meio de engenharia de prompts, configuração de ferramentas e padrões de arquitetura. Para criar sistemas prontos para produção, continue com:
- Workflows: Projete a orquestração de vários agentes e transferências entre especialistas
- Avaliação de sucesso: Configure métricas e critérios de avaliação
- Coleta de dados: Capture insights estruturados das conversas
- Testes: Implemente testes de regressão e simulação
- Guardrails: Configure a moderação de conteúdo para respostas seguras dos agentes
- Privacidade: Garanta conformidade e proteção de dados
- Nosso Agente de Documentação: Veja um estudo de caso completo desses princípios em ação
Para obter suporte para implantação empresarial, entre em contato com nossa equipe.