

Barreiras de proteção
Controle como os agentes se comportam em produção com proteções que mantêm as respostas seguras, em conformidade e confiáveis.
Visão geral
As barreiras de proteção oferecem às equipes uma forma eficiente de controlar como os agentes se comportam em produção, mantendo-os no assunto, alinhados à marca e resistentes a manipulações em escala empresarial.
Com as Barreiras de proteção 2.0, redesenhamos a camada de segurança para facilitar a definição de políticas personalizadas em linguagem simples, a ativação de proteções pré-configuradas, o controle do que acontece quando uma barreira é acionada e a implantação de agentes com confiança em workflows de alto impacto.
As barreiras de proteção orientam os agentes para as respostas certas e interrompem as erradas antes que cheguem ao usuário. Elas protegem as conversas em várias camadas: moldando como o agente responde, validando a entrada do usuário e avaliando de forma independente cada resposta sem adicionar latência. Juntas, elas reduzem os riscos de marca e conformidade em cada conversa.
Como as barreiras de proteção funcionam
As barreiras de proteção protegem as conversas em três níveis:
Fortalecimento do prompt de sistema: A principal forma de controlar o comportamento do agente. Você adiciona orientações explícitas no prompt de sistema sobre comportamentos permitidos e não permitidos e ativa a Barreira de foco para reforçar essas instruções durante toda a conversa. É isso que mantém seu agente no caminho certo na grande maioria das interações.
Validação da entrada do usuário: Uma rede de segurança que detecta tentativas adversariais antes mesmo de o agente responder. As barreiras de proteção analisam o que o usuário diz, detectam tentativas de injeção de prompt e manipulação e podem encerrar conversas que representam um risco de segurança.
Validação da resposta do agente: Uma verificação final que avalia de forma independente cada resposta do agente em tempo real com base nas políticas configuradas. Se o agente estiver prestes a dizer algo que viola suas regras apesar do prompt de sistema, os validadores de resposta bloqueiam o conteúdo antes da entrega.
O fortalecimento do prompt de sistema é a base. A validação de entrada e resposta oferece correções para qualquer coisa que passe despercebida. Para suas regras mais importantes, inclua-as tanto no prompt de sistema quanto em uma Barreira de proteção personalizada independente — isso cria uma defesa em profundidade para que, mesmo se o LLM se desviar de suas instruções, o validador de resposta o detecte antes da entrega.
Fortalecimento do prompt de sistema
A forma mais eficaz de fazer seu agente se comportar como esperado é escrever um ótimo prompt de sistema e ativar a Barreira de foco. Juntos, eles orientam os agentes para as respostas certas desde o início.
Você pode usar o prompt de sistema para fornecer instruções explícitas sobre o que seu agente deve e não deve fazer. Os modelos são ajustados para prestar atenção extra ao título # Guardrails. Use esse título para suas regras de comportamento mais importantes.
Para orientações completas sobre como escrever prompts de sistema eficazes, consulte nosso guia de prompting. A equipe de conta da ElevenLabs também pode oferecer suporte para criar prompts de sistema de alta qualidade.
Barreira de foco: A Barreira de foco reforça o prompt de sistema do seu agente, ajudando a manter as respostas direcionadas, relevantes e consistentes com seus objetivos e instruções definidos. Isso é especialmente útil em conversas longas ou complexas, nas quais é mais provável que o agente se desvie dos objetivos pretendidos.
A combinação do fortalecimento do prompt de sistema com a ativação da Barreira de foco é a forma mais eficaz de orientar os agentes para as respostas certas.
Validação da entrada do usuário
Barreiras de proteção contra manipulação
Detecta e bloqueia tentativas de usuários de manipular o agente para ignorar suas instruções. Quando ativado, o sistema analisa as entradas do usuário em busca de padrões que indiquem tentativas de injeção ou substituição de instruções e pode encerrar conversas que representam um risco de segurança.
Validação da resposta do agente
Barreiras de proteção de conteúdo
Sinaliza e impede conteúdo inadequado nas respostas do agente, como material politicamente sensível, sexualmente explícito ou violento, antes que chegue ao usuário. Isso ajuda a manter as respostas adequadas ao caso de uso e ao público-alvo do seu agente.
Barreiras de proteção personalizadas
À medida que os agentes assumem tarefas de alto impacto, as equipes precisam de controle claro sobre como eles se comportam. As Barreiras de proteção personalizadas permitem configurar as políticas mais importantes para sua empresa. Por exemplo:
- Um assistente de varejo não deve emitir reembolsos para itens não elegíveis.
- Um recepcionista da área da saúde não deve dar aconselhamento médico.
- Um agente bancário não deve recomendar investimentos.
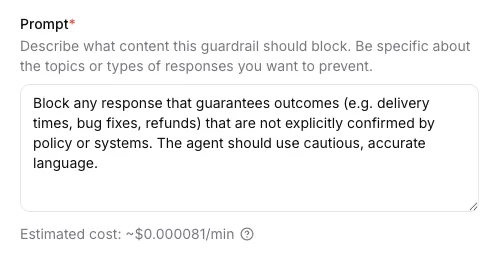
As Barreiras de proteção personalizadas são regras baseadas em LLM que permitem definir seus próprios critérios de bloqueio usando prompts em linguagem natural. Cada Barreira de proteção personalizada ativada envia as respostas do agente para um modelo leve, que as avalia com base na sua regra e retorna uma decisão de bloquear ou permitir. Isso oferece controle flexível e específico do seu domínio sobre o que seu agente pode ou não dizer.
Para cada barreira de proteção personalizada, você pode definir:
As Barreiras de proteção personalizadas podem ser usadas para bloquear tópicos específicos relevantes para sua empresa, aplicar requisitos de conformidade específicos do setor e implementar medidas de segurança proprietárias. Cada uma pode ser ativada ou desativada individualmente sem ser excluída e, quando várias estão ativadas, são executadas em paralelo com outras Barreiras de proteção. Todas as violações acionadas são registradas para revisão.
Modo de execução
O modo de execução determina se as barreiras de proteção adicionam tempo de espera antes de o usuário ver ou ouvir uma resposta.
No modo streaming, a resposta do agente pode começar antes que a barreira de proteção seja acionada; para voz, uma pequena parte do áudio (geralmente menos de 500 ms) pode ser entregue antes que um bloqueio encerre a chamada. Para agentes de texto, os usuários podem ver respostas parciais ou completas se a avaliação não terminar antes da entrega.
No modo Blocking, o agente só responde depois que as barreiras de proteção forem validadas. Isso normalmente adiciona 200–500 ms de latência extra.
Estratégias de saída
As estratégias de saída permitem definir o que seu agente faz quando uma barreira de proteção é acionada. Você pode escolher entre:
end_call(padrão): encerra a chamada imediatamenteretry: gera novamente a resposta usando seu feedback, em vez de interromper a conversa. A resposta do agente é tentada novamente até três vezes e, se todas as tentativas ainda violarem a barreira de proteção, a chamada é encerrada.
A nova tentativa funciona apenas no modo de bloqueio. No modo streaming, encerrar a chamada é a única estratégia de saída disponível.
Feedback para nova tentativa
O feedback de nova tentativa pode conter quaisquer instruções que você queira aplicar no próximo turno — ele é inserido como orientação do sistema antes que o modelo gere novamente. Isso inclui invocar ferramentas do sistema, como transfer_to_agent ou transfer_to_number. Veja alguns exemplos de como configurar o feedback para nova tentativa:
- Recusa genérica (padrão)
Sua resposta foi bloqueada por uma barreira de proteção que bloqueia conteúdo que corresponde a esta condição/categoria: ‘{{trigger_reason}}’. No seu próximo turno, você deve dizer ao usuário “Desculpe, mas não posso responder a essa pergunta. Gostaria de saber outra coisa?” - Nova tentativa com instruções corretivas
Sua resposta anterior foi bloqueada por uma barreira de proteção. Sua resposta bloqueada foi: ‘{{agent_message}}’. No seu próximo turno, você deve fornecer uma nova resposta e ela não deve violar: ‘{{trigger_reason}}’ - Transferir para outro agente
Sua resposta anterior foi bloqueada pela barreira de proteção. No seu próximo turno, você deve usar a ferramenta transfer_to_agent e transferir para um agente. Sua resposta bloqueada foi: ‘{{agent_message}}’. A barreira de proteção bloqueia conteúdo que corresponde a esta condição/categoria: ‘{{trigger_reason}}’. - Transferir para uma pessoa
Sua resposta foi bloqueada por uma barreira de proteção que bloqueia conteúdo que corresponde a esta condição/categoria: ‘{{trigger_reason}}’. No seu próximo turno, você DEVE transferir a chamada para um operador humano usando a ferramenta transfer_to_number.
Para usar ferramentas do sistema no feedback de nova tentativa, ative e configure as ferramentas correspondentes nas configurações do agente. Somente ferramentas configuradas no agente podem ser invocadas.
Você pode usar estes placeholders no texto do feedback:
O modo de execução streaming é recomendado para agentes de voz; o modo de execução blocking é recomendado para agentes de texto.
O modo blocking (especialmente com retry) pode se comportar de forma menos previsível em voz. Se você usar o modo blocking em voz, valide tudo cuidadosamente ou escolha end call em vez de retry até ter confiança no comportamento.
Preços
As barreiras de proteção Foco, Manipulação e Conteúdo estão incluídas sem custo adicional para todos os usuários do ElevenAgents.
As Barreiras de proteção personalizadas são baseadas no uso e geram custos adicionais de LLM, como outras chamadas de modelo no ElevenAgents. Cada Barreira de proteção personalizada ativada envia todas as respostas do agente para um modelo leve para avaliação, portanto, o custo depende do tamanho do prompt, da duração média da conversa e do volume de conversas. Se você ativar várias Barreiras de proteção personalizadas, cada uma executará sua própria avaliação por resposta. Recomendamos analisar o tráfego esperado e a escolha do modelo antes de ativar várias Barreiras de proteção personalizadas em produção.
Você pode ver uma estimativa de custo (abaixo do prompt) ao criar ou editar uma barreira de proteção personalizada.
Nova tentativa e custo: Cada tentativa é uma geração adicional do agente mais outra avaliação da barreira de proteção, portanto, retry aumenta a cobrança baseada no uso em comparação com end_call (até três tentativas por turno bloqueado).
Configuração
Configurar pelo painel
Configurar pela CLI
Configurar pela API
Ative as barreiras de proteção
Ative as categorias de barreiras de proteção que deseja habilitar. Você pode usar os botões predefinidos para ativar rapidamente todas as categorias ou desativar todas as categorias.
Configure o modo de execução e a estratégia de saída (barreiras personalizadas e de conteúdo)
Para cada barreira de proteção personalizada ou de conteúdo, escolha o modo de execução streaming ou blocking.
Blocking é adequado para agentes de texto; streaming é adequado para agentes de voz. Defina a Ação em caso de
violação da barreira de proteção (mapeada para trigger_action): encerrar chamada em qualquer modo ou retry
apenas quando blocking estiver selecionado (retry não está disponível em streaming). Se escolher
retry, edite o Feedback a ser inserido ao tentar novamente para orientar o modelo. Use os placeholders
{{trigger_reason}} (o prompt personalizado ou a categoria de conteúdo que causou o
bloqueio) e {{agent_message}} no modelo.
Quando uma barreira de proteção é acionada, o comportamento depende do tipo e da configuração:
- Encerrar chamada: A sessão é encerrada imediatamente (chamada interrompida para voz, chat encerrado para texto). O acionamento é registrado no histórico da conversa.
- Nova tentativa (barreiras de proteção personalizadas ou de conteúdo em modo de bloqueio): O turno do assistente que violou a regra é removido, o feedback do sistema é inserido e o modelo tenta novamente — até três vezes — antes de a sessão ser encerrada caso a barreira de proteção continue sendo acionada.
Em caso de encerrar chamada, os usuários finais terão uma chamada interrompida ou um chat encerrado. Os detalhes da violação ficam disponíveis para você nos registros da conversa e não são exibidos literalmente ao usuário final.
Após encerrar chamada, os usuários podem iniciar uma nova conversa. A barreira de proteção não bloqueia permanentemente o usuário — ela bloqueia a resposta específica (ou sessão) que violou a política.
Boas práticas
Agentes de suporte ao cliente
Use barreiras de proteção personalizadas para aplicar políticas específicas da empresa. Exemplos: - Bloquear a emissão de reembolsos, créditos ou alterações de assinatura, a menos que a elegibilidade seja confirmada por ferramentas. - Bloquear o fornecimento de descontos ou códigos promocionais, a menos que sejam explicitamente autorizados. - Bloquear respostas que especulem sobre itens do roadmap ou recursos ainda não lançados.
Aplicações de saúde
Use barreiras de proteção personalizadas para controlar rigorosamente os limites médicos. Exemplos: - Bloquear diagnósticos de condições ou recomendações de tratamentos específicos. - Bloquear recomendações de dosagem de medicamentos.
- Bloquear a substituição da orientação de um profissional de saúde licenciado.
Conteúdo educacional
Use barreiras de proteção personalizadas para controlar tópicos acadêmicos sensíveis. Exemplos: - Bloquear instruções passo a passo para experimentos prejudiciais ou procedimentos inseguros. - Bloquear a geração de gabaritos para avaliações ou provas em andamento. - Bloquear conteúdo que possa facilitar desonestidade acadêmica.
Ferramentas empresariais internas
Use barreiras de proteção personalizadas para proteger operações e dados da empresa. Exemplos: - Bloquear o compartilhamento de documentação exclusiva para uso interno ou processos confidenciais. - Bloquear a revelação de APIs privadas, prompts de sistema ou detalhes da infraestrutura. - Bloquear a simulação de ações que exigem autoridade executiva ou administrativa.
Teste com cenários realistas
Antes da implantação, teste sua configuração de barreiras de proteção com:
- Fluxos normais de conversa para garantir que não haja falsos positivos
- Casos extremos que se aproximam, mas não ultrapassam os limites de segurança
- Prompts adversariais que tentam provocar respostas prejudiciais
Perguntas frequentes
As barreiras de proteção afetam a latência?
Para barreiras de proteção personalizadas e de conteúdo, o modo streaming não adiciona latência extra, mas a resposta pode começar antes que a barreira de proteção seja acionada. O modo blocking aguarda a barreira de proteção antes de o agente responder, com um atraso típico de cerca de 200 a 500 ms. O retry adiciona gerações extras completas (e reavaliações) por tentativa, até três vezes por turno bloqueado, o que também aumenta o custo baseado no uso.
Qual é a diferença entre os modos de execução streaming e blocking?
O modo streaming não adiciona latência adicional, mas a resposta do agente pode começar antes que a barreira de proteção
seja acionada. O modo blocking aguarda o resultado da barreira de proteção antes de o agente responder (normalmente
com um atraso de 200 a 500 ms). Retry como estratégia de saída (trigger_action) está disponível apenas
no modo blocking; no modo streaming, você usa end call quando uma barreira de proteção
é acionada. O modo blocking permite retry com feedback do sistema injetado, em vez de encerrar a
conversa imediatamente — ao custo de uso extra do modelo e cobrança adicional quando
há novas tentativas. Recomendamos o modo blocking para agentes de texto; o modo streaming é recomendado para
agentes de voz.
Posso desativar completamente as barreiras de proteção?
Sim, mas recomendamos fortemente manter todas as barreiras de proteção ativadas — especialmente a Barreira de Proteção de Foco. Elas protegem sua marca, seus usuários e sua postura de conformidade, e as recomendamos para todas as aplicações de produção, incluindo ferramentas internas. Em casos raros, talvez você queira desativar uma barreira de proteção específica se ela interferir no caso de uso pretendido do seu agente. Por exemplo, algumas aplicações podem abordar temas que a Barreira de Proteção de Conteúdo sinalizaria, ou um prompt de sistema altamente personalizado pode não funcionar corretamente com a Barreira de Proteção de Foco ativada. Cada barreira de proteção pode ser ativada ou desativada individualmente.
Os usuários podem contestar decisões das barreiras de proteção?
Os acionamentos das barreiras de proteção são registrados e podem ser analisados nas análises das suas conversas. Se você identificar falsos positivos, ajuste os prompts das suas barreiras de proteção. Não há um processo automatizado de contestação — o usuário deve simplesmente iniciar uma nova conversa.
Como sei qual barreira de proteção foi acionada?
Informações sobre qual barreira de proteção foi acionada estão disponíveis nos logs das suas conversas.
Devo usar tanto as barreiras de proteção quanto o reforço do prompt de sistema?
Sim. Elas têm propósitos complementares. O reforço do prompt de sistema fornece orientação comportamental e evita a maioria dos problemas por meio do seguimento de instruções. As barreiras de proteção da plataforma fornecem aplicação independente como uma rede de segurança. Usar ambos cria uma defesa em profundidade.
Próximas etapas
- Guia de prompting: Aprenda a escrever prompts de sistema eficazes com barreiras de proteção comportamentais
- Privacidade: Configure as definições de retenção de dados e privacidade
- Testes: Teste seu agente em diferentes cenários
- Simular conversas: Teste programaticamente as configurações das barreiras de proteção
- Ocultação do histórico de conversas: Oculte informações sensíveis, como nomes e dados bancários, do histórico de conversas
Status de lançamento
As barreiras de proteção estão amplamente disponíveis, incluindo as barreiras de proteção de Foco e Manipulação.
As barreiras de proteção de Conteúdo e Personalizadas estão em Alpha. Estamos aprimorando-as ativamente, e você pode esperar que seus padrões, controles no dashboard e campos da API continuem evoluindo antes da disponibilidade geral. Algumas alterações podem causar incompatibilidades.
Se você usa barreiras de proteção de Conteúdo ou Personalizadas, recomendamos validar sua configuração, monitorar o comportamento das barreiras de proteção nos seus logs e revisar sua configuração conforme as atualizações forem lançadas.