

Coleta de dados
Extraia informações estruturadas das conversas, como dados de contato e informações comerciais.
A coleta de dados extrai automaticamente informações estruturadas de transcrições de conversas usando análises baseadas em LLM. Isso permite capturar pontos de dados valiosos sem processamento manual, melhorando a eficiência operacional e a precisão dos dados.
Visão geral
A coleta de dados analisa transcrições de conversas para identificar e extrair informações específicas que você define. Os dados extraídos são estruturados de acordo com suas especificações e disponibilizados para processamento e análise posteriores.
Tipos de dados compatíveis
A coleta de dados aceita quatro tipos de dados para lidar com vários formatos de informação:
- String: informações baseadas em texto (nomes, e-mails, endereços)
- Boolean: valores verdadeiro/falso (status de concordância, elegibilidade)
- Integer: números inteiros (quantidade, idade, avaliações)
- Number: números decimais (preços, porcentagens, medidas)
Configuração
Acesse as configurações de coleta de dados
Na aba Análise das configurações do seu agente, acesse a seção Coleta de dados.
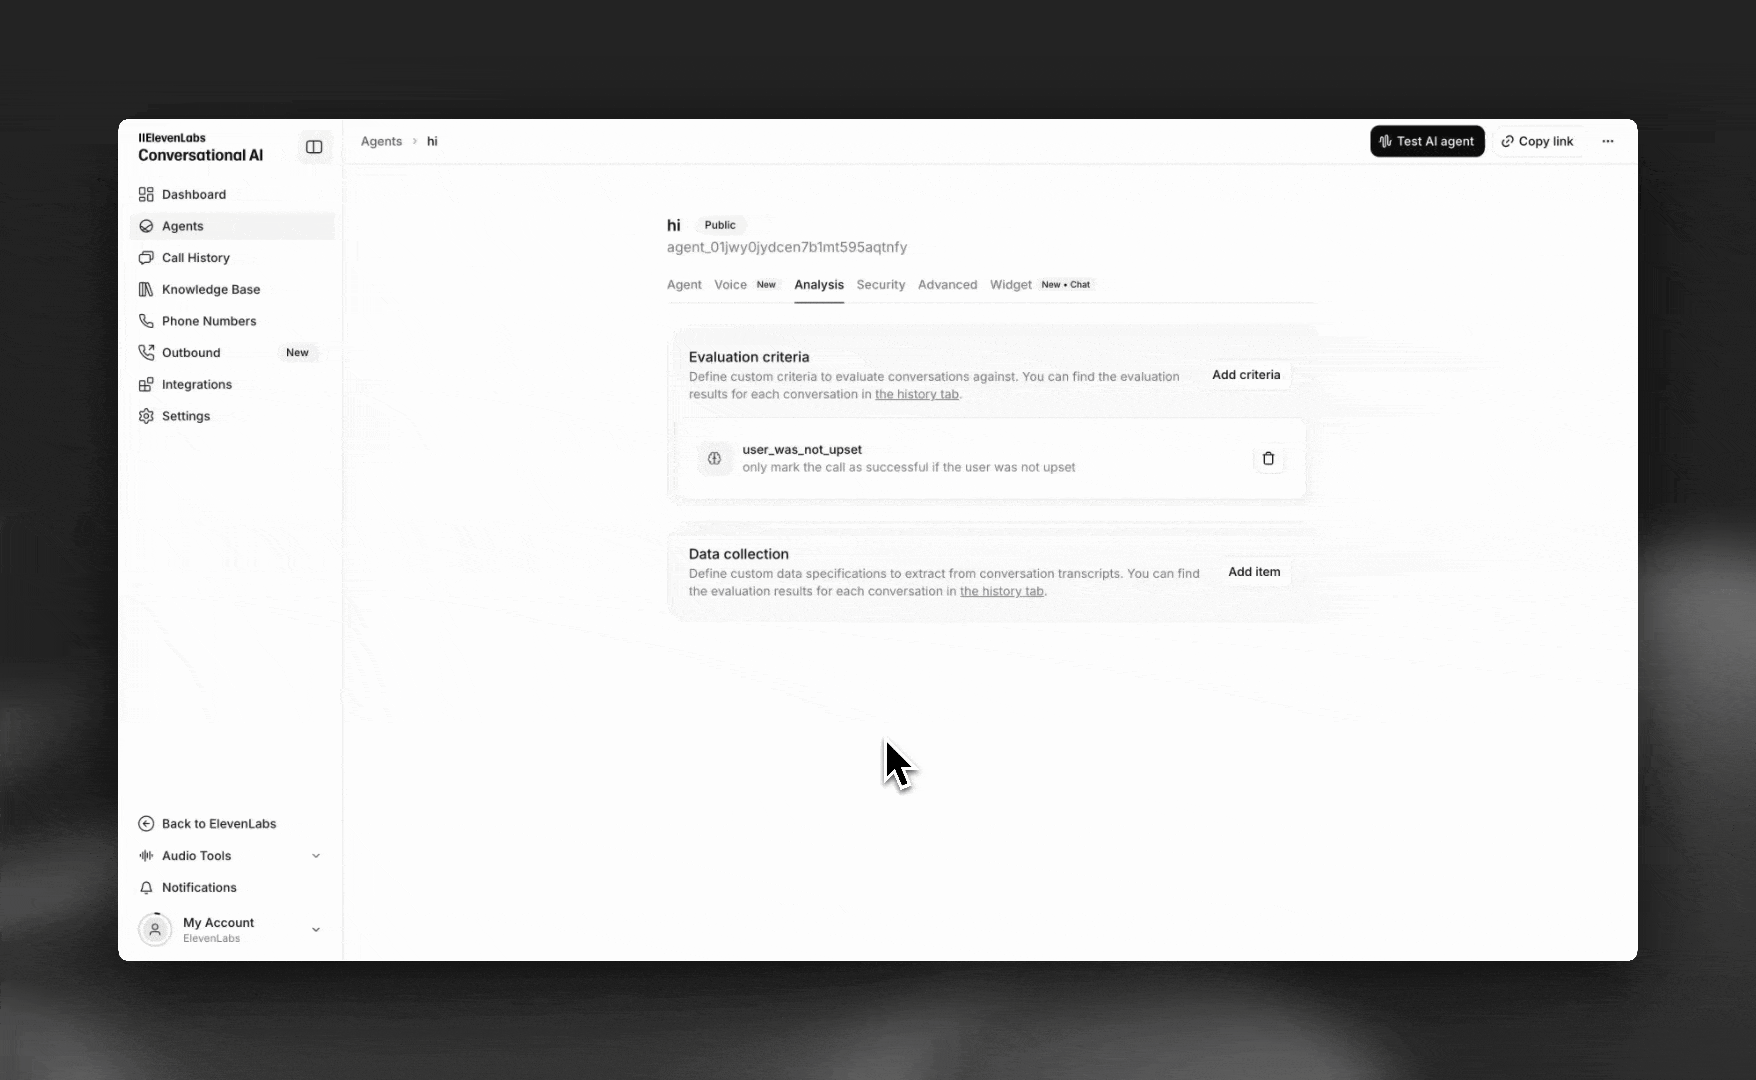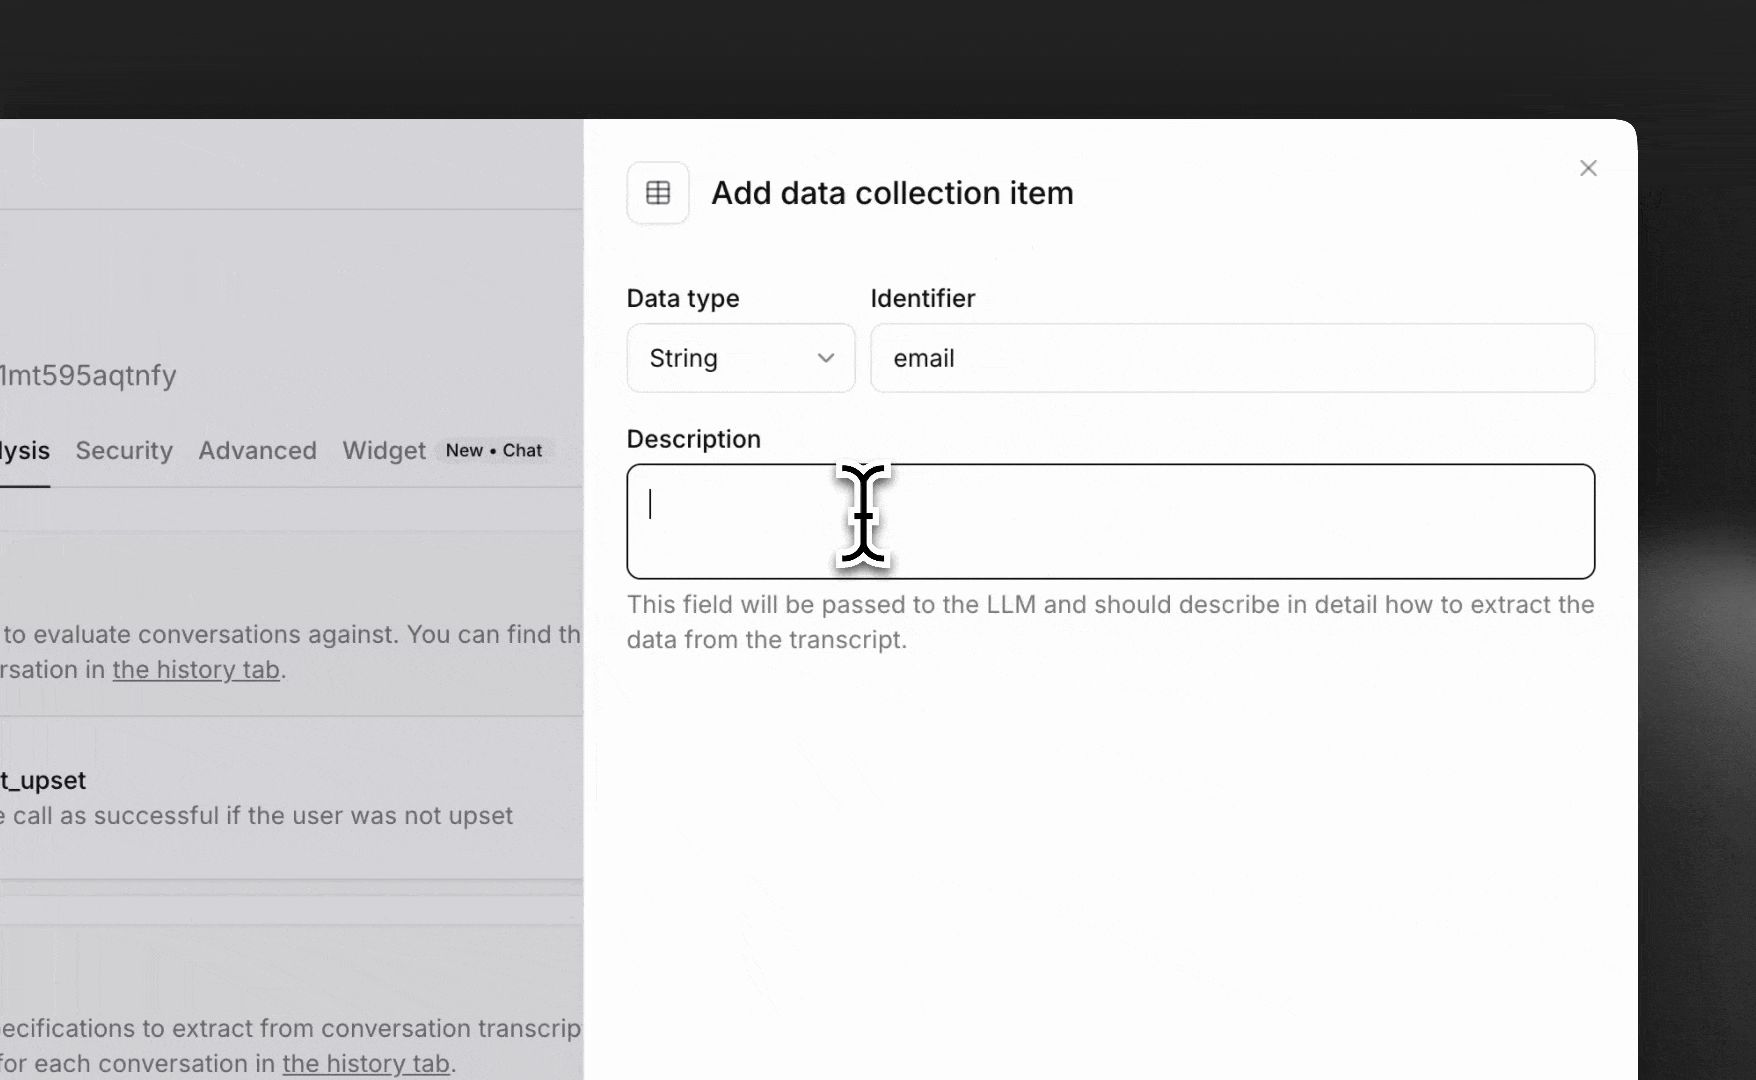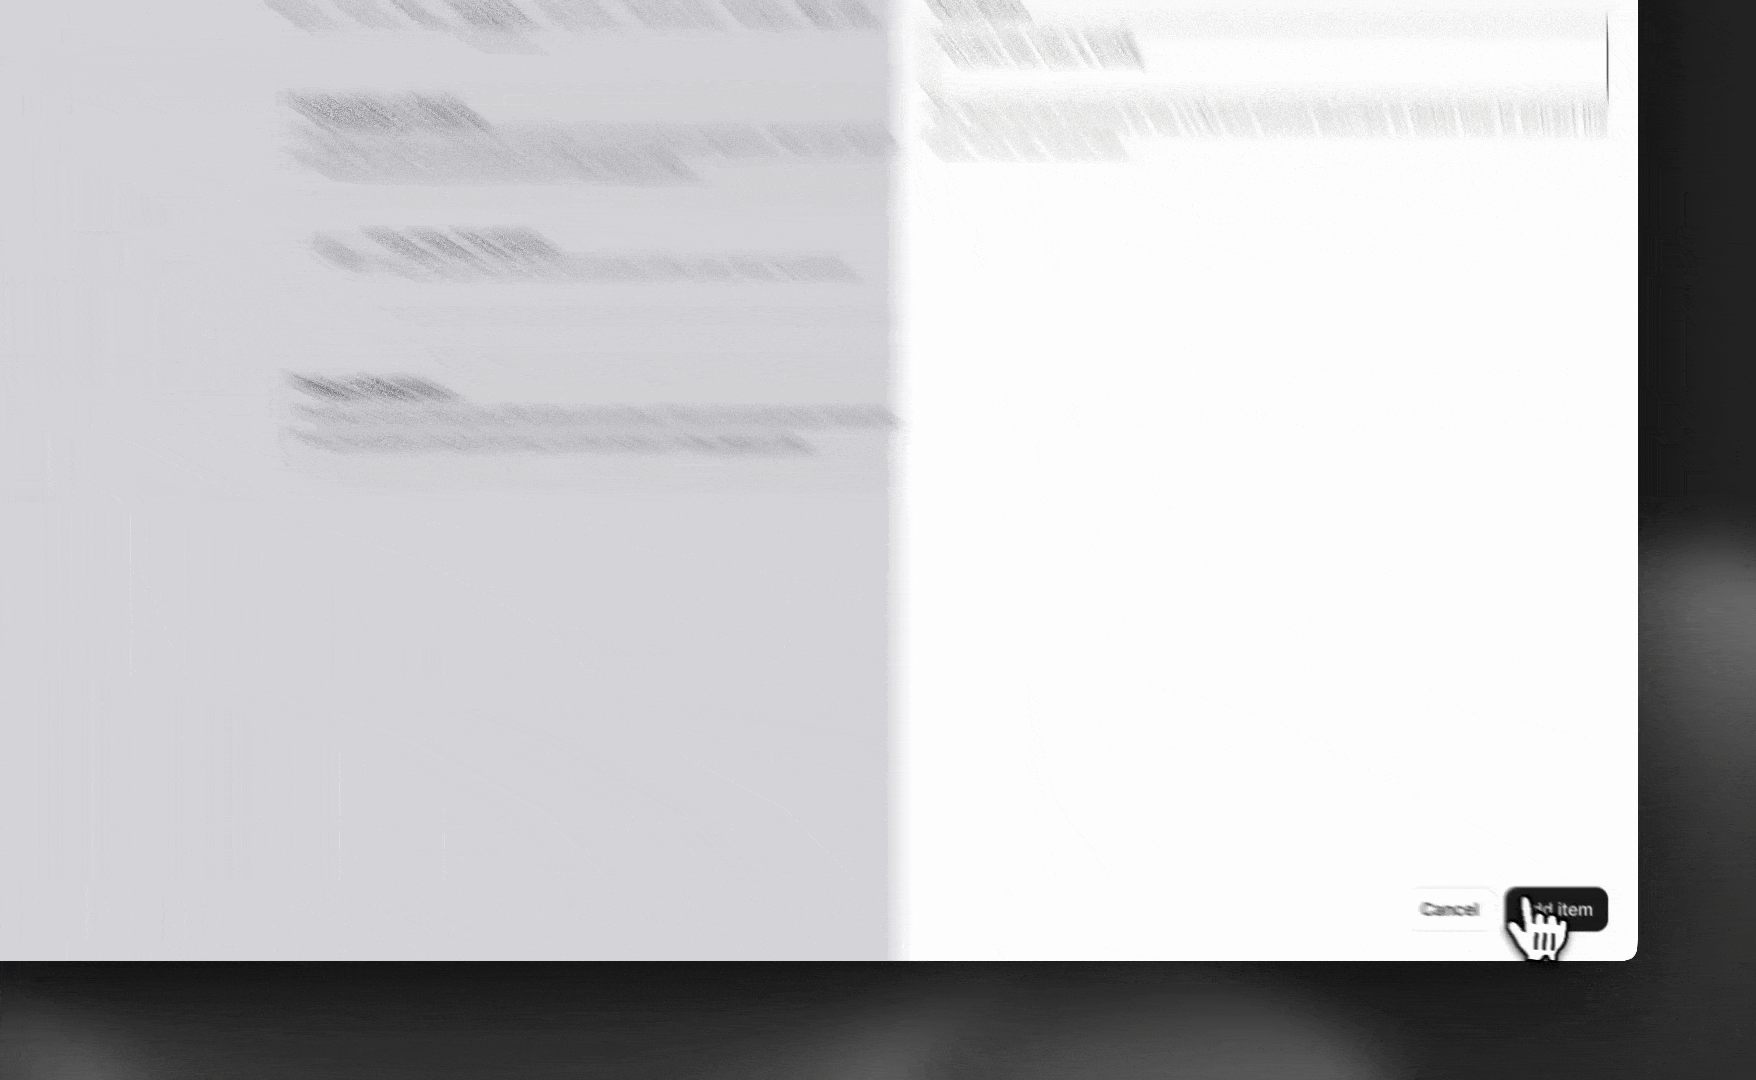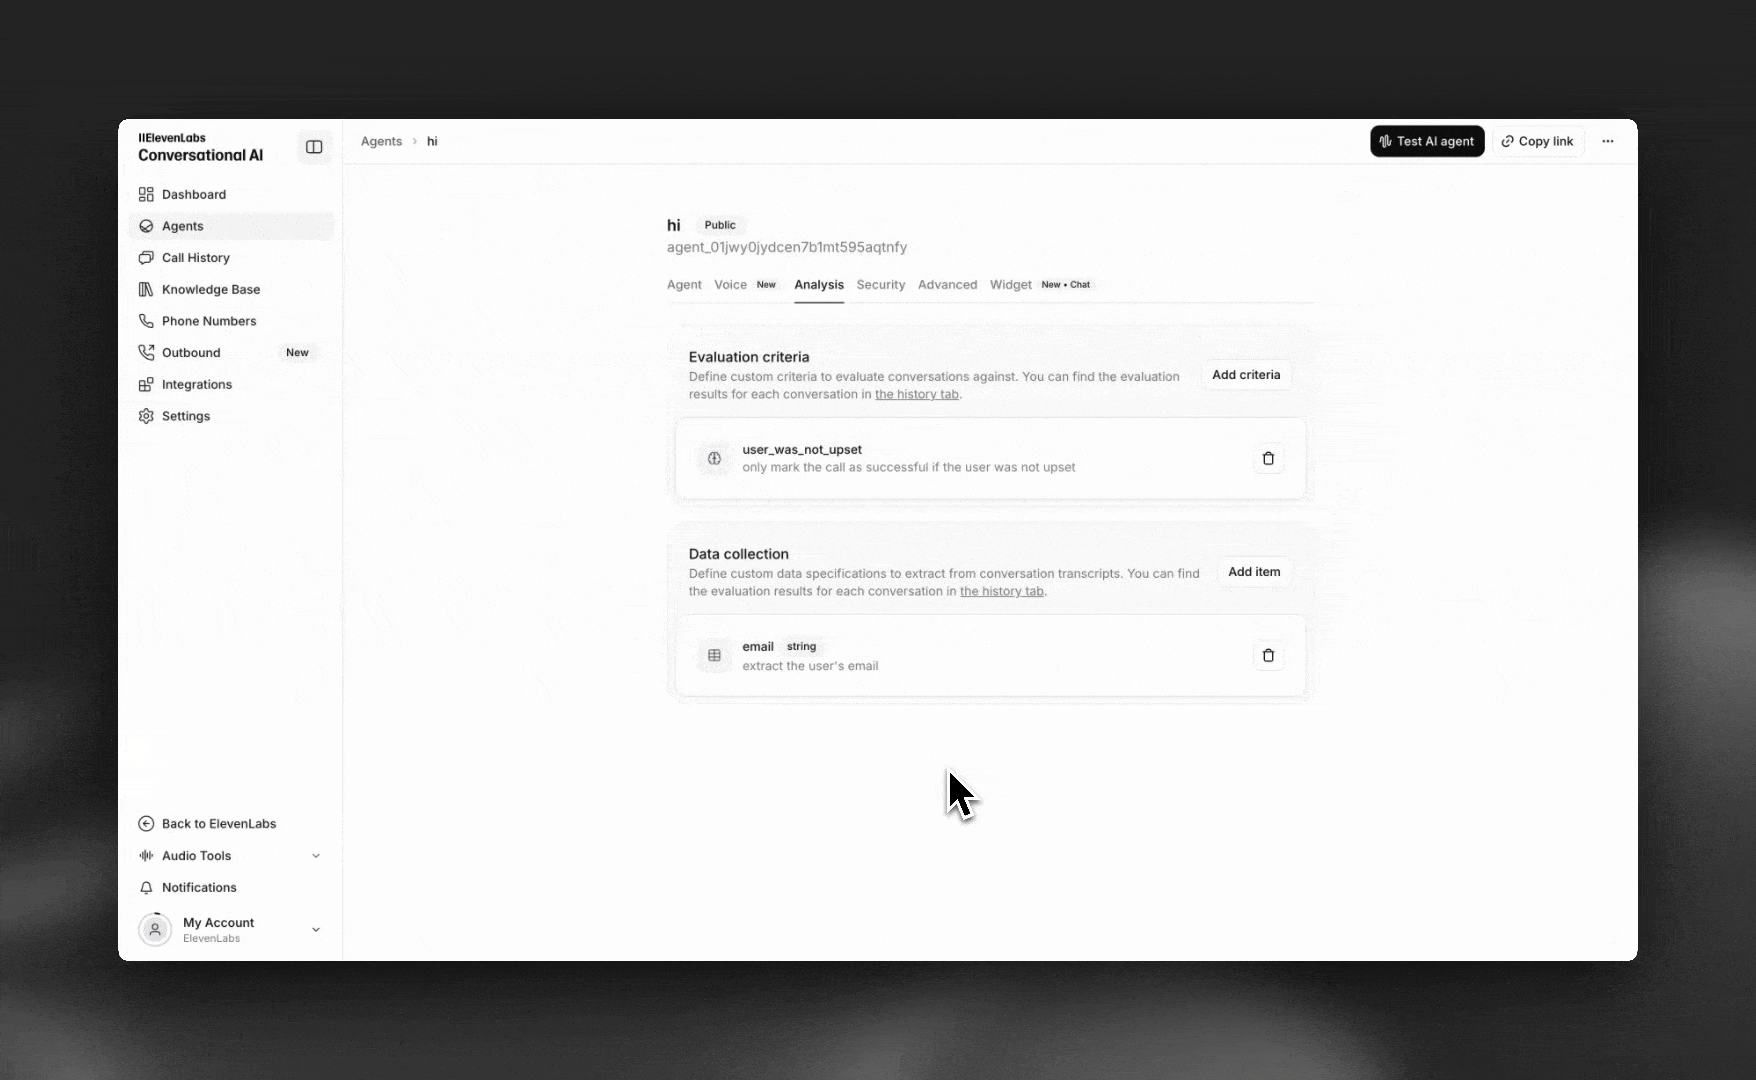
Adicione itens de coleta de dados
Clique em Adicionar coleta de dados para criar uma nova regra de extração de dados ou associar uma da biblioteca de análises do seu workspace.
Configure cada item com:
- Nome: nome único do campo de dados (por exemplo,
email,customer_rating) - Tipo de dados: selecione string, boolean, integer ou number
- Descrição: instruções detalhadas sobre como extrair os dados da transcrição
O campo de descrição é enviado ao LLM e deve ser o mais específico possível sobre o que extrair e como formatar os dados.
Os itens de coleta de dados são limitados a 50 por agente nos planos Trial e Enterprise e a 25 por agente nos outros planos.
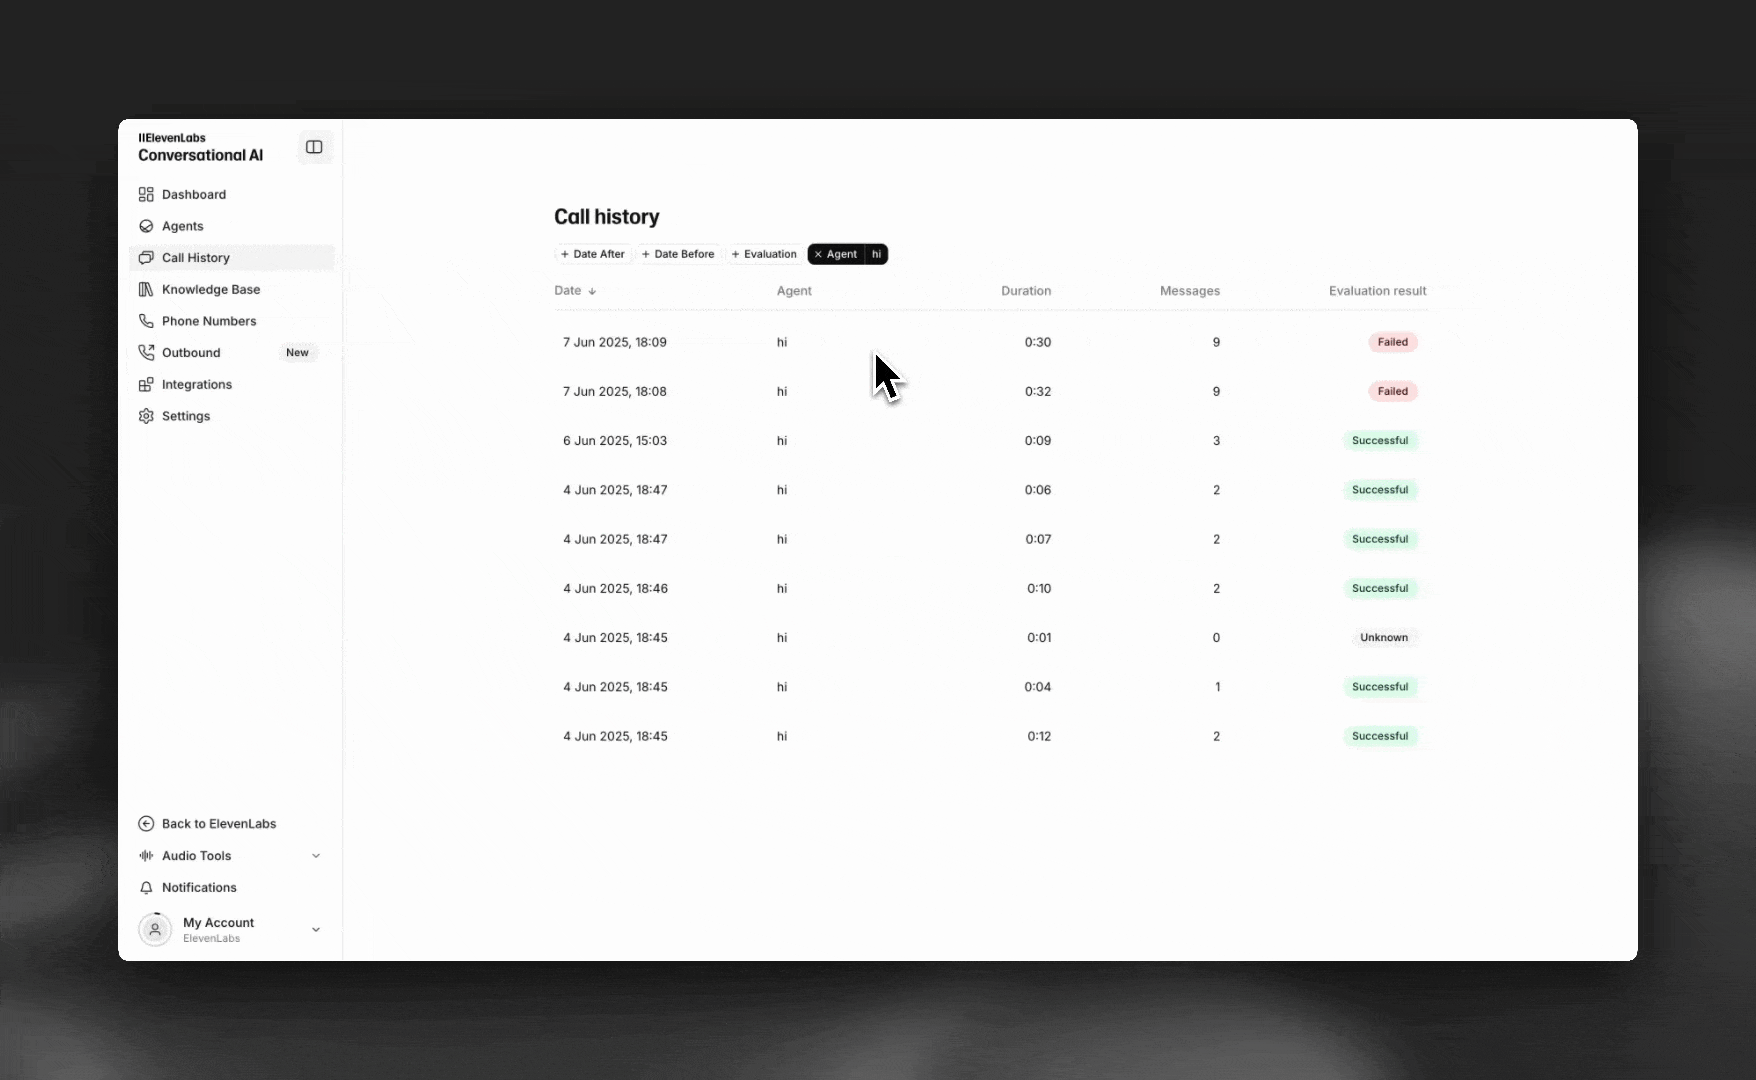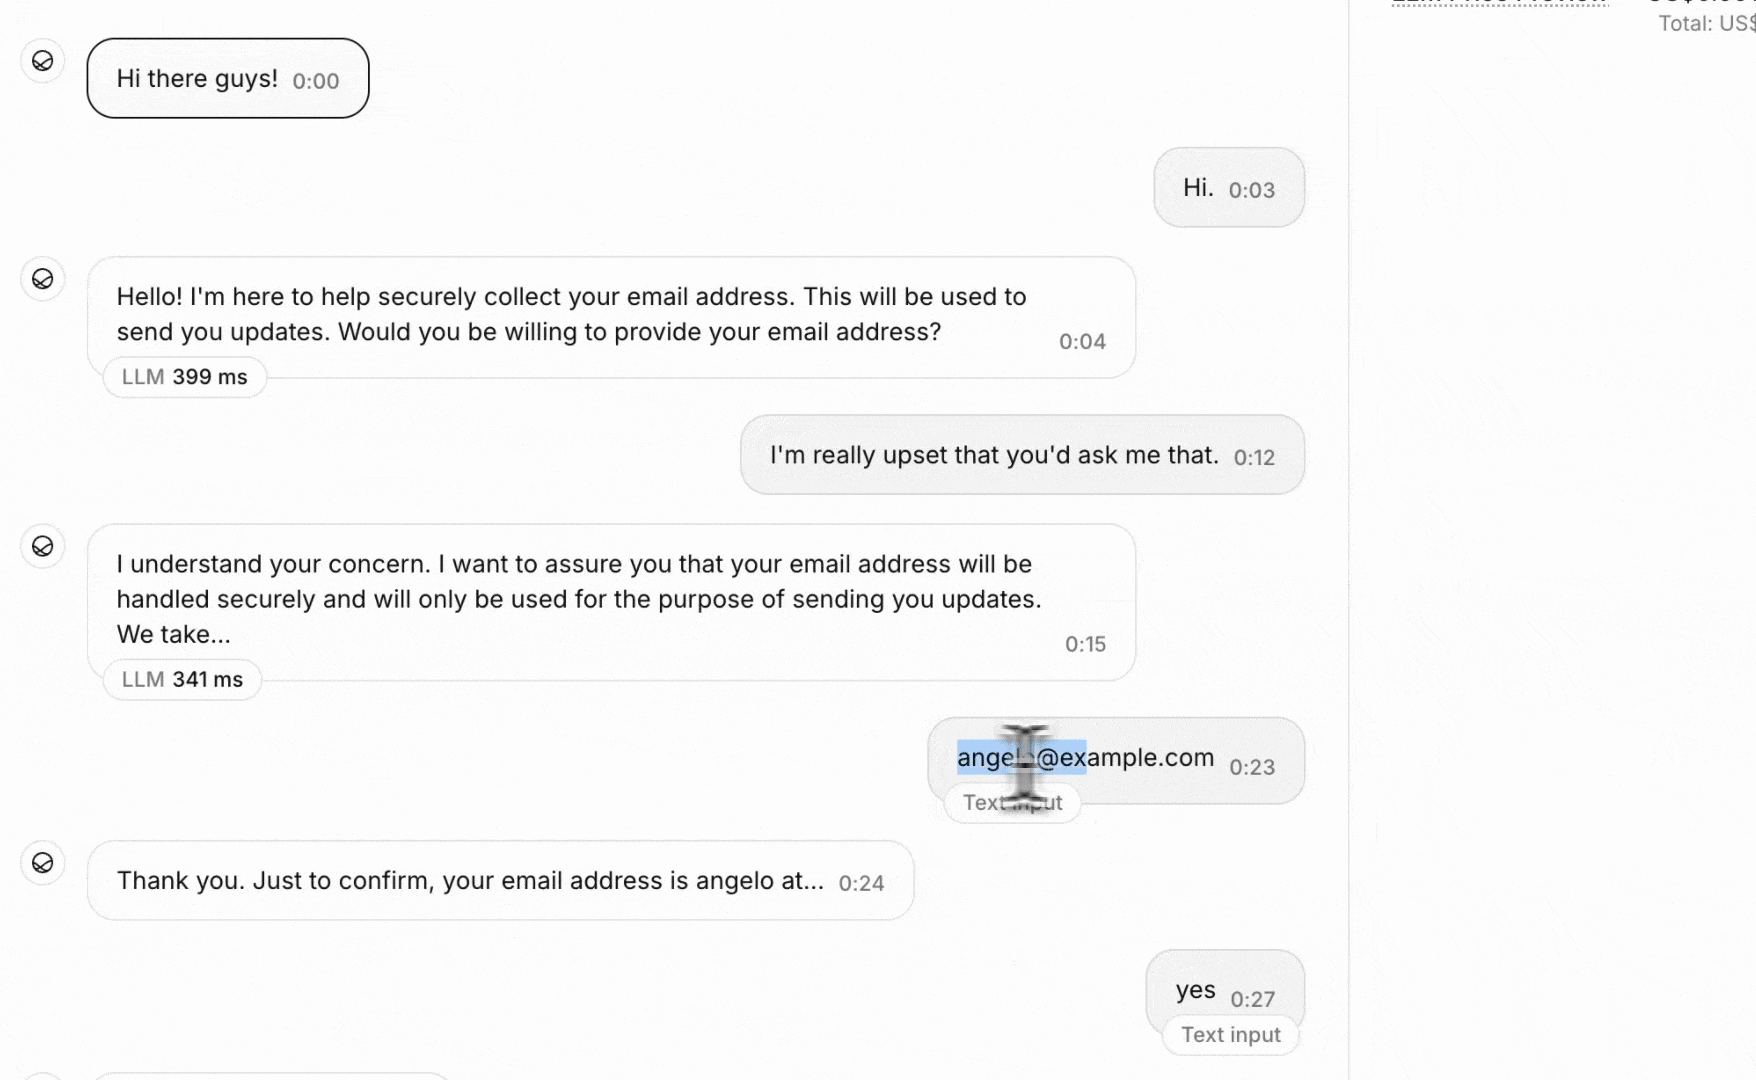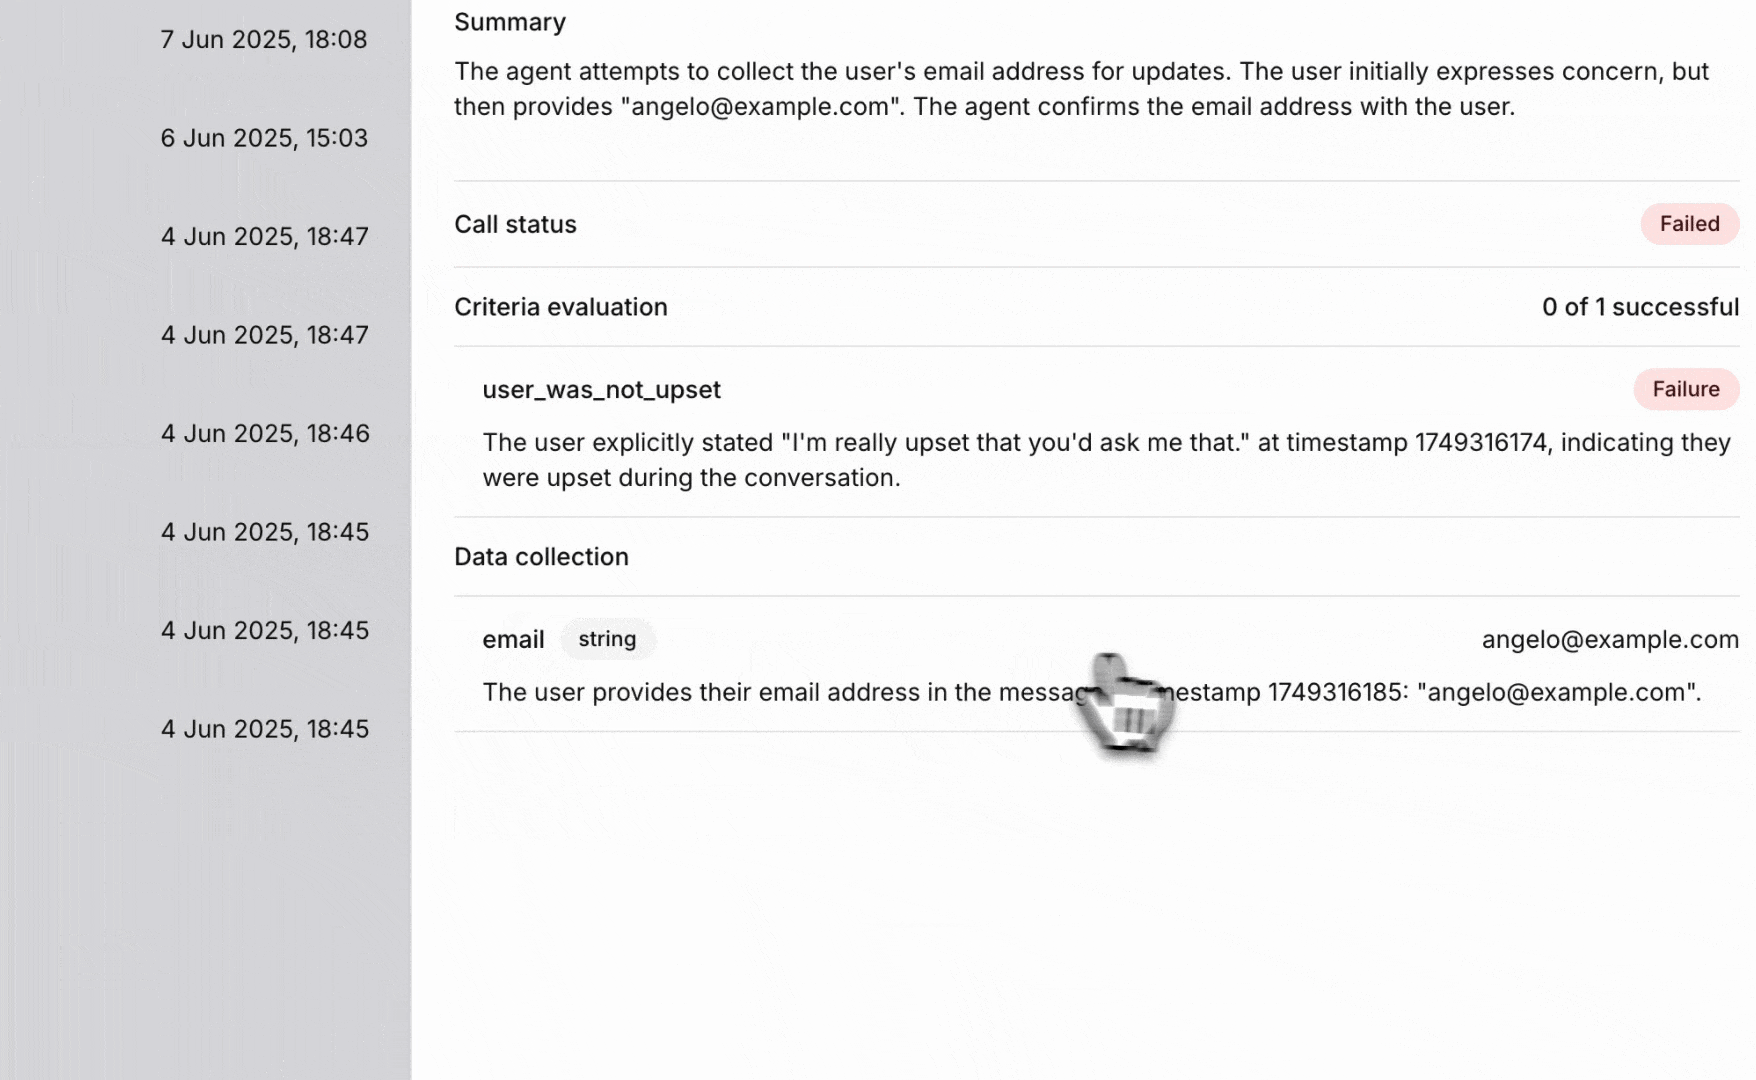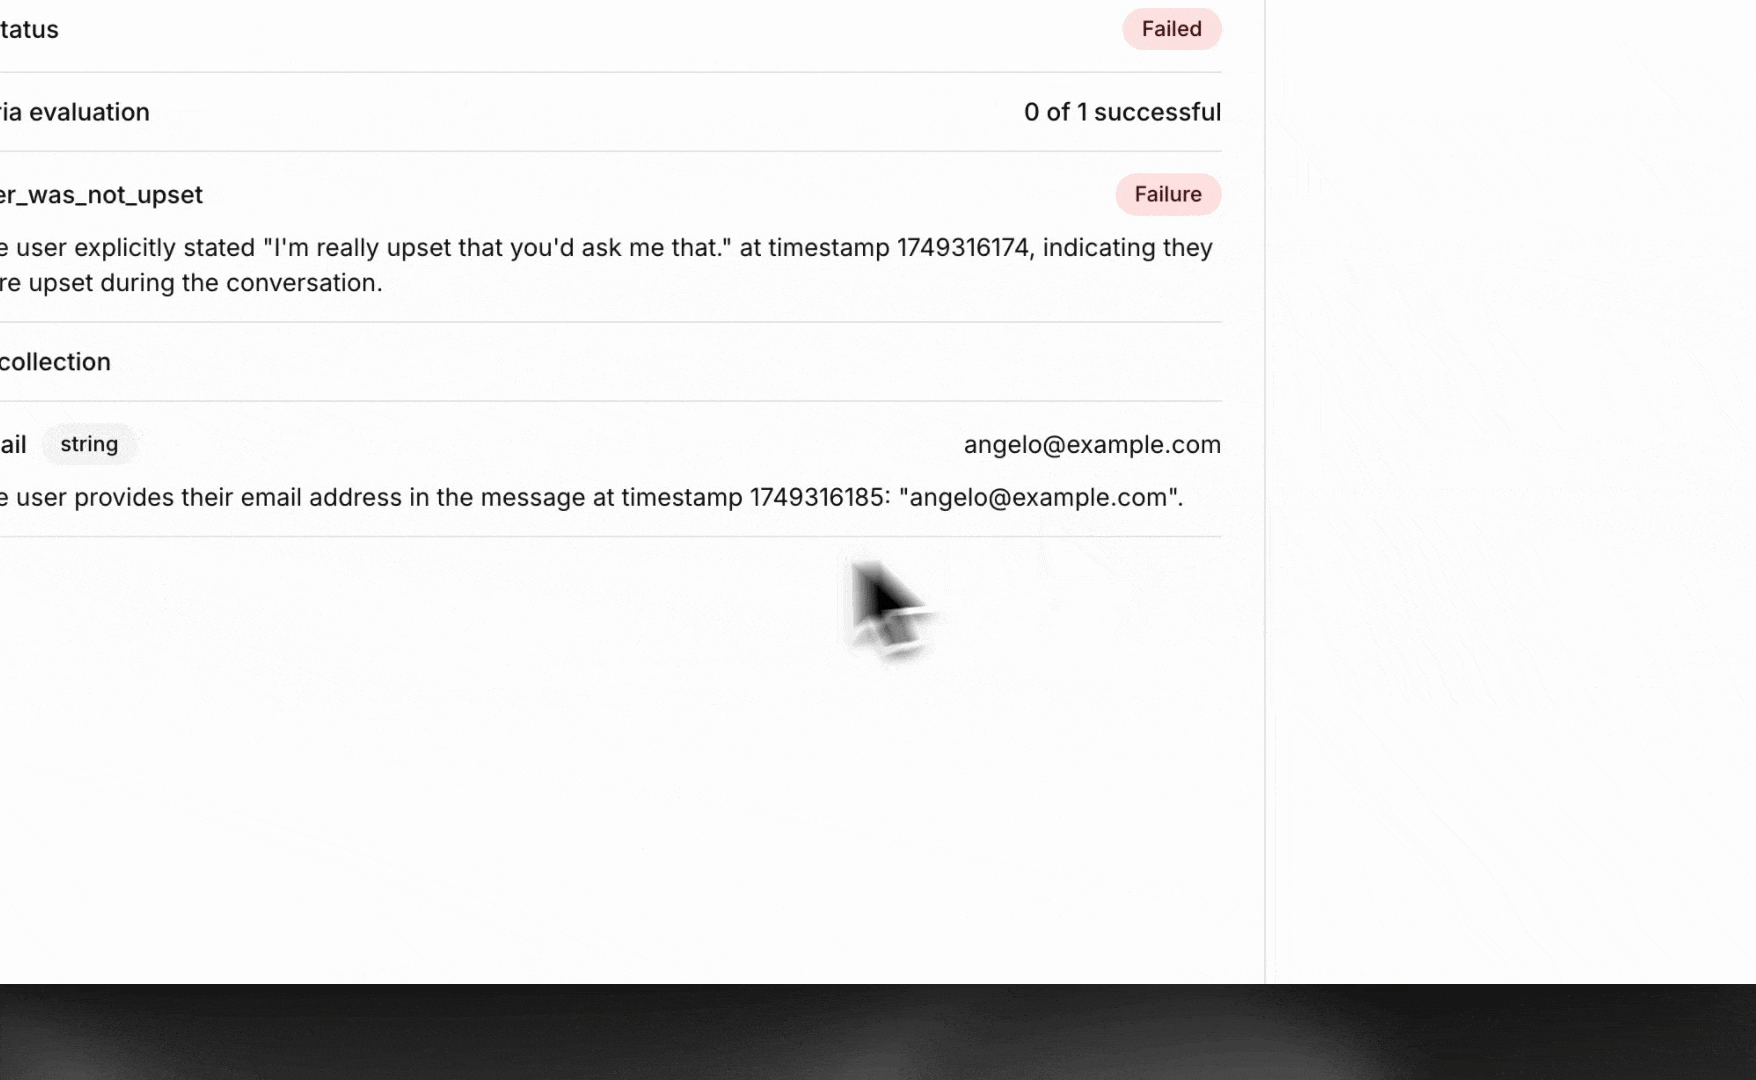
Boas práticas
Como escrever prompts de extração eficazes
- Seja explícito sobre o formato esperado (por exemplo, “endereço de e-mail no formato usuario@dominio.com”)
- Especifique o que fazer quando as informações estiverem ausentes ou não forem claras
- Inclua exemplos de dados válidos e inválidos
- Mencione todos os requisitos de validação
Exemplos comuns de coleta de dados
Informações de contato:
email: “Extraia o endereço de e-mail do cliente no formato padrão (usuario@dominio.com)”phone_number: “Extraia o número de telefone do cliente, incluindo o código de área”full_name: “Extraia o nome completo do cliente conforme informado”
Dados comerciais:
issue_category: “Classifique o problema do cliente como um dos seguintes: técnico, cobrança, conta ou geral”satisfaction_rating: “Extraia qualquer avaliação numérica de satisfação fornecida pelo cliente (escala de 1 a 10)”order_number: “Extraia qualquer número de pedido ou referência mencionado pelo cliente”
Dados comportamentais:
was_angry: “Determine se o cliente expressou raiva ou frustração durante a chamada”requested_callback: “Determine se o cliente solicitou uma ligação de retorno ou acompanhamento”
Como lidar com dados ausentes ou pouco claros
Quando os dados solicitados não puderem ser encontrados ou forem ambíguos na transcrição, a extração retornará valores nulos ou vazios. Considere:
- Usar lógica condicional nos seus aplicativos para lidar com dados ausentes
- Criar critérios alternativos para extrações incompletas
- Treinar agentes para coletar as informações necessárias de forma consistente
Diretrizes de tipos de dados
String
Boolean
Integer
Number
Use para informações baseadas em texto que não se encaixam em outros tipos.
Exemplos:
- Nomes de clientes
- Endereços de e-mail
- Categorias de produtos
- Descrições de problemas
Boas práticas:
- Especifique o formato esperado quando relevante
- Inclua requisitos de validação
- Considere as necessidades de padronização
Casos de uso
Solução de problemas
A extração de dados retorna valores vazios
- Verifique se os dados existem na transcrição da conversa
- Confirme se o prompt de extração é específico o suficiente
- Garanta que o tipo de dados corresponda ao formato esperado
- Considere se as informações foram comunicadas claramente durante a conversa
Formatos de dados inconsistentes
- Revise os prompts de extração quanto às especificações de formato
- Adicione requisitos de validação aos prompts
- Considere o pós-processamento para padronização dos dados
- Teste com vários cenários de conversa
Considerações de desempenho
- Cada regra de coleta de dados adiciona tempo de processamento
- Uma lógica de extração complexa pode levar mais tempo para ser avaliada
- Monitore a precisão da extração em relação aos requisitos de velocidade
- Otimize os prompts para eficiência quando possível
Os dados extraídos estão disponíveis por meio de Webhooks pós-chamada para integração com sistemas de CRM, bancos de dados e plataformas de análise.