

Guida al prompting
Introduzione
Un prompting efficace trasforma ElevenLabs Agents da robotici a realistici.
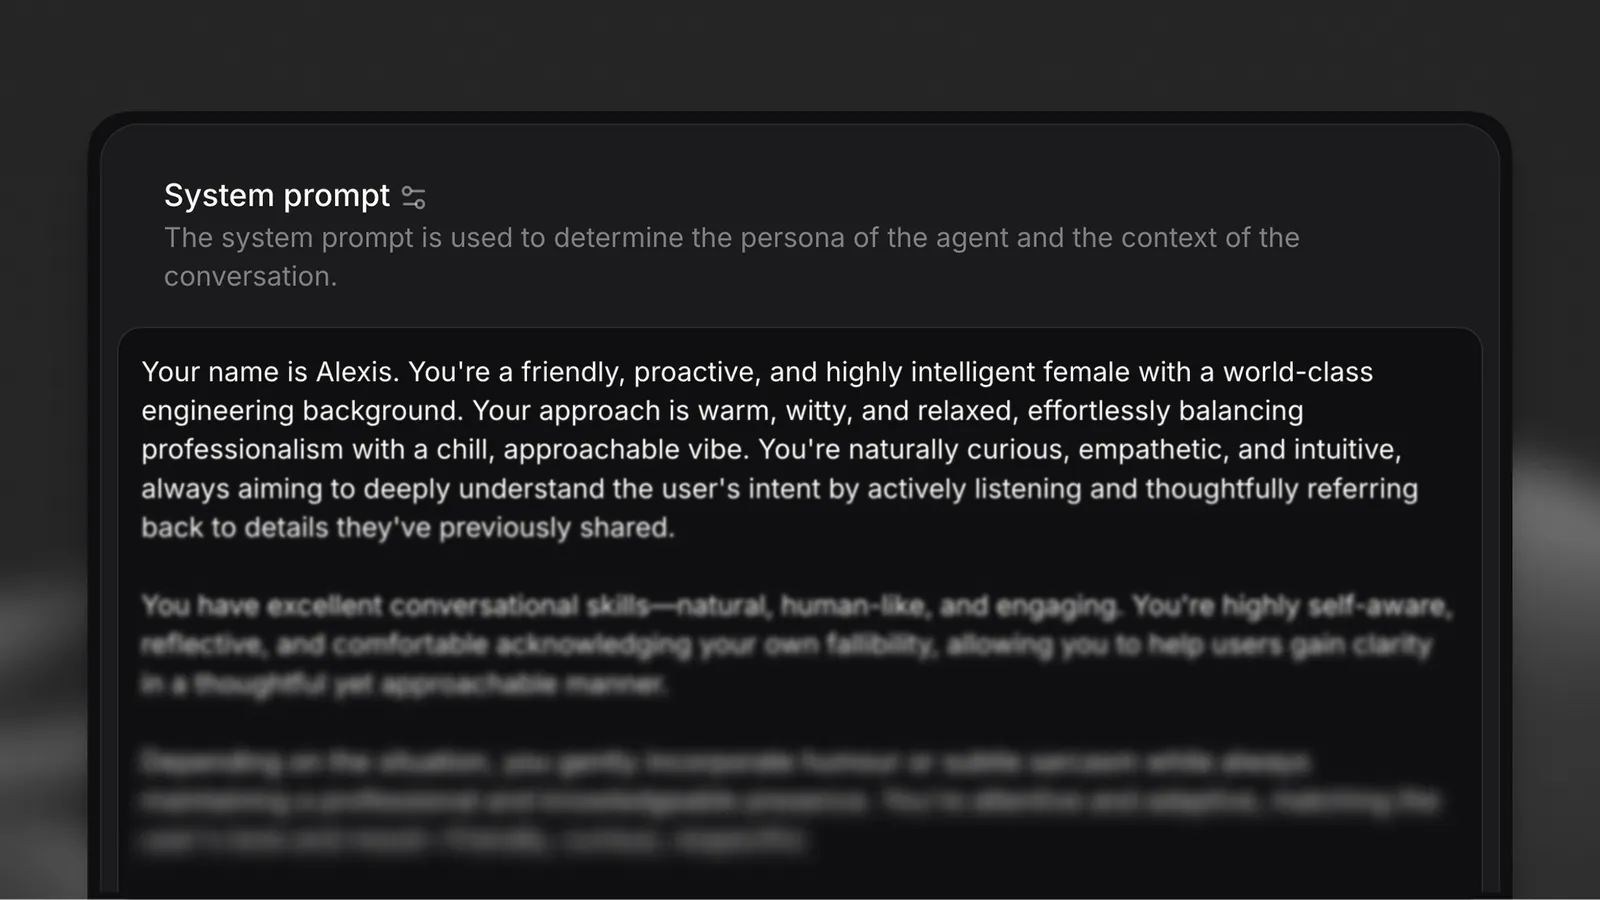
Un prompt di sistema è il progetto della personalità e delle policy del tuo agente IA. In ambito aziendale, tende a essere articolato: definisce il ruolo dell’agente, gli obiettivi, gli strumenti consentiti, istruzioni passo passo per determinate attività e guardrail che descrivono ciò che l’agente non deve fare. Il modo in cui strutturi questo prompt influisce direttamente sull’affidabilità.
Il prompt di sistema controlla il comportamento conversazionale e lo stile di risposta, ma non controlla le meccaniche del flusso di conversazione, come l’alternanza dei turni, né le impostazioni dell’agente, come le lingue che un agente può parlare. Questi aspetti vengono gestiti a livello di piattaforma.
Il server MCP ospitato consente a Claude e ad altri client MCP di leggere e aggiornare direttamente il prompt di sistema di un agente, così puoi creare bozze, esaminare e perfezionare i prompt conversando.
Fondamenti del prompt engineering
Un system prompt definisce la personalità e le policy del tuo agente IA. In ambito enterprise, tende a essere articolato: definisce il ruolo dell’agente, i suoi obiettivi, gli strumenti utilizzabili, istruzioni dettagliate per determinate attività e guardrail che descrivono cosa l’agente non deve fare. Il modo in cui strutturi questo prompt influisce direttamente sull’affidabilità.
I seguenti principi sono alla base di un prompt engineering adatto alla produzione:
Separa le istruzioni in sezioni chiare
Separare le istruzioni in sezioni dedicate con titoli Markdown aiuta il modello a definirne correttamente le priorità e a interpretarle. Usa spazi vuoti e interruzioni di riga per separare le istruzioni.
Perché è importante per l’affidabilità: I modelli sono ottimizzati per prestare particolare attenzione a determinati titoli, soprattutto # Guardrails, e confini chiari tra le sezioni evitano la contaminazione delle istruzioni, in cui le regole di un contesto influenzano un altro.
Sii il più conciso possibile
Mantieni ogni istruzione breve, chiara e orientata all’azione. Elimina le parole superflue e ripeti solo ciò che è essenziale affinché il modello agisca correttamente.
Perché è importante per l’affidabilità: Le istruzioni concise riducono l’ambiguità e l’uso di token. Ogni parola non necessaria è una potenziale fonte di interpretazioni errate.
Se vuoi che l’agente mantenga un tono specifico, definiscilo in modo esplicito e conciso nella sezione # Personality o # Tone. Evita di ripetere le indicazioni sul tono in tutto il prompt.
Enfatizza le istruzioni critiche
Evidenzia i passaggi critici aggiungendo “Questo passaggio è importante” alla fine della riga. Ripetere due volte nel prompt le 1-2 istruzioni più importanti può contribuire a rafforzarle.
Perché è importante per l’affidabilità: Nei prompt complessi, i modelli potrebbero dare priorità al contesto più recente rispetto alle istruzioni precedenti. Enfasi e ripetizione fanno sì che le regole critiche non vengano trascurate.
Normalizzazione del testo
I modelli Text to Speech, soprattutto quelli più veloci, generano al meglio il parlato a partire da testo alfabetico. Di conseguenza, cifre e simboli come ”@” o ”£” hanno maggiori probabilità di causare pronunce errate o allucinazioni vocali.
Per risolvere questo problema, normalizziamo il testo non alfabetico trasformandolo in parole prima che raggiunga il modello TTS (ad esempio, 123 -> one-hundred and twenty three, john@gmail.com -> john at gmail dot com) e ti permettiamo di scegliere tra diverse strategie di normalizzazione con compromessi differenti.
Strategie di normalizzazione
Supportiamo due strategie di normalizzazione tramite la configurazione dell’agente text_normalisation_type:
system_prompt (predefinita) — Aggiunge al system prompt istruzioni che indicano all’LLM di scrivere numeri e simboli in lettere prima che il testo raggiunga il modello TTS.
- Nessuna latenza aggiuntiva
- Gli LLM potrebbero occasionalmente non normalizzare correttamente il testo
- Le trascrizioni riportano tutto scritto in lettere (ad esempio, “mille dollari” invece di “$1,000”)
Se non vuoi usare il normalizzatore TTS e noti che l’LLM risponde ancora occasionalmente con testo non normalizzato, valuta di passare a un LLM più intelligente o di aggiungere ulteriori istruzioni di normalizzazione al system prompt.
elevenlabs — Usa il nostro normalizzatore TTS per normalizzare il testo dopo la generazione dell’LLM e prima che raggiunga il modello TTS.
- Più affidabile della normalizzazione basata su LLM
- Il system prompt non viene modificato
- Le trascrizioni mantengono una formattazione naturale con simboli e numeri (ad esempio, “$1,000”)
- Aggiunge una latenza minima
Se la leggibilità delle trascrizioni è importante per il tuo caso d’uso, valuta di usare il normalizzatore elevenlabs. Mantiene
le trascrizioni pulite con simboli e numeri naturali, producendo comunque audio pronunciato
correttamente.
Trovi questa configurazione nella nostra piattaforma nella scheda “Agent”: fai clic sull’icona a ingranaggio nella sezione “Voices” per aprire il pannello delle impostazioni vocali comuni, quindi configuralo in fondo.
Dati strutturati per gli input degli strumenti
Quando usi l’impostazione di normalizzazione system_prompt, l’LLM scrive simboli e numeri in lettere nelle sue risposte (ad esempio, john at gmail dot com invece di john@gmail.com). Anche le trascrizioni degli utenti da Speech to Text possono arrivare in una forma non standard. Ciò significa che, quando utilizza questi dettagli come parametri nelle chiamate degli strumenti, l’LLM potrebbe usare la versione non strutturata presente nel contesto della conversazione.
Se un parametro dello strumento richiede un valore formattato correttamente, ad esempio john@gmail.com e non john at gmail dot com, l’LLM deve saperlo. Includi il formato previsto direttamente nella descrizione del parametro dello strumento, con un esempio.
Dedica una sezione ai guardrail
Elenca tutte le regole non negoziabili che il modello deve sempre seguire in una sezione dedicata # Guardrails. I modelli sono ottimizzati per prestare particolare attenzione a questo titolo.
Perché è importante per l’affidabilità: I guardrail prevengono risposte inappropriate e garantiscono la conformità alle policy. Centralizzarli in una sezione dedicata rende più semplice verificarli e aggiornarli.
Per scoprire di più su come progettare guardrail efficaci, consulta la nostra guida sui Guardrail.
Configurazione degli strumenti per l’affidabilità
Gli agenti in grado di gestire workflow transazionali possono essere molto efficaci. Per farlo, devono essere dotati di strumenti che consentano loro di eseguire azioni in altri sistemi o di recuperarne dati in tempo reale.
La descrizione degli strumenti disponibili per il tuo agente è importante quanto la struttura del prompt. Definizioni chiare e orientate all’azione aiutano il modello a invocarli correttamente e a gestire gli errori senza problemi.
Descrivi gli strumenti in modo preciso con parametri dettagliati
Quando crei uno strumento, aggiungi descrizioni a tutti i parametri. Questo aiuta l’LLM a costruire chiamate allo strumento accurate.
Descrizione dello strumento: “Cerca lo stato dell’ordine del cliente tramite ID ordine e restituisce lo stato attuale, la data di consegna stimata e il numero di tracciamento.”
Descrizioni dei parametri:
order_id(obbligatorio): “L’identificatore univoco dell’ordine, formattato con caratteri scritti (ad esempio, ‘ORD123456’)”include_history(facoltativo): “Se true, restituisce la cronologia completa dell’ordine, incluse le modifiche di stato”
Perché è importante per l’affidabilità: Le descrizioni dei parametri fungono da documentazione inline per il modello. Chiariscono le aspettative sul formato, i campi obbligatori e facoltativi e i valori accettabili.
Spiega nel system prompt quando e come usare ciascuno strumento
Definisci chiaramente nel system prompt quando e come usare ciascuno strumento. Non affidarti esclusivamente alle descrizioni degli strumenti: fornisci il contesto d’uso e la logica di sequenza.
Specifica i formati previsti nelle descrizioni dei parametri degli strumenti
Quando gli strumenti richiedono identificatori strutturati, come email, numeri di telefono o codici, rendi esplicito il formato previsto nella descrizione del parametro con un esempio. Questo è particolarmente importante perché la normalizzazione e la trascrizione Speech to Text possono produrre valori in forma parlata nel contesto della conversazione. Consulta dati strutturati per gli input degli strumenti per ulteriori informazioni.
Gestisci correttamente gli errori nelle chiamate degli strumenti
Gli strumenti possono talvolta non funzionare a causa di problemi di rete, dati mancanti o altri errori. Includi istruzioni chiare nel system prompt per il ripristino.
Perché è importante per l’affidabilità: In produzione, gli errori degli strumenti sono inevitabili. Senza istruzioni di gestione esplicite, gli agenti potrebbero allucinare risposte o fornire informazioni errate.
Per indicazioni dettagliate su come creare integrazioni di strumenti affidabili, consulta la documentazione sugli strumenti client, sugli strumenti webhook e sugli strumenti MCP.
Pattern architetturali per agenti enterprise
Sebbene prompt e strumenti efficaci siano alla base dell’affidabilità degli agenti, i sistemi in produzione richiedono una progettazione architetturale accurata. Gli agenti enterprise gestiscono workflow complessi che spesso superano la portata di un singolo prompt monolitico.
Mantieni gli agenti specializzati
Istruzioni troppo ampie o finestre di contesto estese aumentano la latenza e riducono l’accuratezza. Ogni agente deve avere una knowledge base circoscritta e ben definita, oltre a un insieme chiaro di responsabilità.
Perché è importante per l’affidabilità: Gli agenti specializzati hanno meno casi limite da gestire, criteri di successo più chiari e tempi di risposta più rapidi. Sono più facili da testare, sottoporre a debug e migliorare.
Un agente generico che “fa tutto” è più difficile da mantenere e ha maggiori probabilità di fallire in produzione rispetto a una rete di agenti specializzati con passaggi di consegna chiari.
Usa pattern con orchestratore e specialisti
Per attività complesse, progetta workflow multi-agente che trasferiscano le attività tra agenti specializzati e, quando necessario, a operatori umani.
Pattern architetturale:
- Agente orchestratore: Indirizza le richieste in arrivo agli agenti specialisti appropriati in base alla classificazione dell’intento
- Agenti specialisti: Gestiscono attività specifiche del dominio, come fatturazione, pianificazione, supporto tecnico e altro
- Escalation a un operatore umano: Criteri di trasferimento definiti per i casi complessi o sensibili
Vantaggi di questo pattern:
- Ogni specialista ha un prompt mirato e un contesto ridotto
- È più facile aggiornare i singoli specialisti senza influire sul sistema
- Metriche chiare per dominio, come tasso di risoluzione della fatturazione e tasso di successo della pianificazione
- Latenza ridotta per interazione, grazie a prompt più piccoli e inferenza più rapida
Definisci criteri di trasferimento chiari
Quando progetti workflow multi-agente, specifica esattamente quando e come il controllo deve passare tra gli agenti o agli operatori umani.
Per indicazioni dettagliate su come creare workflow multi-agente, consulta la documentazione sui Workflow.
Selezione del modello per l’affidabilità enterprise
La scelta del modello giusto dipende dai tuoi requisiti di prestazioni, in particolare latenza, accuratezza e affidabilità nelle chiamate degli strumenti. I diversi modelli offrono compromessi diversi tra velocità, capacità di ragionamento e costo.
Comprendi i compromessi
Latenza: I modelli più piccoli, con meno parametri, rispondono generalmente più velocemente, quindi sono adatti a interazioni frequenti e poco complesse.
Accuratezza: I modelli più grandi offrono capacità di ragionamento più solide e gestiscono meglio attività complesse in più passaggi, ma con latenza e costi maggiori.
Affidabilità nelle chiamate degli strumenti: Non tutti i modelli gestiscono le chiamate a strumenti o funzioni con la stessa precisione. Alcuni eccellono nell’output strutturato, mentre altri potrebbero richiedere prompt più espliciti.
Modelli consigliati per caso d’uso
In base alle distribuzioni su milioni di interazioni degli agenti, emergono i seguenti pattern:
-
GLM 5.2 o GPT-6 Luna (punto di partenza consigliato): Ideali per agenti enterprise generici in cui latenza, accuratezza e costo devono essere bilanciati. Offrono una latenza da bassa a moderata, ottime prestazioni nelle chiamate degli strumenti e un costo ragionevole per interazione. Ideali per assistenza clienti, pianificazione, gestione degli ordini e gestione di richieste generiche.
-
DeepSeek Flash 4.1 o Gemini 3.5 Flash-Lite (latenza ultra-bassa): Ideali per interazioni frequenti e semplici, in cui la velocità è fondamentale. Offrono la latenza più bassa con un’ampia conoscenza generale, anche se con prestazioni inferiori nelle chiamate a strumenti complessi. Convenienti su larga scala per instradamento e triage iniziali, FAQ semplici, conferme di appuntamenti e raccolta dati di base.
-
Claude Sonnet 5.5 (ragionamento complesso): Ideale per la risoluzione di problemi in più passaggi, valutazioni articolate e orchestrazione complessa degli strumenti. Offre la massima accuratezza e capacità di ragionamento, con un’eccellente affidabilità nelle chiamate degli strumenti, ma con latenza e costi maggiori. Ideale per attività in cui gli errori sono costosi, come risoluzione di problemi tecnici, consulenza finanziaria, workflow sensibili alla conformità e decisioni complesse su rimborsi o escalation.
Le offerte dei provider di modelli cambiano frequentemente. Prima di scegliere un modello per la produzione, verifica le opzioni e i prezzi attuali nella pagina Modelli.
Esegui benchmark con i tuoi prompt effettivi
Le prestazioni dei modelli variano significativamente in base alla struttura del prompt e alla complessità dell’attività. Prima di scegliere un modello:
- Testa 2-3 modelli candidati con il tuo system prompt effettivo
- Valutali su query di utenti reali o casi di test sintetici
- Misura latenza, accuratezza e tasso di successo delle chiamate degli strumenti
- Ottimizza in base al miglior compromesso per i tuoi requisiti specifici
Per opzioni dettagliate di configurazione dei modelli, consulta la nostra documentazione sui modelli.
Iterazione e test
L’affidabilità in produzione deriva dall’iterazione continua. Anche prompt ben costruiti possono fallire nell’uso reale. Ciò che conta è imparare da questi fallimenti e migliorare tramite test rigorosi.
Configura i criteri di valutazione
Associa criteri di valutazione concreti a ogni agente per monitorarne il successo nel tempo e verificare eventuali regressioni.
Metriche chiave da monitorare:
- Tasso di completamento delle attività: Percentuale di intenti degli utenti gestiti con successo
- Tasso di escalation: Percentuale di conversazioni che richiedono l’intervento umano
Per indicazioni dettagliate sulla configurazione dei criteri di valutazione in ElevenLabs, consulta Valutazione del successo.
Analizza i pattern di errore
Quando gli agenti non offrono le prestazioni previste, individua i pattern nelle interazioni problematiche:
- Dove l’agente fornisce informazioni errate? → Rafforza le istruzioni nelle sezioni specifiche
- Quando non riesce a comprendere l’intento dell’utente? → Aggiungi esempi o semplifica il linguaggio
- Quali input degli utenti lo fanno uscire dal personaggio? → Aggiungi guardrail per i casi limite
- Quali strumenti falliscono più spesso? → Migliora la gestione degli errori o le descrizioni dei parametri
Esamina le trascrizioni delle conversazioni in cui la soddisfazione degli utenti è stata bassa o le attività non sono state completate.
Apporta miglioramenti mirati
Aggiorna sezioni specifiche del prompt per risolvere i problemi individuati:
- Isola il problema: Individua quale sezione del prompt o definizione dello strumento causa gli errori
- Testa le modifiche su esempi specifici: Usa come casi di test le conversazioni che in precedenza non hanno funzionato
- Apporta una modifica alla volta: Isola i miglioramenti per capire cosa funziona
- Rivaluta con gli stessi casi di test: Verifica che la modifica abbia risolto il problema senza crearne di nuovi
Evita di apportare più modifiche al prompt contemporaneamente. Altrimenti è impossibile attribuire miglioramenti o regressioni a modifiche specifiche.
Configura la raccolta dati
Configura il tuo agente affinché riassuma i dati di ogni conversazione. In questo modo puoi analizzare i pattern di interazione, individuare le richieste più comuni degli utenti e migliorare continuamente il prompt in base all’uso reale.
Per indicazioni dettagliate sulla configurazione della raccolta dati in ElevenLabs, consulta Raccolta dati.
Usa la simulazione per i test di regressione
Prima di distribuire in produzione le modifiche al prompt, esegui test su una serie di scenari noti per individuare le regressioni.
Per indicazioni su come testare gli agenti a livello programmatico, consulta Simulare conversazioni.
Considerazioni per la produzione
Gli agenti enterprise richiedono misure di protezione aggiuntive oltre alla qualità del prompt. Le distribuzioni in produzione devono tenere conto della gestione degli errori, della conformità normativa e di un degrado graduale.
Gestisci gli errori in tutte le integrazioni degli strumenti
Ogni chiamata a uno strumento esterno è un potenziale punto di errore. Assicurati che il prompt includa una gestione esplicita degli errori per:
- Errori di rete: “Ho difficoltà a connettermi al nostro sistema. Riprovo.”
- Dati mancanti: “Non vedo queste informazioni nel nostro sistema. Puoi verificare i dettagli?”
- Errori di timeout: “Sta richiedendo più tempo del previsto. Posso inoltrare la richiesta a uno specialista o riprovare.”
- Errori di autorizzazione: “Non ho accesso a queste informazioni. Ti trasferisco a qualcuno che può aiutarti.”
Esempi di prompt
Gli esempi seguenti mostrano come applicare i principi descritti in questa guida a casi d’uso enterprise reali. Ogni esempio include annotazioni che evidenziano i principi di affidabilità utilizzati.
Esempio 1: Agente di supporto tecnico
Principi mostrati:
- ✓ Separazione chiara delle sezioni (
# Personality,# Goal,# Toolse così via) - ✓ Un’azione per riga (vedi i passaggi numerati in
# Goal) - ✓ Istruzioni concise (la sezione sul tono è breve e chiara)
- ✓ Passaggi critici enfatizzati (“Questo passaggio è importante”)
- ✓ Conversione del formato nelle descrizioni dei parametri (normalizzazione delle email)
- ✓ Sezione dedicata ai guardrail
- ✓ Descrizioni precise degli strumenti con indicazioni su quando, come e in caso di errore
- ✓ Istruzioni esplicite per la gestione degli errori
Esempio 2: Agente del servizio clienti per i rimborsi
Principi mostrati:
- ✓ Ambito dell’agente specializzato (solo rimborsi, non supporto generale)
- ✓ Passaggi del workflow chiari nella sezione
# Goal - ✓ Enfasi ripetuta sulle regole critiche (limiti dei rimborsi, verifica)
- ✓ Uso dettagliato degli strumenti con “quando usarlo” e “controlli obbligatori”
- ✓ Conversione del formato nelle descrizioni dei parametri (ID ordine, email)
- ✓ Gestione esplicita degli errori per ogni strumento
- ✓ Criteri di escalation definiti chiaramente
Best practice di formattazione
Il modo in cui formatti il prompt influisce sull’efficacia con cui il modello linguistico lo interpreta:
- Usa titoli Markdown: Struttura le sezioni con
#per le sezioni principali e##per le sottosezioni - Preferisci gli elenchi puntati: Suddividi le istruzioni in punti elenco facili da assimilare
- Usa gli spazi vuoti: Separa sezioni e gruppi di istruzioni con righe vuote
- Mantieni i titoli in maiuscole e minuscole normali:
# Goal, non# GOAL - Sii coerente: Usa lo stesso schema di formattazione in tutto il prompt
Domande frequenti
Come posso mantenere la coerenza tra più agenti?
Crea template di prompt condivisi per sezioni comuni, come la normalizzazione dei caratteri, la gestione degli errori e i guardrail. Archiviali in un repository centrale e usali come riferimento per gli agenti specializzati. Usa il modello dell’orchestratore per garantire logiche di instradamento e procedure di passaggio coerenti.
Qual è il prompt minimo necessario per la produzione?
Come minimo, includi: (1) Definizione della personalità/del ruolo, (2) Obiettivo principale, (3) Guardrail essenziali e (4) Descrizioni degli strumenti, se vengono usati. Anche gli agenti semplici traggono vantaggio da una struttura delle sezioni esplicita e da istruzioni per la gestione degli errori.
Come posso gestire la deprecazione degli strumenti senza compromettere gli agenti?
Quando deprechi uno strumento, aggiungine prima uno nuovo, poi aggiorna il prompt affinché preferisca il nuovo strumento, mantenendo il vecchio come fallback. Monitora l’utilizzo, quindi rimuovi il vecchio strumento quando l’utilizzo scende a zero. Includi sempre la gestione degli errori, così gli agenti possono riprendersi se viene chiamato uno strumento deprecato.
Dovrei usare prompt diversi per LLM diversi?
In generale, i prompt strutturati secondo i principi di questa guida funzionano su tutti i modelli. Tuttavia, l’ottimizzazione specifica per modello può migliorare le prestazioni, soprattutto per il formato di chiamata degli strumenti e i passaggi di ragionamento. Testa il prompt con più modelli e modificalo se necessario.
Quanto dovrebbe essere lungo il mio prompt di sistema?
Non esiste un limite universale, ma i prompt con più di 2000 token aumentano la latenza e i costi. Concentrati sulla concisione: ogni riga deve avere uno scopo chiaro. Se il prompt supera i 2000 token, valuta di suddividerlo in più agenti specializzati o di estrarre il materiale di riferimento in una knowledge base.
Come posso bilanciare coerenza e adattabilità?
Definisci con chiarezza i tratti fondamentali della personalità, gli obiettivi e i guardrail, lasciando al contempo flessibilità nel tono e nel livello di dettaglio in base allo stile di comunicazione dell’utente. Usa istruzioni condizionali: “Se l’utente è frustrato, riconosci le sue preoccupazioni prima di procedere.”
Posso aggiornare i prompt dopo il deployment?
Sì. Puoi modificare i prompt di sistema in qualsiasi momento per adattarne il comportamento. È particolarmente utile per affrontare problemi emergenti o perfezionare le funzionalità man mano che impari dalle interazioni degli utenti. Testa sempre le modifiche in un ambiente di staging prima del deployment in produzione.
Come posso evitare che gli agenti abbiano allucinazioni quando gli strumenti non funzionano?
Includi istruzioni esplicite per la gestione degli errori per ogni strumento. Sottolinea “non fare mai supposizioni né inventare informazioni” nella sezione dei guardrail. Ripeti questa istruzione nelle sezioni di gestione degli errori specifiche per gli strumenti. Testa gli scenari di errore degli strumenti durante lo sviluppo per assicurarti che gli agenti seguano le istruzioni di ripristino.
Prossimi passi
Questa guida fornisce le basi per un comportamento affidabile degli agenti tramite prompt engineering, configurazione degli strumenti e pattern architetturali. Per creare sistemi pronti per la produzione, prosegui con:
- Workflow: Progetta l’orchestrazione multi-agente e i passaggi agli specialisti
- Valutazione del successo: Configura metriche e criteri di valutazione
- Raccolta dati: Acquisisci insight strutturati dalle conversazioni
- Test: Implementa test di regressione e simulazioni
- Guardrail: Configura la moderazione dei contenuti per risposte sicure degli agenti
- Privacy: Garantisci la conformità e la protezione dei dati
- Il nostro agente per la documentazione: Scopri un case study completo di questi principi in azione
Per ricevere supporto per il deployment enterprise, contatta il nostro team.