

Integra il tuo modello
LLM personalizzato ti consente di collegare le tue conversazioni al tuo LLM tramite un endpoint esterno. ElevenLabs supporta anche gli LLM integrati nativamente
Gli LLM personalizzati ti consentono di usare la tua chiave API OpenAI o di eseguire un server LLM completamente personalizzato.
Un LLM personalizzato non può essere usato con un modello Realtime.
Panoramica
Per impostazione predefinita, utilizziamo le nostre credenziali interne per modelli popolari come OpenAI. Per usare un server LLM personalizzato, deve essere compatibile con una delle seguenti strutture di richiesta/risposta compatibili con OpenAI:
- Chat Completions API (
/v1/chat/completions) - Responses API (
/v1/responses)
La Responses API è il nuovo formato API di OpenAI, che supporta funzionalità aggiuntive. Entrambi i formati API sono pienamente supportati per l’integrazione di LLM personalizzati.
Le guide seguenti coprono entrambi i casi d’uso:
- Usa la tua chiave OpenAI: usa la tua chiave API OpenAI con la nostra piattaforma.
- Server LLM personalizzato: fornisci e collega la tua implementazione di server LLM.
Imparerai a:
- Archiviare la tua chiave API OpenAI in ElevenLabs
- Fornire un server che replica l’endpoint Chat Completions o Responses di OpenAI
- Indirizzare ElevenLabs al tuo endpoint personalizzato
- Passare parametri aggiuntivi al tuo LLM secondo necessità
Riepilogo del ragionamento
Il tuo endpoint deve restituire il ragionamento separatamente dalla risposta finale. ElevenLabs non genera il ragionamento dalla risposta finale.
Per richiedere il ragionamento da un endpoint supportato, attiva Riepilogo del ragionamento nelle impostazioni LLM dell’agente oppure imposta enable_reasoning_summary tramite l’API.
Restituisci il ragionamento
Usa il formato corrispondente al tuo endpoint:
Chat Completions API
Responses API
Trasmetti il ragionamento in streaming nel campo reasoning o reasoning_content di ogni delta di risposta.
Per gli endpoint compatibili con Gemini, ElevenLabs richiede i pensieri con
google.thinking_config.include_thoughts e legge il contenuto contrassegnato con
extra_content.google.thought.
Consulta Riepilogo del ragionamento per informazioni su archiviazione, distribuzione e limitazioni.
Usa la tua chiave OpenAI
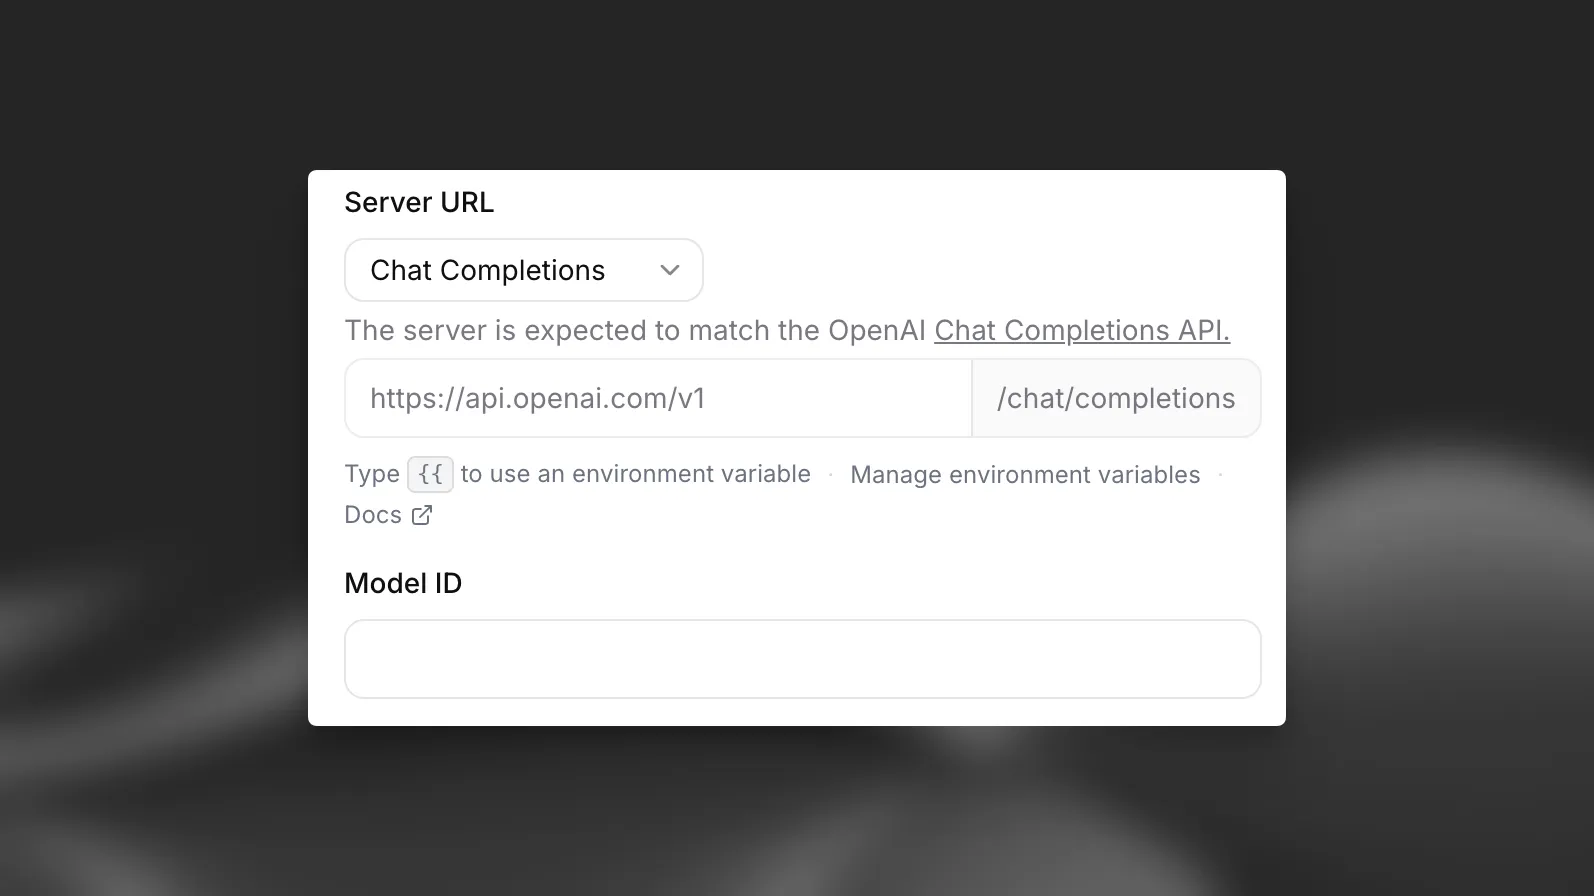
Per integrare una chiave OpenAI personalizzata, aggiorna le impostazioni dell’agente nella dashboard ElevenLabs affinché puntino al tuo server LLM personalizzato e crea un secret contenente OPENAI_API_KEY:
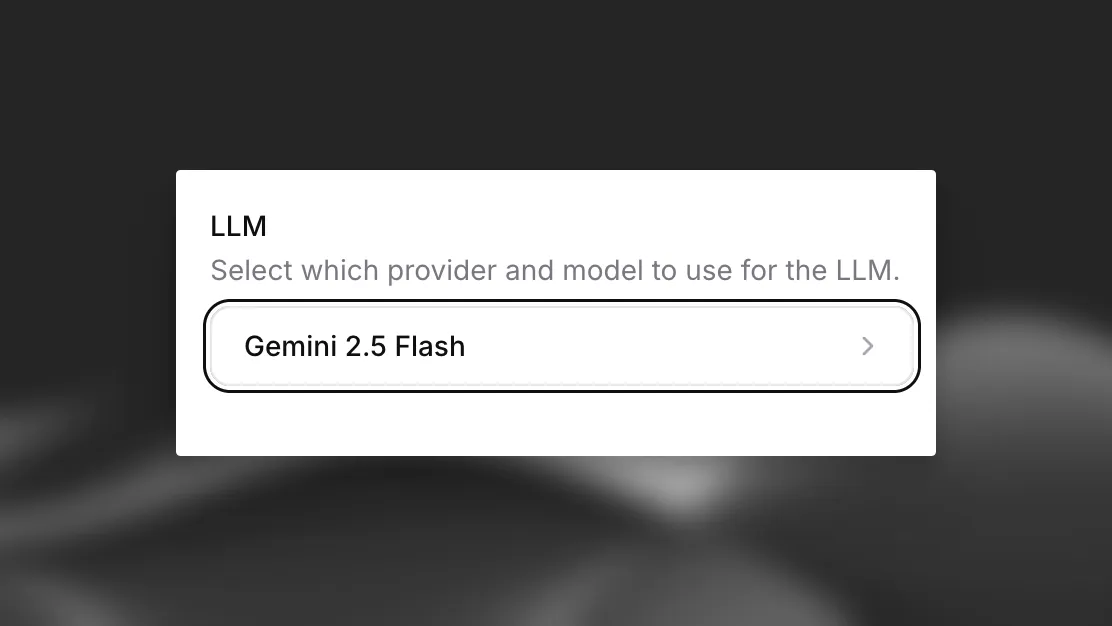
Nelle impostazioni dell’agente nella dashboard ElevenLabs, seleziona “LLM personalizzato” dal menu a discesa “LLM” sulla destra.
Server LLM personalizzato
Per usare un server LLM personalizzato, configura un endpoint server compatibile nello stile di OpenAI. Puoi implementare la Chat Completions API (/v1/chat/completions) oppure la Responses API (/v1/responses).
Entrambi gli endpoint devono restituire risposte in formato SSE (Server-Sent Events) con Content-Type: text/event-stream.
Chat Completions API
Responses API
La Chat Completions API usa l’endpoint /v1/chat/completions.
Ogni chunk deve essere formattato come data: {json}\n\n e lo stream deve terminare con data: [DONE]\n\n.
Ecco un esempio di implementazione del server:
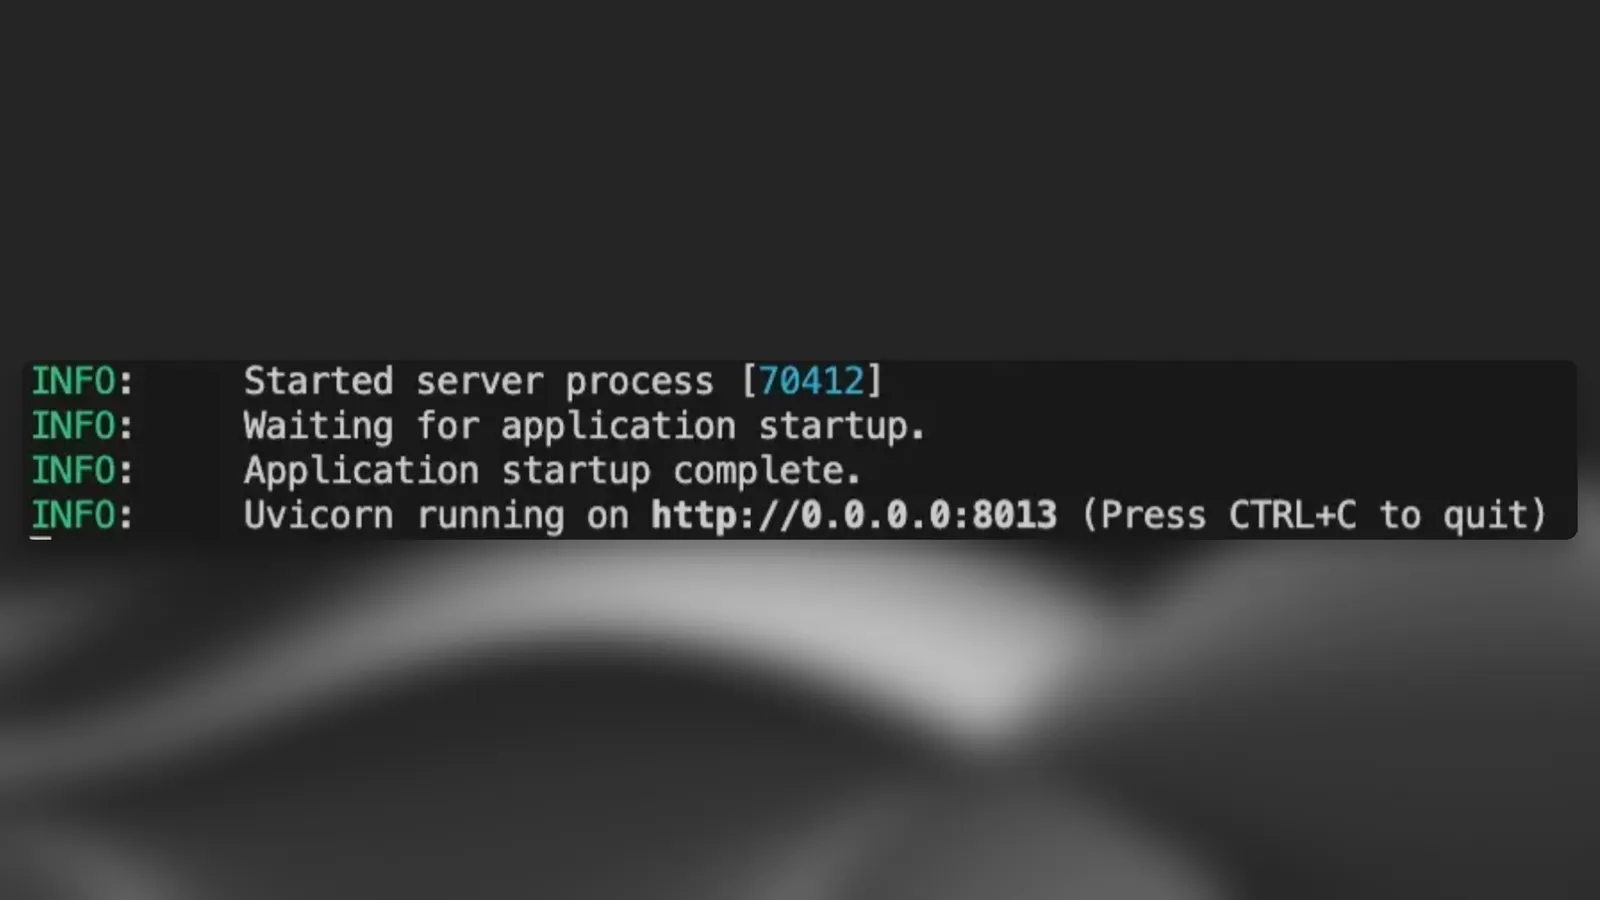
Esegui questo codice o il codice del tuo server.
Configurare un URL pubblico per il server
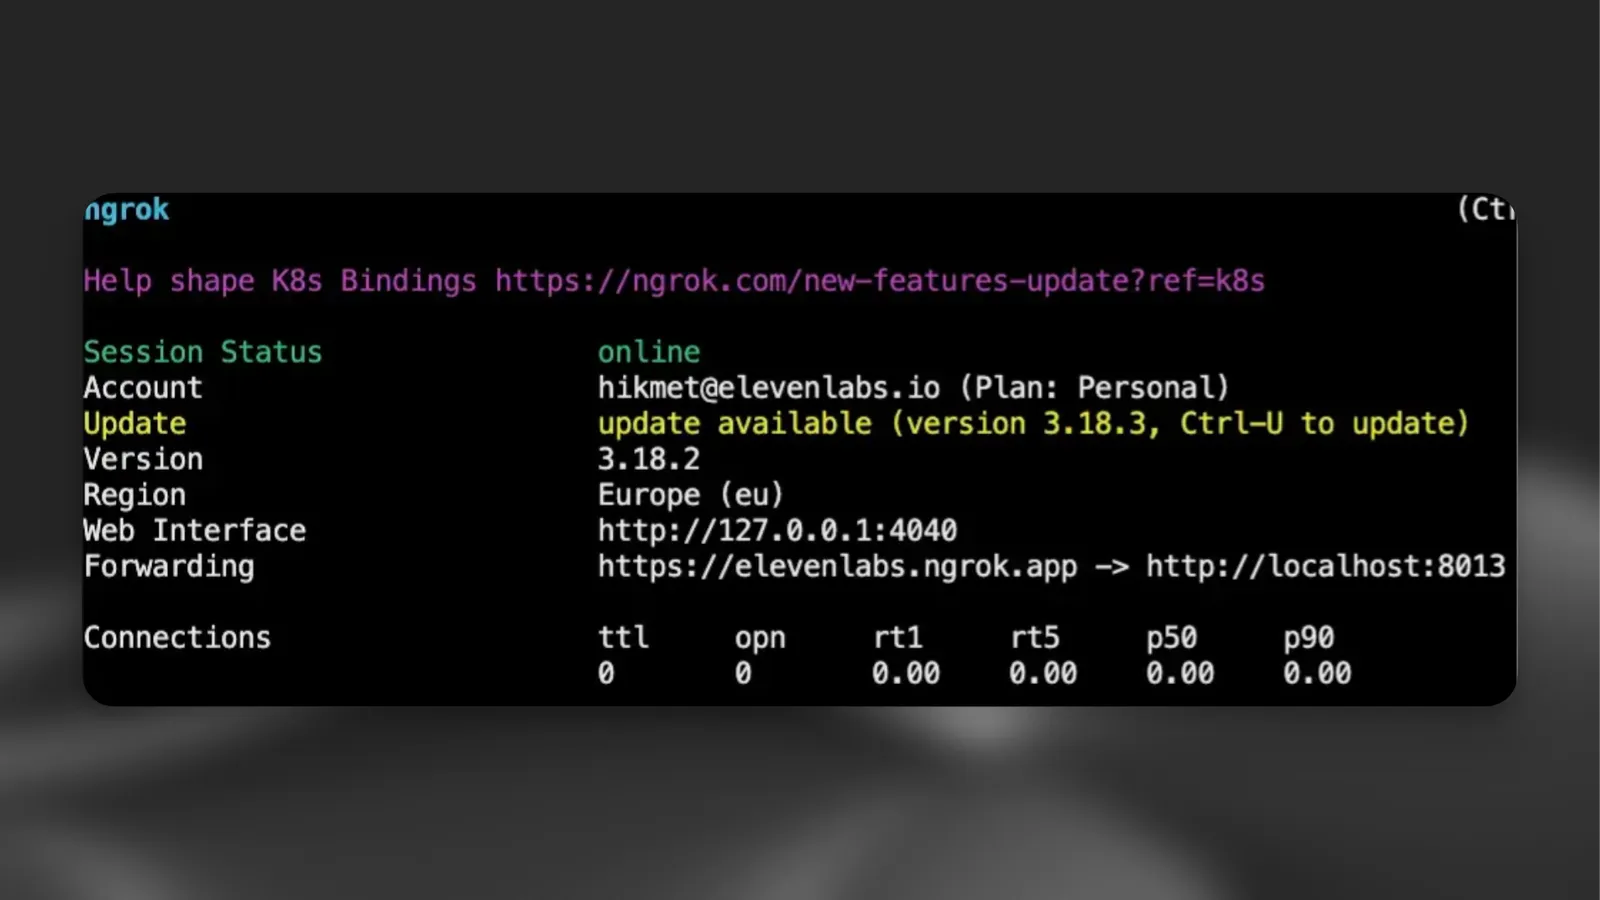
Per rendere accessibile il tuo server, crea un URL pubblico usando uno strumento di tunneling come ngrok:
Configurare CustomLLM di ElevenLabs
Ora aggiorna le impostazioni dell’agente nella dashboard ElevenLabs affinché puntino al tuo server LLM personalizzato.
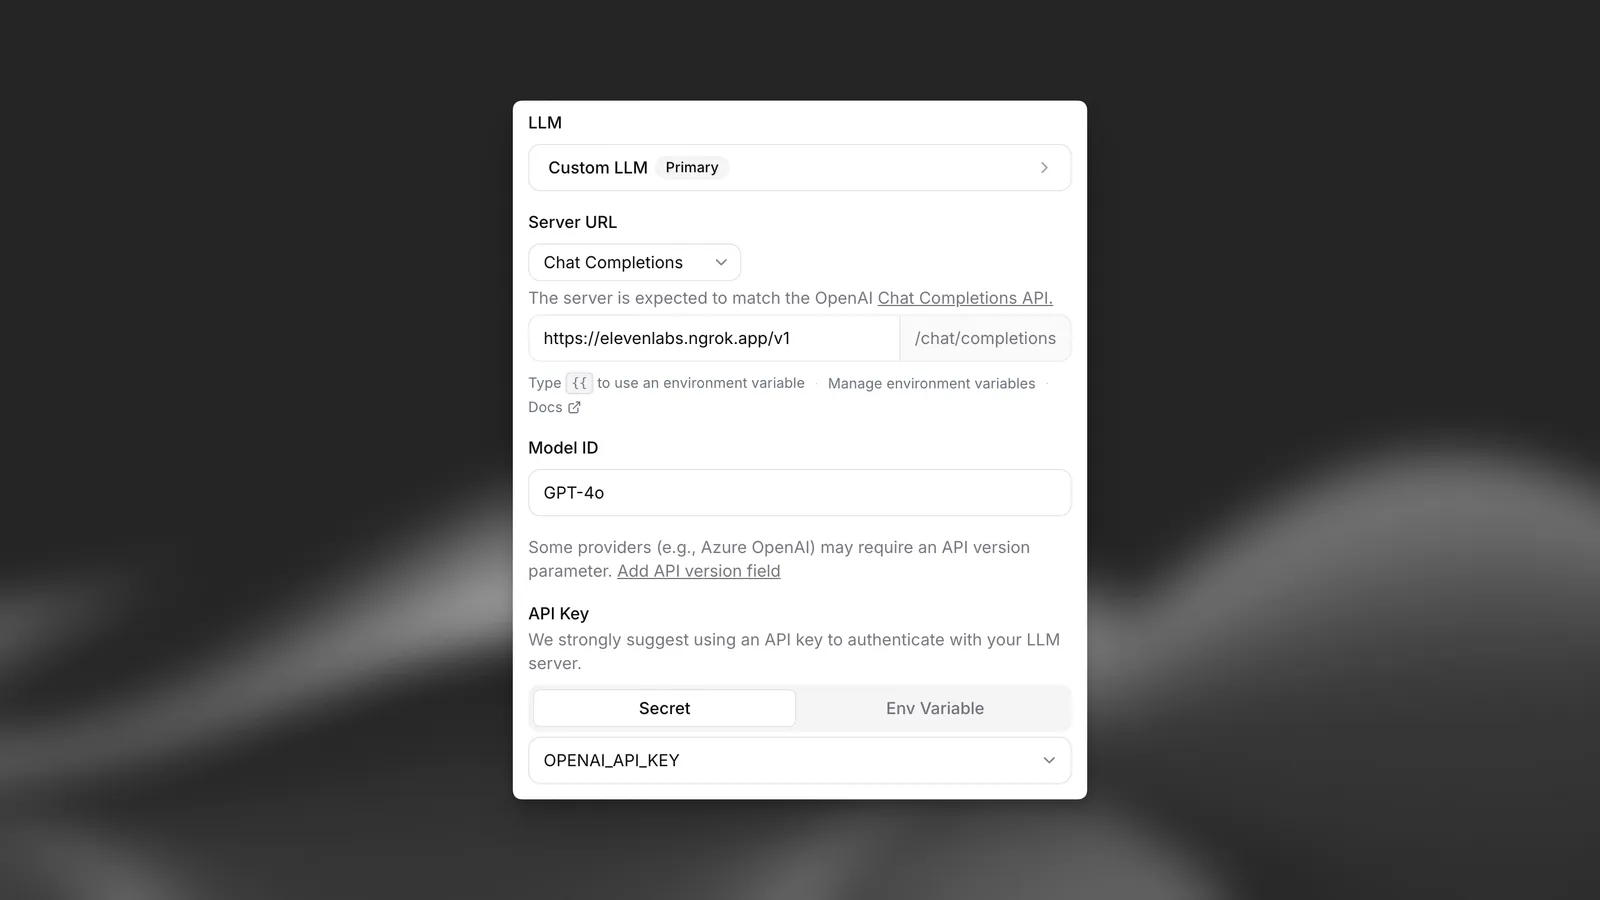
Indirizza l’URL del server all’endpoint ngrok e imposta “Limita l’uso dei token” su 5000.
Ora puoi iniziare a interagire con il tuo agente usando il tuo server LLM.
Ottimizzazione per LLM con elaborazione lenta
Se il tuo LLM personalizzato ha tempi di elaborazione lunghi (forse a causa del ragionamento agentico o di requisiti di pre-elaborazione), puoi migliorare il flusso conversazionale implementando le parole di riempimento nelle risposte in streaming. Questa tecnica aiuta a mantenere una prosodia naturale mentre l’LLM genera la risposta completa.
Parole di riempimento
Quando il tuo LLM ha bisogno di più tempo per elaborare la risposta completa, restituisci una risposta iniziale che termini con "... " (puntini di sospensione seguiti da uno spazio). In questo modo, il sistema Text to Speech può mantenere un flusso naturale e la conversazione resta dinamica.
Questo crea pause naturali che si collegano bene ai contenuti successivi, su cui l’LLM può ragionare più a lungo. Lo spazio aggiuntivo è fondamentale per evitare che il contenuto successivo venga aggiunto a ”…”, causando possibili distorsioni audio.
Implementazione
Ecco come modificare il server del tuo LLM personalizzato per implementare le parole di riempimento:
Integrazione degli strumenti di sistema
Il tuo LLM personalizzato può attivare gli strumenti di sistema per controllare il flusso e lo stato della conversazione. Quando sono configurati nel tuo agente, questi strumenti vengono inclusi automaticamente nel parametro tools delle richieste di completamento della chat.
Come funzionano gli strumenti di sistema
- Decisione dell’LLM: il tuo LLM decide quando chiamare questi strumenti in base al contesto della conversazione
- Risposta dello strumento: l’LLM risponde con chiamate di funzione nel formato OpenAI standard
- Elaborazione backend: ElevenLabs elabora le chiamate degli strumenti e aggiorna lo stato della conversazione
Per maggiori informazioni sugli strumenti di sistema, consulta la nostra guida
Strumenti di sistema disponibili
Termina chiamata
Scopo: terminare automaticamente le conversazioni quando vengono soddisfatte le condizioni appropriate.
Condizioni di attivazione: l’LLM deve chiamare questo strumento quando:
- L’attività principale è stata completata e l’utente è soddisfatto
- La conversazione ha raggiunto una conclusione naturale con accordo reciproco
- L’utente indica esplicitamente di voler terminare la conversazione
Parametri:
reason(stringa, obbligatorio): il motivo per terminare la chiamatamessage(stringa, facoltativo): un messaggio di saluto da inviare all’utente prima di terminare la chiamata
Formato della chiamata di funzione:
Implementazione: configura lo strumento di sistema nelle impostazioni dell’agente. L’LLM riceverà istruzioni dettagliate su quando chiamare questa funzione.
Scopri di più: Strumento Termina chiamata
Rilevamento della lingua
Scopo: passare automaticamente alla lingua rilevata dell’utente durante le conversazioni.
Condizioni di attivazione: l’LLM deve chiamare questo strumento quando:
- L’utente parla una lingua diversa da quella della conversazione corrente
- L’utente richiede esplicitamente di cambiare lingua
- La conversazione richiede il supporto multilingue
Parametri:
reason(stringa, obbligatorio): il motivo del cambio di lingualanguage(stringa, obbligatorio): il codice della lingua a cui passare (deve essere nell’elenco delle lingue supportate)
Formato della chiamata di funzione:
Implementazione: configura le lingue supportate nelle impostazioni dell’agente e aggiungi lo strumento di sistema per il rilevamento della lingua. L’agente cambierà automaticamente voce e risposte in base alle lingue rilevate.
Scopri di più: Strumento di rilevamento della lingua
Trasferimento dell'agente
Scopo: trasferire le conversazioni tra agenti IA specializzati in base alle esigenze dell’utente.
Condizioni di attivazione: l’LLM deve chiamare questo strumento quando:
- La richiesta dell’utente richiede conoscenze specialistiche o funzionalità di un agente diverso
- L’agente corrente non è in grado di gestire adeguatamente la richiesta
- Il flusso della conversazione indica la necessità di un tipo di agente diverso
Parametri:
reason(stringa, facoltativo): il motivo del trasferimento dell’agenteagent_number(intero, obbligatorio): numero con indice a partire da zero dell’agente a cui trasferire la conversazione (in base alle regole di trasferimento configurate)
Formato della chiamata di funzione:
Implementazione: definisci regole di trasferimento che associno le condizioni a ID agente specifici. Configura gli agenti a cui l’agente corrente può trasferire la conversazione. Nella configurazione di trasferimento, gli agenti sono indicati da numeri con indice a partire da zero.
Scopri di più: Strumento di trasferimento dell’agente
Trasferimento a un operatore
Scopo: passare senza interruzioni le conversazioni a operatori umani quando l’assistenza IA non è sufficiente.
Condizioni di attivazione: l’LLM deve chiamare questo strumento quando:
- Ci sono problemi complessi che richiedono il giudizio umano
- L’utente richiede esplicitamente assistenza umana
- L’IA raggiunge i limiti delle sue capacità per la richiesta specifica
- Vengono attivati i protocolli di escalation
Parametri:
reason(stringa, facoltativo): il motivo del trasferimentotransfer_number(stringa, obbligatorio): il numero di telefono a cui trasferire la chiamata (deve corrispondere ai numeri configurati)client_message(stringa, obbligatorio): messaggio letto al cliente durante l’attesa del trasferimentoagent_message(stringa, obbligatorio): messaggio per l’operatore umano che riceve la chiamata
Formato della chiamata di funzione:
Implementazione: configura i numeri di telefono e le condizioni di trasferimento. Definisci i messaggi sia per il cliente sia per l’operatore umano che riceve la chiamata. Funziona sia con Twilio sia con SIP trunking.
Scopri di più: Strumento di trasferimento a un operatore
Salta turno
Scopo: consentire all’agente di fare una pausa e attendere l’input dell’utente senza parlare.
Condizioni di attivazione: l’LLM deve chiamare questo strumento quando:
- L’utente indica di aver bisogno di un momento (“Dammi un secondo”, “Fammi pensare”)
- L’utente richiede una pausa nel flusso della conversazione
- L’agente rileva che l’utente ha bisogno di tempo per elaborare le informazioni
Parametri:
reason(stringa, facoltativo): motivo in formato libero che spiega perché è necessaria la pausa
Formato della chiamata di funzione:
Implementazione: non è necessaria alcuna configurazione aggiuntiva. Lo strumento segnala semplicemente all’agente di rimanere in silenzio finché l’utente non parla di nuovo.
Scopri di più: Strumento Salta turno
Rilevamento della segreteria telefonica
Parametri:
reason(stringa, obbligatorio): il motivo del rilevamento della segreteria telefonica (ad esempio, “rilevato messaggio di benvenuto automatico”, “nessuna risposta umana”)
Formato della chiamata di funzione:
Scopri di più: Strumento di rilevamento della segreteria telefonica
Esempio di richiesta con strumenti di sistema
Quando gli strumenti di sistema sono configurati, il tuo LLM personalizzato riceverà richieste che includono gli strumenti nel formato OpenAI standard:
Il tuo LLM personalizzato deve supportare la chiamata di funzioni per usare gli strumenti di sistema. Assicurati che il modello possa generare risposte di chiamata di funzione corrette nel formato OpenAI.
Funzionalità aggiuntive
Parametri LLM personalizzati
Puoi passare parametri aggiuntivi alla tua implementazione LLM personalizzata.
Python
Esempio di richiesta
Con questa configurazione di messaggi personalizzata, il tuo LLM riceverà richieste in questo formato: