

Integra tu propio modelo
Custom LLM te permite conectar tus conversaciones a tu propio LLM mediante una ruta externa. ElevenLabs también admite LLM integrados de forma nativa
Los LLM personalizados te permiten usar tu propia clave de API de OpenAI o ejecutar un servidor de LLM totalmente personalizado.
Descripción general
De forma predeterminada, usamos nuestras propias credenciales internas para modelos populares como OpenAI. Para usar un servidor de LLM personalizado, debe ajustarse a una de las siguientes estructuras de solicitud/respuesta compatibles con OpenAI:
- API Chat Completions (
/v1/chat/completions) - API Responses (
/v1/responses)
La API Responses es el formato de API más reciente de OpenAI y admite funciones adicionales. Ambos formatos de API son totalmente compatibles con la integración de LLM personalizados.
Las siguientes guías abarcan ambos casos de uso:
- Usa tu propia clave de OpenAI: utiliza tu propia clave de API de OpenAI con nuestra plataforma.
- Servidor de LLM personalizado: aloja y conecta tu propia implementación de servidor de LLM.
Aprenderás a:
- Guardar tu clave de API de OpenAI en ElevenLabs
- Alojar un servidor que reproduzca la ruta de Chat Completions o Responses de OpenAI
- Dirigir ElevenLabs a tu ruta personalizada
- Enviar parámetros adicionales a tu LLM cuando sea necesario
Resumen del razonamiento
Tu ruta debe devolver el razonamiento separado de la respuesta final. ElevenLabs no genera el razonamiento a partir de la respuesta final.
Para solicitar razonamiento a una ruta compatible, activa Resumen del razonamiento en la configuración de LLM del agente o establece enable_reasoning_summary mediante la API.
Devolver el razonamiento
Usa el formato que corresponda a tu ruta:
API Chat Completions
API Responses
Transmite el razonamiento en el campo reasoning o reasoning_content de cada delta de respuesta.
Para rutas compatibles con Gemini, ElevenLabs solicita pensamientos con
google.thinking_config.include_thoughts y lee el contenido marcado con
extra_content.google.thought.
Consulta Resumen del razonamiento para conocer el almacenamiento, la entrega y las limitaciones.
Usar tu propia clave de OpenAI
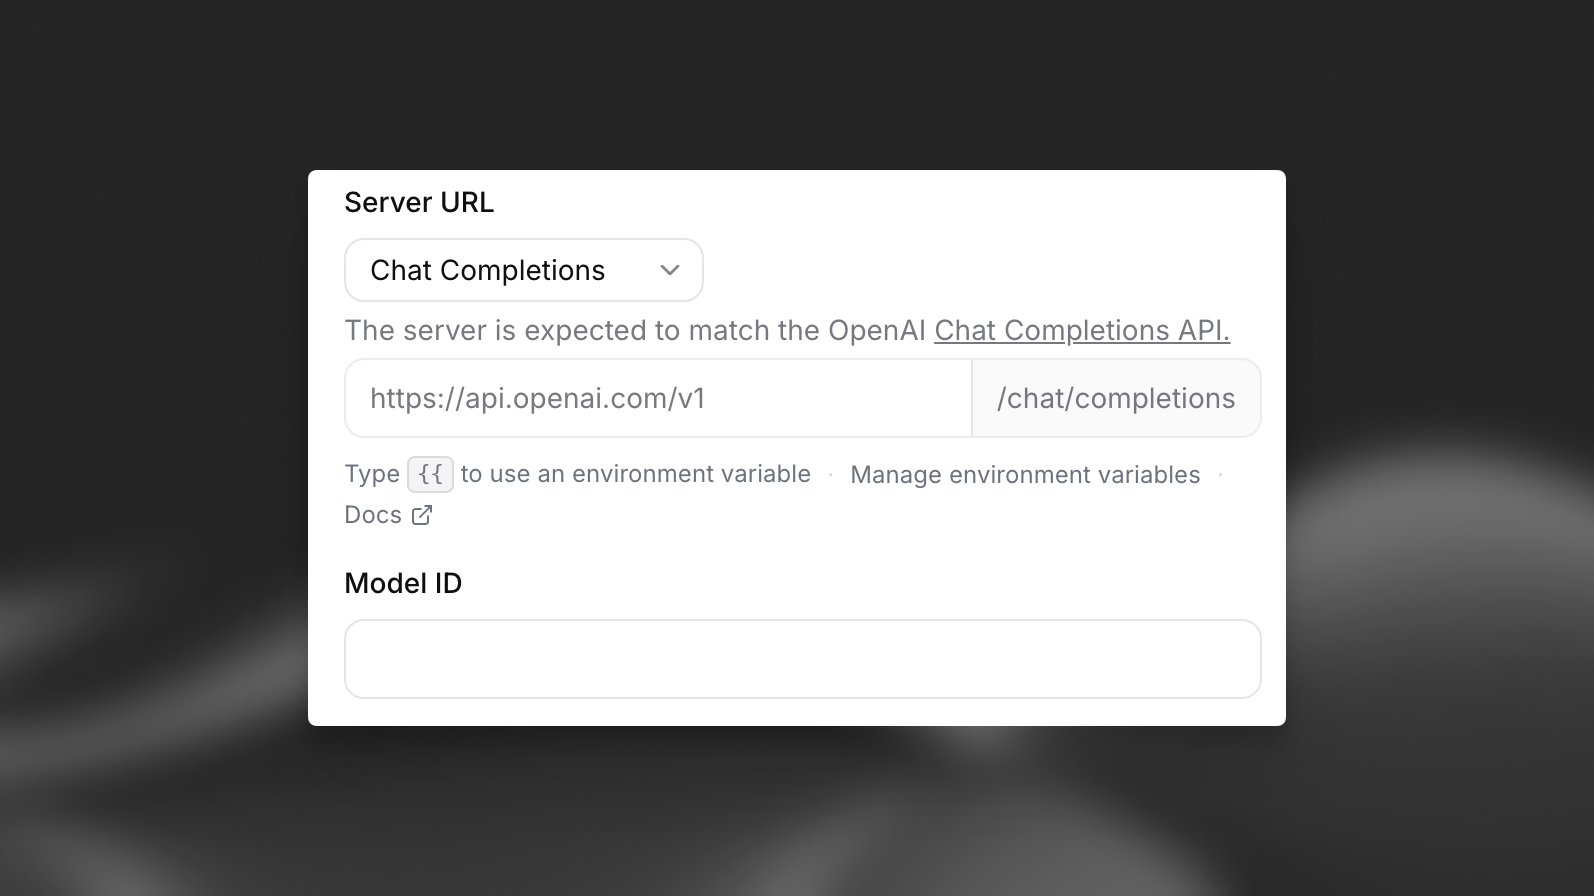
Para integrar una clave de OpenAI personalizada, actualiza la configuración de tu agente en el panel de ElevenLabs para que apunte a tu servidor de LLM personalizado y crea un secreto que contenga tu OPENAI_API_KEY:
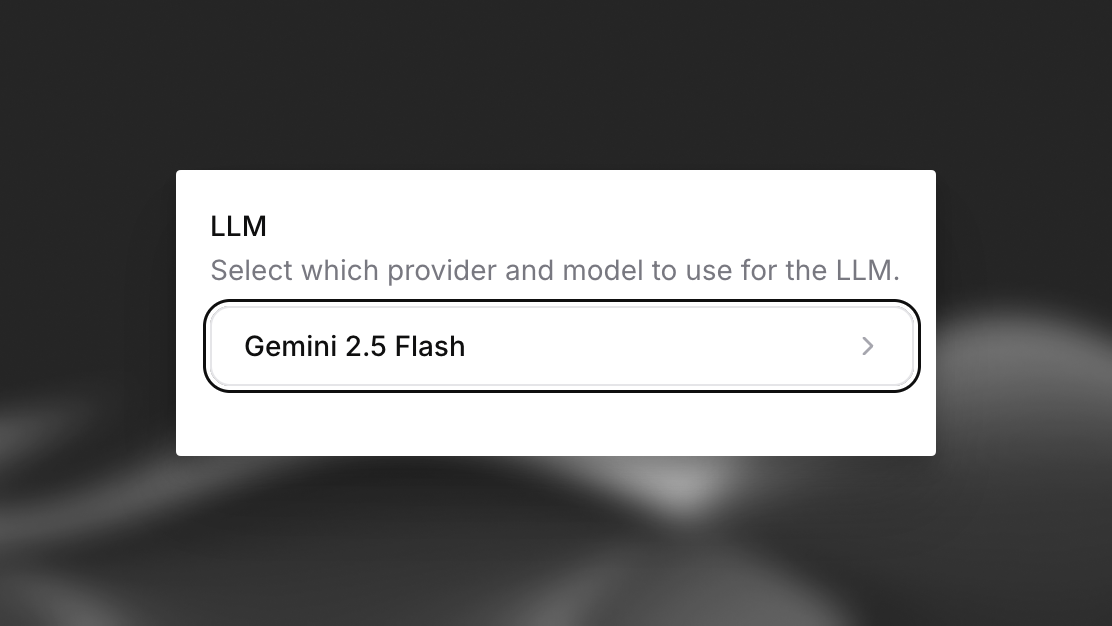
En la configuración de tu agente del panel de ElevenLabs, selecciona “Custom LLM” en el menú desplegable “LLM” de la derecha.
Servidor de LLM personalizado
Para usar un servidor de LLM personalizado, configura una ruta de servidor compatible siguiendo el estilo de OpenAI. Puedes implementar la API Chat Completions (/v1/chat/completions) o la API Responses (/v1/responses).
Ambas rutas deben devolver respuestas en formato SSE (eventos enviados por el servidor) con Content-Type: text/event-stream.
API Chat Completions
API Responses
La API Chat Completions usa la ruta /v1/chat/completions.
Cada fragmento debe tener el formato data: {json}\n\n y el stream debe terminar con data: [DONE]\n\n.
Este es un ejemplo de implementación de servidor:
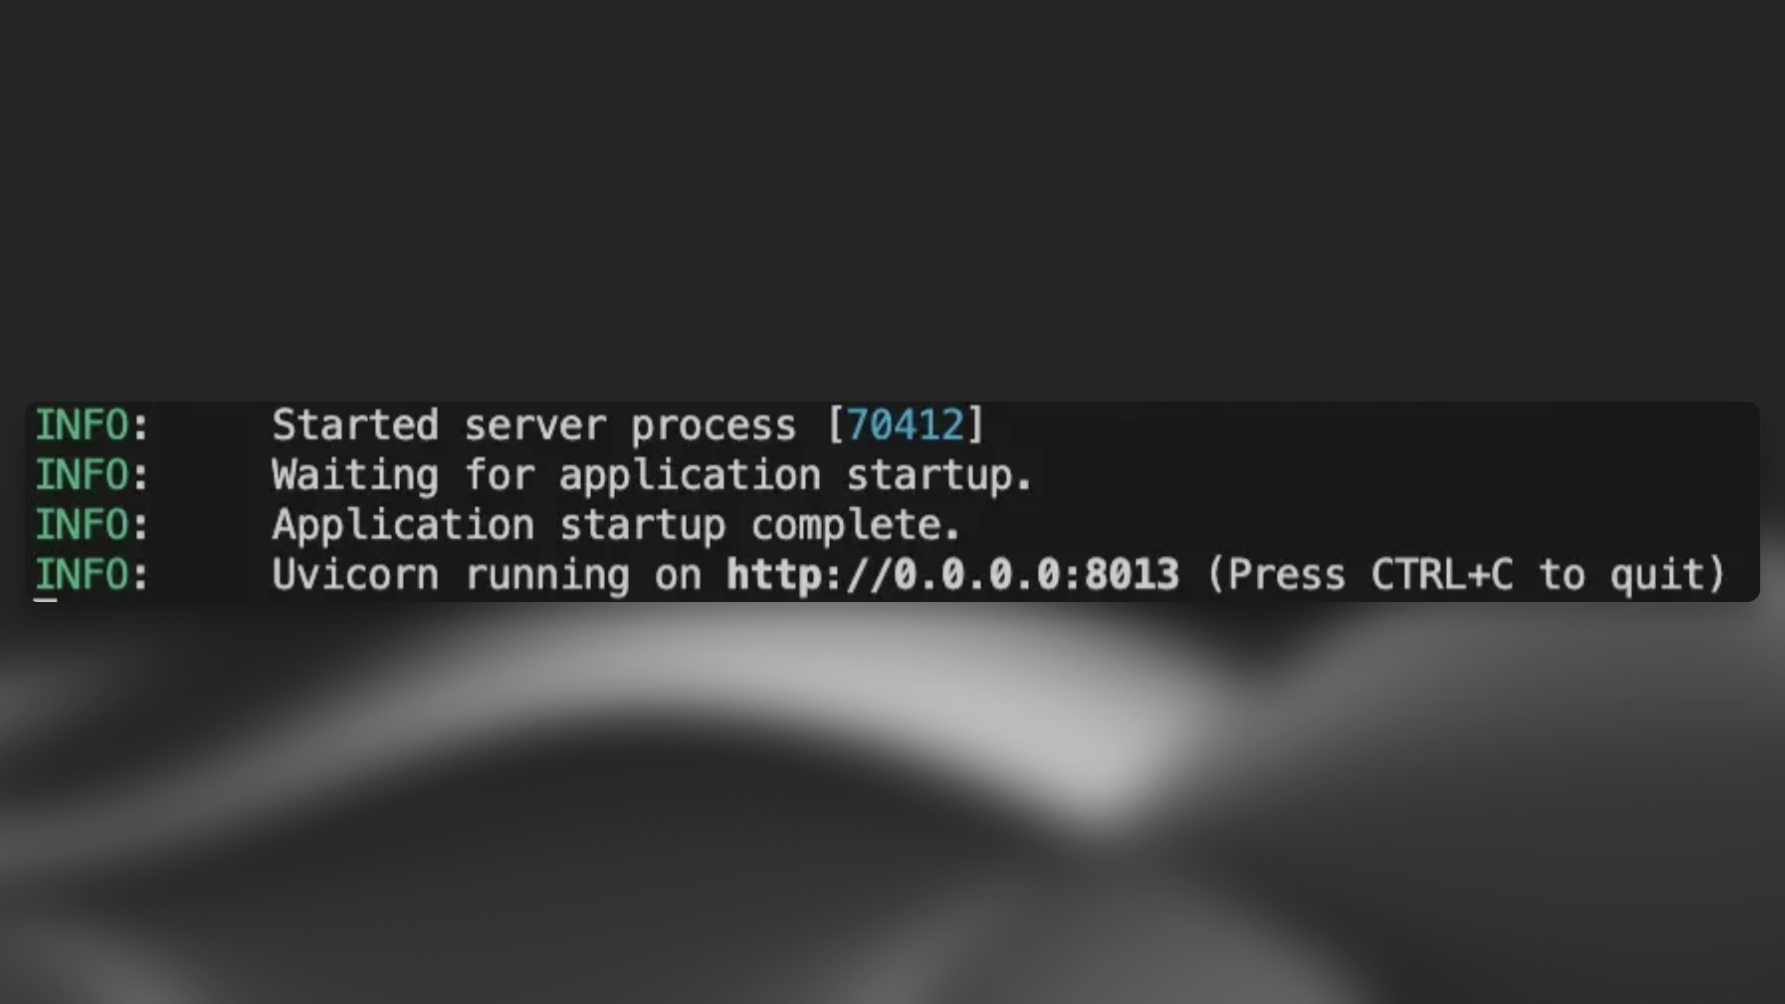
Ejecuta este código o el código de tu propio servidor.
Configurar una URL pública para tu servidor
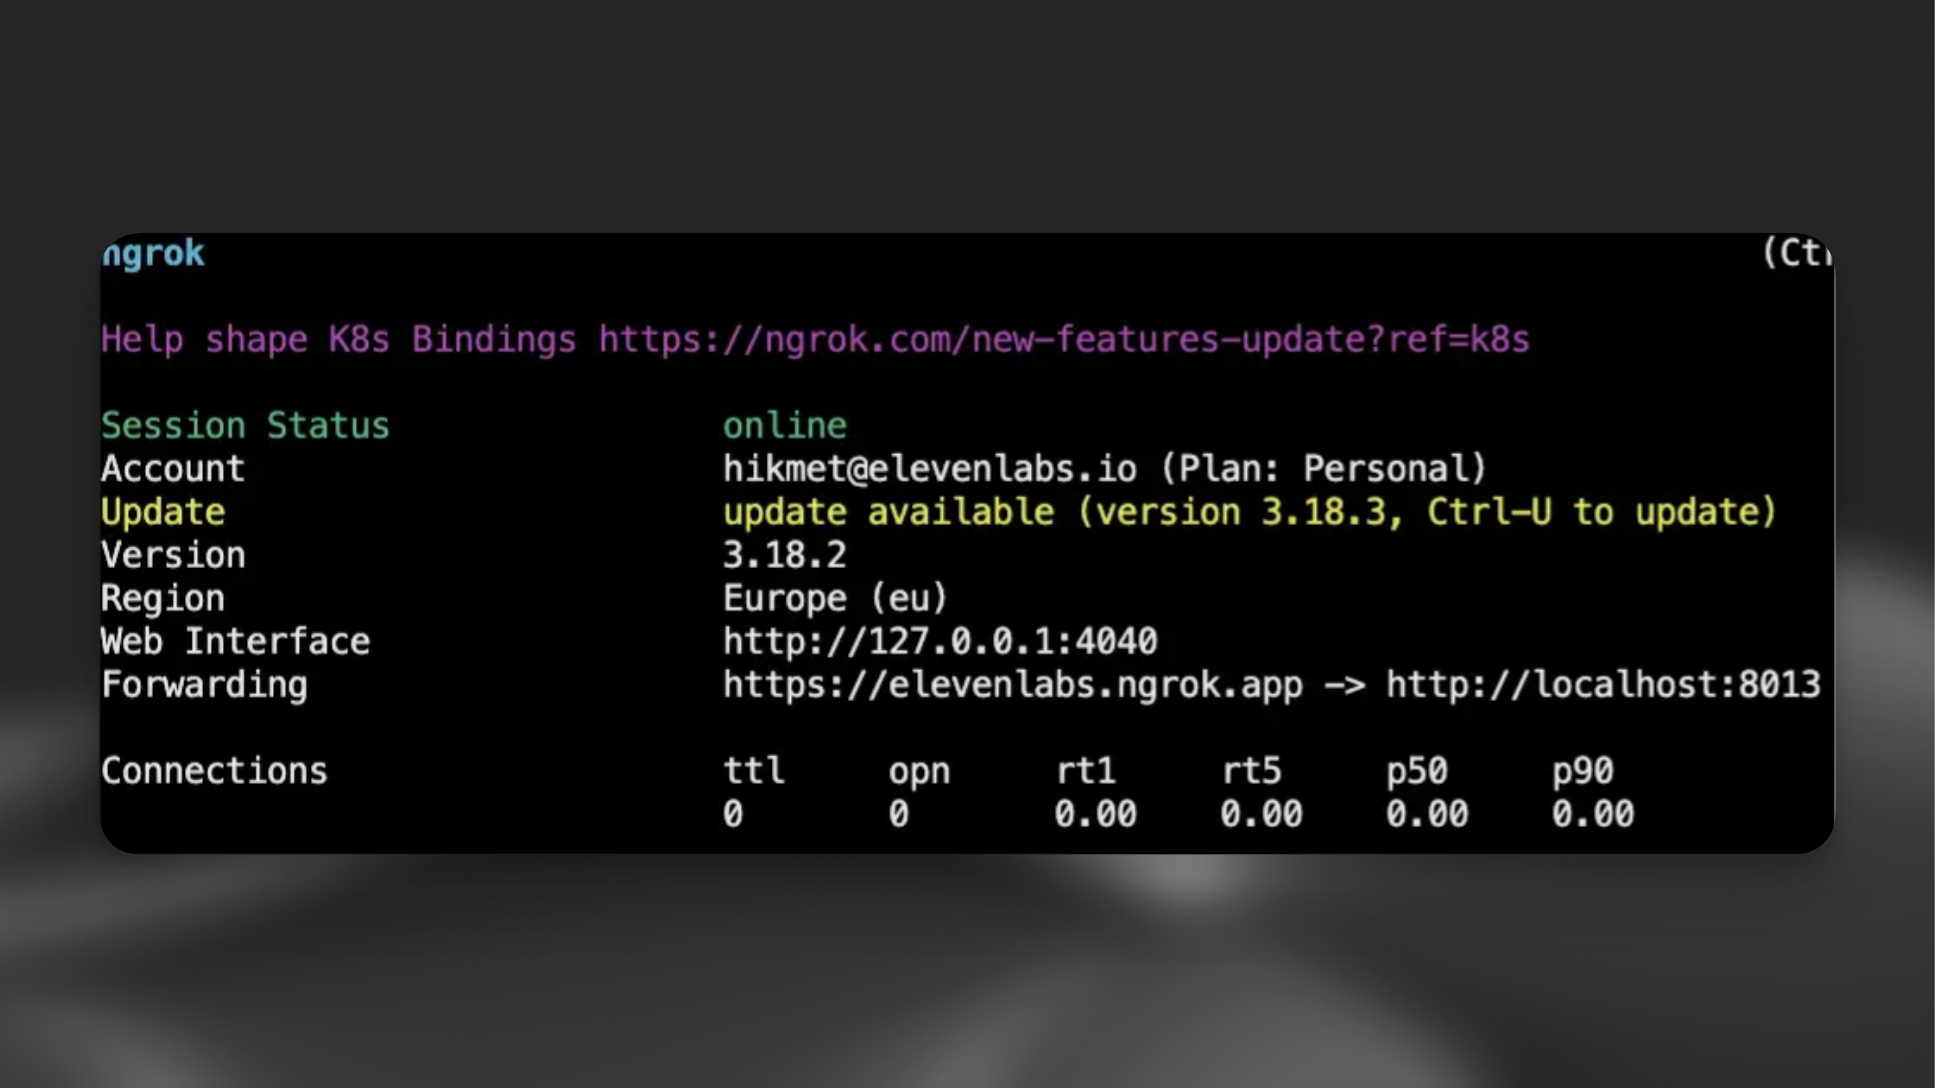
Para que tu servidor sea accesible, crea una URL pública con una herramienta de tunelización como ngrok:
Configurar CustomLLM de ElevenLabs
A continuación, actualiza la configuración de tu agente en el panel de ElevenLabs para que apunte a tu servidor de LLM personalizado.
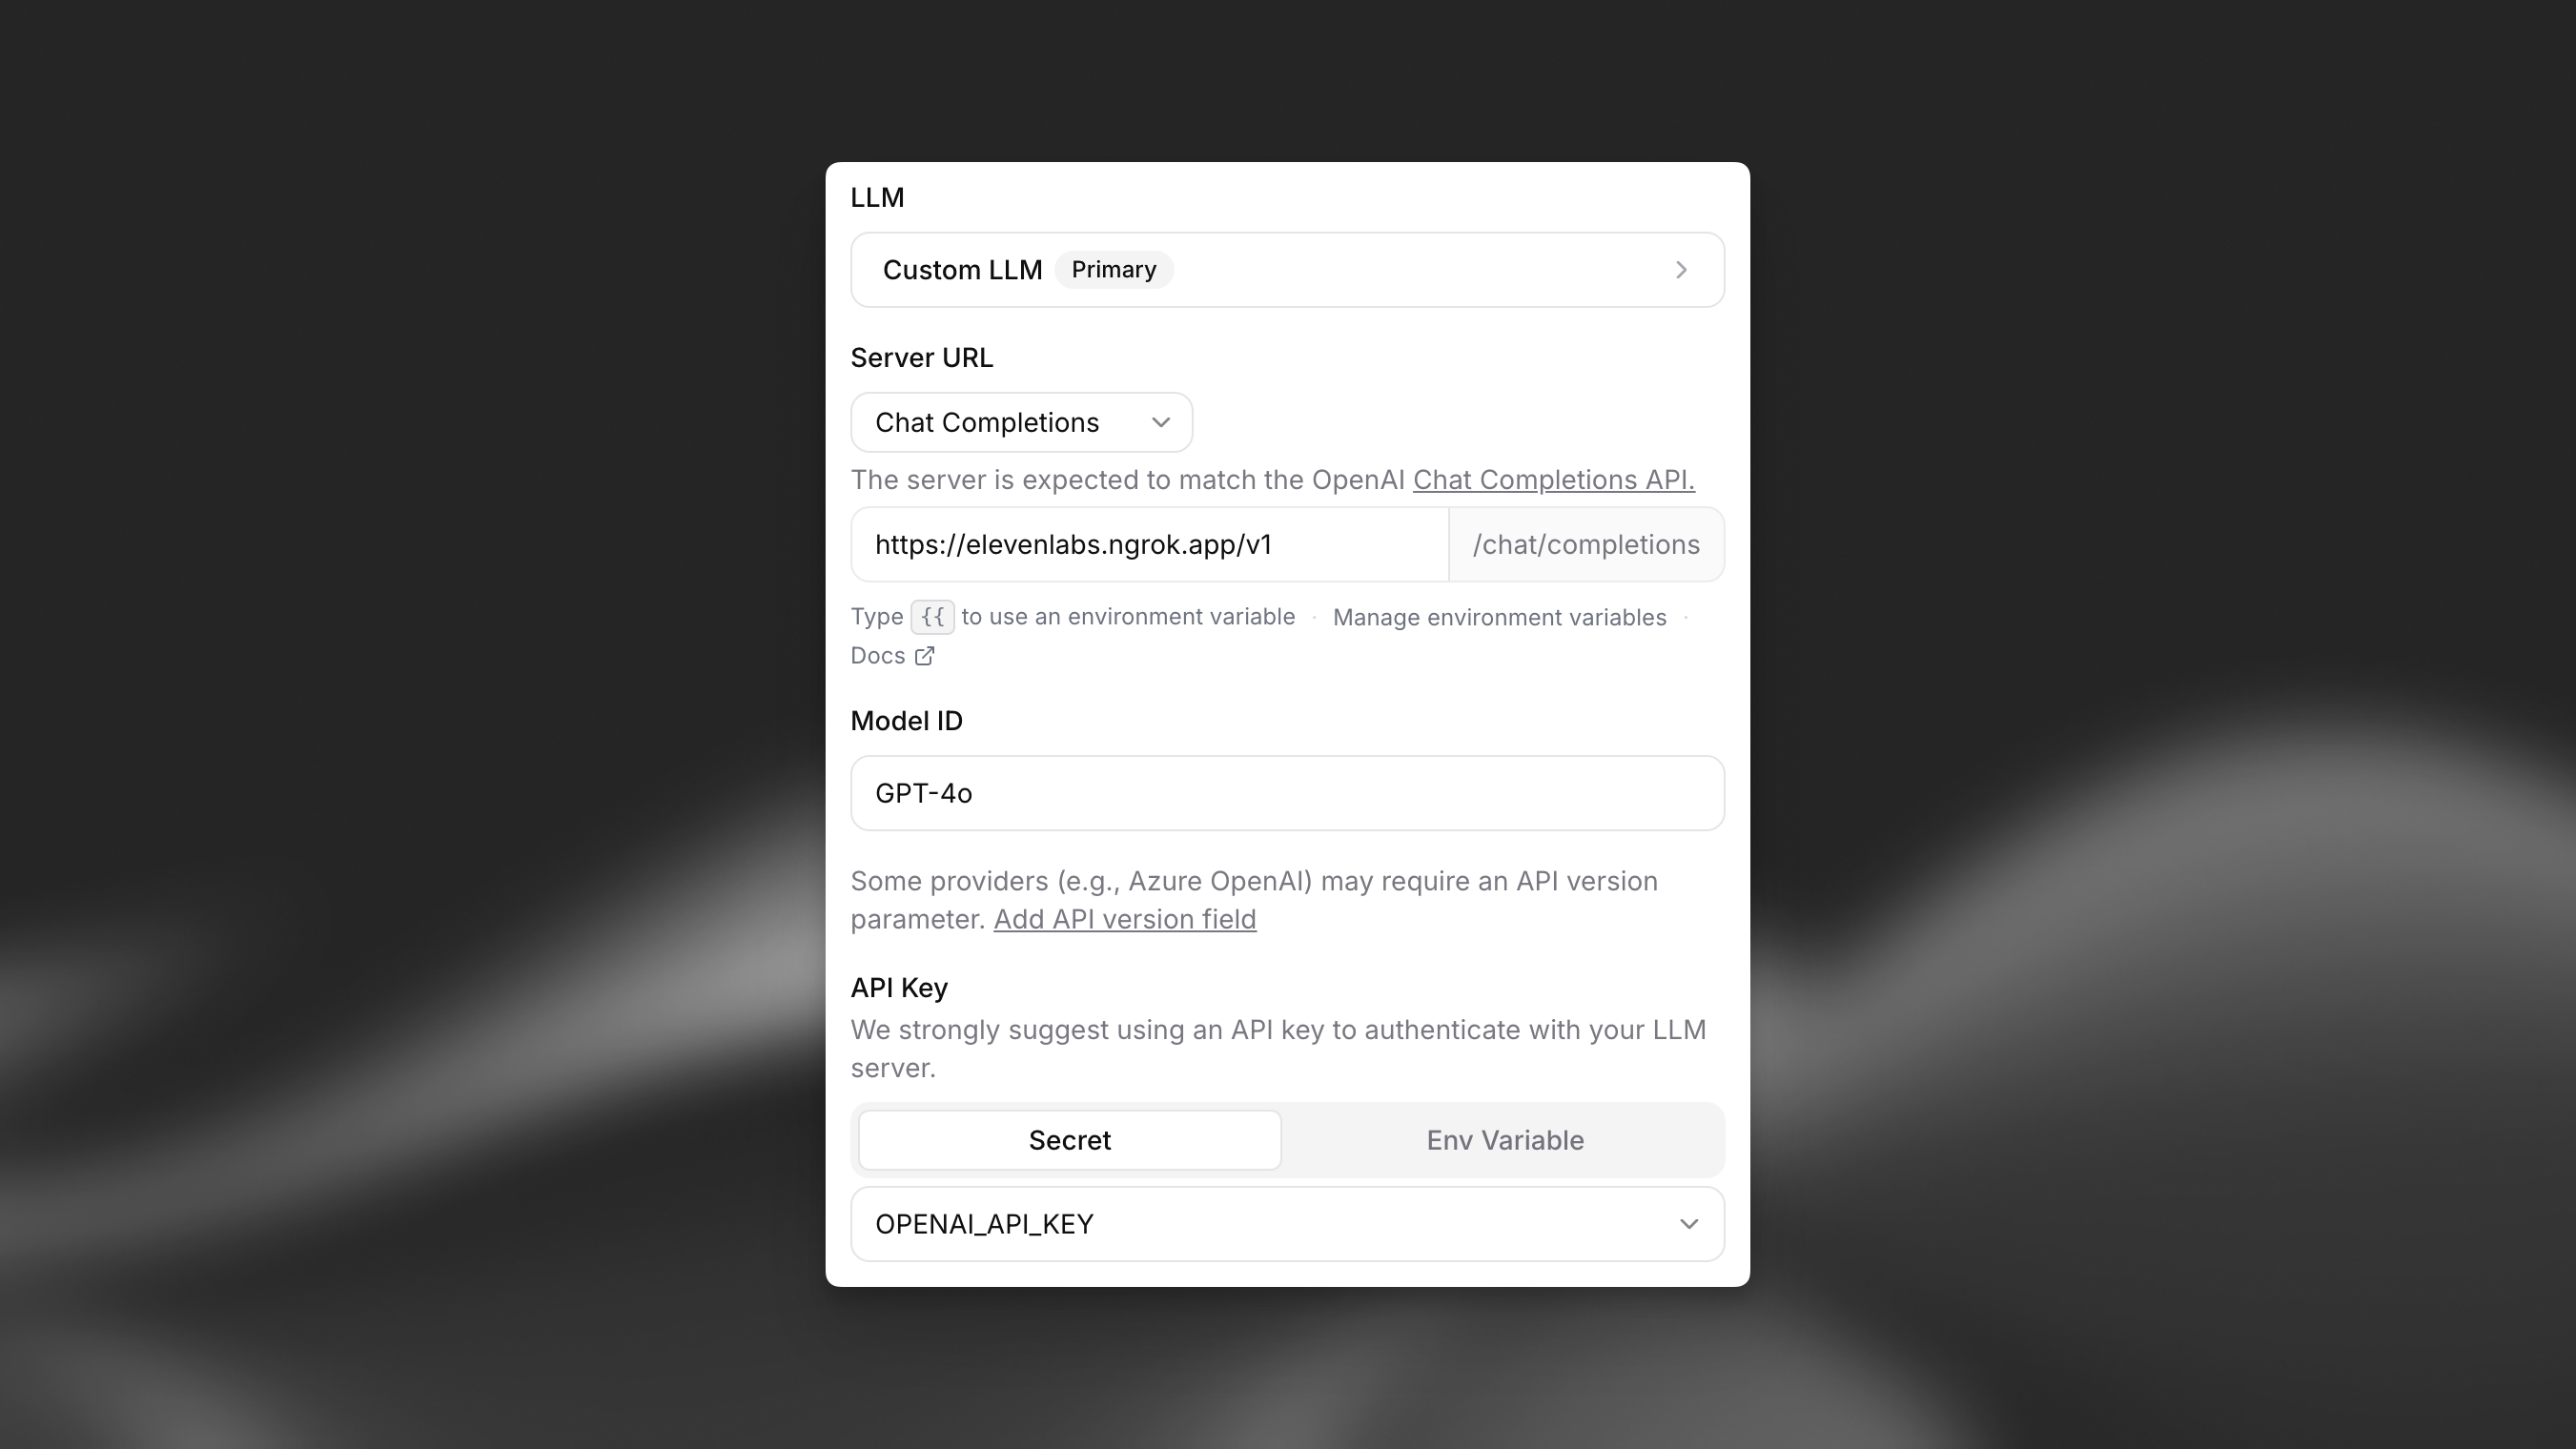
Dirige la URL de tu servidor a la ruta de ngrok y establece “Limit token usage” en 5000.
Ahora puedes empezar a interactuar con tu agente usando tu propio servidor de LLM.
Optimización para LLM con procesamiento lento
Si tu LLM personalizado tiene tiempos de procesamiento lentos (quizá debido al razonamiento agéntico o a requisitos de preprocesamiento), puedes mejorar el flujo de la conversación implementando palabras de espera en tus respuestas de streaming. Esta técnica ayuda a mantener una prosodia natural mientras tu LLM genera la respuesta completa.
Palabras de espera
Cuando tu LLM necesite más tiempo para procesar la respuesta completa, devuelve una respuesta inicial que termine con "... " (puntos suspensivos seguidos de un espacio). Esto permite que el sistema de Texto a Voz mantenga un flujo natural y que la conversación siga siendo dinámica.
Esto crea pausas naturales que enlazan bien con el contenido posterior sobre el que el LLM puede razonar durante más tiempo. El espacio adicional es fundamental para garantizar que el contenido posterior no se añada a ”…”, lo que puede provocar distorsiones de audio.
Implementación
Así puedes modificar tu servidor de LLM personalizado para implementar palabras de espera:
Integración de herramientas del sistema
Tu LLM personalizado puede activar herramientas del sistema para controlar el flujo y el estado de la conversación. Estas herramientas se incluyen automáticamente en el parámetro tools de tus solicitudes de finalización de chat cuando se configuran en tu agente.
Cómo funcionan las herramientas del sistema
- Decisión del LLM: Tu LLM personalizado decide cuándo llamar a estas herramientas según el contexto de la conversación
- Respuesta de la herramienta: El LLM responde con llamadas a funciones en el formato estándar de OpenAI
- Procesamiento del backend: ElevenLabs procesa las llamadas a herramientas y actualiza el estado de la conversación
Para obtener más información sobre las herramientas del sistema, consulta nuestra guía
Herramientas del sistema disponibles
Finalizar llamada
Objetivo: Finalizar automáticamente conversaciones cuando se cumplan las condiciones adecuadas.
Condiciones de activación: El LLM debe llamar a esta herramienta cuando:
- Se haya completado la tarea principal y el usuario esté satisfecho
- La conversación haya llegado a una conclusión natural de mutuo acuerdo
- El usuario indique explícitamente que quiere finalizar la conversación
Parámetros:
reason(cadena, obligatorio): El motivo para finalizar la llamadamessage(cadena, opcional): Un mensaje de despedida para enviar al usuario antes de finalizar la llamada
Formato de llamada a función:
Implementación: Configúrala como una herramienta del sistema en los ajustes de tu agente. El LLM recibirá instrucciones detalladas sobre cuándo llamar a esta función.
Más información: Herramienta para finalizar llamadas
Detección de idioma
Objetivo: Cambiar automáticamente al idioma detectado del usuario durante las conversaciones.
Condiciones de activación: El LLM debe llamar a esta herramienta cuando:
- El usuario hable en un idioma distinto al idioma actual de la conversación
- El usuario solicite explícitamente cambiar de idioma
- La conversación necesite compatibilidad con varios idiomas
Parámetros:
reason(cadena, obligatorio): El motivo del cambio de idiomalanguage(cadena, obligatorio): El código de idioma al que cambiar (debe estar en la lista de idiomas compatibles)
Formato de llamada a función:
Implementación: Configura los idiomas compatibles en los ajustes del agente y añade la herramienta del sistema de detección de idioma. El agente cambiará automáticamente la voz y las respuestas para adaptarse a los idiomas detectados.
Más información: Herramienta de detección de idioma
Transferencia de agente
Objetivo: Transferir conversaciones entre agentes de IA especializados según las necesidades del usuario.
Condiciones de activación: El LLM debe llamar a esta herramienta cuando:
- La solicitud del usuario requiera conocimientos especializados o capacidades de otro agente
- El agente actual no pueda gestionar adecuadamente la consulta
- El flujo de la conversación indique que se necesita un tipo de agente diferente
Parámetros:
reason(cadena, opcional): El motivo de la transferencia de agenteagent_number(entero, obligatorio): Número indexado desde cero del agente al que transferir (según las reglas de transferencia configuradas)
Formato de llamada a función:
Implementación: Define reglas de transferencia que asignen condiciones a ID de agente específicos. Configura a qué agentes puede transferir el agente actual. Los agentes se identifican mediante números indexados desde cero en la configuración de transferencia.
Más información: Herramienta de transferencia de agente
Transferir a una persona
Objetivo: Derivar conversaciones sin problemas a operadores humanos cuando la asistencia de IA no sea suficiente.
Condiciones de activación: El LLM debe llamar a esta herramienta cuando:
- Haya problemas complejos que requieran criterio humano
- El usuario solicite explícitamente asistencia humana
- La IA alcance los límites de sus capacidades para la solicitud específica
- Se activen protocolos de escalado
Parámetros:
reason(cadena, opcional): El motivo de la transferenciatransfer_number(cadena, obligatorio): El número de teléfono al que transferir (debe coincidir con los números configurados)client_message(cadena, obligatorio): Mensaje que se lee al cliente mientras espera la transferenciaagent_message(cadena, obligatorio): Mensaje para el operador humano que recibe la llamada
Formato de llamada a función:
Implementación: Configura los números de teléfono y las condiciones de transferencia. Define mensajes tanto para el cliente como para el operador humano que recibe la llamada. Funciona tanto con Twilio como con trunking SIP.
Más información: Herramienta para transferir a una persona
Omitir turno
Objetivo: Permitir que el agente pause y espere la intervención del usuario sin hablar.
Condiciones de activación: El LLM debe llamar a esta herramienta cuando:
- El usuario indique que necesita un momento (“Dame un segundo”, “Déjame pensar”)
- El usuario solicite una pausa en el flujo de la conversación
- El agente detecte que el usuario necesita tiempo para procesar la información
Parámetros:
reason(cadena, opcional): Motivo de texto libre que explica por qué se necesita la pausa
Formato de llamada a función:
Implementación: No se necesita configuración adicional. La herramienta simplemente indica al agente que permanezca en silencio hasta que el usuario vuelva a hablar.
Más información: Herramienta para omitir turno
Detección de buzón de voz
Parámetros:
reason(cadena, obligatorio): El motivo para detectar el buzón de voz (por ejemplo, «se ha detectado un saludo automatizado», «no hay respuesta humana»)
Formato de llamada de función:
Más información: Herramienta de detección de buzón de voz
Ejemplo de solicitud con herramientas del sistema
Cuando se configuran herramientas del sistema, tu LLM personalizado recibirá solicitudes que incluyen las herramientas en el formato estándar de OpenAI:
Tu LLM personalizado debe admitir llamadas a funciones para usar las herramientas del sistema. Asegúrate de que tu modelo pueda generar respuestas de llamada a función adecuadas en formato OpenAI.
Funciones adicionales
Parámetros de LLM personalizados
Puedes pasar parámetros adicionales a tu implementación de LLM personalizada.
Python
Ejemplo de solicitud
Con esta configuración de mensajes personalizados, tu LLM recibirá solicitudes con este formato: