

Integrera din egen modell
Med Custom LLM kan du ansluta dina samtal till din egen LLM via en extern slutpunkt. ElevenLabs stöder även inbyggt integrerade LLM:er
Custom LLMs låter dig använda din egen OpenAI API-nyckel eller köra en helt anpassad LLM-server.
En anpassad LLM kan inte användas med en Realtime-modell.
Översikt
Som standard använder vi våra egna interna autentiseringsuppgifter för populära modeller som OpenAI. För att använda en anpassad LLM-server måste den följa en av följande OpenAI-kompatibla strukturer för begäran och svar:
- Chat Completions API (
/v1/chat/completions) - Responses API (
/v1/responses)
Responses API är OpenAI:s nyare API-format som stöder ytterligare funktioner. Båda API-formaten stöds fullt ut för integrering av anpassade LLM:er.
Följande guider täcker båda användningsfallen:
- Använd din egen OpenAI-nyckel: Använd din egen OpenAI API-nyckel med vår plattform.
- Anpassad LLM-server: Hosta och anslut din egen implementering av en LLM-server.
Du lär dig att:
- Lagra din OpenAI API-nyckel i ElevenLabs
- Hosta en server som replikerar OpenAI:s slutpunkt för Chat Completions eller Responses
- Rikta ElevenLabs till din anpassade slutpunkt
- Skicka extra parametrar till din LLM vid behov
Sammanfattning av resonemang
Din slutpunkt måste returnera resonemang separat från det slutliga svaret. ElevenLabs genererar inte resonemang från det slutliga svaret.
För att begära resonemang från en slutpunkt som stöds aktiverar du Sammanfattning av resonemang i agentens LLM-inställningar eller anger enable_reasoning_summary via API:t.
Returnera resonemang
Använd det format som matchar din slutpunkt:
Chat Completions API
Responses API
Strömma resonemang i fältet reasoning eller reasoning_content i varje svarsdelta.
För Gemini-kompatibla slutpunkter begär ElevenLabs tankar med
google.thinking_config.include_thoughts och läser innehåll markerat med
extra_content.google.thought.
Se Sammanfattning av resonemang för lagring, leverans och begränsningar.
Använd din egen OpenAI-nyckel
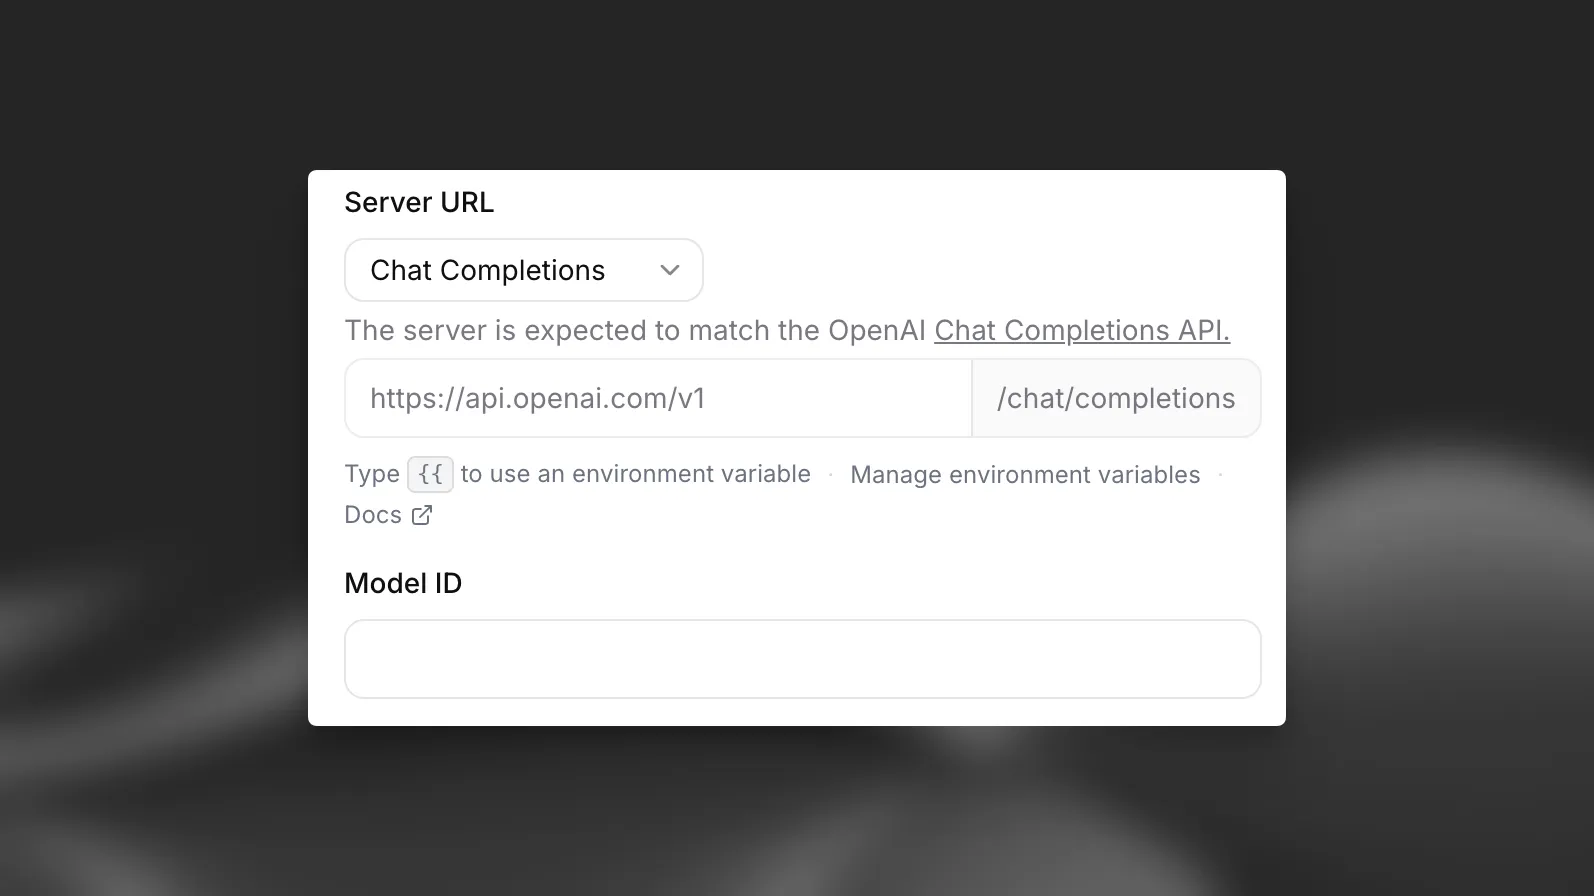
För att integrera en anpassad OpenAI-nyckel uppdaterar du agentinställningarna i ElevenLabs instrumentpanel så att de pekar på din anpassade LLM-server och skapar en hemlighet som innehåller din OPENAI_API_KEY:
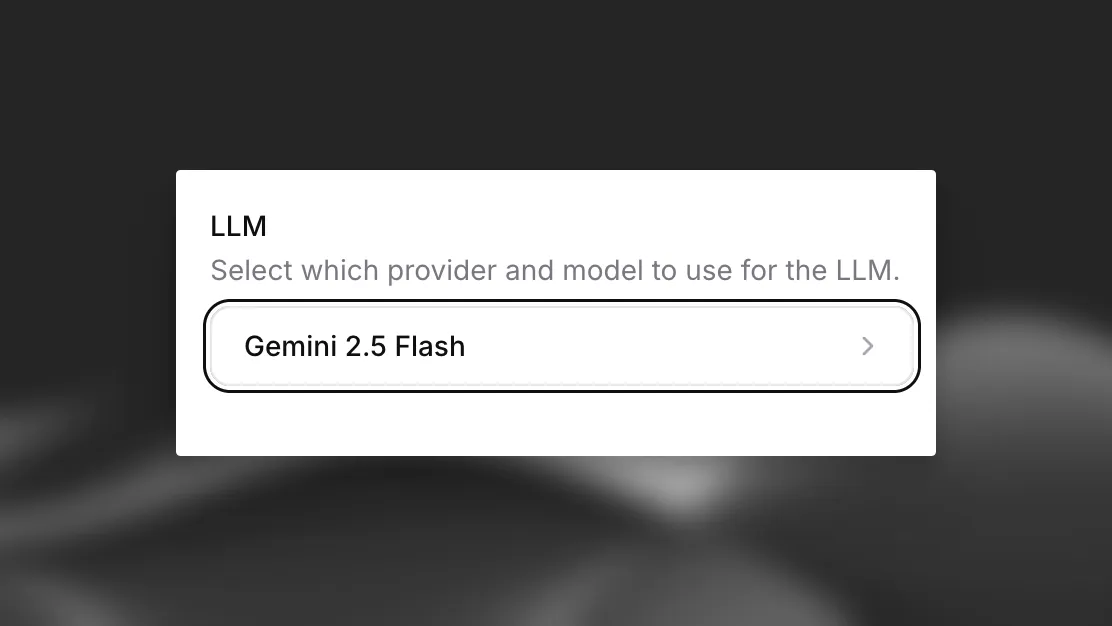
I agentinställningarna i ElevenLabs instrumentpanel väljer du “Custom LLM” i rullgardinsmenyn “LLM” till höger.
Anpassad LLM-server
För att använda en anpassad LLM-server konfigurerar du en kompatibel serverslutpunkt enligt OpenAI:s modell. Du kan implementera antingen Chat Completions API (/v1/chat/completions) eller Responses API (/v1/responses).
Båda slutpunkterna måste returnera svar i SSE-format (Server-Sent Events) med Content-Type: text/event-stream.
Chat Completions API
Responses API
Chat Completions API använder slutpunkten /v1/chat/completions.
Varje del måste formateras som data: {json}\n\n och strömmen måste avslutas med data: [DONE]\n\n.
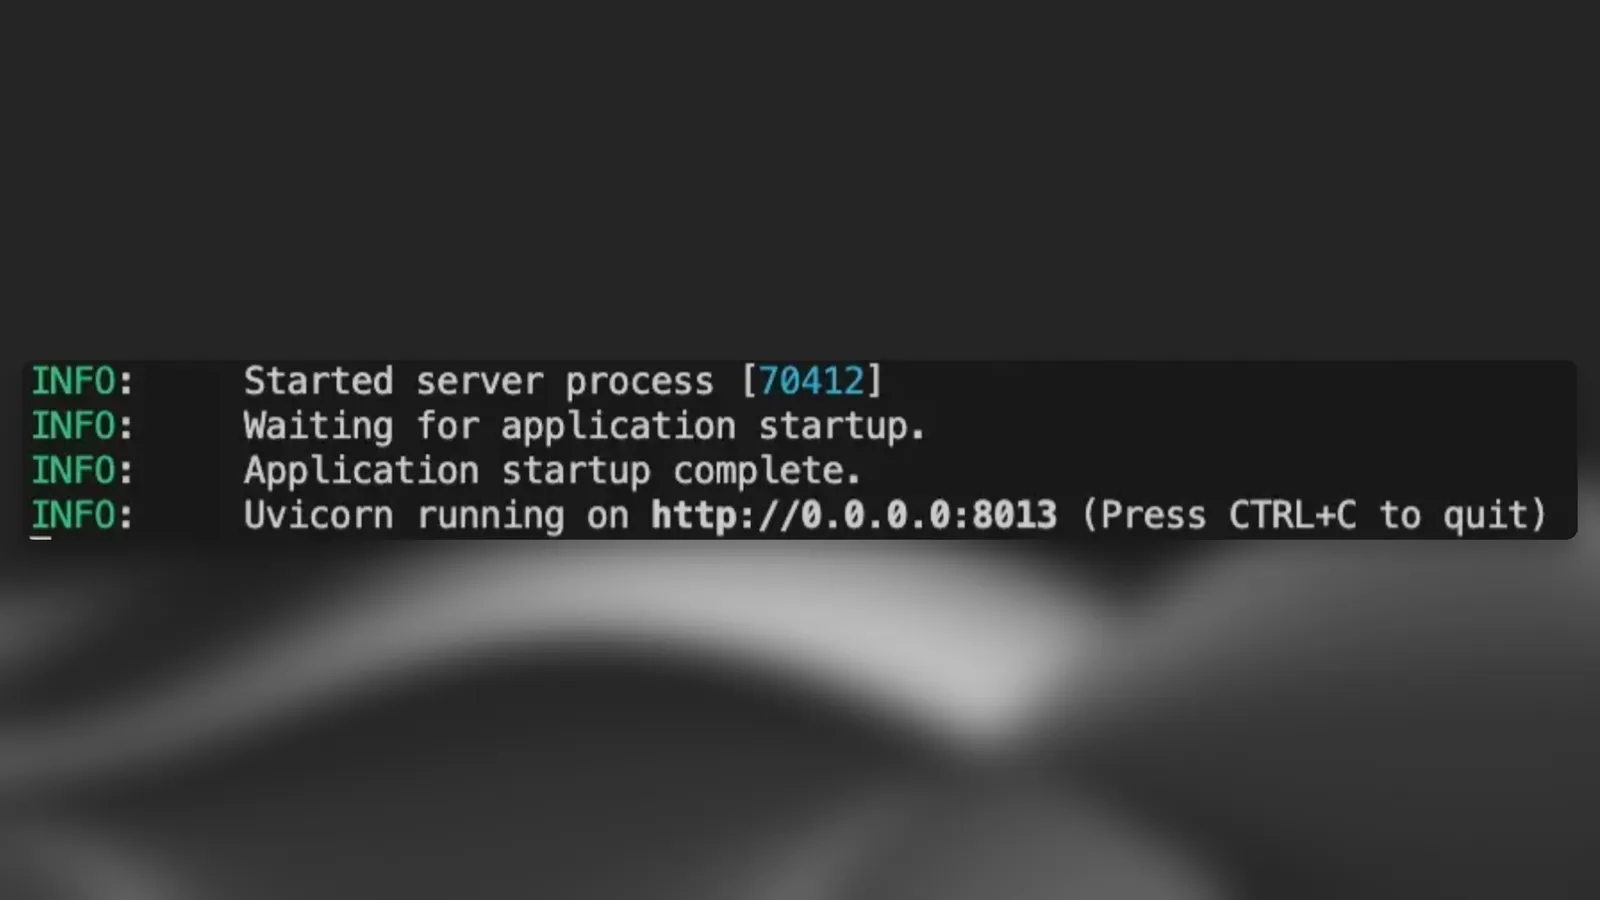
Här är ett exempel på en serverimplementering:
Kör den här koden eller din egen serverkod.
Konfigurera en offentlig URL för din server
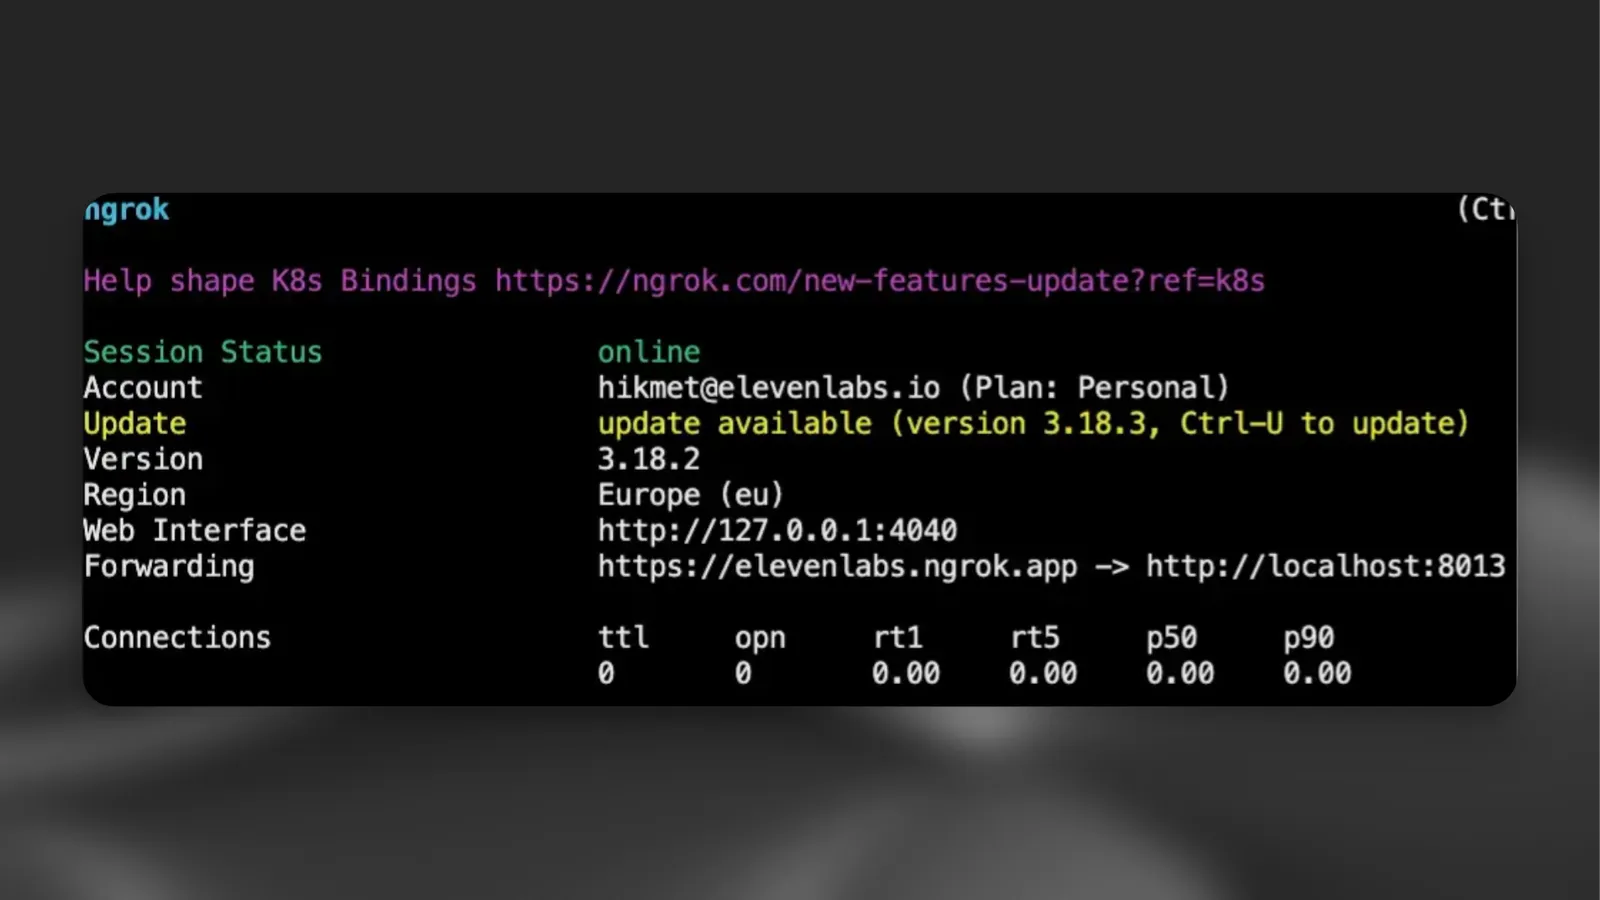
För att göra servern tillgänglig skapar du en offentlig URL med ett tunnlingsverktyg som ngrok:
Konfigurera ElevenLabs CustomLLM
Uppdatera sedan agentinställningarna i ElevenLabs instrumentpanel så att de pekar på din anpassade LLM-server.
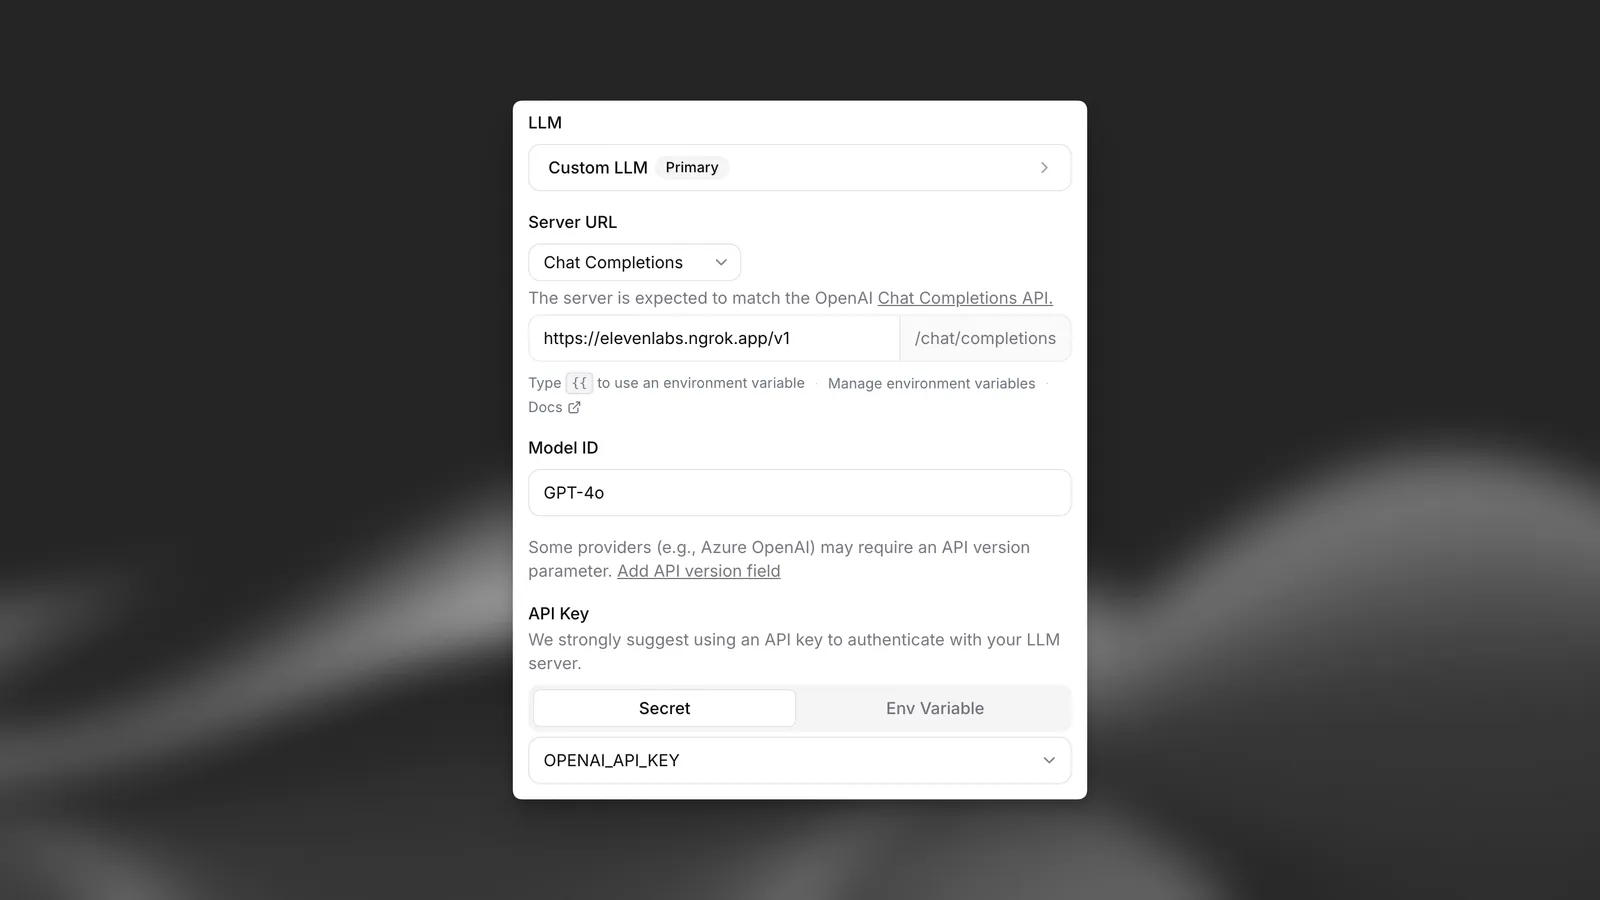
Rikta server-URL:en till ngrok-slutpunkten och ange “Limit token usage” till 5000.
Du kan nu börja interagera med din agent med din egen LLM-server.
Optimera för LLM:er med långsam bearbetning
Om din anpassade LLM har långa bearbetningstider (kanske på grund av agentbaserat resonemang eller krav på förbearbetning) kan du förbättra samtalsflödet genom att använda buffertord i dina streamade svar. Den här tekniken bidrar till att behålla ett naturligt talflyt medan din LLM genererar det fullständiga svaret.
Buffertord
När din LLM behöver mer tid för att bearbeta hela svaret ska du returnera ett första svar som slutar med "... " (tre punkter följt av ett mellanslag). Det gör att Text to Speech-systemet kan behålla ett naturligt flöde och samtidigt få samtalet att kännas dynamiskt.
Det skapar naturliga pauser som flyter väl in i efterföljande innehåll som LLM:en kan resonera längre kring. Det extra mellanslaget är avgörande för att säkerställa att efterföljande innehåll inte läggs till efter ”…”, vilket kan leda till ljudförvrängningar.
Implementering
Så här ändrar du din anpassade LLM-server för att använda buffertord:
Integrering av systemverktyg
Din anpassade LLM kan utlösa systemverktyg för att styra samtalsflöde och tillstånd. Dessa verktyg inkluderas automatiskt i parametern tools för dina begäranden om chat completion när de har konfigurerats i din agent.
Så fungerar systemverktyg
- LLM-beslut: Din anpassade LLM avgör när dessa verktyg ska anropas baserat på samtalskontexten
- Verktygssvar: LLM:en svarar med funktionsanrop i standardformatet för OpenAI
- Bearbetning i backend: ElevenLabs bearbetar verktygsanropen och uppdaterar samtalstillståndet
Mer information om systemverktyg finns i vår guide
Tillgängliga systemverktyg
Avsluta samtal
Syfte: Avsluta samtal automatiskt när lämpliga villkor är uppfyllda.
Utlösande villkor: LLM:en ska anropa det här verktyget när:
- Huvuduppgiften har slutförts och användaren är nöjd
- Samtalet har nått ett naturligt avslut med ömsesidig överenskommelse
- Användaren uttryckligen anger att hen vill avsluta samtalet
Parametrar:
reason(sträng, krävs): Anledningen till att avsluta samtaletmessage(sträng, valfritt): Ett avskedsmeddelande att skicka till användaren innan samtalet avslutas
Format för funktionsanrop:
Implementering: Konfigurera som ett systemverktyg i agentens inställningar. LLM:en får detaljerade instruktioner om när den ska anropa funktionen.
Läs mer: Verktyg för att avsluta samtal
Språkidentifiering
Syfte: Växla automatiskt till användarens identifierade språk under samtal.
Utlösande villkor: LLM:en ska anropa det här verktyget när:
- Användaren talar ett annat språk än det aktuella samtalsspråket
- Användaren uttryckligen ber om att byta språk
- Samtalet behöver stöd för flera språk
Parametrar:
reason(sträng, krävs): Anledningen till språkbytetlanguage(sträng, krävs): Språkkoden att byta till (måste finnas i listan över språk som stöds)
Format för funktionsanrop:
Implementering: Konfigurera språk som stöds i agentens inställningar och lägg till systemverktyget för språkidentifiering. Agenten växlar automatiskt röst och svar för att matcha identifierade språk.
Läs mer: Verktyg för språkidentifiering
Överföring av agent
Syfte: Överför samtal mellan specialiserade AI-agenter baserat på användarens behov.
Utlösande villkor: LLM:en ska anropa det här verktyget när:
- Användarens begäran kräver specialiserad kunskap eller andra agentfunktioner
- Den aktuella agenten inte kan hantera frågan på ett tillräckligt bra sätt
- Samtalsflödet visar att en annan typ av agent behövs
Parametrar:
reason(sträng, valfritt): Anledningen till agentöverföringenagent_number(heltal, krävs): Det nollindexerade numret för agenten som samtalet ska överföras till (baserat på konfigurerade överföringsregler)
Format för funktionsanrop:
Implementering: Definiera överföringsregler som kopplar villkor till specifika agent-ID:n. Konfigurera vilka agenter den aktuella agenten kan överföra till. Agenter refereras med nollindexerade nummer i överföringskonfigurationen.
Läs mer: Verktyg för agentöverföring
Överför till människa
Syfte: Lämna smidigt över samtal till mänskliga operatörer när AI-hjälpen inte räcker till.
Utlösande villkor: LLM:en ska anropa det här verktyget när:
- Komplexa frågor kräver mänskligt omdöme
- Användaren uttryckligen begär mänsklig hjälp
- AI:n når gränserna för vad den kan göra för den specifika begäran
- Eskaleringsprotokoll utlöses
Parametrar:
reason(sträng, valfritt): Anledningen till överföringentransfer_number(sträng, krävs): Telefonnummer att överföra till (måste matcha konfigurerade nummer)client_message(sträng, krävs): Meddelande som läses upp för kunden medan överföringen väntaragent_message(sträng, krävs): Meddelande till den mänskliga operatör som tar emot samtalet
Format för funktionsanrop:
Implementering: Konfigurera telefonnummer och villkor för överföring. Definiera meddelanden för både kunden och den mottagande mänskliga operatören. Fungerar med både Twilio och SIP-trunking.
Läs mer: Verktyg för överföring till människa
Hoppa över tur
Syfte: Låt agenten pausa och vänta på användarens inmatning utan att tala.
Utlösande villkor: LLM:en ska anropa det här verktyget när:
- Användaren anger att hen behöver en stund (“Ge mig en sekund”, “Låt mig tänka”)
- Användaren ber om en paus i samtalsflödet
- Agenten identifierar att användaren behöver tid för att bearbeta information
Parametrar:
reason(sträng, valfritt): Fritt formulerad anledning som förklarar varför pausen behövs
Format för funktionsanrop:
Implementering: Ingen ytterligare konfiguration krävs. Verktyget signalerar helt enkelt till agenten att vara tyst tills användaren talar igen.
Läs mer: Verktyg för att hoppa över tur
Röstbrevlådeidentifiering
Parametrar:
reason(sträng, obligatorisk): Anledningen till att röstbrevlåda identifierades (t.ex. ”automatiskt hälsningsmeddelande identifierat”, ”inget mänskligt svar”)
Format för funktionsanrop:
Exempel på begäran med systemverktyg
När systemverktyg har konfigurerats får din anpassade LLM begäranden som inkluderar verktygen i OpenAIs standardformat:
Din anpassade LLM måste stödja funktionsanrop för att kunna använda systemverktyg. Kontrollera att din modell kan generera korrekta svar på funktionsanrop i OpenAI-format.
Ytterligare funktioner
Anpassade LLM-parametrar
Du kan skicka ytterligare parametrar till din anpassade LLM-implementering.
Python
Exempel på begäran
Med denna konfiguration för anpassade meddelanden får din LLM begäranden i följande format: