

अपना मॉडल इंटीग्रेट करें
अपना मॉडल इंटीग्रेट करें
किसी एजेंट को अपने LLM से कनेक्ट करें या अपना सर्वर होस्ट करें।
Custom LLM आपको बाहरी endpoint के ज़रिए अपनी बातचीत को अपने LLM से कनेक्ट करने देता है। ElevenLabs नेटिव रूप से इंटीग्रेट किए गए LLMs को भी सपोर्ट करता है।
Custom LLMs से आप अपनी OpenAI API key इस्तेमाल कर सकते हैं या पूरी तरह कस्टम LLM सर्वर चला सकते हैं।
परिचय
डिफ़ॉल्ट रूप से, हम OpenAI जैसे लोकप्रिय मॉडलों के लिए अपने आंतरिक क्रेडेंशियल्स इस्तेमाल करते हैं। कस्टम LLM सर्वर इस्तेमाल करने के लिए, उसे नीचे दिए गए OpenAI-compatible request/response structures में से किसी एक के अनुरूप होना चाहिए:
- Chat Completions API (
/v1/chat/completions) - Responses API (
/v1/responses)
Responses API, OpenAI का नया API फ़ॉर्मैट है जो अतिरिक्त सुविधाओं को सपोर्ट करता है। कस्टम LLM इंटीग्रेशन के लिए दोनों API फ़ॉर्मैट पूरी तरह समर्थित हैं।
नीचे दिए गए गाइड दोनों उपयोग मामलों को कवर करते हैं:
- अपनी OpenAI key इस्तेमाल करें: हमारे प्लेटफ़ॉर्म के साथ अपनी OpenAI API key इस्तेमाल करें।
- कस्टम LLM सर्वर: अपना LLM सर्वर implementation होस्ट और कनेक्ट करें।
आप जानेंगे कि कैसे:
- अपनी OpenAI API key को ElevenLabs में स्टोर करें
- ऐसा सर्वर होस्ट करें जो OpenAI के Chat Completions या Responses endpoint की नकल करता हो
- ElevenLabs को अपने कस्टम endpoint पर भेजें
- ज़रूरत के अनुसार अपने LLM को अतिरिक्त parameters भेजें
रीजनिंग सारांश
आपके endpoint को अंतिम उत्तर से अलग रीजनिंग लौटानी होगी। ElevenLabs अंतिम उत्तर से रीजनिंग जनरेट नहीं करता।
समर्थित endpoint से रीजनिंग मांगने के लिए, एजेंट की LLM सेटिंग्स में Reasoning summary चालू करें या API के ज़रिए enable_reasoning_summary सेट करें।
रीजनिंग लौटाएं
अपने endpoint से मेल खाने वाला फ़ॉर्मैट इस्तेमाल करें:
Chat Completions API
Responses API
हर response delta के reasoning या reasoning_content फ़ील्ड में रीजनिंग स्ट्रीम करें।
Gemini-compatible endpoints के लिए, ElevenLabs
google.thinking_config.include_thoughts के साथ thoughts मांगता है और
extra_content.google.thought से चिह्नित कंटेंट पढ़ता है।
स्टोरेज, डिलीवरी और सीमाओं के लिए रीजनिंग सारांश देखें।
अपनी OpenAI key इस्तेमाल करना
कस्टम OpenAI key इंटीग्रेट करने के लिए, ElevenLabs डैशबोर्ड में अपने एजेंट की सेटिंग्स को अपने कस्टम LLM सर्वर पर पॉइंट करने के लिए अपडेट करें और अपनी OPENAI_API_KEY वाला एक सीक्रेट बनाएं:
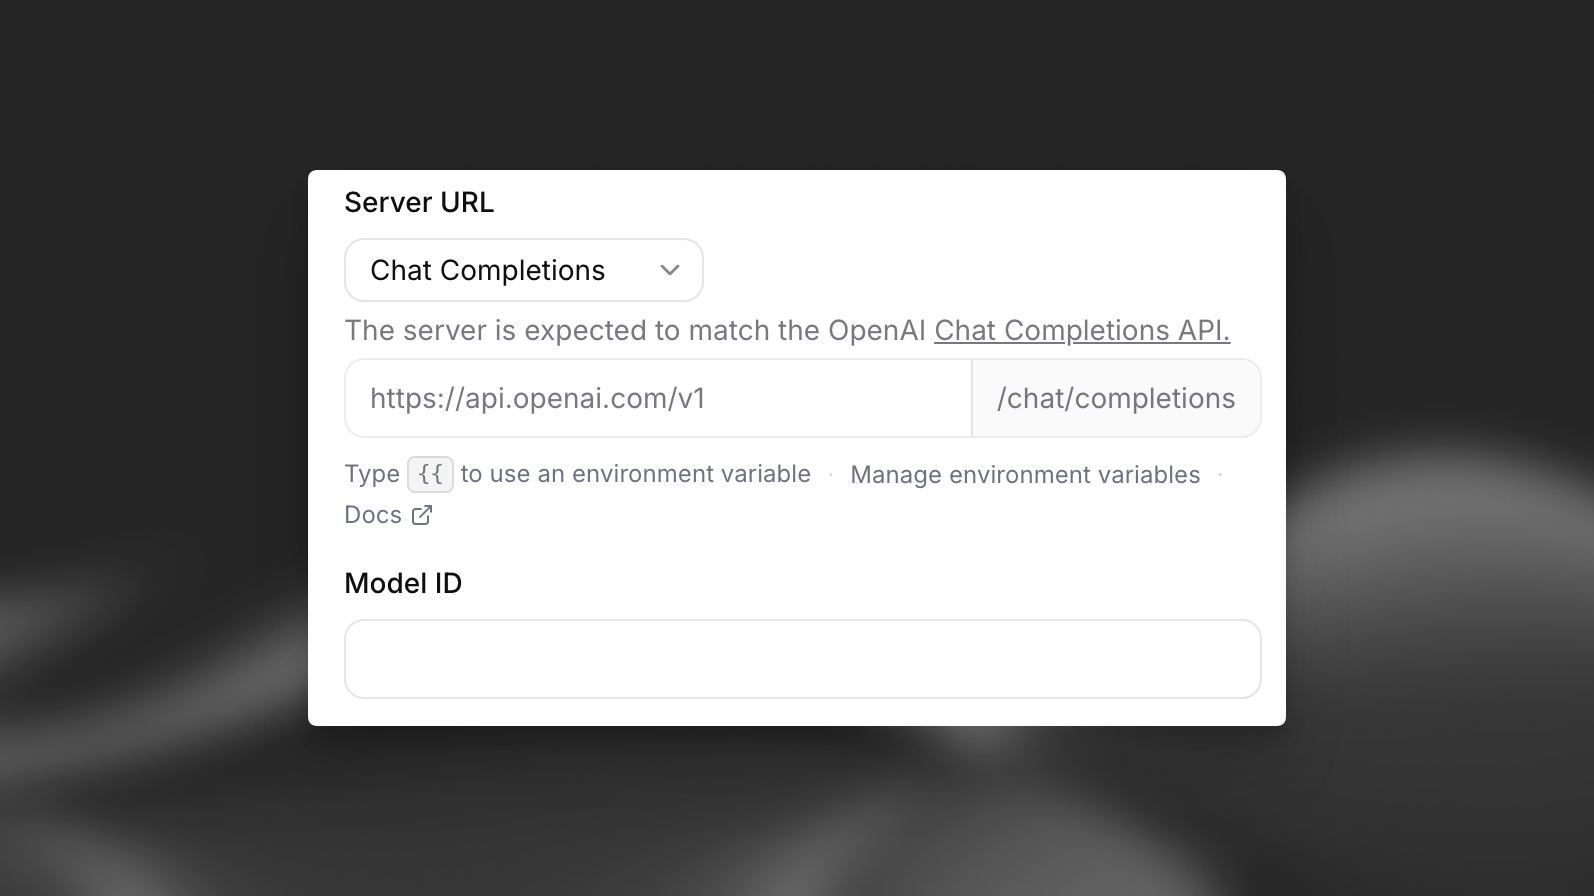
ElevenLabs डैशबोर्ड में अपनी Agent settings में, दाईं ओर “LLM” ड्रॉपडाउन मेनू से “Custom LLM” चुनें।
कस्टम LLM सर्वर
कस्टम LLM सर्वर लाने के लिए, OpenAI की शैली का इस्तेमाल करके एक compatible server endpoint सेट अप करें। आप Chat Completions API (/v1/chat/completions) या Responses API (/v1/responses) में से कोई भी implement कर सकते हैं।
दोनों endpoints को Content-Type: text/event-stream के साथ SSE (Server-Sent Events) फ़ॉर्मैट में responses लौटाने होंगे।
Chat Completions API
Responses API
Chat Completions API, /v1/chat/completions endpoint इस्तेमाल करता है।
हर chunk का फ़ॉर्मैट data: {json}\n\n होना चाहिए और stream का अंत data: [DONE]\n\n से होना चाहिए।
यहां एक उदाहरण server implementation दिया गया है:
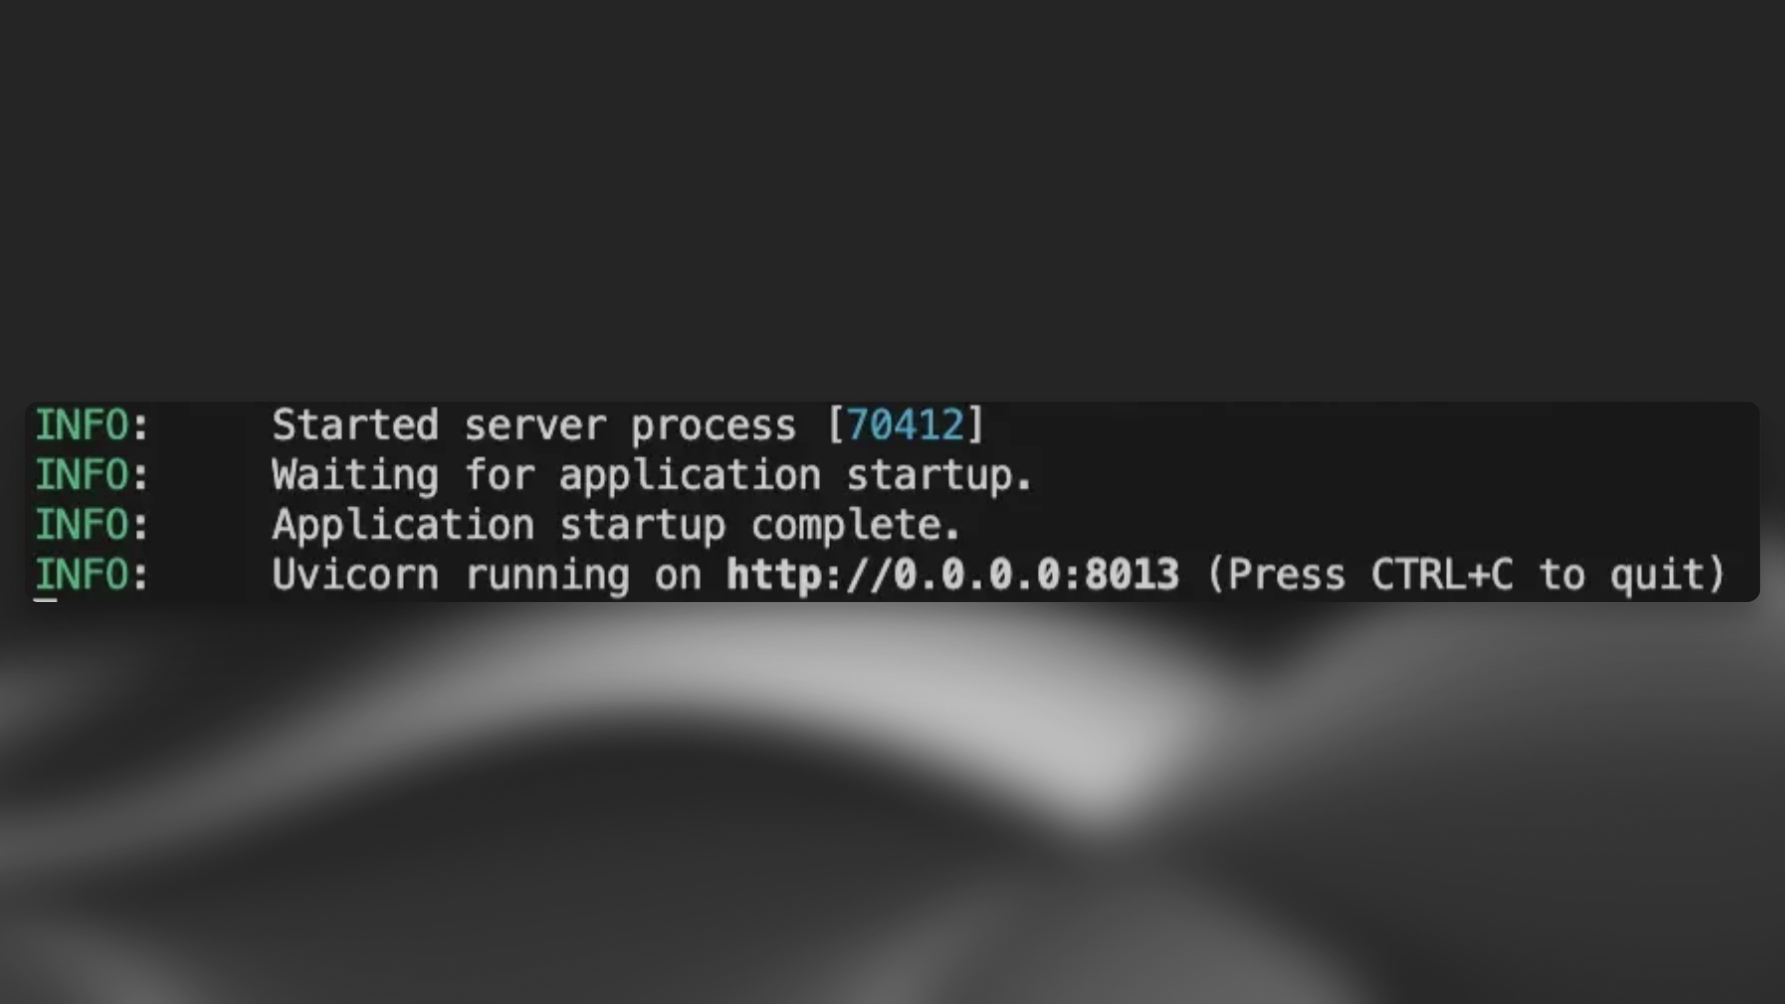
यह कोड या अपना सर्वर कोड चलाएं।
अपने सर्वर के लिए सार्वजनिक URL सेट करना
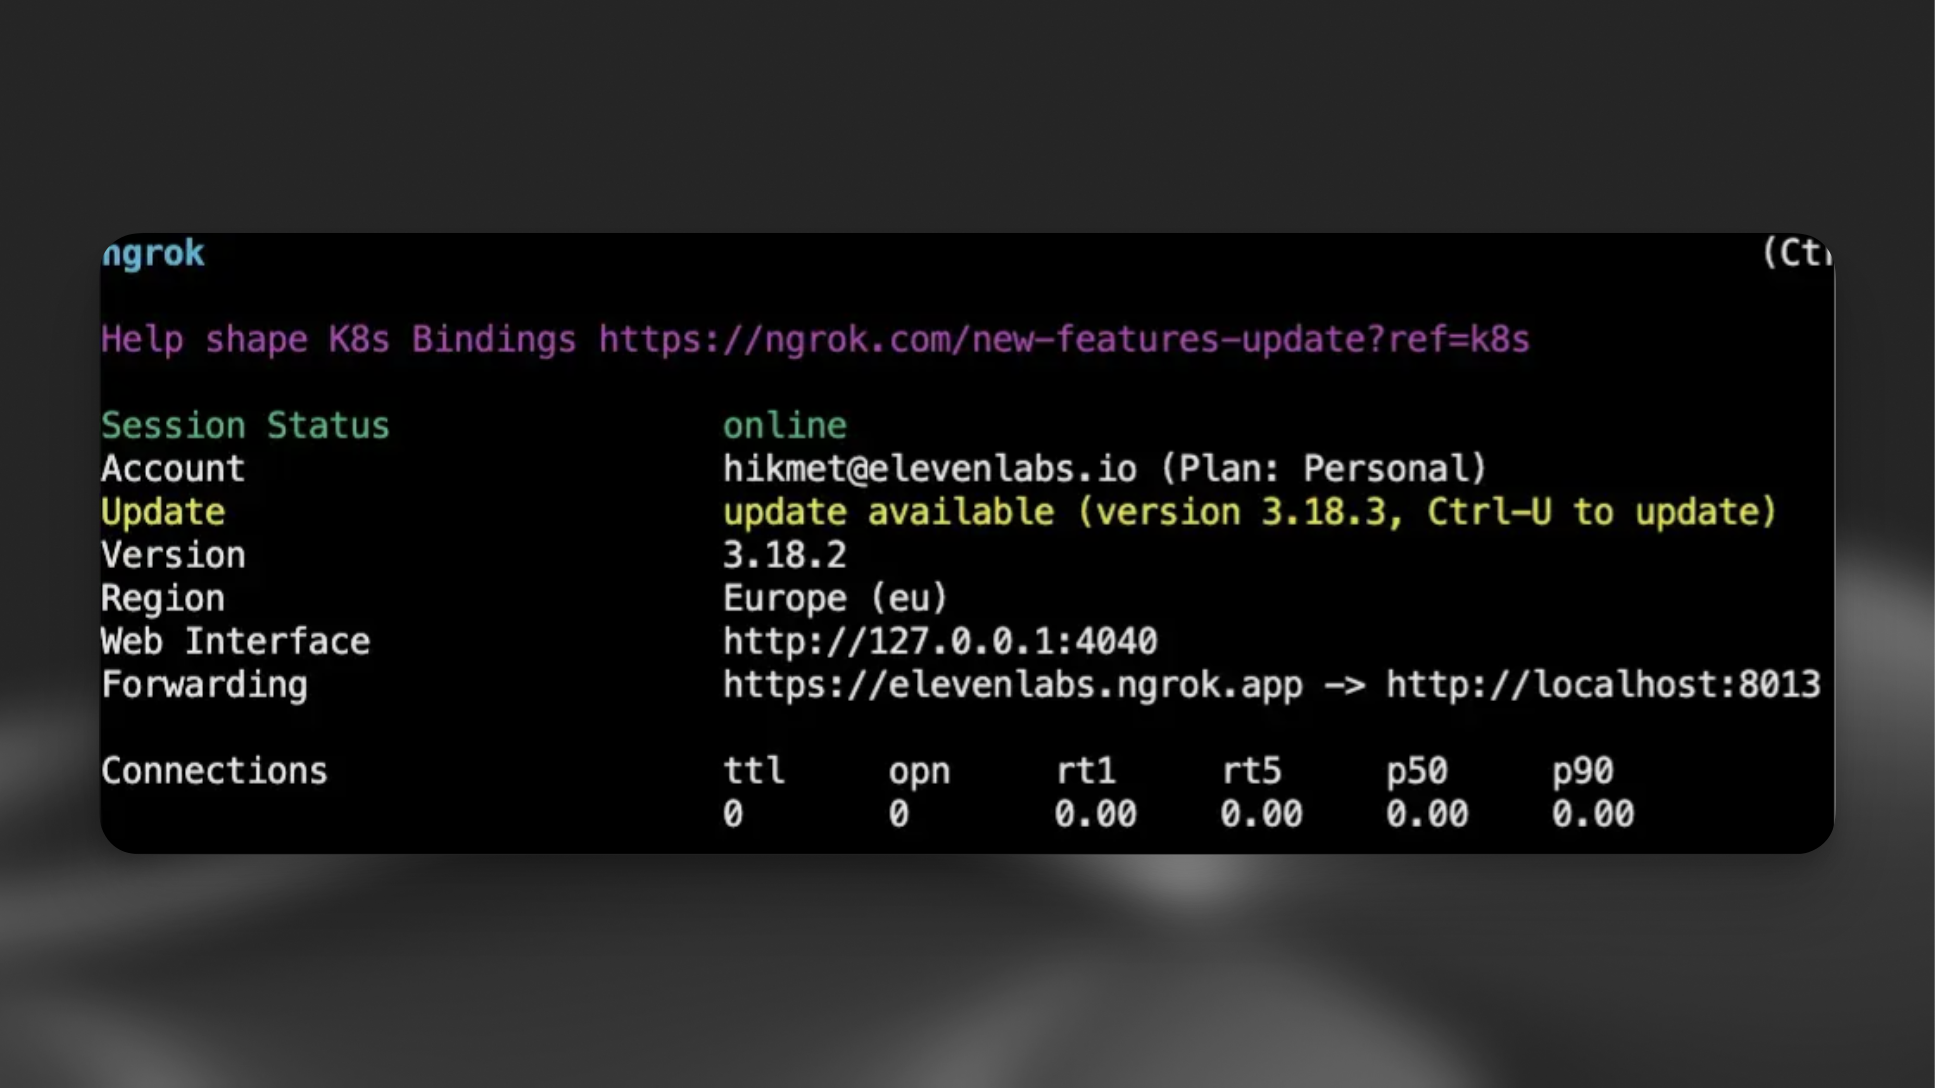
अपने सर्वर को एक्सेस करने योग्य बनाने के लिए, ngrok जैसे tunneling tool से सार्वजनिक URL बनाएं:
ElevenLabs CustomLLM कॉन्फ़िगर करना
अब ElevenLabs डैशबोर्ड में अपने एजेंट की सेटिंग्स को अपने कस्टम LLM सर्वर पर पॉइंट करने के लिए अपडेट करें।
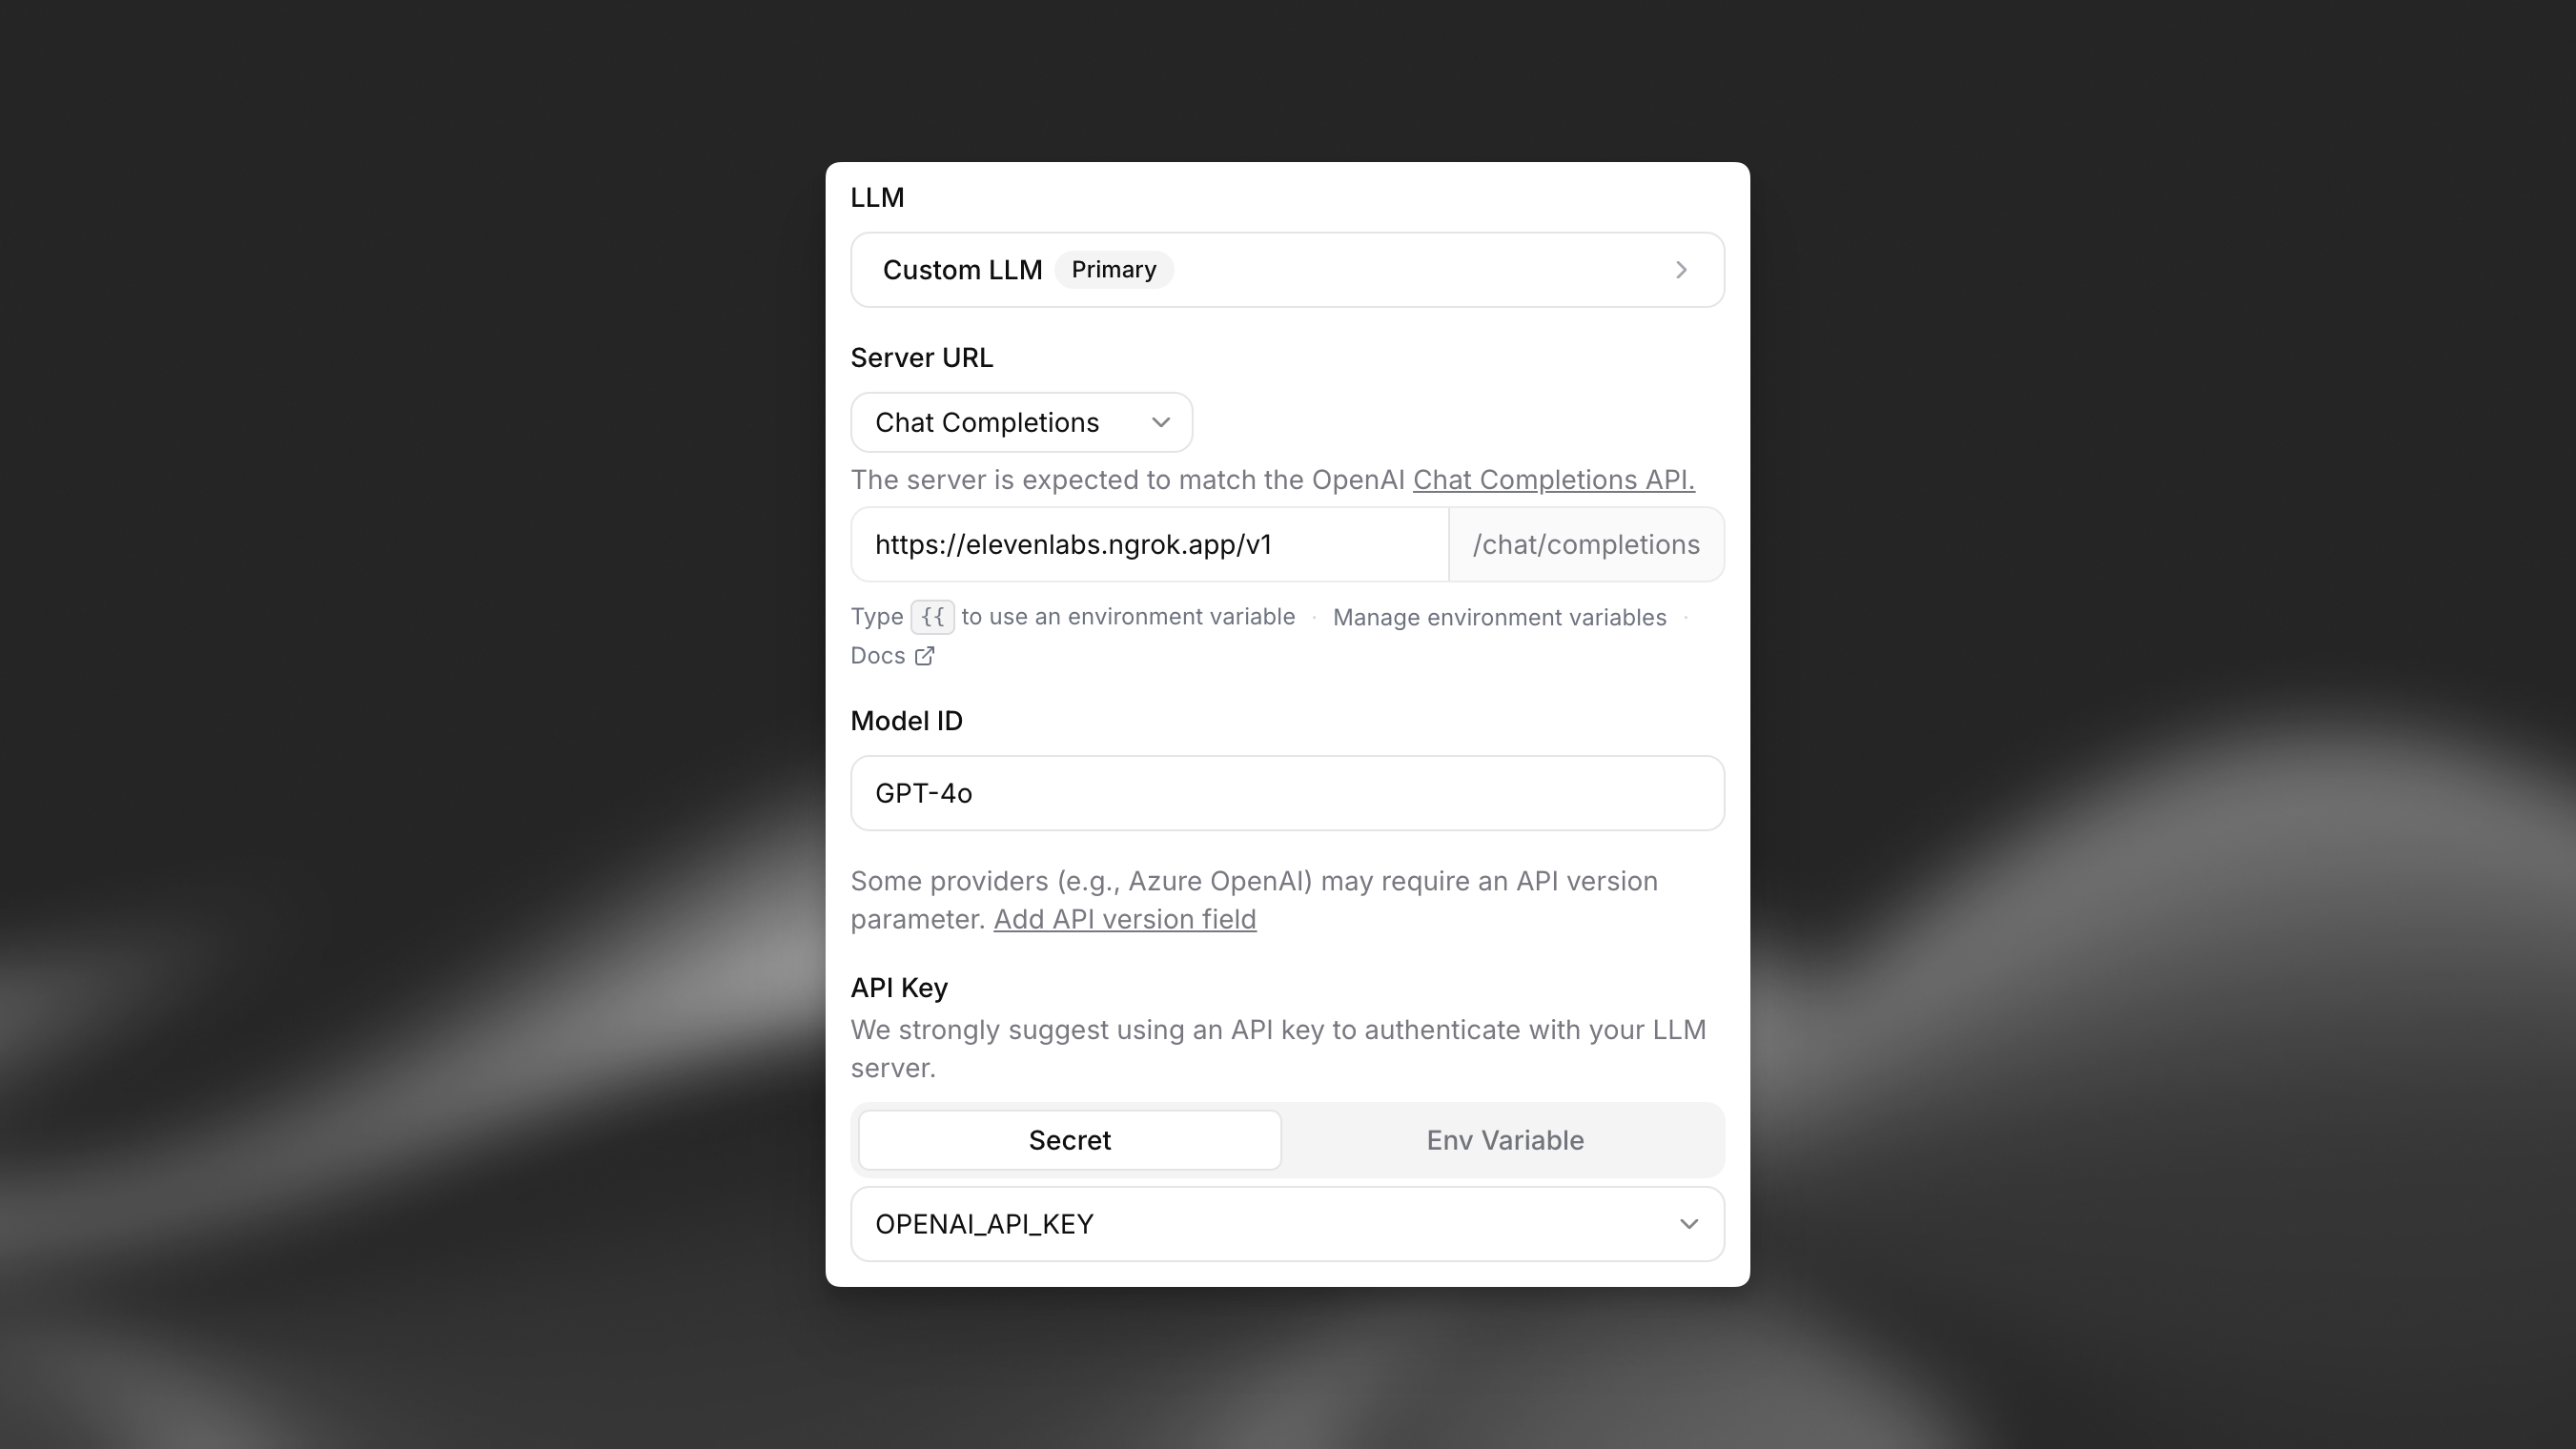
अपने server URL को ngrok endpoint पर सेट करें और “Limit token usage” को 5000 पर सेट करें।
अब आप अपने LLM सर्वर के साथ एजेंट से इंटरैक्ट करना शुरू कर सकते हैं।
धीमी प्रोसेसिंग वाले LLM के लिए ऑप्टिमाइज़ करना
अगर आपके कस्टम LLM का प्रोसेसिंग समय धीमा है (शायद एजेंटिक रीजनिंग या प्री-प्रोसेसिंग की ज़रूरतों के कारण), तो आप अपने स्ट्रीमिंग रिस्पॉन्स में बफ़र शब्द लागू करके बातचीत के प्रवाह को बेहतर बना सकते हैं। यह तकनीक आपके LLM के पूरा रिस्पॉन्स जनरेट करने के दौरान बोलने की प्राकृतिक लय बनाए रखने में मदद करती है।
बफ़र शब्द
जब आपके LLM को पूरा रिस्पॉन्स प्रोसेस करने के लिए ज़्यादा समय चाहिए हो, तो "... " (एलिप्सिस के बाद एक स्पेस) पर खत्म होने वाला शुरुआती रिस्पॉन्स लौटाएं। इससे टेक्स्ट टू स्पीच सिस्टम बातचीत को सहज और सक्रिय रखते हुए प्राकृतिक प्रवाह बनाए रख पाता है।
इससे ऐसे प्राकृतिक विराम बनते हैं, जो बाद के उस कॉन्टेंट में सहजता से जुड़ते हैं जिस पर LLM ज़्यादा देर तक विचार कर सकता है। अतिरिक्त स्पेस ज़रूरी है, ताकि बाद का कॉन्टेंट "..." से न जुड़ जाए, क्योंकि इससे ऑडियो में विकृति आ सकती है।
इम्प्लीमेंटेशन
बफ़र शब्द लागू करने के लिए अपने कस्टम LLM सर्वर को इस तरह बदलें:
सिस्टम टूल्स इंटीग्रेशन
आपका कस्टम LLM बातचीत के प्रवाह और स्थिति को नियंत्रित करने के लिए सिस्टम टूल्स ट्रिगर कर सकता है। आपके एजेंट में कॉन्फ़िगर होने पर ये टूल्स आपके चैट कंप्लीशन अनुरोधों के tools पैरामीटर में अपने-आप शामिल हो जाते हैं।
सिस्टम टूल्स कैसे काम करते हैं
- LLM का निर्णय: आपका कस्टम LLM बातचीत के संदर्भ के आधार पर तय करता है कि इन टूल्स को कब कॉल करना है
- टूल रिस्पॉन्स: LLM स्टैंडर्ड OpenAI फ़ॉर्मेट में फ़ंक्शन कॉल के साथ रिस्पॉन्ड करता है
- बैकएंड प्रोसेसिंग: ElevenLabs टूल कॉल्स को प्रोसेस करता है और बातचीत की स्थिति अपडेट करता है
सिस्टम टूल्स के बारे में ज़्यादा जानकारी के लिए, हमारी गाइड देखें
उपलब्ध सिस्टम टूल्स
कॉल समाप्त करें
उद्देश्य: उचित स्थितियां पूरी होने पर बातचीत को अपने-आप समाप्त करना।
ट्रिगर की स्थितियां: LLM को इस टूल को कॉल करना चाहिए जब:
- मुख्य काम पूरा हो गया हो और यूज़र संतुष्ट हो
- आपसी सहमति से बातचीत अपने स्वाभाविक निष्कर्ष पर पहुंच गई हो
- यूज़र साफ़ तौर पर बातचीत समाप्त करने की इच्छा जताए
पैरामीटर:
reason(string, आवश्यक): कॉल समाप्त करने का कारणmessage(string, वैकल्पिक): कॉल समाप्त करने से पहले यूज़र को भेजने के लिए विदाई संदेश
फ़ंक्शन कॉल फ़ॉर्मेट:
इम्प्लीमेंटेशन: अपने एजेंट की सेटिंग्स में सिस्टम टूल के रूप में कॉन्फ़िगर करें। LLM को इस फ़ंक्शन को कॉल करने के समय के बारे में विस्तृत निर्देश मिलेंगे।
और जानें: कॉल समाप्त करने का टूल
भाषा पहचान
उद्देश्य: बातचीत के दौरान यूज़र की पहचानी गई भाषा पर अपने-आप स्विच करना।
ट्रिगर की स्थितियां: LLM को इस टूल को कॉल करना चाहिए जब:
- यूज़र मौजूदा बातचीत की भाषा से अलग भाषा में बोलता हो
- यूज़र साफ़ तौर पर भाषा बदलने का अनुरोध करे
- बातचीत के लिए कई भाषाओं के सपोर्ट की ज़रूरत हो
पैरामीटर:
reason(string, आवश्यक): भाषा बदलने का कारणlanguage(string, आवश्यक): जिस भाषा को स्विच करना है उसका भाषा कोड (समर्थित भाषाओं की सूची में होना चाहिए)
फ़ंक्शन कॉल फ़ॉर्मेट:
इम्प्लीमेंटेशन: एजेंट की सेटिंग्स में समर्थित भाषाएं कॉन्फ़िगर करें और भाषा पहचान सिस्टम टूल जोड़ें। एजेंट पहचानी गई भाषाओं के अनुसार वॉइस और रिस्पॉन्स अपने-आप बदल देगा।
और जानें: भाषा पहचान टूल
एजेंट ट्रांसफ़र
उद्देश्य: यूज़र की ज़रूरतों के आधार पर विशेषज्ञ AI एजेंट्स के बीच बातचीत ट्रांसफ़र करना।
ट्रिगर की स्थितियां: LLM को इस टूल को कॉल करना चाहिए जब:
- यूज़र के अनुरोध के लिए विशेषज्ञ जानकारी या अलग एजेंट क्षमताओं की ज़रूरत हो
- मौजूदा एजेंट क्वेरी को पर्याप्त रूप से संभाल न सके
- बातचीत का प्रवाह किसी दूसरे तरह के एजेंट की ज़रूरत दिखाए
पैरामीटर:
reason(string, वैकल्पिक): एजेंट ट्रांसफ़र का कारणagent_number(integer, आवश्यक): जिस एजेंट को ट्रांसफ़र करना है उसका शून्य से शुरू होने वाला नंबर (कॉन्फ़िगर किए गए ट्रांसफ़र नियमों के आधार पर)
फ़ंक्शन कॉल फ़ॉर्मेट:
इम्प्लीमेंटेशन: स्थितियों को खास एजेंट ID से मैप करने वाले ट्रांसफ़र नियम तय करें। कॉन्फ़िगर करें कि मौजूदा एजेंट किन एजेंट्स को ट्रांसफ़र कर सकता है। ट्रांसफ़र कॉन्फ़िगरेशन में एजेंट्स को शून्य से शुरू होने वाले नंबरों से संदर्भित किया जाता है।
और जानें: एजेंट ट्रांसफ़र टूल
मानव को ट्रांसफ़र करें
उद्देश्य: जब AI सहायता पर्याप्त न हो, तो बातचीत को सहजता से मानव ऑपरेटर को सौंपना।
ट्रिगर की स्थितियां: LLM को इस टूल को कॉल करना चाहिए जब:
- जटिल समस्याओं के लिए मानवीय निर्णय की ज़रूरत हो
- यूज़र साफ़ तौर पर मानव सहायता मांगे
- खास अनुरोध के लिए AI अपनी क्षमताओं की सीमा तक पहुंच जाए
- एस्केलेशन प्रोटोकॉल ट्रिगर हो जाएं
पैरामीटर:
reason(string, वैकल्पिक): ट्रांसफ़र का कारणtransfer_number(string, आवश्यक): जिस फ़ोन नंबर पर ट्रांसफ़र करना है (कॉन्फ़िगर किए गए नंबरों से मेल खाना चाहिए)client_message(string, आवश्यक): ट्रांसफ़र की प्रतीक्षा के दौरान क्लाइंट को पढ़कर सुनाया जाने वाला संदेशagent_message(string, आवश्यक): कॉल रिसीव करने वाले मानव ऑपरेटर के लिए संदेश
फ़ंक्शन कॉल फ़ॉर्मेट:
इम्प्लीमेंटेशन: ट्रांसफ़र फ़ोन नंबर और स्थितियां कॉन्फ़िगर करें। ग्राहक और कॉल रिसीव करने वाले मानव ऑपरेटर, दोनों के लिए संदेश तय करें। यह Twilio और SIP ट्रंकिंग, दोनों के साथ काम करता है।
और जानें: मानव को ट्रांसफ़र करने का टूल
टर्न छोड़ें
उद्देश्य: एजेंट को बिना बोले रुकने और यूज़र के इनपुट की प्रतीक्षा करने देना।
ट्रिगर की स्थितियां: LLM को इस टूल को कॉल करना चाहिए जब:
- यूज़र संकेत दे कि उसे एक पल चाहिए (“Give me a second”, “Let me think”)
- यूज़र बातचीत के प्रवाह में विराम का अनुरोध करे
- एजेंट को पता चले कि यूज़र को जानकारी समझने के लिए समय चाहिए
पैरामीटर:
reason(string, वैकल्पिक): विराम की ज़रूरत का कारण बताने वाला मुक्त-रूप कारण
फ़ंक्शन कॉल फ़ॉर्मेट:
इम्प्लीमेंटेशन: किसी अतिरिक्त कॉन्फ़िगरेशन की ज़रूरत नहीं है। यह टूल एजेंट को केवल तब तक चुप रहने का संकेत देता है, जब तक यूज़र दोबारा न बोले।
और जानें: टर्न छोड़ने का टूल
वॉइसमेल पहचान
Parameters:
reason(string, आवश्यक): voicemail detect होने का कारण (जैसे, “automated greeting detected”, “no human response”)
Function call format:
और जानें: वॉइसमेल पहचान टूल
सिस्टम टूल्स के साथ उदाहरण अनुरोध
सिस्टम टूल्स कॉन्फ़िगर होने पर, आपके कस्टम LLM को ऐसे अनुरोध मिलेंगे जिनमें स्टैंडर्ड OpenAI फ़ॉर्मेट में टूल्स शामिल होते हैं:
सिस्टम टूल्स का इस्तेमाल करने के लिए आपके कस्टम LLM को फ़ंक्शन कॉलिंग सपोर्ट करनी चाहिए। सुनिश्चित करें कि आपका मॉडल OpenAI फ़ॉर्मेट में सही फ़ंक्शन कॉल रिस्पॉन्स जनरेट कर सकता है।
अतिरिक्त सुविधाएं
कस्टम LLM पैरामीटर
आप अपने कस्टम LLM इम्प्लीमेंटेशन में अतिरिक्त पैरामीटर पास कर सकते हैं।