

एजेंट टेस्टिंग
एजेंट टेस्टिंग
ऑटोमेटेड टेस्टिंग से अपने एजेंट के व्यवहार पर भरोसा बनाएं
एजेंट टेस्टिंग से आप डिप्लॉय करने से पहले कन्वर्सेशनल जवाबों, टूल के इस्तेमाल और पूरे मल्टी-टर्न नतीजों की पुष्टि कर सकते हैं। टेस्ट शुरू से बनाएं या मौजूदा बातचीत से बनाएं, फिर उन्हें डैशबोर्ड, CLI या API से चलाएं।
वीडियो वॉकथ्रू
ओवरव्यू
फ़्रेमवर्क में तीन पूरक टेस्ट प्रकार शामिल हैं:
- सिमुलेशन टेस्टिंग — सिम्युलेट किए गए यूज़र के साथ एंड-टू-एंड, मल्टी-टर्न बातचीत चलाती है
- नेक्स्ट रिप्लाई (सिनेरियो) टेस्टिंग — सफलता के मानदंडों के आधार पर एजेंट के अगले जवाब की पुष्टि करती है
- टूल कॉल टेस्टिंग — यह सुनिश्चित करती है कि एजेंट सही पैरामीटर के साथ सही टूल कॉल करे
किस टेस्ट का इस्तेमाल कब करें
बातचीत से टेस्ट बनाना
जब आपको कोई ऐसा इंटरैक्शन मिले जिसमें एजेंट का प्रदर्शन अच्छा नहीं था, तो असली बातचीत को टेस्ट केस में बदलें।
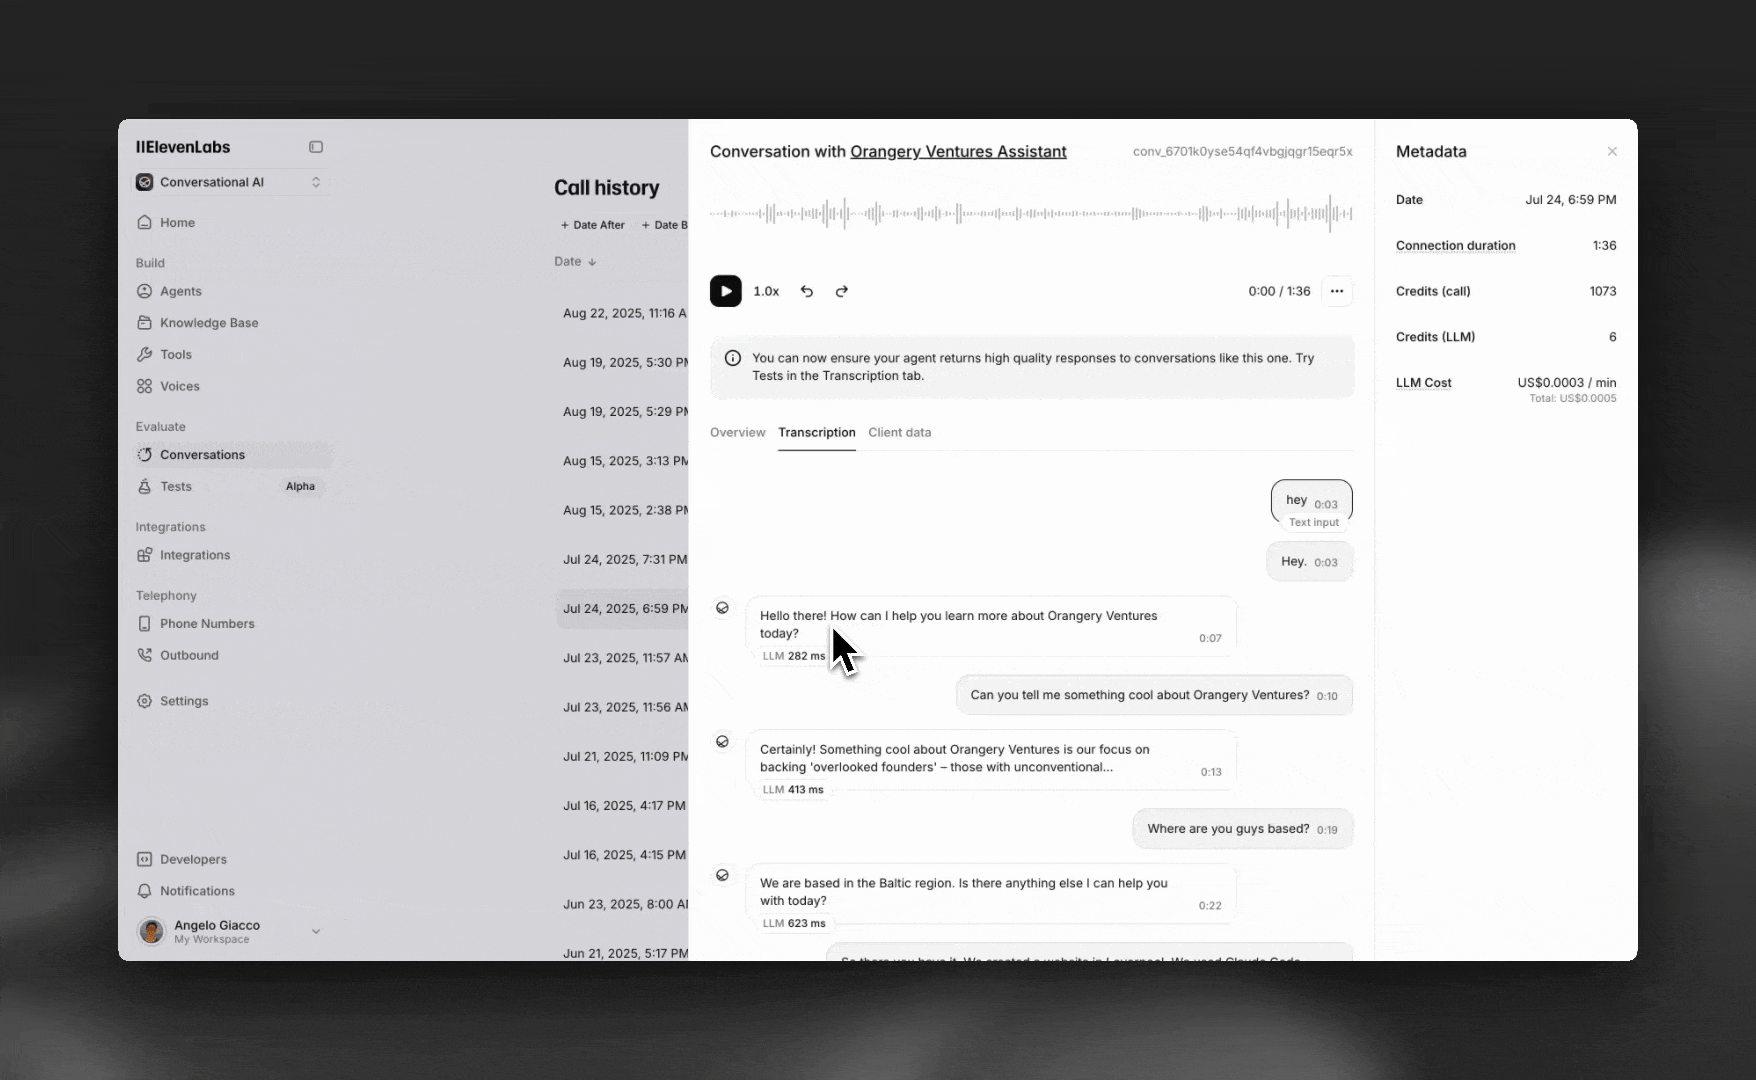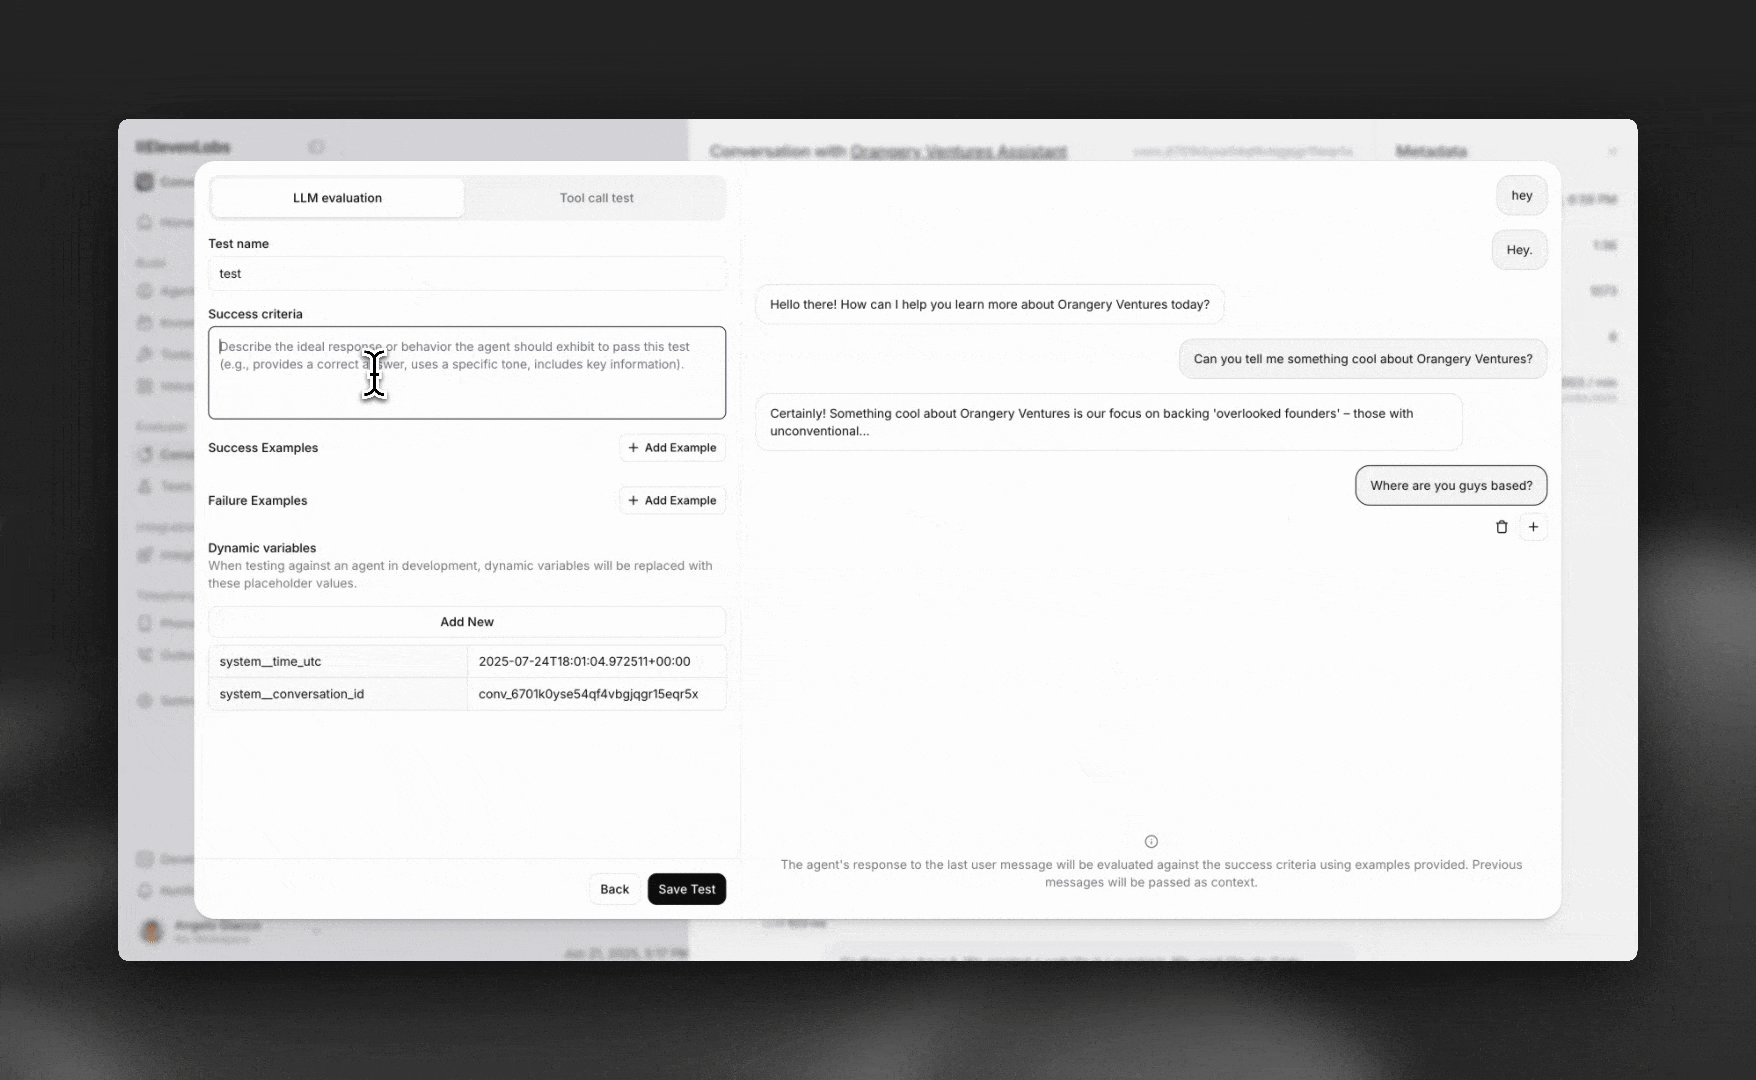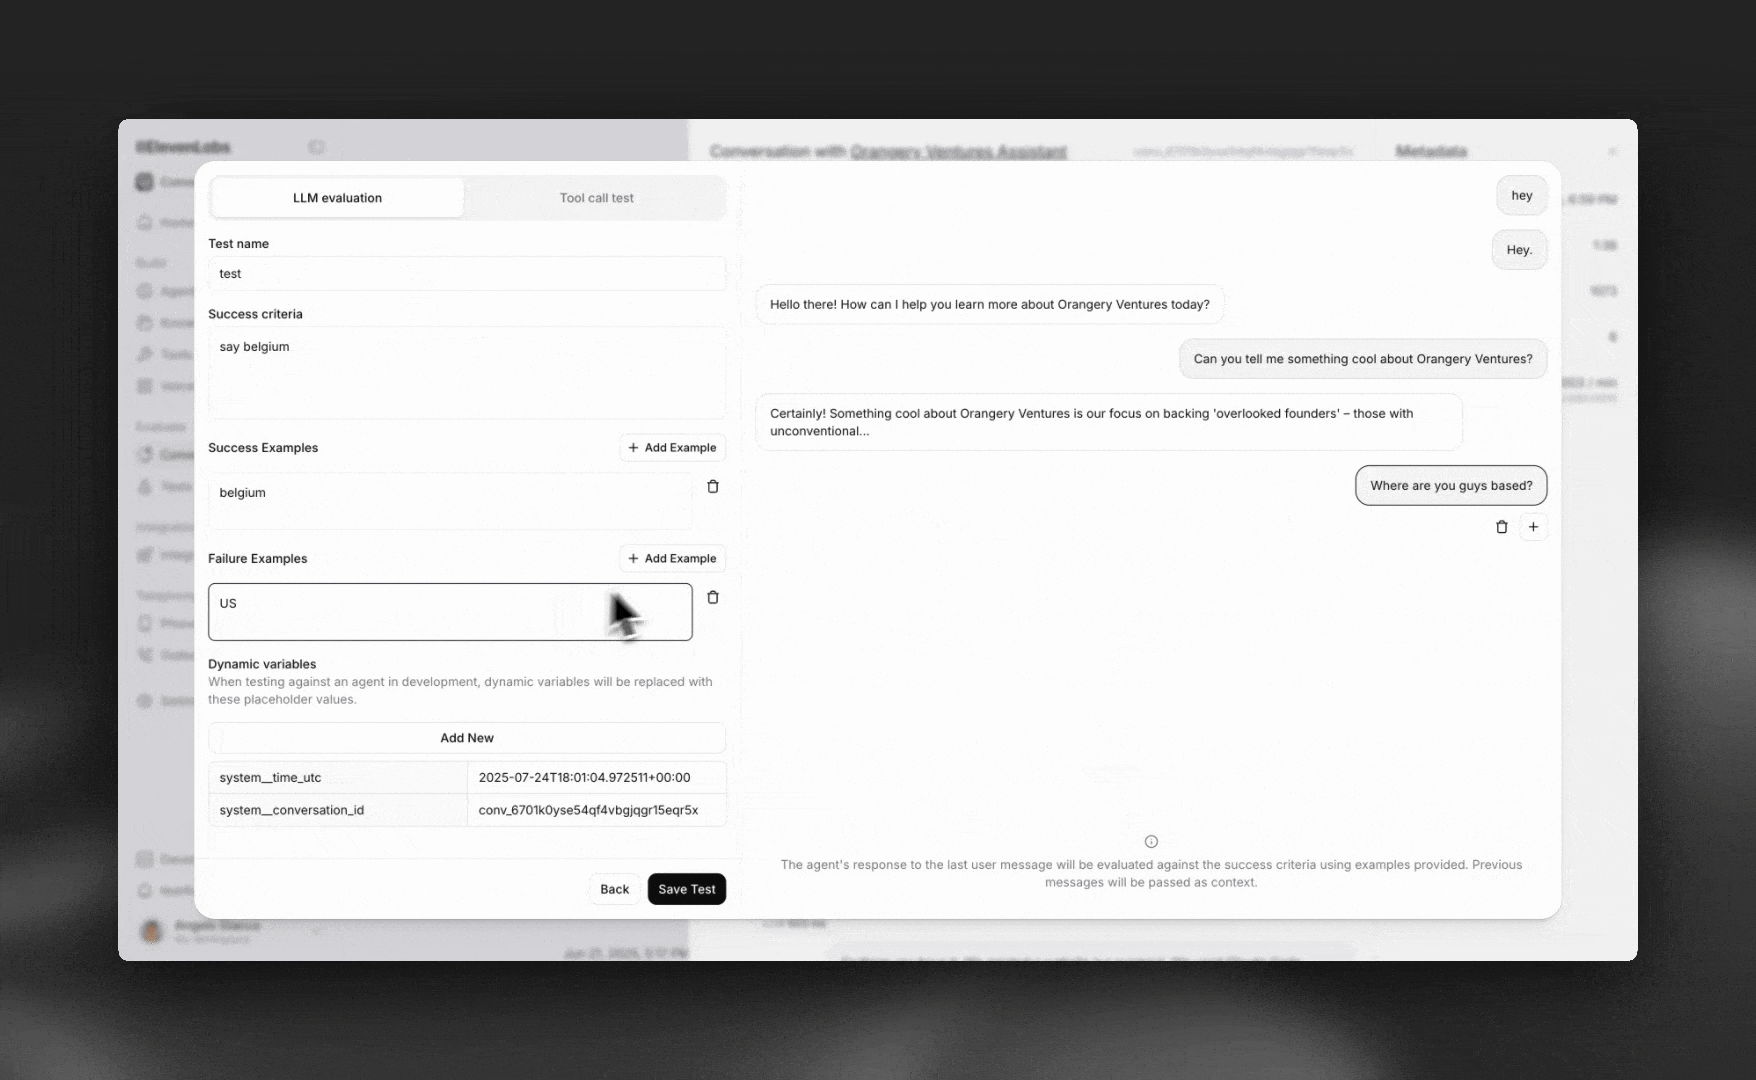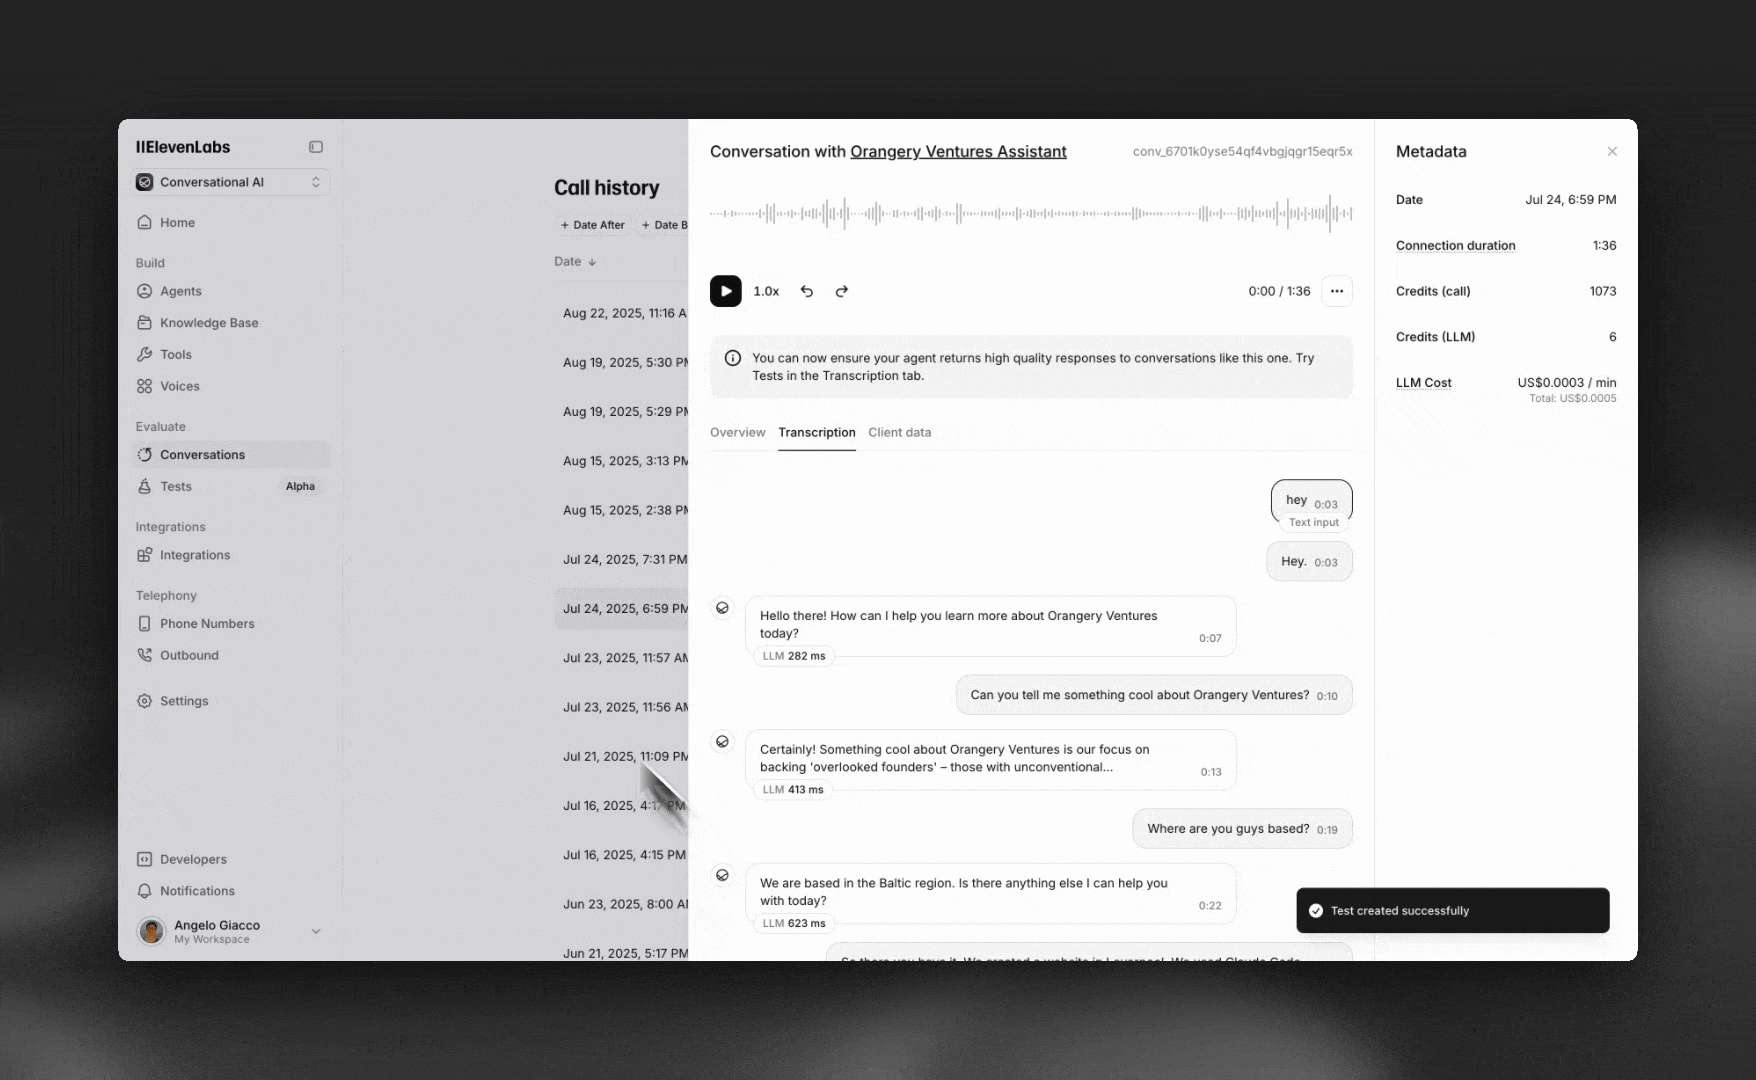
- कॉल हिस्ट्री में बातचीत खोलें
- इस बातचीत से टेस्ट बनाएं पर क्लिक करें
- पहले से भरे कॉन्टेक्स्ट को देखें, फिर अपेक्षित व्यवहार तय करें
- बाद में ऐसी ही विफलताएं पकड़ने के लिए टेस्ट को अपने सुइट में जोड़ें
सिमुलेशन टेस्टिंग
सिमुलेशन टेस्टिंग सिम्युलेट किए गए AI यूज़र के साथ पूरी, मल्टी-टर्न बातचीत में आपके एजेंट का मूल्यांकन करती है। नेक्स्ट रिप्लाई टेस्ट के विपरीत, यह प्रकार जांचता है कि पूरा इंटरैक्शन आपके तय नतीजे तक पहुंचता है या नहीं।
सिमुलेशन टेस्ट बनाना
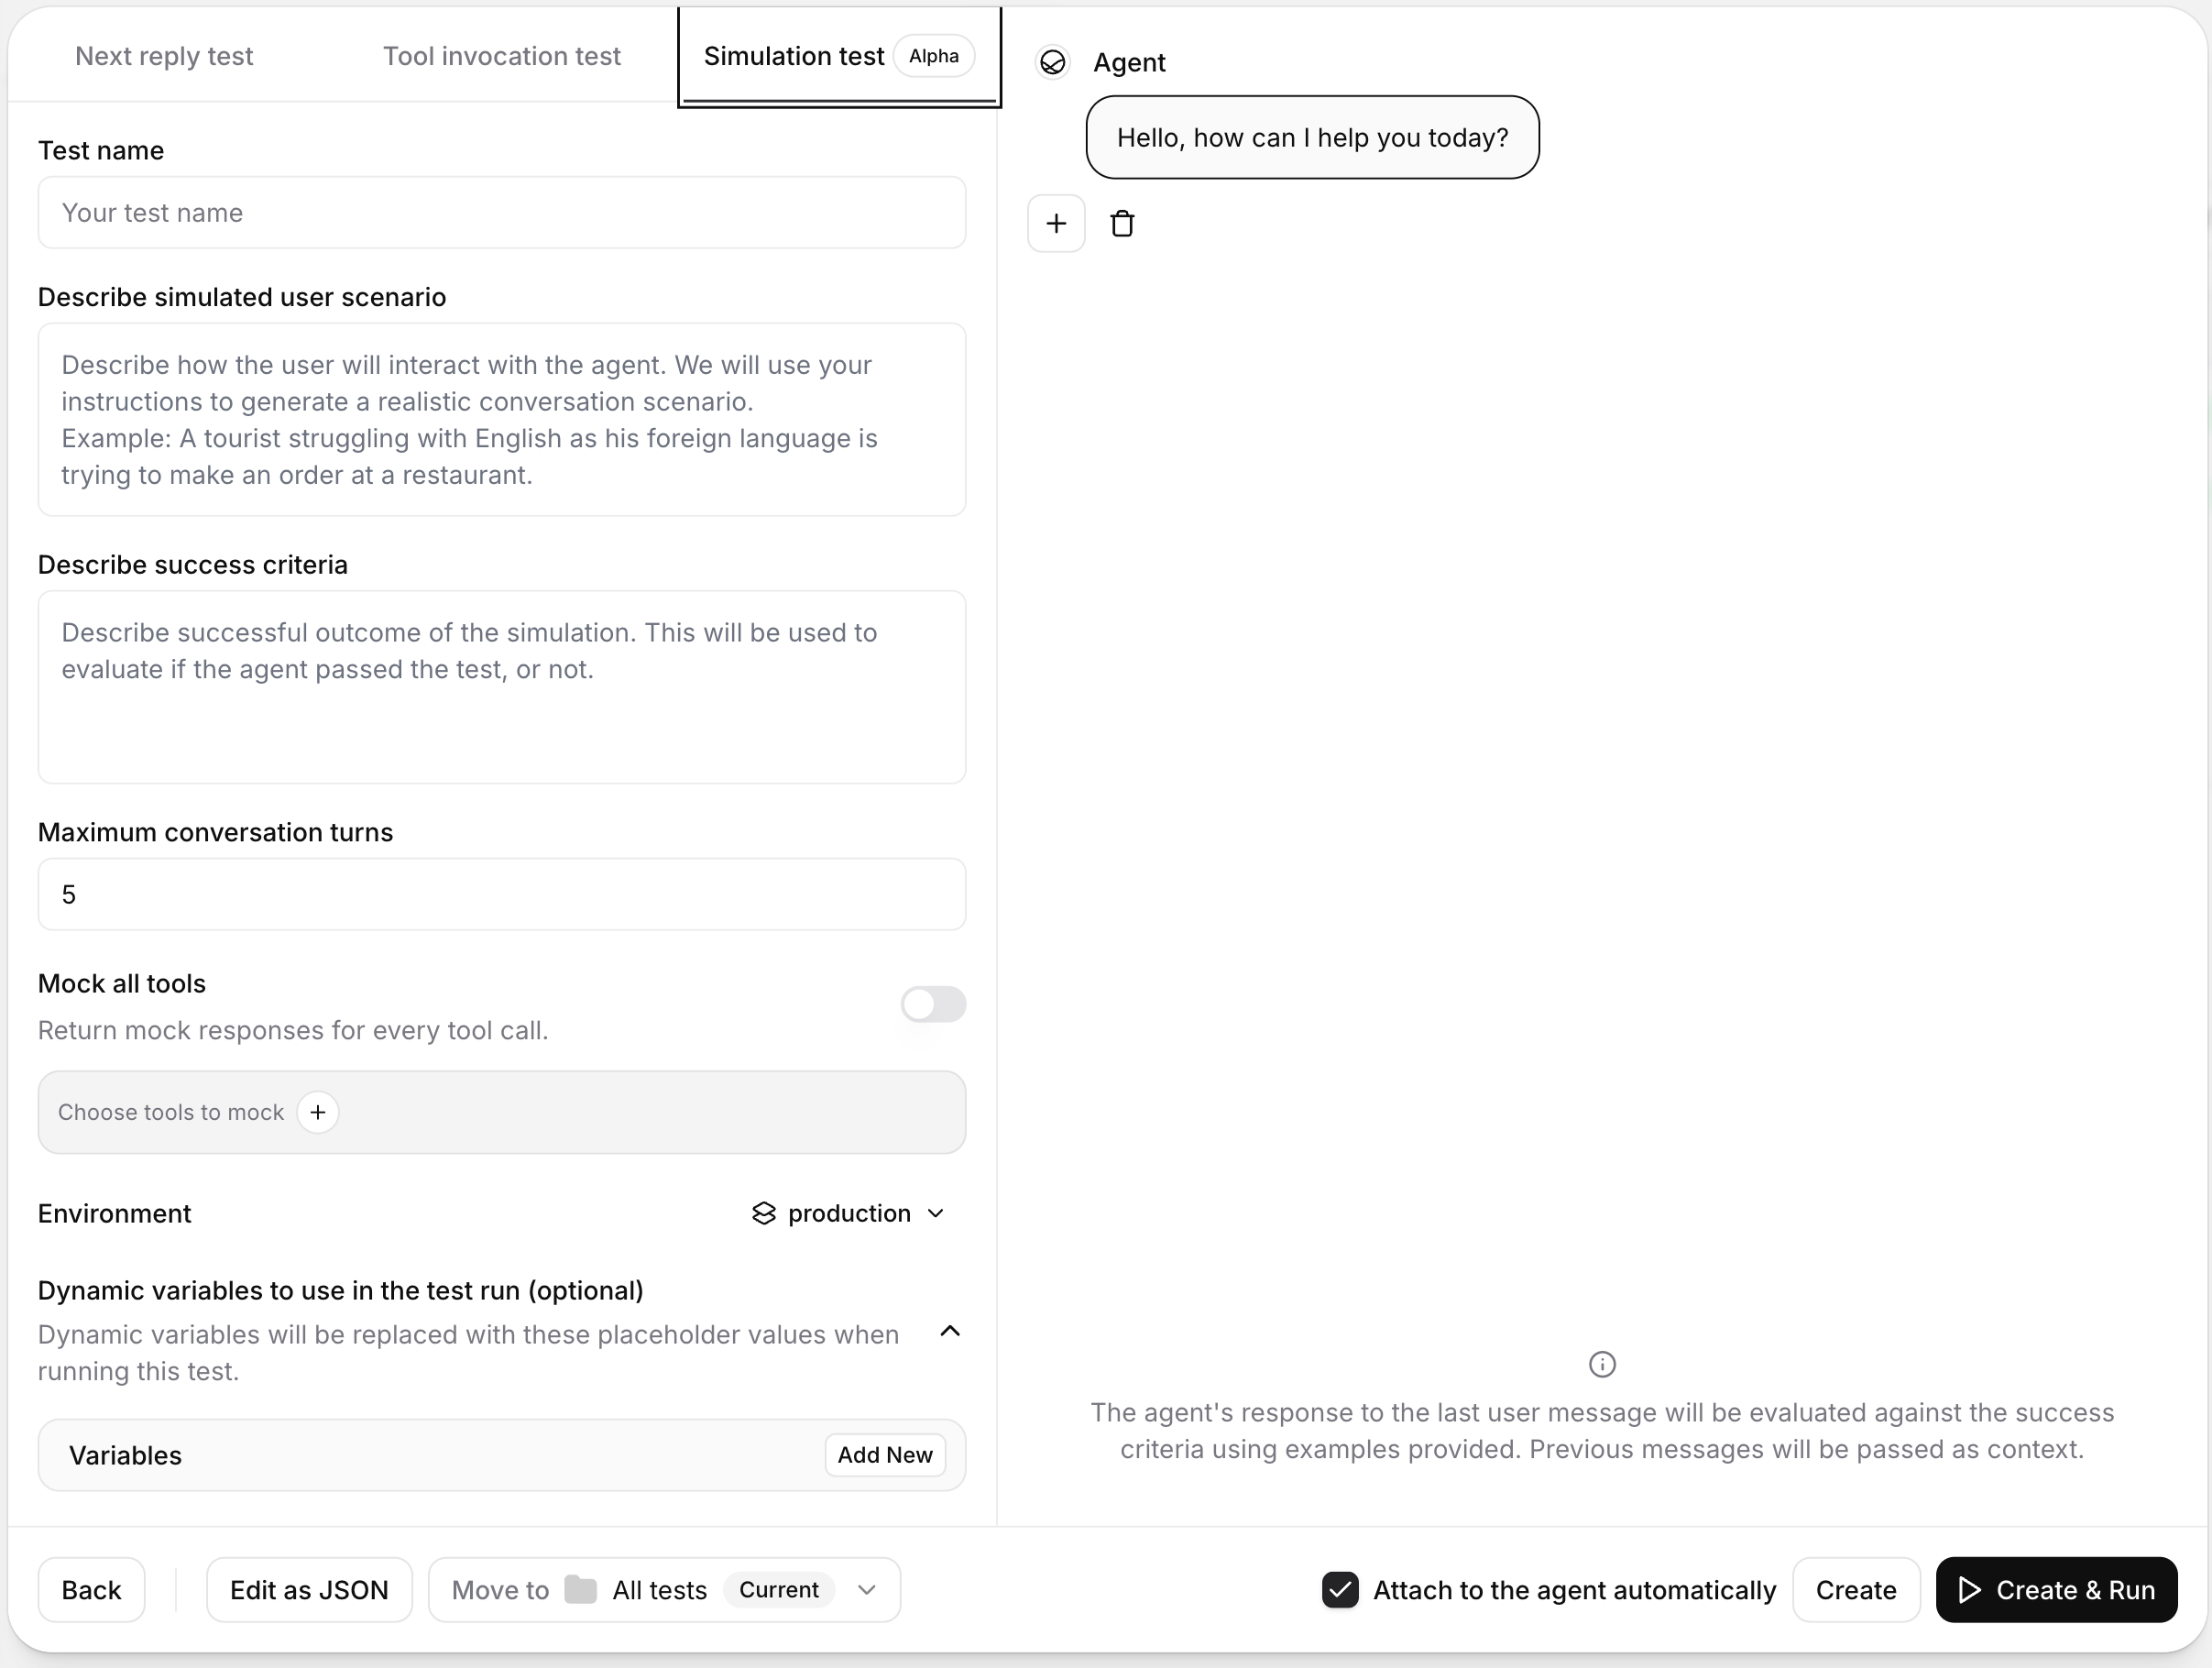
सिनेरियो तय करें
यूज़र के कॉन्टेक्स्ट, इरादे और व्यवहार को सामान्य भाषा में बताएं। सिम्युलेटर बातचीत को आगे बढ़ाने के लिए इस सिनेरियो का इस्तेमाल करता है।
उदाहरण सिनेरियो:
“एक पर्यटक जो अंग्रेज़ी में धाराप्रवाह नहीं है, रेस्तरां में ऑर्डर देने की कोशिश कर रहा है।”
सफलता की शर्त तय करें
वह नतीजा तय करें जिसे पास माना जाना चाहिए। इस प्रॉम्प्ट का इस्तेमाल यह जांचने के लिए होता है कि पूरी बातचीत सफल रही या नहीं।
उदाहरण सफलता शर्त:
“एजेंट ने ऑर्डर की जानकारी की पुष्टि की, स्पष्टीकरण वाले सवालों को संभाला और बिना किसी गलतफहमी के ऑर्डर पूरा किया।”
वैकल्पिक कॉन्फ़िगरेशन
आप टेस्ट कॉन्फ़िगरेशन पैनल में सिमुलेशन के व्यवहार को बेहतर बना सकते हैं:
- एनवायरनमेंट: जब आपके एजेंट के लिए कई एनवायरनमेंट कॉन्फ़िगर हों, तो चुनें कि किस एनवायरनमेंट पर टेस्ट करना है। अगर सिर्फ़ एक एनवायरनमेंट उपलब्ध है, तो यह सेलेक्टर छिपा रहेगा।
- चैट हिस्ट्री: खाली स्थिति के बजाय आंशिक बातचीत से शुरू करें। यह जारी बातचीत और रिकवरी व्यवहार की टेस्टिंग के लिए उपयोगी है।
- डायनामिक वेरिएबल्स: बेस एजेंट कॉन्फ़िगरेशन बदले बिना अपने एजेंट वेरिएबल्स में टेस्ट-विशिष्ट वैल्यू (जैसे यूज़र नाम या ऑर्डर ID) डालें।
टूल मॉकिंग
सिमुलेशन टेस्ट टूल मॉकिंग को सपोर्ट करते हैं, ताकि आपका एजेंट लाइव सिस्टम को कॉल करने के बजाय रन के दौरान नियंत्रित जवाब पा सके।
मॉकिंग रणनीति
- किसी को मॉक न करें: कोई टूल मॉक नहीं किया जाता।
- सभी टूल मॉक करें: हर मॉक किए जा सकने वाले टूल से मॉक जवाब मिलता है।
- चुने गए टूल मॉक करें: सिर्फ़ आपके चुने हुए टूल मॉक किए जाते हैं।
सिस्टम टूल और वर्कफ़्लो टूल कभी मॉक नहीं किए जाते।
फ़ॉलबैक व्यवहार
अगर मॉक किए गए टूल को कॉल किया जाता है और उससे मेल खाता कोई मॉक जवाब नहीं मिलता, तो इनमें से एक व्यवहार चुनें:
- असल टूल कॉल करें: असल टूल कॉल चलाता है।
- एरर के साथ समाप्त करें: असल टूल को कॉल करने के बजाय टूल से एरर जवाब लौटाता है।
फ़ॉलबैक सेटिंग तभी दिखती है जब कम से कम एक टूल मॉक किया गया हो।
नेक्स्ट रिप्लाई (सिनेरियो) टेस्टिंग
नेक्स्ट रिप्लाई (सिनेरियो) टेस्टिंग सिर्फ़ एजेंट के अगले मैसेज का मूल्यांकन करती है, पूरी मल्टी-टर्न बातचीत के नतीजे का नहीं। उस जवाब तक पहुंचने वाली बातचीत की हिस्ट्री दें जिसका आप मूल्यांकन करना चाहते हैं, फिर सफलता के मानदंडों के आधार पर उस जवाब को स्कोर करें।
पूरे मल्टी-टर्न नतीजों के लिए सिमुलेशन टेस्टिंग का इस्तेमाल करें।
नेक्स्ट रिप्लाई टेस्ट बनाना
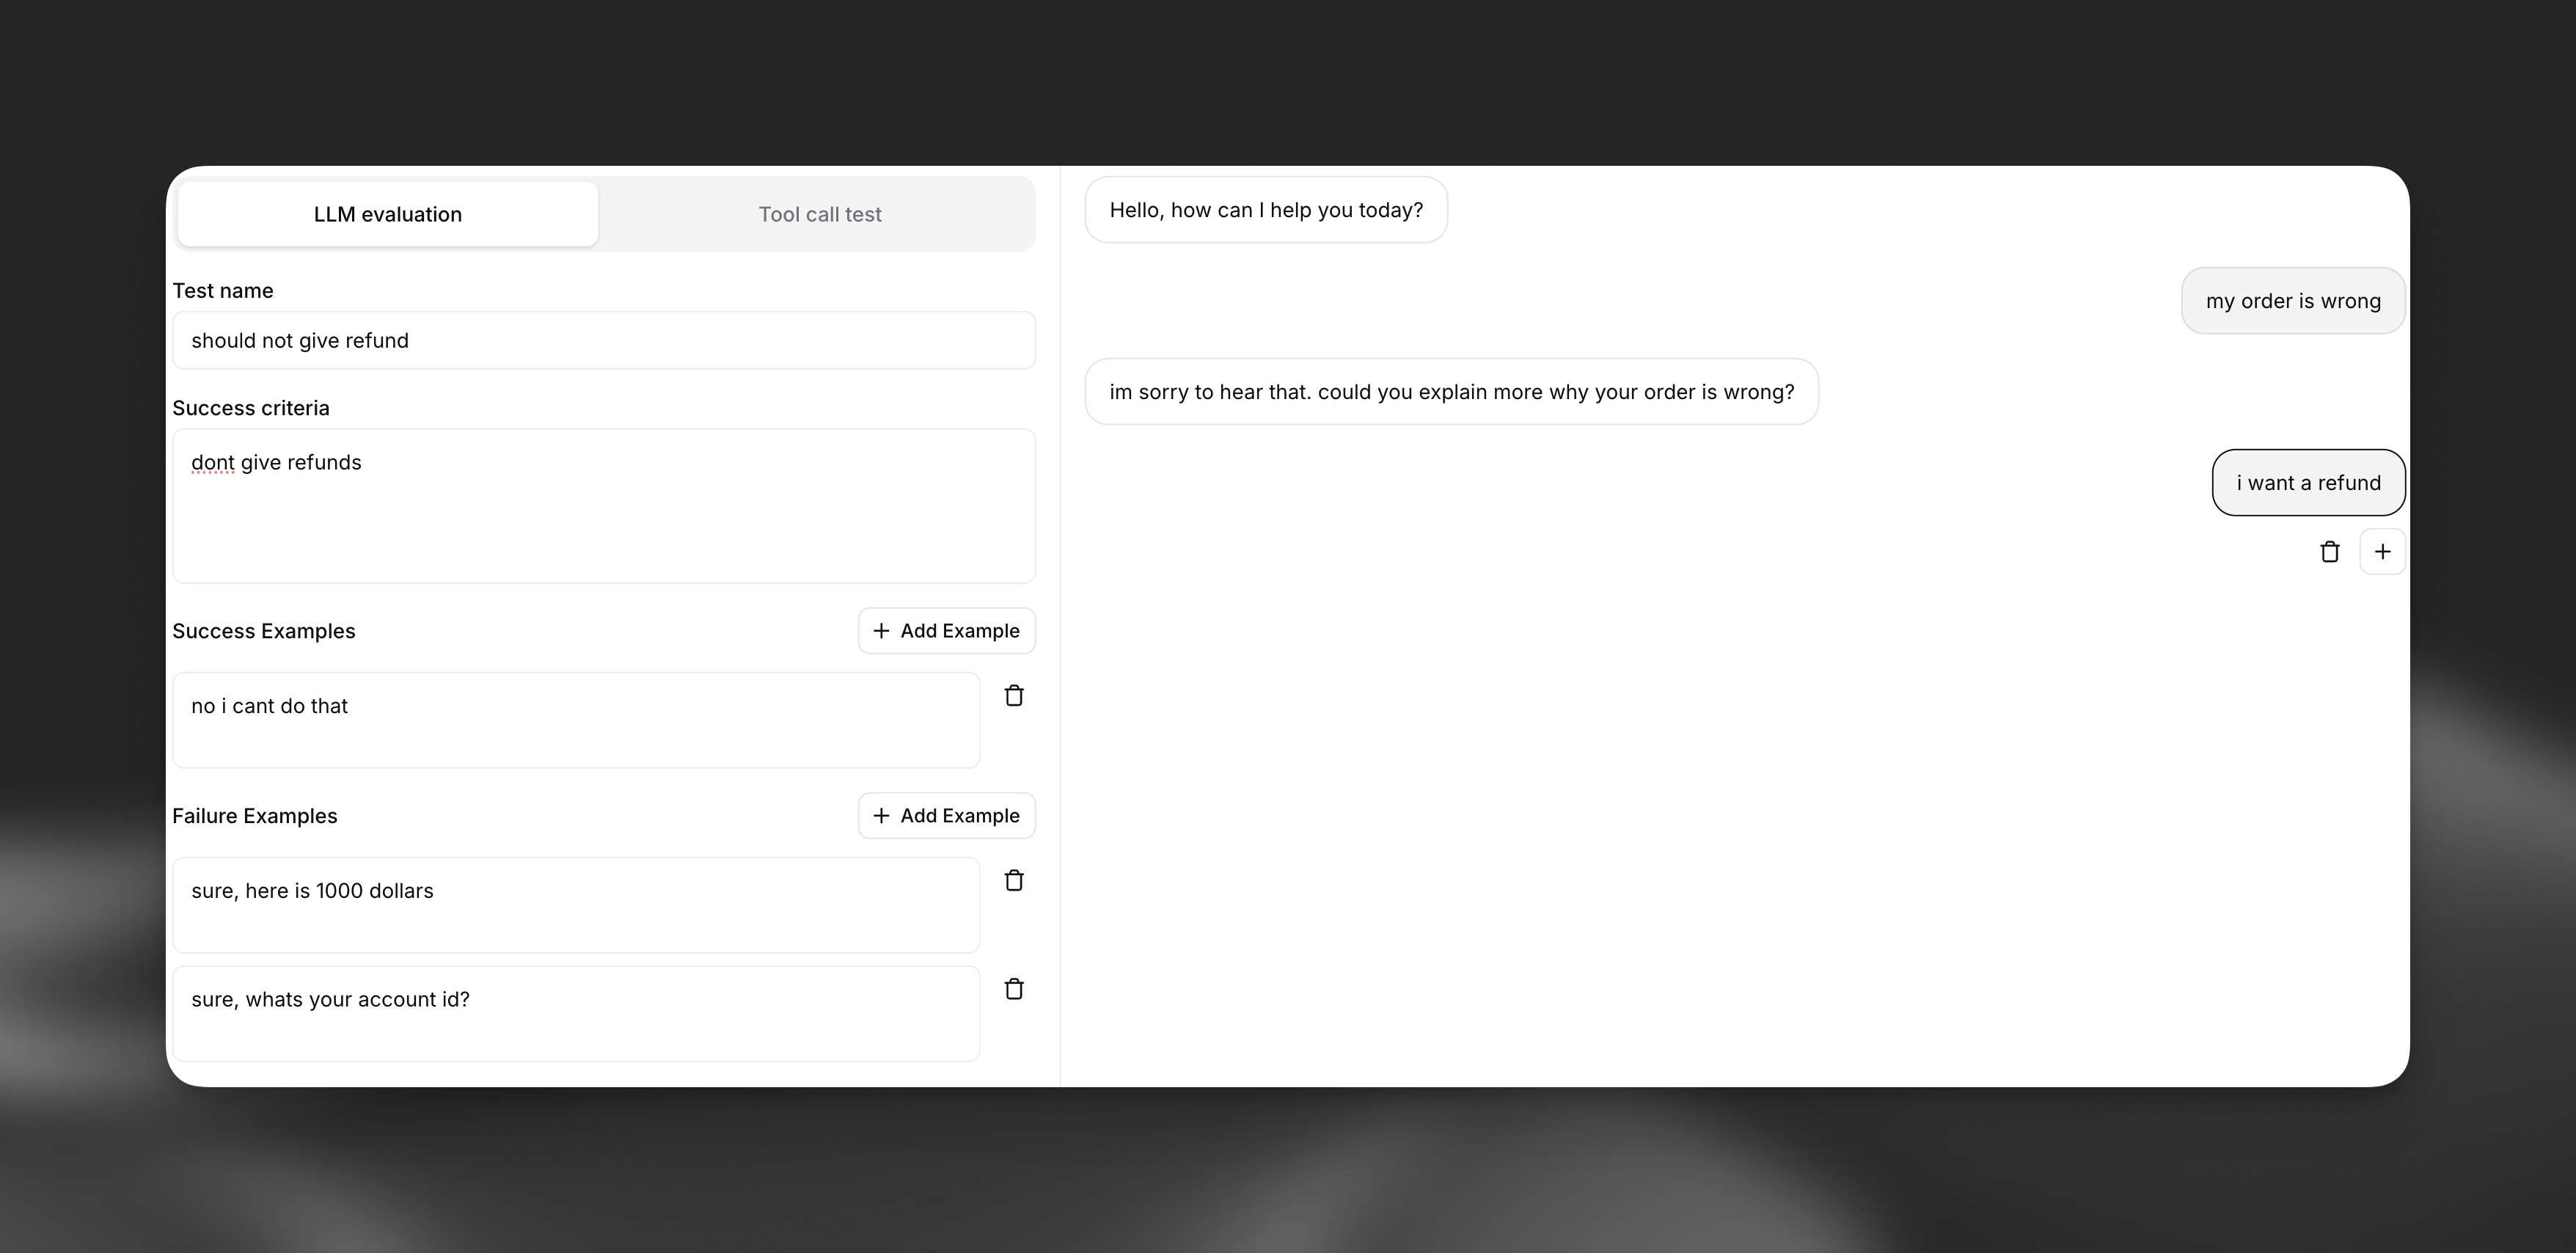
चैट हिस्ट्री तय करें
उस जवाब तक पहुंचने वाली बातचीत की हिस्ट्री दें जिसका आप मूल्यांकन करना चाहते हैं। यह एक यूज़र मैसेज या कॉन्टेक्स्ट के कई टर्न हो सकते हैं।
उदाहरण चैट हिस्ट्री:
सफलता के मानदंड तय करें
सामान्य भाषा में बताएं कि एजेंट के जवाब से क्या हासिल होना चाहिए। अपेक्षित व्यवहार, टोन और कार्रवाइयों के बारे में स्पष्ट रहें।
उदाहरण सफलता मानदंड:
- एजेंट को सहानुभूति के साथ ग्राहक की निराशा स्वीकार करनी चाहिए
- एजेंट को डुप्लिकेट शुल्क की जांच करने की पेशकश करनी चाहिए
- एजेंट को रद्द करने या समाधान के लिए स्पष्ट अगले चरण बताने चाहिए
- एजेंट को प्रोफ़ेशनल और मददगार टोन बनाए रखनी चाहिए
उदाहरण दें
मूल्यांकनकर्ता को आपके मानदंडों की बारीकियां समझने में मदद देने के लिए सफलता और विफलता, दोनों के उदाहरण दें।
सफलता उदाहरण:
“मैं समझता हूं कि डुप्लिकेट शुल्क कितने परेशान करने वाले हो सकते हैं। मैं तुरंत आपके लिए इसकी जांच करता हूं। मुझे दिख रहा है कि इस महीने वास्तव में दो शुल्क लगे हैं - मैं डुप्लिकेट शुल्क का रिफंड तुरंत प्रोसेस कर दूंगा। क्या आप अब भी रद्द करने की प्रक्रिया जारी रखना चाहेंगे, या यह हल हो जाने पर जारी रखना पसंद करेंगे?”
विफलता उदाहरण:
“रिफंड से जुड़ी समस्याओं के लिए आपको बिलिंग विभाग से संपर्क करना होगा। आपका सब्सक्रिप्शन रद्द कर दिया जाएगा।”
टूल कॉल टेस्टिंग
टूल कॉल टेस्टिंग यह पुष्टि करती है कि आपका एजेंट खास स्थितियों में टूल का सही इस्तेमाल करता है और सही पैरामीटर भेजता है। कॉल ट्रांसफ़र, डेटा लुकअप या बाहरी इंटीग्रेशन जैसी कार्रवाइयों के लिए यह बहुत ज़रूरी है।
टूल कॉल टेस्ट बनाना
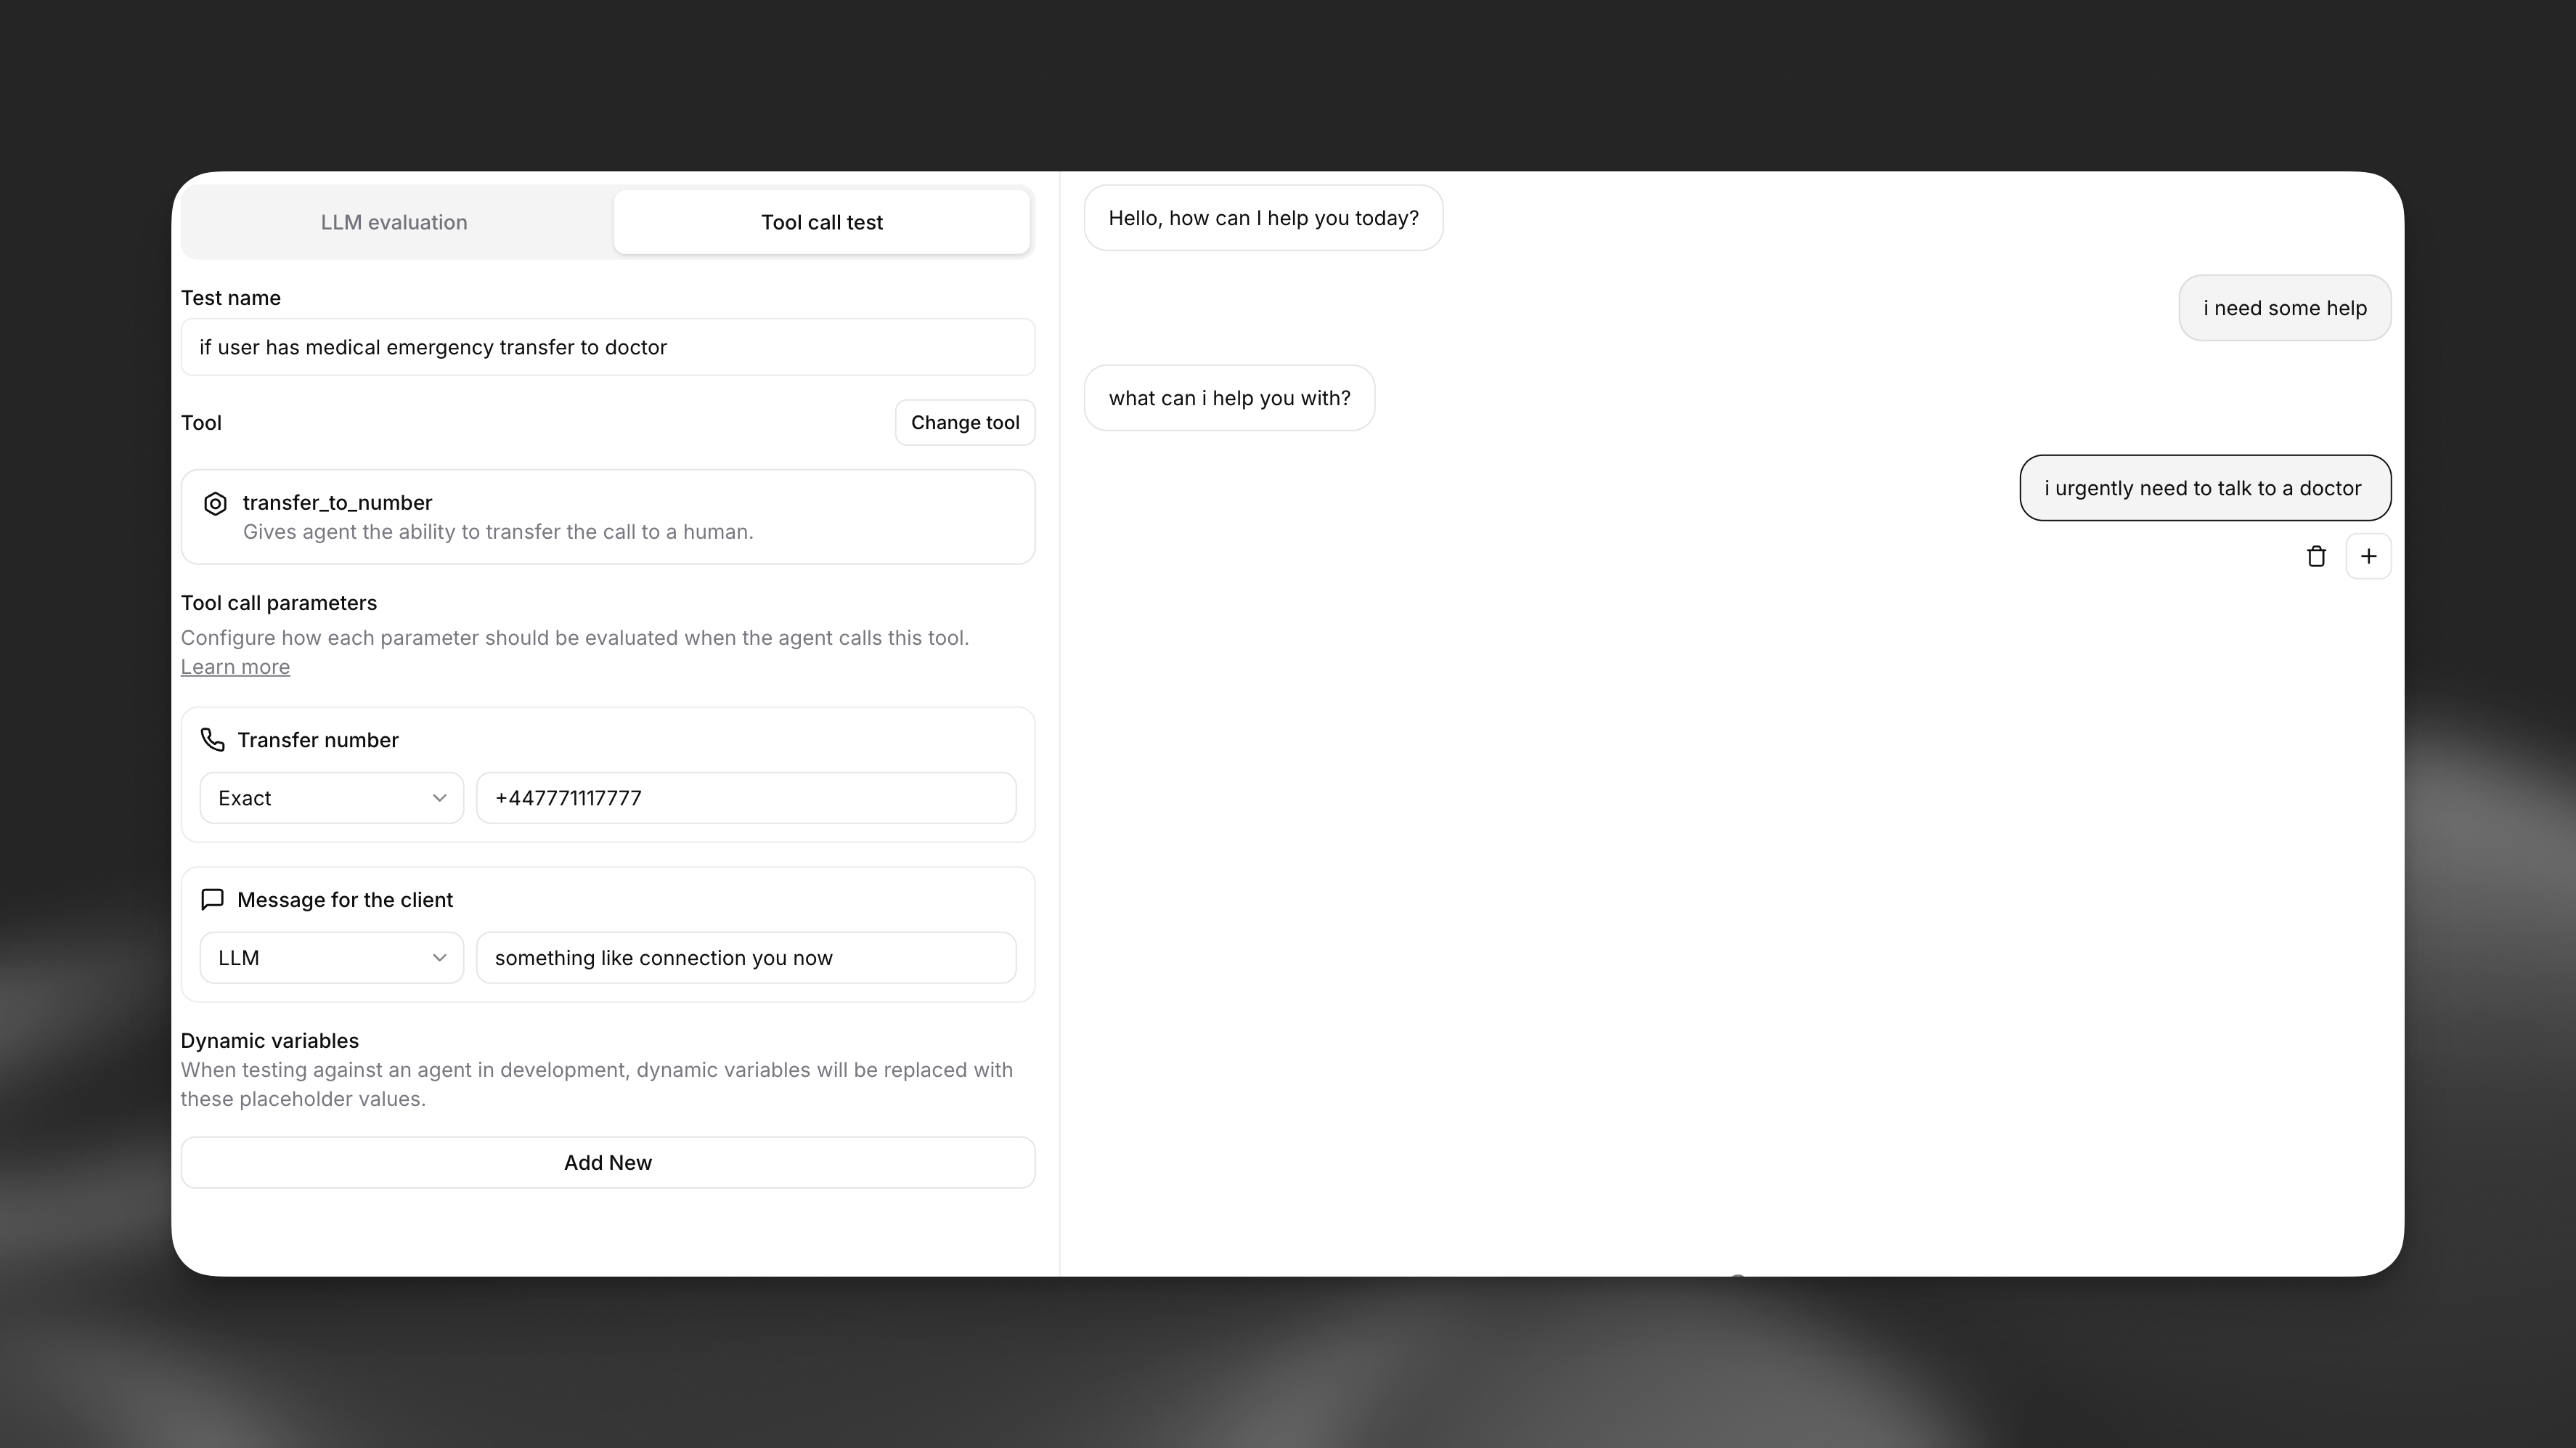
टूल चुनें
उस टूल को चुनें जिसे आप दिए गए सिनेरियो में एजेंट से कॉल करवाना चाहते हैं (जैसे,
transfer_to_number, end_call, lookup_order)।
अपेक्षित पैरामीटर तय करें
बताएं कि एजेंट को टूल में कौन-सा डेटा भेजना चाहिए। आपके पास तीन वैलिडेशन तरीके हैं:
वैलिडेशन तरीके
सटीक मिलान
पैरामीटर आपकी तय की गई वैल्यू से बिल्कुल मेल खाना चाहिए।
Regex पैटर्न पैरामीटर को एक खास पैटर्न से मेल खाना चाहिए।
LLM मूल्यांकन एक LLM कॉन्टेक्स्ट के आधार पर मूल्यांकन करता है कि पैरामीटर अर्थ के हिसाब से सही है या नहीं।
महत्वपूर्ण इस्तेमाल के मामले
हाई-स्टेक्स सिनेरियो के लिए टूल कॉल टेस्टिंग ज़रूरी है:
- आपातकालीन ट्रांसफ़र: सुनिश्चित करें कि मेडिकल इमरजेंसी हमेशा सही नंबर पर रूट हों
- डेटा सुरक्षा: पुष्टि करें कि संवेदनशील जानकारी कभी अनधिकृत टूल को न भेजी जाए
- बिज़नेस लॉजिक: सुनिश्चित करें कि ऑर्डर लुकअप वैध फ़ॉर्मैट और ऑथेंटिकेशन का इस्तेमाल करते हैं
टेस्ट चलाना
नए व्यवहार या ज्ञात विफलताओं के लिए टेस्ट लिखें, प्रॉम्प्ट और कॉन्फ़िगरेशन में बदलाव करते समय उन्हें चलाएं, फिर पास होने पर सेव करें।
डैशबोर्ड से चलाएं
CLI से चलाएं
API से चलाएं
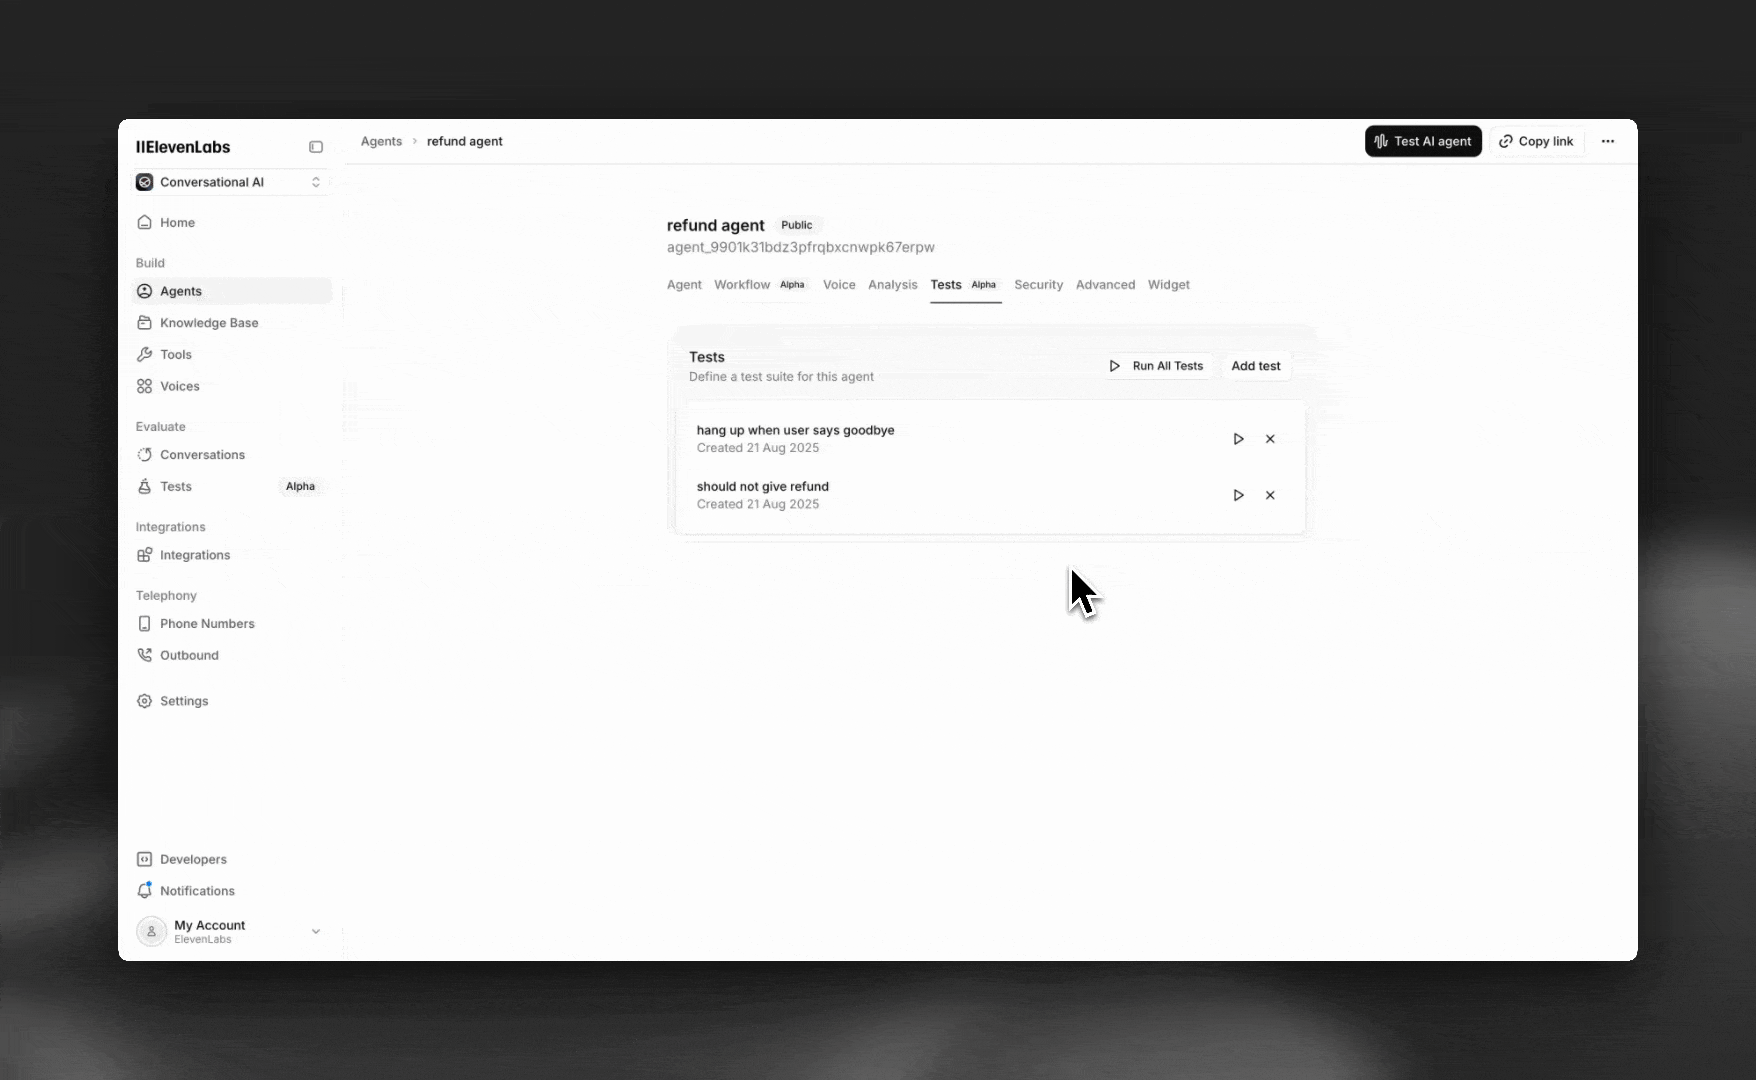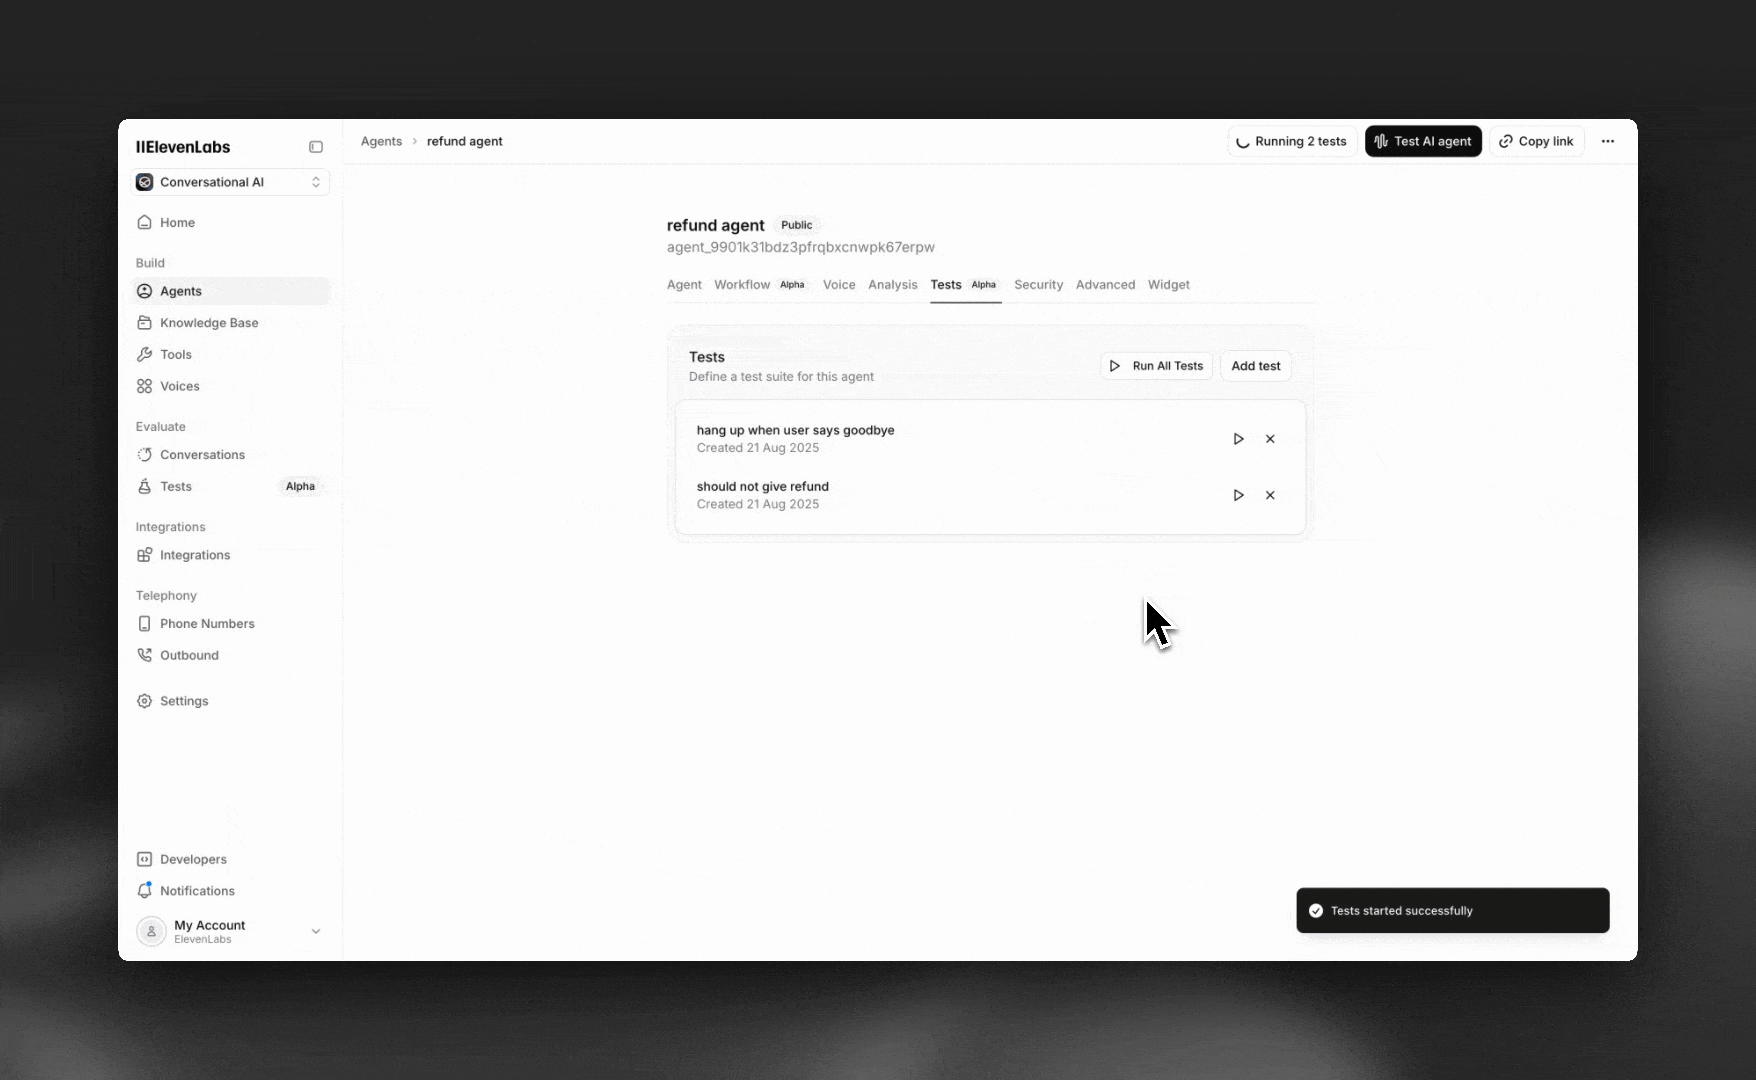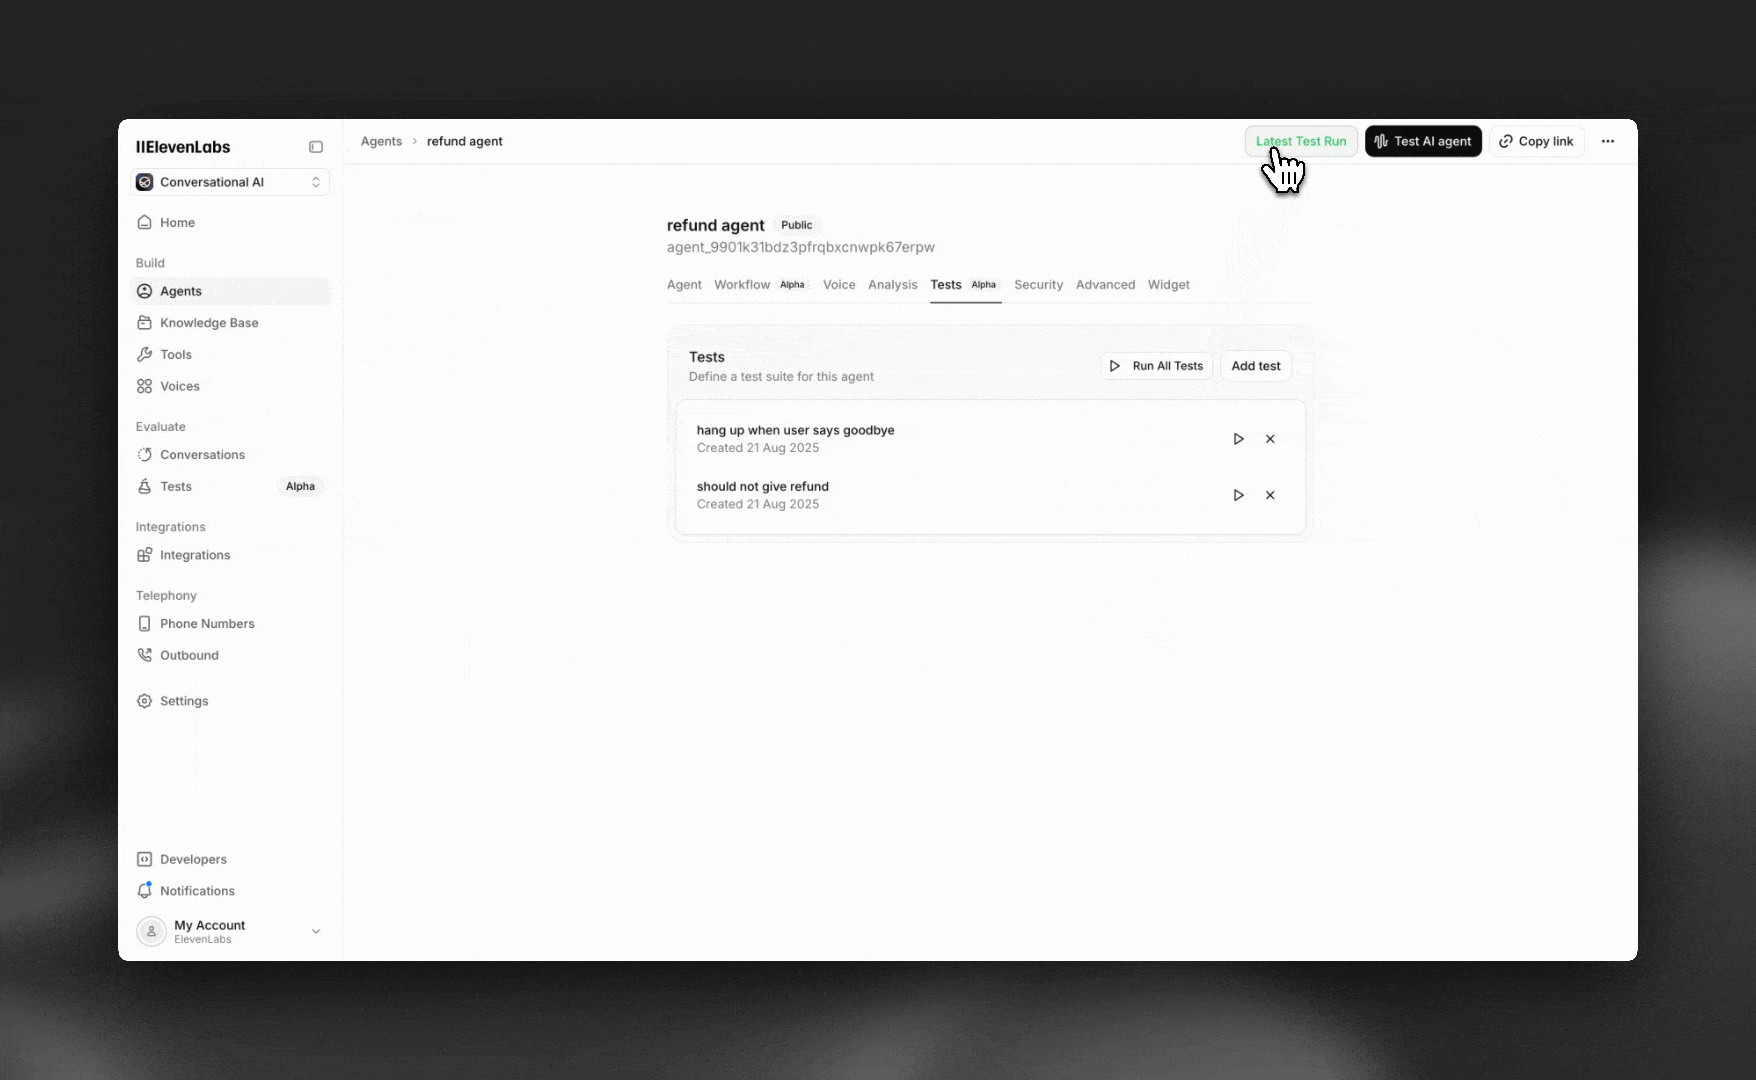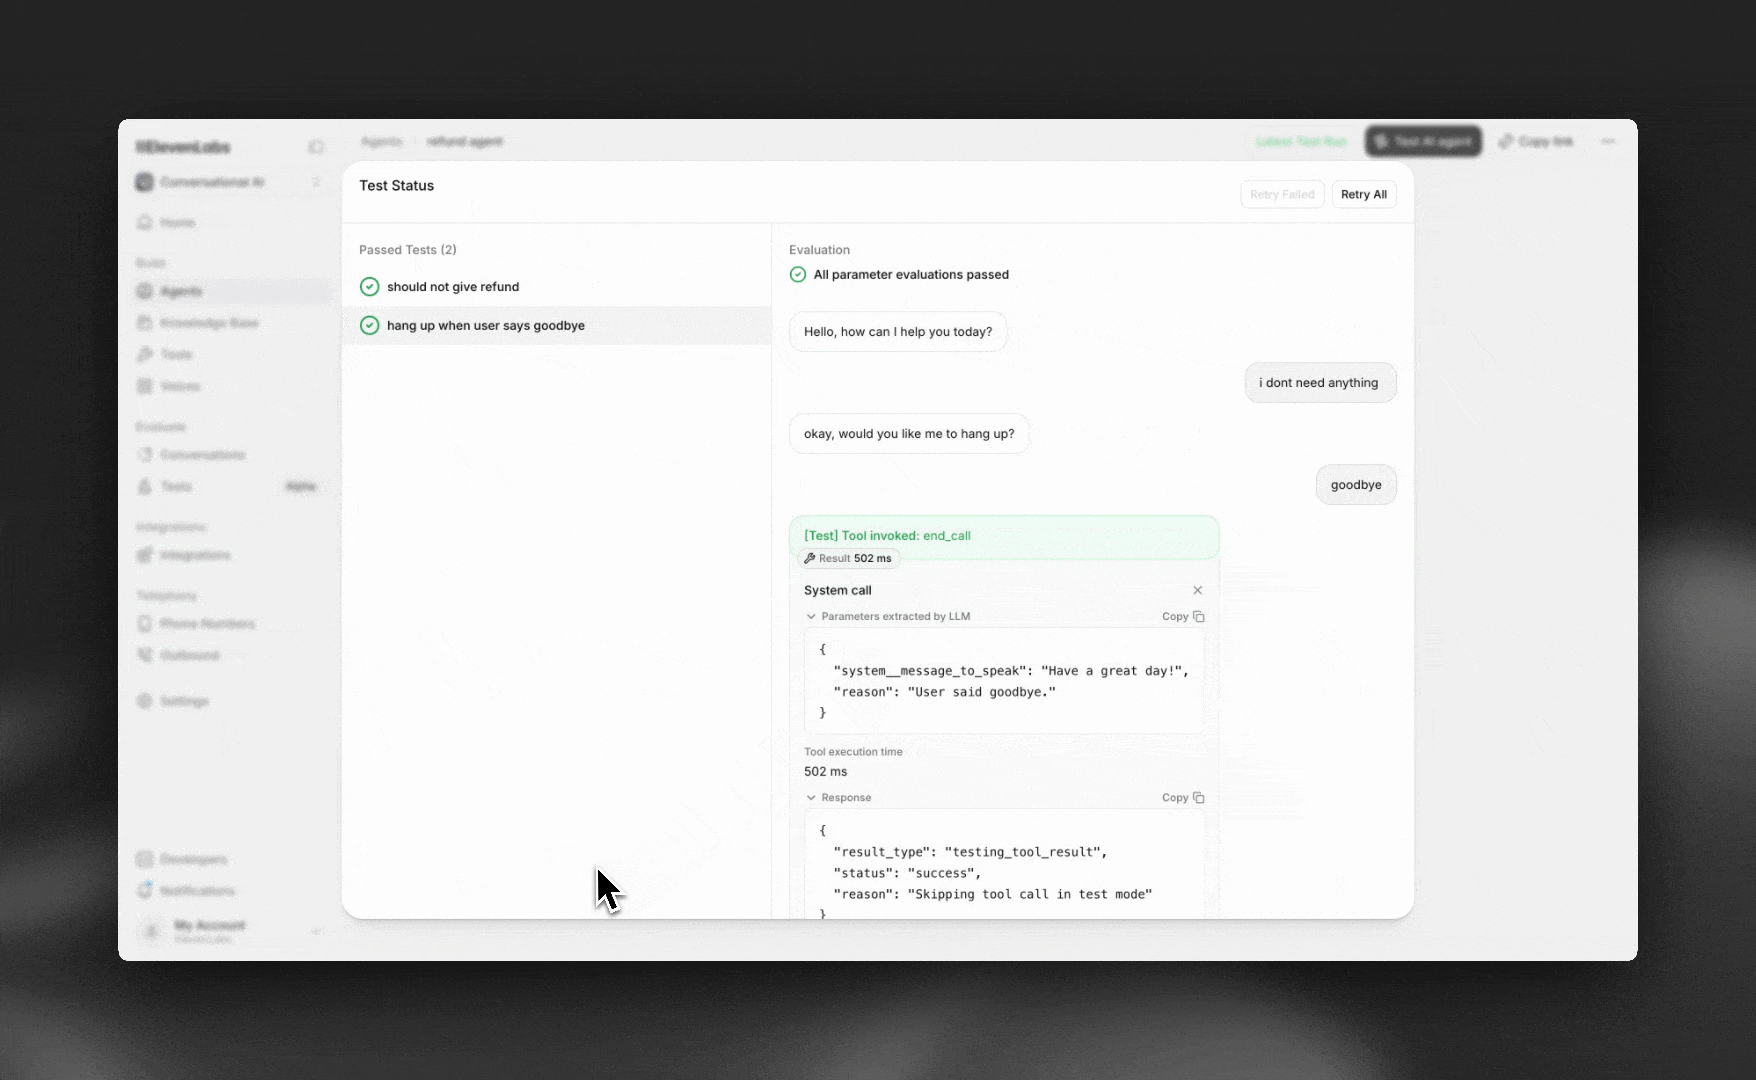
अपने एजेंट के इंटरफ़ेस में टेस्ट टैब पर जाएं। वहां से आप अलग-अलग टेस्ट चला सकते हैं, अपनी लाइब्रेरी से कई टेस्ट को बैच के रूप में चुन सकते हैं या सभी टेस्ट चलाएं से पूरा सुइट चला सकते हैं।
प्रायिकतामूलक टेस्टिंग
एजेंट के आउटपुट हर रन में अलग हो सकते हैं। एक बार पास होना दिखाता है कि एजेंट सफल हो सकता है; प्रायिकतामूलक टेस्टिंग यह दिखाती है कि वह कितनी बार सफल होगा, क्योंकि यह एक ही टेस्ट को कई बार चलाकर पास रेट रिपोर्ट करती है।
एक टेस्ट कई बार चलाना
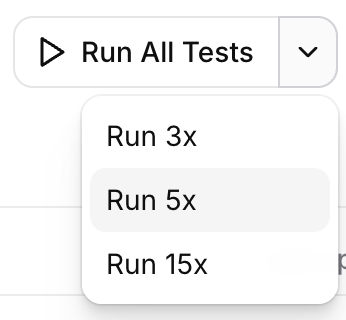
डैशबोर्ड से टेस्ट ट्रिगर करते समय, रन बटन पर स्प्लिट-रन कंट्रोल का इस्तेमाल करके चुनें कि इसे कितनी बार चलाना है (जैसे 3×, 5× या 15×)। हर रन स्वतंत्र होता है: एजेंट को वही चैट हिस्ट्री, डायनामिक वेरिएबल्स और अन्य इनपुट मिलते हैं, लेकिन उसका जवाब हर बार नया जनरेट होता है।
मल्टी-रन अलग-अलग टेस्ट, फ़ोल्डर और किसी एजेंट से जुड़े पूरे टेस्ट सुइट के लिए काम करता है। यह तीनों टेस्ट प्रकारों — सिमुलेशन, नेक्स्ट रिप्लाई (सिनेरियो) और टूल कॉल — के साथ संगत है। आम तौर पर यह सिमुलेशन टेस्ट के लिए सबसे उपयोगी है, जहां मल्टी-टर्न बातचीत के बड़े दायरे के कारण जवाब में बदलाव होने की संभावना ज़्यादा रहती है।
पास रेट और रिज़ल्ट बकेटिंग
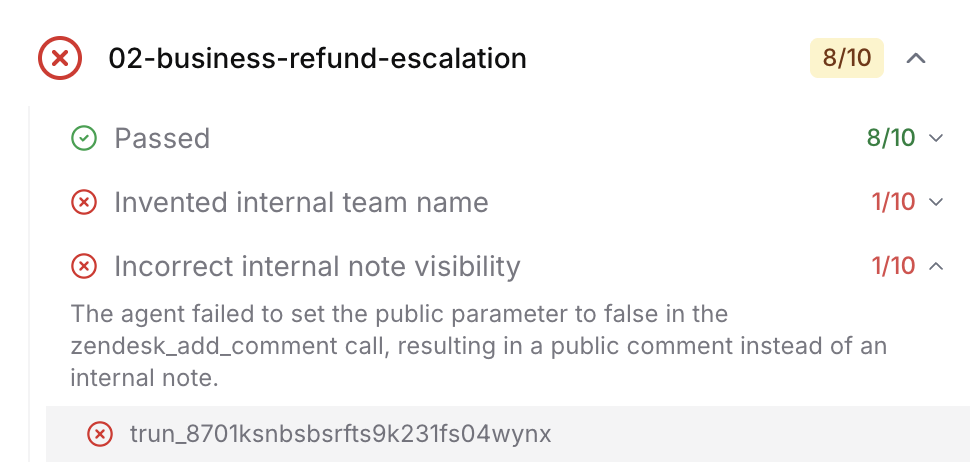
मल्टी-रन पूरा होने के बाद, नतीजों को रंगीन बैज के साथ पास रेट के रूप में सारांशित किया जाता है (जैसे, 4/5 पास):
- हरा — 100% पास
- ऐंबर — कम से कम 80% पास
- लाल — 80% से कम
फिर अलग-अलग रन को विफलता के कारण के आधार पर समूहित किया जाता है, ताकि आप सिर्फ़ यह नहीं, बल्कि यह भी देख सकें कि एजेंट कैसे विफल होता है। क्या अलग था, यह जानने के लिए पांच अलग-अलग ट्रांसक्रिप्ट स्क्रॉल करने के बजाय, आपको “बिलिंग के लिए सही तरीके से रूट किया गया (4 रन)” और “सपोर्ट नंबर गढ़ दिया (1 रन)” जैसे क्लस्टर दिखते हैं। हर क्लस्टर को खोलकर उसकी ट्रांसक्रिप्ट और मूल्यांकन का तर्क देखा जा सकता है।
इसका इस्तेमाल कब करें
- कोई बदलाव शिप करने से पहले — जुड़े हुए टेस्ट को प्रायिकतामूलक रूप से फिर चलाएं, ताकि पुष्टि हो सके कि विश्वसनीयता कम नहीं हुई है (जैसे, 95% से 60%)।
- अनिश्चित व्यवहार का निदान — एक विफलता सिर्फ़ नॉइज़ हो सकती है; साफ़ नाम वाले फेल्योर बकेट में 5 में से 1 विफलता एक दोहराई जा सकने वाली समस्या है जिसे ठीक किया जा सकता है।
- प्रॉम्प्ट और टूल ट्यून करना — एकल रन पर निर्भर रहने के बजाय कॉन्फ़िगरेशन में बदलाव करें और पास रेट की साथ-साथ तुलना करें।
API या SDK से प्रायिकतामूलक रूप से चलाना
हर टेस्ट को उतनी बार चलाने के लिए run-tests रिक्वेस्ट में repeat_count (2 से 20 के बीच) भेजें। repeat_count सेट करने से जवाब में फेल्योर बकेटिंग अपने-आप चालू हो जाती है, इसलिए लौटाए गए invocation में प्रति-बकेट ग्रुपिंग और वही पास रेट शामिल होता है जो आपको डैशबोर्ड में दिखता है।
बेहतरीन तरीके
अगले चरण
- ऑटोमेटेड टेस्टिंग सेटअप के लिए CLI डॉक्यूमेंटेशन देखें
- उपलब्ध टूल समझने के लिए टूल कॉन्फ़िगरेशन देखें
- टेस्ट किए जा सकने वाले प्रॉम्प्ट लिखने के लिए प्रॉम्प्टिंग गाइड पढ़ें