

Zintegruj własny model
Połącz agenta z własnym LLM lub hostuj własny serwer.
Custom LLM pozwala połączyć rozmowy z własnym LLM przez zewnętrzny endpoint. ElevenLabs obsługuje też natywnie zintegrowane LLM
Custom LLMs pozwala użyć własnego klucza API OpenAI lub uruchomić całkowicie własny serwer LLM.
Custom LLM nie może być używany z modelem Realtime.
Omówienie
Domyślnie używamy własnych wewnętrznych danych uwierzytelniających do popularnych modeli, takich jak OpenAI. Aby użyć własnego serwera LLM, musi on obsługiwać jedną z poniższych struktur żądań i odpowiedzi zgodnych z OpenAI:
- Chat Completions API (
/v1/chat/completions) - Responses API (
/v1/responses)
Responses API to nowszy format API OpenAI, który obsługuje dodatkowe funkcje. Oba formaty API są w pełni obsługiwane w integracji z Custom LLM.
Poniższe przewodniki obejmują oba zastosowania:
- Użyj własnego klucza OpenAI: Użyj własnego klucza API OpenAI na naszej platformie.
- Własny serwer LLM: Hostuj i połącz własną implementację serwera LLM.
Dowiesz się, jak:
- Zapisać klucz API OpenAI w ElevenLabs
- Hostować serwer odwzorowujący endpoint Chat Completions lub Responses OpenAI
- Skierować ElevenLabs do własnego endpointu
- W razie potrzeby przekazywać dodatkowe parametry do LLM
Podsumowanie rozumowania
Endpoint musi zwracać rozumowanie oddzielnie od końcowej odpowiedzi. ElevenLabs nie generuje rozumowania na podstawie końcowej odpowiedzi.
Aby żądać rozumowania z obsługiwanego endpointu, włącz Reasoning summary w ustawieniach LLM agenta lub ustaw enable_reasoning_summary przez API.
Zwracanie rozumowania
Użyj formatu zgodnego z endpointem:
Chat Completions API
Responses API
Strumieniuj rozumowanie w polu reasoning lub reasoning_content każdego delta odpowiedzi.
W przypadku endpointów zgodnych z Gemini ElevenLabs żąda przemyśleń za pomocą
google.thinking_config.include_thoughts i odczytuje treść oznaczoną przez
extra_content.google.thought.
Informacje o przechowywaniu, dostarczaniu i ograniczeniach znajdziesz w Reasoning summary.
Używanie własnego klucza OpenAI
Aby zintegrować własny klucz OpenAI, zaktualizuj ustawienia agenta w panelu ElevenLabs, aby wskazywały własny serwer LLM, i utwórz sekret zawierający OPENAI_API_KEY:
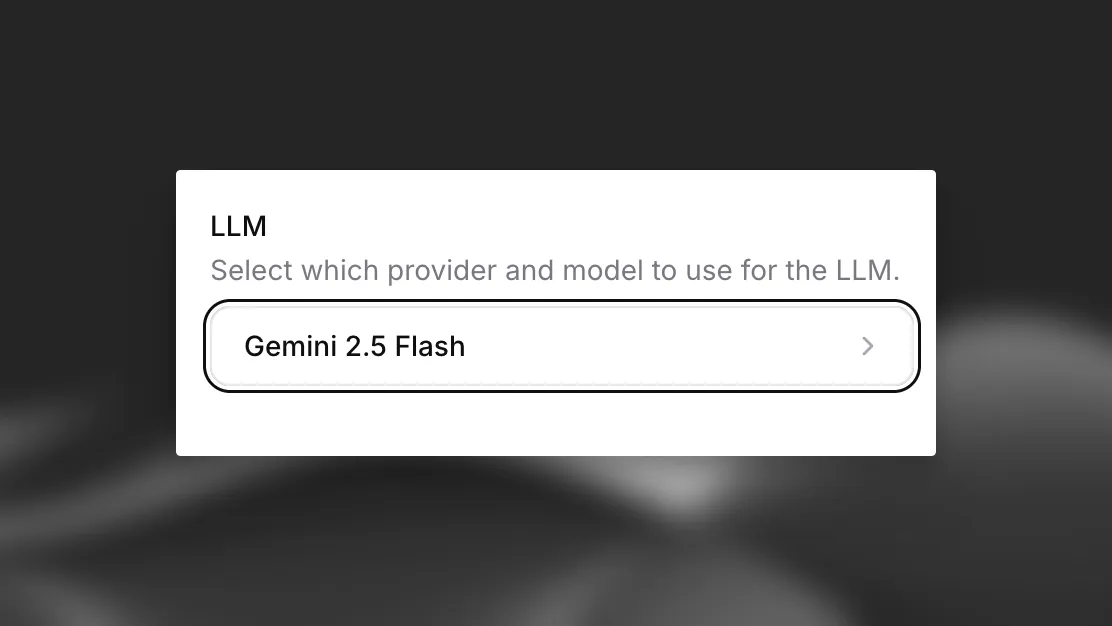
W ustawieniach agenta w panelu ElevenLabs wybierz „Custom LLM” z menu rozwijanego „LLM” po prawej stronie.
Własny serwer LLM
Aby użyć własnego serwera LLM, skonfiguruj zgodny endpoint serwera w stylu OpenAI. Możesz zaimplementować Chat Completions API (/v1/chat/completions) albo Responses API (/v1/responses).
Oba endpointy muszą zwracać odpowiedzi w formacie SSE (Server-Sent Events) z Content-Type: text/event-stream.
Chat Completions API
Responses API
Chat Completions API używa endpointu /v1/chat/completions.
Każdy fragment musi mieć format data: {json}\n\n, a strumień musi kończyć się data: [DONE]\n\n.
Oto przykładowa implementacja serwera:
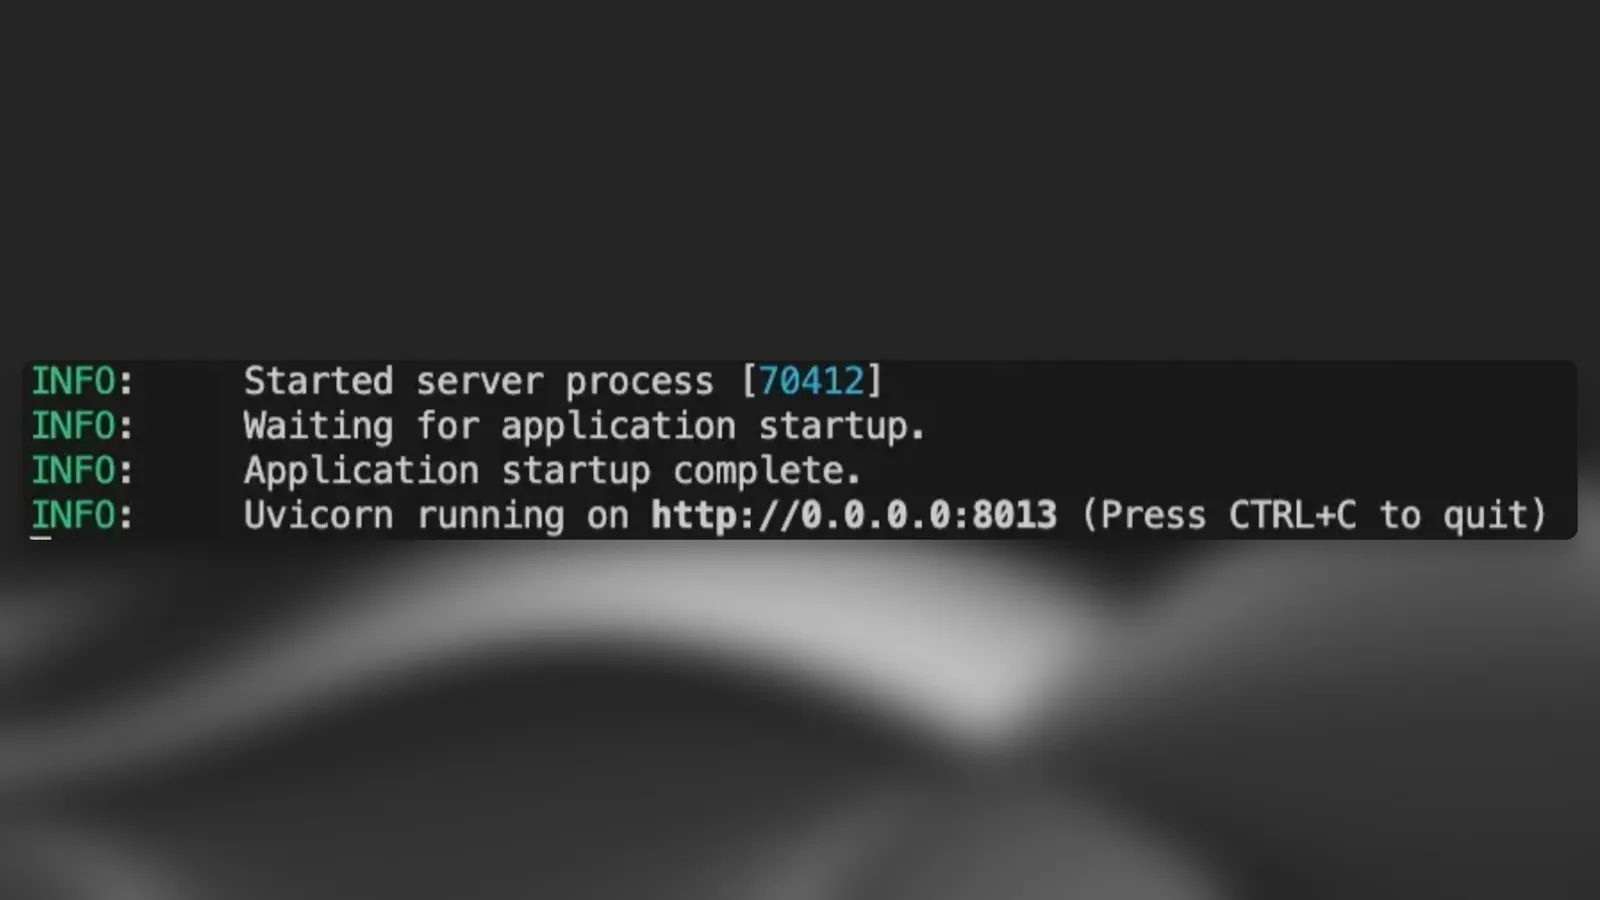
Uruchom ten kod lub własny kod serwera.
Konfigurowanie publicznego adresu URL serwera
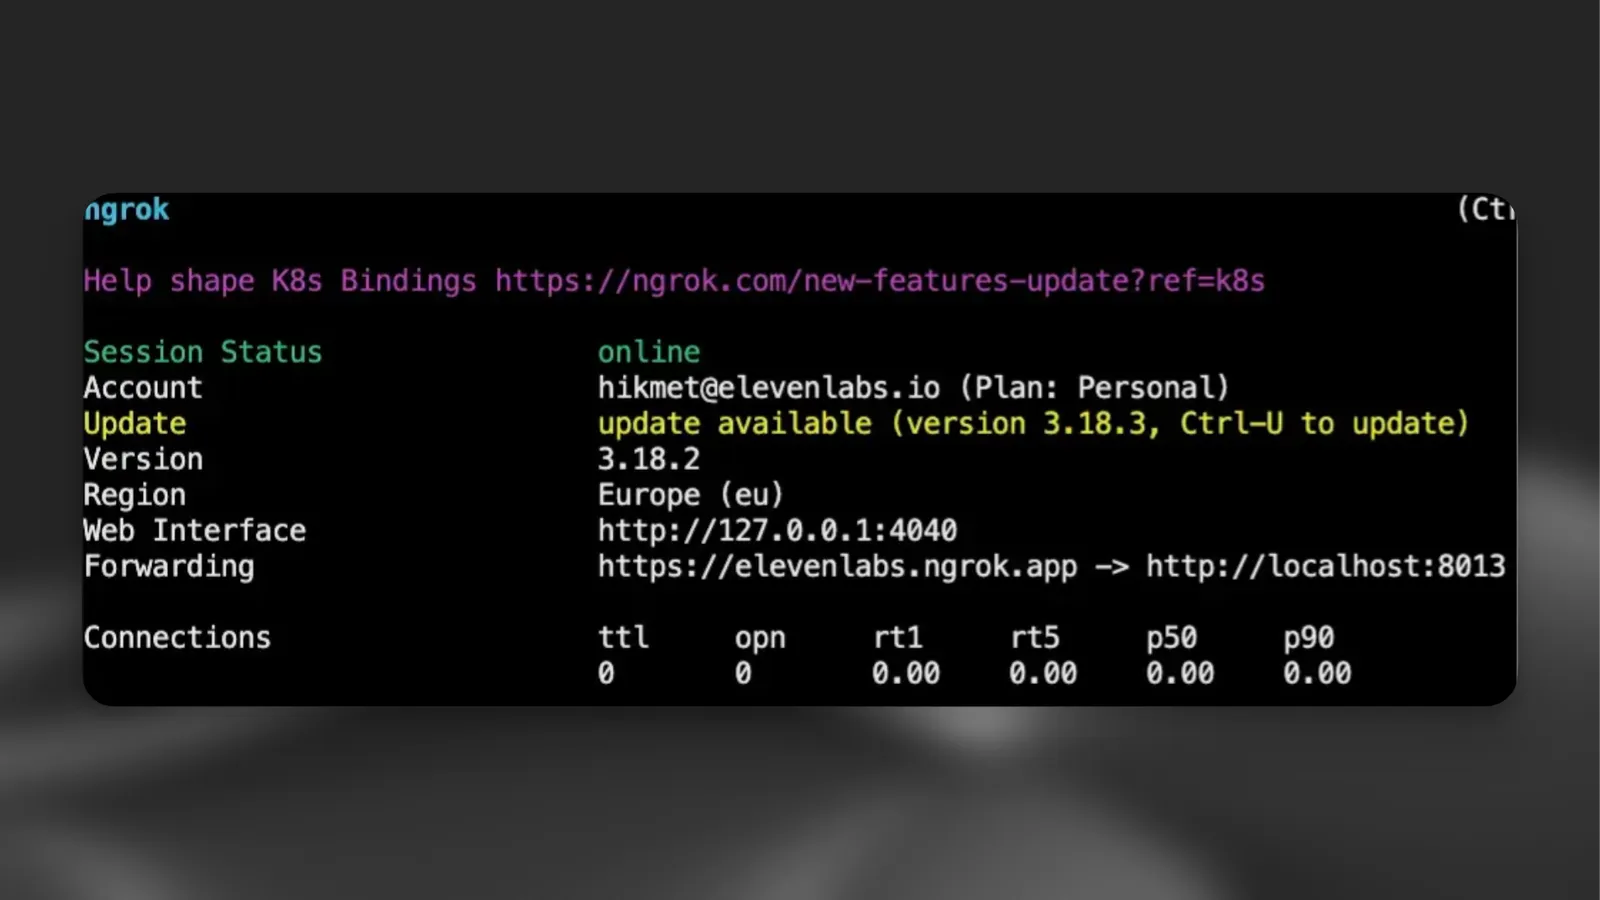
Aby udostępnić serwer, utwórz publiczny adres URL za pomocą narzędzia do tunelowania, takiego jak ngrok:
Konfigurowanie CustomLLM w ElevenLabs
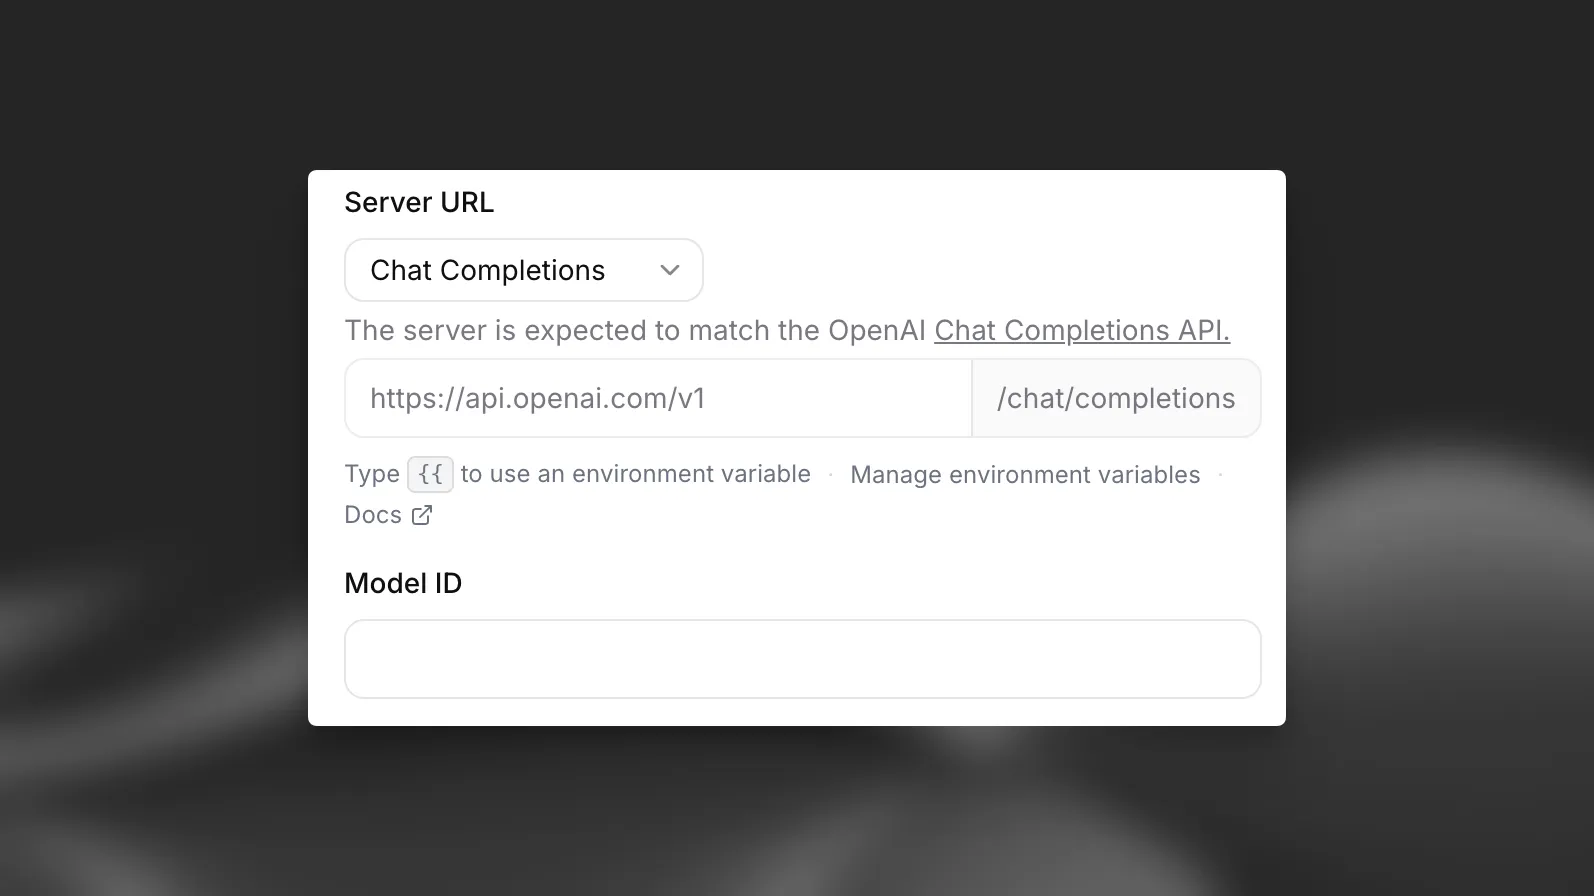
Następnie zaktualizuj ustawienia agenta w panelu ElevenLabs, aby wskazywały własny serwer LLM.
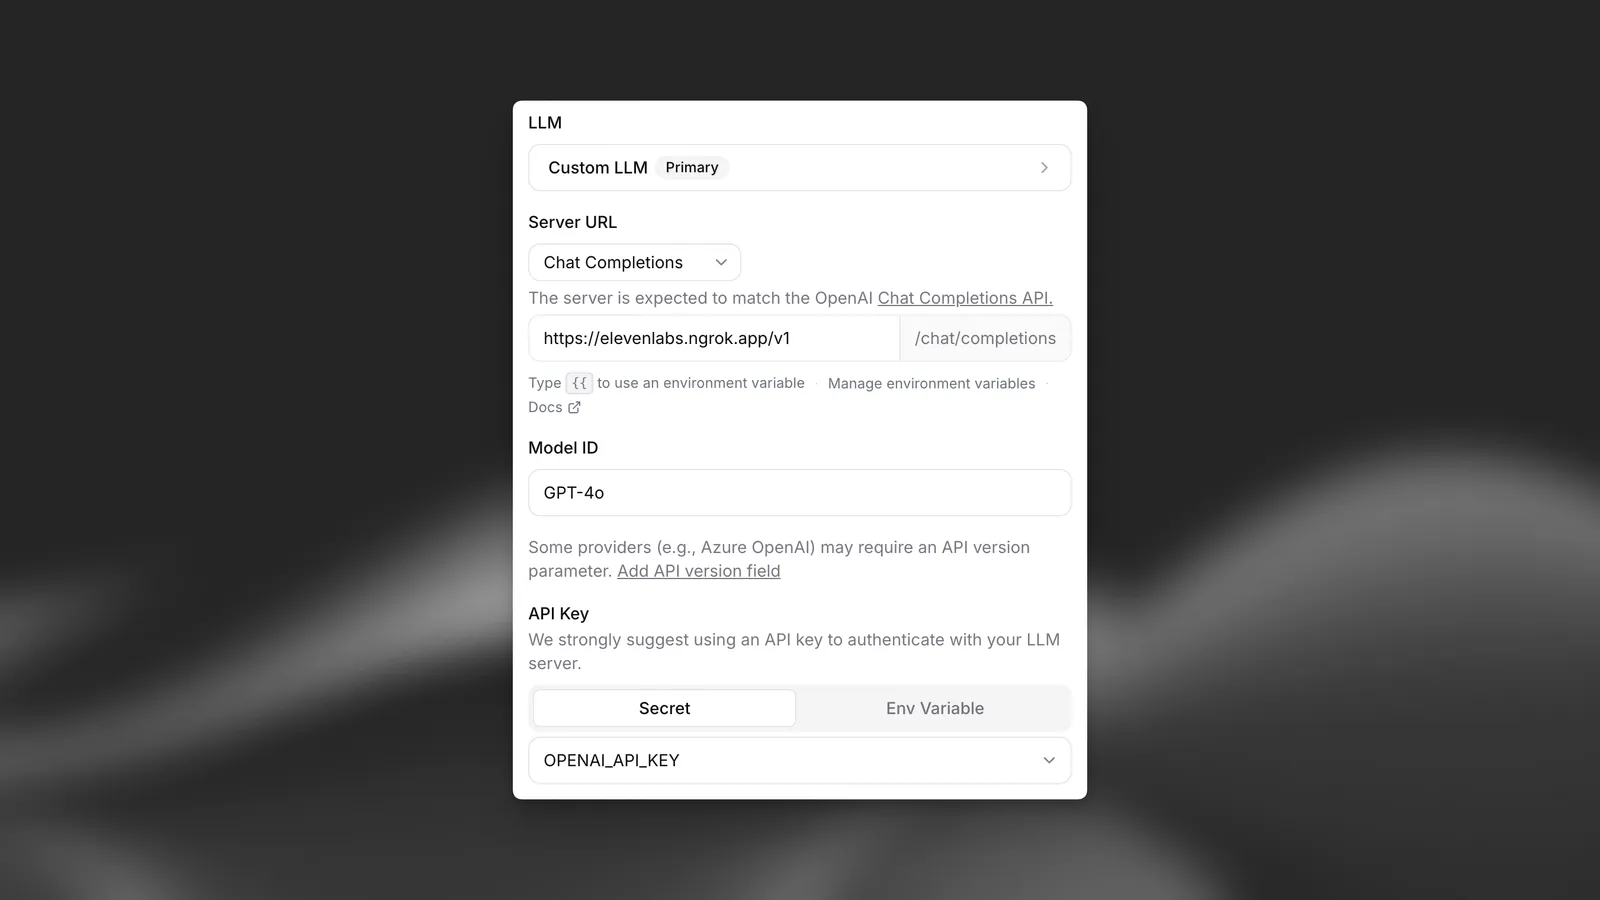
Ustaw adres URL serwera na endpoint ngrok i wartość „Limit token usage” na 5000.
Możesz teraz rozpocząć interakcję z agentem korzystającym z własnego serwera LLM.
Optymalizacja dla wolno działających LLM-ów
Jeśli twój własny LLM działa wolno (na przykład ze względu na rozumowanie agentowe lub wymagania dotyczące wstępnego przetwarzania), możesz poprawić płynność rozmowy, stosując słowa buforujące w odpowiedziach strumieniowanych. Ta technika pomaga zachować naturalną prozodię mowy, gdy LLM generuje pełną odpowiedź.
Słowa buforujące
Gdy LLM potrzebuje więcej czasu na przetworzenie pełnej odpowiedzi, zwróć początkową odpowiedź kończącą się "... " (wielokropkiem ze spacją). Dzięki temu system Text to Speech może zachować naturalny rytm, a rozmowa pozostaje dynamiczna.
Tworzy to naturalne pauzy, które płynnie przechodzą w kolejne treści, nad którymi LLM może dłużej się zastanawiać. Dodatkowa spacja jest kluczowa, aby kolejne treści nie zostały dołączone do „…”, co może powodować zniekształcenia dźwięku.
Implementacja
Tak zmodyfikujesz serwer własnego LLM-a, aby stosował słowa buforujące:
Integracja narzędzi systemowych
Twój własny LLM może uruchamiać narzędzia systemowe, aby kontrolować przebieg i stan rozmowy. Po skonfigurowaniu w agencie narzędzia te są automatycznie uwzględniane w parametrze tools żądań ukończenia czatu.
Jak działają narzędzia systemowe
- Decyzja LLM-a: Twój własny LLM decyduje, kiedy wywołać te narzędzia na podstawie kontekstu rozmowy
- Odpowiedź narzędzia: LLM odpowiada wywołaniami funkcji w standardowym formacie OpenAI
- Przetwarzanie backendowe: ElevenLabs przetwarza wywołania narzędzi i aktualizuje stan rozmowy
Więcej informacji o narzędziach systemowych znajdziesz w naszym przewodniku
Dostępne narzędzia systemowe
Zakończenie rozmowy
Cel: Automatyczne kończenie rozmów, gdy zostaną spełnione odpowiednie warunki.
Warunki uruchomienia: LLM powinien wywołać to narzędzie, gdy:
- Główne zadanie zostało ukończone, a użytkownik jest zadowolony
- Rozmowa dobiegła naturalnego końca za obopólną zgodą
- Użytkownik wyraźnie wskazuje, że chce zakończyć rozmowę
Parametry:
reason(ciąg znaków, wymagany): Powód zakończenia rozmowymessage(ciąg znaków, opcjonalny): Wiadomość pożegnalna wysyłana użytkownikowi przed zakończeniem rozmowy
Format wywołania funkcji:
Implementacja: Skonfiguruj jako narzędzie systemowe w ustawieniach agenta. LLM otrzyma szczegółowe instrukcje, kiedy wywołać tę funkcję.
Dowiedz się więcej: Narzędzie zakończenia rozmowy
Wykrywanie języka
Cel: Automatyczne przełączanie na wykryty język użytkownika podczas rozmów.
Warunki uruchomienia: LLM powinien wywołać to narzędzie, gdy:
- Użytkownik mówi w języku innym niż obecny język rozmowy
- Użytkownik wyraźnie prosi o zmianę języka
- Rozmowa wymaga obsługi wielu języków
Parametry:
reason(ciąg znaków, wymagany): Powód zmiany językalanguage(ciąg znaków, wymagany): Kod języka, na który należy przełączyć (musi być na liście obsługiwanych języków)
Format wywołania funkcji:
Implementacja: Skonfiguruj obsługiwane języki w ustawieniach agenta i dodaj narzędzie systemowe wykrywania języka. Agent automatycznie dopasuje głos i odpowiedzi do wykrytego języka.
Dowiedz się więcej: Narzędzie wykrywania języka
Przekazanie do agenta
Cel: Przekazywanie rozmów między wyspecjalizowanymi agentami AI zależnie od potrzeb użytkownika.
Warunki uruchomienia: LLM powinien wywołać to narzędzie, gdy:
- Prośba użytkownika wymaga specjalistycznej wiedzy lub innych możliwości agenta
- Obecny agent nie może odpowiednio obsłużyć zapytania
- Przebieg rozmowy wskazuje na potrzebę innego typu agenta
Parametry:
reason(ciąg znaków, opcjonalny): Powód przekazania do agentaagent_number(liczba całkowita, wymagany): Numer indeksowany od zera agenta, do którego należy przekazać rozmowę (na podstawie skonfigurowanych reguł przekazywania)
Format wywołania funkcji:
Implementacja: Zdefiniuj reguły przekazywania, które mapują warunki na konkretne identyfikatory agentów. Skonfiguruj, do których agentów może przekazywać rozmowy bieżący agent. Agenci są oznaczani numerami indeksowanymi od zera w konfiguracji przekazywania.
Dowiedz się więcej: Narzędzie przekazywania do agenta
Przekazanie do człowieka
Cel: Płynne przekazywanie rozmów do ludzkich operatorów, gdy pomoc AI nie wystarcza.
Warunki uruchomienia: LLM powinien wywołać to narzędzie, gdy:
- Występują złożone problemy wymagające ludzkiego osądu
- Użytkownik wyraźnie prosi o pomoc człowieka
- AI osiąga granice swoich możliwości w danym zapytaniu
- Zostają uruchomione procedury eskalacji
Parametry:
reason(ciąg znaków, opcjonalny): Powód przekazaniatransfer_number(ciąg znaków, wymagany): Numer telefonu, na który należy przekazać rozmowę (musi odpowiadać skonfigurowanym numerom)client_message(ciąg znaków, wymagany): Komunikat odczytywany klientowi podczas oczekiwania na przekazanieagent_message(ciąg znaków, wymagany): Komunikat dla ludzkiego operatora odbierającego rozmowę
Format wywołania funkcji:
Implementacja: Skonfiguruj numery telefonów i warunki przekazywania. Zdefiniuj komunikaty zarówno dla klienta, jak i odbierającego rozmowę operatora. Działa z Twilio i SIP trunkingiem.
Dowiedz się więcej: Narzędzie przekazywania do człowieka
Pomiń turę
Cel: Pozwala agentowi zrobić pauzę i czekać na dane od użytkownika bez mówienia.
Warunki uruchomienia: LLM powinien wywołać to narzędzie, gdy:
- Użytkownik wskazuje, że potrzebuje chwili („Daj mi sekundę”, „Muszę pomyśleć”)
- Użytkownik prosi o przerwę w rozmowie
- Agent wykrywa, że użytkownik potrzebuje czasu na przetworzenie informacji
Parametry:
reason(ciąg znaków, opcjonalny): Dowolny powód wyjaśniający, dlaczego potrzebna jest pauza
Format wywołania funkcji:
Implementacja: Nie wymaga dodatkowej konfiguracji. Narzędzie po prostu sygnalizuje agentowi, aby zachował ciszę, dopóki użytkownik nie odezwie się ponownie.
Dowiedz się więcej: Narzędzie pomijania tury
Wykrywanie poczty głosowej
Parametry:
reason(string, wymagany): Powód wykrycia poczty głosowej (np. „wykryto automatyczne powitanie”, „brak odpowiedzi człowieka”)
Format wywołania funkcji:
Dowiedz się więcej: Narzędzie wykrywania poczty głosowej
Przykładowe żądanie z narzędziami systemowymi
Gdy narzędzia systemowe są skonfigurowane, twój własny LLM otrzyma żądania zawierające narzędzia w standardowym formacie OpenAI:
Twój własny LLM musi obsługiwać wywoływanie funkcji, aby korzystać z narzędzi systemowych. Upewnij się, że model może generować poprawne odpowiedzi wywołań funkcji w formacie OpenAI.
Dodatkowe funkcje
Własne parametry LLM-a
Możesz przekazać dodatkowe parametry do implementacji własnego LLM-a.