

Integreer je eigen model
Met Custom LLM kun je je gesprekken via een extern endpoint koppelen aan je eigen LLM. ElevenLabs ondersteunt ook native geïntegreerde LLM’s
Met aangepaste LLM’s kun je je eigen OpenAI API-sleutel gebruiken of een volledig aangepaste LLM-server uitvoeren.
Overzicht
Standaard gebruiken we onze eigen interne gegevens voor populaire modellen zoals OpenAI. Om een aangepaste LLM-server te gebruiken, moet deze overeenkomen met een van de volgende OpenAI-compatibele request/response-structuren:
- Chat Completions API (
/v1/chat/completions) - Responses API (
/v1/responses)
De Responses API is de nieuwere API-indeling van OpenAI en ondersteunt extra functies. Beide API-indelingen worden volledig ondersteund voor aangepaste LLM-integratie.
De volgende handleidingen behandelen beide gebruiksscenario’s:
- Gebruik je eigen OpenAI-sleutel: Gebruik je eigen OpenAI API-sleutel met ons platform.
- Aangepaste LLM-server: Host en koppel je eigen LLM-serverimplementatie.
Je leert hoe je:
- Je OpenAI API-sleutel opslaat in ElevenLabs
- Een server host die het Chat Completions- of Responses-endpoint van OpenAI nabootst
- ElevenLabs naar je aangepaste endpoint verwijst
- Indien nodig extra parameters doorgeeft aan je LLM
Samenvatting van de redenering
Je endpoint moet de redenering afzonderlijk van het definitieve antwoord teruggeven. ElevenLabs genereert geen redenering op basis van het definitieve antwoord.
Om redenering op te vragen bij een ondersteund endpoint, schakel je Reasoning summary in bij de LLM-instellingen van de agent of stel je enable_reasoning_summary in via de API.
Redenering teruggeven
Gebruik de indeling die bij je endpoint past:
Chat Completions API
Responses API
Stream redenering in het veld reasoning of reasoning_content van elke response-delta.
Voor Gemini-compatibele endpoints vraagt ElevenLabs gedachten op met
google.thinking_config.include_thoughts en leest het content die is gemarkeerd met
extra_content.google.thought.
Zie Reasoning summary voor opslag, levering en beperkingen.
Je eigen OpenAI-sleutel gebruiken
Om een aangepaste OpenAI-sleutel te integreren, werk je de instellingen van je agent in het ElevenLabs-dashboard bij zodat deze naar je aangepaste LLM-server verwijzen, en maak je een geheim met je OPENAI_API_KEY:
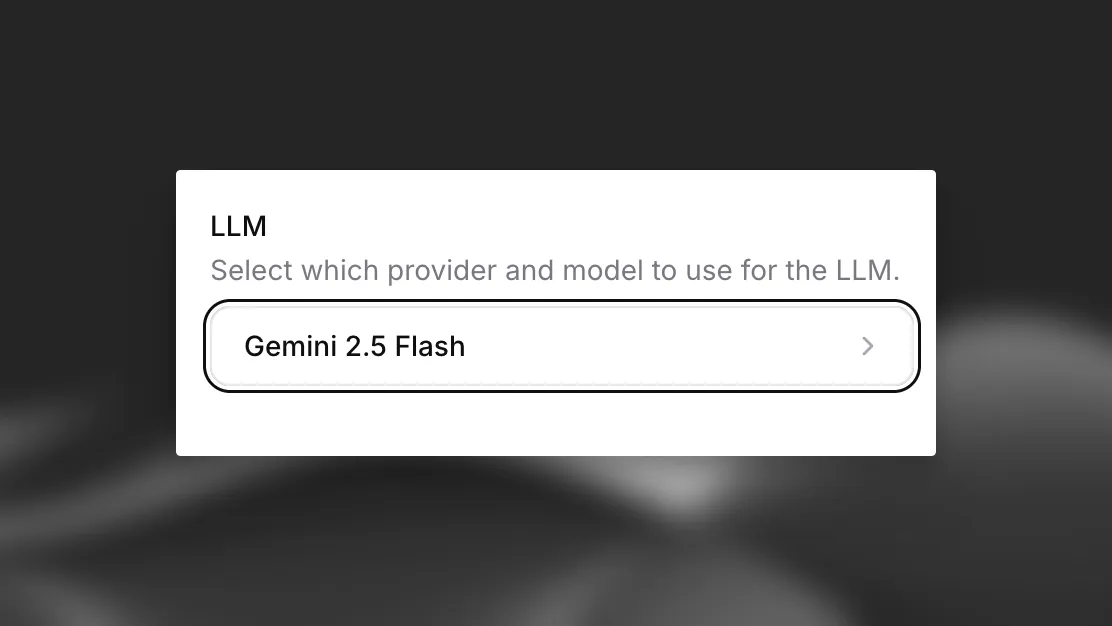
Selecteer in de agentinstellingen in het ElevenLabs-dashboard “Custom LLM” in het dropdownmenu “LLM” aan de rechterkant.
Aangepaste LLM-server
Om een aangepaste LLM-server te gebruiken, stel je een compatibel server-endpoint in volgens de stijl van OpenAI. Je kunt de Chat Completions API (/v1/chat/completions) of de Responses API (/v1/responses) implementeren.
Beide endpoints moeten responses retourneren in SSE-indeling (Server-Sent Events) met Content-Type: text/event-stream.
Chat Completions API
Responses API
De Chat Completions API gebruikt het endpoint /v1/chat/completions.
Elk chunk moet de indeling data: {json}\n\n hebben en de stream moet eindigen met data: [DONE]\n\n.
Hier is een voorbeeld van een serverimplementatie:
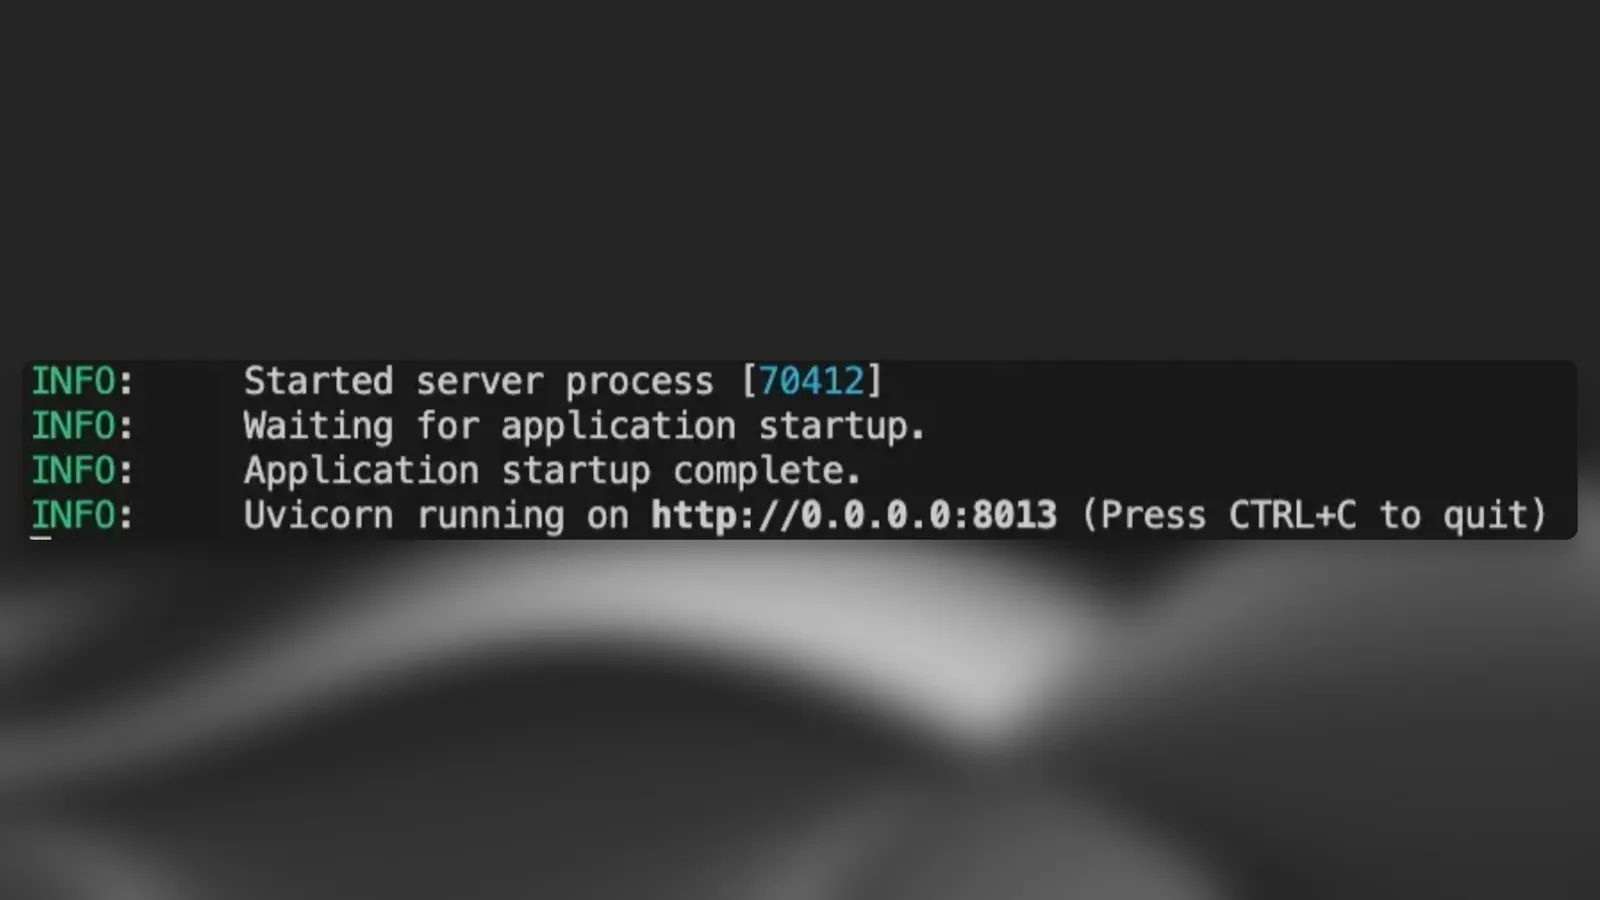
Voer deze code of je eigen servercode uit.
Een openbare URL instellen voor je server
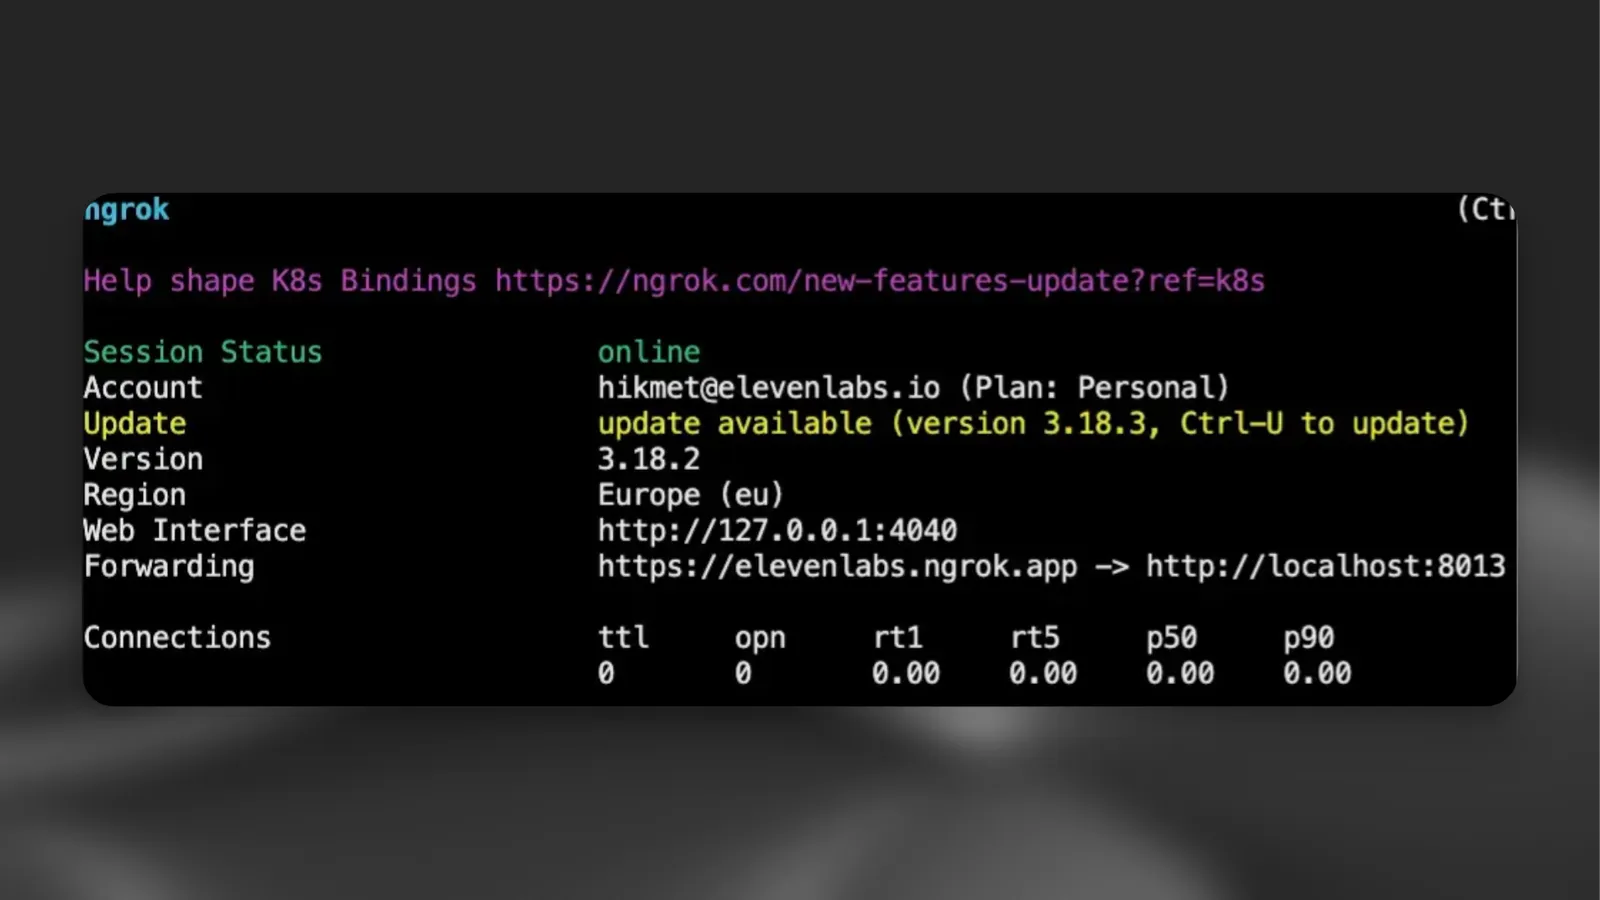
Maak je server toegankelijk door een openbare URL te maken met een tunnelingtool zoals ngrok:
ElevenLabs CustomLLM configureren
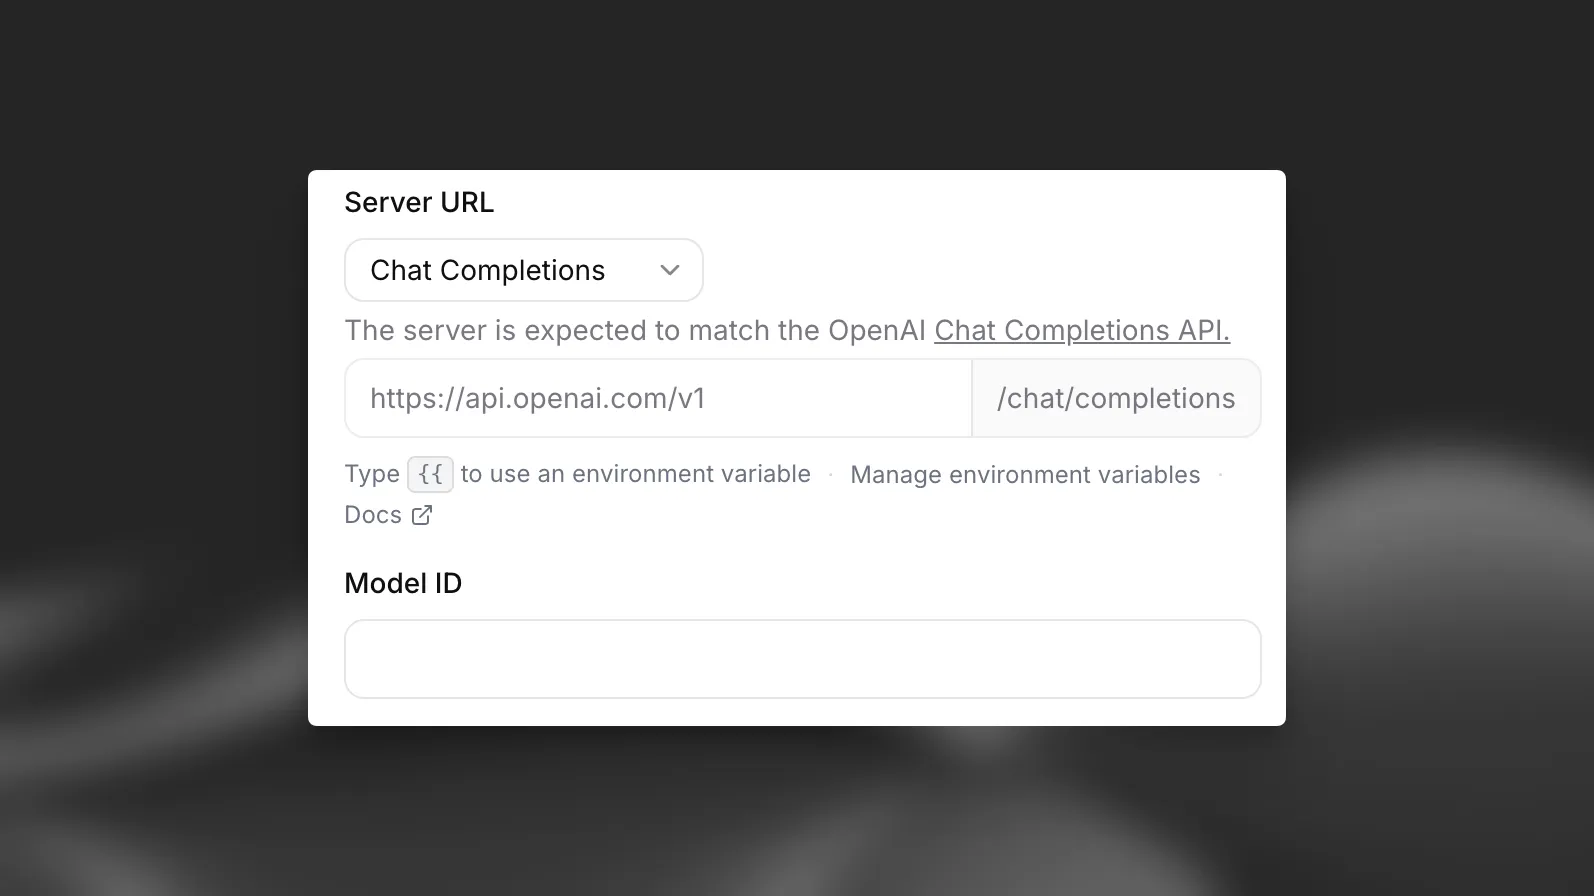
Werk vervolgens de instellingen van je agent in het ElevenLabs-dashboard bij zodat deze naar je aangepaste LLM-server verwijzen.
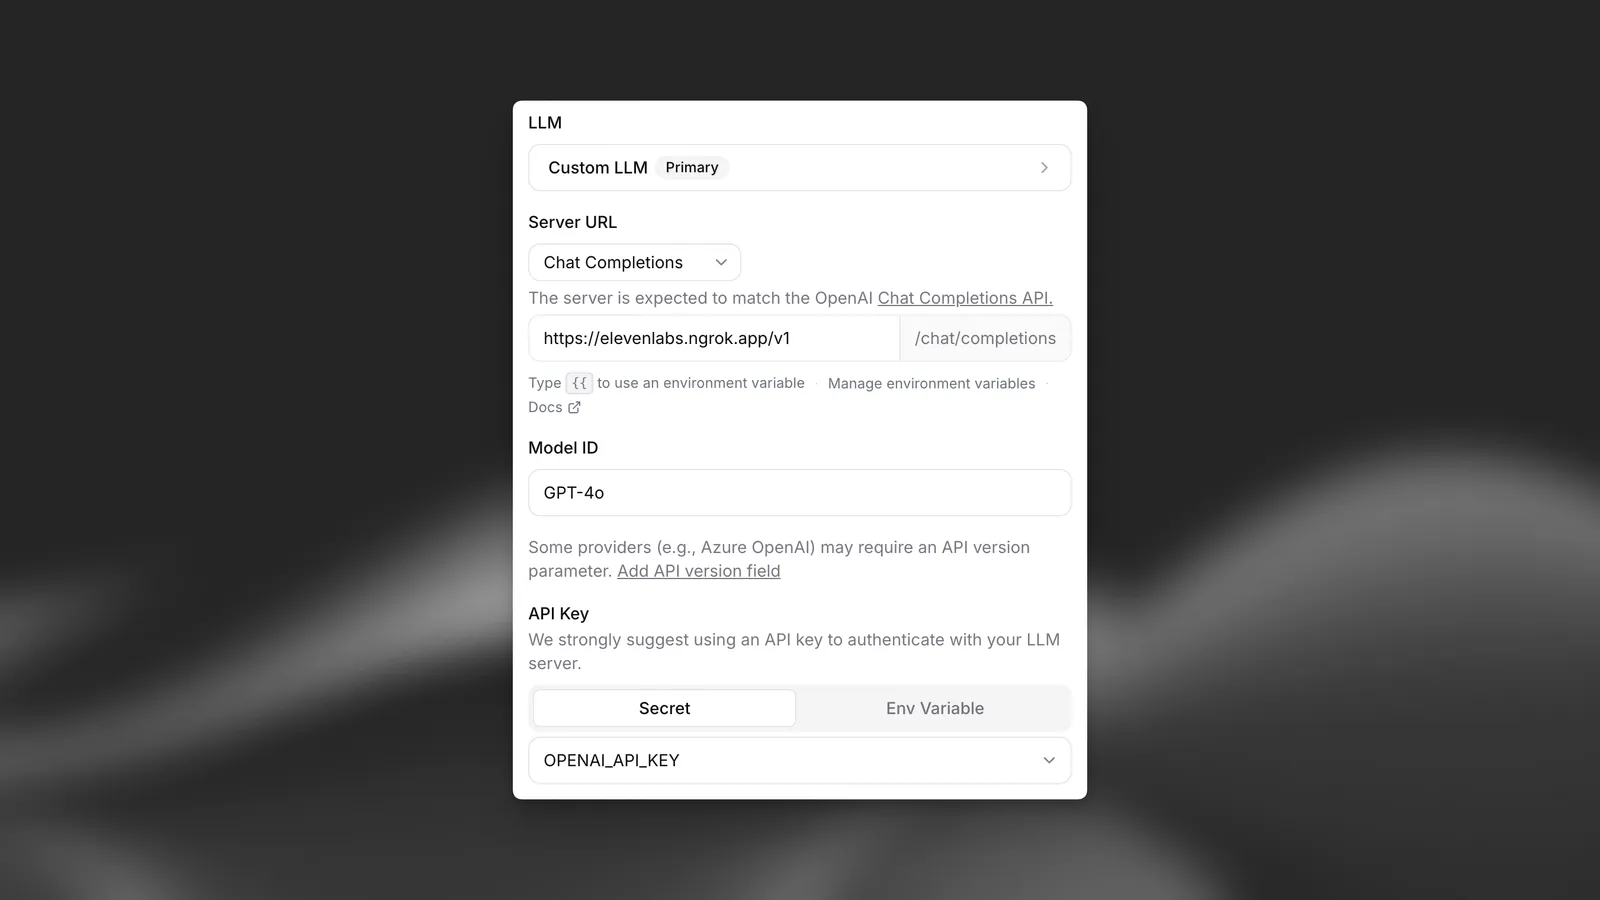
Verwijs je server-URL naar het ngrok-endpoint en stel “Limit token usage” in op 5000.
Je kunt nu met je agent en je eigen LLM-server communiceren.
Optimaliseren voor LLM’s met trage verwerking
Als je aangepaste LLM trage verwerkingstijden heeft (bijvoorbeeld vanwege agentische redenering of vereisten voor voorverwerking), kun je de gespreksflow verbeteren door bufferwoorden te implementeren in je streaming responses. Deze techniek helpt de natuurlijke spraakprosodie te behouden terwijl je LLM de volledige response genereert.
Bufferwoorden
Wanneer je LLM meer tijd nodig heeft om de volledige response te verwerken, geef je een eerste response terug die eindigt op "... " (beletselteken gevolgd door een spatie). Hierdoor kan het Text to Speech-systeem een natuurlijke flow behouden, terwijl het gesprek dynamisch blijft aanvoelen.
Dit creëert natuurlijke pauzes die goed overgaan in volgende content waarover het LLM langer kan redeneren. De extra spatie is cruciaal om te voorkomen dat de volgende content aan de ”…” wordt toegevoegd, wat tot audiovervormingen kan leiden.
Implementatie
Zo pas je je aangepaste LLM-server aan om bufferwoorden te implementeren:
Integratie van systeemtools
Je aangepaste LLM kan systeemtools activeren om de gespreksflow en -status te beheren. Deze tools worden automatisch opgenomen in de parameter tools van je chat-completion-requests wanneer ze zijn geconfigureerd in je agent.
Zo werken systeemtools
- LLM-beslissing: Je aangepaste LLM bepaalt op basis van de gesprekscontext wanneer deze tools moeten worden aangeroepen
- Toolresponse: Het LLM antwoordt met functieaanroepen in de standaardindeling van OpenAI
- Backendverwerking: ElevenLabs verwerkt de toolaanroepen en werkt de gespreksstatus bij
Zie voor meer informatie over systeemtools onze handleiding
Beschikbare systeemtools
Gesprek beëindigen
Doel: Gesprekken automatisch beëindigen wanneer aan de juiste voorwaarden is voldaan.
Triggervoorwaarden: Het LLM moet deze tool aanroepen wanneer:
- De hoofdtaak is voltooid en de gebruiker tevreden is
- Het gesprek met wederzijdse instemming tot een natuurlijk einde is gekomen
- De gebruiker expliciet aangeeft het gesprek te willen beëindigen
Parameters:
reason(string, vereist): De reden voor het beëindigen van het gesprekmessage(string, optioneel): Een afscheidsbericht dat vóór het beëindigen van het gesprek naar de gebruiker wordt gestuurd
Indeling van functieaanroep:
Implementatie: Configureer dit als systeemtool in je agentinstellingen. Het LLM ontvangt gedetailleerde instructies over wanneer deze functie moet worden aangeroepen.
Meer informatie: Tool voor gesprek beëindigen
Taaldetectie
Doel: Tijdens gesprekken automatisch overschakelen naar de gedetecteerde taal van de gebruiker.
Triggervoorwaarden: Het LLM moet deze tool aanroepen wanneer:
- De gebruiker een andere taal spreekt dan de huidige gesprekstaal
- De gebruiker expliciet vraagt om van taal te wisselen
- Ondersteuning voor meerdere talen nodig is voor het gesprek
Parameters:
reason(string, vereist): De reden voor de taalwissellanguage(string, vereist): De taalcode waarnaar moet worden gewisseld (moet in de lijst met ondersteunde talen staan)
Indeling van functieaanroep:
Implementatie: Configureer ondersteunde talen in de agentinstellingen en voeg de systeemtool voor taaldetectie toe. De agent wisselt automatisch van stem en responses om overeen te komen met gedetecteerde talen.
Meer informatie: Tool voor taaldetectie
Agentoverdracht
Doel: Gesprekken op basis van gebruikersbehoeften overdragen tussen gespecialiseerde AI-agents.
Triggervoorwaarden: Het LLM moet deze tool aanroepen wanneer:
- Het verzoek van de gebruiker gespecialiseerde kennis of andere agentmogelijkheden vereist
- De huidige agent de vraag niet adequaat kan afhandelen
- De gespreksflow aangeeft dat een ander type agent nodig is
Parameters:
reason(string, optioneel): De reden voor de agentoverdrachtagent_number(integer, vereist): Het nummer vanaf nul van de agent waarnaar moet worden overgedragen (op basis van geconfigureerde overdrachtsregels)
Indeling van functieaanroep:
Implementatie: Definieer overdrachtsregels die voorwaarden toewijzen aan specifieke agent-ID’s. Configureer naar welke agents de huidige agent kan overdragen. Agents worden met nummers vanaf nul aangeduid in de overdrachtsconfiguratie.
Meer informatie: Tool voor agentoverdracht
Overdragen aan een persoon
Doel: Gesprekken naadloos doorgeven aan menselijke medewerkers wanneer AI-ondersteuning onvoldoende is.
Triggervoorwaarden: Het LLM moet deze tool aanroepen wanneer:
- Er complexe problemen zijn die menselijk oordeel vereisen
- De gebruiker expliciet om menselijke hulp vraagt
- AI de grenzen van zijn mogelijkheden bereikt voor het specifieke verzoek
- Escalatieprotocollen worden geactiveerd
Parameters:
reason(string, optioneel): De reden voor de overdrachttransfer_number(string, vereist): Het telefoonnummer waarnaar moet worden overgedragen (moet overeenkomen met geconfigureerde nummers)client_message(string, vereist): Bericht dat aan de klant wordt voorgelezen tijdens het wachten op overdrachtagent_message(string, vereist): Bericht voor de menselijke medewerker die het gesprek ontvangt
Indeling van functieaanroep:
Implementatie: Configureer telefoonnummers en voorwaarden voor overdracht. Definieer berichten voor zowel de klant als de ontvangende menselijke medewerker. Werkt met zowel Twilio als SIP-trunking.
Meer informatie: Tool voor overdracht aan een persoon
Beurt overslaan
Doel: De agent laten pauzeren en wachten op gebruikersinvoer zonder te spreken.
Triggervoorwaarden: Het LLM moet deze tool aanroepen wanneer:
- De gebruiker aangeeft even tijd nodig te hebben (“Geef me een moment”, “Even nadenken”)
- De gebruiker vraagt om een pauze in de gespreksflow
- De agent detecteert dat de gebruiker tijd nodig heeft om informatie te verwerken
Parameters:
reason(string, optioneel): Vrije tekst die uitlegt waarom de pauze nodig is
Indeling van functieaanroep:
Implementatie: Geen extra configuratie nodig. De tool geeft de agent simpelweg het signaal om stil te blijven totdat de gebruiker opnieuw spreekt.
Meer informatie: Tool voor beurt overslaan
Voicemaildetectie
Parameters:
reason(string, verplicht): De reden voor het detecteren van voicemail (bijvoorbeeld “geautomatiseerde begroeting gedetecteerd”, “geen menselijke reactie”)
Indeling van functieaanroep:
Meer informatie: Tool voor voicemaildetectie
Voorbeeldrequest met systeemtools
Wanneer systeemtools zijn geconfigureerd, ontvangt je aangepaste LLM requests waarin de tools zijn opgenomen in de standaardindeling van OpenAI:
Je aangepaste LLM moet function calling ondersteunen om systeemtools te gebruiken. Zorg dat je model correcte responses voor functieaanroepen in OpenAI-indeling kan genereren.
Extra functies
Aangepaste LLM-parameters
Je kunt aanvullende parameters doorgeven aan je aangepaste LLM-implementatie.