자체 모델 통합

에이전트를 자체 LLM에 연결하거나 자체 서버를 호스팅하세요.

Custom LLM을 사용하면 외부 엔드포인트를 통해 대화를 자체 LLM에 연결할 수 있습니다. ElevenLabs는 기본 통합 LLM도 지원합니다.

사용자 지정 LLM을 사용하면 자체 OpenAI API 키를 가져오거나 완전히 사용자 지정된 LLM 서버를 실행할 수 있습니다.

개요

기본적으로 OpenAI와 같은 인기 모델에는 ElevenLabs의 내부 자격 증명을 사용합니다. 사용자 지정 LLM 서버를 사용하려면 다음 OpenAI 호환 요청/응답 구조 중 하나를 따라야 합니다.

Responses API는 추가 기능을 지원하는 OpenAI의 최신 API 형식입니다. 두 API 형식 모두 사용자 지정 LLM 통합에 완전히 지원됩니다.

다음 가이드에서는 두 가지 사용 사례를 다룹니다.

  1. 자체 OpenAI 키 사용: 자체 OpenAI API 키를 플랫폼과 함께 사용합니다.
  2. 사용자 지정 LLM 서버: 자체 LLM 서버 구현을 호스팅하고 연결합니다.

다음 방법을 알아봅니다.

  • ElevenLabs에 OpenAI API 키 저장
  • OpenAI의 Chat Completions 또는 Responses 엔드포인트를 복제하는 서버 호스팅
  • ElevenLabs를 사용자 지정 엔드포인트로 연결
  • 필요에 따라 LLM에 추가 매개변수 전달

추론 요약

엔드포인트는 최종 답변과 별도로 추론을 반환해야 합니다. ElevenLabs는 최종 답변에서 추론을 생성하지 않습니다.

지원되는 엔드포인트에서 추론을 요청하려면 에이전트의 LLM 설정에서 추론 요약을 켜거나 API를 통해 enable_reasoning_summary를 설정하세요.

추론 반환

엔드포인트에 맞는 형식을 사용하세요.

각 응답 델타의 reasoning 또는 reasoning_content 필드에서 추론을 스트리밍하세요.

Gemini 호환 엔드포인트의 경우 ElevenLabs는 google.thinking_config.include_thoughts로 생각을 요청하고 extra_content.google.thought로 표시된 콘텐츠를 읽습니다.

저장, 전달 및 제한 사항은 추론 요약을 참조하세요.

자체 OpenAI 키 사용

사용자 지정 OpenAI 키를 통합하려면 ElevenLabs 대시보드에서 에이전트 설정을 업데이트하여 사용자 지정 LLM 서버를 가리키도록 하고, OPENAI_API_KEY가 포함된 시크릿을 만드세요.
1

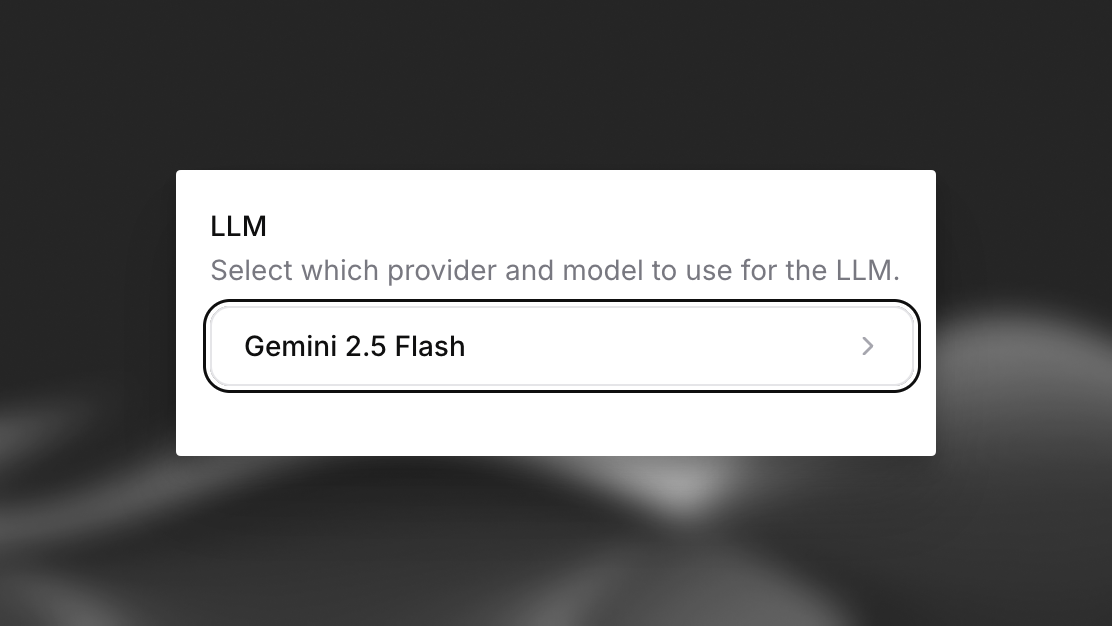
ElevenLabs 대시보드의 Agent 설정에서 오른쪽 “LLM” 드롭다운 메뉴의 “Custom LLM”을 선택하세요.

시크릿 추가

2

“LLM” 아래 필드를 클릭하고 아래로 스크롤해 “Custom LLM”을 선택하세요.

3

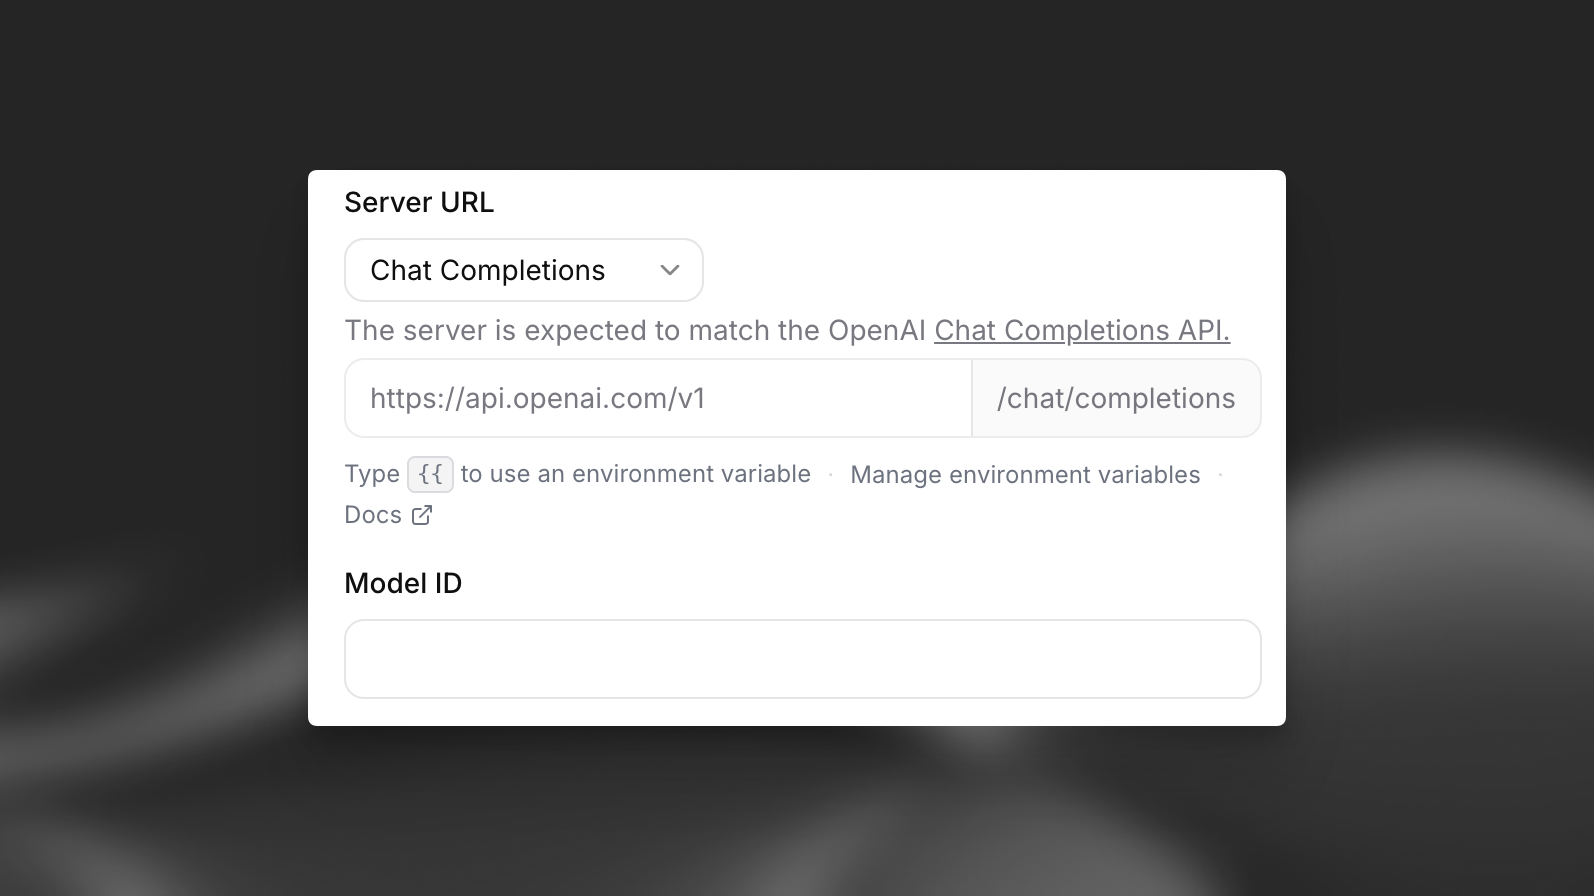
사용자 지정 LLM 서버의 서버 URL과 Model ID를 입력하세요.

URL 입력

4

“API key” 아래 드롭다운을 클릭하고 “Create new secret”을 선택하세요. 키 이름을 OPENAI_API_KEY로 지정하고 “value” 필드에 키를 추가한 다음 “Add secret”을 클릭하세요.

5

“x” 버튼을 클릭해 LLM 모달을 닫고 “Publish”를 클릭해 변경 사항을 저장하세요.

사용자 지정 LLM 서버

사용자 지정 LLM 서버를 사용하려면 OpenAI 스타일을 따르는 호환 서버 엔드포인트를 설정하세요. Chat Completions API (/v1/chat/completions) 또는 Responses API (/v1/responses) 중 하나를 구현할 수 있습니다.

두 엔드포인트는 모두 Content-Type: text/event-stream을 사용하는 SSE(Server-Sent Events) 형식으로 응답을 반환해야 합니다.

Chat Completions API는 /v1/chat/completions 엔드포인트를 사용합니다.

각 청크는 data: {json}\n\n 형식이어야 하며, 스트림은 data: [DONE]\n\n으로 끝나야 합니다.

다음은 서버 구현 예시입니다.

import json
import os
import fastapi
from fastapi.responses import StreamingResponse
from openai import AsyncOpenAI
import uvicorn
import logging
from dotenv import load_dotenv
from pydantic import BaseModel
from typing import List, Optional
# Load environment variables from .env file
load_dotenv()
# Retrieve API key from environment
OPENAI_API_KEY = os.getenv('OPENAI_API_KEY')
if not OPENAI_API_KEY:
raise ValueError("OPENAI_API_KEY not found in environment variables")
app = fastapi.FastAPI()
oai_client = AsyncOpenAI(api_key=OPENAI_API_KEY)
class Message(BaseModel):
role: str
content: str
class ChatCompletionRequest(BaseModel):
messages: List[Message]
model: str
temperature: Optional[float] = 0.7
max_tokens: Optional[int] = None
stream: Optional[bool] = False
user_id: Optional[str] = None
@app.post("/v1/chat/completions")
async def create_chat_completion(request: ChatCompletionRequest) -> StreamingResponse:
oai_request = request.dict(exclude_none=True)
if "user_id" in oai_request:
oai_request["user"] = oai_request.pop("user_id")
chat_completion_coroutine = await oai_client.chat.completions.create(**oai_request)
async def event_stream():
try:
async for chunk in chat_completion_coroutine:
# Convert the ChatCompletionChunk to a dictionary before JSON serialization
chunk_dict = chunk.model_dump()
yield f"data: {json.dumps(chunk_dict)}\n\n"
yield "data: [DONE]\n\n"
except Exception as e:
logging.error("An error occurred: %s", str(e))
yield f"data: {json.dumps({'error': 'Internal error occurred!'})}\n\n"
return StreamingResponse(event_stream(), media_type="text/event-stream")
if __name__ == "__main__":
uvicorn.run(app, host="0.0.0.0", port=8013)

이 코드를 실행하거나 자체 서버 코드를 실행하세요.

서버용 공개 URL 설정

서버에 액세스할 수 있도록 ngrok과 같은 터널링 도구를 사용해 공개 URL을 만드세요.
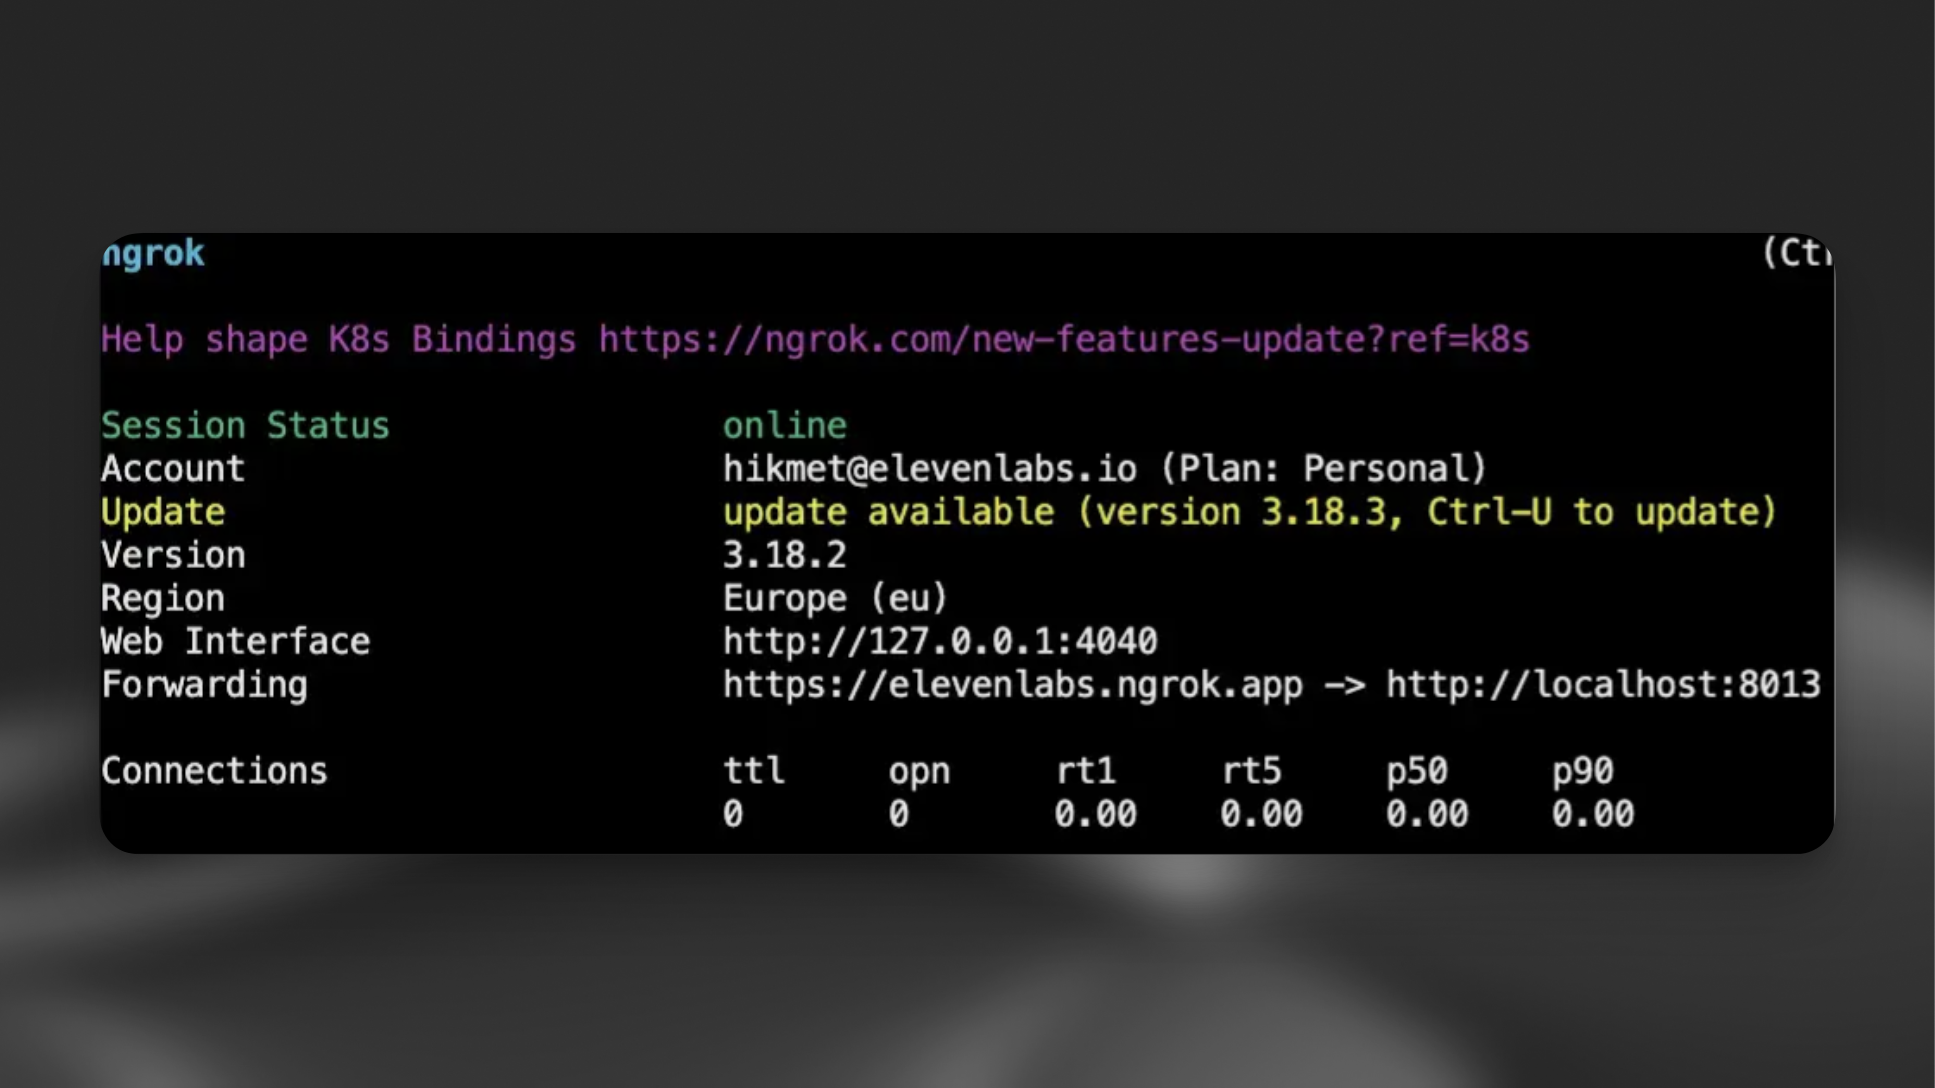
ngrok http --url=<Your url>.ngrok.app 8013

ElevenLabs CustomLLM 구성

다음으로 ElevenLabs 대시보드에서 에이전트 설정을 업데이트하여 사용자 지정 LLM 서버를 가리키도록 하세요.
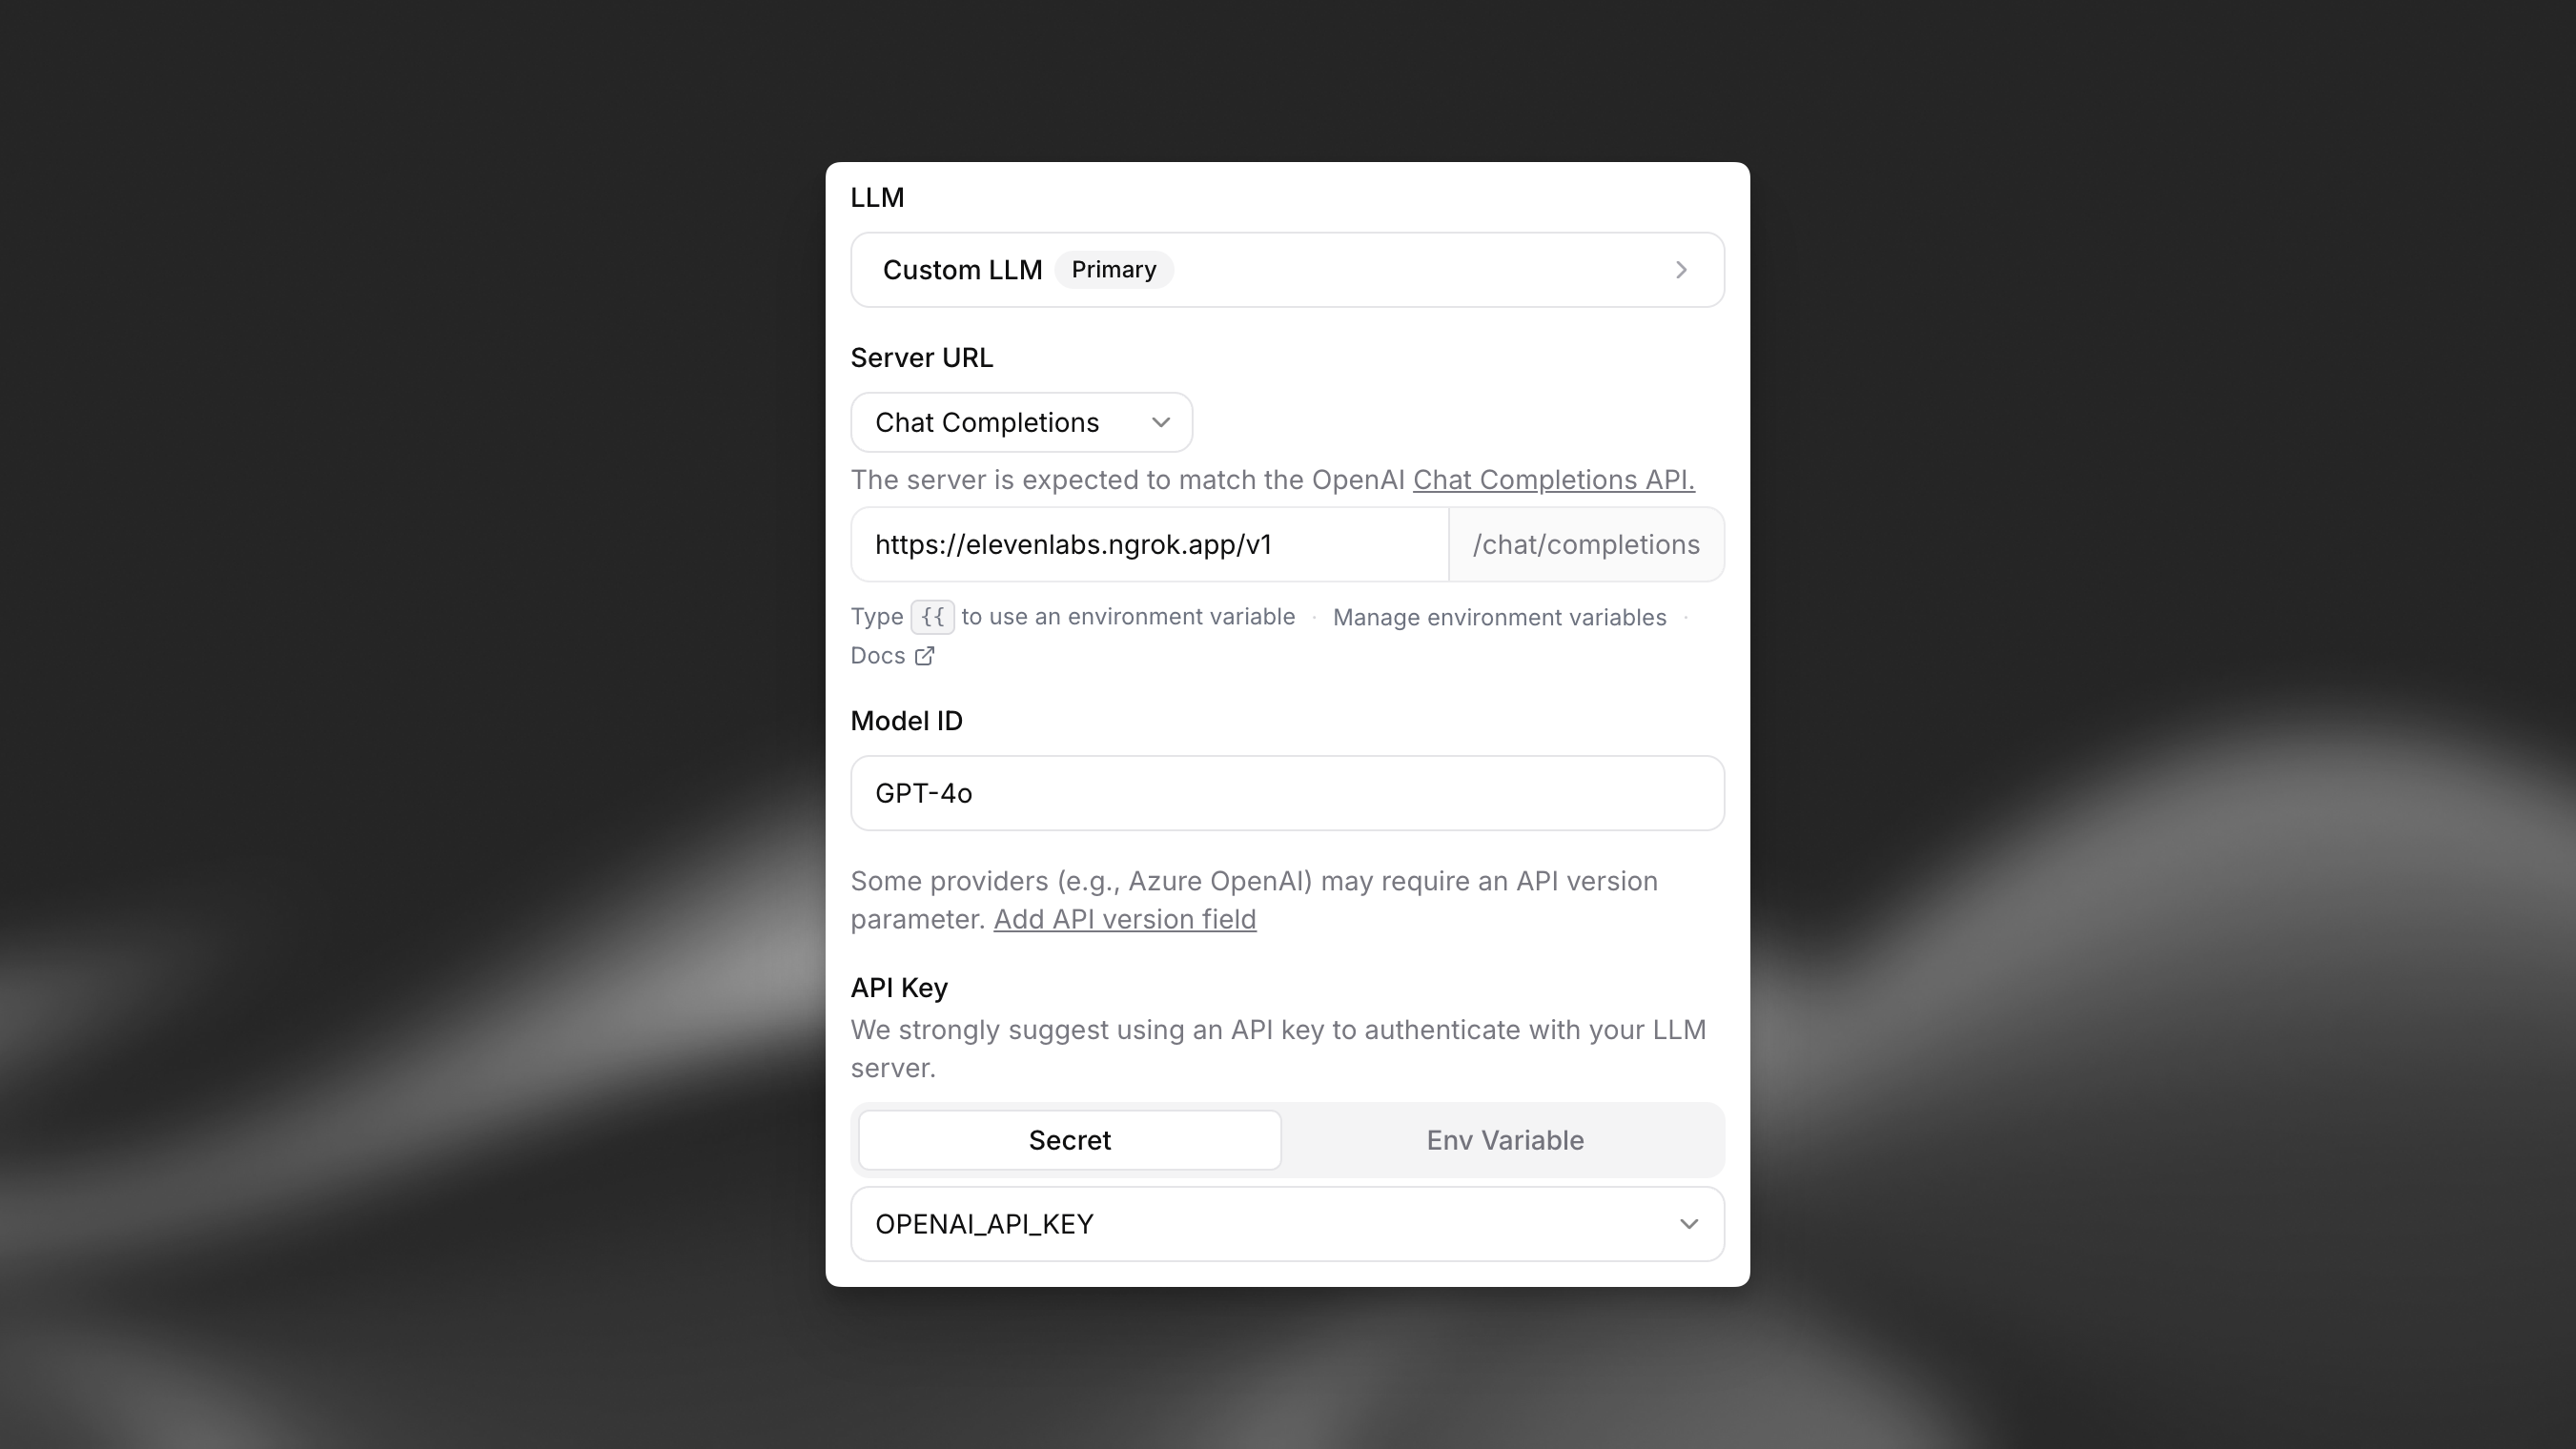
서버 URL을 ngrok 엔드포인트로 지정하고 “Limit token usage”를 5000으로 설정하세요.

이제 자체 LLM 서버로 에이전트와 상호작용할 수 있습니다.

처리 속도가 느린 LLM 최적화

사용자 지정 LLM의 처리 시간이 느린 경우(에이전트형 추론 또는 사전 처리 요구 사항 등) 스트리밍 응답에 버퍼 단어를 구현하여 대화 흐름을 개선할 수 있습니다. 이 기법은 LLM이 전체 응답을 생성하는 동안 자연스러운 음성 운율을 유지하는 데 도움이 됩니다.

버퍼 단어

LLM이 전체 응답을 처리하는 데 시간이 더 필요한 경우, "... "(줄임표 뒤 공백)으로 끝나는 초기 응답을 반환하세요. 이렇게 하면 텍스트 음성 변환 시스템이 자연스러운 흐름을 유지하면서 대화가 역동적으로 느껴지게 할 수 있습니다. 이 방식은 LLM이 더 오래 추론할 수 있는 후속 콘텐츠로 자연스럽게 이어지는 일시 정지를 만듭니다. 후속 콘텐츠가 "..."에 이어 붙어 오디오 왜곡이 발생하는 것을 방지하려면 추가 공백이 매우 중요합니다.

구현

버퍼 단어를 구현하도록 사용자 지정 LLM 서버를 수정하는 방법은 다음과 같습니다.

@app.post("/v1/chat/completions")
async def create_chat_completion(request: ChatCompletionRequest) -> StreamingResponse:
oai_request = request.dict(exclude_none=True)
if "user_id" in oai_request:
oai_request["user"] = oai_request.pop("user_id")
async def event_stream():
try:
# Send initial buffer chunk while processing
initial_chunk = {
"id": "chatcmpl-buffer",
"object": "chat.completion.chunk",
"created": 1234567890,
"model": request.model,
"choices": [{
"delta": {"content": "Let me think about that... "},
"index": 0,
"finish_reason": None
}]
}
yield f"data: {json.dumps(initial_chunk)}\n\n"
# Process the actual LLM response
chat_completion_coroutine = await oai_client.chat.completions.create(**oai_request)
async for chunk in chat_completion_coroutine:
chunk_dict = chunk.model_dump()
yield f"data: {json.dumps(chunk_dict)}\n\n"
yield "data: [DONE]\n\n"
except Exception as e:
logging.error("An error occurred: %s", str(e))
yield f"data: {json.dumps({'error': 'Internal error occurred!'})}\n\n"
return StreamingResponse(event_stream(), media_type="text/event-stream")

시스템 도구 통합

사용자 지정 LLM은 시스템 도구를 트리거하여 대화 흐름과 상태를 제어할 수 있습니다. 이러한 도구는 에이전트에서 구성하면 채팅 완료 요청의 tools 매개변수에 자동으로 포함됩니다.

시스템 도구 작동 방식

  1. LLM 결정: 사용자 지정 LLM은 대화 맥락에 따라 이러한 도구를 호출할 시점을 결정합니다.
  2. 도구 응답: LLM은 표준 OpenAI 형식의 함수 호출로 응답합니다.
  3. 백엔드 처리: ElevenLabs는 도구 호출을 처리하고 대화 상태를 업데이트합니다.

시스템 도구에 관한 자세한 내용은 가이드를 참조하세요.

사용 가능한 시스템 도구

목적: 적절한 조건이 충족되면 대화를 자동으로 종료합니다.

트리거 조건: 다음 경우에 LLM이 이 도구를 호출해야 합니다.

  • 주요 작업이 완료되었고 사용자가 만족한 경우
  • 상호 합의하에 대화가 자연스럽게 마무리된 경우
  • 사용자가 대화 종료 의사를 명시적으로 밝힌 경우

매개변수:

  • reason(문자열, 필수): 통화를 종료하는 이유
  • message(문자열, 선택 사항): 통화 종료 전 사용자에게 보낼 작별 메시지

함수 호출 형식:

{
"type": "function",
"function": {
"name": "end_call",
"arguments": "{\"reason\": \"Task completed successfully\", \"message\": \"Thank you for using our service. Have a great day!\"}"
}
}

구현: 에이전트 설정에서 시스템 도구로 구성하세요. LLM은 이 함수를 호출할 시점에 관한 자세한 지침을 받습니다.

자세히 알아보기: 통화 종료 도구

목적: 대화 중 감지된 사용자의 언어로 자동 전환합니다.

트리거 조건: 다음 경우에 LLM이 이 도구를 호출해야 합니다.

  • 사용자가 현재 대화 언어와 다른 언어로 말하는 경우
  • 사용자가 언어 전환을 명시적으로 요청하는 경우
  • 대화에 다국어 지원이 필요한 경우

매개변수:

  • reason(문자열, 필수): 언어 전환 이유
  • language(문자열, 필수): 전환할 언어 코드(지원 언어 목록에 있어야 함)

함수 호출 형식:

{
"type": "function",
"function": {
"name": "language_detection",
"arguments": "{\"reason\": \"User requested Spanish\", \"language\": \"es\"}"
}
}

구현: 에이전트 설정에서 지원 언어를 구성하고 언어 감지 시스템 도구를 추가하세요. 에이전트는 감지된 언어에 맞춰 음성과 응답을 자동으로 전환합니다.

자세히 알아보기: 언어 감지 도구

목적: 사용자 요구에 따라 전문 AI 에이전트 간에 대화를 전환합니다.

트리거 조건: 다음 경우에 LLM이 이 도구를 호출해야 합니다.

  • 사용자 요청에 전문 지식 또는 다른 에이전트 기능이 필요한 경우
  • 현재 에이전트가 쿼리를 적절하게 처리할 수 없는 경우
  • 대화 흐름상 다른 유형의 에이전트가 필요한 경우

매개변수:

  • reason(문자열, 선택 사항): 에이전트 전환 이유
  • agent_number(정수, 필수): 전환할 에이전트의 0부터 시작하는 번호(구성된 전환 규칙 기준)

함수 호출 형식:

{
"type": "function",
"function": {
"name": "transfer_to_agent",
"arguments": "{\"reason\": \"User needs billing support\", \"agent_number\": 0}"
}
}

구현: 조건을 특정 에이전트 ID에 매핑하는 전환 규칙을 정의하세요. 현재 에이전트가 전환할 수 있는 에이전트를 구성하세요. 에이전트는 전환 구성에서 0부터 시작하는 번호로 참조됩니다.

자세히 알아보기: 에이전트 전환 도구

목적: AI 지원이 충분하지 않을 때 대화를 상담원에게 원활하게 인계합니다.

트리거 조건: 다음 경우에 LLM이 이 도구를 호출해야 합니다.

  • 사람의 판단이 필요한 복잡한 문제인 경우
  • 사용자가 상담원 지원을 명시적으로 요청하는 경우
  • 특정 요청에 대해 AI의 역량 한계에 도달한 경우
  • 에스컬레이션 프로토콜이 트리거된 경우

매개변수:

  • reason(문자열, 선택 사항): 전환 이유
  • transfer_number(문자열, 필수): 전환할 전화번호(구성된 번호와 일치해야 함)
  • client_message(문자열, 필수): 전환을 기다리는 동안 고객에게 읽어줄 메시지
  • agent_message(문자열, 필수): 통화를 받는 상담원에게 전달할 메시지

함수 호출 형식:

{
"type": "function",
"function": {
"name": "transfer_to_number",
"arguments": "{\"reason\": \"Complex billing issue\", \"transfer_number\": \"+15551234567\", \"client_message\": \"I'm transferring you to a billing specialist who can help with your account.\", \"agent_message\": \"Customer has a complex billing dispute about order #12345 from last month.\"}"
}
}

구현: 전환 전화번호와 조건을 구성하세요. 고객과 통화를 받는 상담원 모두를 위한 메시지를 정의하세요. Twilio 및 SIP 트렁킹 모두에서 작동합니다.

자세히 알아보기: 상담원에게 전환 도구

목적: 에이전트가 말하지 않고 일시 정지하여 사용자 입력을 기다릴 수 있게 합니다.

트리거 조건: 다음 경우에 LLM이 이 도구를 호출해야 합니다.

  • 사용자가 잠시 시간이 필요하다고 말하는 경우(“잠깐만요”, “생각해 볼게요”)
  • 사용자가 대화 흐름의 일시 정지를 요청하는 경우
  • 에이전트가 사용자가 정보를 처리할 시간이 필요하다고 감지한 경우

매개변수:

  • reason(문자열, 선택 사항): 일시 정지가 필요한 이유를 설명하는 자유 형식의 사유

함수 호출 형식:

{
"type": "function",
"function": {
"name": "skip_turn",
"arguments": "{\"reason\": \"User requested time to think\"}"
}
}

구현: 추가 구성은 필요하지 않습니다. 이 도구는 사용자가 다시 말할 때까지 에이전트가 침묵 상태를 유지하도록 신호만 보냅니다.

자세히 알아보기: 턴 건너뛰기 도구

파라미터:

  • reason (문자열, 필수): 음성사서함 감지 사유(예: “자동 안내 감지됨”, “사람의 응답 없음”)

함수 호출 형식:

{
"type": "function",
"function": {
"name": "voicemail_detection",
"arguments": "{\"reason\": \"Automated greeting detected with request to leave message\"}"
}
}

자세히 알아보기: 음성사서함 감지 도구

시스템 도구가 포함된 요청 예시

시스템 도구를 구성하면 사용자 지정 LLM은 표준 OpenAI 형식으로 도구가 포함된 요청을 받습니다.

{
"messages": [
{
"role": "system",
"content": "You are a helpful assistant. You have access to system tools for managing conversations."
},
{
"role": "user",
"content": "I think we're done here, thanks for your help!"
}
],
"model": "your-custom-model",
"temperature": 0.7,
"max_tokens": 1000,
"stream": true,
"tools": [
{
"type": "function",
"function": {
"name": "end_call",
"description": "Call this function to end the current conversation when the main task has been completed...",
"parameters": {
"type": "object",
"properties": {
"reason": {
"type": "string",
"description": "The reason for the tool call."
},
"message": {
"type": "string",
"description": "A farewell message to send to the user along right before ending the call."
}
},
"required": ["reason"]
}
}
},
{
"type": "function",
"function": {
"name": "language_detection",
"description": "Change the conversation language when the user expresses a language preference explicitly...",
"parameters": {
"type": "object",
"properties": {
"reason": {
"type": "string",
"description": "The reason for the tool call."
},
"language": {
"type": "string",
"description": "The language to switch to. Must be one of language codes in tool description."
}
},
"required": ["reason", "language"]
}
}
},
{
"type": "function",
"function": {
"name": "skip_turn",
"description": "Skip a turn when the user explicitly indicates they need a moment to think...",
"parameters": {
"type": "object",
"properties": {
"reason": {
"type": "string",
"description": "Optional free-form reason explaining why the pause is needed."
}
},
"required": []
}
}
}
]
}

시스템 도구를 사용하려면 사용자 지정 LLM이 함수 호출을 지원해야 합니다. 모델이 OpenAI 형식의 올바른 함수 호출 응답을 생성할 수 있는지 확인하세요.

추가 기능

사용자 지정 LLM 구현에 추가 매개변수를 전달할 수 있습니다.

1

추가 매개변수 정의

사용자 지정 매개변수가 포함된 객체를 만드세요.

from elevenlabs.conversational_ai.conversation import Conversation, ConversationInitiationData
extra_body_for_convai = {
"UUID": "123e4567-e89b-12d3-a456-426614174000",
"parameter-1": "value-1",
"parameter-2": "value-2",
}
config = ConversationInitiationData(
extra_body=extra_body_for_convai,
)
2

LLM 구현 업데이트

추가 매개변수를 처리하도록 사용자 지정 LLM 코드를 수정하세요.

import json
import os
import fastapi
from fastapi.responses import StreamingResponse
from fastapi import Request
from openai import AsyncOpenAI
import uvicorn
import logging
from dotenv import load_dotenv
from pydantic import BaseModel
from typing import List, Optional
# Load environment variables from .env file
load_dotenv()
# Retrieve API key from environment
OPENAI_API_KEY = os.getenv('OPENAI_API_KEY')
if not OPENAI_API_KEY:
raise ValueError("OPENAI_API_KEY not found in environment variables")
app = fastapi.FastAPI()
oai_client = AsyncOpenAI(api_key=OPENAI_API_KEY)
class Message(BaseModel):
role: str
content: str
class ChatCompletionRequest(BaseModel):
messages: List[Message]
model: str
temperature: Optional[float] = 0.7
max_tokens: Optional[int] = None
stream: Optional[bool] = False
user_id: Optional[str] = None
elevenlabs_extra_body: Optional[dict] = None
@app.post("/v1/chat/completions")
async def create_chat_completion(request: ChatCompletionRequest) -> StreamingResponse:
oai_request = request.dict(exclude_none=True)
print(oai_request)
if "user_id" in oai_request:
oai_request["user"] = oai_request.pop("user_id")
if "elevenlabs_extra_body" in oai_request:
oai_request.pop("elevenlabs_extra_body")
chat_completion_coroutine = await oai_client.chat.completions.create(**oai_request)
async def event_stream():
try:
async for chunk in chat_completion_coroutine:
chunk_dict = chunk.model_dump()
yield f"data: {json.dumps(chunk_dict)}\n\n"
yield "data: [DONE]\n\n"
except Exception as e:
logging.error("An error occurred: %s", str(e))
yield f"data: {json.dumps({'error': 'Internal error occurred!'})}\n\n"
return StreamingResponse(event_stream(), media_type="text/event-stream")
if __name__ == "__main__":
uvicorn.run(app, host="0.0.0.0", port=8013)

요청 예시

이 사용자 지정 메시지 설정을 사용하면 LLM은 다음 형식의 요청을 받습니다.

{
"messages": [
{
"role": "system",
"content": "\n <Redacted>"
},
{
"role": "assistant",
"content": "Hey I'm currently unavailable."
},
{
"role": "user",
"content": "Hey, who are you?"
}
],
"model": "gpt-4o",
"temperature": 0.5,
"max_tokens": 5000,
"stream": true,
"elevenlabs_extra_body": {
"UUID": "123e4567-e89b-12d3-a456-426614174000",
"parameter-1": "value-1",
"parameter-2": "value-2"
}
}