Vai alla navigazione

Tracce OpenTelemetry

Esporta le tracce OpenTelemetry nel tuo stack di osservabilità come JSON OTLP.

Gli agenti di ElevenLabs possono esportare le conversazioni come tracce OpenTelemetry codificate come JSON OTLP (resourceSpans). Inoltrale a Datadog, Grafana Tempo, Honeycomb o a qualsiasi backend che acquisisca OTLP.

ElevenLabs non invia le tracce direttamente al tuo collector OTLP. Ricevi JSON in formato OTLP da un webhook, un’API o un WebSocket di monitoraggio e lo inoltri al tuo backend.

Panoramica

Esporta le tracce da tre superfici. Tutte e tre condividono lo stesso ID traccia per conversazione e la denominazione degli attributi elevenlabs.*. La struttura e le tempistiche degli span differiscono tra post-chiamata/GET (basati sulla trascrizione) e monitoraggio (basato sugli eventi).

Superfici di esportazione

SuperficieQuando ricevi i datiIdeale per
Webhook post-chiamataDopo la fine della conversazione e dell’analisiPipeline batch, fatturazione e QA, storage durevole
API GET della conversazioneSu richiesta, dopo la creazione della conversazioneBackfill, debugging, rielaborazione
WebSocket di monitoraggioDurante una conversazione in tempo realeDashboard in tempo reale, avvisi, human-in-the-loop

Scegliere una superficie

  • Ogni chiamata completata nel tuo data warehouse: webhook post-chiamata
  • Esportazione o correzione una tantum: GET della conversazione con format=opentelemetry
  • Interfaccia supervisore o avvisi in tempo reale: WebSocket di monitoraggio
  • Timeline completa a posteriori: webhook post-chiamata o GET della conversazione
  • Eventi di tool, MCP o guardrail nel momento in cui si verificano: WebSocket di monitoraggio

Usa traceId o elevenlabs.conversation_id per unire i dati tra le superfici. Combina il monitoraggio per le operazioni in tempo reale, i webhook per analisi durevoli e GET per il backfill.

Per ogni superficie ti serve un collector compatibile con OTLP o un provider di osservabilità. I webhook post-chiamata richiedono un endpoint webhook del workspace. L’API GET e il WebSocket di monitoraggio hanno ciascuno i propri scope per le chiavi API e la propria configurazione; consulta le sezioni seguenti.

Webhook post-chiamata

Al termine di una conversazione, ElevenLabs invia una richiesta POST quando è configurato un webhook post-chiamata, events include transcript e transcript_format è opentelemetry.

Il type del webhook è post_call_transcription_otel (non post_call_transcription, che restituisce trascrizioni JSON).

Payload del webhook

{
"type": "post_call_transcription_otel",
"event_timestamp": 1700000000,
"data": {
"conversation_id": "conv_9001k1zph3fkeh5s8xg9z90swaqa",
"agent_id": "agent_7101k5zvyjhmfg983brhmhkd98n6",
"otlp_traces": {
"resourceSpans": []
}
}
}

Abilitare le trascrizioni OpenTelemetry

1

Crea un webhook del workspace

Nella Dashboard di ElevenAgents, crea un webhook del workspace con il tuo URL HTTPS e l’autenticazione.

2

Collega il webhook post-chiamata

Apri le impostazioni degli agenti, assegna il webhook come webhook post-chiamata, abilita l’evento Trascrizione e attiva i payload di trascrizione OpenTelemetry.
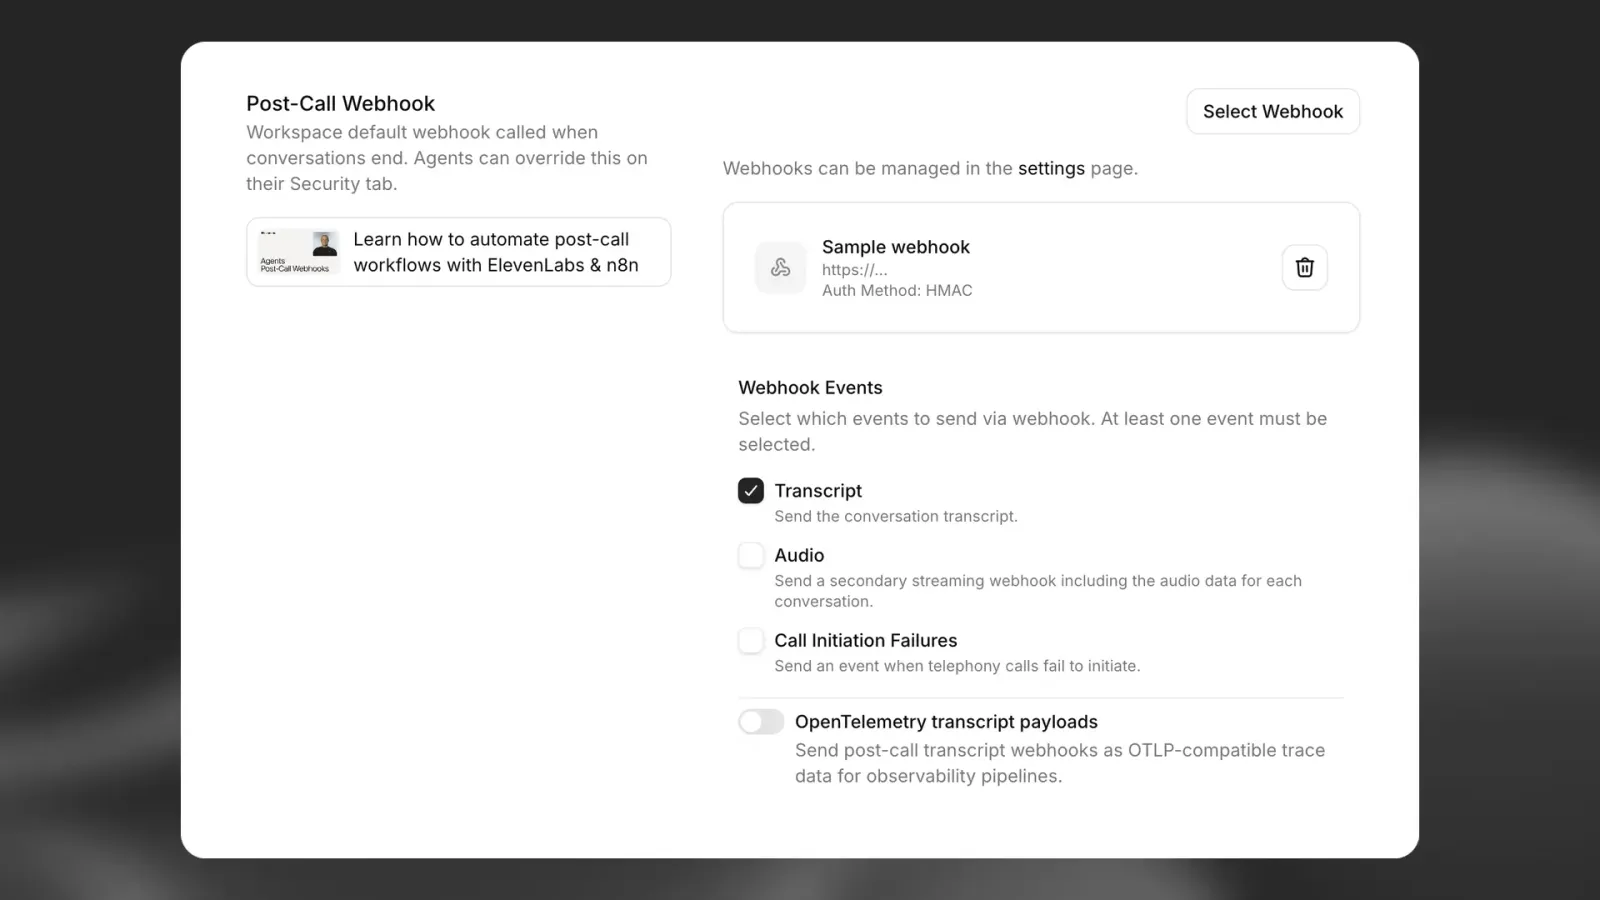
Impostazioni del webhook post-chiamata

I webhook di trascrizione OpenTelemetry non includono l’audio. Usa post_call_audio se ti servono le registrazioni.

Restituisci 2xx in caso di successo. 4xx e 5xx sono considerati errori.

I tentativi si applicano ai webhook di trascrizione (incluso OpenTelemetry) e audio solo quando Abilita ritentativi è attivo per il webhook del workspace. Gli errori transitori (** 5xx **, **429 **, **408 **) vengono ritentati fino a 5 volte; 4xx no. Errori ripetuti possono disabilitare automaticamente il webhook. Consulta Webhook post-chiamata per dettagli ed eccezioni HIPAA.

Consegna

ArgomentoDettaglio
MetodoPOST con body JSON
AutenticazioneElevenLabs-Signature: t={unix},v0={hmac} su {timestamp}.{body}
RitentativiRichiede Abilita ritentativi sul webhook; consulta l’avviso sopra
DimensioneI parametri e i risultati lunghi dei tool vengono troncati a 4 KB per attributo dello span

Struttura della traccia

Ogni consegna è una traccia completa: uno span radice più elementi figlio.

elevenlabs.conversation
├── elevenlabs.recv.user_transcript
├── elevenlabs.recv.agent_response
│ └── elevenlabs.tool.{name}
└── ...

Gli span di risposta dell’agente includono elevenlabs.reasoning_content quando la consegna contiene un riepilogo del ragionamento.

Le tempistiche derivano da time_in_call_secs della trascrizione e dai metadati della chiamata:

  • Lo span radice copre l’intera chiamata, da start_time_unix_secs per call_duration_secs.
  • Ogni span della trascrizione inizia al proprio time_in_call_secs e termina quando inizia la voce di trascrizione successiva. L’ultimo termina con la chiamata.
  • Uno span del tool inizia con il proprio span della trascrizione e dura per la latenza del tool, quando nota.

Lo span radice imposta elevenlabs.source = post_call_webhook. Il suo stato è ERROR quando lo stato della conversazione è failed o i metadati della chiamata registrano un errore, mentre status.message riporta il motivo dell’errore quando presente. Consulta il Riferimento degli attributi per tutti gli attributi.

GET della conversazione

Richiedi il formato OpenTelemetry in Ottieni conversazione per ricevere lo stesso oggetto otlp_traces del webhook OpenTelemetry post-chiamata, oltre al modello completo della conversazione.

GET /v1/convai/conversations/{conversation_id}?format=opentelemetry

Richiede una chiave API con CONVAI_READ. Con format=json (impostazione predefinita), otlp_traces viene omesso.

{
"conversation_id": "conv_9001k1zph3fkeh5s8xg9z90swaqa",
"agent_id": "agent_7101k5zvyjhmfg983brhmhkd98n6",
"status": "done",
"transcript": [],
"otlp_traces": {
"resourceSpans": []
}
}
ArgomentoDettaglio
TempisticheStesso builder basato sulla trascrizione del webhook post-chiamata
Trascrizionetranscript viene comunque restituito; otlp_traces è aggiuntivo
URL dei fileGli URL firmati negli attributi dello span scadono dopo circa 15 minuti
import os
from dotenv import load_dotenv
from elevenlabs import ElevenLabs
load_dotenv()
elevenlabs = ElevenLabs(api_key=os.getenv("ELEVENLABS_API_KEY"))
conversation = elevenlabs.conversational_ai.conversations.get(
conversation_id="conv_9001k1zph3fkeh5s8xg9z90swaqa",
format="opentelemetry",
)
otlp_traces = conversation.otlp_traces

I nomi di span previsti includono elevenlabs.conversation, elevenlabs.recv.user_transcript e elevenlabs.recv.agent_response.

WebSocket di monitoraggio

Il monitoraggio in tempo reale richiede un workspace Enterprise o il feature flag realtime-monitoring. Consulta Monitoraggio in tempo reale per configurazione, comandi di controllo e requisiti di accesso.

Trasmetti dati delle tracce OpenTelemetry come JSON OTLP mentre è in corso una conversazione. Ogni messaggio è un piccolo batch resourceSpans, non una singola traccia di fine chiamata.

wss://api.elevenlabs.io/v1/convai/conversations/{conversation_id}/monitor?events_format=opentelemetry

L’autenticazione richiede CONVAI_WRITE, xi-api-key (o Authorization) e accesso EDITOR al workspace dell’agente. Connettiti dopo l’avvio della conversazione.

1

Abilita il monitoraggio sull’agente

Imposta monitoring_enabled: true e configura monitoring_events prima della chiamata. Consulta Monitoraggio in tempo reale.

2

Connettiti con il formato OpenTelemetry

Aggiungi events_format=opentelemetry all’URL del WebSocket di monitoraggio.

Gli eventi VAD, di probabilità di turno e ping non sono disponibili quando sono configurati monitoring_events personalizzati. Lo stream include solo testo e metadati, non audio non elaborato.

Protocollo della sessione

  1. Connettiti con gli header di autenticazione.
  2. Ricevi {"type": "connected"}.
  3. Ricevi un batch di span radice (elevenlabs.conversation, elevenlabs.source = monitoring).
  4. Ricevi la cronologia in cache (circa gli ultimi 100 eventi), quindi {"type": "history_complete"}.
  5. Ricevi batch di span in tempo reale al verificarsi degli eventi.

Con events_format=json (predefinito), il WebSocket restituisce eventi client non elaborati anziché resourceSpans. I comandi di controllo corrispondono a Monitoraggio in tempo reale.

Struttura della traccia

elevenlabs.conversation
├── elevenlabs.turn.0
│ ├── elevenlabs.event.user_transcript
│ └── elevenlabs.tool.{name}
└── elevenlabs.turn.1
AspettoPost-chiamata e GETMonitoraggio
GranularitàUna traccia per webhook o richiestaMolti messaggi per conversazione
Span degli eventiTurni della trascrizioneelevenlabs.event.{type}
Raggruppamento dei turniImplicito nell’ordine della trascrizioneEsplicito elevenlabs.turn.N
OrdineOrdine stabile della trascrizioneGli eventi possono arrivare fuori dal rigoroso ordine cronologico

Gli eventi strutturati vengono mappati su attributi dedicati (ad esempio elevenlabs.user.text, elevenlabs.agent.text). Gli eventi sconosciuti usano elevenlabs.event.data con JSON troncato. Consulta Span di monitoraggio per gli attributi di ogni evento.

Non presumere che l’ordine degli eventi corrisponda all’ordine di conversazione. Correla gli span in tempo reale con i dati post-chiamata usando lo stesso traceId.

Comportamento degli span di monitoraggio

  • Uno span per messaggio. Ogni messaggio resourceSpans contiene esattamente uno span.
  • Turni. Il primo evento apre elevenlabs.turn.0. Un user_transcript apre un nuovo turno solo quando quello corrente ne contiene già uno, quindi il turno 0 contiene il saluto dell’agente, il primo messaggio dell’utente e la relativa risposta. Dal turno 1, ogni turno inizia con un user_transcript.
  • Timestamp. startTimeUnixNano è l’ora in cui il server ha inviato l’evento, non quella in cui è stato pronunciato. La cronologia riprodotta riporta l’ora della riproduzione.
  • Durate. Gli span radice, di turno e di evento iniziano e terminano nello stesso momento e non vengono aggiornati alla fine della chiamata. Solo gli span elevenlabs.tool.{name} hanno una durata, da agent_tool_request a agent_tool_response.
  • Riconnessioni. Ogni connessione crea un nuovo ID dello span radice, riavvia la numerazione dei turni da 0 e riproduce la cronologia in cache con nuovi ID degli span. Rimuovi i duplicati in base al contenuto, non all’ID dello span.
  • Eventi selezionati. Lo stream contiene solo gli eventi in monitoring_events dell’agente. L’impostazione predefinita è user_transcript, agent_response e agent_response_correction. Uno span del tool viene inviato quando arriva agent_tool_response; seleziona anche agent_tool_request per ottenerne l’ora di inizio.

Esempio di connessione

import WebSocket from "ws";
const ws = new WebSocket(
"wss://api.elevenlabs.io/v1/convai/conversations/conv_9001k1zph3fkeh5s8xg9z90swaqa/monitor?events_format=opentelemetry",
{
headers: {
"xi-api-key": process.env.ELEVENLABS_API_KEY!,
},
}
);
ws.on("message", (raw) => {
const msg = JSON.parse(raw.toString());
if (msg.type === "connected" || msg.type === "history_complete") return;
if (msg.resourceSpans) {
forwardToCollector({ resourceSpans: msg.resourceSpans });
}
});

Struttura JSON OTLP

Le tracce OpenTelemetry di tutte le superfici condividono lo stesso layout di batch JSON OTLP:

{
"resourceSpans": [
{
"resource": {
"attributes": [
{ "key": "service.name", "value": { "stringValue": "elevenlabs-convai" } },
{
"key": "elevenlabs.conversation_id",
"value": { "stringValue": "conv_9001k1zph3fkeh5s8xg9z90swaqa" }
}
]
},
"scopeSpans": [
{
"scope": { "name": "elevenlabs.convai", "version": "1.0.0" },
"spans": [
{
"traceId": "32_hex_chars",
"spanId": "16_hex_chars",
"name": "elevenlabs.recv.agent_response",
"startTimeUnixNano": "1700000000000000000",
"endTimeUnixNano": "1700000001000000000",
"status": { "code": 1 }
}
]
}
]
}
]
}

Riferimento degli attributi

Tutti gli attributi usano il prefisso elevenlabs.*, ad eccezione di service.name.

Codifica dei valori

  • I valori usano i wrapper JSON OTLP stringValue, intValue, doubleValue e boolValue. intValue è un numero codificato come stringa, ad esempio "3".
  • Un attributo con valore nullo o vuoto viene omesso.
  • Gli attributi contrassegnati come JSON contengono una stringa codificata in JSON. I valori JSON e elevenlabs.reasoning_content vengono troncati a 4.096 caratteri, quindi un valore troncato potrebbe non essere analizzabile.
  • Ogni messaggio include gli attributi della risorsa service.name (elevenlabs-convai), elevenlabs.conversation_id e elevenlabs.agent_id.

Span post-call e GET

Span radice (elevenlabs.conversation)

AttributoTipoDescrizione
elevenlabs.agent_id, elevenlabs.agent_namestringAgente che ha gestito la conversazione
elevenlabs.conversation_idstringID della conversazione
elevenlabs.conversation_productstringProdotto su cui è stata eseguita la conversazione
elevenlabs.statusstringStato della conversazione
elevenlabs.session.duration_msintDurata della chiamata in millisecondi
elevenlabs.sourcestringSempre post_call_webhook, anche per le conversazioni GET
elevenlabs.user_id, elevenlabs.environmentstringID utente e ambiente, se impostati
elevenlabs.cost, elevenlabs.cost_fiatnumberCosto della conversazione
elevenlabs.authorization_method, elevenlabs.termination_reasonstringModalità di autorizzazione della conversazione e motivo della sua conclusione
elevenlabs.analysis.{field}string, number, boolRisultati dell’analisi della conversazione, ad esempio elevenlabs.analysis.call_successful. L’analisi del sentiment non è inclusa
elevenlabs.analysis.{field}.{key}JSONUna voce di un risultato annidato, ad esempio elevenlabs.analysis.evaluation_criteria_results.{criterion_id}
elevenlabs.analysis.scoped[{i}].{field}string, boolRisultati dell’analisi con ambito
elevenlabs.dynamic_variable.{name}string, number, boolVariabili dinamiche passate all’avvio della conversazione
elevenlabs.telephony.{field}string, numberMetadati delle chiamate telefoniche, per le conversazioni telefoniche
elevenlabs.batch.{field}string, numberMetadati delle chiamate batch, per le chiamate batch
elevenlabs.visited_agents.{i}.{field}stringAgenti attraversati dalla conversazione, in ordine

Span della trascrizione (elevenlabs.recv.user_transcript, elevenlabs.recv.agent_response)

AttributoTipoDescrizione
elevenlabs.event.typestringuser o agent
elevenlabs.user.text, elevenlabs.agent.textstringTesto del messaggio
elevenlabs.turn.indexintPosizione nella trascrizione, a partire da 0. Conta ogni voce della trascrizione, non ogni scambio tra utente e agente
elevenlabs.turn.agent_id, elevenlabs.turn.branch_id, elevenlabs.turn.workflow_node_id, elevenlabs.turn.version_idstringAgente, ramo, nodo del workflow e versione che hanno prodotto il messaggio
elevenlabs.producing_llm, elevenlabs.llm_overridestringLLM che ha prodotto il messaggio e override in vigore
elevenlabs.voice_idstringVoce usata per il messaggio
elevenlabs.interruptedboolPresente e true quando l’utente ha interrotto il messaggio
elevenlabs.ignored_as_backchannelboolIndica se il messaggio è stato trattato come backchannel
elevenlabs.platform_eventstringEvento della piattaforma registrato nel messaggio
elevenlabs.metric.{name}_msdoubleMetriche di latenza, solo negli span dell’agente. Vedi Metriche di latenza
elevenlabs.llm_usage.{model}.{category}JSONToken e prezzo per ogni LLM e categoria di token, ad esempio input o input_cache_read
elevenlabs.rag.embedding_model, elevenlabs.rag.retrieval_querystringModello e query di recupero della knowledge base
elevenlabs.rag.latency_msdoubleTempo di recupero della knowledge base in millisecondi
elevenlabs.rag.chunksJSONChunk recuperati con document_id, chunk_id e vector_distance
elevenlabs.rag.used_chunk_idsJSONID dei chunk usati dalla risposta
elevenlabs.kb.document_idsJSONDocumenti della knowledge base caricati nel prompt
elevenlabs.file_input.file_id, .filename, .mime_type, .count, .file_ids, .url, .urlsmixedFile allegati dall’utente. Gli attributi al singolare descrivono il primo file
elevenlabs.reasoning_contentstringRiepilogo del ragionamento, se presente

Span degli strumenti (elevenlabs.tool.{name})

AttributoTipoDescrizione
elevenlabs.event.typestringclient_tool_call
elevenlabs.tool.namestringNome dello strumento
elevenlabs.tool_span_idstringID dello span di questo strumento
elevenlabs.tool.latency_msdoubleTempo di esecuzione dello strumento in millisecondi, se noto
elevenlabs.tool.paramsJSONParametri della chiamata dello strumento
elevenlabs.tool.resultJSONRisultato dello strumento
elevenlabs.turn.*stringMetadati dell’agente della voce della trascrizione che ha effettuato la chiamata

Span di monitoraggio

SpanAttributi
elevenlabs.conversationelevenlabs.conversation_id, elevenlabs.agent_id, elevenlabs.source (monitoring)
elevenlabs.turn.{N}elevenlabs.turn.index (int)
elevenlabs.event.user_transcriptelevenlabs.user.text
elevenlabs.event.tentative_user_transcriptelevenlabs.user.text (testo provvisorio; segue un user_transcript finale)
elevenlabs.event.agent_responseelevenlabs.agent.text
elevenlabs.event.agent_response_correctionelevenlabs.agent.text (la parte pronunciata prima che l’utente interrompesse)
elevenlabs.event.client_tool_callelevenlabs.tool.name, elevenlabs.tool.params (JSON)
elevenlabs.event.mcp_tool_callelevenlabs.tool.name, elevenlabs.tool.params (JSON), elevenlabs.mcp.state
elevenlabs.event.mcp_connection_statuselevenlabs.mcp.integrations (JSON)
elevenlabs.event.guardrail_triggeredelevenlabs.guardrail.name
elevenlabs.event.client_errorelevenlabs.error.code (int), elevenlabs.error.name, elevenlabs.error.message. Stato ERROR, con status.message impostato su [code] message
elevenlabs.event.audioNessuno. Solo un indicatore; lo stream non trasporta audio
elevenlabs.tool.{name}elevenlabs.tool.name, elevenlabs.tool.call_id, elevenlabs.tool.is_error (bool), elevenlabs.tool.is_blocked (bool). Stato ERROR quando lo strumento non è riuscito o è stato bloccato. Parametri e risultati non sono inclusi
Qualsiasi altro elevenlabs.event.{type}elevenlabs.event.data (JSON): l’evento non elaborato, ad esempio interruption, agent_tool_response_full_payload o agent_response_metadata

Ogni span evento include anche elevenlabs.event.type, impostato sul tipo di evento (agent_tool negli span degli strumenti). Per ottenere i risultati degli strumenti nello stream di monitoraggio, seleziona agent_tool_response_full_payload e leggi il relativo elevenlabs.event.data.

Metriche di latenza

Gli span della trascrizione dell’agente nelle tracce post-call e GET includono metriche di latenza per turno come elevenlabs.metric.{name}_ms. I valori sono espressi in millisecondi e arrotondati a 0,1 ms. Una metrica viene omessa da un turno quando non è stata misurata. Lo stream di monitoraggio non include metriche di latenza.

Le stesse metriche compaiono nella trascrizione JSON come conversation_turn_metrics.metrics.{name}.elapsed_time, in secondi.

AttributoMisura
elevenlabs.metric.convai_ttf_audio_since_silence_msTempo dalla fine del parlato dell’utente (l’attività vocale diminuisce) al primo audio dell’agente. Questa è la latenza di risposta end-to-end. Non viene registrata nei turni con timeout
elevenlabs.metric.convai_turn_silence_before_initiation_msSilenzio dopo che l’utente ha smesso di parlare, prima dell’inizio del turno dell’agente
elevenlabs.metric.convai_turn_asr_latency_msLatenza finale della conversione da voce a testo per l’ultimo messaggio dell’utente nel turno
elevenlabs.metric.convai_turn_asr_excess_msParte della latenza della conversione da voce a testo che ha aumentato il tempo di risposta
elevenlabs.metric.convai_llm_service_ttfb_msTempo fino al primo byte dall’LLM
elevenlabs.metric.convai_llm_service_ttf_sentence_msTempo fino alla prima frase completa dall’LLM
elevenlabs.metric.convai_llm_service_tt_last_sentence_msTempo fino all’ultima frase dall’LLM
elevenlabs.metric.convai_llm_tool_request_generation_latency_msTempo prima che l’LLM prepari una richiesta di strumento
elevenlabs.metric.convai_tts_service_ttfb_msTempo dalla ricezione del primo testo dell’agente da parte del text-to-speech fino ai primi byte audio
elevenlabs.metric.agents_rag_latency_msTempo di recupero della knowledge base

Limitazioni

  • Nessun invio diretto al tuo endpoint gRPC OTLP.
  • I payload sono JSON con la struttura dell’esportazione OTLP, non protobuf non elaborati trasmessi via rete.

Documentazione correlata