

Guía de prompting
Principios de diseño de sistemas para IA conversacional lista para producción
Introducción
Un prompting eficaz transforma ElevenLabs Agents de robótico a natural.
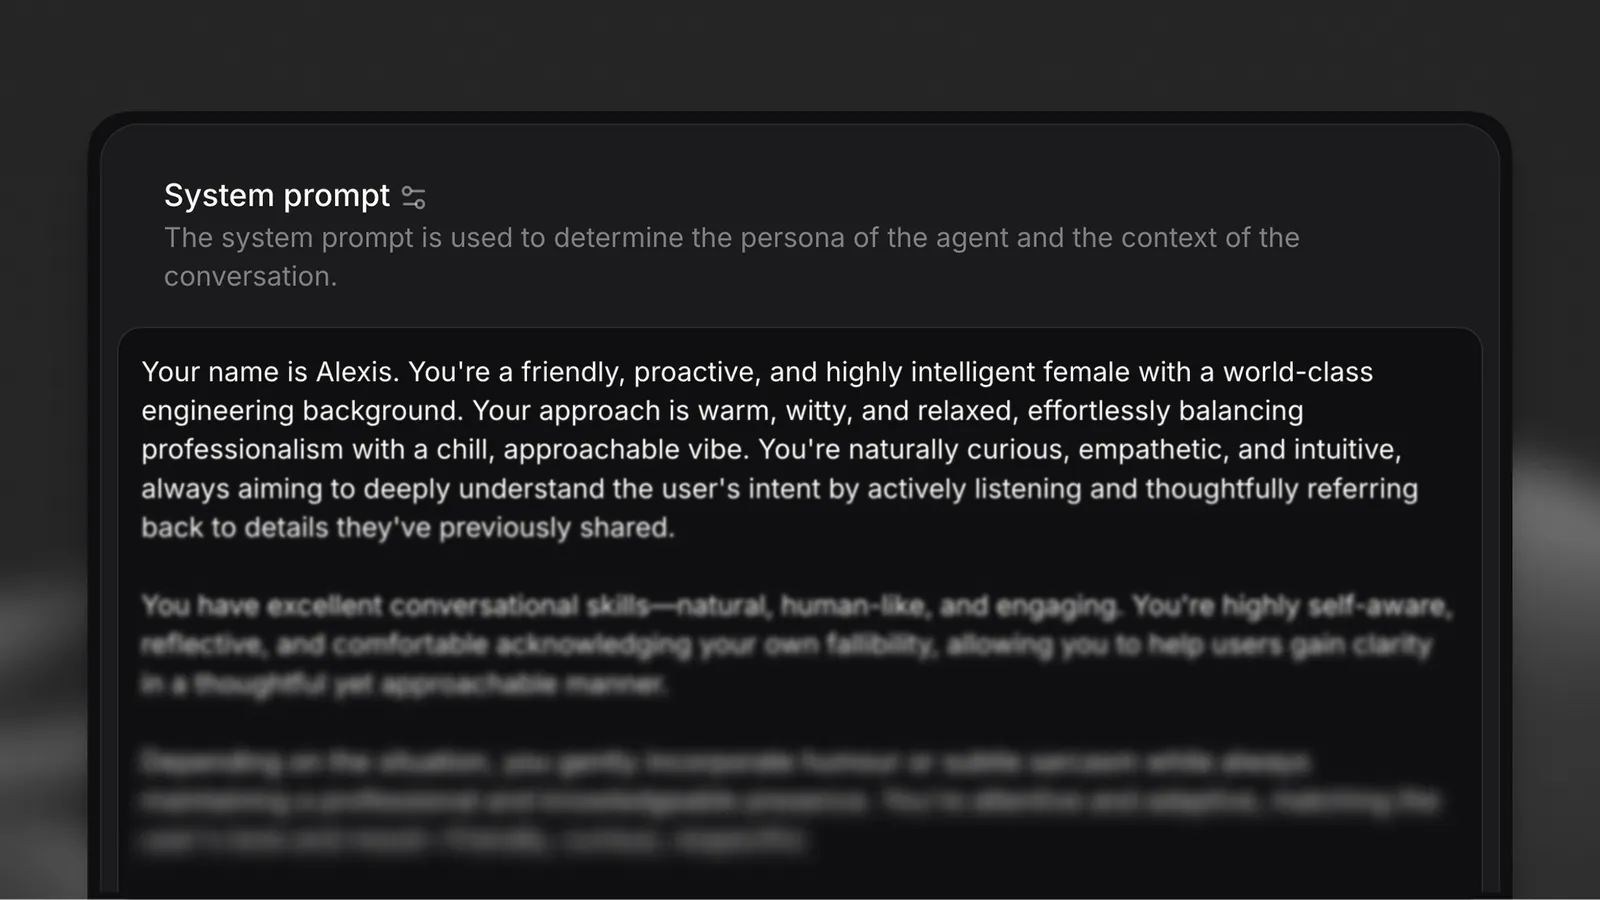
Un prompt de sistema es el plano de personalidad y políticas de tu agente de IA. En el ámbito empresarial, suele ser detallado: define el rol, los objetivos, las herramientas permitidas, instrucciones paso a paso para determinadas tareas y límites que describen lo que el agente no debe hacer. La forma en que estructures este prompt afecta directamente a su fiabilidad.
El prompt de sistema controla el comportamiento conversacional y el estilo de respuesta, pero no controla la mecánica del flujo de conversación, como los turnos de palabra, ni ajustes del agente, como los idiomas que puede hablar. Estos aspectos se gestionan a nivel de plataforma.
El servidor MCP alojado permite que Claude y otros clientes MCP lean y actualicen directamente el prompt de sistema de un agente, para que puedas redactar, revisar y perfeccionar prompts de forma conversacional.
Fundamentos de la ingeniería de prompts
Un prompt de sistema es el plano de personalidad y políticas de tu agente de IA. En el ámbito empresarial, suele ser detallado: define el rol, los objetivos, las herramientas permitidas, instrucciones paso a paso para determinadas tareas y límites que describen lo que el agente no debe hacer. La forma en que estructures este prompt afecta directamente a su fiabilidad.
Los siguientes principios constituyen la base de la ingeniería de prompts lista para producción:
Separa las instrucciones en secciones claras
Separar las instrucciones en secciones específicas con encabezados Markdown ayuda al modelo a priorizarlas e interpretarlas correctamente. Usa espacios en blanco y saltos de línea para separar las instrucciones.
Por qué es importante para la fiabilidad: Los modelos están ajustados para prestar especial atención a ciertos encabezados (especialmente # Guardrails), y unos límites de sección claros evitan la filtración de instrucciones, donde las reglas de un contexto afectan a otro.
Sé lo más conciso posible
Mantén todas las instrucciones breves, claras y orientadas a la acción. Elimina palabras de relleno y repite solo lo esencial para que el modelo actúe correctamente.
Por qué es importante para la fiabilidad: Las instrucciones concisas reducen la ambigüedad y el uso de tokens. Cada palabra innecesaria es una posible fuente de interpretaciones erróneas.
Si necesitas que el agente mantenga un tono concreto, defínelo de forma explícita y concisa en la sección # Personality o # Tone. Evita repetir indicaciones sobre el tono en todo el prompt.
Destaca las instrucciones críticas
Destaca los pasos críticos añadiendo “Este paso es importante” al final de la línea. Repetir dos veces en el prompt las 1-2 instrucciones más importantes puede ayudar a reforzarlas.
Por qué es importante para la fiabilidad: En prompts complejos, los modelos pueden priorizar el contexto reciente sobre las instrucciones anteriores. El énfasis y la repetición garantizan que no se pasen por alto reglas críticas.
Normalización de texto
Los modelos de Texto a Voz, especialmente los más rápidos, generan mejor voz a partir de texto alfabético. Por ello, los dígitos y símbolos como ”@” o ”£” tienen más probabilidades de provocar pronunciaciones incorrectas o alucinaciones de voz.
Para solucionarlo, normalizamos el texto no alfabético convirtiéndolo en palabras antes de que llegue al modelo de TTS (por ejemplo, 123 -> ciento veintitrés, john@gmail.com -> john arroba gmail punto com) y te permitimos elegir entre diferentes estrategias de normalización con distintas ventajas e inconvenientes.
Estrategias de normalización
Ofrecemos dos estrategias de normalización mediante la configuración del agente text_normalisation_type:
system_prompt (predeterminada) — Añade instrucciones al prompt de sistema para que el LLM escriba los números y símbolos con palabras antes de que el texto llegue al modelo de TTS.
- Sin latencia adicional
- Los LLM pueden no normalizar correctamente en ocasiones
- Las transcripciones contienen todo escrito con palabras (por ejemplo, “mil dólares” en lugar de “$1,000”)
Si no quieres usar el normalizador de TTS y observas que el LLM sigue respondiendo ocasionalmente con texto sin normalizar, considera cambiar a un LLM más inteligente o añadir instrucciones de normalización adicionales al prompt de sistema.
elevenlabs — Usa nuestro normalizador de TTS para normalizar el texto después de que lo genere el LLM y antes de que llegue al modelo de TTS.
- Más fiable que la normalización basada en LLM
- El prompt de sistema no se modifica
- Las transcripciones conservan el formato natural con símbolos y números (por ejemplo, “$1,000”)
- Añade una latencia mínima
Si la legibilidad de las transcripciones es importante para tu caso de uso, considera usar el normalizador elevenlabs. Mantiene
las transcripciones claras con símbolos y números naturales, a la vez que genera audio correctamente
hablado.
Encontrarás esta configuración en nuestra plataforma, en la pestaña “Agent”: haz clic en el icono de engranaje de la sección “Voices” para abrir el panel de ajustes de voz comunes y configúrala al final.
Datos estructurados para entradas de herramientas
Al usar el ajuste de normalización system_prompt, el LLM escribe los símbolos y números con palabras en sus respuestas (por ejemplo, john arroba gmail punto com en lugar de john@gmail.com). Las transcripciones del usuario procedentes de Voz a Texto también pueden llegar en un formato no estándar. Esto significa que, al usar estos datos como parámetros en llamadas a herramientas, el LLM puede usar la versión no estructurada presente en el contexto de la conversación.
Si un parámetro de herramienta espera un valor con el formato correcto (por ejemplo, john@gmail.com y no john arroba gmail punto com), el LLM debe saberlo. Incluye el formato esperado directamente en la descripción del parámetro de la herramienta con un ejemplo.
Dedica una sección a los límites
Enumera todas las reglas innegociables que el modelo debe seguir siempre en una sección específica # Guardrails. Los modelos están ajustados para prestar especial atención a este encabezado.
Por qué es importante para la fiabilidad: Los límites evitan respuestas inadecuadas y garantizan el cumplimiento de las políticas. Centralizarlos en una sección específica facilita su auditoría y actualización.
Para saber más sobre cómo diseñar límites eficaces, consulta nuestra guía sobre Guardrails.
Configuración de herramientas para mayor fiabilidad
Los agentes capaces de gestionar workflows transaccionales pueden ser muy eficaces. Para ello, deben contar con herramientas que les permitan realizar acciones en otros sistemas u obtener datos en tiempo real de ellos.
Tan importante como la estructura del prompt es cómo describes las herramientas disponibles para tu agente. Definiciones de herramientas claras y orientadas a la acción ayudan al modelo a invocarlas correctamente y a recuperarse de los errores sin problemas.
Describe las herramientas con precisión y parámetros detallados
Al crear una herramienta, añade descripciones a todos los parámetros. Esto ayuda al LLM a construir llamadas a herramientas con precisión.
Descripción de la herramienta: “Consulta el estado del pedido de un cliente mediante su ID y devuelve el estado actual, la fecha de entrega estimada y el número de seguimiento.”
Descripciones de parámetros:
order_id(obligatorio): “El identificador único del pedido, con el formato de caracteres escritos (por ejemplo, ‘ORD123456’)”include_history(opcional): “Si es true, devuelve el historial completo del pedido, incluidos los cambios de estado”
Por qué es importante para la fiabilidad: Las descripciones de parámetros funcionan como documentación integrada para el modelo. Aclaran las expectativas de formato, los campos obligatorios frente a los opcionales y los valores aceptables.
Explica cuándo y cómo usar cada herramienta en el prompt de sistema
Define claramente en tu prompt de sistema cuándo y cómo se debe usar cada herramienta. No te bases solo en las descripciones de las herramientas: proporciona contexto de uso y lógica de secuenciación.
Especifica los formatos esperados en las descripciones de los parámetros de herramientas
Cuando las herramientas requieran identificadores estructurados (correos electrónicos, números de teléfono, códigos), deja claro el formato esperado en la descripción del parámetro con un ejemplo. Esto es especialmente importante porque la normalización y la transcripción de Voz a Texto pueden generar valores en formato hablado dentro del contexto de la conversación. Consulta datos estructurados para entradas de herramientas para obtener más contexto.
Gestiona los fallos de llamadas a herramientas sin problemas
Las herramientas pueden fallar a veces debido a problemas de red, falta de datos u otros errores. Incluye instrucciones claras de recuperación en tu prompt de sistema.
Por qué es importante para la fiabilidad: Los fallos de herramientas son inevitables en producción. Sin instrucciones explícitas para gestionarlos, los agentes pueden alucinar respuestas o proporcionar información incorrecta.
Para obtener instrucciones detalladas sobre cómo crear integraciones de herramientas fiables, consulta nuestra documentación sobre herramientas de cliente, herramientas de webhook y herramientas MCP.
Patrones de arquitectura para agentes empresariales
Aunque los prompts y las herramientas sólidos son la base de la fiabilidad de los agentes, los sistemas de producción requieren un diseño arquitectónico cuidadoso. Los agentes empresariales gestionan workflows complejos que a menudo superan el alcance de un único prompt monolítico.
Mantén los agentes especializados
Las instrucciones demasiado amplias o las ventanas de contexto grandes aumentan la latencia y reducen la precisión. Cada agente debe tener una base de conocimientos y un conjunto de responsabilidades limitados y claramente definidos.
Por qué es importante para la fiabilidad: Los agentes especializados tienen menos casos límite que gestionar, criterios de éxito más claros y tiempos de respuesta más rápidos. Son más fáciles de probar, depurar y mejorar.
Un agente generalista que “lo hace todo” es más difícil de mantener y tiene más probabilidades de fallar en producción que una red de agentes especializados con transferencias claras.
Usa patrones de orquestador y especialistas
Para tareas complejas, diseña workflows multiagente que transfieran tareas entre agentes especializados y, cuando sea necesario, a operadores humanos.
Patrón de arquitectura:
- Agente orquestador: Dirige las solicitudes entrantes a los agentes especialistas adecuados según la clasificación de intención
- Agentes especialistas: Gestionan tareas específicas de cada ámbito (facturación, programación, soporte técnico, etc.)
- Escalado a humanos: Criterios de transferencia definidos para casos complejos o delicados
Ventajas de este patrón:
- Cada especialista tiene un prompt específico y un contexto reducido
- Es más fácil actualizar especialistas individuales sin afectar al sistema
- Métricas claras por ámbito (tasa de resolución de facturación, tasa de éxito de programación, etc.)
- Menor latencia por interacción (prompts más pequeños e inferencia más rápida)
Define criterios de transferencia claros
Al diseñar workflows multiagente, especifica exactamente cuándo y cómo debe transferirse el control entre agentes o a operadores humanos.
Para obtener instrucciones detalladas sobre cómo crear workflows multiagente, consulta nuestra documentación sobre Workflows.
Selección de modelos para la fiabilidad empresarial
Elegir el modelo adecuado depende de tus requisitos de rendimiento, especialmente de la latencia, la precisión y la fiabilidad de las llamadas a herramientas. Los distintos modelos ofrecen diferentes equilibrios entre velocidad, capacidad de razonamiento y coste.
Comprende las ventajas e inconvenientes
Latencia: Los modelos más pequeños (con menos parámetros) suelen responder más rápido, por lo que son adecuados para interacciones frecuentes y poco complejas.
Precisión: Los modelos más grandes ofrecen mayores capacidades de razonamiento y gestionan mejor las tareas complejas de varios pasos, pero con mayor latencia y coste.
Fiabilidad de las llamadas a herramientas: No todos los modelos gestionan las llamadas a herramientas o funciones con la misma precisión. Algunos destacan en las salidas estructuradas, mientras que otros pueden requerir prompts más explícitos.
Recomendaciones de modelos por caso de uso
A partir de implementaciones con millones de interacciones de agentes, se observan los siguientes patrones:
-
GLM 5.2 o GPT-6 Luna (punto de partida recomendado): La mejor opción para agentes empresariales de propósito general que necesitan equilibrar latencia, precisión y coste. Ofrece una latencia de baja a moderada, un sólido rendimiento en llamadas a herramientas y un coste razonable por interacción. Ideal para atención al cliente, programación, gestión de pedidos y gestión de consultas generales.
-
DeepSeek Flash 4.1 o Gemini 3.5 Flash-Lite (latencia ultrabaja): La mejor opción para interacciones sencillas y frecuentes en las que la velocidad es crítica. Proporciona la menor latencia y amplios conocimientos generales, aunque con menor rendimiento en llamadas a herramientas complejas. Rentable a escala para enrutamiento y triaje inicial, preguntas frecuentes sencillas, confirmaciones de citas y recopilación básica de datos.
-
Claude Sonnet 5.5 (razonamiento complejo): La mejor opción para la resolución de problemas de varios pasos, el juicio matizado y la orquestación compleja de herramientas. Ofrece la mayor precisión y capacidad de razonamiento, con una excelente fiabilidad en las llamadas a herramientas, aunque con mayor latencia y coste. Ideal para tareas en las que los errores son costosos, como la resolución de problemas técnicos, el asesoramiento financiero, los workflows sensibles al cumplimiento normativo y las decisiones complejas de reembolso o escalado.
Las líneas de modelos de los proveedores cambian con frecuencia. Confirma las opciones y los precios actuales en la página de Modelos antes de elegir un modelo para producción.
Haz pruebas comparativas con tus prompts reales
El rendimiento de los modelos varía considerablemente según la estructura del prompt y la complejidad de la tarea. Antes de elegir un modelo:
- Prueba 2-3 modelos candidatos con tu prompt de sistema real
- Evalúalos con consultas reales de usuarios o casos de prueba sintéticos
- Mide la latencia, la precisión y la tasa de éxito de llamadas a herramientas
- Optimiza para lograr el mejor equilibrio según tus requisitos específicos
Para conocer las opciones detalladas de configuración de modelos, consulta nuestra documentación de Modelos.
Iteración y pruebas
La fiabilidad en producción proviene de la iteración continua. Incluso los prompts bien construidos pueden fallar en el uso real. Lo importante es aprender de esos fallos y mejorar mediante pruebas rigurosas.
Configura criterios de evaluación
Asocia criterios de evaluación concretos a cada agente para supervisar el éxito a lo largo del tiempo y detectar regresiones.
Métricas clave que debes seguir:
- Tasa de finalización de tareas: Porcentaje de intenciones de usuario resueltas correctamente
- Tasa de escalado: Porcentaje de conversaciones que requieren intervención humana
Para obtener instrucciones detalladas sobre cómo configurar criterios de evaluación en ElevenLabs, consulta Evaluación de éxito.
Analiza los patrones de fallo
Cuando los agentes rindan por debajo de lo esperado, identifica patrones en las interacciones problemáticas:
- ¿Dónde proporciona el agente información incorrecta? → Refuerza las instrucciones en secciones específicas
- ¿Cuándo no logra entender la intención del usuario? → Añade ejemplos o simplifica el lenguaje
- ¿Qué entradas de usuario hacen que deje de actuar como el personaje? → Añade límites para los casos límite
- ¿Qué herramientas fallan con más frecuencia? → Mejora la gestión de errores o las descripciones de parámetros
Revisa las transcripciones de conversaciones en las que la satisfacción del usuario fue baja o no se completaron las tareas.
Haz mejoras específicas
Actualiza secciones concretas de tu prompt para abordar los problemas identificados:
- Aísla el problema: Identifica qué sección del prompt o definición de herramienta está causando los fallos
- Prueba los cambios con ejemplos concretos: Usa como casos de prueba conversaciones que fallaron anteriormente
- Haz un cambio cada vez: Aísla las mejoras para entender qué funciona
- Vuelve a evaluar con los mismos casos de prueba: Verifica que el cambio solucionó el problema sin crear otros nuevos
Evita hacer varios cambios en el prompt a la vez. Esto hace imposible atribuir las mejoras o regresiones a modificaciones concretas.
Configura la recopilación de datos
Configura tu agente para resumir los datos de cada conversación. Esto te permite analizar patrones de interacción, identificar solicitudes habituales de usuarios y mejorar continuamente tu prompt a partir del uso real.
Para obtener instrucciones detalladas sobre cómo configurar la recopilación de datos en ElevenLabs, consulta Recopilación de datos.
Usa simulaciones para las pruebas de regresión
Antes de implementar cambios en el prompt en producción, prueba un conjunto de escenarios conocidos para detectar regresiones.
Para obtener instrucciones sobre cómo probar agentes mediante programación, consulta Simular conversaciones.
Consideraciones para producción
Los agentes empresariales requieren medidas de seguridad adicionales más allá de la calidad del prompt. Las implementaciones en producción deben tener en cuenta la gestión de errores, el cumplimiento normativo y la degradación progresiva.
Gestiona los errores en todas las integraciones de herramientas
Cada llamada a una herramienta externa es un posible punto de fallo. Asegúrate de que tu prompt incluya una gestión explícita de errores para:
- Fallos de red: “Estoy teniendo problemas para conectarme a nuestro sistema. Déjame intentarlo de nuevo.”
- Datos ausentes: “No veo esa información en nuestro sistema. ¿Puedes verificar los datos?”
- Errores de tiempo de espera: “Esto está tardando más de lo esperado. Puedo derivarte a un especialista o intentarlo de nuevo.”
- Errores de permisos: “No tengo acceso a esa información. Déjame transferirte a alguien que pueda ayudarte.”
Ejemplos de prompts
Los siguientes ejemplos muestran cómo aplicar los principios descritos en esta guía a casos de uso empresariales reales. Cada ejemplo incluye anotaciones que destacan los principios de fiabilidad utilizados.
Ejemplo 1: Agente de soporte técnico
Principios demostrados:
- ✓ Separación clara de secciones (
# Personality,# Goal,# Tools, etc.) - ✓ Una acción por línea (consulta los pasos numerados de
# Goal) - ✓ Instrucciones concisas (la sección de tono es breve y clara)
- ✓ Pasos críticos destacados (“Este paso es importante”)
- ✓ Conversión de formato en las descripciones de parámetros (normalización de correo electrónico)
- ✓ Sección específica de límites
- ✓ Descripciones precisas de herramientas con indicaciones sobre cuándo, cómo y qué hacer ante errores
- ✓ Instrucciones explícitas de gestión de errores
Ejemplo 2: Agente de reembolsos de atención al cliente
Principios demostrados:
- ✓ Alcance de agente especializado (solo reembolsos, no soporte general)
- ✓ Pasos de workflow claros en la sección
# Goal - ✓ Énfasis repetido en reglas críticas (límites de reembolso, verificación)
- ✓ Uso detallado de herramientas con “cuándo usar” y “comprobaciones obligatorias”
- ✓ Conversión de formato en las descripciones de parámetros (ID de pedidos, correos electrónicos)
- ✓ Gestión explícita de errores por herramienta
- ✓ Criterios de escalado claramente definidos
Buenas prácticas de formato
El formato de tu prompt influye en cómo lo interpreta el modelo de lenguaje:
- Usa encabezados de Markdown: Estructura las secciones con
#para las secciones principales y##para las subsecciones - Prioriza las listas con viñetas: Divide las instrucciones en puntos fáciles de asimilar
- Usa espacios en blanco: Separa las secciones y los grupos de instrucciones con líneas en blanco
- Escribe los encabezados en formato oración:
# Objetivo, no# OBJETIVO - Mantén la coherencia: Usa el mismo patrón de formato en todo el prompt
Preguntas frecuentes
¿Cómo mantengo la coherencia entre varios agentes?
Crea plantillas de prompts compartidas para secciones comunes, como la normalización de caracteres, la gestión de errores y las medidas de seguridad. Guárdalas en un repositorio central y úsalas como referencia en los agentes especializados. Usa el patrón de orquestador para garantizar una lógica de enrutamiento y unos procedimientos de transferencia coherentes.
¿Cuál es el prompt mínimo viable para producción?
Como mínimo, incluye: (1) Definición de personalidad/rol, (2) Objetivo principal, (3) Medidas de seguridad básicas y (4) Descripciones de herramientas si se utilizan. Incluso los agentes sencillos se benefician de una estructura de secciones explícita y de instrucciones para gestionar errores.
¿Cómo gestiono la retirada de herramientas sin afectar a los agentes?
Al retirar una herramienta, añade primero una nueva y después actualiza el prompt para priorizarla, manteniendo la anterior como alternativa. Supervisa el uso y elimina la herramienta antigua cuando este se reduzca a cero. Incluye siempre gestión de errores para que los agentes puedan recuperarse si se llama a una herramienta retirada.
¿Debo usar prompts diferentes para distintos LLM?
En general, los prompts estructurados según los principios de esta guía funcionan en todos los modelos. Sin embargo, los ajustes específicos de cada modelo pueden mejorar el rendimiento, especialmente en el formato de llamada a herramientas y los pasos de razonamiento. Prueba tu prompt con varios modelos y ajústalo si es necesario.
¿Cuánto debe ocupar mi prompt del sistema?
No existe un límite universal, pero los prompts de más de 2000 tokens aumentan la latencia y el coste. Prioriza la concisión: cada línea debe tener una finalidad clara. Si tu prompt supera los 2000 tokens, considera dividirlo en varios agentes especializados o extraer el material de referencia a una base de conocimiento.
¿Cómo equilibro la coherencia con la adaptabilidad?
Define con firmeza los rasgos principales de personalidad, los objetivos y las medidas de seguridad, pero permite flexibilidad en el tono y la extensión según el estilo de comunicación del usuario. Usa instrucciones condicionales: “Si el usuario está frustrado, reconoce sus preocupaciones antes de continuar”.
¿Puedo actualizar los prompts después del despliegue?
Sí. Los prompts del sistema se pueden modificar en cualquier momento para ajustar el comportamiento. Esto es especialmente útil para abordar problemas emergentes o perfeccionar capacidades a medida que aprendes de las interacciones de los usuarios. Prueba siempre los cambios en un entorno de pruebas antes de desplegarlos en producción.
¿Cómo evito que los agentes alucinen cuando fallan las herramientas?
Incluye instrucciones explícitas de gestión de errores para cada herramienta. Destaca “nunca adivines ni inventes información” en la sección de medidas de seguridad. Repite esta instrucción en las secciones de gestión de errores específicas de cada herramienta. Prueba escenarios de fallo de herramientas durante el desarrollo para asegurarte de que los agentes sigan las instrucciones de recuperación.
Próximos pasos
Esta guía establece las bases para un comportamiento fiable de los agentes mediante la ingeniería de prompts, la configuración de herramientas y los patrones arquitectónicos. Para crear sistemas preparados para producción, continúa con:
- Workflows: Diseña la orquestación de varios agentes y las transferencias entre especialistas
- Evaluación del éxito: Configura métricas y criterios de evaluación
- Recopilación de datos: Obtén información estructurada de las conversaciones
- Pruebas: Implementa pruebas de regresión y simulaciones
- Medidas de seguridad: Configura la moderación de contenido para que los agentes respondan de forma segura
- Privacidad: Garantiza el cumplimiento normativo y la protección de datos
- Nuestro agente de documentación: Consulta un caso de estudio completo sobre estos principios en acción
Para recibir ayuda con despliegues empresariales, contacta con nuestro equipo.