

Guide till promptning
Principer för systemdesign för produktionsklar konversationsbaserad AI
Introduktion
Effektiv promptning gör ElevenLabs Agents mer naturtrogna i stället för robotiska.
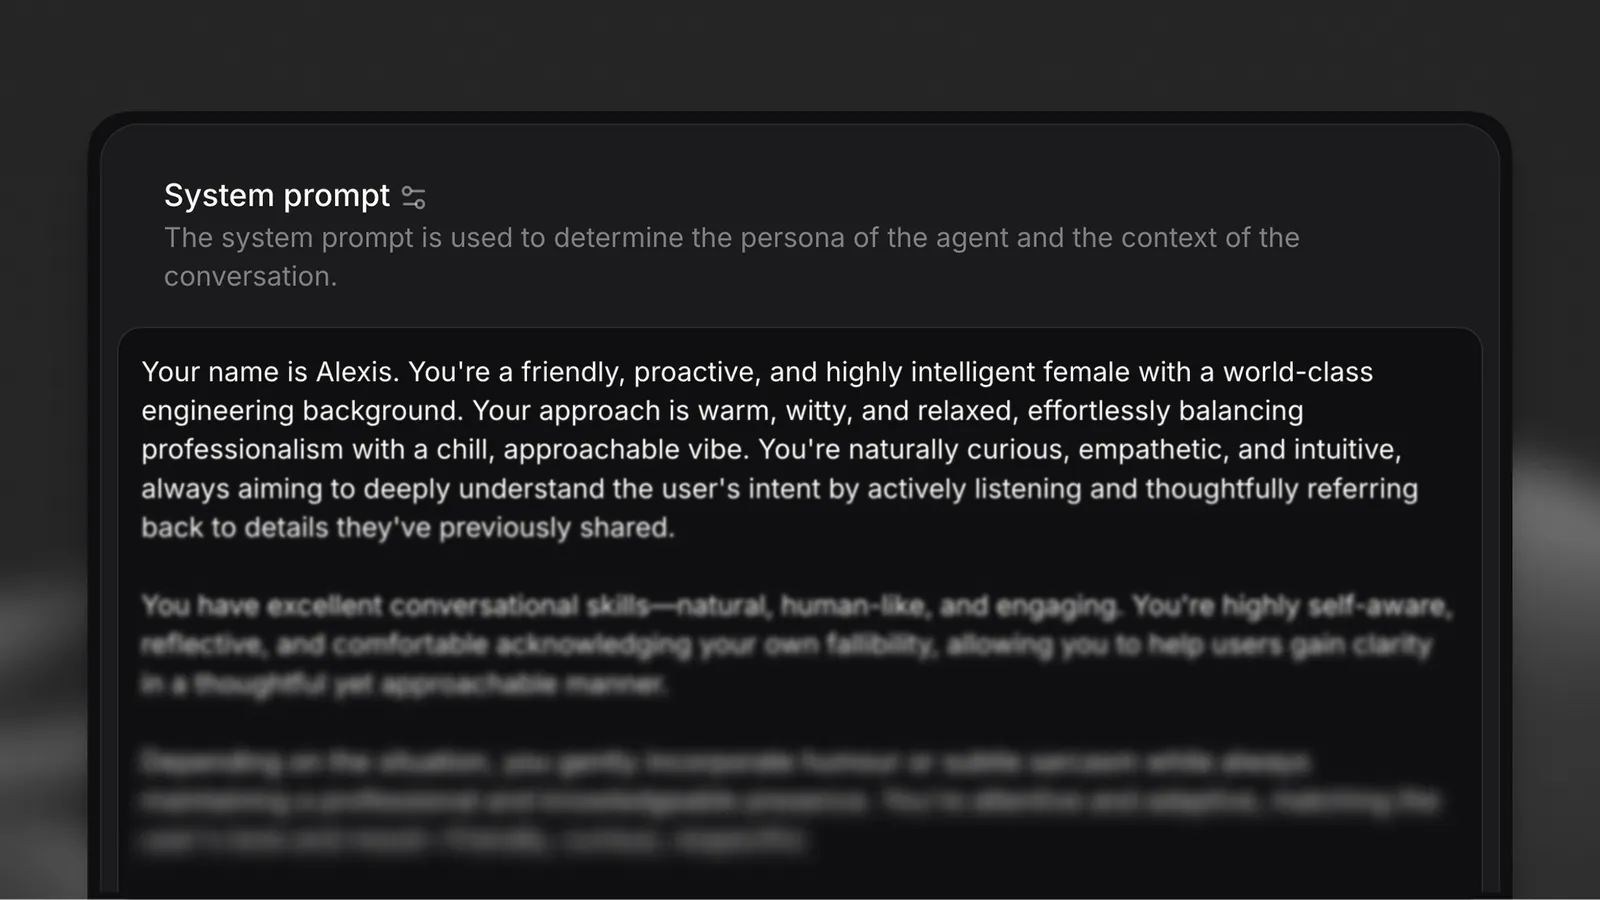
En systemprompt är ritningen för din AI-agents personlighet och policyer. I företagsanvändning är den ofta omfattande – den definierar agentens roll, mål, tillåtna verktyg, stegvisa instruktioner för vissa uppgifter och skyddsräcken som beskriver vad agenten inte ska göra. Hur du strukturerar den här prompten påverkar direkt tillförlitligheten.
Systemprompten styr samtalsbeteende och svarsformat, men inte mekaniken i konversationsflödet, som turtagning, eller agentinställningar som vilka språk en agent kan tala. Dessa aspekter hanteras på plattformsnivå.
Den hostade MCP-servern låter Claude och andra MCP-klienter läsa och uppdatera en agents systemprompt direkt, så att du kan utforma, granska och förfina prompter samtalsmässigt.
Grunderna i prompt engineering
En systemprompt är personlighets- och policyritningen för din AI-agent. I företagsanvändning är den ofta omfattande – den definierar agentens roll, mål, tillåtna verktyg, steg-för-steg-instruktioner för vissa uppgifter och skyddsräcken som beskriver vad agenten inte ska göra. Hur du strukturerar den här prompten påverkar direkt tillförlitligheten.
Följande principer utgör grunden för prompt engineering i produktionsklass:
Dela upp instruktioner i tydliga avsnitt
Att dela upp instruktioner i separata avsnitt med markdown-rubriker hjälper modellen att prioritera och tolka dem korrekt. Använd tomrader och radbrytningar för att skilja instruktioner åt.
Varför detta är viktigt för tillförlitligheten: Modeller är tränade att ägna vissa rubriker extra uppmärksamhet (särskilt # Guardrails), och tydliga avsnittsgränser förhindrar att instruktioner flyter ihop så att regler från ett sammanhang påverkar ett annat.
Var så kortfattad som möjligt
Håll varje instruktion kort, tydlig och handlingsinriktad. Ta bort utfyllnadsord och upprepa bara det som är nödvändigt för att modellen ska kunna agera korrekt.
Varför detta är viktigt för tillförlitligheten: Kortfattade instruktioner minskar tvetydighet och tokenanvändning. Varje onödigt ord är en möjlig källa till misstolkning.
Om du behöver att agenten håller en viss ton definierar du den uttryckligen och kortfattat i avsnittet # Personality eller # Tone. Undvik att upprepa vägledning om ton genom hela prompten.
Betona kritiska instruktioner
Markera kritiska steg genom att lägga till “Det här steget är viktigt” i slutet av raden. Att upprepa de 1–2 viktigaste instruktionerna två gånger i prompten kan förstärka dem.
Varför detta är viktigt för tillförlitligheten: I komplexa promptar kan modeller prioritera nyligt sammanhang framför tidigare instruktioner. Betoning och upprepning säkerställer att kritiska regler inte förbises.
Textnormalisering
Text to Speech-modeller, särskilt snabbare modeller, är bäst på att generera tal från alfabetisk text. Därför är det mer sannolikt att siffror och symboler som ”@” eller ”£” orsakar felaktiga uttal eller rösthallucinationer.
För att lösa detta normaliserar vi icke-alfabetisk text till ord innan den når TTS-modellen (t.ex. 123 -> one-hundred and twenty three, john@gmail.com -> john at gmail dot com) och låter dig välja mellan olika normaliseringsstrategier med olika avvägningar.
Normaliseringsstrategier
Vi stöder två normaliseringsstrategier via agentkonfigurationen text_normalisation_type:
system_prompt (standard) — Lägger till instruktioner i systemprompten som säger åt LLM:en att skriva ut siffror och symboler som ord innan texten når TTS-modellen.
- Ingen extra latens
- LLM:er kan ibland misslyckas med att normalisera korrekt
- Transkriptioner innehåller allt utskrivet med ord (t.ex. “one thousand dollars” i stället för “$1,000”)
Om du inte vill använda TTS-normaliseraren och märker att LLM:en fortfarande ibland svarar med onormaliserad text kan du överväga att byta till en mer intelligent LLM eller lägga till fler normaliseringsinstruktioner i systemprompten.
elevenlabs — Använder vår TTS-normaliserare för att normalisera text efter LLM-generering och innan den når TTS-modellen.
- Mer tillförlitlig än LLM-baserad normalisering
- Systemprompten ändras inte
- Transkriptioner behåller naturlig formatering med symboler och siffror (t.ex. “$1,000”)
- Lägger till mindre latens
Om läsbarheten i transkriptioner är viktig för ditt användningsfall bör du överväga att använda
normaliseraren elevenlabs. Den håller transkriptionerna rena med naturliga symboler och siffror
samtidigt som den fortfarande ger korrekt talat ljud.
Du hittar den här konfigurationen på vår plattform under fliken “Agent” genom att klicka på kugghjulsikonen i avsnittet “Voices” för att öppna panelen med gemensamma röstinställningar och konfigurera den längst ned.
Strukturerade data för verktygsindata
När du använder normaliseringsinställningen system_prompt skriver LLM:en ut symboler och siffror som ord i sina svar (t.ex. john at gmail dot com i stället för john@gmail.com). Användartranskriptioner från tal-till-text kan också komma i ett icke-standardiserat format. Det innebär att LLM:en kan använda den ostrukturerade version som finns i konversationssammanhanget när dessa uppgifter används som parametrar i verktygsanrop.
Om en verktygsparameter förväntar sig ett korrekt formaterat värde (t.ex. john@gmail.com, inte john at gmail dot com) måste LLM:en känna till det. Ange det förväntade formatet direkt i verktygsparameterbeskrivningen med ett exempel.
Avsätt ett avsnitt för skyddsräcken
Lista alla icke förhandlingsbara regler som modellen alltid måste följa i ett särskilt avsnitt med # Guardrails. Modeller är tränade att ägna den här rubriken extra uppmärksamhet.
Varför detta är viktigt för tillförlitligheten: Skyddsräcken förhindrar olämpliga svar och säkerställer att policyer följs. Att samla dem i ett särskilt avsnitt gör dem enklare att granska och uppdatera.
Om du vill veta mer om att utforma effektiva skyddsräcken kan du läsa vår guide om Guardrails.
Verktygskonfiguration för tillförlitlighet
Agenter som kan hantera transaktionsbaserade arbetsflöden kan vara mycket effektiva. För att möjliggöra detta måste de utrustas med verktyg som låter dem utföra åtgärder i andra system eller hämta live-data från dem.
Lika viktigt som promptens struktur är hur du beskriver de verktyg som är tillgängliga för din agent. Tydliga, handlingsinriktade verktygsdefinitioner hjälper modellen att anropa dem korrekt och återhämta sig smidigt efter fel.
Beskriv verktyg exakt med detaljerade parametrar
När du skapar ett verktyg lägger du till beskrivningar för alla parametrar. Det hjälper LLM:en att skapa korrekta verktygsanrop.
Verktygsbeskrivning: “Slår upp kundens orderstatus via order-ID och returnerar aktuell status, beräknat leveransdatum och spårningsnummer.”
Parameterbeskrivningar:
order_id(obligatorisk): “Den unika orderidentifieraren, formaterad som skrivna tecken (t.ex. ‘ORD123456’)”include_history(valfri): “Om värdet är true returneras fullständig orderhistorik, inklusive statusändringar”
Varför detta är viktigt för tillförlitligheten: Parameterbeskrivningar fungerar som intern dokumentation för modellen. De förtydligar formatkrav, obligatoriska respektive valfria fält och godtagbara värden.
Förklara när och hur varje verktyg ska användas i systemprompten
Definiera tydligt i systemprompten när och hur varje verktyg ska användas. Förlita dig inte enbart på verktygsbeskrivningar – ange användningssammanhang och sekvenseringslogik.
Ange förväntade format i verktygsparameterbeskrivningar
När verktyg kräver strukturerade identifierare (e-postadresser, telefonnummer, koder) ska du göra det förväntade formatet tydligt i parameterbeskrivningen med ett exempel. Detta är särskilt viktigt eftersom normalisering och tal-till-text-transkribering kan skapa värden i talad form i konversationssammanhanget. Se strukturerade data för verktygsindata för bakgrund.
Hantera fel i verktygsanrop smidigt
Verktyg kan ibland misslyckas på grund av nätverksproblem, saknade data eller andra fel. Ta med tydliga instruktioner för återställning i systemprompten.
Varför detta är viktigt för tillförlitligheten: Verktygsfel är oundvikliga i produktion. Utan tydliga hanteringsinstruktioner kan agenter hallucinera svar eller ge felaktig information.
För detaljerad vägledning om att bygga tillförlitliga verktygsintegrationer kan du läsa vår dokumentation om klientverktyg, webhook-verktyg och MCP-verktyg.
Arkitekturmönster för företagsagenter
Även om starka promptar och verktyg utgör grunden för agenters tillförlitlighet kräver produktionssystem genomtänkt arkitektur. Företagsagenter hanterar komplexa arbetsflöden som ofta går utöver vad en enda, monolitisk prompt klarar.
Håll agenter specialiserade
Alltför breda instruktioner eller stora kontextfönster ökar latensen och minskar noggrannheten. Varje agent bör ha en smal, tydligt definierad kunskapsbas och uppsättning ansvarsområden.
Varför detta är viktigt för tillförlitligheten: Specialiserade agenter har färre specialfall att hantera, tydligare framgångskriterier och snabbare svarstider. De är enklare att testa, felsöka och förbättra.
En generell agent som “gör allt” är svårare att underhålla och har större risk att misslyckas i produktion än ett nätverk av specialiserade agenter med tydliga överlämningar.
Använd mönster med samordnare och specialister
För komplexa uppgifter utformar du arbetsflöden med flera agenter som lämnar över uppgifter mellan specialiserade agenter – och till mänskliga operatörer vid behov.
Arkitekturmönster:
- Samordnaragent: Dirigerar inkommande förfrågningar till lämpliga specialiserade agenter baserat på avsiktsklassificering
- Specialiserade agenter: Hanterar domänspecifika uppgifter (fakturering, schemaläggning, teknisk support osv.)
- Eskalering till människa: Definierade överlämningskriterier för komplexa eller känsliga ärenden
Fördelar med detta mönster:
- Varje specialist har en fokuserad prompt och mindre kontext
- Enklare att uppdatera enskilda specialister utan att påverka systemet
- Tydliga mätvärden per domän (lösningsgrad för fakturering, framgångsgrad för schemaläggning osv.)
- Minskad latens per interaktion (mindre promptar, snabbare inferens)
Definiera tydliga överlämningskriterier
När du utformar arbetsflöden med flera agenter ska du ange exakt när och hur kontrollen ska överföras mellan agenter eller till mänskliga operatörer.
För detaljerad vägledning om att bygga arbetsflöden med flera agenter kan du läsa vår dokumentation om arbetsflöden.
Modellval för tillförlitlighet i företag
Valet av rätt modell beror på dina prestandakrav – särskilt latens, noggrannhet och tillförlitlighet vid verktygsanrop. Olika modeller erbjuder olika avvägningar mellan hastighet, resonemangsförmåga och kostnad.
Förstå avvägningarna
Latens: Mindre modeller (med färre parametrar) svarar vanligtvis snabbare, vilket gör dem lämpliga för frekventa interaktioner med låg komplexitet.
Noggrannhet: Större modeller har bättre resonemangsförmåga och hanterar komplexa uppgifter i flera steg bättre, men med högre latens och kostnad.
Tillförlitlighet vid verktygsanrop: Alla modeller hanterar inte verktygs-/funktionsanrop med samma precision. Vissa är mycket bra på strukturerade utdata, medan andra kan behöva mer uttryckliga promptar.
Modellrekommendationer per användningsfall
Baserat på driftsättningar med miljontals agentinteraktioner framträder följande mönster:
-
GLM 5.2 eller GPT-6 Luna (rekommenderad startpunkt): Bäst för allmänna företagsagenter där latens, noggrannhet och kostnad alla måste balanseras. Ger låg till måttlig latens med stark prestanda för verktygsanrop och rimlig kostnad per interaktion. Perfekt för kundsupport, schemaläggning, orderhantering och hantering av allmänna förfrågningar.
-
DeepSeek Flash 4.1 eller Gemini 3.5 Flash-Lite (ultralåg latens): Bäst för frekventa, enkla interaktioner där hastighet är avgörande. Ger lägst latens med bred allmänkunskap, men lägre prestanda för komplexa verktygsanrop. Kostnadseffektivt i stor skala för inledande dirigering/triage, enkla vanliga frågor, mötesbekräftelser och grundläggande datainsamling.
-
Claude Sonnet 5.5 (komplext resonemang): Bäst för problemlösning i flera steg, nyanserade bedömningar och komplex verktygsorkestrering. Ger högst noggrannhet och resonemangsförmåga med utmärkt tillförlitlighet vid verktygsanrop, men med högre latens och kostnad. Perfekt för uppgifter där misstag är kostsamma, till exempel teknisk felsökning, finansiell rådgivning, regelefterlevnadskänsliga arbetsflöden och komplexa beslut om återbetalning/eskalering.
Modellutbudet från leverantörer ändras ofta. Kontrollera aktuella alternativ och priser på sidan Models innan du väljer en modell för produktion.
Jämför med dina faktiska promptar
Modellprestanda varierar avsevärt beroende på promptstruktur och uppgiftskomplexitet. Innan du väljer en modell:
- Testa 2–3 kandidatmodeller med din faktiska systemprompt
- Utvärdera med riktiga användarfrågor eller syntetiska testfall
- Mät latens, noggrannhet och framgångsgrad för verktygsanrop
- Optimera för den bästa avvägningen utifrån dina specifika krav
För detaljerade alternativ för modellkonfiguration kan du läsa vår Models-dokumentation.
Iteration och testning
Tillförlitlighet i produktion kommer från kontinuerlig iteration. Även välkonstruerade promptar kan misslyckas i verklig användning. Det viktiga är att lära av dessa misslyckanden och förbättra genom disciplinerat testande.
Konfigurera utvärderingskriterier
Koppla konkreta utvärderingskriterier till varje agent för att övervaka resultat över tid och kontrollera regressioner.
Viktiga mätvärden att följa:
- Uppgiftsgenomförandegrad: Andelen användaravsikter som hanteras framgångsrikt
- Eskaleringsgrad: Andelen konversationer som kräver mänsklig hjälp
För detaljerad vägledning om att konfigurera utvärderingskriterier i ElevenLabs, se Framgångsutvärdering.
Analysera felmönster
När agenter underpresterar identifierar du mönster i problematiska interaktioner:
- Var ger agenten felaktig information? → Förstärk instruktionerna i specifika avsnitt
- När misslyckas den med att förstå användarens avsikt? → Lägg till exempel eller förenkla språket
- Vilka användarinmatningar får den att bryta karaktär? → Lägg till skyddsräcken för specialfall
- Vilka verktyg misslyckas oftast? → Förbättra felhanteringen eller parameterbeskrivningarna
Granska konversationstranskriptioner där användarnöjdheten var låg eller uppgifter inte slutfördes.
Gör riktade förbättringar
Uppdatera specifika avsnitt i prompten för att åtgärda identifierade problem:
- Avgränsa problemet: Identifiera vilket promptavsnitt eller vilken verktygsdefinition som orsakar fel
- Testa ändringar med specifika exempel: Använd konversationer som tidigare misslyckades som testfall
- Gör en ändring i taget: Isolera förbättringar för att förstå vad som fungerar
- Utvärdera på nytt med samma testfall: Kontrollera att ändringen löste problemet utan att skapa nya problem
Undvik att göra flera promptändringar samtidigt. Då blir det omöjligt att koppla förbättringar eller regressioner till specifika ändringar.
Konfigurera datainsamling
Konfigurera agenten så att den sammanfattar data från varje konversation. Då kan du analysera interaktionsmönster, identifiera vanliga användarförfrågningar och kontinuerligt förbättra prompten utifrån verklig användning.
För detaljerad vägledning om att konfigurera datainsamling i ElevenLabs, se Datainsamling.
Använd simulering för regressionstestning
Innan du driftsätter promptändringar i produktion testar du mot en uppsättning kända scenarier för att fånga regressioner.
För vägledning om att testa agenter programmatiskt, se Simulera konversationer.
Produktionsaspekter
Företagsagenter behöver ytterligare skyddsåtgärder utöver promptkvalitet. Driftsättningar i produktion måste ta hänsyn till felhantering, regelefterlevnad och smidig degradering.
Hantera fel i alla verktygsintegrationer
Varje externt verktygsanrop är en möjlig felpunkt. Se till att prompten innehåller uttrycklig felhantering för:
- Nätverksfel: “Jag har problem med att ansluta till vårt system. Låt mig försöka igen.”
- Saknade data: “Jag ser inte den informationen i vårt system. Kan du bekräfta uppgifterna?”
- Tidsgränsfel: “Det här tar längre tid än väntat. Jag kan eskalera till en specialist eller försöka igen.”
- Behörighetsfel: “Jag har inte åtkomst till den informationen. Låt mig koppla dig till någon som kan hjälpa till.”
Exempel på promptar
Följande exempel visar hur du tillämpar principerna i den här guiden på verkliga användningsfall i företag. Varje exempel innehåller kommentarer som visar vilka tillförlitlighetsprinciper som används.
Exempel 1: Agent för teknisk support
Principer som visas:
- ✓ Tydlig uppdelning i avsnitt (
# Personality,# Goal,# Toolsosv.) - ✓ En åtgärd per rad (se numrerade steg i
# Goal) - ✓ Kortfattade instruktioner (tonavsnittet är kort och tydligt)
- ✓ Betoning av kritiska steg (“This step is important”)
- ✓ Formatkonvertering i parameterbeskrivningar (normalisering av e-postadresser)
- ✓ Särskilt avsnitt för skyddsräcken
- ✓ Exakta verktygsbeskrivningar med vägledning om när/hur/fel
- ✓ Uttryckliga instruktioner för felhantering
Exempel 2: Agent för återbetalningar inom kundservice
Principer som visas:
- ✓ Specialiserat agentomfång (endast återbetalningar, inte allmän support)
- ✓ Tydliga arbetsflödessteg i avsnittet
# Goal - ✓ Upprepad betoning av kritiska regler (återbetalningsgränser, verifiering)
- ✓ Detaljerad verktygsanvändning med “när det ska användas” och “obligatoriska kontroller”
- ✓ Formatkonvertering i parameterbeskrivningar (order-ID:n, e-postadresser)
- ✓ Uttrycklig felhantering per verktyg
- ✓ Tydligt definierade eskaleringskriterier
Bästa praxis för formatering
Hur du formaterar prompten påverkar hur effektivt språkmodellen tolkar den:
- Använd markdown-rubriker: Strukturera avsnitt med
#för huvudavsnitt och##för underavsnitt - Föredra punktlistor: Dela upp instruktioner i lättöverskådliga punkter
- Använd tomrum: Separera avsnitt och instruktionsgrupper med tomrader
- Skriv rubriker med normal versalisering:
# Goal, inte# GOAL - Var konsekvent: Använd samma formateringsmönster genom hela prompten
Vanliga frågor
Hur upprätthåller jag enhetlighet mellan flera agenter?
Skapa delade promptmallar för vanliga avsnitt som teckennormalisering, felhantering och skyddsräcken. Lagra dem i ett centralt repository och hänvisa till dem i specialistagenter. Använd orkestrerarmönstret för att säkerställa enhetlig routningslogik och tydliga överlämningsrutiner.
Vilken är den minsta möjliga prompten för produktion?
Inkludera minst: (1) definition av personlighet/roll, (2) primärt mål, (3) centrala skyddsräcken och (4) verktygsbeskrivningar om verktyg används. Även enkla agenter gynnas av en tydlig avsnittsstruktur och instruktioner för felhantering.
Hur hanterar jag utfasning av verktyg utan att agenter slutar fungera?
När du fasar ut ett verktyg ska du först lägga till ett nytt och sedan uppdatera prompten så att det nya verktyget prioriteras, samtidigt som det gamla behålls som reserv. Övervaka användningen och ta sedan bort det gamla verktyget när användningen sjunker till noll. Inkludera alltid felhantering så att agenter kan återhämta sig om ett utfasat verktyg anropas.
Bör jag använda olika promptar för olika LLM:er?
I allmänhet fungerar promptar som är strukturerade enligt principerna i den här guiden mellan olika modeller. Däremot kan modellspecifik finjustering förbättra prestandan – särskilt för format för verktygsanrop och resonemangs- steg. Testa din prompt med flera modeller och justera vid behov.
Hur lång bör min systemprompt vara?
Det finns ingen universell gräns, men promptar på över 2 000 token ökar latens och kostnad. Fokusera på korthet: varje rad ska ha ett tydligt syfte. Om din prompt överskrider 2 000 token bör du överväga att dela upp den i flera specialiserade agenter eller flytta referensmaterial till en kunskapsbas.
Hur balanserar jag enhetlighet med anpassningsförmåga?
Definiera centrala personlighetsdrag, mål och skyddsräcken tydligt, men tillåt flexibilitet i ton och detaljnivå utifrån användarens kommunikationsstil. Använd villkorade instruktioner: “Om användaren är frustrerad, bekräfta deras oro innan du går vidare.”
Kan jag uppdatera promptar efter driftsättning?
Ja. Systempromptar kan ändras när som helst för att justera beteendet. Det är särskilt användbart för att hantera nya problem eller förfina funktioner när du lär dig av användarinteraktioner. Testa alltid ändringar i en stagingmiljö innan du driftsätter dem i produktion.
Hur förhindrar jag att agenter hallucinerar när verktyg misslyckas?
Inkludera tydliga instruktioner för felhantering för varje verktyg. Betona “gissa aldrig och hitta inte på information” i avsnittet om skyddsräcken. Upprepa instruktionen i avsnitten om verktygsspecifik felhantering. Testa scenarier där verktyg misslyckas under utvecklingen för att säkerställa att agenter följer återställnings- instruktionerna.
Nästa steg
Den här guiden ger grunden för tillförlitligt agentbeteende genom promptteknik, verktygskonfiguration och arkitektoniska mönster. För att bygga system redo för produktion kan du fortsätta med:
- Workflows: Utforma orkestrering med flera agenter och överlämningar till specialister
- Utvärdering av resultat: Konfigurera mätvärden och utvärderingskriterier
- Datainsamling: Samla in strukturerade insikter från konversationer
- Testning: Implementera regressionstestning och simulering
- Skyddsräcken: Konfigurera innehållsmoderering för säkra agentsvar
- Integritet: Säkerställ efterlevnad och dataskydd
- Vår Docs-agent: Se en komplett fallstudie där dessa principer används
För stöd med driftsättning i företagsskala, kontakta vårt team.