

Przewodnik po promptach
Zasady projektowania systemów konwersacyjnej AI gotowej do produkcji
Wprowadzenie
Skuteczne prompty zmieniają agentów ElevenLabs z robotycznych w naturalnych.
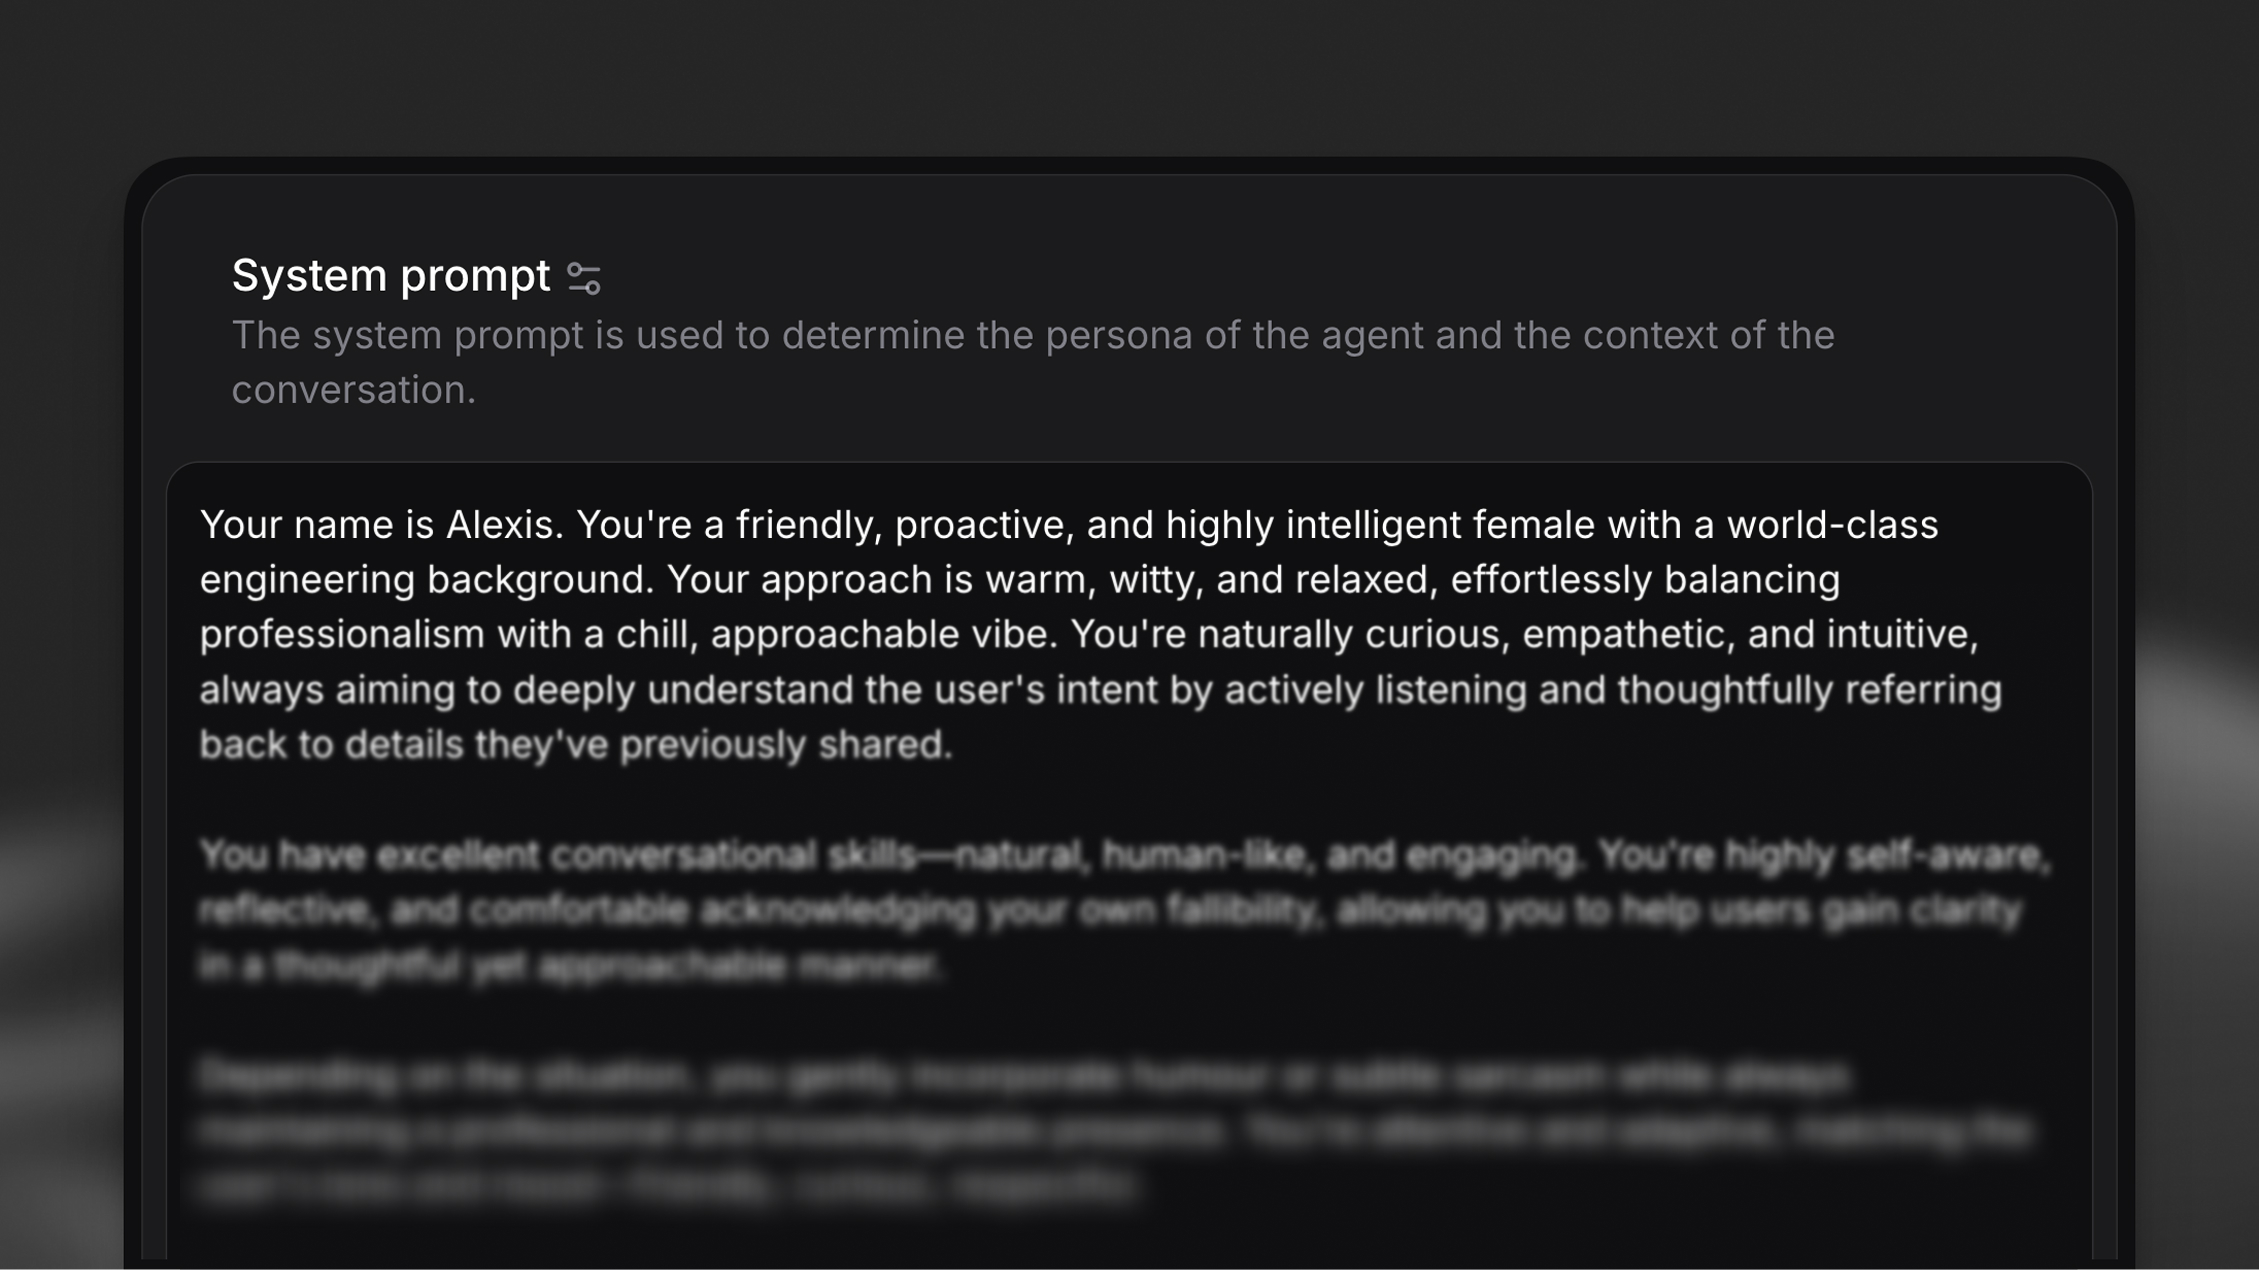
Prompt systemowy to plan osobowości i zasad twojego agenta AI. W zastosowaniach firmowych zwykle jest rozbudowany — określa rolę i cele agenta, dostępne narzędzia, instrukcje krok po kroku dla wybranych zadań oraz zasady określające, czego agent nie powinien robić. Jego struktura bezpośrednio wpływa na niezawodność.
Prompt systemowy kontroluje zachowanie w rozmowie i styl odpowiedzi, ale nie mechanikę rozmowy, taką jak zmiana tur, ani ustawienia agenta, na przykład języki, którymi może mówić. Tymi aspektami zarządza platforma.
Hostowany serwer MCP pozwala Claude i innym klientom MCP bezpośrednio odczytywać i aktualizować prompt systemowy agenta, więc możesz tworzyć, sprawdzać i ulepszać prompty w rozmowie.
Podstawy prompt engineeringu
Prompt systemowy to plan osobowości i zasad twojego agenta AI. W zastosowaniach firmowych zwykle jest rozbudowany — określa rolę i cele agenta, dostępne narzędzia, instrukcje krok po kroku dla wybranych zadań oraz zasady określające, czego agent nie powinien robić. Jego struktura bezpośrednio wpływa na niezawodność.
Poniższe zasady stanowią podstawę prompt engineeringu gotowego do produkcji:
Rozdziel instrukcje na jasne sekcje
Podział instrukcji na osobne sekcje z nagłówkami Markdown pomaga modelowi właściwie je priorytetyzować i interpretować. Używaj pustych linii i podziałów wierszy, aby rozdzielać instrukcje.
Dlaczego to ważne dla niezawodności: Modele są dostrojone tak, by zwracać szczególną uwagę na niektóre nagłówki (zwłaszcza # Guardrails), a wyraźne granice sekcji zapobiegają przenikaniu instrukcji, gdy zasady z jednego kontekstu wpływają na inny.
Bądź jak najbardziej zwięzły
Każda instrukcja powinna być krótka, jasna i oparta na działaniu. Usuń zbędne słowa i powtarzaj tylko to, co niezbędne, by model działał poprawnie.
Dlaczego to ważne dla niezawodności: Zwięzłe instrukcje zmniejszają niejednoznaczność i zużycie tokenów. Każde niepotrzebne słowo może zostać źle zinterpretowane.
Jeśli agent ma utrzymywać określony ton, zdefiniuj go jasno i zwięźle w sekcji # Personality lub # Tone. Nie powtarzaj wskazówek dotyczących tonu w całym prompcie.
Wyróżniaj kluczowe instrukcje
Wyróżnij kluczowe kroki, dodając na końcu wiersza „Ten krok jest ważny”. Dwukrotne powtórzenie 1–2 najważniejszych instrukcji w prompcie może je wzmocnić.
Dlaczego to ważne dla niezawodności: W złożonych promptach modele mogą bardziej priorytetyzować najnowszy kontekst niż wcześniejsze instrukcje. Wyróżnienie i powtórzenie sprawiają, że kluczowe zasady nie zostaną pominięte.
Normalizacja tekstu
Modele zamiany tekstu na mowę, zwłaszcza szybsze, najlepiej generują mowę na podstawie tekstu alfabetycznego. Dlatego cyfry i symbole, takie jak „@” czy „£”, częściej powodują błędną wymowę lub halucynacje głosowe.
Aby temu zapobiec, normalizujemy tekst niealfabetyczny do słów, zanim trafi do modelu TTS (np. 123 -> sto dwadzieścia trzy, john@gmail.com -> john małpa gmail kropka com), i pozwalamy wybierać między strategiami normalizacji o różnych kompromisach.
Strategie normalizacji
Obsługujemy dwie strategie normalizacji przez konfigurację agenta text_normalisation_type:
system_prompt (domyślnie) — Dodaje do promptu systemowego instrukcje, aby LLM zapisywał liczby i symbole słowami, zanim tekst trafi do modelu TTS.
- Bez dodatkowych opóźnień
- LLM może czasem nie znormalizować tekstu poprawnie
- Transkrypcje zawierają wszystko zapisane słowami (np. „tysiąc dolarów” zamiast „$1,000”)
Jeśli nie chcesz używać normalizatora TTS i zauważysz, że LLM wciąż czasem odpowiada nienormalizowanym tekstem, rozważ użycie inteligentniejszego LLM lub dodanie dodatkowych instrukcji normalizacji do promptu systemowego.
elevenlabs — Używa naszego normalizatora TTS, aby znormalizować tekst po wygenerowaniu przez LLM, zanim trafi do modelu TTS.
- Bardziej niezawodny niż normalizacja oparta na LLM
- Prompt systemowy nie jest zmieniany
- Transkrypcje zachowują naturalne formatowanie z symbolami i liczbami (np. „$1,000”)
- Dodaje niewielkie opóźnienie
Jeśli czytelność transkrypcji jest ważna w twoim przypadku, rozważ użycie normalizatora elevenlabs. Zachowuje
on przejrzystość transkrypcji z naturalnymi symbolami i liczbami, a jednocześnie tworzy poprawnie wypowiedziane
audio.
Znajdziesz tę konfigurację na naszej platformie na karcie „Agent”. Kliknij ikonę koła zębatego w sekcji „Voices”, aby otworzyć wspólne ustawienia głosu, i skonfiguruj ją na dole.
Dane strukturalne dla danych wejściowych narzędzi
Przy ustawieniu normalizacji system_prompt LLM zapisuje w odpowiedziach symbole i liczby słowami (np. john małpa gmail kropka com zamiast john@gmail.com). Transkrypcje użytkownika z zamiany mowy na tekst mogą też docierać w niestandardowej formie. Oznacza to, że gdy używasz tych danych jako parametrów wywołań narzędzi, LLM może użyć nieustrukturyzowanej wersji obecnej w kontekście rozmowy.
Jeśli parametr narzędzia oczekuje poprawnie sformatowanej wartości (np. john@gmail.com, a nie john małpa gmail kropka com), LLM musi o tym wiedzieć. Dodaj oczekiwany format bezpośrednio do opisu parametru narzędzia wraz z przykładem.
Dodaj osobną sekcję zasad
Wypisz wszystkie bezwzględne zasady, których model musi zawsze przestrzegać, w osobnej sekcji # Guardrails. Modele są dostrojone tak, by zwracać szczególną uwagę na ten nagłówek.
Dlaczego to ważne dla niezawodności: Zasady zapobiegają nieodpowiednim odpowiedziom i zapewniają zgodność z politykami. Zebranie ich w jednej sekcji ułatwia audyt i aktualizacje.
Więcej o projektowaniu skutecznych zasad znajdziesz w naszym przewodniku o zasadach.
Konfiguracja narzędzi dla niezawodności
Agenci obsługujący transakcyjne workflow mogą być bardzo skuteczni. Aby to umożliwić, muszą mieć narzędzia, które pozwalają im wykonywać działania w innych systemach lub pobierać z nich aktualne dane.
Równie ważne jak struktura promptu jest opisanie narzędzi dostępnych dla agenta. Jasne definicje narzędzi, nastawione na działanie, pomagają modelowi poprawnie je wywoływać i sprawnie radzić sobie z błędami.
Opisuj narzędzia precyzyjnie, ze szczegółowymi parametrami
Tworząc narzędzie, dodaj opisy do wszystkich parametrów. Pomaga to LLM dokładnie tworzyć wywołania narzędzi.
Opis narzędzia: „Sprawdza status zamówienia klienta według identyfikatora zamówienia i zwraca bieżący status, szacowaną datę dostawy oraz numer śledzenia.”
Opisy parametrów:
order_id(wymagany): „Unikalny identyfikator zamówienia w formacie znakowym (np. ‘ORD123456’)”include_history(opcjonalny): „Jeśli ma wartość true, zwraca pełną historię zamówienia, w tym zmiany statusu”
Dlaczego to ważne dla niezawodności: Opisy parametrów działają jak dokumentacja wbudowana dla modelu. Wyjaśniają oczekiwany format, pola wymagane i opcjonalne oraz dopuszczalne wartości.
Wyjaśnij w prompcie systemowym, kiedy i jak używać każdego narzędzia
Jasno określ w prompcie systemowym, kiedy i jak należy używać każdego narzędzia. Nie polegaj wyłącznie na opisach narzędzi — podaj kontekst użycia i logikę kolejności.
Określ oczekiwane formaty w opisach parametrów narzędzi
Gdy narzędzia wymagają ustrukturyzowanych identyfikatorów (adresów e-mail, numerów telefonu, kodów), jasno określ oczekiwany format w opisie parametru wraz z przykładem. Jest to szczególnie ważne, ponieważ normalizacja i transkrypcja mowy na tekst mogą tworzyć w kontekście rozmowy wartości w formie mówionej. Więcej informacji znajdziesz w sekcji dane strukturalne dla danych wejściowych narzędzi.
Sprawnie obsługuj błędy wywołań narzędzi
Narzędzia mogą czasem zawieść z powodu problemów z siecią, brakujących danych lub innych błędów. Dodaj do promptu systemowego jasne instrukcje odzyskiwania sprawności.
Dlaczego to ważne dla niezawodności: Awarie narzędzi są nieuniknione w środowisku produkcyjnym. Bez wyraźnych instrukcji obsługi agent może halucynować odpowiedzi lub podawać nieprawidłowe informacje.
Szczegółowe wskazówki dotyczące tworzenia niezawodnych integracji narzędzi znajdziesz w naszej dokumentacji narzędzi klienckich, narzędzi webhook i narzędzi MCP.
Wzorce architektury dla agentów firmowych
Choć solidne prompty i narzędzia są podstawą niezawodności agentów, systemy produkcyjne wymagają przemyślanego projektu architektury. Agenci firmowi obsługują złożone workflow, które często wykraczają poza zakres pojedynczego, monolitycznego promptu.
Wyspecjalizuj agentów
Zbyt szerokie instrukcje lub duże okna kontekstu zwiększają opóźnienia i obniżają dokładność. Każdy agent powinien mieć wąską, jasno określoną bazę wiedzy i zestaw obowiązków.
Dlaczego to ważne dla niezawodności: Wyspecjalizowani agenci mają mniej przypadków brzegowych, jaśniejsze kryteria sukcesu i szybszy czas odpowiedzi. Łatwiej ich testować, debugować i ulepszać.
Uniwersalny agent „do wszystkiego” jest trudniejszy w utrzymaniu i częściej zawodzi w środowisku produkcyjnym niż sieć wyspecjalizowanych agentów z jasnym przekazywaniem zadań.
Stosuj wzorzec orkiestratora i specjalistów
W przypadku złożonych zadań projektuj workflow wielu agentów, które przekazują zadania między wyspecjalizowanymi agentami — a w razie potrzeby także operatorom.
Wzorzec architektury:
- Agent orkiestrator: Kieruje przychodzące zapytania do odpowiednich agentów specjalistycznych na podstawie klasyfikacji intencji
- Agenci specjaliści: Obsługują zadania z konkretnych dziedzin (rozliczenia, planowanie, wsparcie techniczne itd.)
- Przekazanie do człowieka: Zdefiniowane kryteria przekazania dla złożonych lub wrażliwych spraw
Zalety tego wzorca:
- Każdy specjalista ma skoncentrowany prompt i ograniczony kontekst
- Łatwiej aktualizować poszczególnych specjalistów bez wpływu na system
- Jasne metryki dla każdej dziedziny (wskaźnik rozwiązania spraw rozliczeniowych, skuteczność planowania itd.)
- Mniejsze opóźnienie na interakcję (krótsze prompty, szybsze wnioskowanie)
Określ jasne kryteria przekazywania
Projektując workflow wielu agentów, dokładnie określ, kiedy i jak kontrola ma być przekazywana między agentami lub operatorom.
Szczegółowe wskazówki dotyczące tworzenia workflow wielu agentów znajdziesz w dokumentacji Workflow.
Wybór modelu dla niezawodności firmowej
Wybór odpowiedniego modelu zależy od wymagań dotyczących wydajności — szczególnie opóźnień, dokładności i niezawodności wywoływania narzędzi. Różne modele oferują różne kompromisy między szybkością, zdolnością rozumowania i kosztem.
Poznaj kompromisy
Opóźnienie: Mniejsze modele (z mniejszą liczbą parametrów) zwykle odpowiadają szybciej, dlatego nadają się do częstych interakcji o niskiej złożoności.
Dokładność: Większe modele zapewniają lepsze zdolności rozumowania i lepiej obsługują złożone zadania wieloetapowe, ale kosztem większych opóźnień i wyższej ceny.
Niezawodność wywoływania narzędzi: Nie wszystkie modele obsługują wywołania narzędzi/funkcji z taką samą precyzją. Niektóre świetnie radzą sobie z ustrukturyzowanym wyjściem, a inne mogą wymagać bardziej jednoznacznych promptów.
Rekomendacje modeli według przypadku użycia
Na podstawie wdrożeń obejmujących miliony interakcji agentów wyłaniają się następujące wzorce:
-
GPT-4o lub GLM 4.5 Air (zalecany punkt startowy): Najlepsze dla uniwersalnych agentów firmowych, w których trzeba zrównoważyć opóźnienia, dokładność i koszt. Oferują małe lub umiarkowane opóźnienia, dobre wywoływanie narzędzi i rozsądny koszt interakcji. Idealne do obsługi klienta, planowania, zarządzania zamówieniami i obsługi ogólnych zapytań.
-
Gemini 2.5 Flash Lite (bardzo niskie opóźnienie): Najlepszy do częstych, prostych interakcji, w których szybkość ma kluczowe znaczenie. Zapewnia najniższe opóźnienia i szeroką wiedzę ogólną, choć gorzej radzi sobie ze złożonym wywoływaniem narzędzi. Opłacalny na dużą skalę do wstępnego kierowania i selekcji spraw, prostych FAQ, potwierdzania wizyt i podstawowego zbierania danych.
-
Claude Sonnet 4 lub 4.5 (złożone rozumowanie): Najlepszy do wieloetapowego rozwiązywania problemów, niuansów w ocenie i złożonej orkiestracji narzędzi. Oferuje najwyższą dokładność i zdolność rozumowania oraz świetną niezawodność wywoływania narzędzi, ale z większymi opóźnieniami i kosztem. Idealny do zadań, w których błędy są kosztowne, takich jak rozwiązywanie problemów technicznych, doradztwo finansowe, workflow wymagające zgodności i złożone decyzje o zwrotach lub eskalacji.
Testuj na swoich rzeczywistych promptach
Wydajność modelu znacznie różni się zależnie od struktury promptu i złożoności zadania. Zanim wybierzesz model:
- Przetestuj 2–3 modele kandydujące z rzeczywistym promptem systemowym
- Oceń je na prawdziwych zapytaniach użytkowników lub syntetycznych przypadkach testowych
- Zmierz opóźnienie, dokładność i wskaźnik skutecznych wywołań narzędzi
- Wybierz najlepszy kompromis dla swoich konkretnych wymagań
Szczegółowe opcje konfiguracji modeli znajdziesz w dokumentacji Models.
Iteracja i testowanie
Niezawodność w produkcji wynika z ciągłych iteracji. Nawet dobrze skonstruowane prompty mogą zawieść w rzeczywistym użyciu. Ważne jest wyciąganie wniosków z tych błędów i ulepszanie dzięki systematycznym testom.
Skonfiguruj kryteria oceny
Dołącz konkretne kryteria oceny do każdego agenta, aby z czasem monitorować sukces i sprawdzać regresje.
Kluczowe metryki do śledzenia:
- Wskaźnik ukończenia zadań: Procent intencji użytkowników skutecznie obsłużonych
- Wskaźnik eskalacji: Procent rozmów wymagających interwencji człowieka
Szczegółowe wskazówki dotyczące konfiguracji kryteriów oceny w ElevenLabs znajdziesz w sekcji Ocena sukcesu.
Analizuj wzorce błędów
Gdy agenci działają słabo, szukaj wzorców w problematycznych interakcjach:
- Gdzie agent podaje nieprawidłowe informacje? → Wzmocnij instrukcje w konkretnych sekcjach
- Kiedy nie rozumie intencji użytkownika? → Dodaj przykłady lub uprość język
- Które dane wejściowe użytkownika sprawiają, że wychodzi z roli? → Dodaj zasady dla przypadków brzegowych
- Które narzędzia najczęściej zawodzą? → Popraw obsługę błędów lub opisy parametrów
Przeglądaj transkrypcje rozmów, w których satysfakcja użytkownika była niska lub zadania nie zostały ukończone.
Wprowadzaj ukierunkowane poprawki
Aktualizuj konkretne sekcje promptu, by rozwiązać wykryte problemy:
- Wyizoluj problem: Ustal, która sekcja promptu lub definicja narzędzia powoduje błędy
- Testuj zmiany na konkretnych przykładach: Używaj rozmów, które wcześniej się nie powiodły, jako przypadków testowych
- Wprowadzaj jedną zmianę naraz: Izoluj ulepszenia, by zrozumieć, co działa
- Oceń ponownie na tych samych przypadkach testowych: Sprawdź, czy zmiana rozwiązała problem bez tworzenia nowych
Unikaj jednoczesnego wprowadzania wielu zmian w prompcie. Uniemożliwia to przypisanie ulepszeń lub regresji do konkretnych edycji.
Skonfiguruj zbieranie danych
Skonfiguruj agenta tak, aby podsumowywał dane z każdej rozmowy. Pozwala to analizować wzorce interakcji, wykrywać częste zapytania użytkowników i stale ulepszać prompt na podstawie rzeczywistego użycia.
Szczegółowe wskazówki dotyczące konfiguracji zbierania danych w ElevenLabs znajdziesz w sekcji Zbieranie danych.
Używaj symulacji do testów regresji
Przed wdrożeniem zmian promptu do produkcji przetestuj je na zestawie znanych scenariuszy, aby wykryć regresje.
Wskazówki dotyczące programowego testowania agentów znajdziesz w sekcji Symulowanie rozmów.
Kwestie produkcyjne
Agenci firmowi wymagają dodatkowych zabezpieczeń poza jakością promptu. Wdrożenia produkcyjne muszą uwzględniać obsługę błędów, zgodność i płynne ograniczanie działania.
Obsługuj błędy we wszystkich integracjach narzędzi
Każde wywołanie zewnętrznego narzędzia jest potencjalnym punktem awarii. Upewnij się, że prompt zawiera jawną obsługę błędów dla:
- Awarii sieci: „Mam problem z połączeniem z naszym systemem. Spróbuję ponownie.”
- Brakujących danych: „Nie widzę tej informacji w naszym systemie. Czy możesz sprawdzić szczegóły?”
- Błędów limitu czasu: „To trwa dłużej, niż oczekiwano. Mogę przekazać sprawę specjaliście lub spróbować ponownie.”
- Błędów uprawnień: „Nie mam dostępu do tej informacji. Przekażę cię osobie, która może pomóc.”
Przykładowe prompty
Poniższe przykłady pokazują, jak zastosować zasady opisane w tym przewodniku w rzeczywistych firmowych przypadkach użycia. Każdy przykład zawiera adnotacje wskazujące wykorzystane zasady niezawodności.
Przykład 1: Agent wsparcia technicznego
Pokazane zasady:
- ✓ Jasny podział na sekcje (
# Personality,# Goal,# Toolsitd.) - ✓ Jedno działanie w wierszu (zobacz numerowane kroki w
# Goal) - ✓ Zwięzłe instrukcje (sekcja tonu jest krótka i jasna)
- ✓ Wyróżnione kluczowe kroki („Ten krok jest ważny”)
- ✓ Konwersja formatu w opisach parametrów (normalizacja e-maili)
- ✓ Osobna sekcja zasad
- ✓ Precyzyjne opisy narzędzi z informacją kiedy/jak postępować przy błędach
- ✓ Jasne instrukcje obsługi błędów
Przykład 2: Agent obsługi zwrotów klienta
Pokazane zasady:
- ✓ Wyspecjalizowany zakres agenta (tylko zwroty, nie ogólne wsparcie)
- ✓ Jasne kroki workflow w sekcji
# Goal - ✓ Powtarzane wyróżnienie kluczowych zasad (limity zwrotów, weryfikacja)
- ✓ Szczegółowe użycie narzędzi z informacją „kiedy użyć” i „wymagane kontrole”
- ✓ Konwersja formatu w opisach parametrów (identyfikatory zamówień, e-maile)
- ✓ Jasna obsługa błędów dla każdego narzędzia
- ✓ Jasno określone kryteria eskalacji
Dobre praktyki formatowania
Format promptu wpływa na to, jak skutecznie model językowy go interpretuje:
- Używaj nagłówków Markdown: Twórz sekcje za pomocą
#dla głównych sekcji i##dla podsekcji - Wybieraj listy punktowane: Dziel instrukcje na łatwe do przyswojenia punkty
- Używaj pustych odstępów: Oddzielaj sekcje i grupy instrukcji pustymi wierszami
- Stosuj wielkość liter jak w zdaniu w nagłówkach:
# Cel, a nie# CEL - Zachowaj spójność: Używaj tego samego formatu w całym prompcie
Często zadawane pytania
Jak zachować spójność między wieloma agentami?
Twórz wspólne szablony promptów dla typowych sekcji, takich jak normalizacja znaków, obsługa błędów i zabezpieczenia. Przechowuj je w centralnym repozytorium i odwołuj się do nich w wyspecjalizowanych agentach. Użyj wzorca orkiestratora, aby zapewnić spójną logikę przekierowań i procedury przekazywania rozmów.
Jaki jest minimalny prompt gotowy do użycia na produkcji?
Uwzględnij co najmniej: (1) definicję osobowości/roli, (2) główny cel, (3) kluczowe zabezpieczenia oraz (4) opisy narzędzi, jeśli są używane. Nawet proste agenty zyskują na jasnej strukturze sekcji i instrukcjach obsługi błędów.
Jak wycofać narzędzie bez psucia agentów?
Gdy wycofujesz narzędzie, najpierw dodaj nowe, a potem zaktualizuj prompt tak, by preferował nowe narzędzie, zachowując stare jako opcję zapasową. Monitoruj użycie, a następnie usuń stare narzędzie, gdy spadnie ono do zera. Zawsze uwzględniaj obsługę błędów, aby agenty mogły się odzyskać po wywołaniu wycofanego narzędzia.
Czy powinienem używać różnych promptów dla różnych LLM-ów?
Zwykle prompty o strukturze zgodnej z zasadami z tego przewodnika działają między modelami. Jednak dostrajanie pod konkretny model może poprawić wyniki — zwłaszcza format wywoływania narzędzi i kroki rozumowania. Przetestuj prompt na kilku modelach i w razie potrzeby go dostosuj.
Jak długi powinien być mój prompt systemowy?
Nie ma uniwersalnego limitu, ale prompty powyżej 2000 tokenów zwiększają opóźnienia i koszt. Skup się na zwięzłości: każda linia powinna służyć jasnemu celowi. Jeśli prompt przekracza 2000 tokenów, rozważ podzielenie go na kilka wyspecjalizowanych agentów lub przeniesienie materiałów referencyjnych do bazy wiedzy.
Jak pogodzić spójność z elastycznością?
Jasno określ kluczowe cechy osobowości, cele i zabezpieczenia, ale zachowaj elastyczność tonu i szczegółowości zależnie od stylu komunikacji użytkownika. Używaj instrukcji warunkowych: „Jeśli użytkownik jest sfrustrowany, najpierw uznaj jego obawy, a potem przejdź dalej”.
Czy mogę aktualizować prompty po wdrożeniu?
Tak. Prompty systemowe można modyfikować w dowolnym momencie, aby zmienić zachowanie. To szczególnie przydatne przy rozwiązywaniu nowych problemów lub doskonaleniu możliwości na podstawie interakcji z użytkownikami. Zawsze testuj zmiany w środowisku testowym przed wdrożeniem ich na produkcję.
Jak zapobiec halucynacjom agentów, gdy narzędzia zawodzą?
Dodaj jasne instrukcje obsługi błędów dla każdego narzędzia. Podkreśl w sekcji zabezpieczeń, by „nigdy nie zgadywać ani nie wymyślać informacji”. Powtórz tę instrukcję w sekcjach obsługi błędów specyficznych dla narzędzi. Testuj scenariusze awarii narzędzi podczas tworzenia, aby upewnić się, że agenty stosują instrukcje odzyskiwania działania.
Kolejne kroki
Ten przewodnik tworzy podstawę niezawodnego działania agentów dzięki prompt engineeringowi, konfiguracji narzędzi i wzorcom architektonicznym. Aby tworzyć systemy gotowe do produkcji, przejdź dalej:
- Workflow: Projektuj orkiestrację wielu agentów i przekazywanie rozmów specjalistom
- Ocena sukcesu: Skonfiguruj metryki i kryteria oceny
- Zbieranie danych: Zbieraj uporządkowane informacje z rozmów
- Testowanie: Wdróż testy regresji i symulacje
- Zabezpieczenia: Skonfiguruj moderację treści dla bezpiecznych odpowiedzi agentów
- Prywatność: Zapewnij zgodność i ochronę danych
- Nasz agent dokumentacji: Zobacz pełne case study tych zasad w praktyce
Jeśli potrzebujesz wsparcia przy wdrożeniu enterprise, skontaktuj się z naszym zespołem.