

Guardrails
Steuern Sie das Verhalten von Agenten in der Produktion mit Schutzmechanismen für sichere, konforme und zuverlässige Antworten.
Überblick
Guardrails geben Teams leistungsstarke Möglichkeiten, das Verhalten von Agenten in der Produktion zu steuern. Sie halten sie beim Thema, markenkonform und widerstandsfähig gegen Manipulation – auch im Unternehmensmaßstab.
Mit Guardrails 2.0 haben wir die Sicherheitsebene neu entwickelt. Teams können damit eigene Richtlinien einfacher in natürlicher Sprache definieren, vorgefertigte Schutzmechanismen aktivieren, festlegen, was bei Auslösung eines Guardrails geschieht, und Agenten zuverlässig für geschäftskritische Workflows bereitstellen.
Guardrails führen Agenten zu den richtigen Antworten und stoppen falsche Antworten, bevor sie Nutzer erreichen. Sie schützen Gespräche auf mehreren Ebenen: Sie steuern die Antworten des Agenten, prüfen Nutzereingaben und bewerten jede Antwort unabhängig ohne zusätzliche Latenz. So sinkt das Marken- und Compliance-Risiko in jedem Gespräch.
So funktionieren Guardrails
Guardrails schützen Gespräche auf drei Ebenen:
Absicherung des System Prompts: Die wichtigste Methode zur Steuerung des Agentenverhaltens. Ergänzen Sie den System Prompt um klare Vorgaben zu erlaubtem und verbotenem Verhalten und aktivieren Sie den Focus Guardrail, um diese Anweisungen während des gesamten Gesprächs zu verstärken. So bleibt Ihr Agent in den meisten Interaktionen auf Kurs.
Validierung von Nutzereingaben: Ein Sicherheitsnetz, das gegnerische Versuche abfängt, bevor der Agent überhaupt antwortet. Guardrails analysieren Nutzereingaben, erkennen Prompt-Injection- und Manipulationsversuche und können Gespräche beenden, die ein Sicherheitsrisiko darstellen.
Validierung von Agentenantworten: Eine abschließende Prüfung, die jede Agentenantwort in Echtzeit unabhängig anhand Ihrer konfigurierten Richtlinien bewertet. Wenn der Agent trotz seines System Prompts etwas sagen will, das gegen Ihre Regeln verstößt, blockieren Antwortvalidatoren dies vor der Auslieferung.
Die Absicherung des System Prompts bildet die Grundlage. Die Eingabe- und Antwortvalidierung korrigieren alles, was durch diese Grundlage fällt. Nehmen Sie Ihre wichtigsten Regeln sowohl in den System Prompt als auch als unabhängigen benutzerdefinierten Guardrail auf. So entsteht eine mehrschichtige Verteidigung: Selbst wenn das LLM von seinen Anweisungen abweicht, fängt der Antwortvalidator dies vor der Auslieferung ab.
Absicherung des System Prompts
Der effektivste Weg, damit sich Ihr Agent wie vorgesehen verhält, ist ein guter System Prompt in Kombination mit dem Focus Guardrail. Zusammen führen sie Agenten von Beginn an zu den richtigen Antworten.
Mit dem System Prompt können Sie klare Anweisungen dazu geben, was Ihr Agent tun soll und was nicht. Modelle sind darauf abgestimmt, der Überschrift # Guardrails besondere Aufmerksamkeit zu schenken. Verwenden Sie diese Überschrift für Ihre wichtigsten Verhaltensregeln.
Eine umfassende Anleitung zum Schreiben effektiver System Prompts finden Sie in unserem Prompting-Leitfaden. Ihr ElevenLabs-Account-Team unterstützt Sie auch beim Erstellen hochwertiger System Prompts.
Focus Guardrail: Der Focus Guardrail verstärkt den System Prompt Ihres Agenten. Er hilft, Antworten zielgerichtet, relevant und im Einklang mit Ihren definierten Zielen und Anweisungen zu halten. Das ist besonders bei langen oder komplexen Gesprächen hilfreich, in denen der Agent eher von seinen vorgesehenen Zielen abweichen kann.
Die Kombination aus der Absicherung des System Prompts und der Aktivierung des Focus Guardrails ist der effektivste Weg, Agenten zu den richtigen Antworten zu führen.
Validierung von Nutzereingaben
Manipulation Guardrails
Erkennt und blockiert Versuche von Nutzern, den Agenten zur Umgehung seiner Anweisungen zu manipulieren. Wenn diese Funktion aktiviert ist, analysiert das System Nutzereingaben auf Muster, die auf Injektions- oder Anweisungsüberschreibungsversuche hinweisen, und kann Gespräche beenden, die ein Sicherheitsrisiko darstellen.
Validierung von Agentenantworten
Content Guardrails
Kennzeichnet und verhindert unangemessene Inhalte in Agentenantworten, etwa politisch sensible, sexuell explizite oder gewalttätige Inhalte, bevor sie Nutzer erreichen. So bleiben Antworten für den vorgesehenen Anwendungsfall und die Zielgruppe Ihres Agenten angemessen.
Benutzerdefinierte Guardrails
Wenn Agenten geschäftskritische Aufgaben übernehmen, benötigen Teams klare Kontrolle über ihr Verhalten. Mit benutzerdefinierten Guardrails können Sie die wichtigsten Richtlinien für Ihr Unternehmen konfigurieren. Zum Beispiel:
- Ein Handelsassistent sollte keine Rückerstattungen für nicht berechtigte Artikel gewähren.
- Ein Empfangsmitarbeiter im Gesundheitswesen sollte keine medizinischen Ratschläge geben.
- Ein Banken-Agent sollte keine Anlageempfehlungen geben.
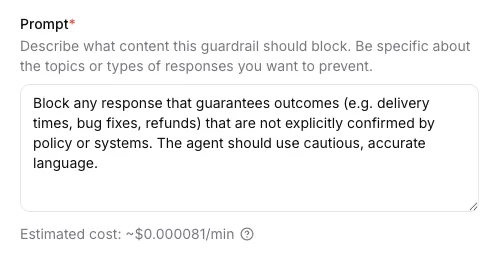
Benutzerdefinierte Guardrails sind LLM-basierte Regeln, mit denen Sie eigene Blockierungskriterien über Prompts in natürlicher Sprache definieren können. Jeder aktivierte benutzerdefinierte Guardrail sendet Agentenantworten an ein schlankes Modell, das sie anhand Ihrer Regel bewertet und eine Entscheidung zum Blockieren oder Zulassen zurückgibt. Das gibt Ihnen flexible, domänenspezifische Kontrolle darüber, was Ihr Agent sagen darf und was nicht.
Für jeden benutzerdefinierten Guardrail können Sie Folgendes definieren:
Mit benutzerdefinierten Guardrails können Sie für Ihr Unternehmen relevante Themen blockieren, branchenspezifische Compliance-Anforderungen durchsetzen und eigene Sicherheitsmaßnahmen umsetzen. Jeder Guardrail kann einzeln ein- oder ausgeschaltet werden, ohne ihn zu löschen. Wenn mehrere aktiviert sind, werden sie parallel zu anderen Guardrails ausgeführt. Alle ausgelösten Verstöße werden zur Überprüfung protokolliert.
Ausführungsmodus
Der Ausführungsmodus bestimmt, ob Guardrails Wartezeit hinzufügen, bevor der Nutzer eine Antwort sieht oder hört.
Im Streaming-Modus kann die Agentenantwort beginnen, bevor der Guardrail ausgelöst wird. Bei Sprache kann ein kleiner Teil des Audios (oft weniger als 500 ms) ausgegeben werden, bevor eine Blockierung den Anruf beendet. Bei Text-Agenten können Nutzer teilweise oder vollständige Antworten sehen, wenn die Bewertung nicht vor der Auslieferung abgeschlossen ist.
Im Blocking-Modus antwortet der Agent erst, nachdem die Guardrails validiert wurden. Das fügt in der Regel 200–500 ms zusätzliche Latenz hinzu.
Exit-Strategien
Mit Exit-Strategien definieren Sie, was Ihr Agent tut, wenn ein Guardrail ausgelöst wird. Sie können wählen zwischen:
end_call(Standard): beendet den Anruf sofortretry: generiert die Antwort mit Ihrem Feedback neu, statt das Gespräch abzubrechen. Die Agentenantwort wird bis zu dreimal erneut versucht. Wenn jeder Versuch weiterhin gegen den Guardrail verstößt, wird der Anruf beendet.
Retry funktioniert nur im Blocking-Modus. Im Streaming-Modus ist das Beenden des Anrufs die einzige verfügbare Exit- Strategie.
Feedback für Retry
Retry-Feedback kann beliebige Anweisungen enthalten, die im nächsten Zug angewendet werden sollen – es wird als Systemanweisung eingefügt, bevor das Modell erneut generiert. Dazu gehört auch der Aufruf von Systemtools wie transfer_to_agent oder transfer_to_number. Hier sind einige Beispiele für die Konfiguration von Retry-Feedback:
- Allgemeine Ablehnung (Standard)
Ihre Antwort wurde von einem Guardrail blockiert, der Inhalte blockiert, die dieser Bedingung/Kategorie entsprechen: ‘{{trigger_reason}}’. In Ihrem nächsten Zug müssen Sie dem Nutzer sagen: “Es tut mir leid, aber ich kann diese Frage nicht beantworten. Möchten Sie etwas anderes wissen?” - Retry mit korrigierenden Anweisungen
Ihre vorherige Antwort wurde von einem Guardrail blockiert. Ihre blockierte Antwort war: ‘{{agent_message}}’. In Ihrem nächsten Zug müssen Sie eine neue Antwort geben, die nicht gegen Folgendes verstößt: ‘{{trigger_reason}}’. - An einen anderen Agenten weiterleiten
Ihre vorherige Antwort wurde vom Guardrail blockiert. In Ihrem nächsten Zug müssen Sie das Tool transfer_to_agent verwenden und an einen Agenten weiterleiten. Ihre blockierte Antwort war: ‘{{agent_message}}’. Der Guardrail blockiert Inhalte, die dieser Bedingung/Kategorie entsprechen: ‘{{trigger_reason}}’. - An eine Person weiterleiten
Ihre Antwort wurde von einem Guardrail blockiert, der Inhalte blockiert, die dieser Bedingung/Kategorie entsprechen: ‘{{trigger_reason}}’. In Ihrem nächsten Zug MÜSSEN Sie den Anruf mit dem Tool transfer_to_number an einen menschlichen Mitarbeiter weiterleiten.
Um Systemtools im Retry-Feedback zu verwenden, aktivieren und konfigurieren Sie die entsprechenden Tools in den Agenteneinstellungen. Es können nur Tools aufgerufen werden, die für den Agenten eingerichtet sind.
Sie können diese Platzhalter im Feedbacktext verwenden:
Der Streaming-Ausführungsmodus wird für Sprach-Agenten empfohlen. Der Blocking-Ausführungsmodus wird für Text-Agenten empfohlen.
Blocking (insbesondere mit retry) kann sich bei Sprache weniger vorhersehbar verhalten. Wenn Sie Blocking bei Sprache verwenden, testen Sie gründlich oder wählen Sie end call statt retry, bis Sie sich auf das Verhalten verlassen können.
Preise
Die Guardrails Focus, Manipulation und Content sind für alle ElevenAgents-Nutzer ohne zusätzliche Kosten enthalten.
Benutzerdefinierte Guardrails sind nutzungsbasiert und verursachen zusätzliche LLM-Kosten, ähnlich wie andere Modellaufrufe in ElevenAgents. Jeder aktivierte benutzerdefinierte Guardrail sendet jede Agentenantwort zur Bewertung an ein schlankes Modell. Die Kosten hängen daher von der Länge des Prompts, der Länge des durchschnittlichen Gesprächs und dem Gesprächsvolumen ab. Wenn Sie mehrere benutzerdefinierte Guardrails aktivieren, führt jeder eine eigene Bewertung pro Antwort aus. Prüfen Sie Ihr erwartetes Aufkommen und die Modellauswahl, bevor Sie mehrere benutzerdefinierte Guardrails in der Produktion aktivieren.
Beim Erstellen oder Bearbeiten eines benutzerdefinierten Guardrails sehen Sie unter dem Prompt eine Kostenschätzung.
Retry und Kosten: Jeder Versuch ist eine zusätzliche Agentengenerierung plus eine weitere Guardrail-Bewertung. Daher erhöht retry die nutzungsbasierte Abrechnung gegenüber end_call (bis zu drei Versuche pro blockiertem Zug).
Konfiguration
Über das Dashboard konfigurieren
Über die CLI konfigurieren
Über die API konfigurieren
Guardrails aktivieren
Aktivieren Sie die Guardrail-Kategorien, die Sie verwenden möchten. Mit den Schaltflächen für Voreinstellungen können Sie schnell alle Kategorien aktivieren oder deaktivieren.
Ausführungsmodus und Exit-Strategie konfigurieren (benutzerdefinierte und Content Guardrails)
Wählen Sie für jeden benutzerdefinierten oder Content Guardrail den Ausführungsmodus streaming oder blocking.
Blocking eignet sich für Text-Agenten, streaming für Sprach-Agenten. Legen Sie Aktion bei
Guardrail-Verstoß fest (entspricht trigger_action): Anruf beenden in jedem Modus oder retry
nur bei Auswahl von blocking (retry ist bei streaming nicht verfügbar). Wenn Sie retry wählen,
bearbeiten Sie Beim Retry einzufügendes Feedback, um das Modell zu steuern. Verwenden Sie die Platzhalter
{{trigger_reason}} (der benutzerdefinierte Prompt oder die Content-Kategorie, die die
Blockierung ausgelöst hat) und {{agent_message}} in der Vorlage.
Wenn ein Guardrail ausgelöst wird, hängt das Verhalten vom Typ und der Konfiguration ab:
- Anruf beenden: Die Sitzung wird sofort beendet (Anruf wird bei Sprache getrennt, Chat wird bei Text beendet). Die Auslösung wird im Gesprächsverlauf protokolliert.
- Retry (blockierende benutzerdefinierte oder Content Guardrails): Der regelverletzende Assistentenzug wird entfernt, Systemfeedback wird eingefügt und das Modell versucht es erneut – bis zu dreimal –, bevor die Sitzung endet, falls der Guardrail weiterhin ausgelöst wird.
Bei Anruf beenden erleben Endnutzer einen getrennten Anruf oder einen beendeten Chat. Details zum Verstoß stehen Ihnen in den Gesprächsprotokollen zur Verfügung und werden Endnutzern nicht wörtlich angezeigt.
Nach Anruf beenden können Nutzer ein neues Gespräch starten. Der Guardrail blockiert den Nutzer nicht dauerhaft – er blockiert die konkrete Antwort (oder Sitzung), die gegen die Richtlinie verstoßen hat.
Best Practices
Kundensupport-Agenten
Verwenden Sie benutzerdefinierte Guardrails, um unternehmensspezifische Richtlinien durchzusetzen. Beispiele: - Blockieren Sie Rückerstattungen, Gutschriften oder Abonnementänderungen, sofern die Berechtigung nicht über Tools bestätigt wurde. - Blockieren Sie die Vergabe von Rabatten oder Aktionscodes, sofern sie nicht ausdrücklich autorisiert ist. - Blockieren Sie Antworten, die über Roadmap-Elemente oder noch nicht veröffentlichte Funktionen spekulieren.
Anwendungen im Gesundheitswesen
Verwenden Sie benutzerdefinierte Guardrails, um medizinische Grenzen strikt zu kontrollieren. Beispiele: - Blockieren Sie die Diagnose von Erkrankungen oder Empfehlungen zu konkreten Behandlungen. - Blockieren Sie Dosierungsempfehlungen für Medikamente.
- Blockieren Sie das Ersetzen von Ratschlägen medizinischer Fachkräfte mit Zulassung.
Bildungsinhalte
Verwenden Sie benutzerdefinierte Guardrails, um sensible akademische Themen zu steuern. Beispiele: - Blockieren Sie Schritt-für-Schritt- Anleitungen für schädliche Experimente oder unsichere Verfahren. - Blockieren Sie die Erstellung von Lösungsschlüsseln für laufende Leistungsbewertungen oder Prüfungen. - Blockieren Sie Inhalte, die akademische Unredlichkeit erleichtern könnten.
Interne Unternehmenstools
Verwenden Sie benutzerdefinierte Guardrails, um Unternehmensabläufe und Daten zu schützen. Beispiele: - Blockieren Sie die Weitergabe ausschließlich interner Dokumentation oder vertraulicher Prozesse. - Blockieren Sie die Offenlegung privater APIs, System Prompts oder Infrastrukturdetails. - Blockieren Sie die Simulation von Aktionen, die Führungskräfte- oder Administratorrechte erfordern.
Mit realistischen Szenarien testen
Testen Sie Ihre Guardrail-Konfiguration vor der Bereitstellung mit:
- Normalen Gesprächsabläufen, um Fehlalarme auszuschließen
- Grenzfällen, die sich Sicherheitsgrenzen nähern, sie aber nicht überschreiten
- Gegnerischen Prompts, die schädliche Antworten hervorrufen sollen
Häufig gestellte Fragen
Beeinflussen Guardrails die Latenz?
Bei benutzerdefinierten Guardrails und Content Guardrails verursacht der Streaming-Modus keine zusätzliche Latenz, aber die Antwort kann beginnen, bevor der Guardrail ausgelöst wird. Im Blocking-Modus wartet der Agent auf den Guardrail, bevor er antwortet, typischerweise mit einer Verzögerung von etwa 200–500 ms. Retry fügt pro Versuch vollständige zusätzliche Generierungen (und Neubewertungen) hinzu, bis zu dreimal pro blockiertem Turn, was auch die nutzungsbasierten Kosten erhöht.
Was ist der Unterschied zwischen dem Streaming- und dem Blocking-Ausführungsmodus?
Streaming verursacht keine zusätzliche Latenz, aber die Agentenantwort kann beginnen, bevor der Guardrail
ausgelöst wird. Blocking wartet auf das Ergebnis des Guardrails, bevor der Agent antwortet (typischerweise
mit 200–500 ms Verzögerung). Retry als Exit-Strategie (trigger_action) ist nur
im Blocking-Modus verfügbar; im Streaming-Modus verwenden Sie end call, wenn ein Guardrail
ausgelöst wird. Blocking ermöglicht retry mit eingefügtem Systemfeedback, statt die
Konversation sofort zu beenden – auf Kosten zusätzlicher Modellnutzung und zusätzlicher Abrechnung, wenn
Wiederholungen erfolgen. Blocking wird für Text-Agenten empfohlen, Streaming für
Voice-Agenten.
Kann ich Guardrails vollständig deaktivieren?
Ja, aber wir empfehlen dringend, alle Guardrails aktiviert zu lassen – insbesondere den Focus Guardrail. Sie schützen Ihre Marke, Ihre Nutzer und Ihre Compliance-Position und wir empfehlen sie für alle Produktionsanwendungen, einschließlich interner Tools. In seltenen Fällen möchten Sie möglicherweise einen bestimmten Guardrail deaktivieren, wenn er den vorgesehenen Anwendungsfall Ihres Agenten beeinträchtigt. Einige Anwendungen können beispielsweise Themen behandeln, die der Content Guardrail sonst markieren würde, oder ein stark angepasster System Prompt funktioniert möglicherweise nicht richtig, wenn der Focus Guardrail aktiviert ist. Jeder Guardrail kann einzeln ein- oder ausgeschaltet werden.
Können Nutzer Guardrail-Entscheidungen anfechten?
Guardrail-Auslösungen werden protokolliert und können in Ihrer Konversationsanalyse überprüft werden. Wenn Sie False Positives feststellen, passen Sie Ihre Guardrail-Prompts an. Es gibt keinen automatisierten Einspruchsprozess – der Nutzer sollte einfach eine neue Konversation starten.
Wie finde ich heraus, welcher Guardrail ausgelöst wurde?
Informationen darüber, welcher Guardrail ausgelöst wurde, finden Sie in Ihren Konversationslogs.
Sollte ich sowohl Guardrails als auch System Prompt Hardening verwenden?
Ja. Sie erfüllen sich ergänzende Zwecke. System Prompt Hardening bietet Verhaltensrichtlinien und verhindert die meisten Probleme durch das Befolgen von Anweisungen. Plattform-Guardrails sorgen als Sicherheitsnetz für eine unabhängige Durchsetzung. Zusammen bieten beide einen mehrschichtigen Schutz.
Nächste Schritte
- Prompting-Leitfaden: Erfahren Sie, wie Sie effektive System Prompts mit verhaltensbezogenen Guardrails schreiben
- Datenschutz: Konfigurieren Sie Einstellungen für Datenaufbewahrung und Datenschutz
- Tests: Testen Sie Ihren Agenten mit verschiedenen Szenarien
- Konversationen simulieren: Testen Sie Guardrail-Konfigurationen programmatisch
- Schwärzung des Konversationsverlaufs: Schwärzen Sie sensible Informationen wie Namen und Bankdaten im Konversationsverlauf
Release-Status
Guardrails sind allgemein verfügbar, einschließlich der Focus- und Manipulation-Guardrails.
Die Content- und Custom-Guardrails befinden sich in der Alpha-Phase. Wir verbessern sie kontinuierlich. Sie können davon ausgehen, dass sich ihre Standardeinstellungen, Dashboard-Steuerelemente und API-Felder vor der allgemeinen Verfügbarkeit weiterentwickeln. Einige Änderungen können Breaking Changes sein.
Wenn Sie Content- oder Custom-Guardrails verwenden, empfehlen wir, Ihr Setup zu validieren, das Verhalten der Guardrails in Ihren Logs zu überwachen und Ihre Konfiguration bei Updates erneut zu prüfen.