

ガードレール
安全性、コンプライアンス、信頼性を保つ保護機能で、本番環境におけるエージェントの動作を制御します。
概要
ガードレールは、本番環境でのエージェントの動作をチームが強力に管理できるようにします。エンタープライズ規模でも、話題から逸れず、ブランドに沿い、操作に強い状態を維持できます。
Guardrails 2.0では、安全性レイヤーを刷新しました。チームは自然言語でカスタムポリシーを簡単に定義でき、事前構築済みの保護機能をオンにし、ガードレールが発動した際の動作を制御して、影響の大きいワークフロー全体に安心してエージェントをデプロイできます。
ガードレールは、エージェントを適切な応答へ導き、不適切な応答がユーザーに届く前に停止します。エージェントの応答方法を整え、ユーザー入力を検証し、遅延を追加せずにすべての返信を独立して評価するという複数のレイヤーで会話を保護します。これにより、すべての会話におけるブランドリスクとコンプライアンスリスクを低減できます。
ガードレールの仕組み
ガードレールは、3つのレベルで会話を保護します。
システムプロンプトの強化: エージェントの動作を制御する主な方法です。許可される動作と許可されない動作に関する明確な指示をシステムプロンプトに追加し、Focus Guardrailを有効にして、会話全体でその指示を強化します。これにより、大半のやり取りでエージェントを正しい方向に維持できます。
ユーザー入力の検証: エージェントが応答する前に、敵対的な試みを検出するセーフティネットです。ガードレールはユーザーの発言を分析し、プロンプトインジェクションや操作の試みを検出して、セキュリティリスクのある会話を終了できます。
エージェント応答の検証: 設定したポリシーに照らして、すべてのエージェントの返信をリアルタイムで独立して評価する最終チェックです。システムプロンプトに従っているにもかかわらずエージェントがルールに違反する内容を発言しようとした場合、応答バリデーターが配信前にブロックします。
システムプロンプトの強化が基盤です。入力と応答の検証は、見落とされた問題を軌道修正します。最も重要なルールについては、システムプロンプトと独立したカスタムガードレールの両方に含めてください。これにより多層防御が実現し、LLMが指示から逸脱しても、応答バリデーターが配信前に検出します。
システムプロンプトの強化
エージェントを意図どおりに動作させる最も効果的な方法は、優れたシステムプロンプトを作成し、Focus Guardrailを有効にすることです。これらを組み合わせることで、最初からエージェントを適切な応答へ導けます。
システムプロンプトでは、エージェントがすべきこととすべきでないことを明確に指示できます。モデルは、# Guardrails見出しに特に注意を払うよう調整されています。最も重要な動作ルールには、この見出しを使用してください。
効果的なシステムプロンプトの作成に関する包括的なガイダンスは、プロンプトガイドを参照してください。ElevenLabsのアカウントチームも、高品質なシステムプロンプトの作成をサポートできます。
Focus Guardrail: Focus Guardrailはエージェントのシステムプロンプトを強化し、定義した目標や指示に沿って、応答の方向性、関連性、一貫性を保ちます。特に、エージェントが意図した目的から逸脱しやすい長時間または複雑な会話で役立ちます。
システムプロンプトの強化とFocus Guardrailの有効化を組み合わせることが、エージェントを適切な応答へ導く最も効果的な方法です。
ユーザー入力の検証
Manipulation Guardrails
ユーザーがエージェントを操作して指示を回避させようとする試みを検出し、ブロックします。有効にすると、システムはインジェクションや指示の上書きを試みるパターンがないかユーザー入力を分析し、セキュリティリスクのある会話を終了できます。
エージェント応答の検証
Content guardrails
政治的に慎重な扱いが必要な内容、性的に露骨な内容、暴力的な内容など、エージェントの応答に含まれる不適切なコンテンツを、ユーザーに届く前に検出して防止します。これにより、エージェントの想定ユースケースと対象ユーザーに適した応答を維持できます。
Custom guardrails
エージェントが影響の大きい業務を担うようになると、チームはその動作を明確に制御する必要があります。Custom Guardrailsでは、ビジネスにとって最も重要なポリシーを設定できます。例:
- 小売アシスタントは、対象外の商品に対して返金を行わない。
- 医療機関の受付担当者は、医療アドバイスを提供しない。
- 銀行エージェントは、投資を推奨しない。
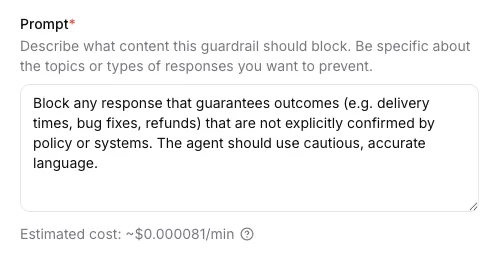
Custom Guardrailsは、自然言語プロンプトを使用して独自のブロック基準を定義できる、LLMベースのルールです。有効なCustom Guardrailごとに、エージェントの応答が軽量モデルに送信され、ルールに照らして評価し、ブロックまたは許可の判断を返します。これにより、エージェントが発言できる内容とできない内容を、柔軟かつドメイン固有の方法で制御できます。
カスタムガードレールごとに、次の項目を定義できます。
Custom Guardrailsは、ビジネスに関連する特定のトピックをブロックしたり、業界固有のコンプライアンス要件を適用したり、独自の安全対策を実装したりするために使用できます。それぞれを削除せずに個別にオンまたはオフにでき、複数を有効にすると、他のガードレールと並行して実行されます。発生した違反はすべて、レビュー用にログに記録されます。
実行モード
実行モードは、ユーザーが応答を見たり聞いたりする前に、ガードレールによる待機時間を追加するかどうかを決定します。
streamingモードでは、ガードレールが発動する前にエージェントの応答が始まる可能性があります。音声の場合、ブロックによって通話が終了する前に、短いオーディオ(多くの場合500ms未満)が配信されることがあります。テキストエージェントの場合、配信前に評価が完了しなければ、ユーザーは応答の一部または全部を見る可能性があります。
Blockingモードでは、ガードレールによる検証が完了した後にのみ、エージェントが応答します。通常、200~500msの追加遅延が発生します。
終了戦略
終了戦略では、ガードレールが発動したときにエージェントが行う動作を定義できます。次から選択できます。
end_call(デフォルト):通話をすぐに終了しますretry:会話を中断する代わりに、フィードバックを使用して応答を再生成します。エージェントの応答は最大3回再試行され、すべての試行でガードレールに違反した場合は通話が終了します。
再試行はブロッキングモードでのみ機能します。ストリーミングモードでは、通話の終了が唯一利用可能な終了 戦略です。
再試行フィードバック
Retryフィードバックには、次のターンに適用したい任意の指示を含められます。モデルが再生成する前に、システムガイダンスとして挿入されます。これには、transfer_to_agentやtransfer_to_numberなどのシステムツールの呼び出しも含まれます。再試行フィードバックの設定例を以下に示します。
- 汎用的な拒否(デフォルト)
あなたの応答は、この条件/カテゴリに一致するコンテンツをブロックするガードレールによってブロックされました:‘{{trigger_reason}}’ 次のターンでは、ユーザーに「申し訳ありませんが、その質問にはお答えできません。ほかに知りたいことはありますか?」と伝える必要があります。 - 修正指示を含む再試行
前の応答はガードレールによってブロックされました。ブロックされた応答は次のとおりです:‘{{agent_message}}‘。次のターンでは、新しい回答を提供し、‘{{trigger_reason}}‘に違反してはいけません。 - 別のエージェントへの転送
前の応答はガードレールによってブロックされました。次のターンでは、transfer_to_agentツールを使用してエージェントに転送する必要があります。ブロックされた応答は次のとおりです:‘{{agent_message}}‘。このガードレールは、この条件/カテゴリに一致するコンテンツをブロックします:‘{{trigger_reason}}’。 - 担当者への転送
あなたの応答は、この条件/カテゴリに一致するコンテンツをブロックするガードレールによってブロックされました:‘{{trigger_reason}}‘。次のターンでは、transfer_to_numberツールを使用して、必ず通話を人間のオペレーターに転送する必要があります。
再試行フィードバックでシステムツールを使用するには、エージェントの設定で対応するツールを有効にして 設定してください。呼び出せるのは、エージェントに設定されているツールのみです。
フィードバックテキストでは、以下のプレースホルダーを使用できます。
Streaming実行モードは音声エージェントに、blocking実行モードはテキストエージェントに 推奨されます。
Blocking(特にretry)は、音声では予測しにくい動作をすることがあります。音声でブロッキングを 使用する場合は、十分に検証するか、動作に確信が持てるまでretryではなくend callを選択してください。
料金
Focus、Manipulation、Contentガードレールは、すべてのElevenAgentsユーザーに追加料金なしで含まれています。
Custom Guardrailsは使用量ベースで、ElevenAgentsの他のモデル呼び出しと同様に、追加のLLMコストが発生します。 有効なCustom Guardrailごとに、すべてのエージェント応答が評価のため軽量モデルへ送信されるため、コストはプロンプトの長さ、平均会話時間、会話数によって異なります。複数のCustom Guardrailsを有効にすると、それぞれが応答ごとに独自の評価を実行します。本番環境で複数のCustom Guardrailsを有効にする前に、想定トラフィックとモデルの選択を確認することをおすすめします。
カスタムガードレールの作成または編集時には、推定コストを確認できます(プロンプトの下に表示されます)。
再試行とコスト: 各試行では追加のエージェント生成とガードレール評価が行われるため、retryは end_callと比較して使用量ベースの料金を増加させます(ブロックされたターンごとに最大3回の試行)。
設定
ダッシュボードで設定
CLIで設定
APIで設定
実行モードと終了戦略を設定(カスタムおよびコンテンツガードレール)
カスタムまたはコンテンツガードレールごとに、streamingまたはblockingの実行モードを選択します。
Blockingはテキストエージェントに適しており、streamingは音声エージェントに適しています。Action on
guardrail violation (trigger_actionに対応)を設定します。どちらのモードでもend callを選択でき、** retryは
blockingを選択した場合のみ利用できます(streamingではretry**は利用できません)。retryを選択した場合は、
Feedback to inject when retryingを編集してモデルを誘導します。テンプレートでは、プレースホルダー
{{trigger_reason}}(ブロックの原因となったカスタムプロンプトまたはコンテンツカテゴリ)と、
{{agent_message}}を使用します。
ガードレールが発動した際の動作は、種類と設定によって異なります。
- 通話終了: セッションがすぐに終了します(音声では通話が切断され、テキストではチャットが終了します)。トリガーは会話履歴に記録されます。
- 再試行(ブロッキングのカスタムまたはコンテンツガードレール): 違反したアシスタントのターンが削除され、システムフィードバックが挿入されて、モデルが再試行します。ガードレールが引き続き発動する場合は、最大3回試行した後にセッションが終了します。
end callの場合、エンドユーザーには通話の切断またはチャットの終了として表示されます。違反の詳細は 会話ログで確認でき、エンドユーザーにはそのまま表示されません。
end callの後、ユーザーは新しい会話を開始できます。ガードレールはユーザーを永続的にブロックするのではなく、 ポリシーに違反した特定の応答(またはセッション)をブロックします。
ベストプラクティス
カスタマーサポートエージェント
カスタムガードレールを使用して、ビジネス固有のポリシーを適用します。例:- ツールで適格性が確認されない限り、返金、 クレジット、サブスクリプション変更の実行をブロックする。- 明示的な承認がない限り、割引やプロモーションコードの提供を ブロックする。- ロードマップ項目や未リリース機能について推測する応答をブロックする。
医療アプリケーション
カスタムガードレールを使用して、医療に関する境界を厳密に制御します。例:- 病状の診断や特定の治療の推奨を ブロックする。- 薬剤の用量に関する推奨をブロックする。
- 医療資格を持つ専門家からの助言に取って代わる内容をブロックする。
教育コンテンツ
カスタムガードレールを使用して、学術上のデリケートなトピックを制御します。例:- 有害な実験や安全でない手順に関する 段階的な手順をブロックする。- 実施中の評価や試験の解答集の生成をブロックする。- 学術的不正を助長する可能性のある コンテンツをブロックする。
社内エンタープライズツール
カスタムガードレールを使用して、企業の業務とデータを保護します。例:- 社内限定のドキュメントや機密プロセスの共有を ブロックする。- 非公開API、システムプロンプト、インフラストラクチャの詳細の開示をブロックする。- 経営層または 管理者の権限を必要とするアクションのシミュレーションをブロックする。
現実的なシナリオでテストする
デプロイ前に、次の内容でガードレール設定をテストしてください。
- 誤検知がないことを確認するための通常の会話フロー
- 安全性の境界に近づくが越えないエッジケース
- 有害な応答を引き出そうとする敵対的なプロンプト
よくある質問
ガードレールはレイテンシーに影響しますか?
カスタムおよびコンテンツガードレールでは、ストリーミング モードで追加のレイテンシーは発生しませんが、 ガードレールが作動する前に応答が始まる場合があります。ブロッキング モードでは、 エージェントが応答する前にガードレールを待つため、通常は約 200~500 ms の遅延が発生します。再試行 では、 ブロックされたターンごとに最大3回、試行ごとに完全な追加生成 (および再評価)が行われるため、従量課金コストも増加します。
ストリーミング実行モードとブロッキング実行モードの違いは何ですか?
ストリーミング では追加のレイテンシーは発生しませんが、ガードレールが
作動する前にエージェントの応答が始まる場合があります。ブロッキング では、エージェントが応答する前にガードレールの結果を待ちます(通常、
200~500 ms の遅延)。終了戦略としての 再試行 (trigger_action)は、
ブロッキング モードでのみ利用できます。ストリーミング モードでは、ガードレールが
作動した際に 通話を終了 します。ブロッキング では、会話を直ちに終了する代わりに、
注入されたシステムフィードバックを使用して 再試行 できます。ただし、再試行が発生すると、モデル使用量が増え、
追加料金 がかかります。ブロッキング は テキスト エージェントに、ストリーミング は
音声 エージェントに推奨されます。
ガードレールを完全に無効にできますか?
はい。ただし、特にフォーカスガードレールを含め、すべてのガードレールを有効にしておくことを強く推奨します。 ガードレールはブランド、ユーザー、コンプライアンス体制を保護するため、社内ツールを含むすべての 本番アプリケーションでの使用を推奨します。まれに、特定のガードレールがエージェントの意図したユースケースを妨げる場合は、 無効にすることもできます。たとえば、一部のアプリケーションではコンテンツガードレールが通常フラグを立てるトピックを扱う場合や、 高度にカスタマイズしたシステムプロンプトがフォーカスガードレールを有効にしたままでは適切に機能しない場合があります。各ガードレールは 個別にオンまたはオフに切り替えられます。
ユーザーはガードレールの判断に異議を申し立てられますか?
ガードレールの作動はログに記録され、会話分析で確認できます。 誤検知が見つかった場合は、ガードレールのプロンプトを調整してください。自動化された異議申し立てプロセスはありません。 ユーザーは新しい会話を開始してください。
どのガードレールが作動したかを確認するには?
どのガードレールが作動したかに関する情報は、会話ログで確認できます。
ガードレールとシステムプロンプトの強化を両方使うべきですか?
はい。両者は補完的な役割を果たします。システムプロンプトの強化は行動に関するガイダンスを提供し、 指示に従うことでほとんどの問題を防ぎます。プラットフォームのガードレールは、セーフティネットとして独立した 強制を提供します。両方を使うことで、多層防御を実現できます。
次のステップ
- プロンプトガイド: 行動ガードレールを備えた効果的なシステムプロンプトの書き方を学ぶ
- プライバシー: データ保持とプライバシーの設定を構成する
- テスト: さまざまなシナリオでエージェントをテストする
- 会話をシミュレート: プログラムでガードレールの構成をテストする
- 会話履歴の編集: 会話履歴から名前や銀行口座情報などの機密情報を編集する
リリース状況
フォーカスガードレールと操作ガードレールを含むガードレールは、一般提供されています。
コンテンツガードレールとカスタムガードレールはアルファ版です。現在も積極的に改善を進めており、一般提供までにデフォルト設定、ダッシュボードのコントロール、APIフィールドは引き続き変更される予定です。一部の変更には互換性のないものが含まれる場合があります。
コンテンツガードレールまたはカスタムガードレールを使用する場合は、設定を検証し、ログでガードレールの動作を監視し、アップデートの展開に合わせて構成を見直すことを推奨します。