

実験
実験
直感ではなくデータに基づき、プロダクション環境のトラフィックで制御されたA/Bテストを実施してエージェントのパフォーマンスを最適化します。
実験では、トラフィックの一定割合をバリアントに振り分け、主要な成果への影響を測定し、勝者を本番環境に昇格させることで、プロンプト構造、ワークフローロジック、音声、個性、ツール、ナレッジベースなど、エージェント設定のあらゆる側面で管理されたA/Bテストを実行できます。
実験はエージェントのバージョン管理を基盤に構築されています。 実験を実行する前に、エージェントでバージョン管理を有効にする必要があります。
実験する理由
体系的な実験がなければ、最適化は直感頼みになります。プロンプトの調整で「良くなった気がする」。ワークフローの調整で自己解決率が「改善するはず」。新しいエスカレーション経路が「より効率的に見える」。
実験は推測を根拠に置き換えます。実際のトラフィックに対して変更をテストし、現実の結果を測定して、機能するものを昇格させます。
仕組み
実験は次の4ステップで行います。
バリアントを作成
現在のエージェント設定を起点に、新しいブランチを作成します。システムプロンプト、ワークフロー、音声、ツール、ナレッジベース、ガードレール、評価基準など、あらゆる項目を変更できます。各変更はバージョン管理された設定として追跡されます。
エージェント設定のBranchesタブに移動し、Create branchをクリックします。
トラフィックを振り分け
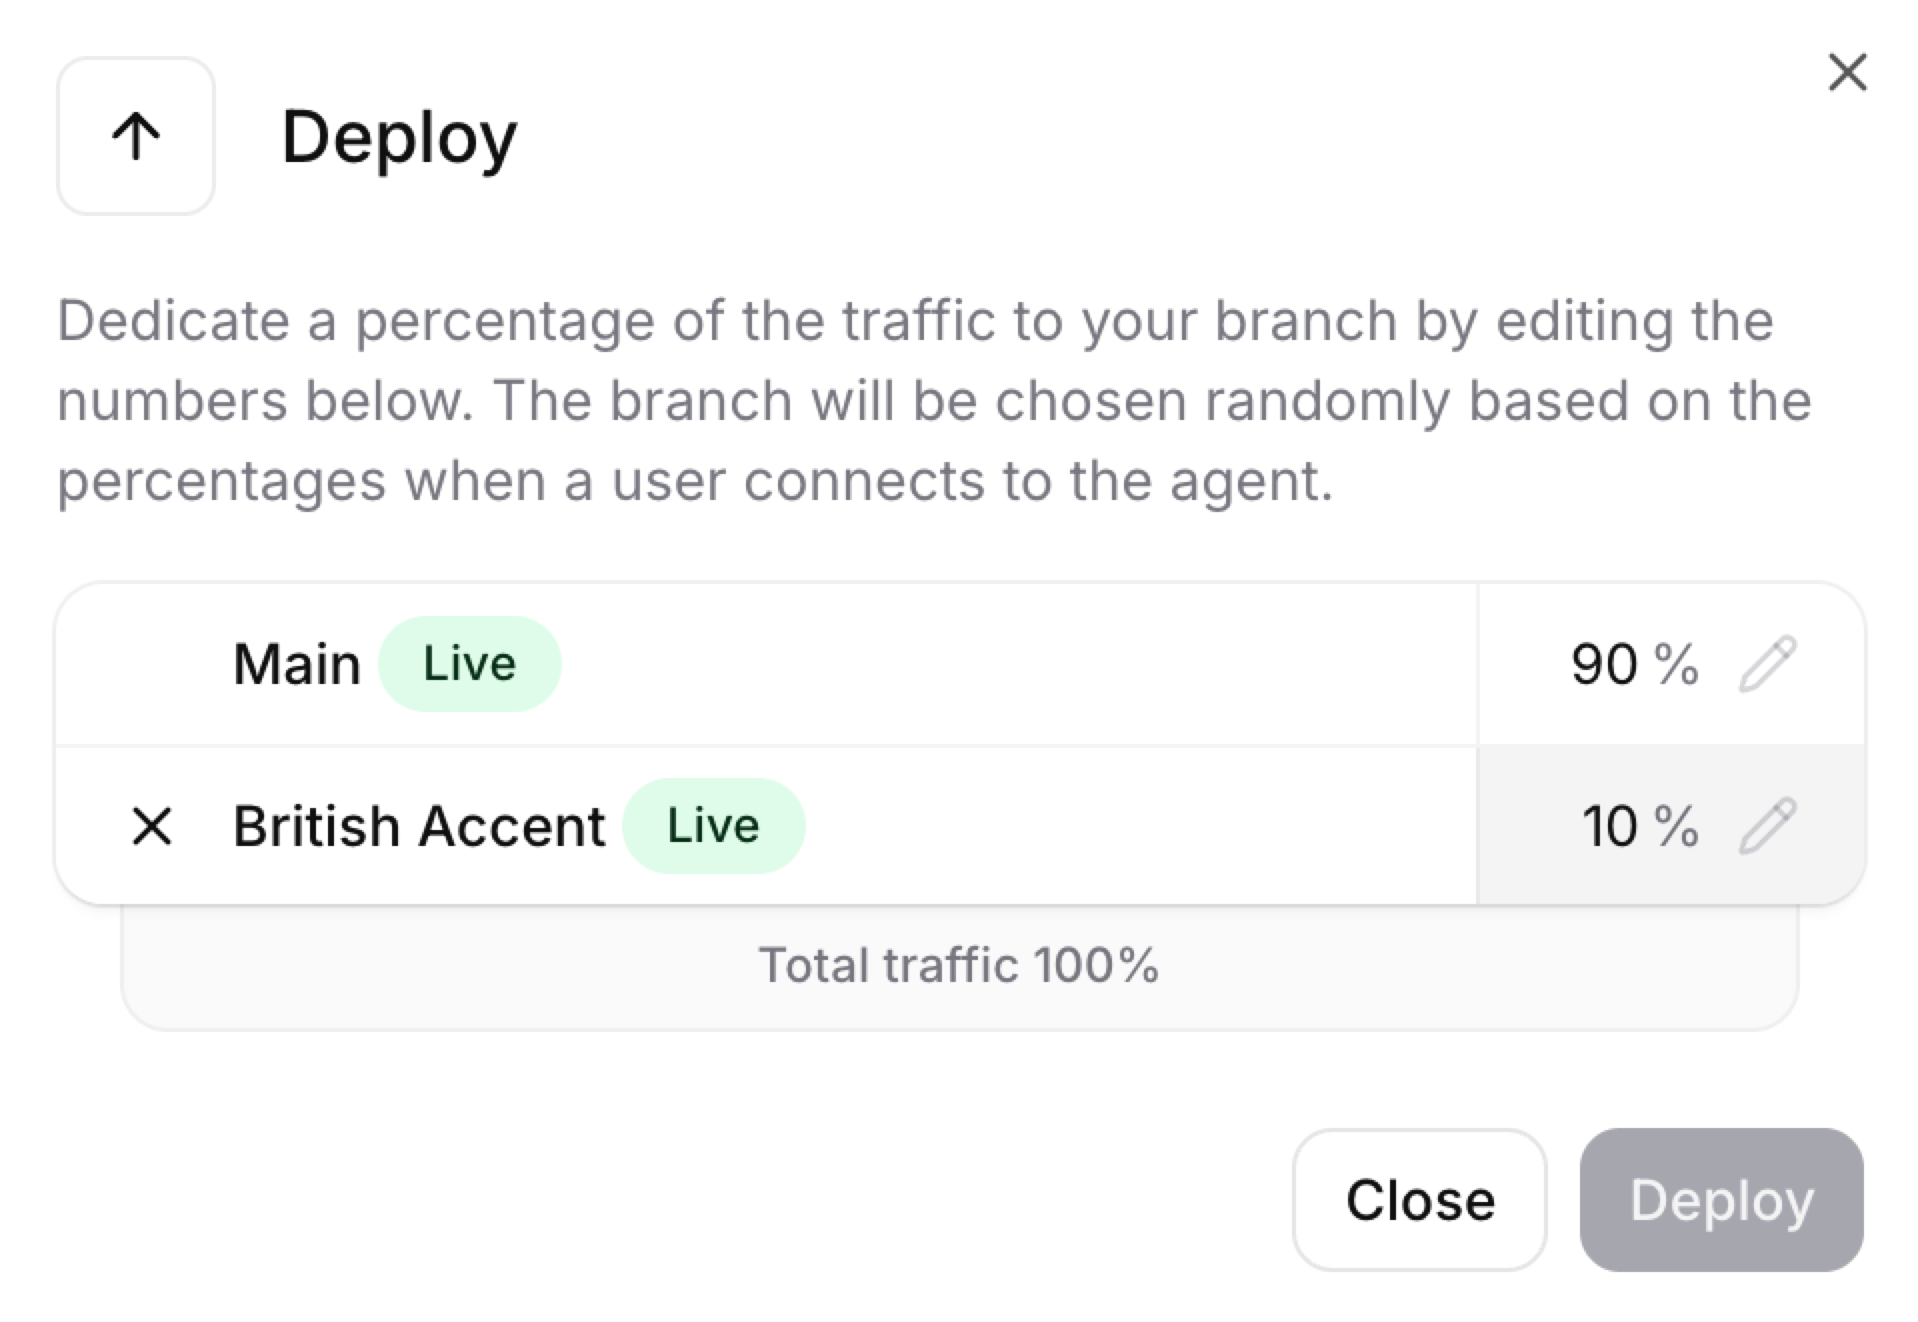
バリアントに送るライブ会話の割合を定義します。リスクを抑えるために少ない割合(5~10%)から始め、自信が高まるにつれて増やします。
Edit traffic splitをクリックし、各ブランチの割合を設定します。割合の合計は必ず100%ちょうどにする必要があります。
影響を測定
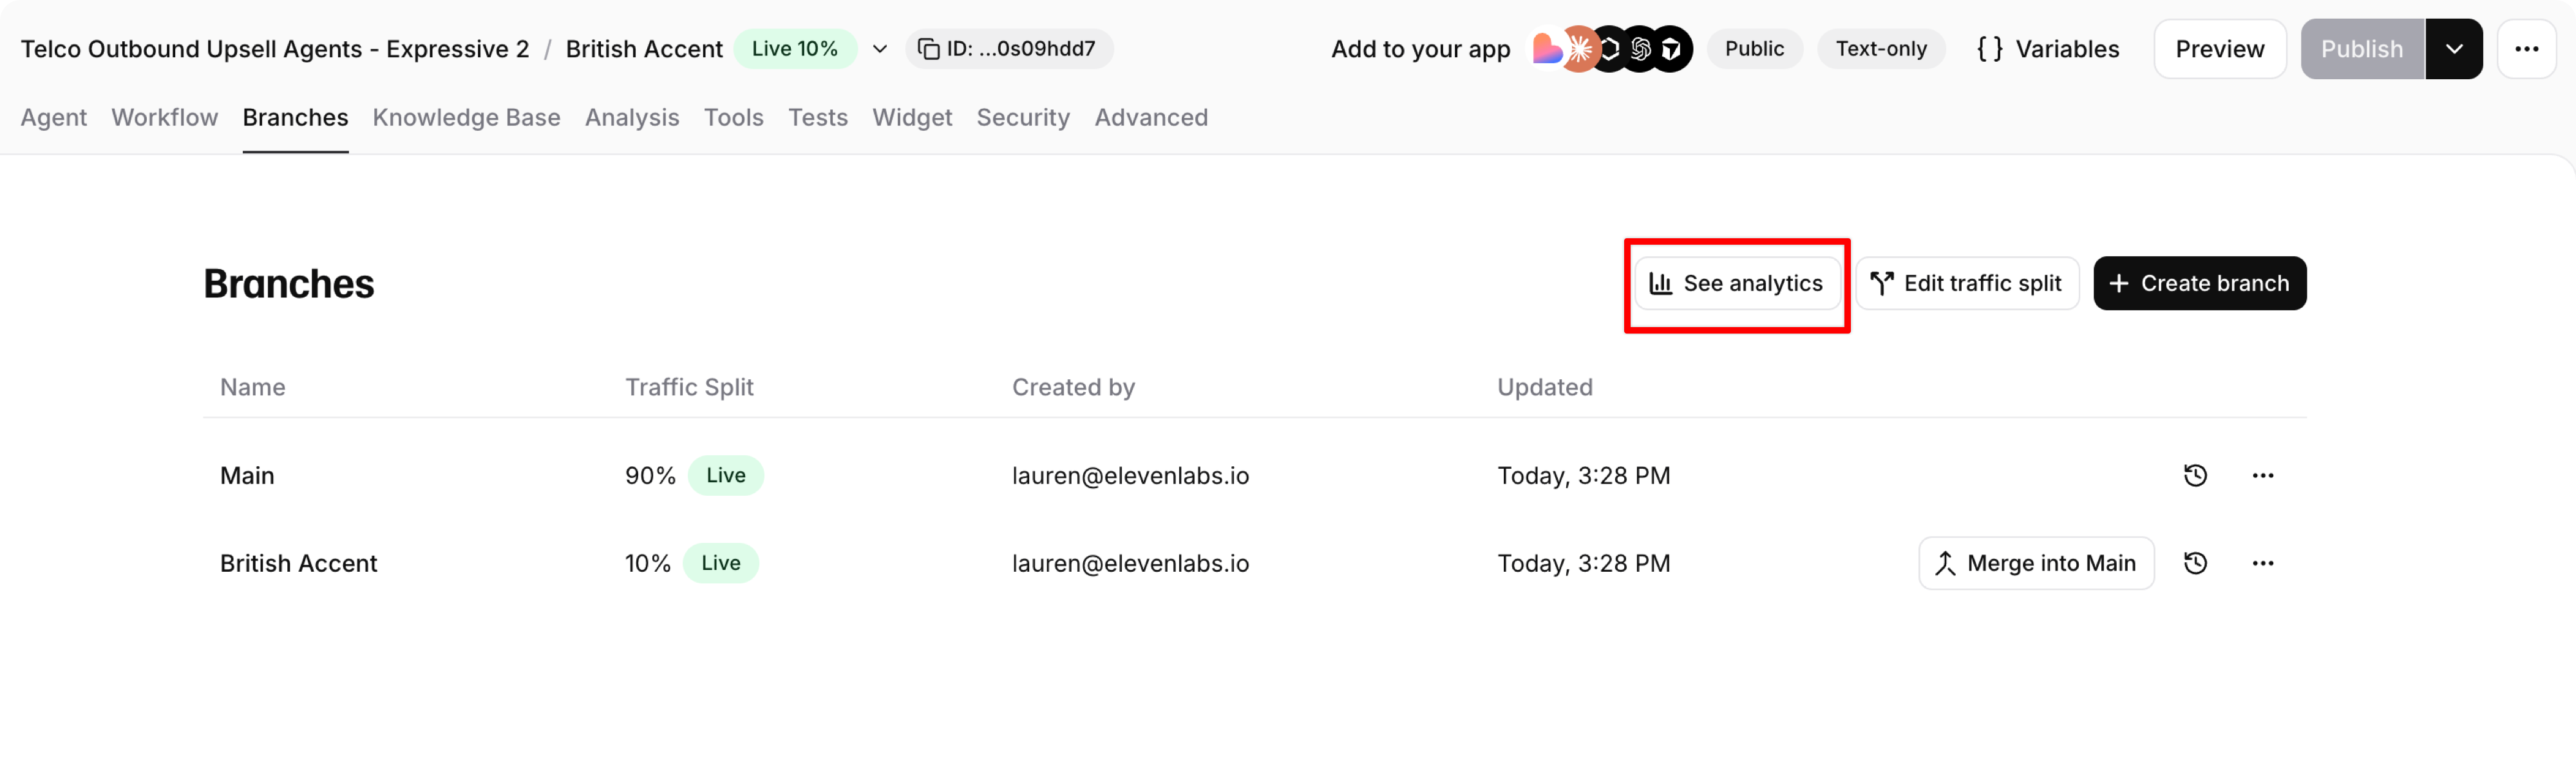
分析ダッシュボードを使用して、バリアントのパフォーマンスをベースラインと比較します。ブランチパネルのSee analyticsをクリックすると、ブランチでフィルタリングされたビューに直接移動できます。
チームは次のような成果を測定できます。
- CSAT
- 自己解決率
- コンバージョン
- 平均対応時間
- エージェント応答レイテンシの中央値
- エージェントによる解決1件あたりのコスト
トラフィックルーティング
トラフィックは割合に応じてブランチ間で分割されます。ルーティングは会話IDに基づく決定論的なものであるため、同じユーザーはセッションをまたいでも常に同じブランチに到達します。
デフォルトでは、トラフィックはユーザーベース全体でランダムに振り分けられます。APIを使用して会話を開始する場合は、どのブランチ設定で会話を開始するかを制御することで、特定のコホートを特定のブランチに振り分けられます。
すべてのトラフィック割合の合計は、必ず100%ちょうどにする必要があります。そうでない場合、デプロイは失敗します。
ユースケース
実験は、顧客向けワークフローと運用ワークフロー全体で継続的な最適化をサポートします。
各実験は特定のエージェントバージョンに紐づいているため、すべてのパフォーマンス変化を明確に定義された設定変更に帰属させられます。
テストできる項目
エージェント設定のあらゆる側面をブランチ間で変えられます。
ベストプラクティス
仮説から始める
バリアントを作成する前に、何が改善すると予測するか、その測定方法を定義します。たとえば、 「問題の要約を含めるようエスカレーションプロンプトを変更すると、解決率の評価基準が10%改善する」とします。
一度に変更するのは1つだけ
変数を1つに絞ると、パフォーマンス差の原因が明確になります。プロンプト、音声、ワークフローを同時に変更すると、どの変更が結果につながったのか分かりません。
まず評価基準を設定する
実験を実行する前に、成功 評価の基準を設定します。これにより、バリアントを客観的に比較するために必要な構造化された指標を得られます。
少ないトラフィック割合から始める
バリアントへのトラフィックを5~10%から始めます。問題が発生した場合の影響を抑えつつ、意味のあるデータを生成できます。
実験に十分な時間をかける
結論を出す前に、十分な数の会話が蓄積されるようにします。サンプルサイズが小さいと、結果の信頼性が低くなります。分析ダッシュボードを監視し、傾向が安定するのを待ちます。
実験を長期間放置しない
実験は速やかにマージまたは破棄します。長期間続くブランチはマージが難しくなり、メイン設定との差が広がる可能性があります。