

Gegevensverzameling
Gegevensverzameling extraheert automatisch gestructureerde informatie uit gesprekstranscripten met LLM-gestuurde analyse. Zo leg je waardevolle gegevenspunten vast zonder handmatige verwerking, wat de operationele efficiëntie en gegevensnauwkeurigheid verbetert.
Overzicht
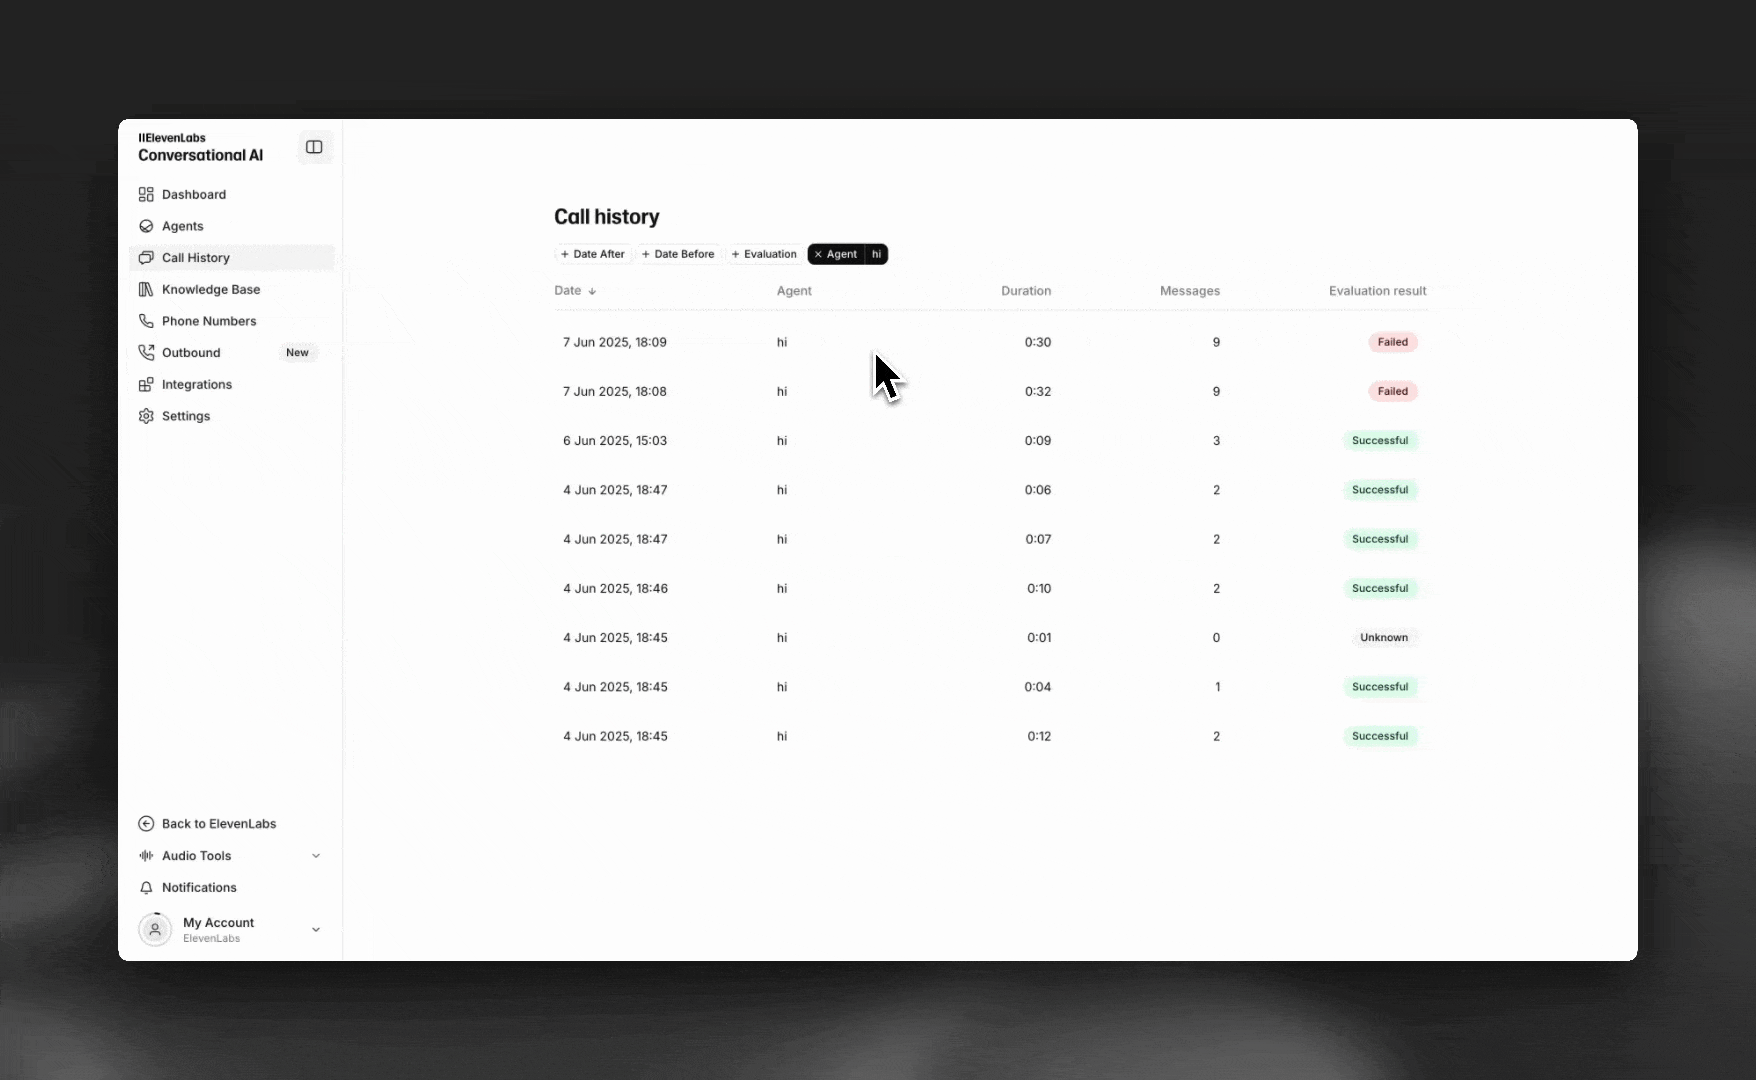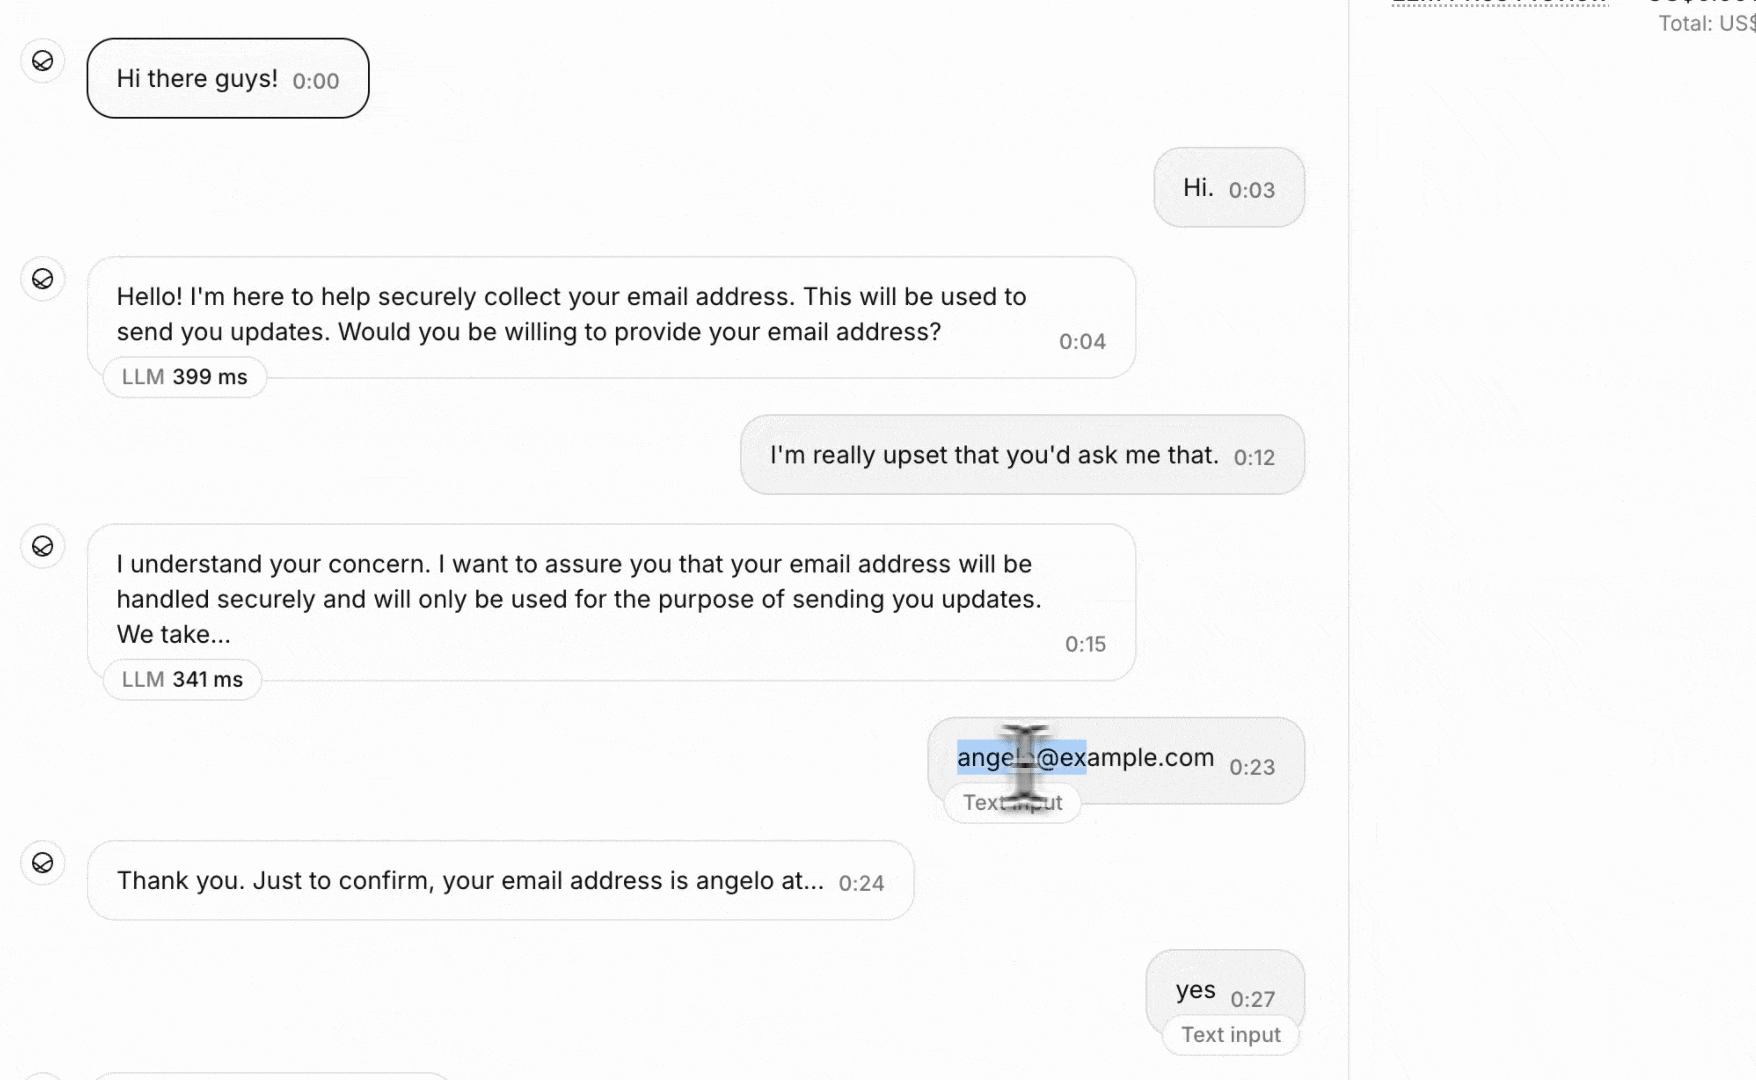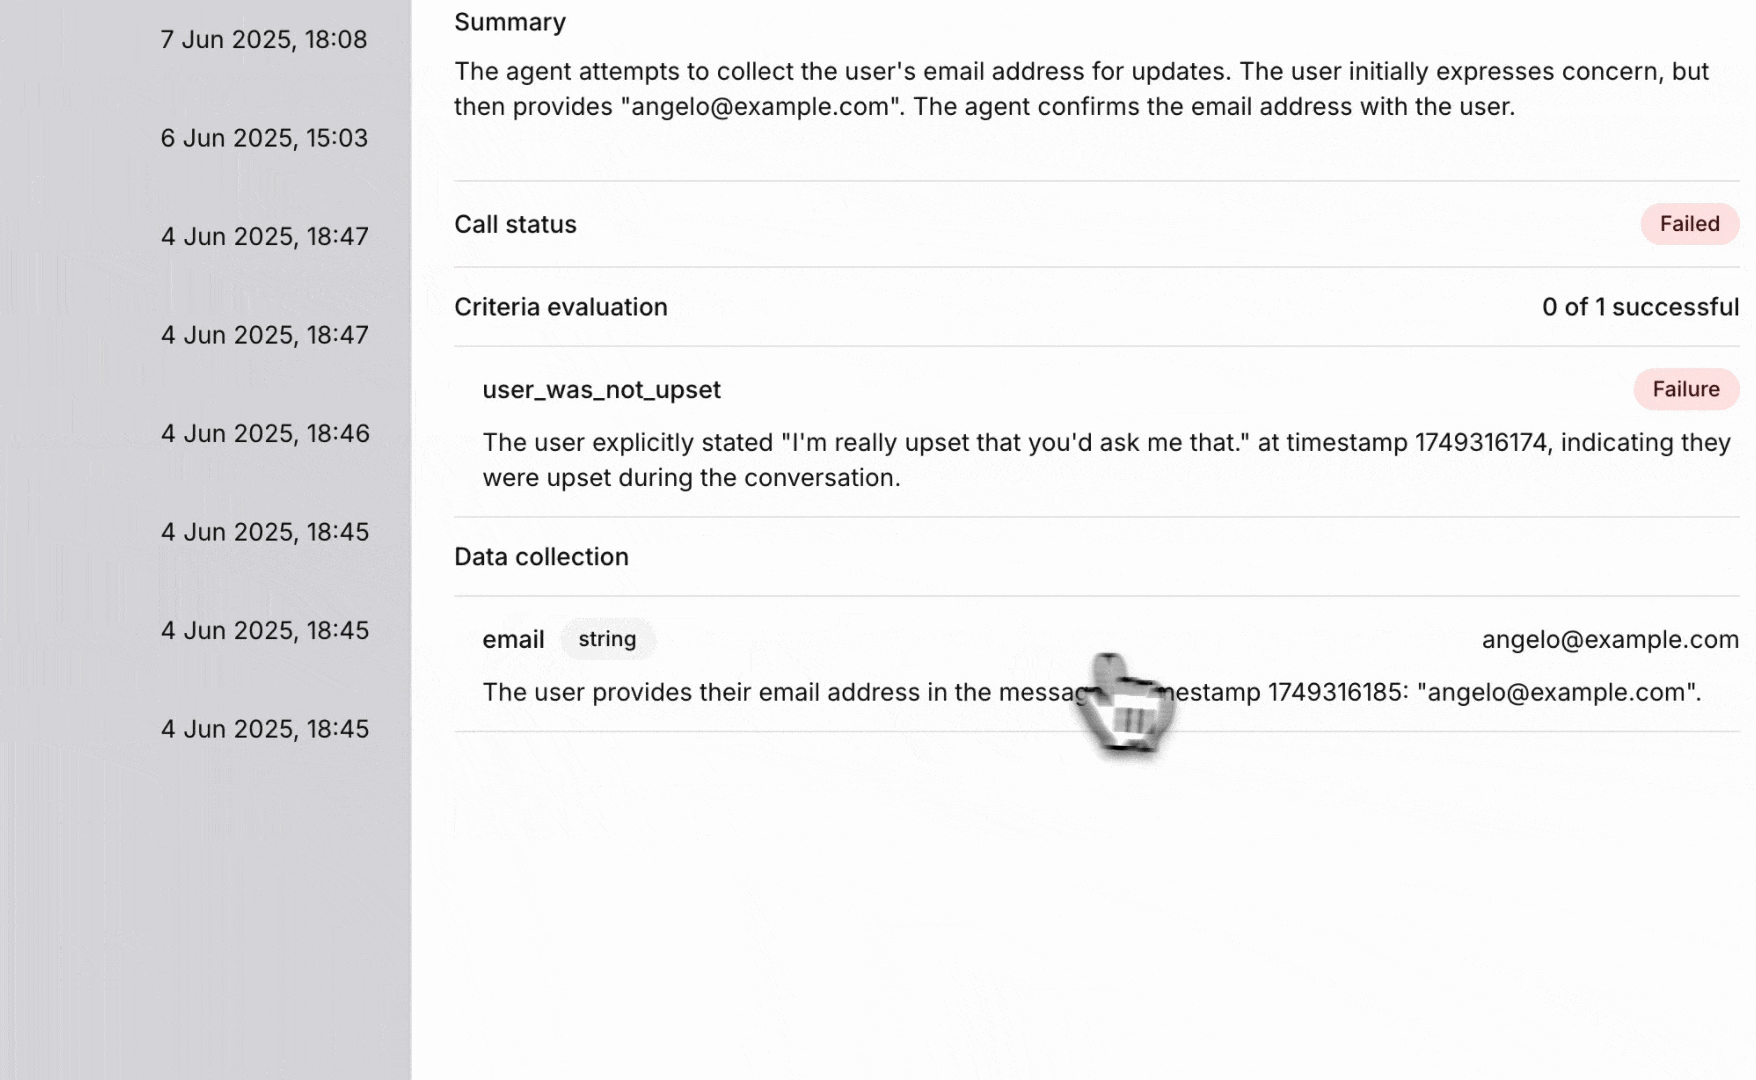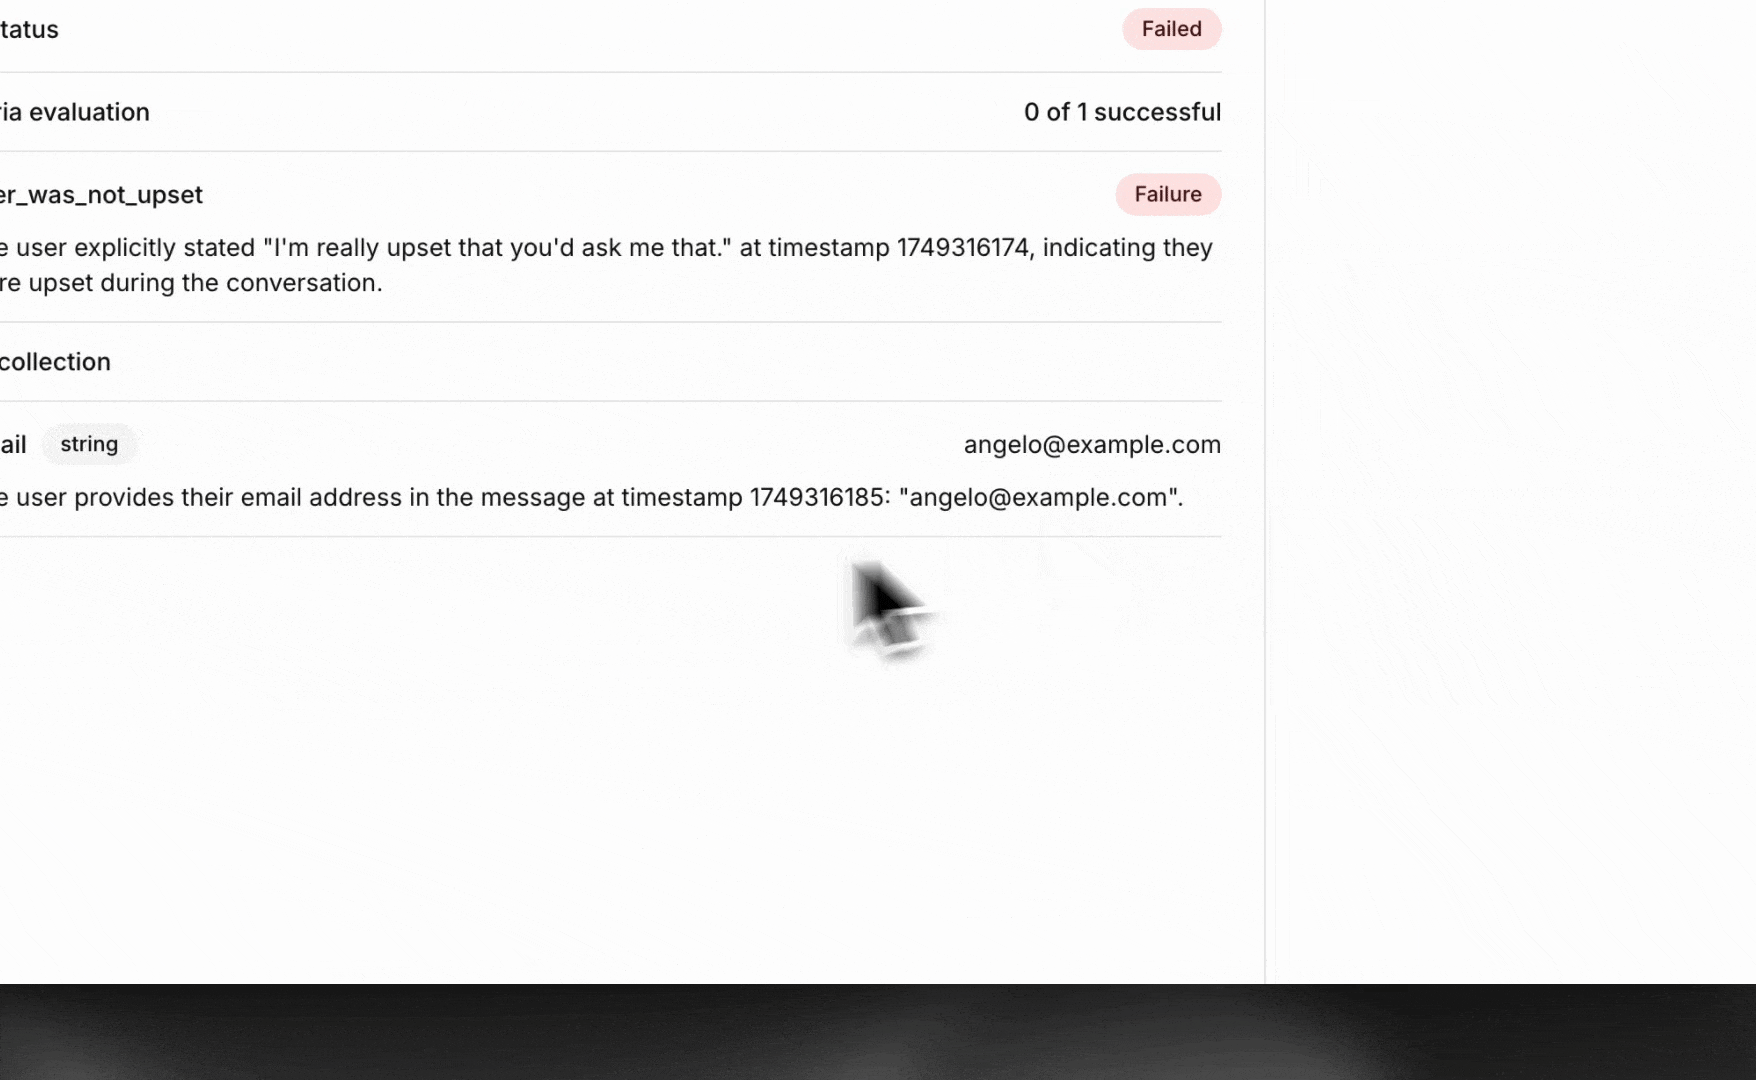
Gegevensverzameling analyseert gesprekstranscripten om specifieke informatie te identificeren en extraheren die je definieert. De geëxtraheerde gegevens worden gestructureerd volgens je specificaties en beschikbaar gemaakt voor verdere verwerking en analyse.
Ondersteunde gegevenstypen
Gegevensverzameling ondersteunt vier gegevenstypen voor verschillende informatieformaten:
- String: Tekstuele informatie (namen, e-mailadressen, adressen)
- Boolean: Waar/onwaar-waarden (akkoordstatus, geschiktheid)
- Integer: Hele getallen (aantal, leeftijd, beoordelingen)
- Number: Decimale getallen (prijzen, percentages, metingen)
Configuratie
Open de instellingen voor gegevensverzameling
Ga op het tabblad Analyse van je agentinstellingen naar de sectie Gegevensverzameling.
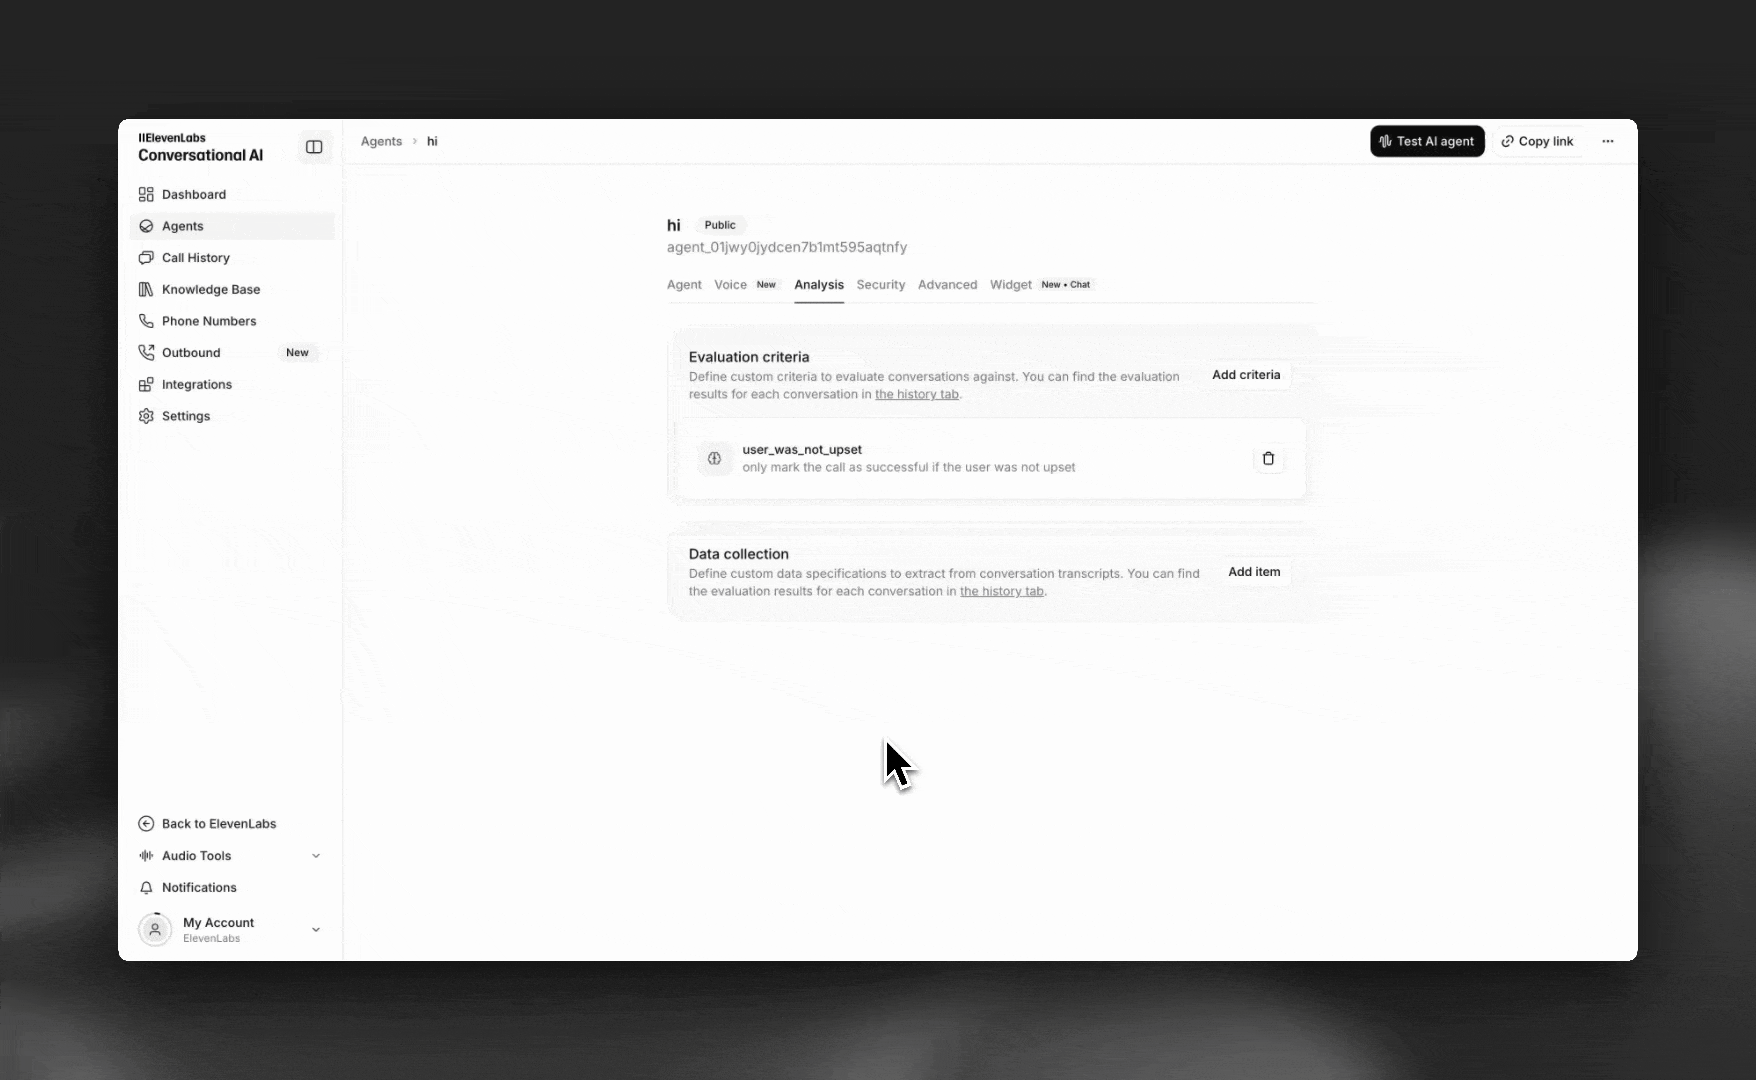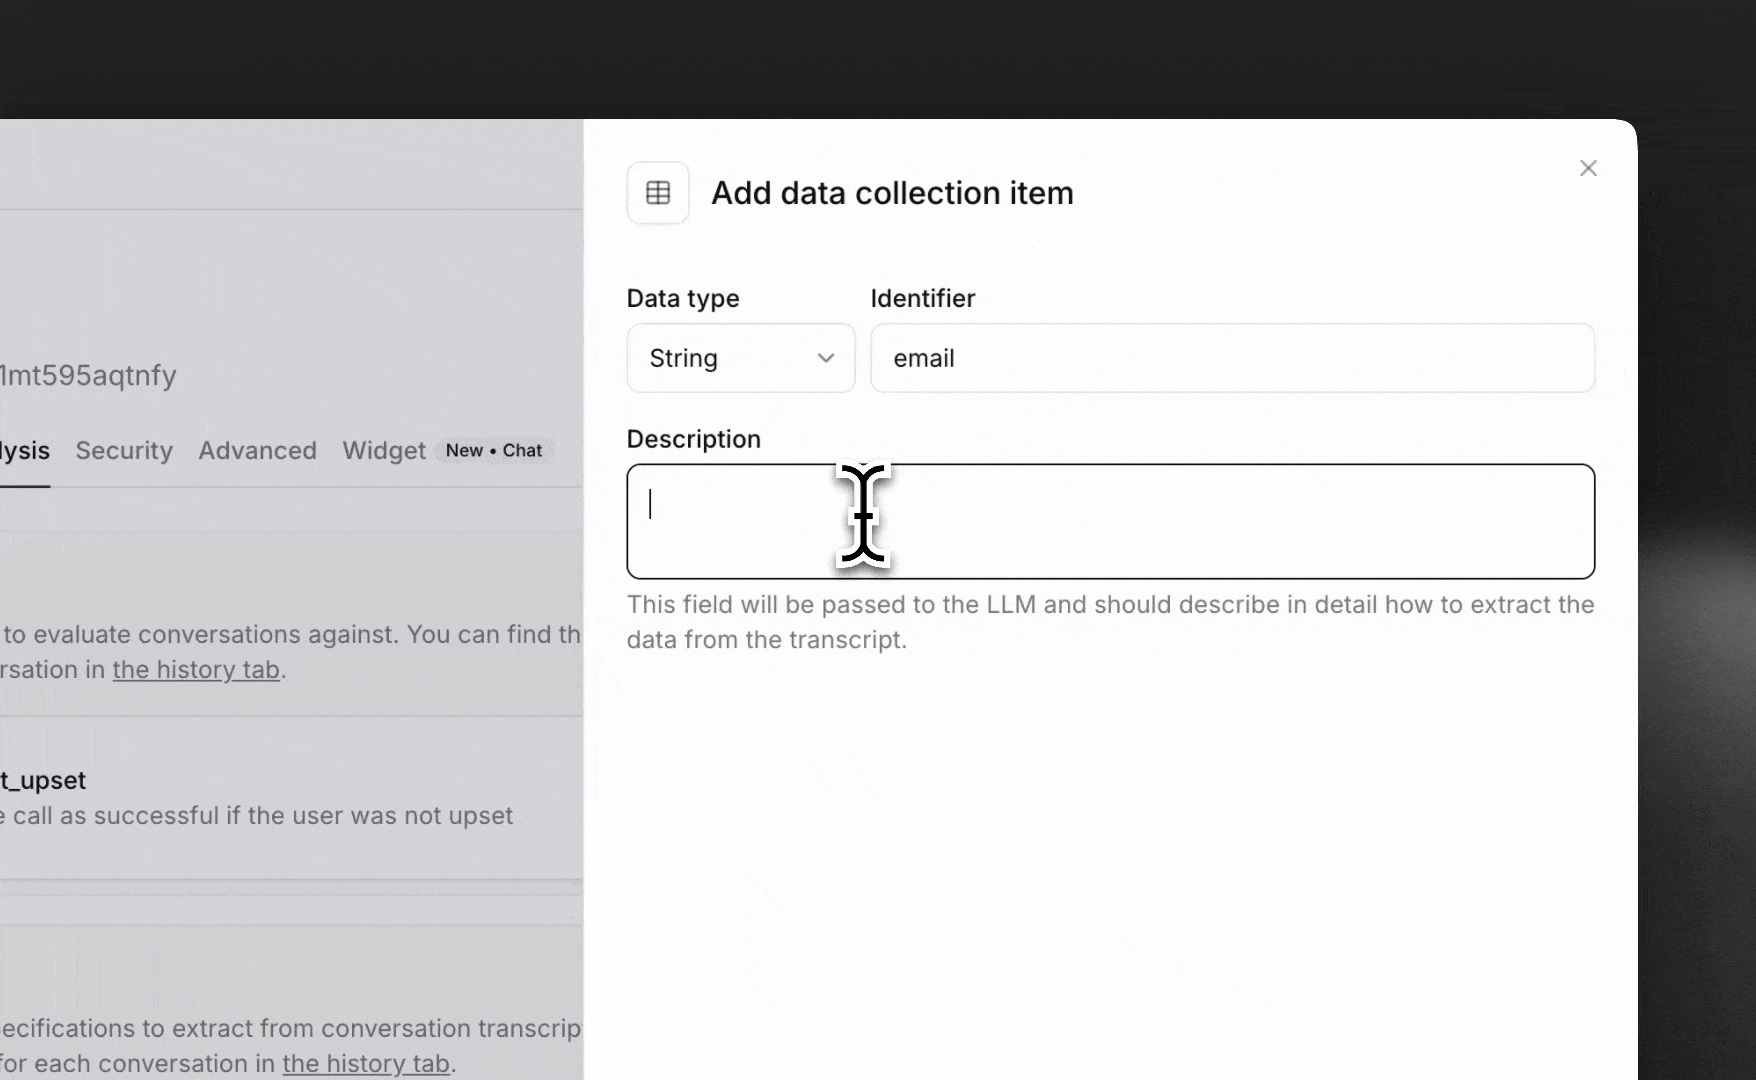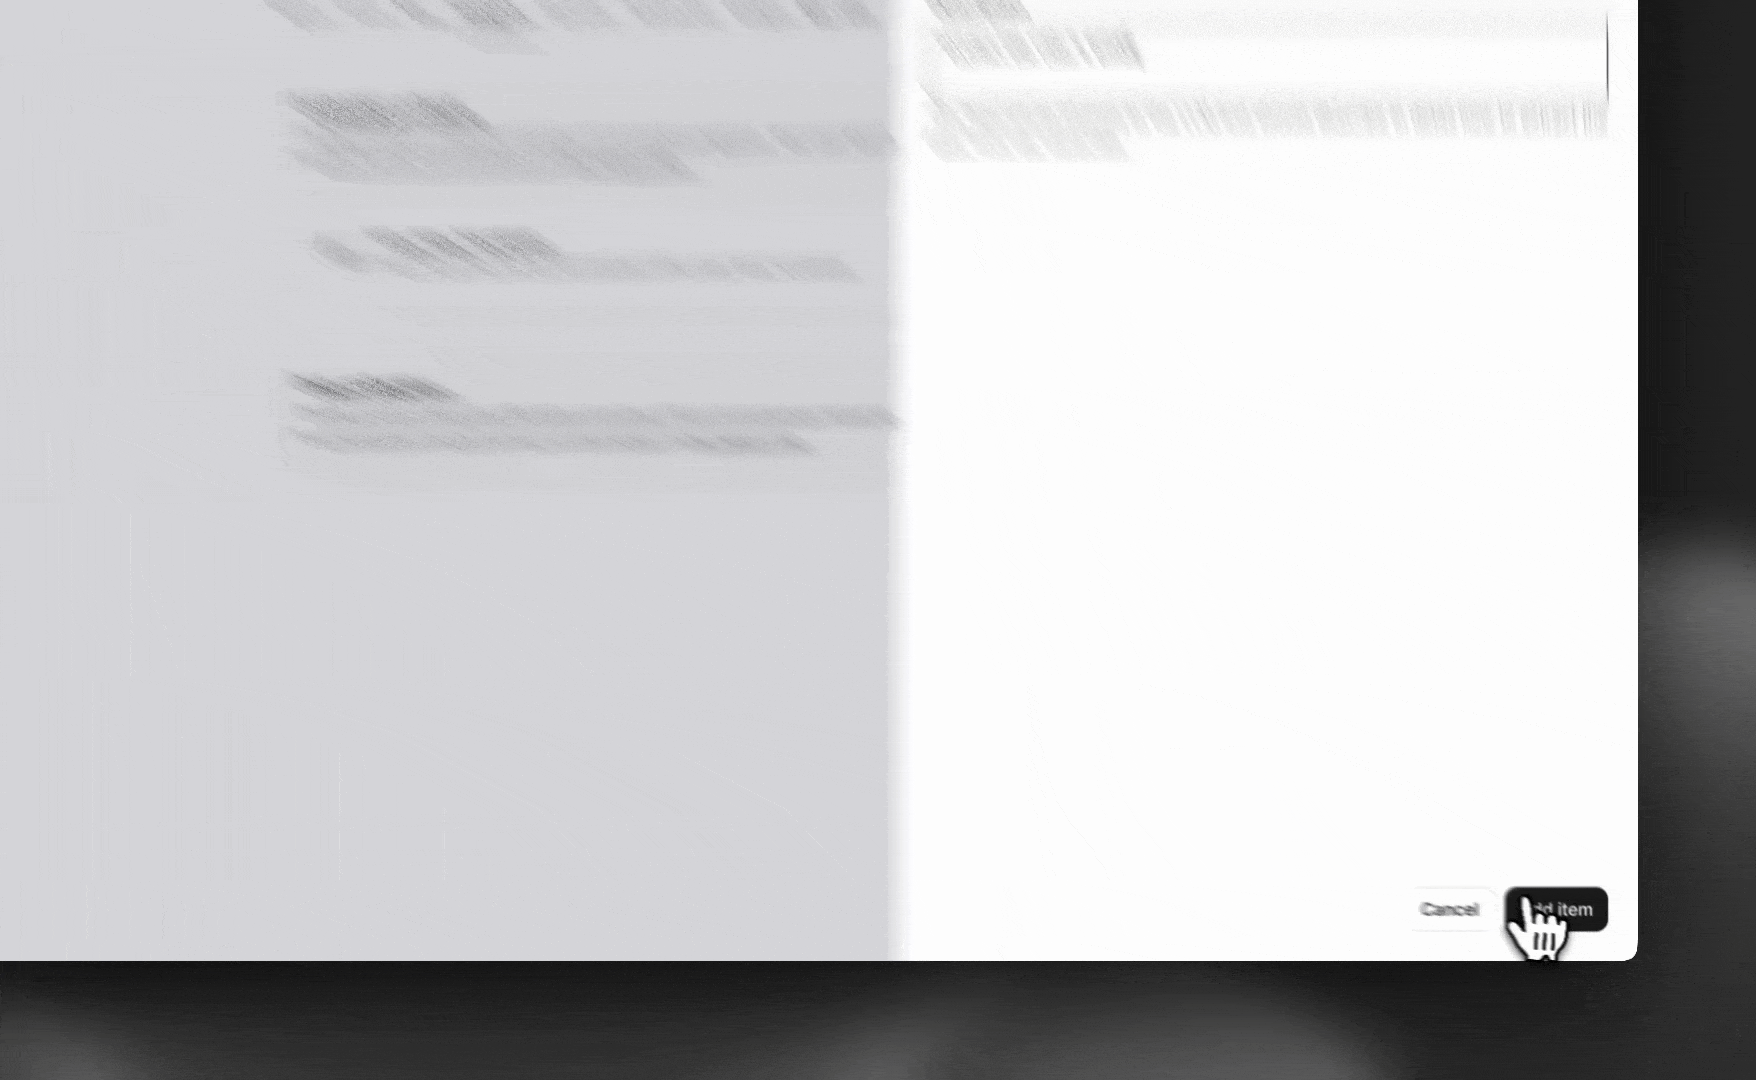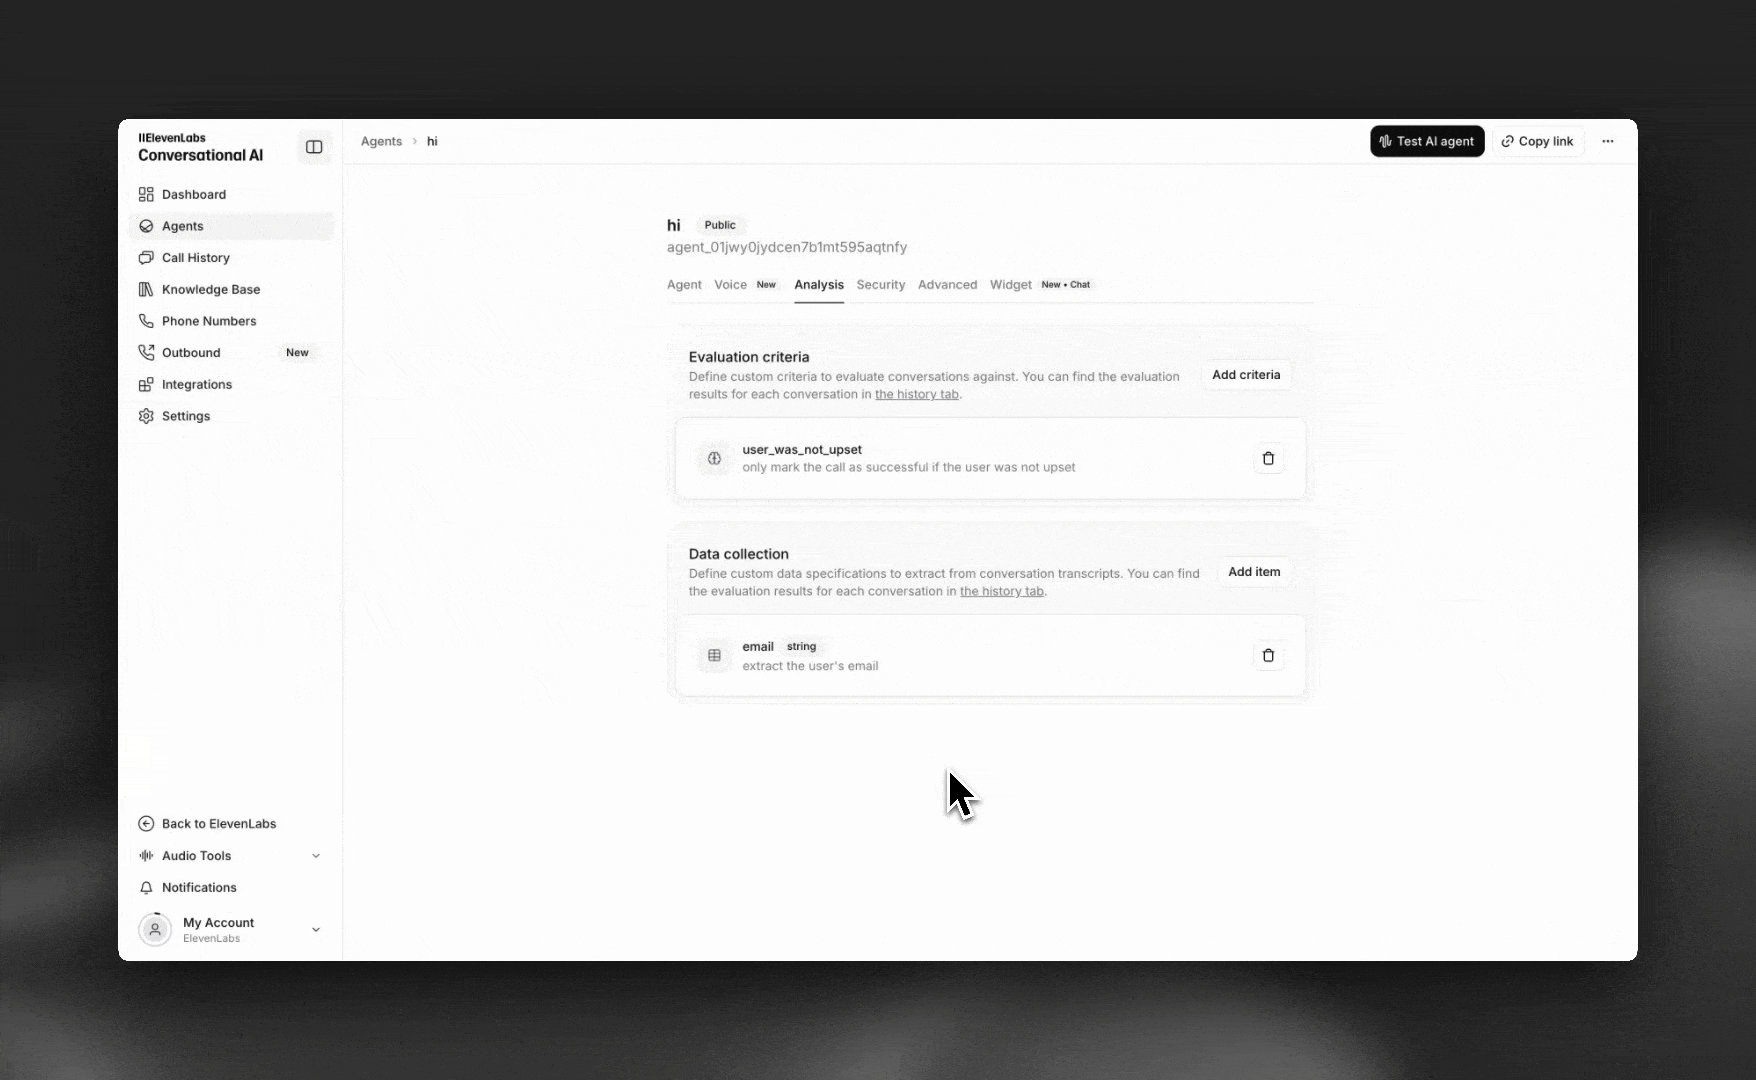
Voeg items voor gegevensverzameling toe
Klik op Gegevensverzameling toevoegen om een nieuwe regel voor gegevensextractie te maken of er een te koppelen vanuit de analysebibliotheek van je workspace.
Configureer elk item met:
- Naam: Unieke naam voor het gegevensveld (bijv.
email,customer_rating) - Gegevenstype: Kies uit string, boolean, integer of number
- Beschrijving: Gedetailleerde instructies voor het extraheren van de gegevens uit het transcript
Het beschrijvingsveld wordt aan de LLM doorgegeven en moet zo specifiek mogelijk aangeven wat er moet worden geëxtraheerd en hoe dit moet worden opgemaakt.
Items voor gegevensverzameling zijn beperkt tot 50 per agent voor Trial- en Enterprise-abonnementen, en 25 per agent voor andere abonnementen.
Best practices
Effectieve extractieprompts schrijven
- Geef expliciet het verwachte formaat aan (bijv. “e-mailadres in de indeling user@domain.com”)
- Geef aan wat er moet gebeuren wanneer informatie ontbreekt of onduidelijk is
- Voeg voorbeelden van geldige en ongeldige gegevens toe
- Vermeld eventuele validatievereisten
Veelvoorkomende voorbeelden van gegevensverzameling
Contactinformatie:
email: “Extraheer het e-mailadres van de klant in standaardindeling (user@domain.com)”phone_number: “Extraheer het telefoonnummer van de klant, inclusief netnummer”full_name: “Extraheer de volledige naam van de klant zoals opgegeven”
Bedrijfsdata:
issue_category: “Classificeer het probleem van de klant als een van de volgende: technisch, facturering, account of algemeen”satisfaction_rating: “Extraheer elke numerieke tevredenheidsbeoordeling die de klant geeft (schaal van 1 tot 10)”order_number: “Extraheer elk bestel- of referentienummer dat de klant noemt”
Gedragsgegevens:
was_angry: “Bepaal of de klant tijdens het gesprek boosheid of frustratie uitte”requested_callback: “Bepaal of de klant om een terugbelverzoek of follow-up vroeg”
Omgaan met ontbrekende of onduidelijke gegevens
Wanneer de gevraagde gegevens niet kunnen worden gevonden of dubbelzinnig zijn in het transcript, retourneert de extractie null- of lege waarden. Overweeg:
- Voorwaardelijke logica in je applicaties te gebruiken om ontbrekende gegevens af te handelen
- Terugvalcriteria te maken voor onvolledige extracties
- Agents te trainen om vereiste informatie consequent te verzamelen
Richtlijnen voor gegevenstypen
String
Boolean
Integer
Number
Gebruik dit voor tekstuele informatie die niet binnen andere typen past.
Voorbeelden:
- Klantnamen
- E-mailadressen
- Productcategorieën
- Probleembeschrijvingen
Best practices:
- Geef indien relevant het verwachte formaat aan
- Voeg validatievereisten toe
- Houd rekening met de behoefte aan standaardisatie
Toepassingen
Problemen oplossen
Gegevensextractie retourneert lege waarden
- Controleer of de gegevens in het gesprekstranscript staan
- Controleer of je extractieprompt specifiek genoeg is
- Zorg ervoor dat het gegevenstype overeenkomt met het verwachte formaat
- Overweeg of de informatie duidelijk is gecommuniceerd tijdens het gesprek
Inconsistente gegevensformaten
- Controleer extractieprompts op formaatspecificaties
- Voeg validatievereisten toe aan prompts
- Overweeg nabewerking voor gegevensstandaardisatie
- Test met verschillende gespreksscenario’s
Overwegingen voor prestaties
- Elke regel voor gegevensverzameling voegt verwerkingstijd toe
- Complexe extractielogica kan langer duren om te beoordelen
- Controleer de nauwkeurigheid van extracties tegenover snelheidsvereisten
- Optimaliseer prompts waar mogelijk voor efficiëntie
Geëxtraheerde gegevens zijn beschikbaar via Post-call Webhooks voor integratie met CRM-systemen, databases en analyseplatforms.