

数据收集
从对话中提取联系人详情和业务数据等结构化信息。
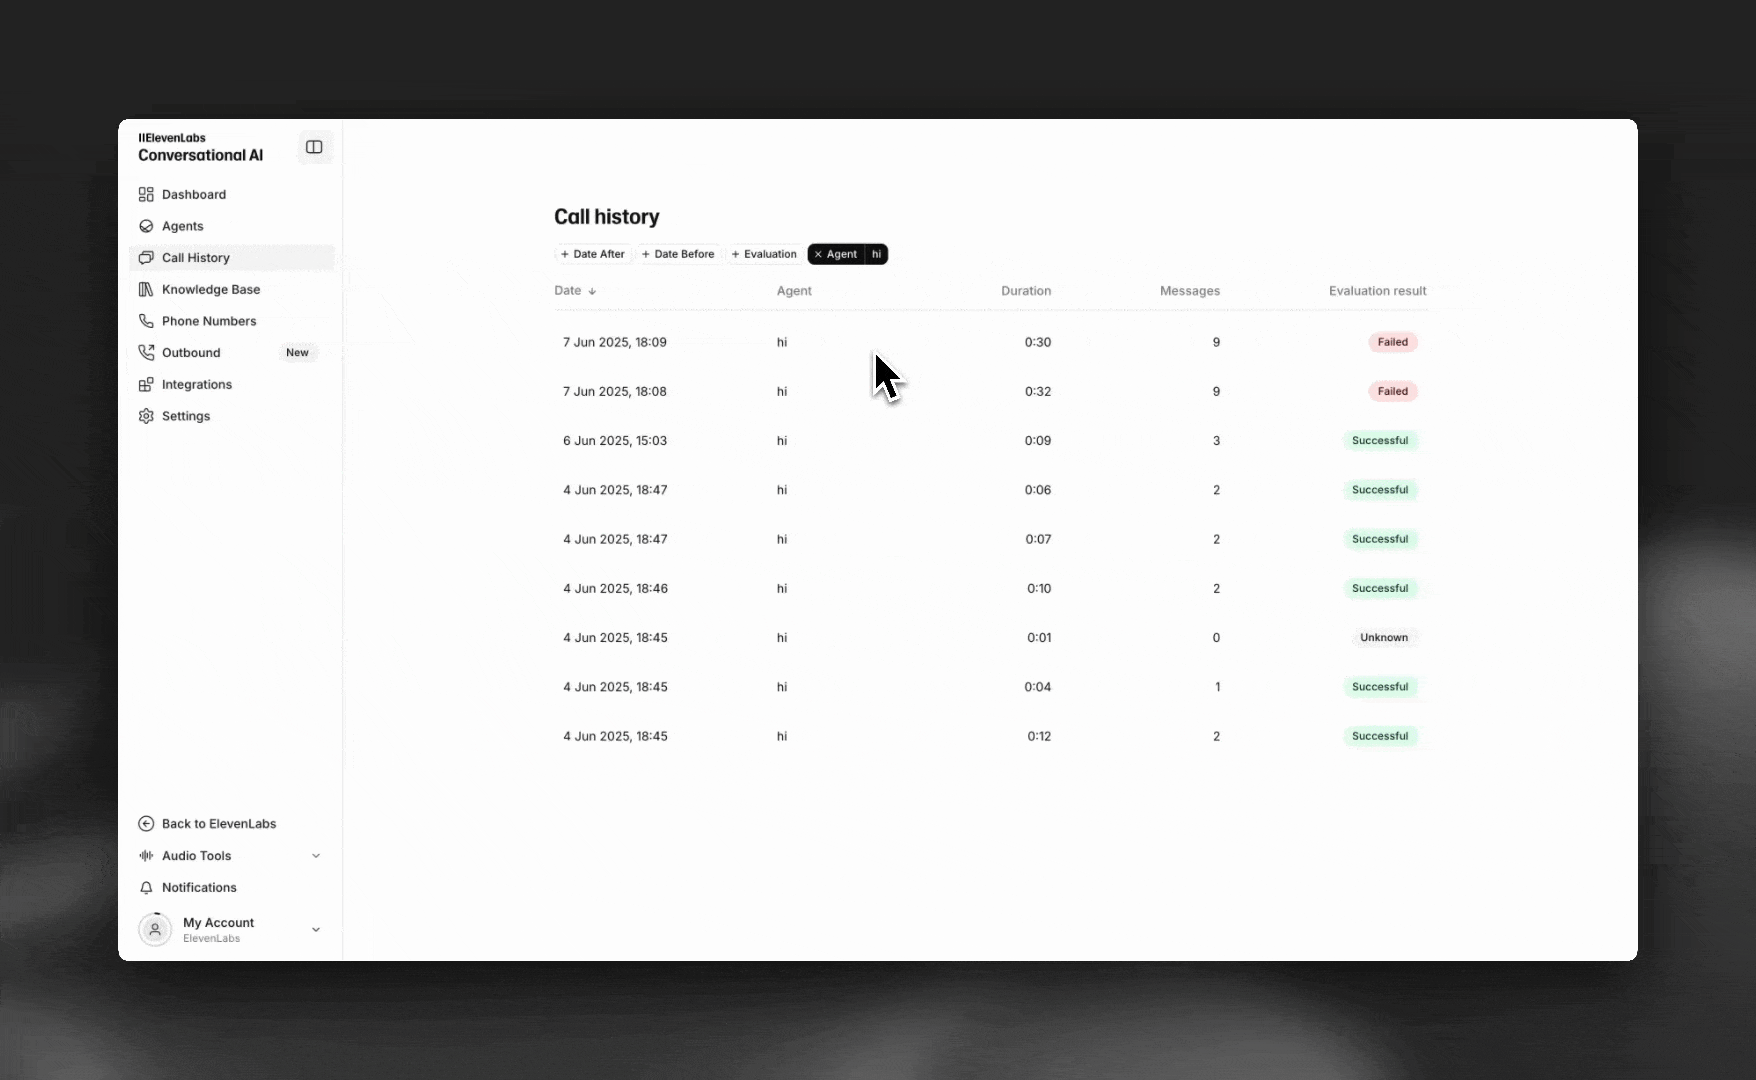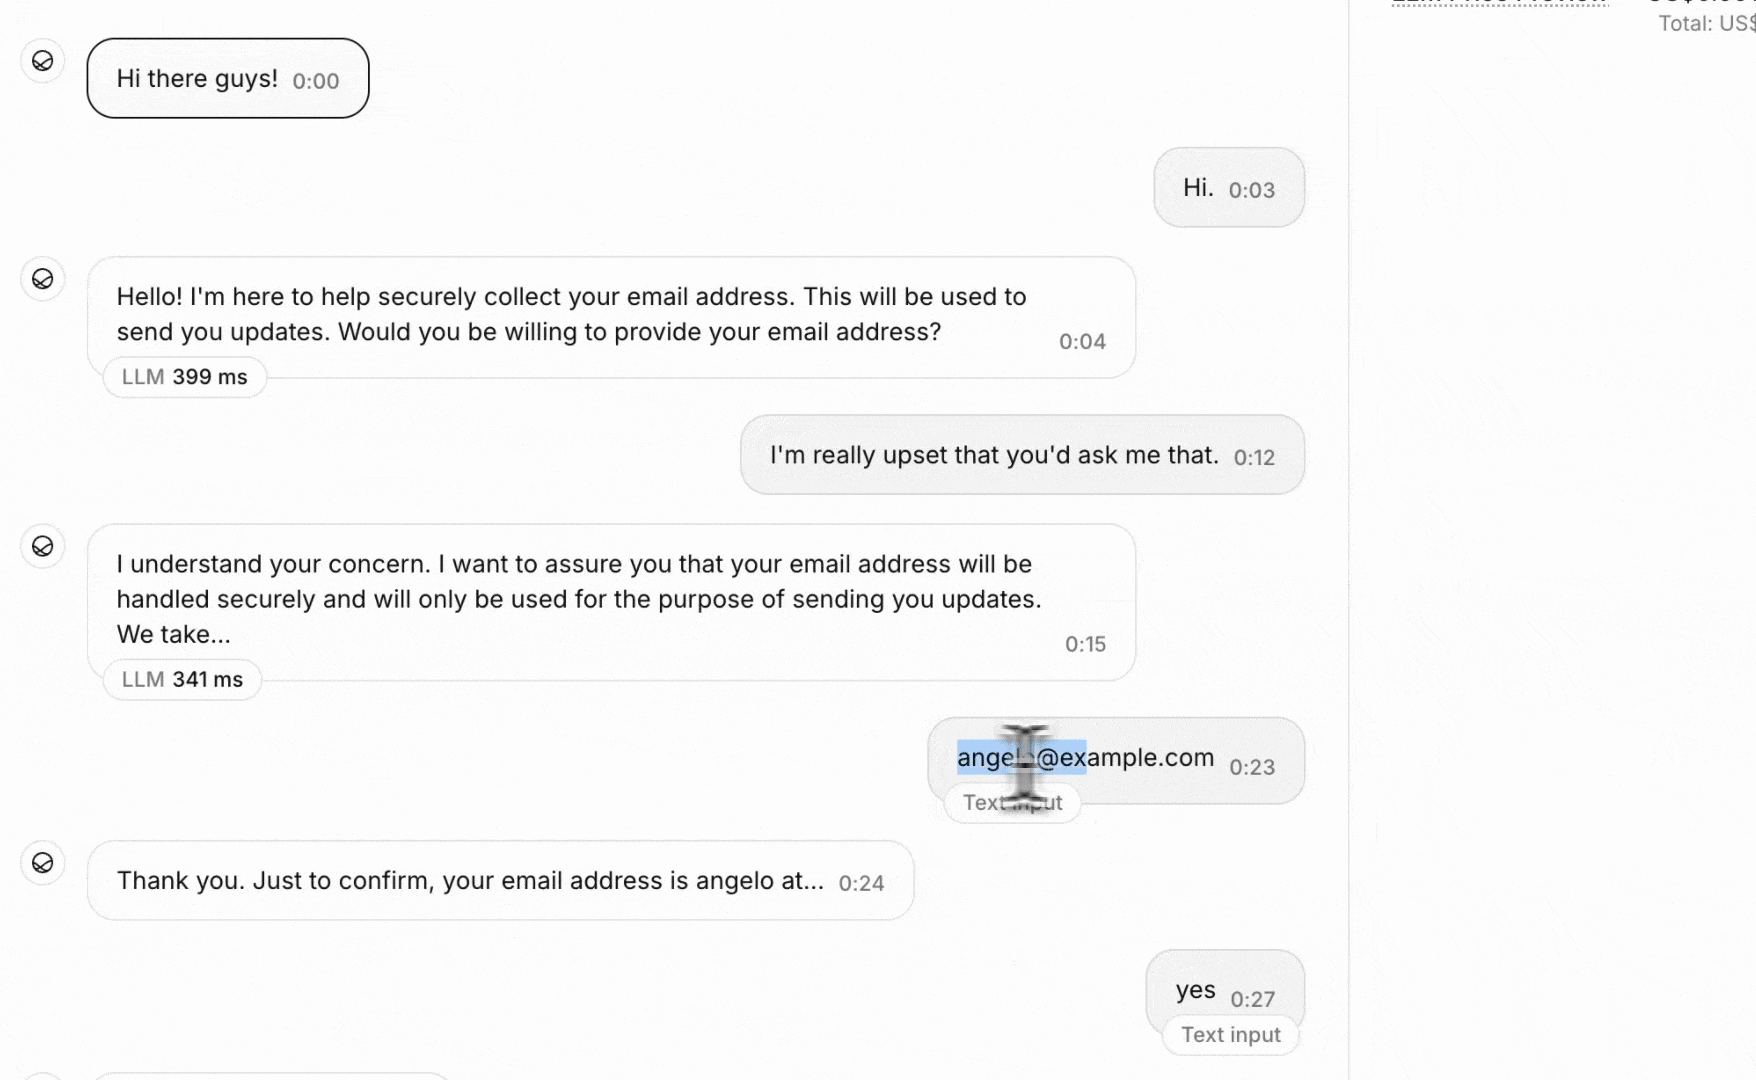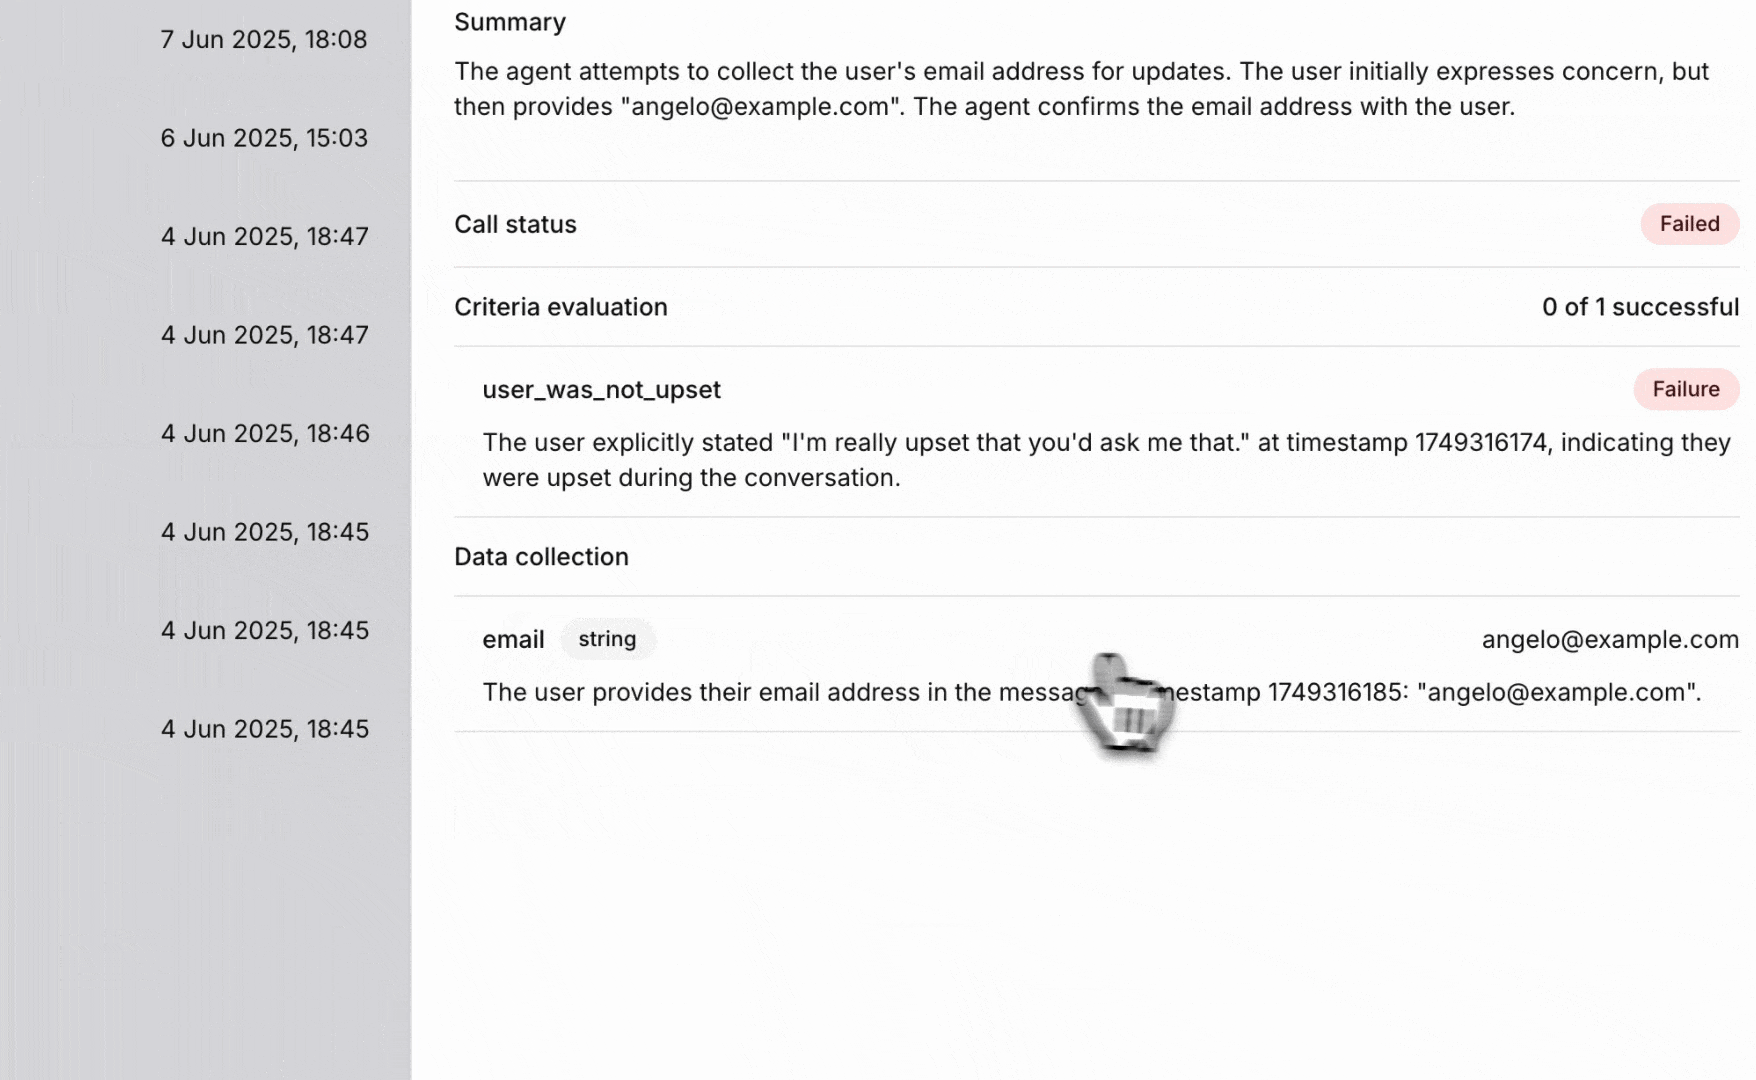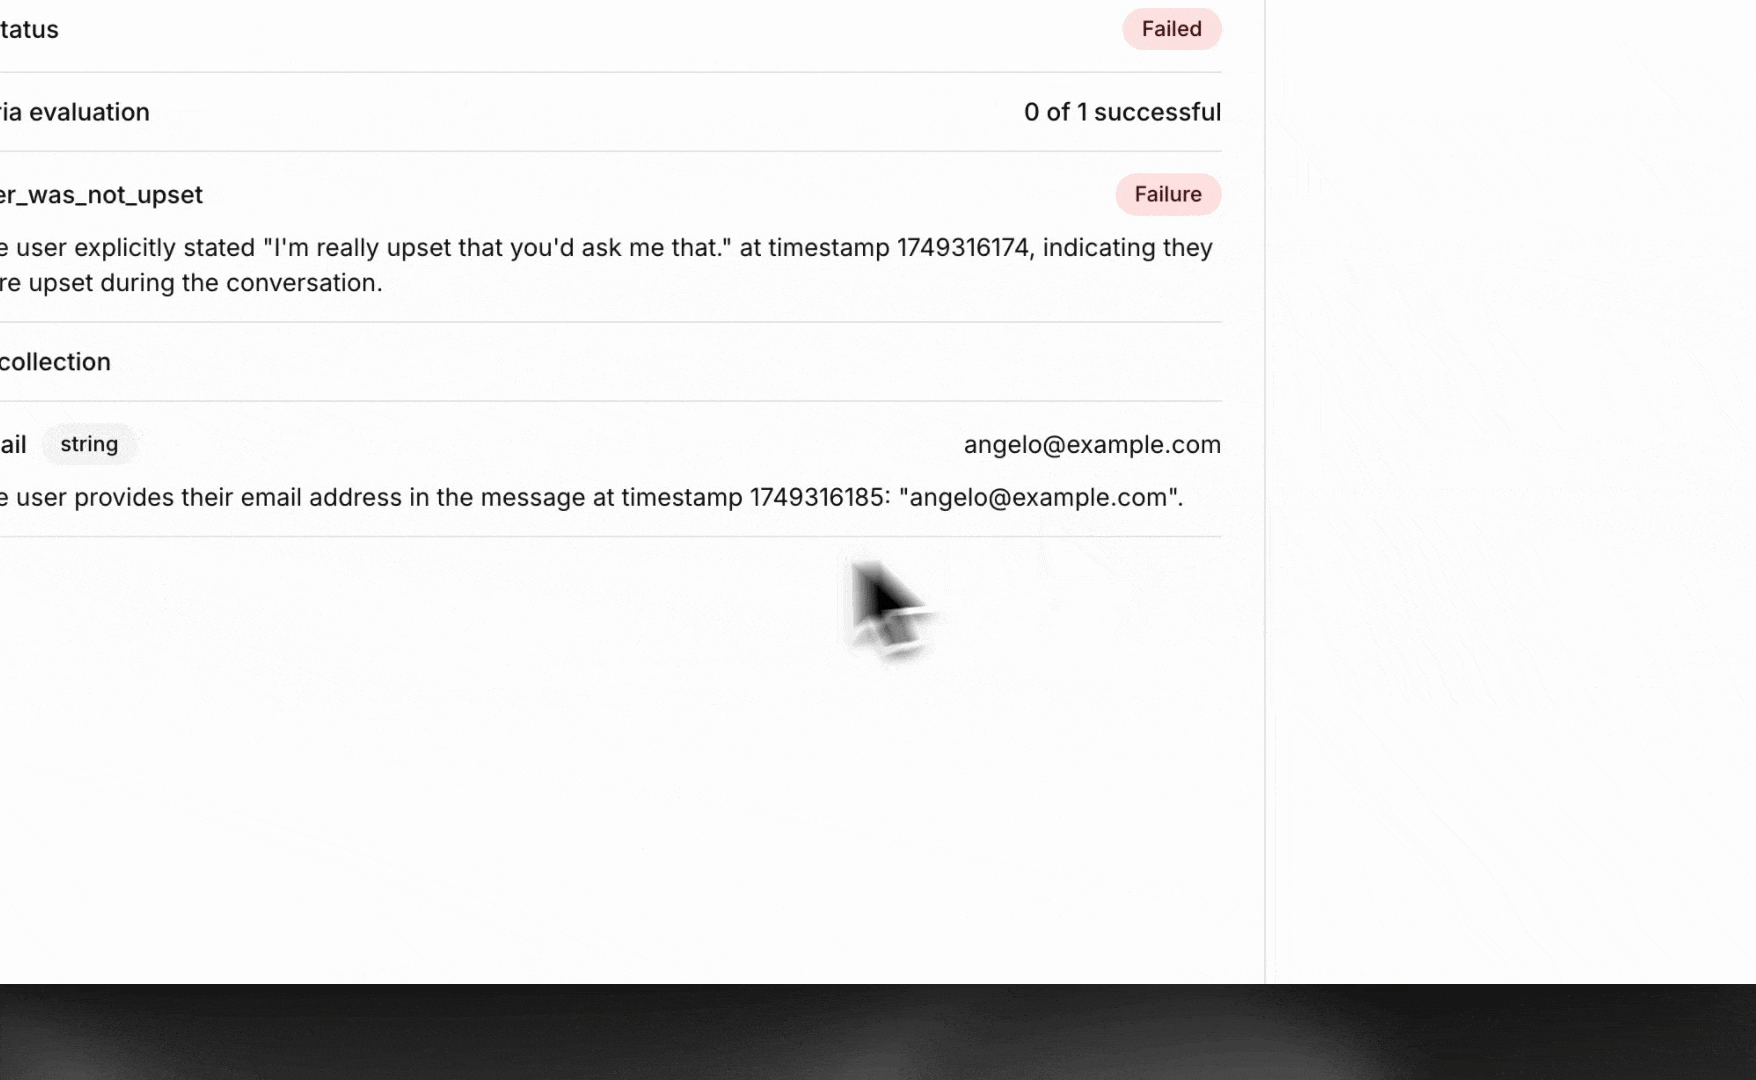
数据收集使用由 LLM 驱动的分析,从对话转录文本中自动提取结构化信息。无需人工处理即可获取有价值的数据点,提高运营效率和数据准确性。
概览
数据收集会分析对话转录文本,识别并提取你定义的特定信息。提取的数据会按你的规格进行结构化,并可用于后续处理和分析。
支持的数据类型
数据收集支持 4 种数据类型,以处理不同的信息格式:
- 字符串:文本信息(姓名、邮箱、地址)
- 布尔值:真/假值(同意状态、资格)
- 整数:整数值(数量、年龄、评分)
- 数字:小数值(价格、百分比、测量值)
配置
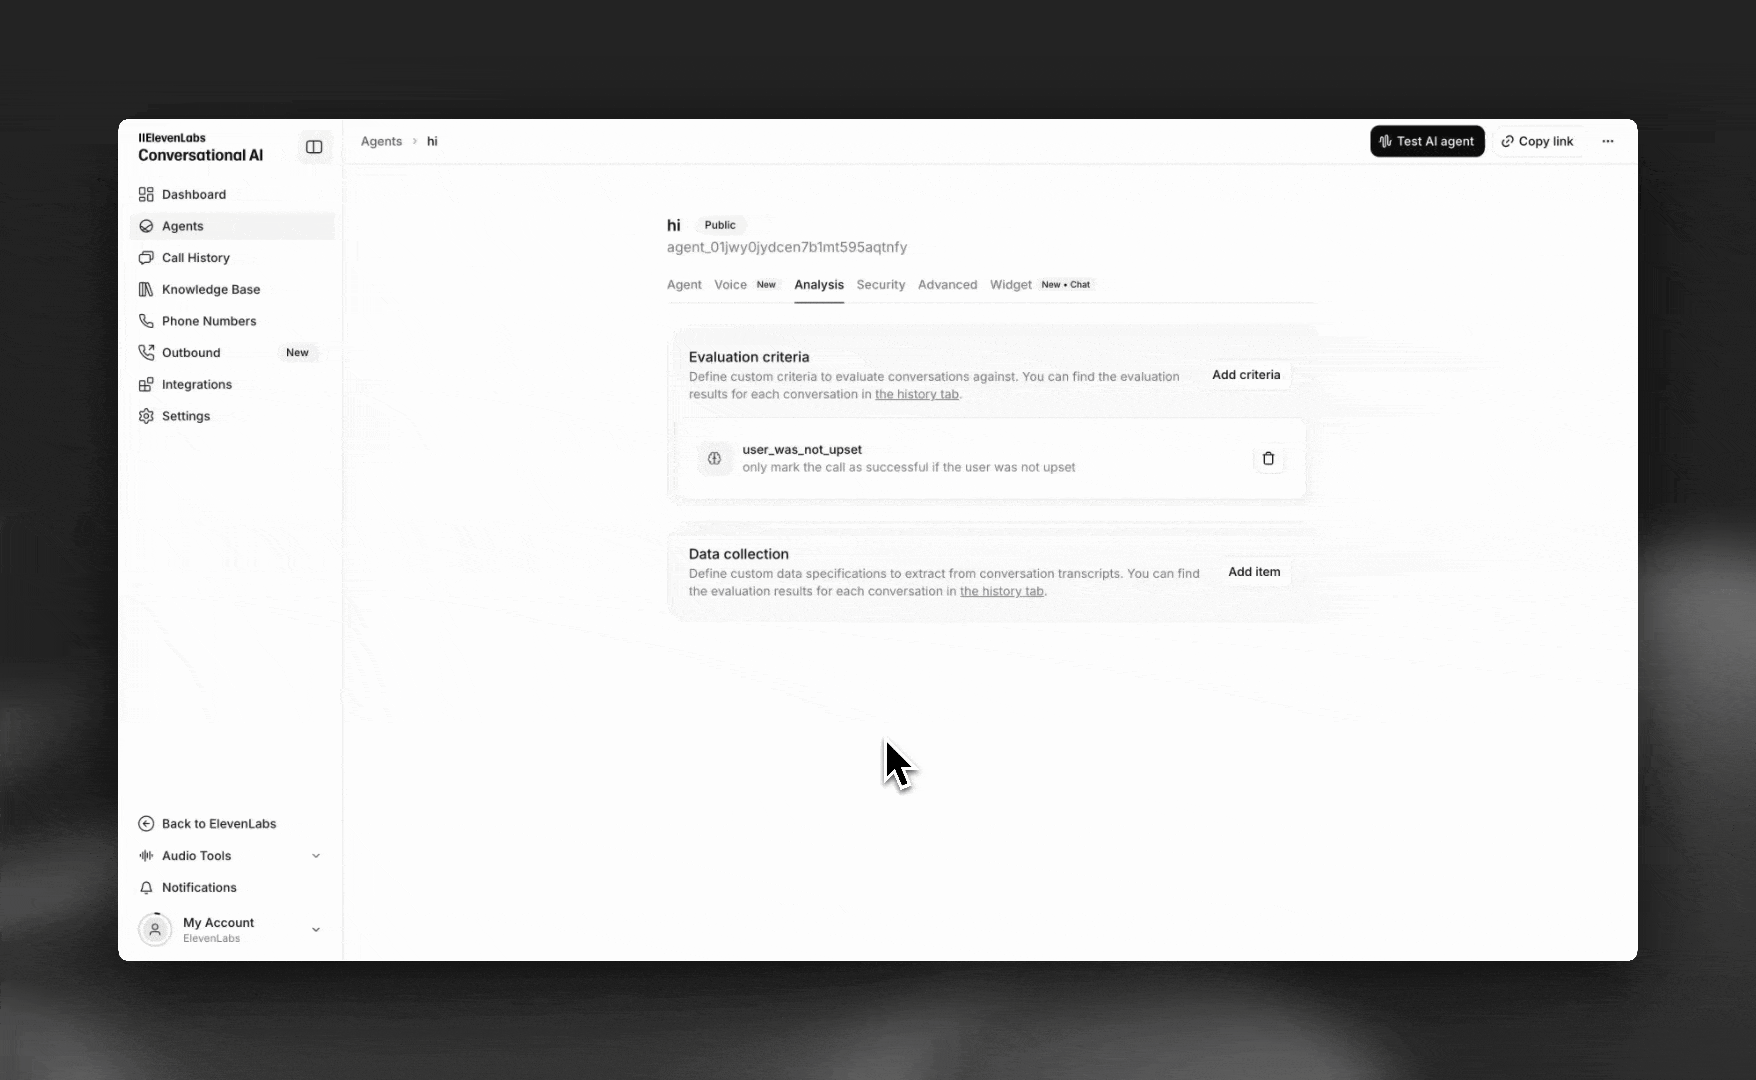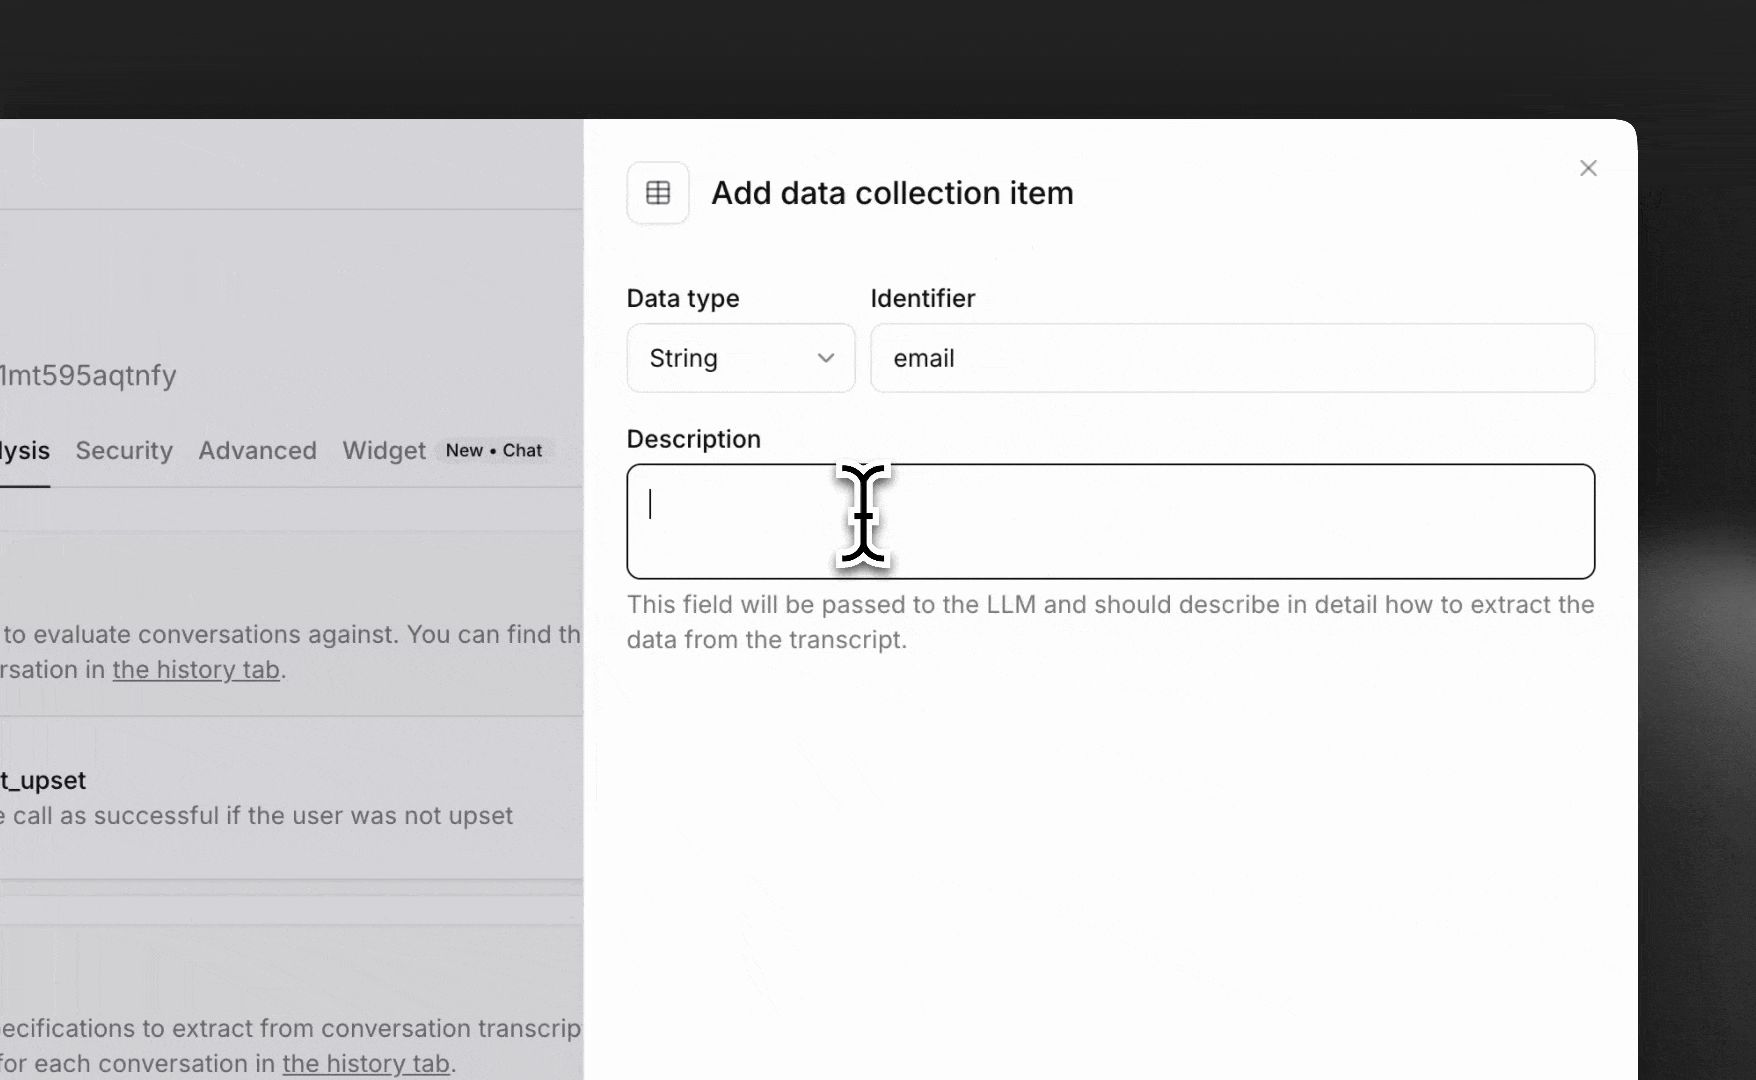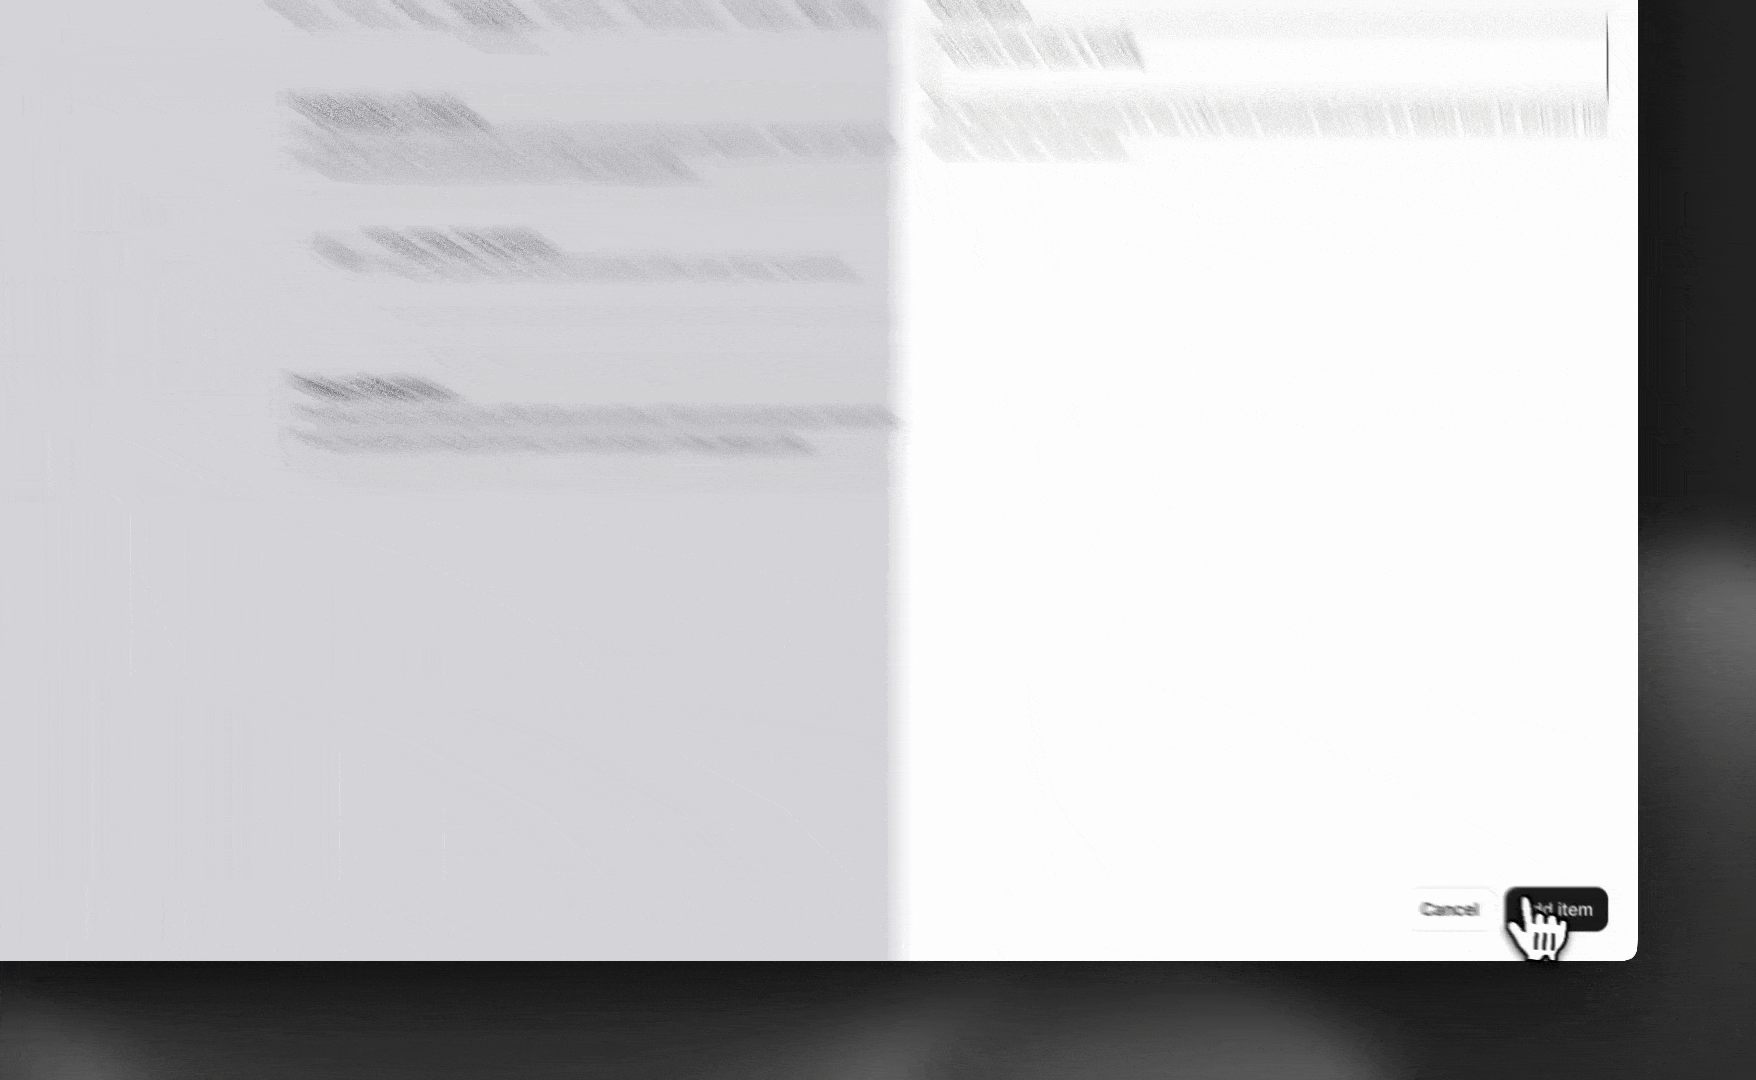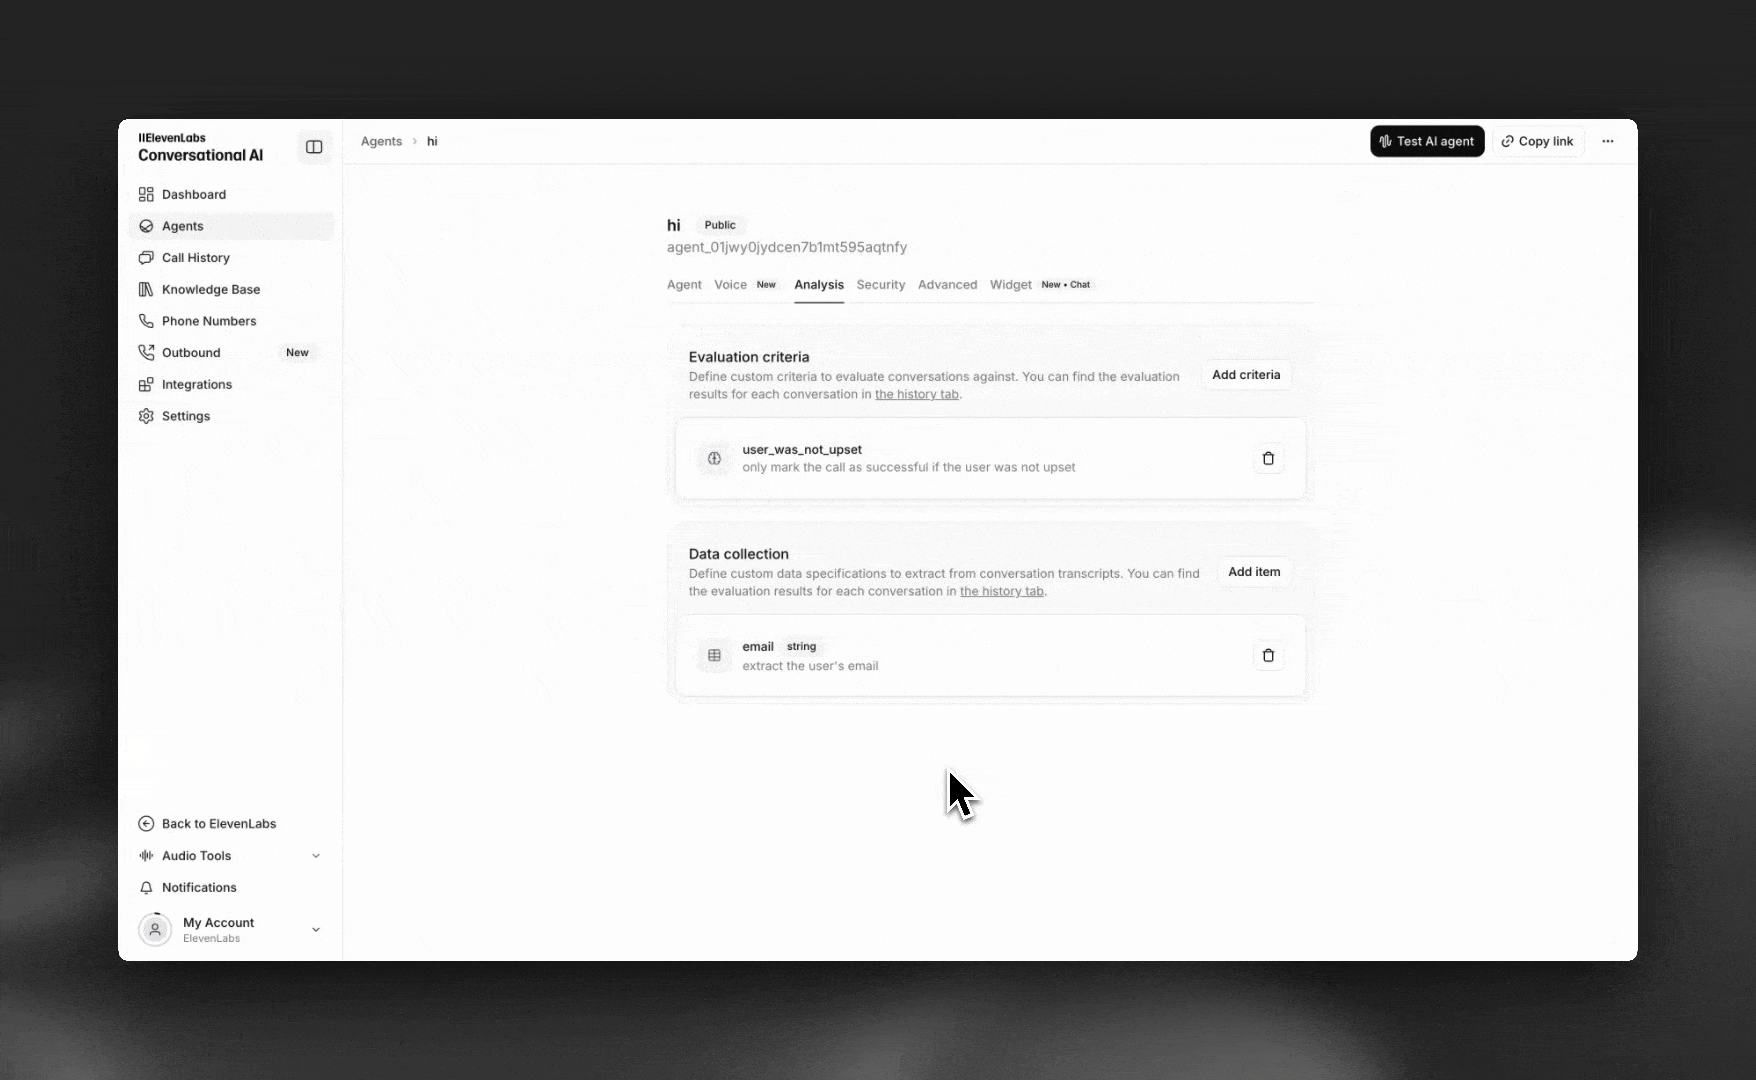
添加数据收集项目
点击 Add data collection,创建新的数据提取规则,或从工作区的分析库关联规则。
为每个项目配置:
- 名称:数据字段的唯一名称(例如
email、customer_rating) - 数据类型:选择字符串、布尔值、整数或数字
- 描述:关于如何从转录文本中提取数据的详细说明
描述字段会传递给 LLM,应尽可能具体地说明要提取什么内容及其格式。
Trial 和企业版套餐中,每个智能体最多可添加 50 个数据收集项目;其他套餐最多 25 个。
最佳实践
编写有效的提取提示词
- 明确预期格式(例如,“格式为 user@domain.com 的邮箱地址”)
- 说明信息缺失或不清晰时该如何处理
- 提供有效和无效数据示例
- 说明所有验证要求
常见数据收集示例
联系信息:
email:“以标准格式提取客户邮箱地址(user@domain.com)”phone_number:“提取包含区号的客户电话号码”full_name:“提取客户提供的完整姓名”
业务数据:
issue_category:“将客户问题归类为以下之一:技术、账单、账户或一般问题”satisfaction_rating:“提取客户给出的任何数值满意度评分(1-10 分)”order_number:“提取客户提到的任何订单号或参考编号”
行为数据:
was_angry:“判断客户是否在通话中表达愤怒或沮丧情绪”requested_callback:“判断客户是否请求回电或后续跟进”
处理缺失或不明确的数据
如果在转录文本中找不到请求的数据,或数据存在歧义,提取结果将返回 null 或空值。建议:
- 在应用中使用条件逻辑处理缺失数据
- 为不完整的提取创建备用标准
- 训练智能体稳定收集所需信息
数据类型指南
字符串
布尔值
整数
数字
用于不适合其他类型的文本信息。
示例:
- 客户姓名
- 邮箱地址
- 产品类别
- 问题描述
最佳实践:
- 相关时指定预期格式
- 包含验证要求
- 考虑标准化需求
使用场景
故障排除
数据提取返回空值
- 确认对话转录文本中存在该数据
- 检查提取提示词是否足够具体
- 确保数据类型符合预期格式
- 考虑信息在对话中是否表达清楚
数据格式不一致
- 检查提取提示词中的格式说明
- 在提示词中添加验证要求
- 考虑进行后处理以标准化数据
- 使用各种对话场景进行测试
性能注意事项
- 每条数据收集规则都会增加处理时间
- 复杂的提取逻辑可能需要更长的评估时间
- 监控提取准确性与速度要求之间的平衡
- 尽可能优化提示词以提高效率
可通过通话后 Webhook获取提取的数据,并将其集成到 CRM 系统、 数据库和分析平台中。