

डेटा संग्रह
बातचीत से संपर्क विवरण और व्यावसायिक डेटा जैसी संरचित जानकारी निकालें।
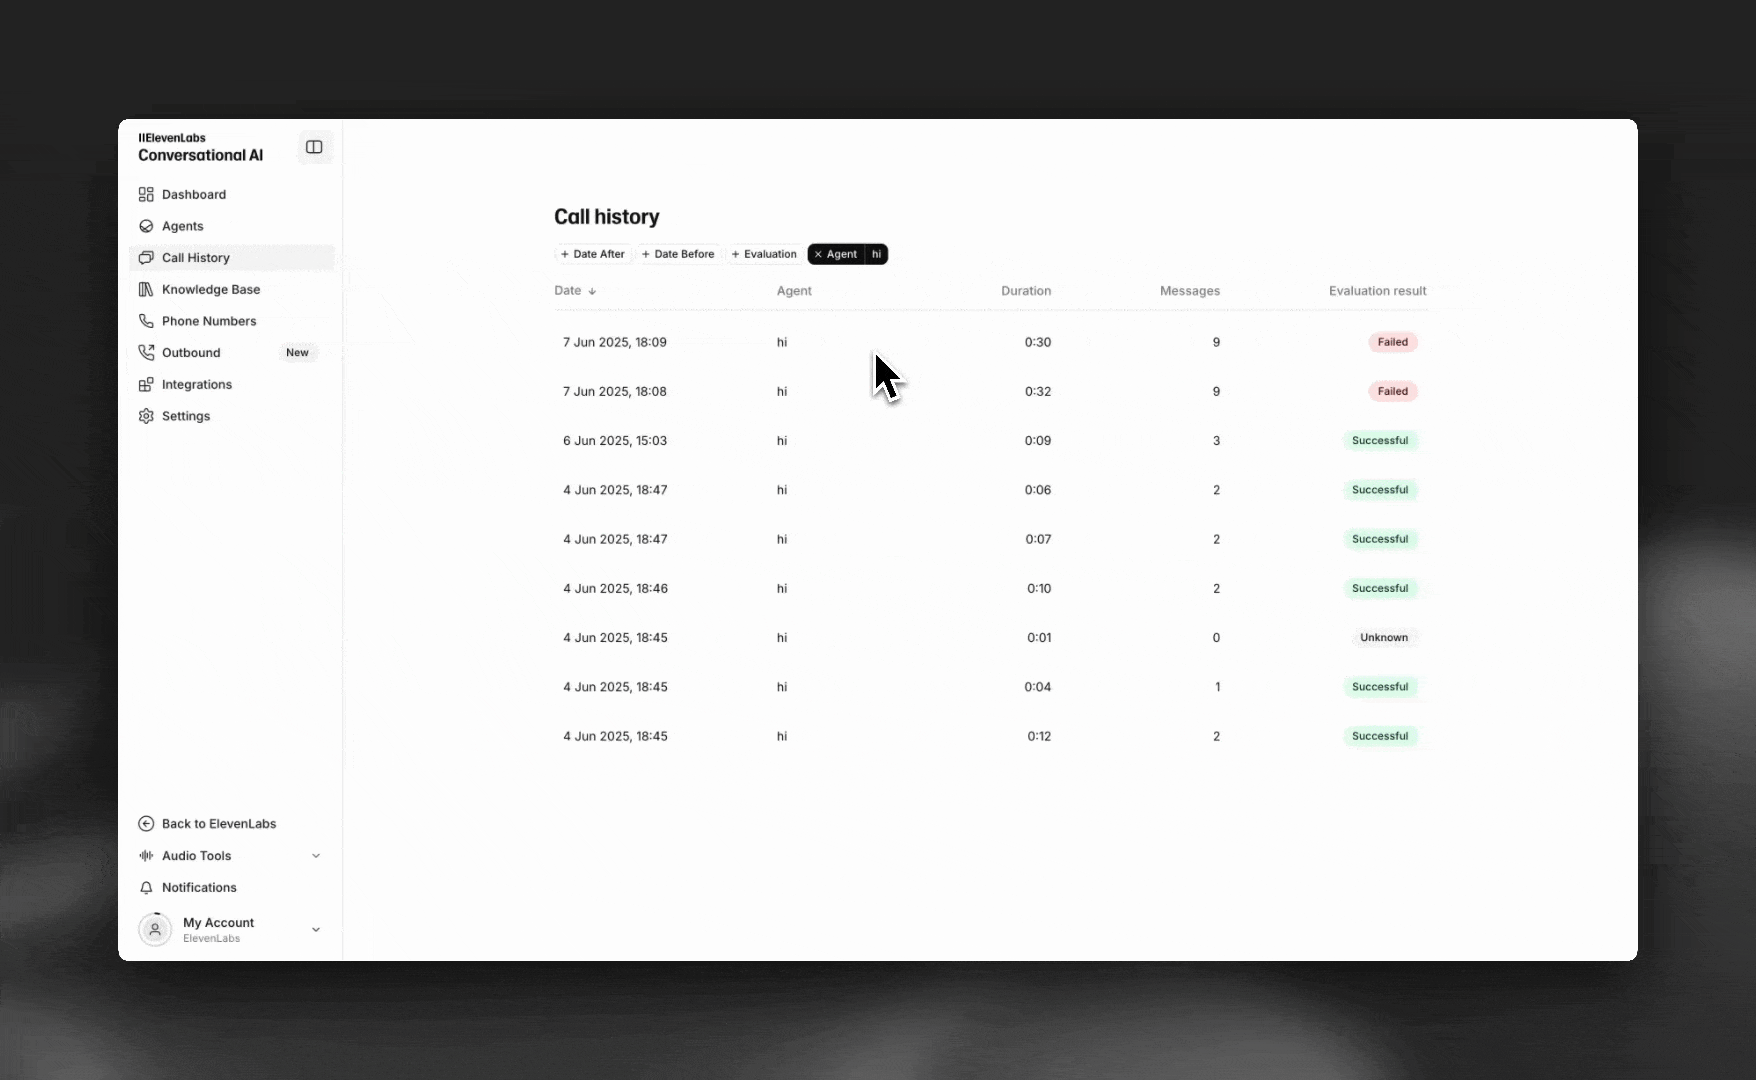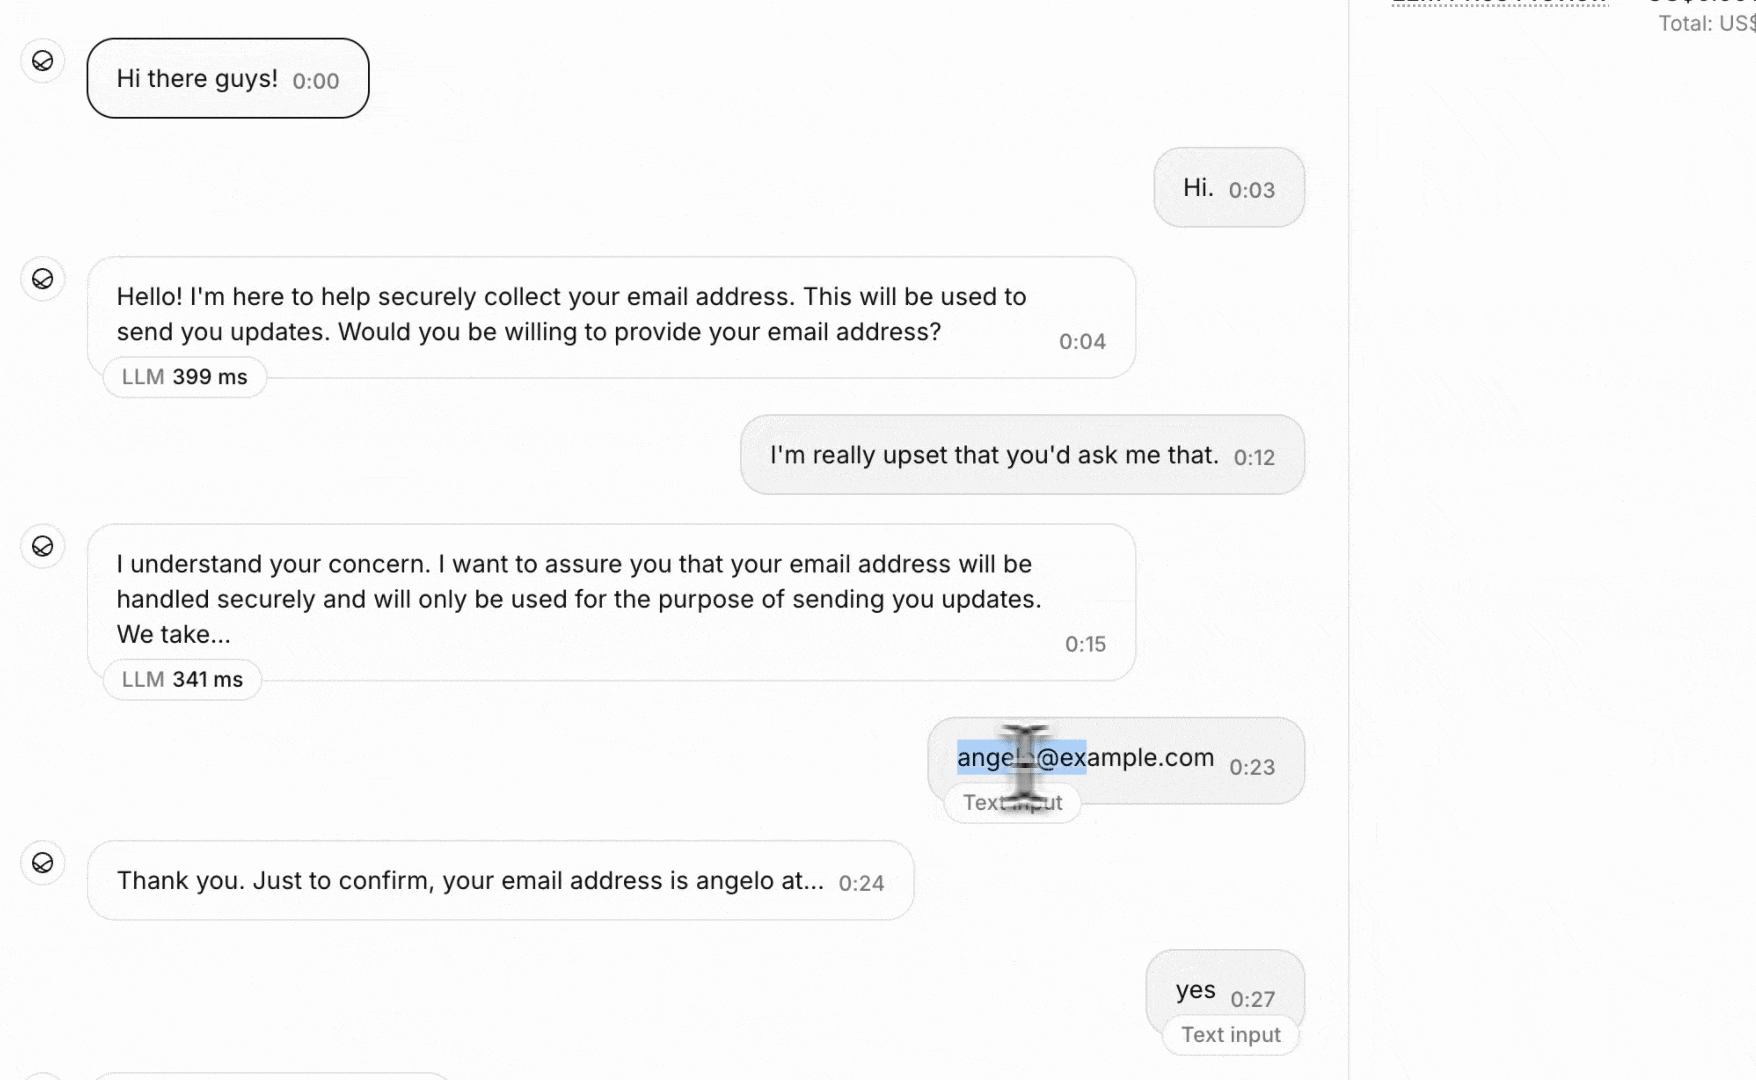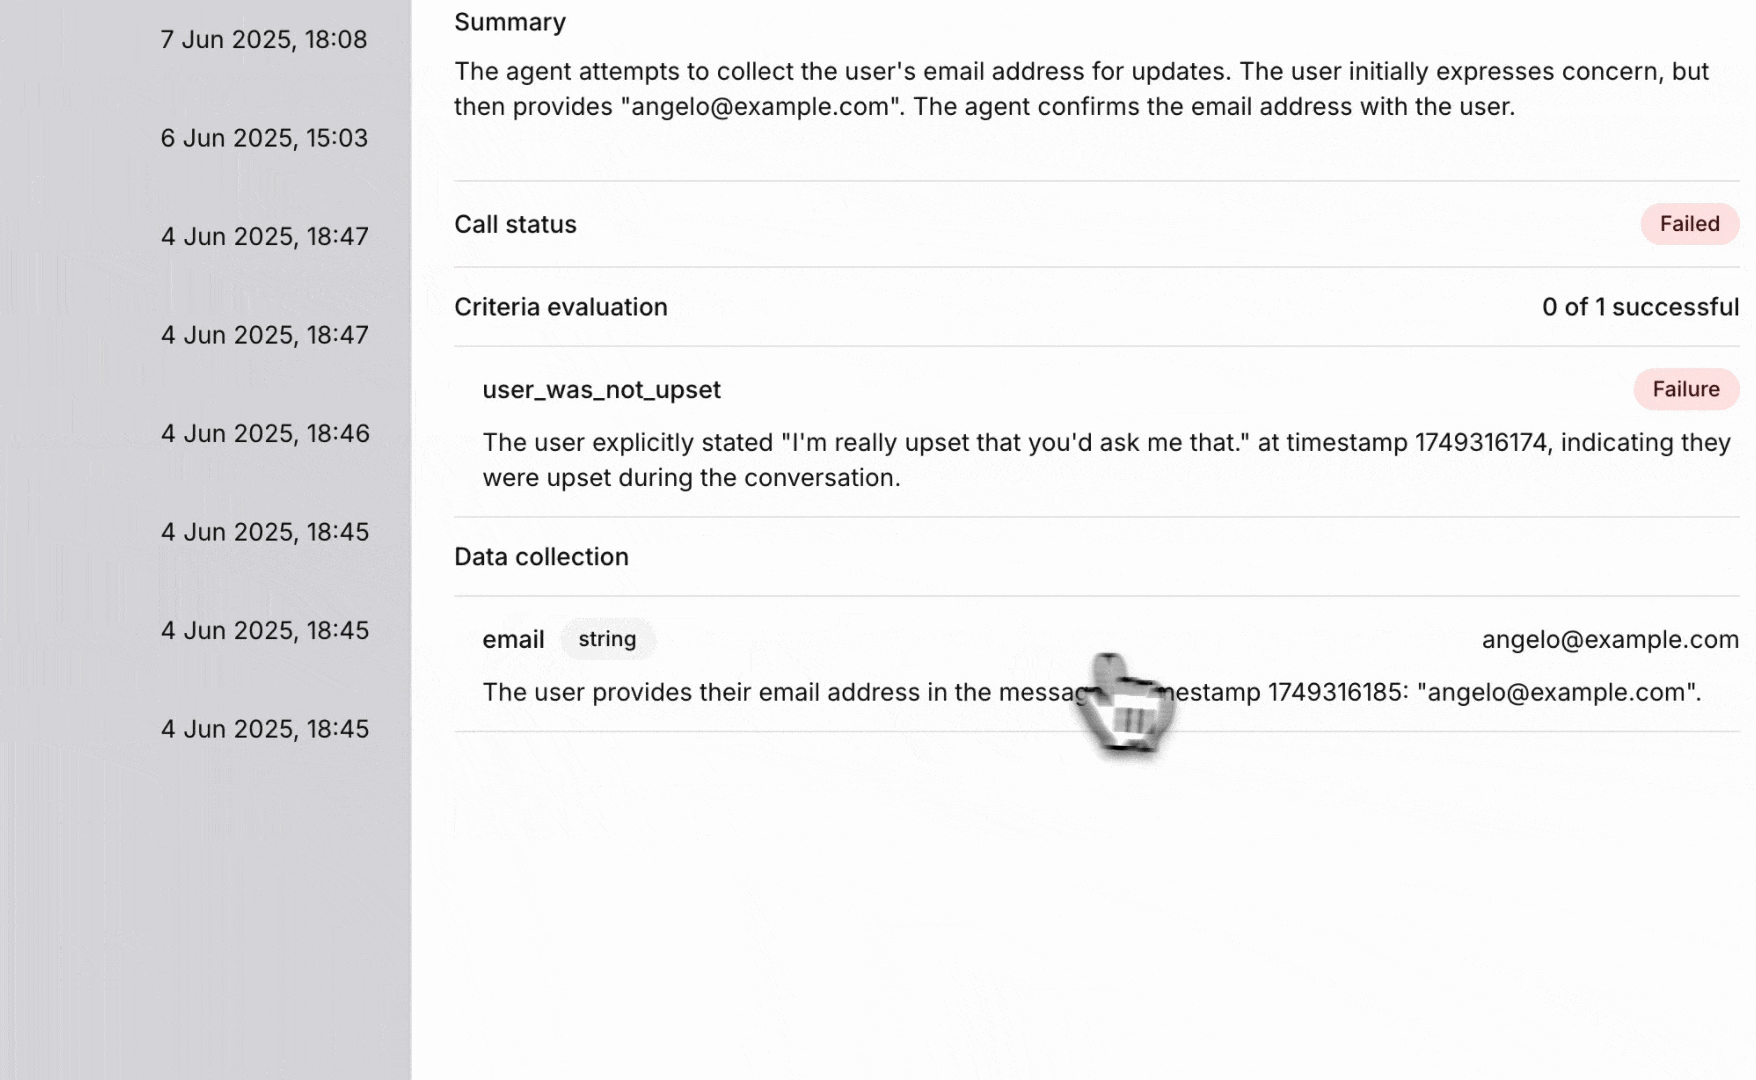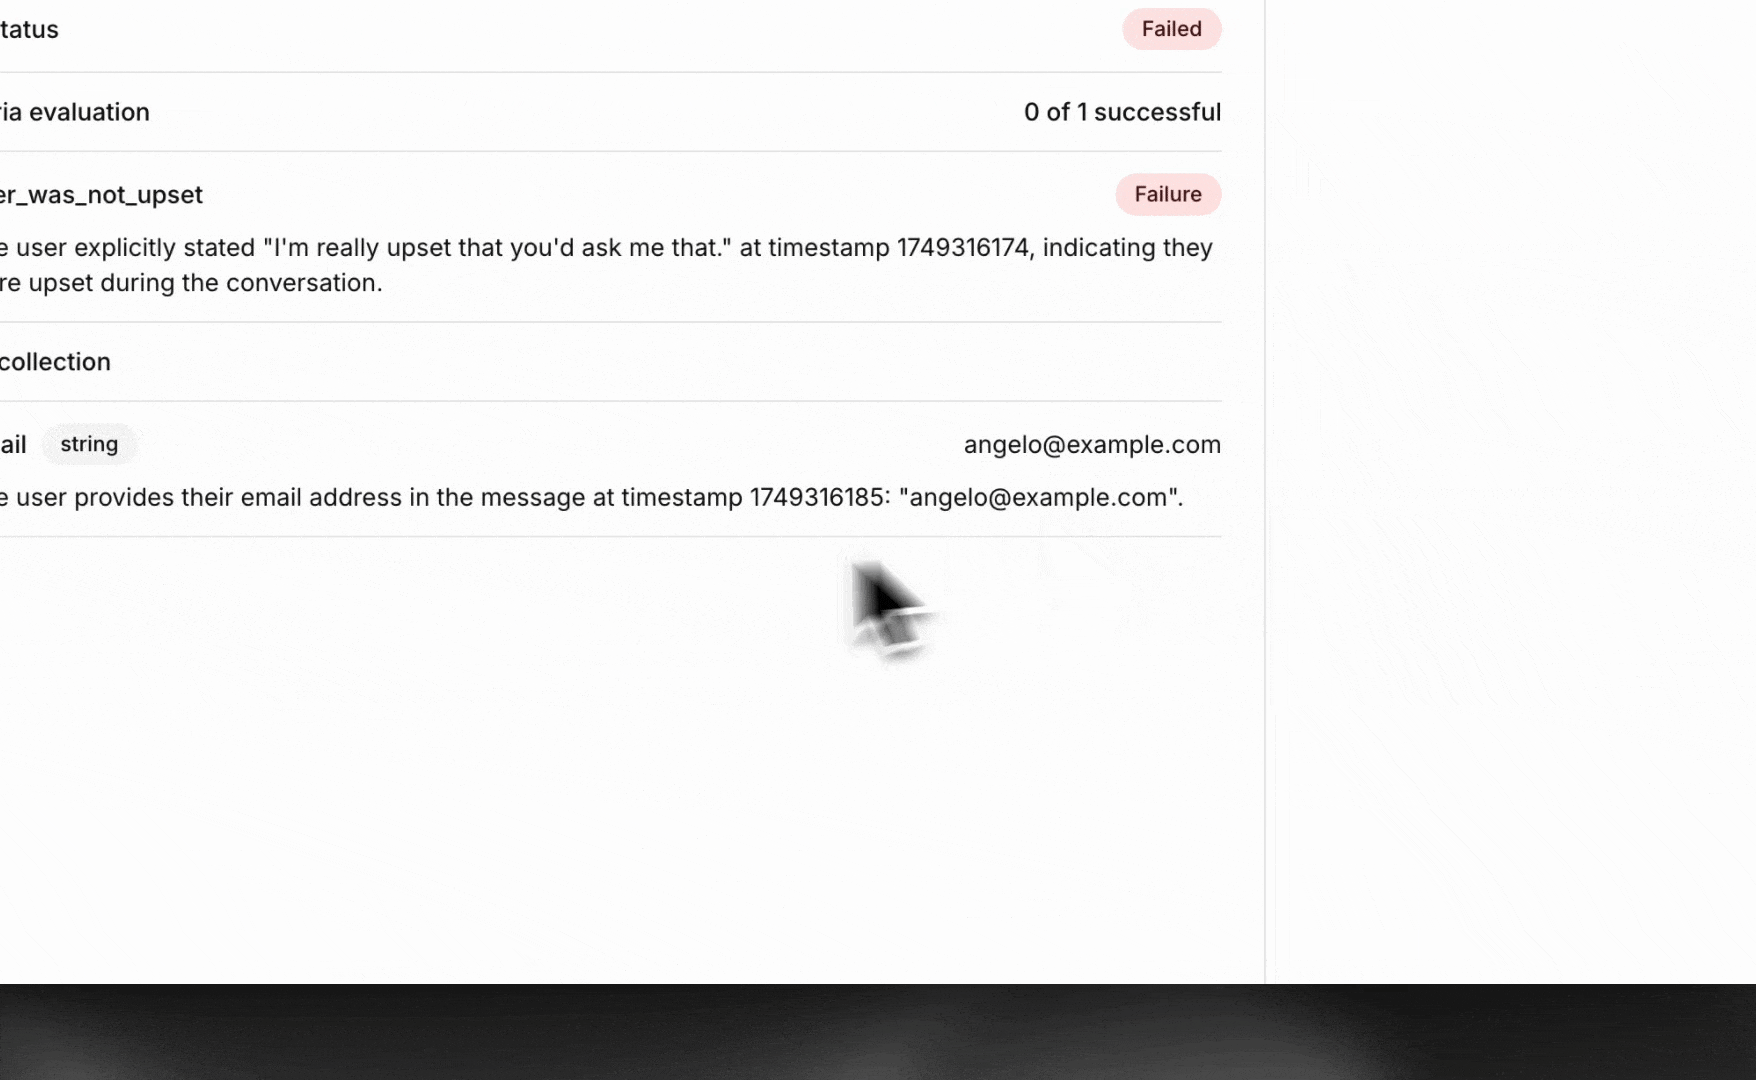
डेटा संग्रह, LLM-आधारित विश्लेषण का इस्तेमाल करके बातचीत के ट्रांसक्रिप्ट से संरचित जानकारी अपने-आप निकालता है। इससे आप मैन्युअल प्रोसेसिंग के बिना महत्वपूर्ण डेटा पॉइंट कैप्चर कर सकते हैं, जिससे ऑपरेशनल दक्षता और डेटा की सटीकता बेहतर होती है।
परिचय
डेटा संग्रह, बातचीत के ट्रांसक्रिप्ट का विश्लेषण करके आपकी तय की हुई खास जानकारी पहचानता और निकालता है। निकाला गया डेटा आपके विनिर्देशों के अनुसार संरचित होता है और आगे की प्रोसेसिंग व विश्लेषण के लिए उपलब्ध कराया जाता है।
समर्थित डेटा प्रकार
डेटा संग्रह अलग-अलग जानकारी फ़ॉर्मैट को संभालने के लिए चार डेटा प्रकार सपोर्ट करता है:
- स्ट्रिंग: टेक्स्ट-आधारित जानकारी (नाम, ईमेल, पते)
- बूलियन: सही/गलत वैल्यू (सहमति की स्थिति, पात्रता)
- इंटीजर: पूर्ण संख्याएं (मात्रा, उम्र, रेटिंग)
- नंबर: दशमलव संख्याएं (कीमत, प्रतिशत, माप)
कॉन्फ़िगरेशन
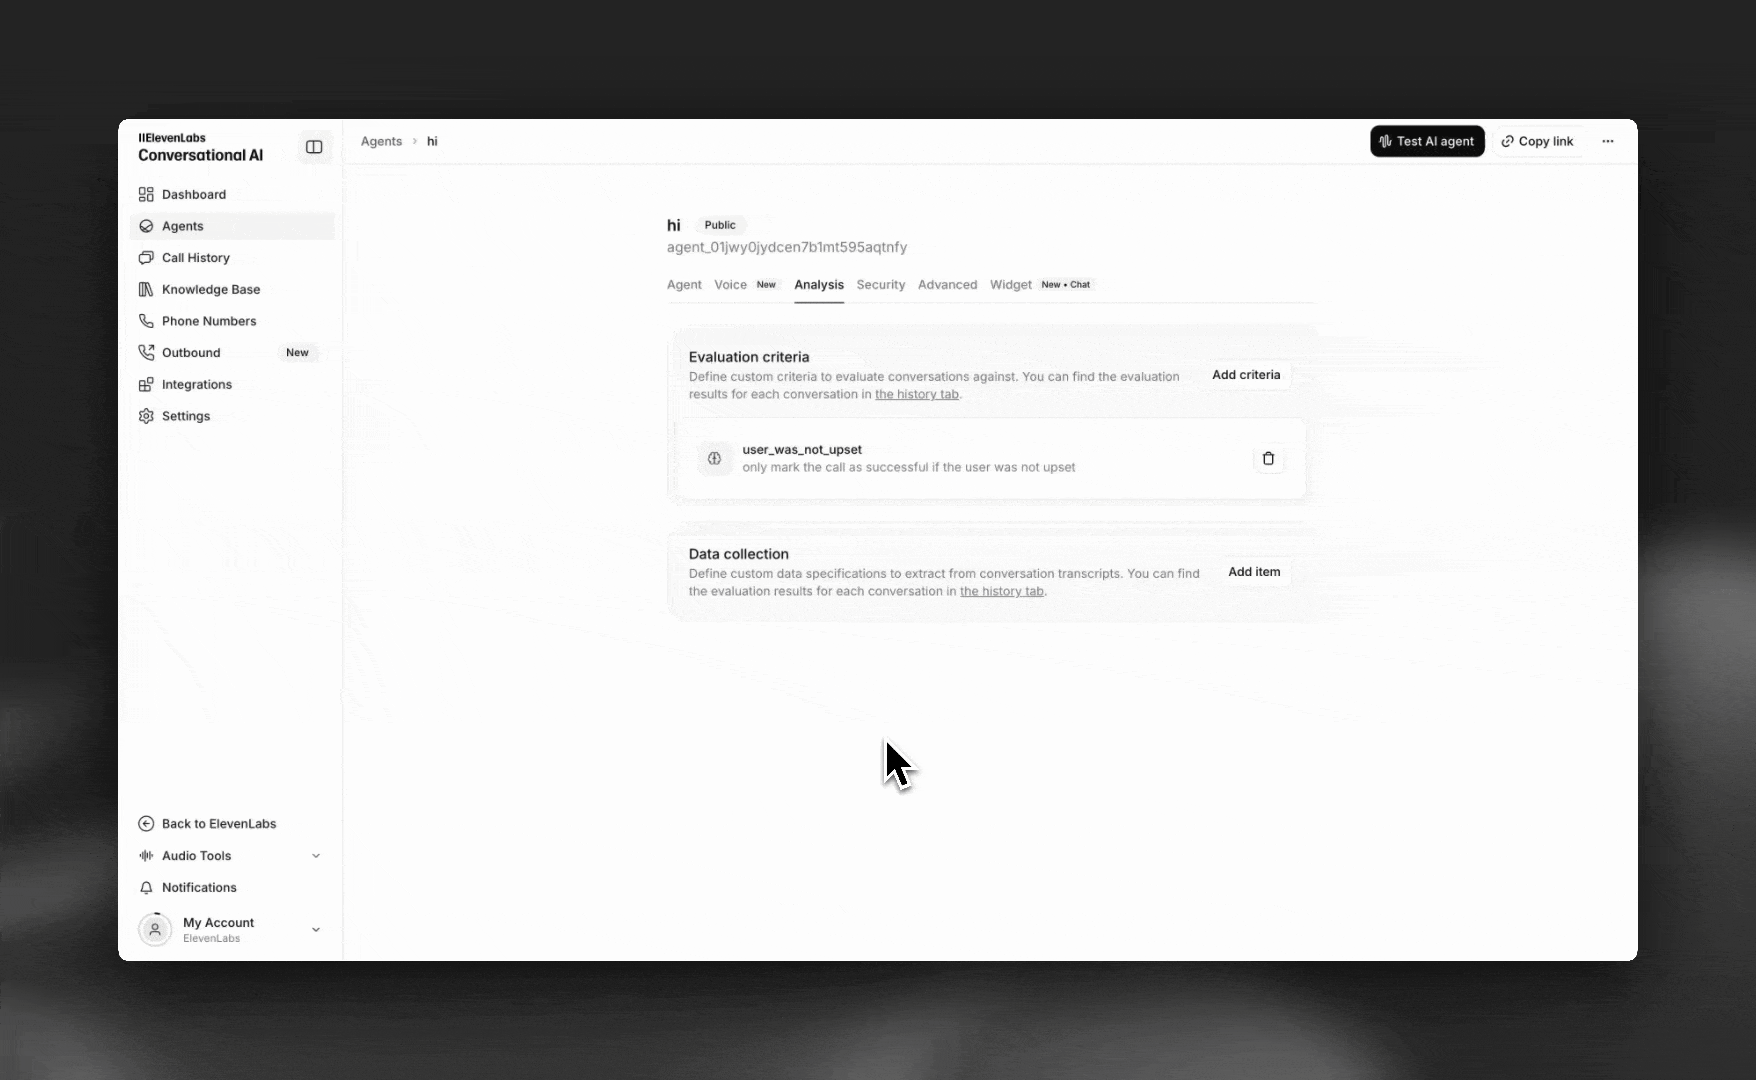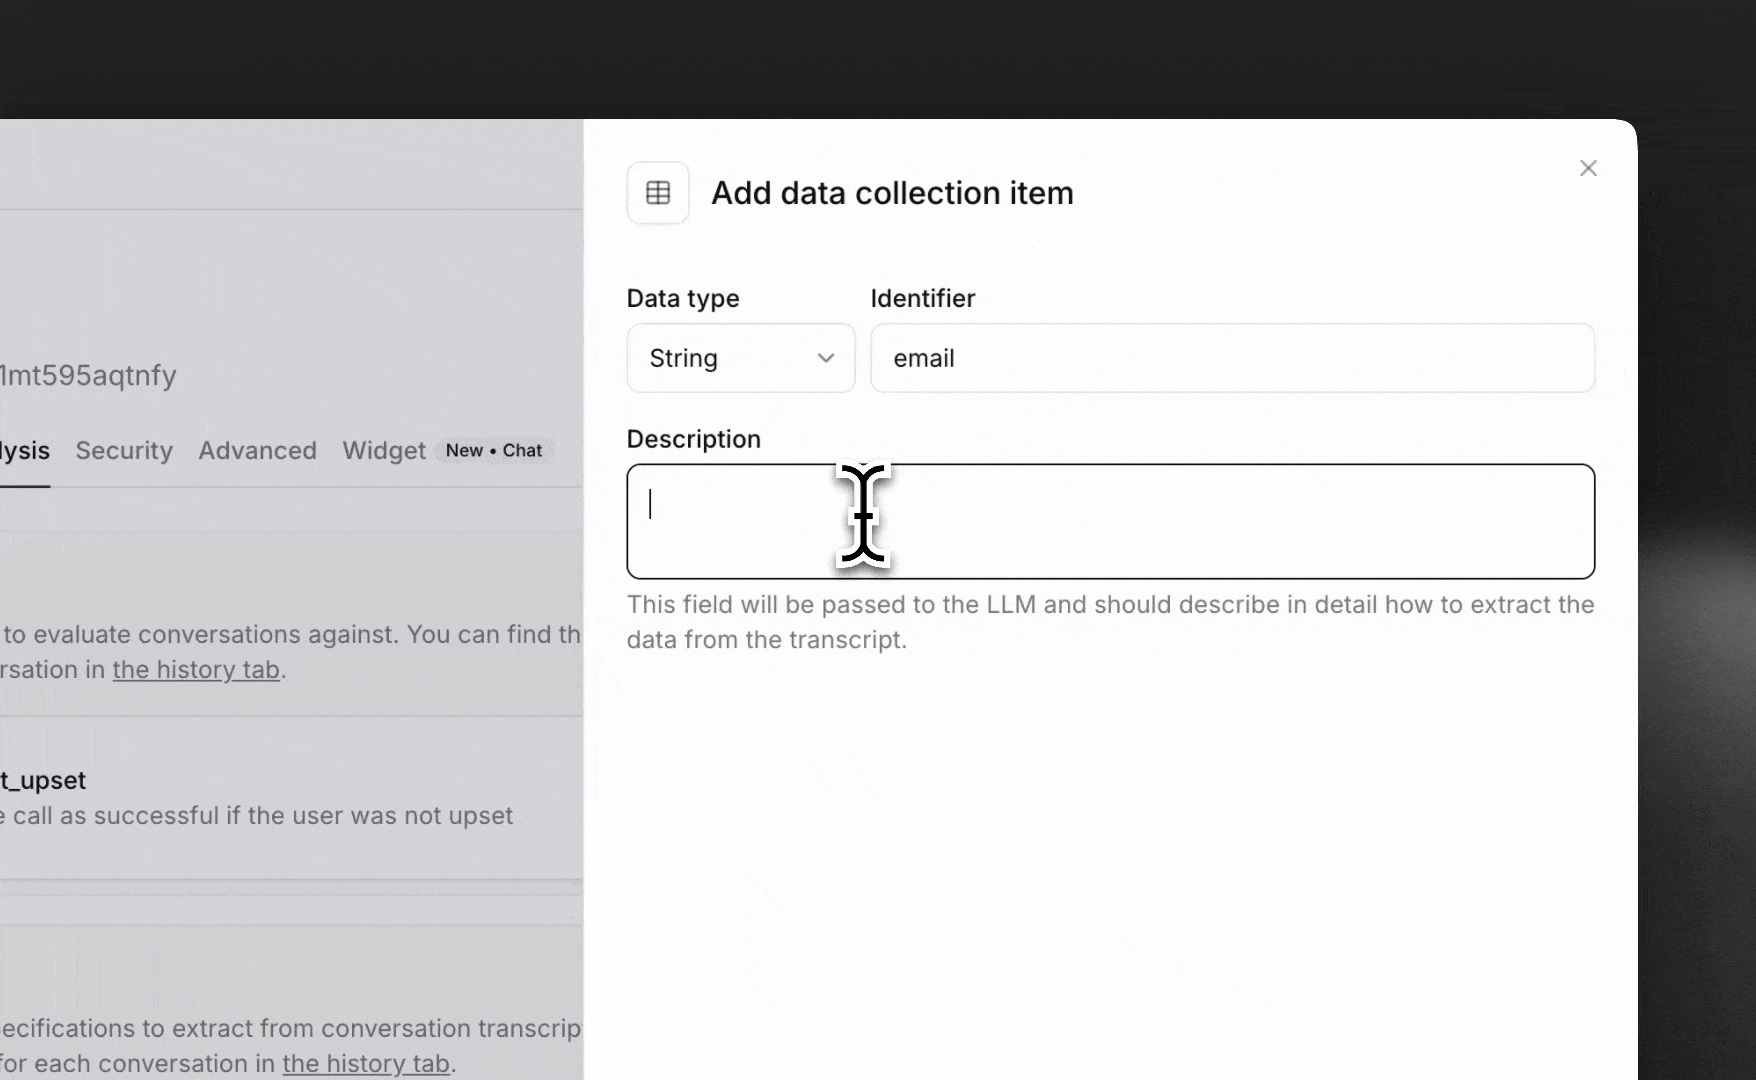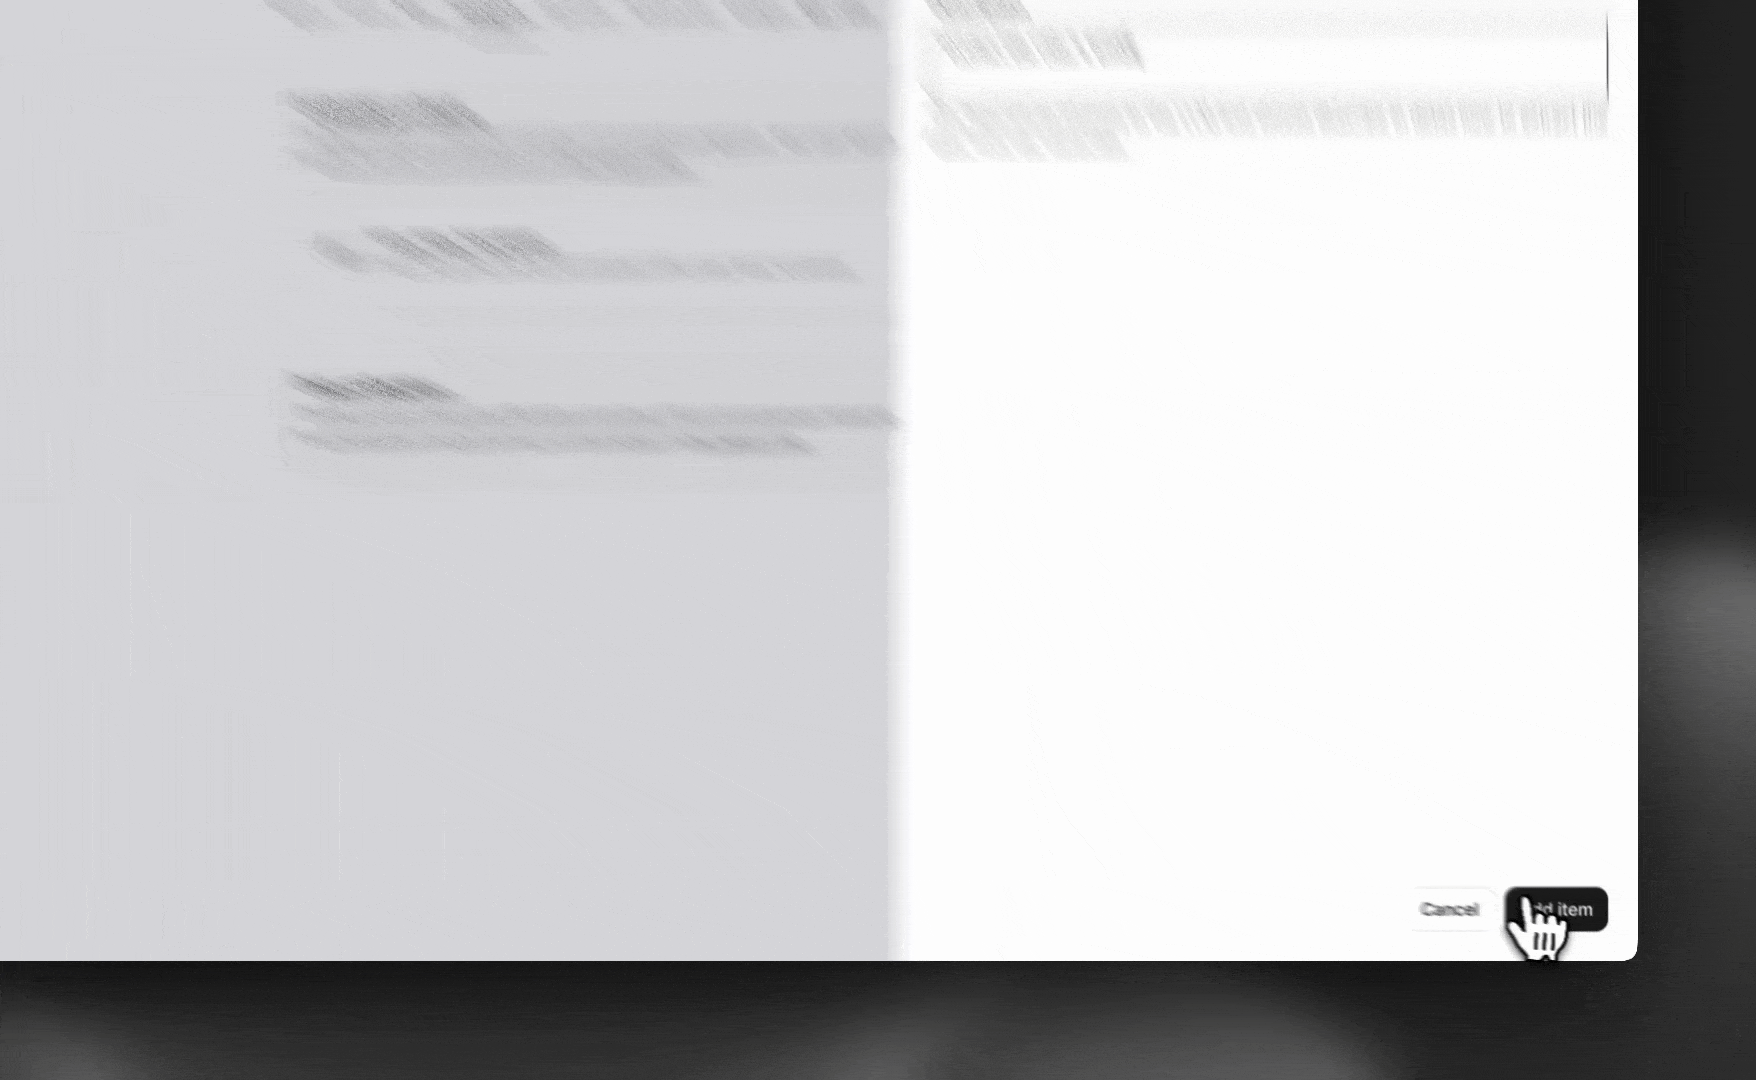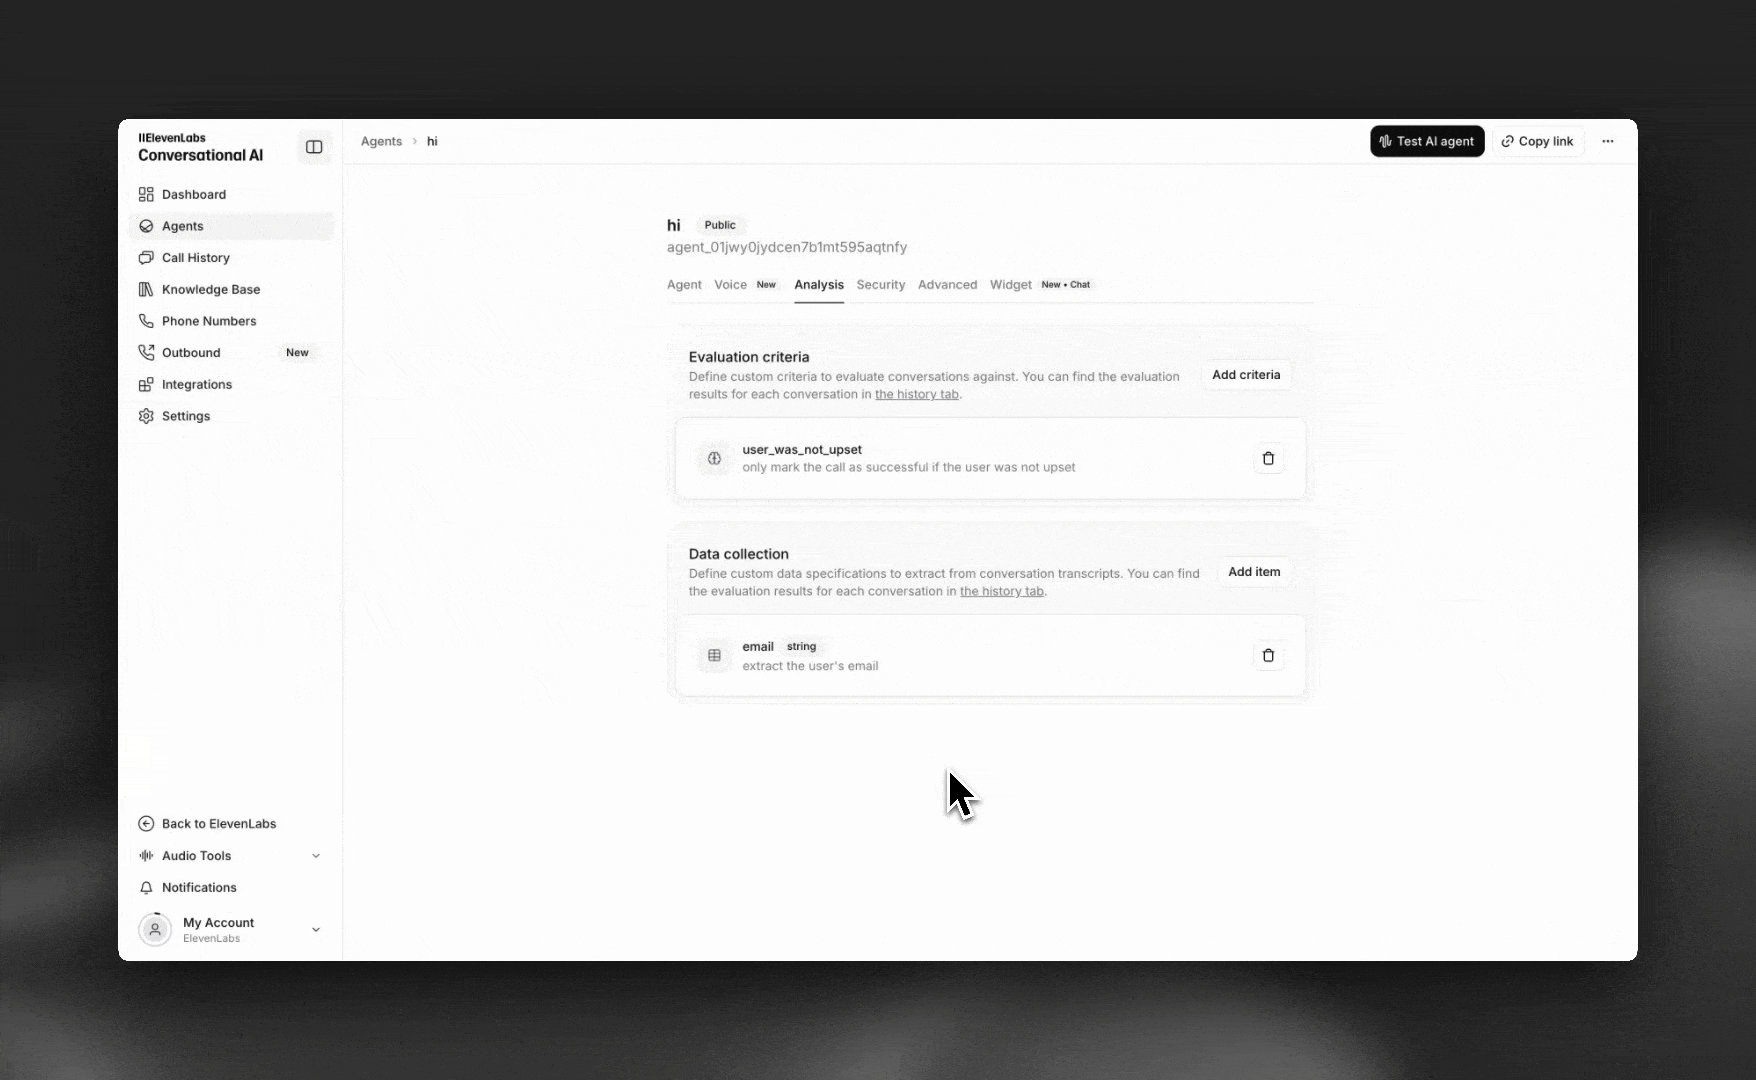
डेटा संग्रह आइटम जोड़ें
नया डेटा एक्सट्रैक्शन नियम बनाने के लिए या अपने वर्कस्पेस की analysis library से कोई नियम जोड़ने के लिए Add data collection पर क्लिक करें।
हर आइटम को इन विकल्पों के साथ कॉन्फ़िगर करें:
- नाम: डेटा फ़ील्ड का यूनिक नाम (जैसे,
email,customer_rating) - डेटा प्रकार: स्ट्रिंग, बूलियन, इंटीजर या नंबर में से चुनें
- विवरण: ट्रांसक्रिप्ट से डेटा निकालने के तरीके के विस्तृत निर्देश
विवरण फ़ील्ड LLM को भेजा जाता है और इसमें क्या निकालना है व उसे कैसे फ़ॉर्मैट करना है, यह यथासंभव स्पष्ट रूप से बताया जाना चाहिए।
Trial और Enterprise प्लान के लिए डेटा संग्रह आइटम की सीमा हर एजेंट पर 50 और दूसरे प्लान के लिए हर एजेंट पर 25 है।
सर्वोत्तम तरीके
प्रभावी एक्सट्रैक्शन प्रॉम्प्ट लिखना
- अपेक्षित फ़ॉर्मैट साफ़ तौर पर बताएं (जैसे, “user@domain.com फ़ॉर्मैट में ईमेल पता”)
- जानकारी गायब या अस्पष्ट होने पर क्या करना है, यह बताएं
- मान्य और अमान्य डेटा के उदाहरण शामिल करें
- सत्यापन की किसी भी ज़रूरत का उल्लेख करें
सामान्य डेटा संग्रह उदाहरण
संपर्क जानकारी:
email: “ग्राहक का ईमेल पता मानक फ़ॉर्मैट (user@domain.com) में निकालें”phone_number: “एरिया कोड सहित ग्राहक का फ़ोन नंबर निकालें”full_name: “ग्राहक का दिया हुआ पूरा नाम निकालें”
व्यावसायिक डेटा:
issue_category: “ग्राहक की समस्या को इनमें से एक में वर्गीकृत करें: तकनीकी, बिलिंग, अकाउंट या सामान्य”satisfaction_rating: “ग्राहक द्वारा दी गई कोई भी संख्यात्मक संतुष्टि रेटिंग निकालें (1-10 स्केल)”order_number: “ग्राहक द्वारा बताया गया कोई भी ऑर्डर या रेफ़रेंस नंबर निकालें”
व्यवहार संबंधी डेटा:
was_angry: “तय करें कि कॉल के दौरान ग्राहक ने गुस्सा या निराशा व्यक्त की थी या नहीं”requested_callback: “तय करें कि ग्राहक ने कॉलबैक या फ़ॉलो-अप का अनुरोध किया था या नहीं”
गायब या अस्पष्ट डेटा संभालना
जब मांगा गया डेटा ट्रांसक्रिप्ट में नहीं मिलता या अस्पष्ट होता है, तो एक्सट्रैक्शन null या खाली वैल्यू लौटाएगा। इन बातों पर विचार करें:
- गायब डेटा संभालने के लिए अपने ऐप्लिकेशन में कंडीशनल लॉजिक इस्तेमाल करें
- अधूरे एक्सट्रैक्शन के लिए फ़ॉलबैक मानदंड बनाएं
- एजेंट्स को ज़रूरी जानकारी लगातार इकट्ठा करने के लिए प्रशिक्षित करें
डेटा प्रकार दिशानिर्देश
स्ट्रिंग
बूलियन
इंटीजर
नंबर
ऐसी टेक्स्ट-आधारित जानकारी के लिए इस्तेमाल करें जो दूसरे प्रकारों में फ़िट नहीं होती।
उदाहरण:
- ग्राहक के नाम
- ईमेल पते
- प्रोडक्ट कैटेगरी
- समस्या के विवरण
सर्वोत्तम तरीके:
- ज़रूरत होने पर अपेक्षित फ़ॉर्मैट बताएं
- सत्यापन की ज़रूरतें शामिल करें
- मानकीकरण की ज़रूरतों पर विचार करें
उपयोग के मामले
समस्या निवारण
डेटा एक्सट्रैक्शन से खाली वैल्यू मिलना
- पुष्टि करें कि डेटा बातचीत के ट्रांसक्रिप्ट में मौजूद है
- जांचें कि आपका एक्सट्रैक्शन प्रॉम्प्ट पर्याप्त रूप से विशिष्ट है या नहीं
- सुनिश्चित करें कि डेटा प्रकार अपेक्षित फ़ॉर्मैट से मेल खाता है
- विचार करें कि बातचीत के दौरान जानकारी स्पष्ट रूप से बताई गई थी या नहीं
असंगत डेटा फ़ॉर्मैट
- फ़ॉर्मैट विनिर्देशों के लिए एक्सट्रैक्शन प्रॉम्प्ट की समीक्षा करें
- प्रॉम्प्ट में सत्यापन की ज़रूरतें जोड़ें
- डेटा मानकीकरण के लिए पोस्ट-प्रोसेसिंग पर विचार करें
- अलग-अलग बातचीत स्थितियों में टेस्ट करें
प्रदर्शन संबंधी बातें
- हर डेटा संग्रह नियम प्रोसेसिंग समय बढ़ाता है
- जटिल एक्सट्रैक्शन लॉजिक का मूल्यांकन होने में ज़्यादा समय लग सकता है
- एक्सट्रैक्शन की सटीकता और स्पीड की ज़रूरतों पर नज़र रखें
- संभव होने पर दक्षता के लिए प्रॉम्प्ट ऑप्टिमाइज़ करें
CRM सिस्टम, डेटाबेस और एनालिटिक्स प्लेटफ़ॉर्म के साथ इंटीग्रेशन के लिए निकाला गया डेटा पोस्ट-कॉल वेबहुक्स के ज़रिए उपलब्ध है।