

Retrieval-Augmented Generation
Overzicht
Retrieval-Augmented Generation (RAG) geeft je agent toegang tot grote kennisbanken die deze tijdens gesprekken kan gebruiken. In plaats van volledige documenten in het contextvenster te laden, haalt RAG alleen de meest relevante informatie op voor elke gebruikersvraag. Hierdoor kan je agent:
- Kennisbanken raadplegen die veel groter zijn dan in een prompt passen
- Nauwkeurigere, op kennis gebaseerde antwoorden geven
- Hallucinaties verminderen door naar bronmateriaal te verwijzen
- Kennis opschalen zonder meerdere gespecialiseerde agents te maken
RAG is ideaal voor agents die grote documenten, technische handleidingen of uitgebreide kennisbanken moeten raadplegen die de limieten van het contextvenster van traditionele prompting zouden overschrijden. RAG voegt een kleine vertraging van ongeveer 250 ms toe aan de reactietijd van je agent.
Deze video is opgenomen met een eerdere versie van het dashboard. De configuratiestappen voor RAG zijn ongewijzigd, maar sommige interface-elementen kunnen er anders uitzien.
Hoe RAG werkt
Wanneer RAG is ingeschakeld, verwerkt je agent gebruikersvragen volgens deze stappen:
- Queryverwerking: De vraag van de gebruiker wordt geanalyseerd en geherformuleerd voor optimale retrieval.
- Embeddinggeneratie: De verwerkte query wordt omgezet in een vector-embedding die de vraag van de gebruiker weergeeft.
- Retrieval: Het systeem zoekt de semantisch meest vergelijkbare content in je kennisbank.
- Antwoordgeneratie: De agent genereert een antwoord met zowel de gesprekscontext als de opgehaalde informatie.
Dit proces zorgt ervoor dat informatie die relevant is voor de vraag van de gebruiker aan de LLM wordt doorgegeven om een feitelijk juist antwoord te genereren.
Handleiding
Vereisten
- Een ElevenLabs-account
- Een geconfigureerde ElevenLabs-agent (maak er hier een)
- Minstens één document toegevoegd aan de kennisbank van je agent
Schakel RAG in voor je agent
Bijwerken via het dashboard
Bijwerken via de CLI
Bijwerken via de API
Ga in de instellingen van je agent naar de sectie Knowledge Base en schakel de optie Use RAG in. Configureer naar behoefte het embeddingmodel, het maximumaantal documentchunks en de maximale vectorafstand op het tabblad Advanced.
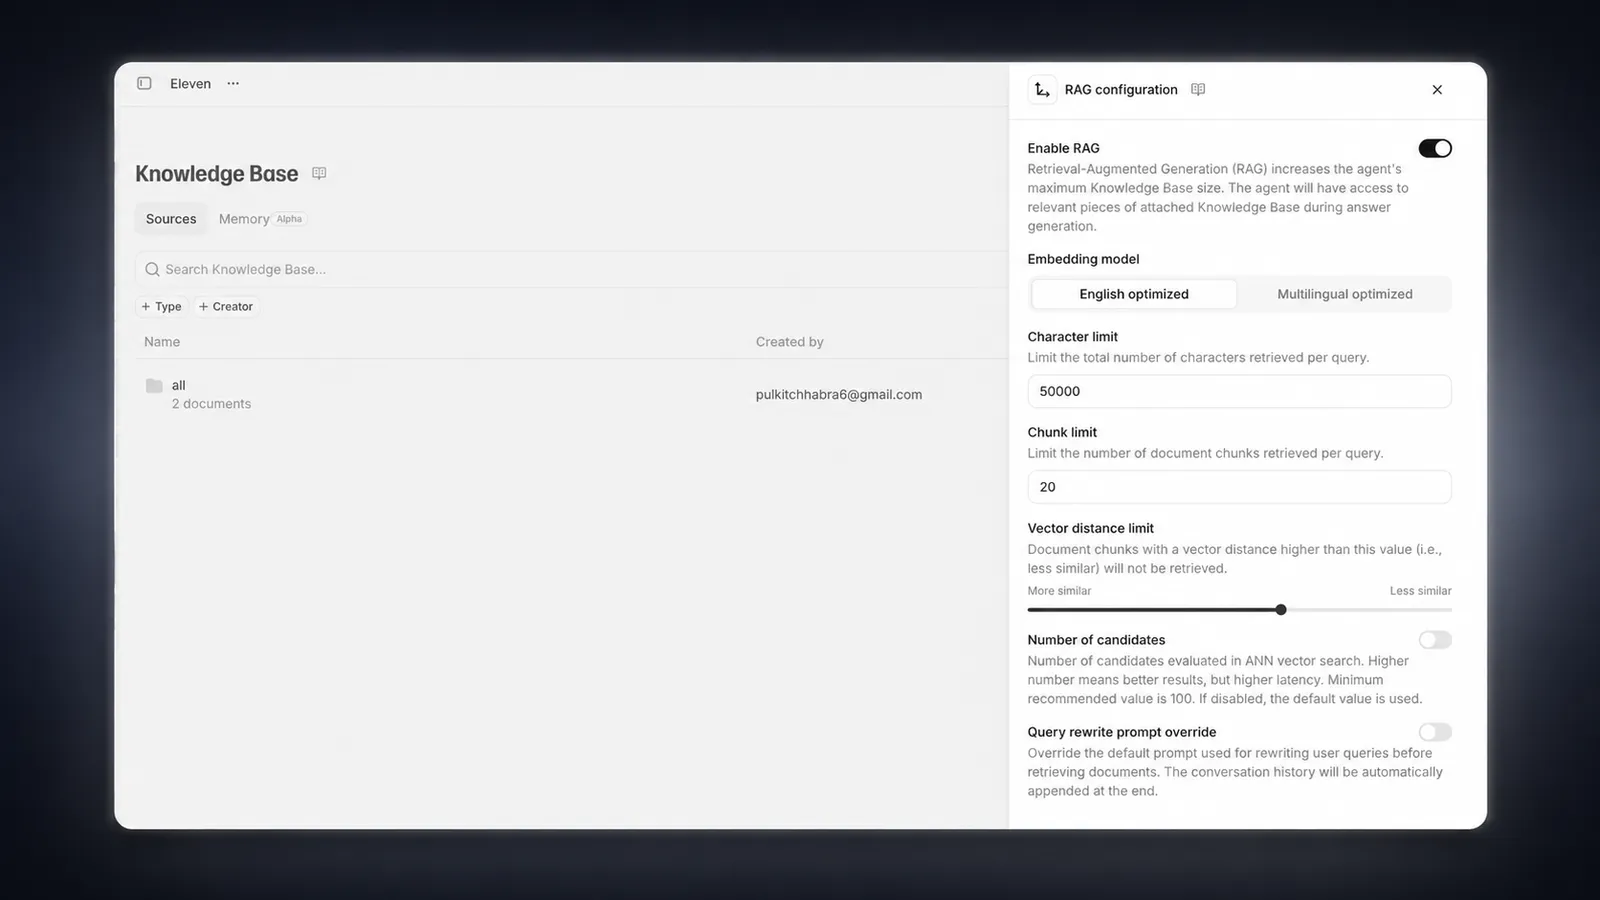
Kennisbankindexering
Elk document in je kennisbank moet worden geïndexeerd voordat het met RAG kan worden gebruikt. Dit gebeurt automatisch wanneer een document wordt toegevoegd aan een agent waarvoor RAG is ingeschakeld.
Het indexeren van grote documenten kan enkele minuten duren. Je kunt de indexeringsstatus in de kennisbanklijst controleren.
Modi voor documentgebruik configureren (optioneel)
Voor elk document in je kennisbank kun je kiezen hoe het wordt gebruikt:
- Auto (standaard): Het document wordt alleen opgehaald wanneer het relevant is voor de query
- Prompt: Het document wordt altijd opgenomen in de systeemprompt, ongeacht de relevantie
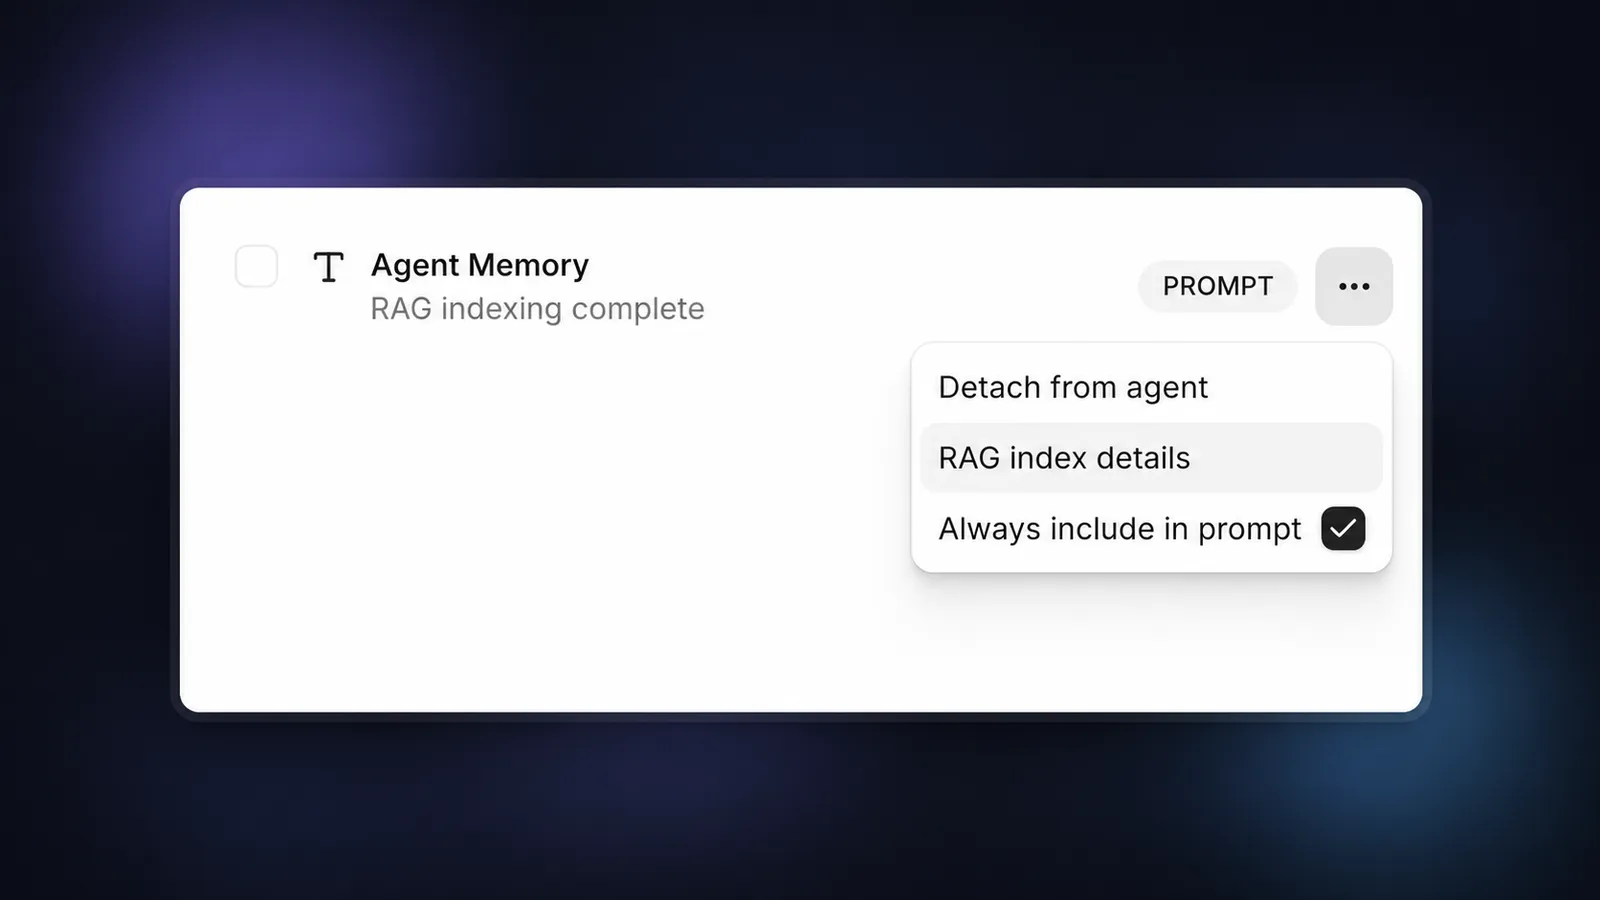
Te veel documenten instellen op de modus “Prompt” kan contextlimieten overschrijden. Gebruik deze optie spaarzaam voor kritieke informatie.
Test je agent met RAG ingeschakeld
Test je agent na het opslaan van je configuratie door vragen te stellen die verband houden met je kennisbank. Je agent moet nu specifieke informatie uit je documenten kunnen ophalen en ernaar kunnen verwijzen.
Gebruiksbeperkingen
Om een eerlijke verdeling van resources te waarborgen, hanteert ElevenLabs limieten voor de totale grootte van documenten die per workspace voor RAG kunnen worden geïndexeerd, op basis van het abonnement.
De limieten zijn als volgt:
Opmerking:
- Deze limieten gelden voor de totale oorspronkelijke bestandsgrootte van documenten die voor RAG zijn geïndexeerd, niet voor de interne opslaggrootte van de RAG-index zelf (die aanzienlijk groter kan zijn).
- Documenten kleiner dan 500 bytes kunnen niet voor RAG worden geïndexeerd en worden in plaats daarvan automatisch in de prompt gebruikt.
API-implementatie
Je kunt RAG ook implementeren via de API: