

Retrieval-Augmented Generation
Retrieval-Augmented Generation
Erweitern Sie Ihren Agenten mit großen Wissensdatenbanken durch RAG.
Übersicht
Retrieval-Augmented Generation (RAG) ermöglicht Ihrem Agenten, während Gesprächen auf große Wissensdatenbanken zuzugreifen und diese zu nutzen. Statt ganze Dokumente in das Kontextfenster zu laden, ruft RAG nur die relevantesten Informationen für jede Nutzeranfrage ab. So kann Ihr Agent:
- Auf deutlich größere Wissensdatenbanken zugreifen, als in einen Prompt passen würden
- Genauere, wissensbasierte Antworten geben
- Halluzinationen reduzieren, indem er sich auf Quellmaterial bezieht
- Wissen skalieren, ohne mehrere spezialisierte Agenten zu erstellen
RAG eignet sich ideal für Agenten, die auf große Dokumente, technische Handbücher oder umfangreiche Wissensdatenbanken zugreifen müssen, welche die Kontextfenster-Limits herkömmlicher Prompts überschreiten. RAG erhöht die Antwortzeit Ihres Agenten geringfügig, um etwa 250 ms.
Dieses Video wurde mit einer früheren Version des Dashboards aufgenommen. Die Schritte zur RAG-Konfiguration sind unverändert, aber einige Oberflächenelemente können anders aussehen.
So funktioniert RAG
Wenn RAG aktiviert ist, verarbeitet Ihr Agent Nutzeranfragen in diesen Schritten:
- Anfrageverarbeitung: Die Frage des Nutzers wird analysiert und für einen optimalen Abruf neu formuliert.
- Embedding-Erstellung: Die verarbeitete Anfrage wird in ein Vektor-Embedding umgewandelt, das die Frage des Nutzers darstellt.
- Abruf: Das System findet die semantisch ähnlichsten Inhalte aus Ihrer Wissensdatenbank.
- Antworterstellung: Der Agent erstellt eine Antwort anhand des Gesprächskontexts und der abgerufenen Informationen.
Dieser Prozess stellt sicher, dass für die Anfrage des Nutzers relevante Informationen an das LLM übergeben werden, um eine sachlich korrekte Antwort zu erzeugen.
Anleitung
Voraussetzungen
- Ein ElevenLabs-Konto
- Ein konfigurierter ElevenLabs-Conversational Agent
- Mindestens ein Dokument in der Wissensdatenbank Ihres Agenten
RAG für Ihren Agenten aktivieren
Über das Dashboard aktualisieren
Über die CLI aktualisieren
Über die API aktualisieren
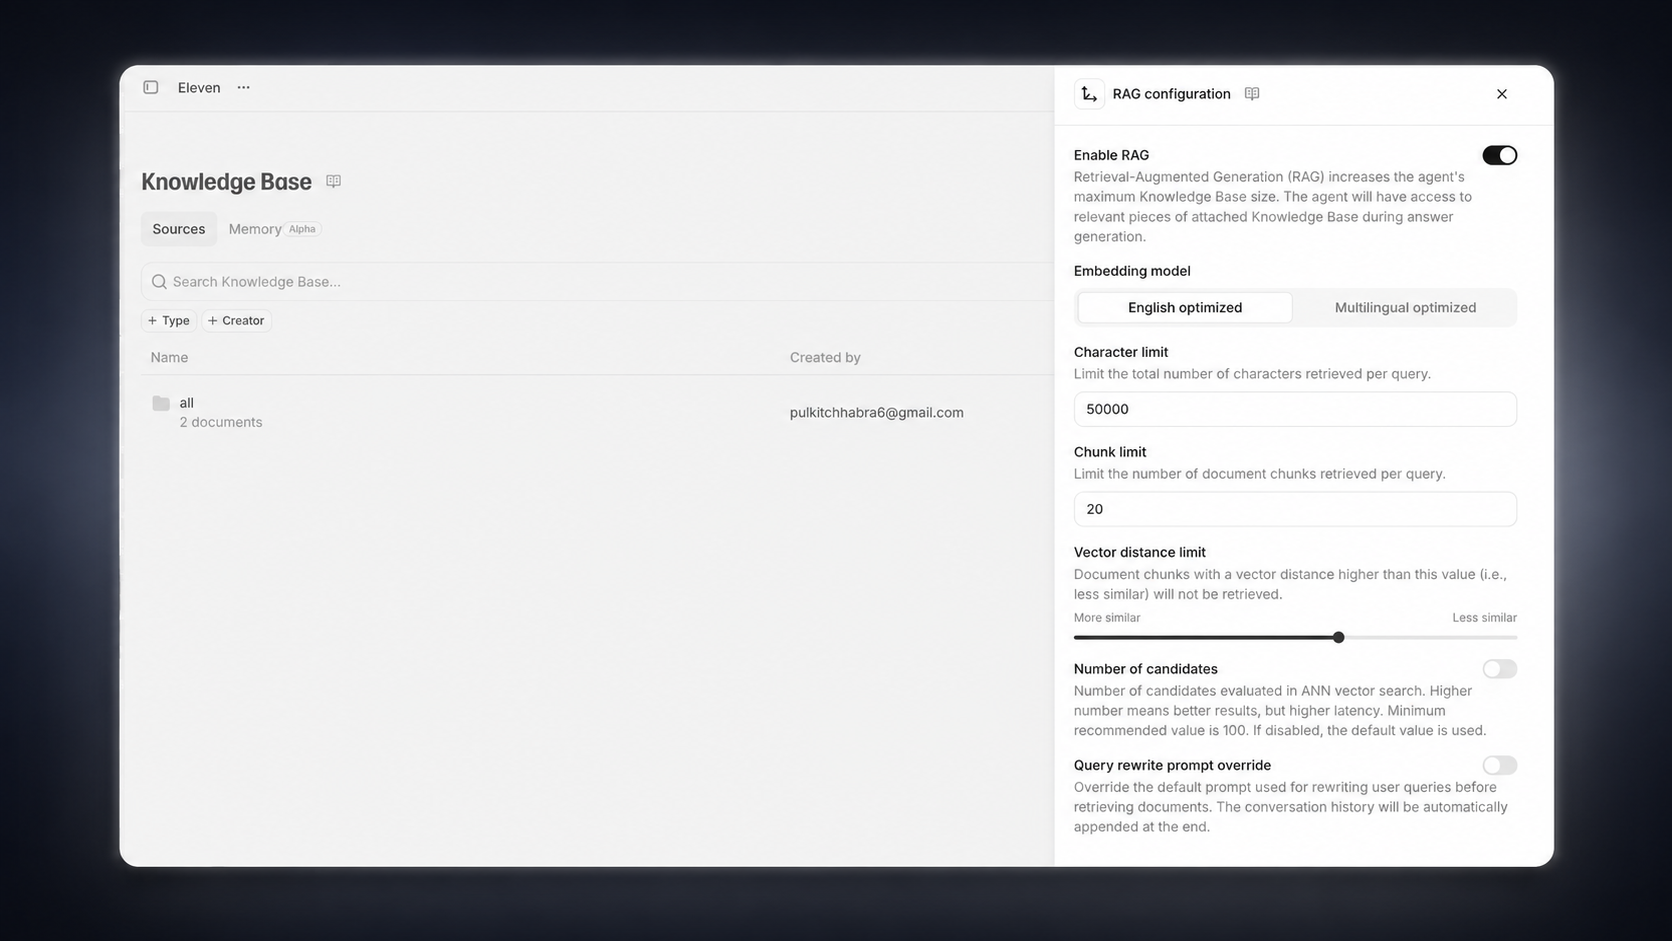
Navigieren Sie in den Einstellungen Ihres Agenten zum Abschnitt Knowledge Base und aktivieren Sie die Option Use RAG. Konfigurieren Sie bei Bedarf unter dem Tab Advanced das Embedding-Modell, die maximale Anzahl an Dokument-Chunks und die maximale Vektordistanz.
Indizierung der Wissensdatenbank
Jedes Dokument in Ihrer Wissensdatenbank muss indiziert werden, bevor es mit RAG verwendet werden kann. Dieser Prozess erfolgt automatisch, wenn ein Dokument zu einem Agenten mit aktiviertem RAG hinzugefügt wird.
Die Indizierung großer Dokumente kann einige Minuten dauern. Sie können den Indizierungsstatus in der Wissensdatenbankliste prüfen.
Dokumentnutzungsmodi konfigurieren (optional)
Für jedes Dokument in Ihrer Wissensdatenbank können Sie festlegen, wie es verwendet wird:
- Auto (Standard): Das Dokument wird nur abgerufen, wenn es für die Anfrage relevant ist
- Prompt: Das Dokument wird unabhängig von seiner Relevanz immer in den System-Prompt aufgenommen
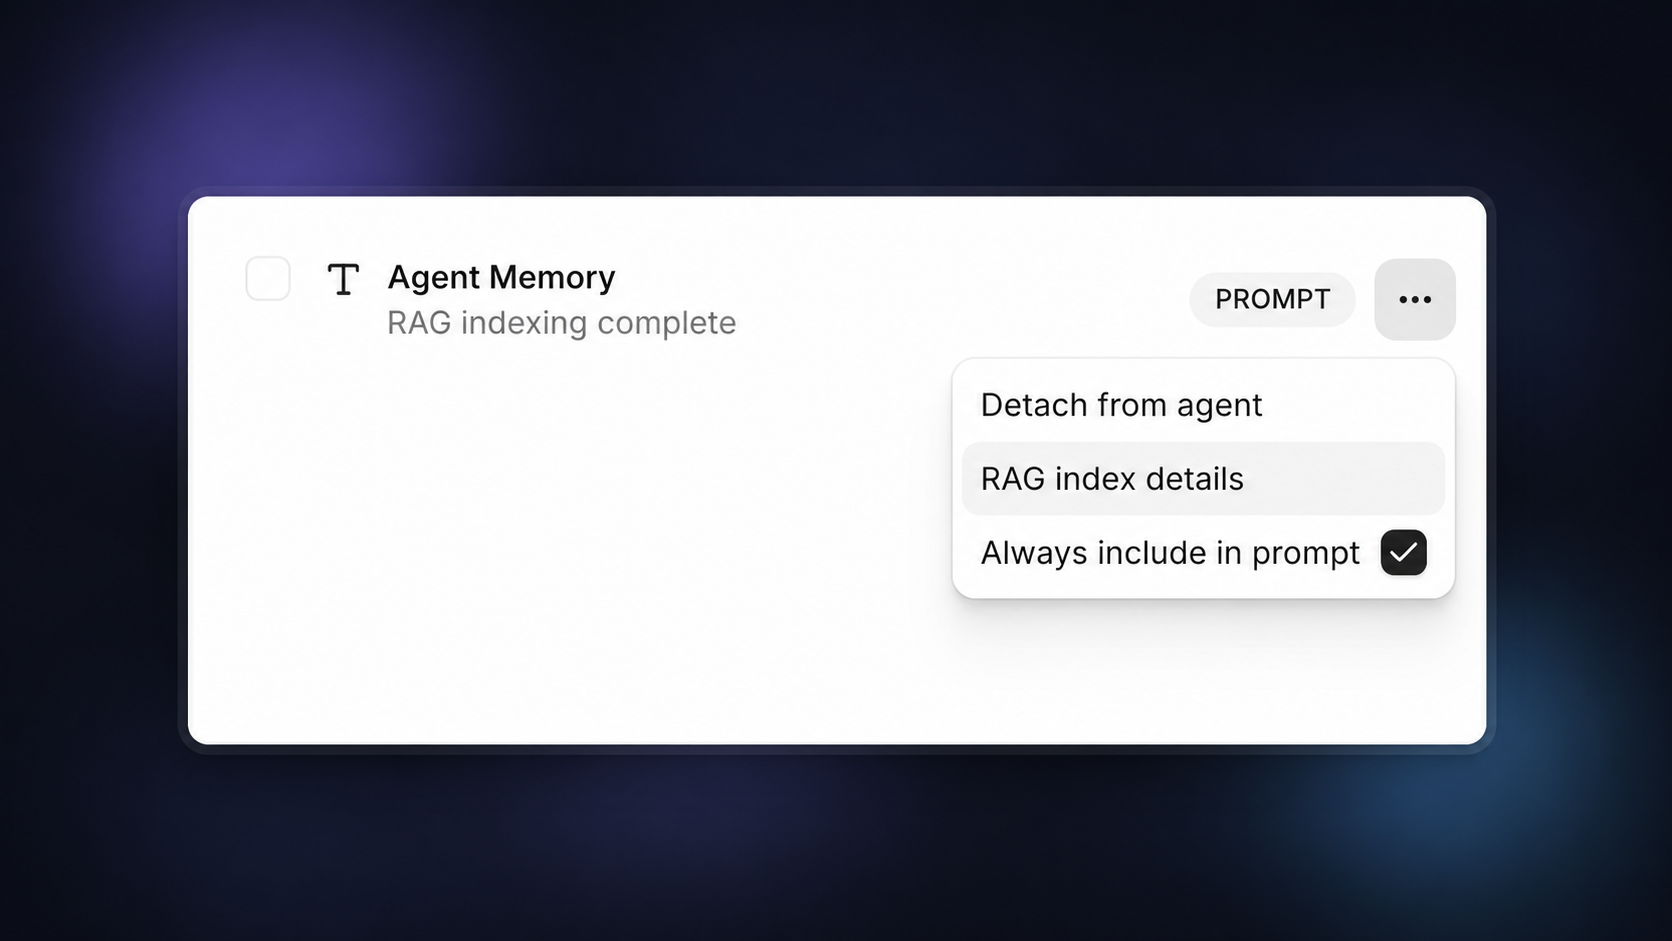
Wenn zu viele Dokumente auf den Modus „Prompt“ gesetzt werden, können Kontextlimits überschritten werden. Verwenden Sie diese Option sparsam für wichtige Informationen.
Ihren RAG-fähigen Agenten testen
Testen Sie Ihren Agenten nach dem Speichern der Konfiguration mit Fragen zu Ihrer Wissensdatenbank. Der Agent sollte nun spezifische Informationen aus Ihren Dokumenten abrufen und darauf verweisen können.
Nutzungslimits
Um eine faire Ressourcenverteilung zu gewährleisten, begrenzt ElevenLabs je Workspace die Gesamtgröße der für RAG indizierbaren Dokumente. Die Limits richten sich nach dem Abonnement.
Die Limits sind wie folgt:
Hinweis:
- Diese Limits gelten für die gesamte Originaldateigröße der für RAG indizierten Dokumente, nicht für die interne Speichergröße des RAG-Index selbst (die deutlich größer sein kann).
- Dokumente mit weniger als 500 Bytes können nicht für RAG indiziert werden und werden stattdessen automatisch im Prompt verwendet.
API-Implementierung
Sie können RAG auch über die API implementieren: