

Génération augmentée par récupération
Enrichissez votre agent avec de vastes bases de connaissances grâce au RAG.
Vue d’ensemble
La génération augmentée par récupération (RAG) permet à votre agent d’accéder à de vastes bases de connaissances et de les utiliser lors des conversations. Au lieu de charger des documents entiers dans la fenêtre de contexte, le RAG récupère uniquement les informations les plus pertinentes pour chaque requête utilisateur, ce qui permet à votre agent de :
- Accéder à des bases de connaissances bien plus vastes que ce qui tiendrait dans un prompt
- Fournir des réponses plus précises, fondées sur les connaissances
- Réduire les hallucinations en s’appuyant sur les documents sources
- Faire évoluer les connaissances sans concevoir plusieurs agents spécialisés
Le RAG est idéal pour les agents qui doivent consulter de grands documents, des manuels techniques ou de vastes bases de connaissances qui dépasseraient les limites de la fenêtre de contexte du prompting traditionnel. Le RAG ajoute une légère latence au temps de réponse de votre agent, d’environ 250 ms.
Cette vidéo a été enregistrée avec une version antérieure du Dashboard. Les étapes de configuration du RAG restent inchangées, mais certains éléments de l’interface peuvent être différents.
Fonctionnement du RAG
Lorsque le RAG est activé, votre agent traite les requêtes utilisateur selon les étapes suivantes :
- Traitement de la requête : la question de l’utilisateur est analysée et reformulée afin d’optimiser la récupération.
- Génération de l’embedding : la requête traitée est convertie en embedding vectoriel représentant la question de l’utilisateur.
- Récupération : le système trouve le contenu le plus similaire sur le plan sémantique dans votre base de connaissances.
- Génération de la réponse : l’agent génère une réponse à partir du contexte de la conversation et des informations récupérées.
Ce processus garantit que les informations pertinentes pour la requête de l’utilisateur sont transmises au LLM afin de générer une réponse factuellement correcte.
Guide
Prérequis
- Un compte ElevenLabs
- Un agent conversationnel ElevenLabs configuré
- Au moins un document ajouté à la base de connaissances de votre agent
Activer le RAG pour votre agent
Mise à jour via le Dashboard
Mise à jour via la CLI
Mise à jour via l’API
Dans les paramètres de votre agent, ouvrez Base de connaissances, puis sélectionnez l’onglet Récupération. Sous Mode de récupération, choisissez À chaque tour pour rechercher dans la base de connaissances à chaque tour, ou À la demande pour permettre à l’agent de rechercher uniquement lorsqu’il estime en avoir besoin. Prompt uniquement désactive la récupération.
Configurez le modèle d’embedding, la limite de distance vectorielle et le nombre de candidats sous Recherche sémantique, ainsi que les limites de caractères et de segments sous Limites de récupération.
Indexation de la base de connaissances
Chaque document de votre base de connaissances doit être indexé avant de pouvoir être utilisé avec le RAG. Ce processus s’exécute automatiquement lorsqu’un document est ajouté à un agent avec le RAG activé.
L’indexation de documents volumineux peut prendre რამდენიმე minutes. Vous pouvez vérifier l’état de l’indexation dans la liste de la base de connaissances.
Configurer les modes d’utilisation des documents (facultatif)
Pour chaque document de votre base de connaissances, vous pouvez choisir son mode d’utilisation :
- Auto (par défaut) : le document est récupéré uniquement lorsqu’il est pertinent pour la requête
- Prompt : le document est toujours inclus dans le prompt système, quelle que soit sa pertinence
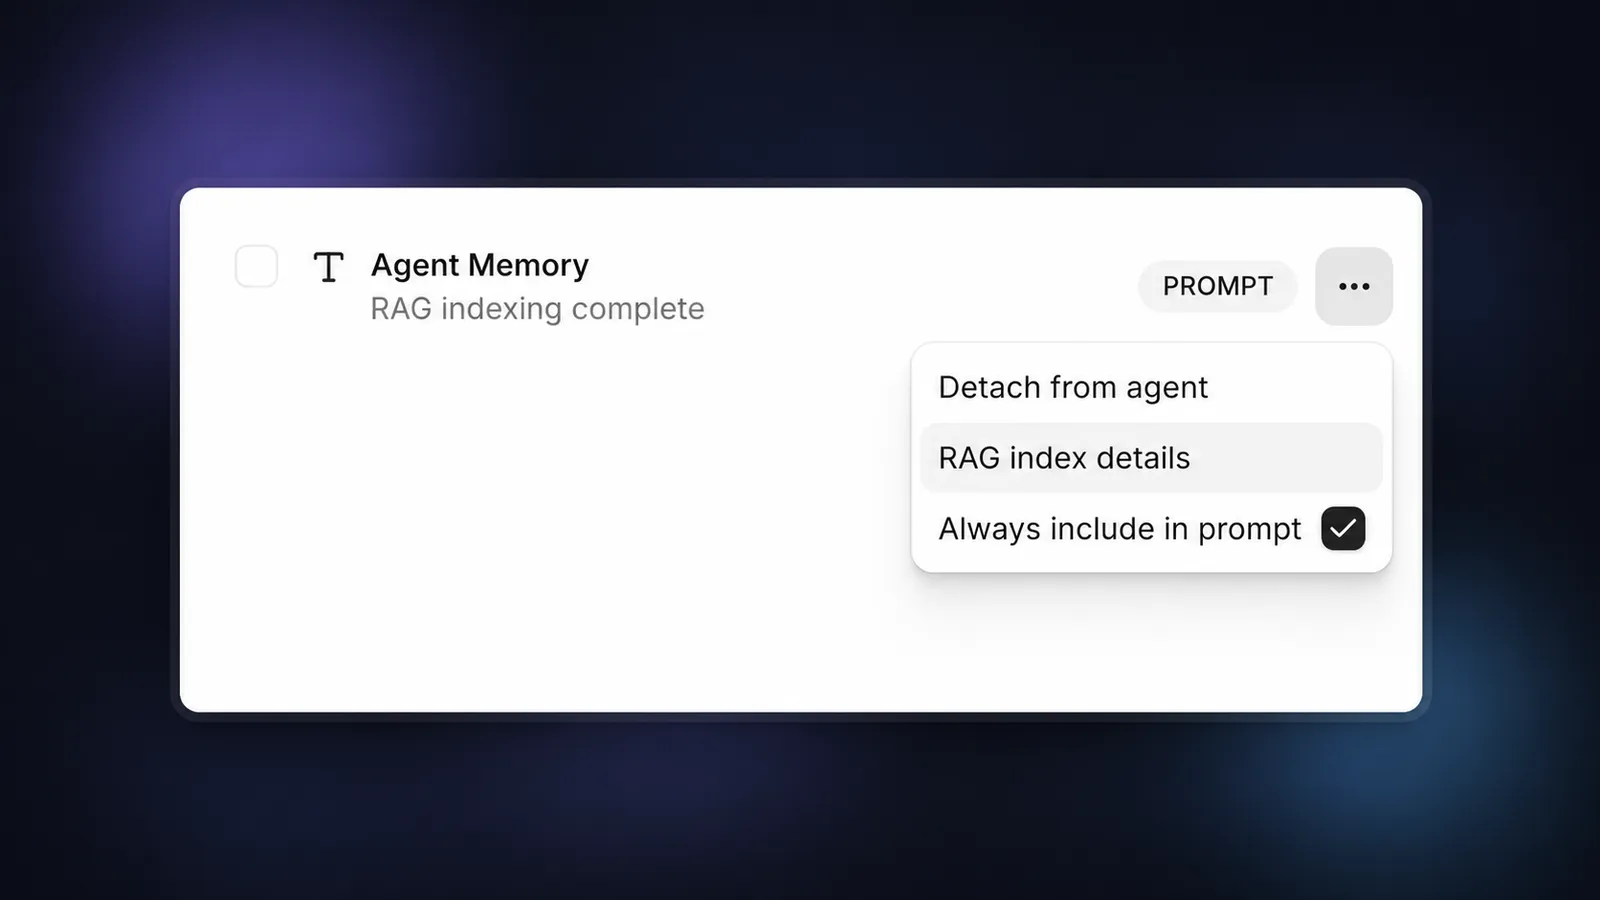
Définir trop de documents en mode « Prompt » peut dépasser les limites de contexte. Utilisez cette option avec parcimonie pour les informations critiques.
Tester votre agent avec RAG activé
Après avoir enregistré votre configuration, testez votre agent en posant des questions liées à votre base de connaissances. L’agent devrait désormais pouvoir récupérer et citer des informations spécifiques de vos documents.
Limites d’utilisation
Afin de garantir une répartition équitable des ressources, ElevenLabs applique, pour chaque Workspace, des limites à la taille totale des documents pouvant être indexés pour le RAG, selon le niveau d’abonnement.
Les limites sont les suivantes :
Remarque :
- Ces limites s’appliquent à la taille d’origine des fichiers des documents indexés pour le RAG, et non à la taille de stockage interne de l’index RAG lui-même, qui peut être nettement plus importante.
- Les documents de moins de 500 octets ne peuvent pas être indexés pour le RAG et seront automatiquement utilisés dans le prompt à la place.
Implémentation de l’API
Vous pouvez également implémenter le RAG via l’API :