

Retrieval-Augmented Generation
Förbättra din agent med stora kunskapsbaser med hjälp av RAG.
Översikt
Retrieval-Augmented Generation (RAG) gör att din agent kan få åtkomst till och använda stora kunskapsbaser under samtal. I stället för att läsa in hela dokument i kontextfönstret hämtar RAG bara den mest relevanta informationen för varje användarfråga, vilket gör att din agent kan:
- Få åtkomst till betydligt större kunskapsbaser än vad som ryms i en prompt
- Ge mer korrekta svar som är förankrade i kunskapsunderlaget
- Minska hallucinationer genom att hänvisa till källmaterial
- Skala kunskap utan att skapa flera specialiserade agenter
RAG passar perfekt för agenter som behöver hänvisa till stora dokument, tekniska manualer eller omfattande kunskapsbaser som skulle överskrida kontextfönstrets gränser vid traditionell prompting. RAG lägger till en liten fördröjning i agentens svarstid, omkring 250 ms.
Den här videon spelades in med en tidigare version av instrumentpanelen. Stegen för att konfigurera RAG är oförändrade, men vissa gränssnittselement kan se annorlunda ut.
Så fungerar RAG
När RAG är aktiverat behandlar din agent användarfrågor i följande steg:
- Frågebearbetning: Användarens fråga analyseras och omformuleras för optimal hämtning.
- Generering av embedding: Den bearbetade frågan omvandlas till en vektor-embedding som representerar användarens fråga.
- Hämtning: Systemet hittar innehållet i din kunskapsbas som är semantiskt mest likt.
- Svarsgenerering: Agenten genererar ett svar med hjälp av både samtalskontexten och den hämtade informationen.
Den här processen säkerställer att information som är relevant för användarens fråga skickas till LLM:en för att generera ett faktamässigt korrekt svar.
Guide
Förutsättningar
- Ett ElevenLabs-konto
- En konfigurerad Conversational Agent från ElevenLabs
- Minst ett dokument tillagt i agentens kunskapsbas
Aktivera RAG för din agent
Uppdatera via instrumentpanelen
Uppdatera via CLI
Uppdatera via API
Öppna Knowledge Base i agentens inställningar och välj fliken Retrieval. Under Retrieval mode väljer du Every turn för att söka i kunskapsbasen vid varje tur, eller On demand för att låta agenten söka endast när den bedömer att det behövs. Prompt only stänger av hämtning.
Konfigurera embedding-modellen, gränsen för vektoravstånd och antalet kandidater under Semantic search, samt tecken- och chunk-gränserna under Retrieval limits.
Indexering av kunskapsbasen
Varje dokument i din kunskapsbas måste indexeras innan det kan användas med RAG. Den här processen sker automatiskt när ett dokument läggs till i en agent med RAG aktiverat.
Indexering av stora dokument kan ta några minuter. Du kan kontrollera indexeringsstatusen i listan över kunskapsbaser.
Konfigurera lägen för dokumentanvändning (valfritt)
För varje dokument i din kunskapsbas kan du välja hur det används:
- Auto (standard): Dokumentet hämtas bara när det är relevant för frågan
- Prompt: Dokumentet inkluderas alltid i systemprompten, oavsett relevans
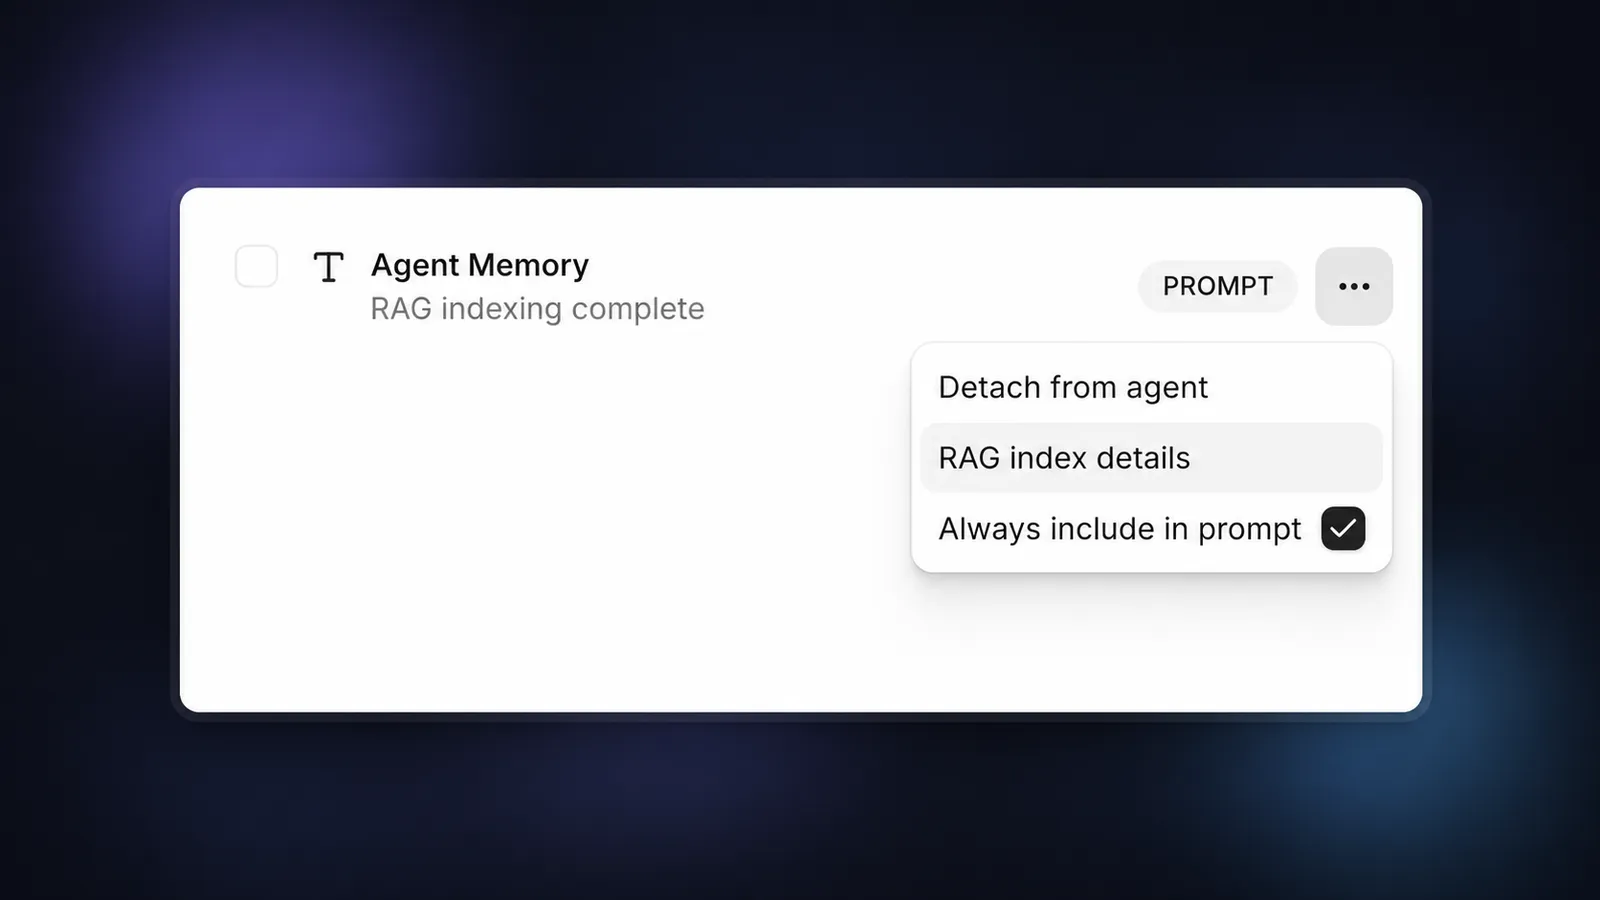
Om du ställer in för många dokument på läget “Prompt” kan du överskrida kontextgränserna. Använd det här alternativet sparsamt för viktig information.
Testa din RAG-aktiverade agent
När du har sparat konfigurationen testar du agenten genom att ställa frågor som rör din kunskapsbas. Agenten bör nu kunna hämta och hänvisa till specifik information från dina dokument.
Användningsgränser
För att säkerställa en rättvis resursfördelning tillämpar ElevenLabs gränser för den totala storleken på dokument som kan indexeras för RAG per arbetsyta, baserat på abonnemangsnivå.
Gränserna är följande:
Obs!
- Dessa gränser gäller den sammanlagda ursprungliga filstorleken för dokument som indexeras för RAG, inte den interna lagringsstorleken för själva RAG-indexet (som kan vara betydligt större).
- Dokument som är mindre än 500 byte kan inte indexeras för RAG och används automatiskt i prompten i stället.
API-implementering
Du kan också implementera RAG via API:et: