

検索拡張生成
検索拡張生成
RAGを使用して、大規模なナレッジベースでエージェントを強化します。
概要
**検索拡張生成(RAG)**を使用すると、エージェントは会話中に大規模なナレッジベースへアクセスして活用できます。ドキュメント全体をコンテキストウィンドウに読み込む代わりに、RAGはユーザーのクエリごとに最も関連性の高い情報だけを取得するため、次のことが可能になります。
- プロンプトに収まりきらないほど大規模なナレッジベースにアクセス
- ナレッジに基づいた、より正確な応答を提供
- ソース資料を参照してハルシネーションを削減
- 複数の専門エージェントを作成せずにナレッジを拡張
RAGは、大量のドキュメント、技術マニュアル、または従来のプロンプトの コンテキストウィンドウの制限を超える広範なナレッジベースを参照する必要があるエージェントに最適です。 RAGを使用すると、エージェントの応答時間に約250msのわずかなレイテンシーが追加されます。
この動画は以前のバージョンのダッシュボードで収録されています。RAGの設定手順は 変わりませんが、一部のインターフェース要素は異なる場合があります。
RAGの仕組み
RAGを有効にすると、エージェントは次の手順でユーザーのクエリを処理します。
- クエリ処理:ユーザーの質問を分析し、最適な検索のために再構成します。
- 埋め込みの生成:処理済みのクエリを、ユーザーの質問を表すベクトル埋め込みに変換します。
- 検索:ナレッジベースから意味的に最も類似したコンテンツを検索します。
- 応答生成:会話のコンテキストと取得した情報の両方を使用して、エージェントが応答を生成します。
このプロセスにより、ユーザーのクエリに関連する情報がLLMに渡され、事実に基づいた正確な回答を生成できます。
ガイド
前提条件
- ElevenLabsアカウント
- 設定済みのElevenLabs会話型エージェント
- エージェントのナレッジベースに追加されたドキュメントが1つ以上あること
エージェントでRAGを有効にする
ダッシュボードで更新
CLIで更新
APIで更新
エージェントの設定でナレッジベースセクションに移動し、RAGを使用オプションをオンにします。必要に応じて、詳細設定タブで埋め込みモデル、ドキュメントチャンクの最大数、ベクトル距離の最大値を設定します。
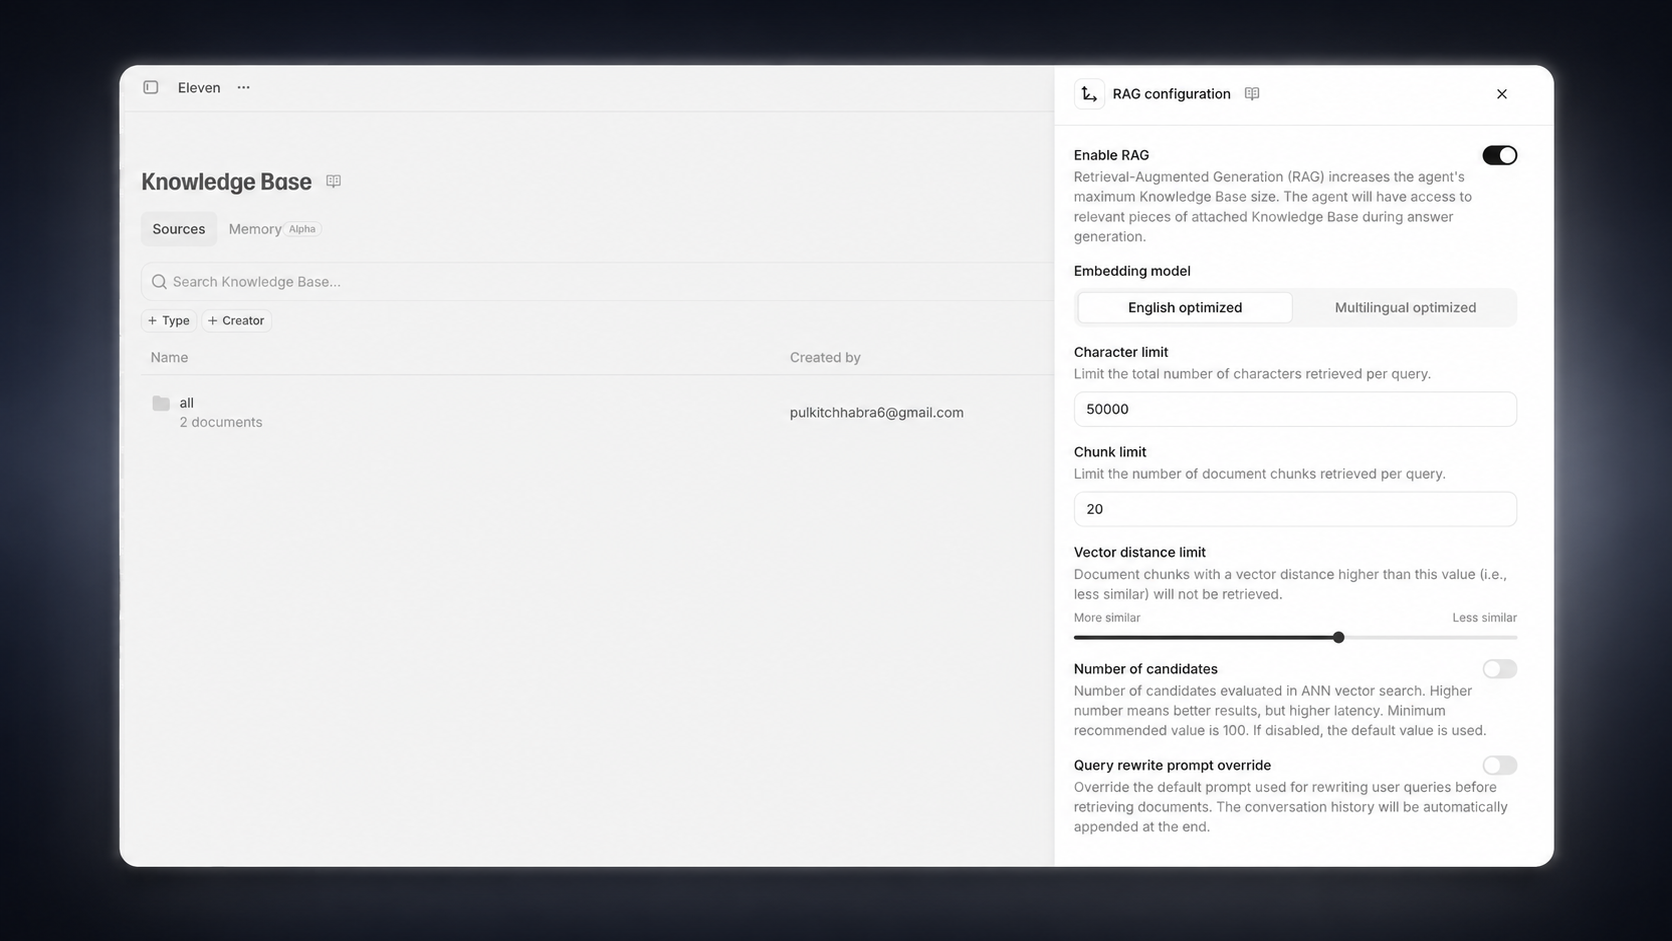
ナレッジベースのインデックス作成
ナレッジベース内の各ドキュメントは、RAGで使用する前にインデックスを作成する必要があります。この 処理は、RAGが有効なエージェントにドキュメントを追加すると自動的に行われます。
大規模なドキュメントでは、インデックス作成に数分かかる場合があります。インデックスのステータスは ナレッジベースのリストで確認できます。
ドキュメントの使用モードを設定する(任意)
ナレッジベース内のドキュメントごとに、使用方法を選択できます。
- 自動(デフォルト):クエリに関連する場合にのみドキュメントを取得します
- プロンプト:関連性にかかわらず、ドキュメントを常にシステムプロンプトに含めます
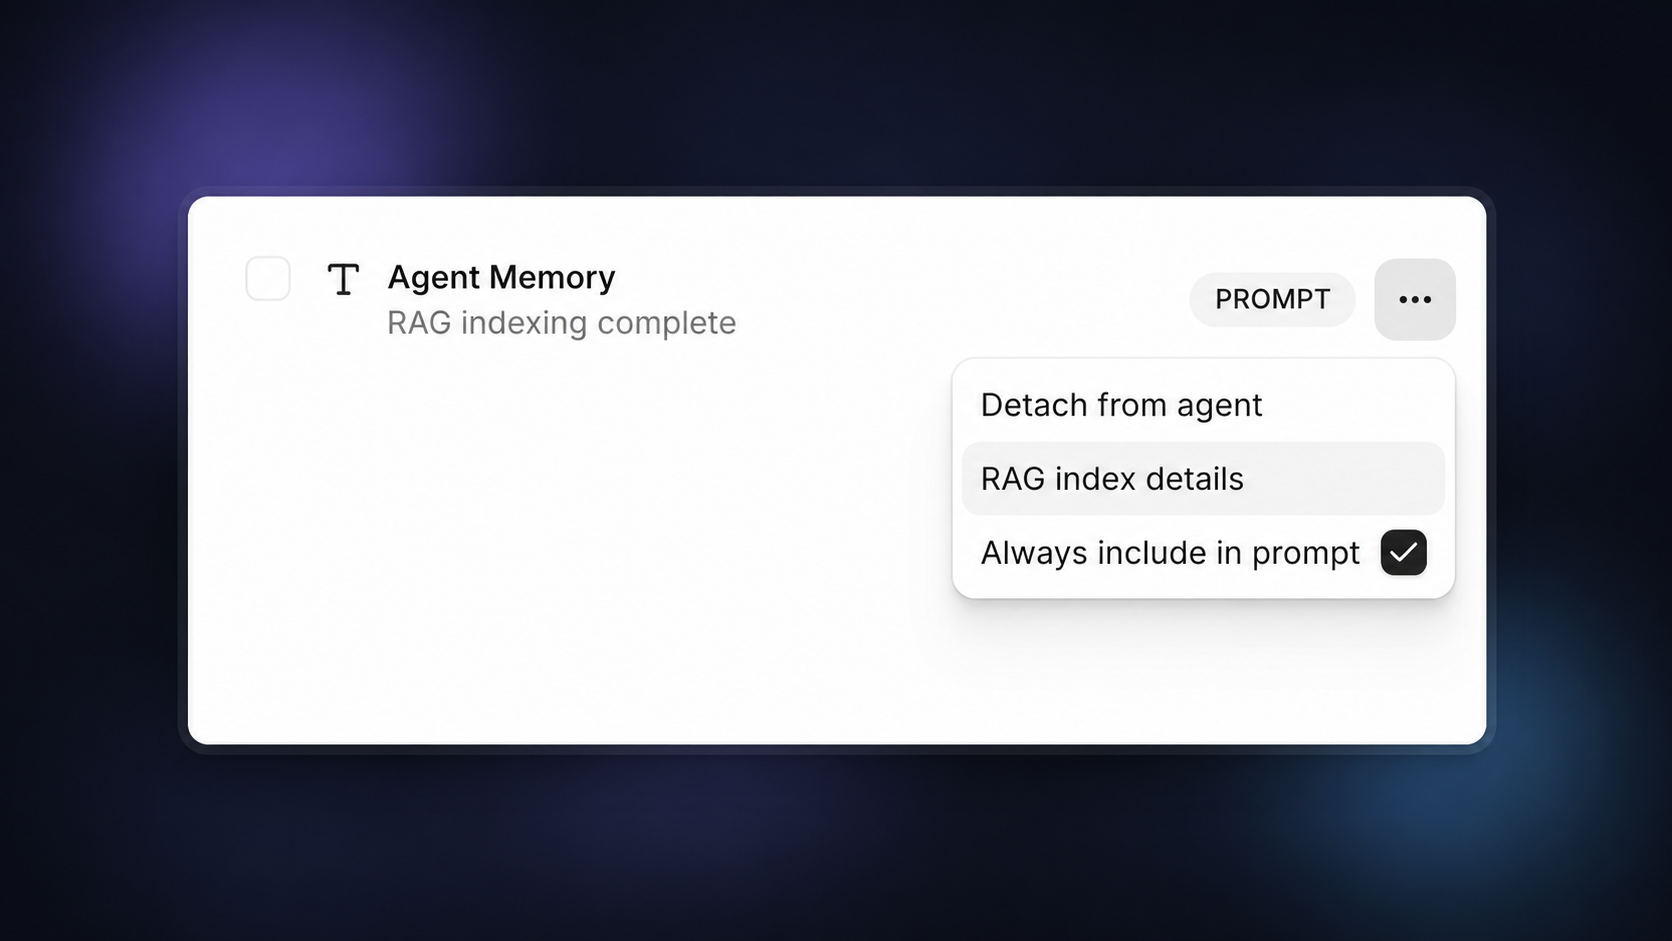
多数のドキュメントを「プロンプト」モードに設定すると、コンテキストの上限を超える場合があります。重要な情報にのみ このオプションを慎重に使用してください。
RAG有効化済みエージェントをテストする
設定を保存したら、ナレッジベースに関連する質問をしてエージェントをテストしてください。エージェントはドキュメントから特定の情報を取得して参照できるようになります。
使用制限
公平なリソース配分のため、ElevenLabsではサブスクリプションティアに応じて、ワークスペースごとにRAG用にインデックスを作成できるドキュメントの合計サイズを制限しています。
制限は次のとおりです。
注:
- これらの制限は、RAGインデックス自体の内部ストレージサイズ(大幅に大きくなる場合があります)ではなく、RAG用にインデックスを作成するドキュメントの合計元ファイルサイズに適用されます。
- 500バイト未満のドキュメントはRAG用にインデックスを作成できず、代わりに自動的にプロンプトで使用されます。
API実装
APIを通じてRAGを実装することもできます。