

Generowanie wspomagane wyszukiwaniem
Ulepsz swojego agenta dużymi bazami wiedzy dzięki RAG.
Omówienie
Retrieval-Augmented Generation (RAG) pozwala agentowi korzystać z dużych baz wiedzy podczas rozmów. Zamiast ładować całe dokumenty do okna kontekstu, RAG pobiera tylko informacje najbardziej istotne dla każdego zapytania użytkownika, dzięki czemu agent może:
- Korzystać z dużo większych baz wiedzy, niż zmieściłoby się w prompcie
- Udzielać dokładniejszych odpowiedzi opartych na wiedzy
- Ograniczać halucynacje dzięki odwoływaniu się do materiałów źródłowych
- Skalować bazę wiedzy bez tworzenia wielu wyspecjalizowanych agentów
RAG idealnie sprawdza się w agentach, które muszą odwoływać się do dużych dokumentów, instrukcji technicznych lub rozbudowanych baz wiedzy, przekraczających limity okna kontekstu tradycyjnego promptowania. RAG nieznacznie wydłuża czas odpowiedzi agenta, o około 250 ms.
Ten film nagrano we wcześniejszej wersji panelu. Kroki konfiguracji RAG pozostały bez zmian, ale niektóre elementy interfejsu mogą wyglądać inaczej.
Jak działa RAG
Gdy RAG jest włączony, agent przetwarza zapytania użytkownika w tych krokach:
- Przetwarzanie zapytania: Pytanie użytkownika jest analizowane i przeformułowywane, by zoptymalizować wyszukiwanie.
- Tworzenie embeddingu: Przetworzone zapytanie jest konwertowane na embedding wektorowy reprezentujący pytanie użytkownika.
- Wyszukiwanie: System znajduje najbardziej podobne semantycznie treści w bazie wiedzy.
- Generowanie odpowiedzi: Agent tworzy odpowiedź, korzystając zarówno z kontekstu rozmowy, jak i pobranych informacji.
Ten proces zapewnia przekazanie do LLM informacji istotnych dla zapytania użytkownika, aby wygenerować zgodną z faktami odpowiedź.
Przewodnik
Wymagania wstępne
- Konto ElevenLabs
- Skonfigurowany agent ElevenLabs
- Co najmniej jeden dokument dodany do bazy wiedzy agenta
Włącz RAG dla agenta
Aktualizacja w panelu
Aktualizacja przez CLI
Aktualizacja przez API
W ustawieniach agenta otwórz Knowledge Base i wybierz kartę Retrieval. W sekcji Retrieval mode wybierz Every turn, aby przeszukiwać bazę wiedzy przy każdej turze, albo On demand, aby agent wyszukiwał tylko wtedy, gdy uzna to za potrzebne. Prompt only wyłącza wyszukiwanie.
W sekcji Semantic search skonfiguruj model embeddingu, limit odległości wektorowej i liczbę kandydatów, a w Retrieval limits — limity znaków i fragmentów.
Indeksowanie bazy wiedzy
Każdy dokument w bazie wiedzy musi zostać zindeksowany, zanim będzie można użyć go z RAG. Ten proces odbywa się automatycznie, gdy dokument zostanie dodany do agenta z włączonym RAG.
Indeksowanie dużych dokumentów może potrwać kilka minut. Status indeksowania sprawdzisz na liście bazy wiedzy.
Skonfiguruj tryby użycia dokumentów (opcjonalnie)
Dla każdego dokumentu w bazie wiedzy możesz wybrać sposób jego użycia:
- Auto (domyślnie): Dokument jest pobierany tylko wtedy, gdy jest istotny dla zapytania
- Prompt: Dokument jest zawsze dołączany do promptu systemowego, niezależnie od istotności
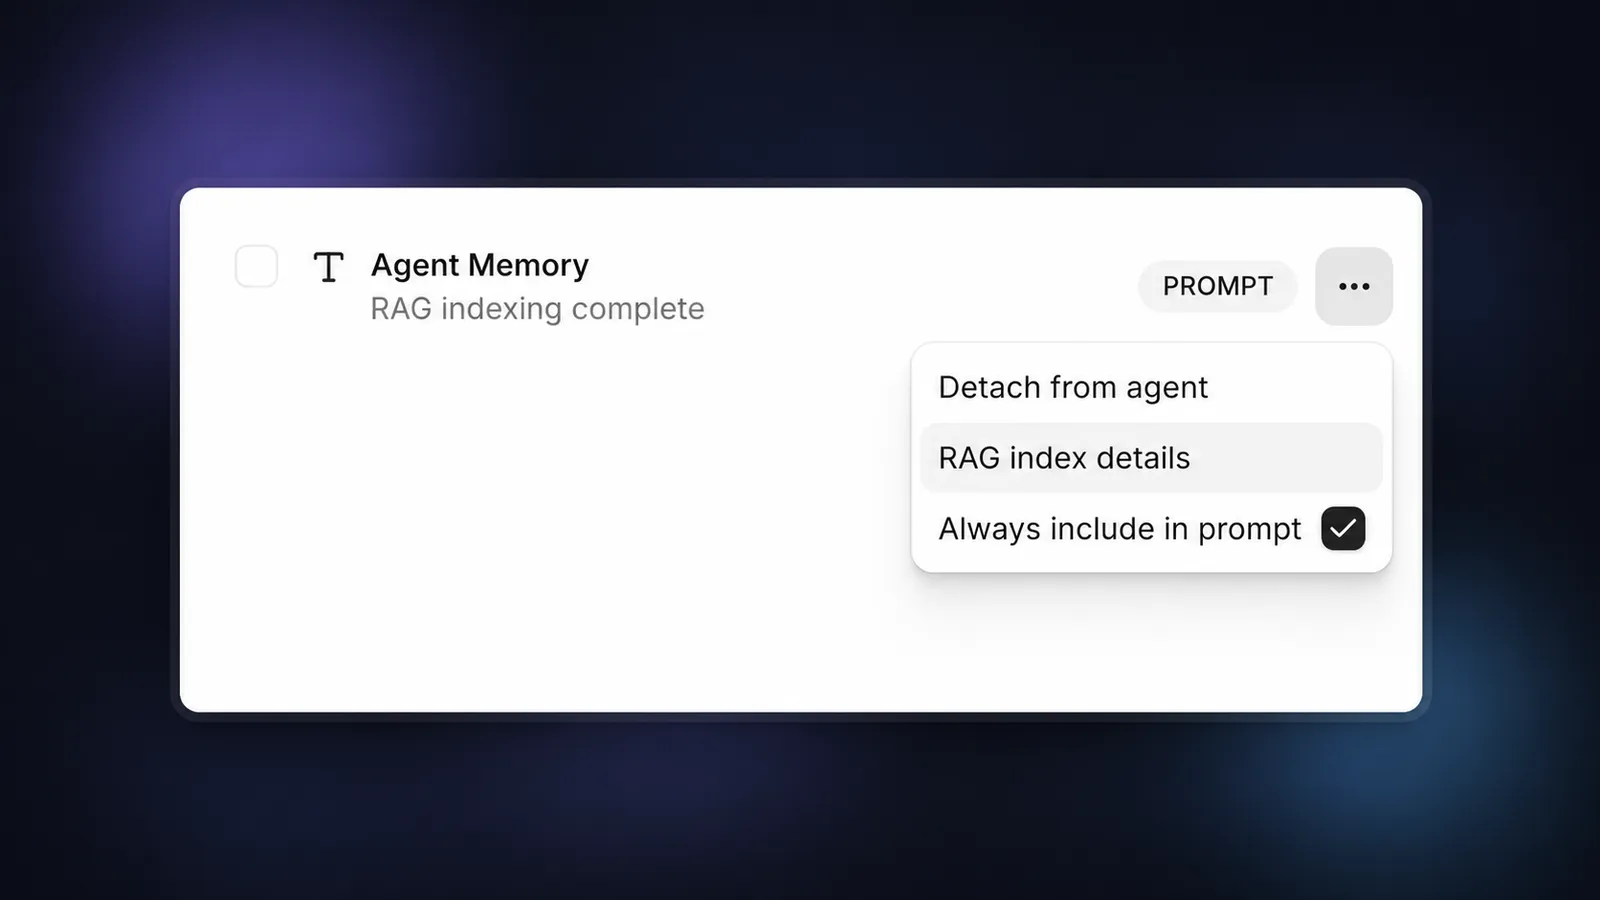
Ustawienie zbyt wielu dokumentów w trybie „Prompt” może przekroczyć limity kontekstu. Używaj tej opcji oszczędnie dla kluczowych informacji.
Przetestuj agenta z włączonym RAG
Po zapisaniu konfiguracji przetestuj agenta, zadając pytania związane z bazą wiedzy. Agent powinien teraz pobierać i przywoływać konkretne informacje z dokumentów.
Limity użycia
Aby zapewnić sprawiedliwy podział zasobów, ElevenLabs stosuje limity łącznego rozmiaru dokumentów, które można indeksować dla RAG w każdym obszarze roboczym, zależnie od planu subskrypcji.
Limity są następujące:
Uwaga:
- Te limity dotyczą łącznego oryginalnego rozmiaru plików dokumentów indeksowanych dla RAG, a nie wewnętrznego rozmiaru magazynu indeksu RAG (który może być znacznie większy).
- Dokumentów mniejszych niż 500 bajtów nie można indeksować dla RAG — zamiast tego będą automatycznie używane w prompcie.
Implementacja API
RAG możesz też wdrożyć przez API: